




50 câu hỏi phỏng vấn Data Engineer từ Junior đến Senior
Một buổi phỏng vấn Data Engineer hiếm khi chỉ kiểm tra khả năng nhớ cú pháp. Nhà tuyển dụng muốn biết ứng viên có thể biến dữ liệu rời rạc thành nguồn thông tin đáng tin cậy hay không: hiểu yêu cầu, thiết kế bảng, xây pipeline, kiểm soát chất lượng, xử lý sự cố và giải thích quyết định kỹ thuật.
Người mới thường học theo danh sách câu hỏi rồi thuộc một đáp án mẫu. Cách này dễ thất bại khi người phỏng vấn đổi bối cảnh hoặc hỏi tiếp “vì sao”. Một câu trả lời tốt cần có bốn lớp: định nghĩa đơn giản, tình huống sử dụng, lựa chọn đánh đổi và ví dụ từng làm hoặc có thể thiết kế.
Bài viết sắp xếp 50 câu hỏi phỏng vấn Data Engineer từ Junior đến Senior theo độ rộng của năng lực. Phần đầu kiểm tra nền tảng; phần sau đi vào kiến trúc, vận hành và trách nhiệm của người có kinh nghiệm. Mỗi câu không chỉ đưa đáp án mà còn chỉ ra điều nhà tuyển dụng thực sự muốn nghe.
Đây không phải bộ câu thần chú bảo đảm trúng tuyển. Mục tiêu là giúp người học xây cách suy nghĩ có hệ thống, nhận ra phần kiến thức còn thiếu và kết nối lý thuyết với dự án trong Portfolio. Khi có thể tự bảo vệ một thiết kế trước câu hỏi phản biện, ứng viên đã tiến gần hơn tới năng lực làm việc thật.
Mục lục
- PHẦN I — Cách chuẩn bị và trả lời phỏng vấn
- PHẦN II — SQL và mô hình dữ liệu
- PHẦN III — Python, Linux và Git
- PHẦN IV — Pipeline, ETL, ELT và Data Warehouse
- PHẦN V — Airflow, Docker và kiểm thử
- PHẦN VI — Cloud, bảo mật và chi phí
- PHẦN VII — Spark, Kafka và xử lý quy mô lớn
- PHẦN VIII — Thiết kế hệ thống và vận hành
- PHẦN IX — Câu hỏi hành vi và cấp Senior
- PHẦN X — Kế hoạch ôn tập và ứng tuyển
PHẦN I — CÁCH CHUẨN BỊ VÀ TRẢ LỜI PHỎNG VẤN
1. Data Engineer làm gì trong doanh nghiệp?
Data Engineer xây và vận hành hệ thống đưa dữ liệu từ nơi phát sinh tới nơi có thể phân tích hoặc phục vụ ứng dụng. Công việc gồm kết nối nguồn, làm sạch, mô hình hóa, kiểm tra chất lượng, phân quyền, theo dõi và xử lý lỗi. Ví dụ, kỹ sư dữ liệu hợp nhất đơn hàng từ website, cửa hàng và sàn vào Data Warehouse, tức kho dữ liệu dành cho phân tích, để tài chính đối soát doanh thu.
Nhà tuyển dụng muốn nghe một chuỗi trách nhiệm thay vì câu “xây pipeline”. Cần nói rõ hệ thống phải đúng, cập nhật đúng hạn, có thể truy tìm nguồn gốc và phục hồi khi lỗi. Data Engineer không tự định nghĩa doanh thu, nhưng phải phối hợp với người nghiệp vụ để biến định nghĩa đó thành logic được kiểm thử.
2. Data Engineer khác Data Analyst và Data Scientist thế nào?
Data Analyst dùng dữ liệu để trả lời câu hỏi kinh doanh và tạo báo cáo. Data Scientist xây mô hình thống kê hoặc Machine Learning, tức phương pháp để máy học quy luật từ dữ liệu. Data Engineer chuẩn bị nền tảng để hai nhóm kia có dữ liệu đúng, ổn định và có thể tái sử dụng.
Ranh giới có thể chồng lấn ở doanh nghiệp nhỏ. Một Data Engineer vẫn cần SQL phân tích; một Analyst có thể tự tạo mô hình dữ liệu. Điểm quan trọng là đầu ra chính: Data Engineer chịu trách nhiệm về luồng dữ liệu và độ tin cậy của hệ thống, không chỉ một báo cáo hoặc một mô hình.
3. Batch và streaming khác nhau ra sao?
Batch xử lý dữ liệu theo lô, chẳng hạn tổng hợp đơn hàng mỗi giờ. Streaming xử lý dòng sự kiện liên tục hoặc theo các lô rất nhỏ, chẳng hạn cập nhật vị trí tài xế sau vài giây. Streaming cho độ trễ thấp nhưng khó xử lý dữ liệu đến muộn, sai thứ tự, trùng và khôi phục trạng thái hơn.
Câu trả lời tốt không cho rằng thời gian thực luôn tốt hơn. Báo cáo tài chính theo ngày có thể dùng batch đơn giản, rẻ và dễ kiểm toán. Cảnh báo gian lận có thể cần streaming. Hãy gắn lựa chọn với quyết định kinh doanh, độ trễ chấp nhận được và chi phí vận hành.
4. OLTP và OLAP là gì?
OLTP là hệ thống xử lý giao dịch trực tuyến, tối ưu cho nhiều thao tác nhỏ như tạo đơn, cập nhật thanh toán hoặc kiểm tra tồn kho. OLAP là hệ thống phân tích trực tuyến, tối ưu cho truy vấn tổng hợp trên nhiều dữ liệu lịch sử. ERP hoặc ứng dụng bán hàng thường thuộc nhóm OLTP; Data Warehouse thường phục vụ OLAP.
Không nên chạy truy vấn phân tích nặng trực tiếp trên hệ thống giao dịch vì có thể làm chậm hoạt động bán hàng. Data Engineer thường sao chép thay đổi sang nền tảng phân tích, sau đó tổ chức dữ liệu theo cách thuận tiện cho báo cáo mà không ảnh hưởng nguồn.
5. Một câu trả lời kỹ thuật tốt nên có cấu trúc nào?
Bắt đầu bằng cách làm rõ yêu cầu, sau đó nêu phương án, lý do và điểm đánh đổi. Tiếp theo dùng ví dụ có số liệu giả định, nói cách kiểm thử, theo dõi và phục hồi. Nếu chưa từng dùng công nghệ được hỏi, hãy nối nó với khái niệm tương đương đã biết thay vì giả vờ có kinh nghiệm.
Ở câu thiết kế hệ thống, có thể đi theo thứ tự nguồn, cách lấy dữ liệu, nơi lưu, cách biến đổi, người dùng, SLA và bảo mật. SLA là cam kết về mức dịch vụ, chẳng hạn dữ liệu phải cập nhật trước 8 giờ. Cấu trúc rõ giúp người phỏng vấn đánh giá tư duy, kể cả khi phương án chưa hoàn hảo.
PHẦN II — SQL VÀ MÔ HÌNH DỮ LIỆU
6. INNER JOIN và LEFT JOIN khác nhau thế nào?
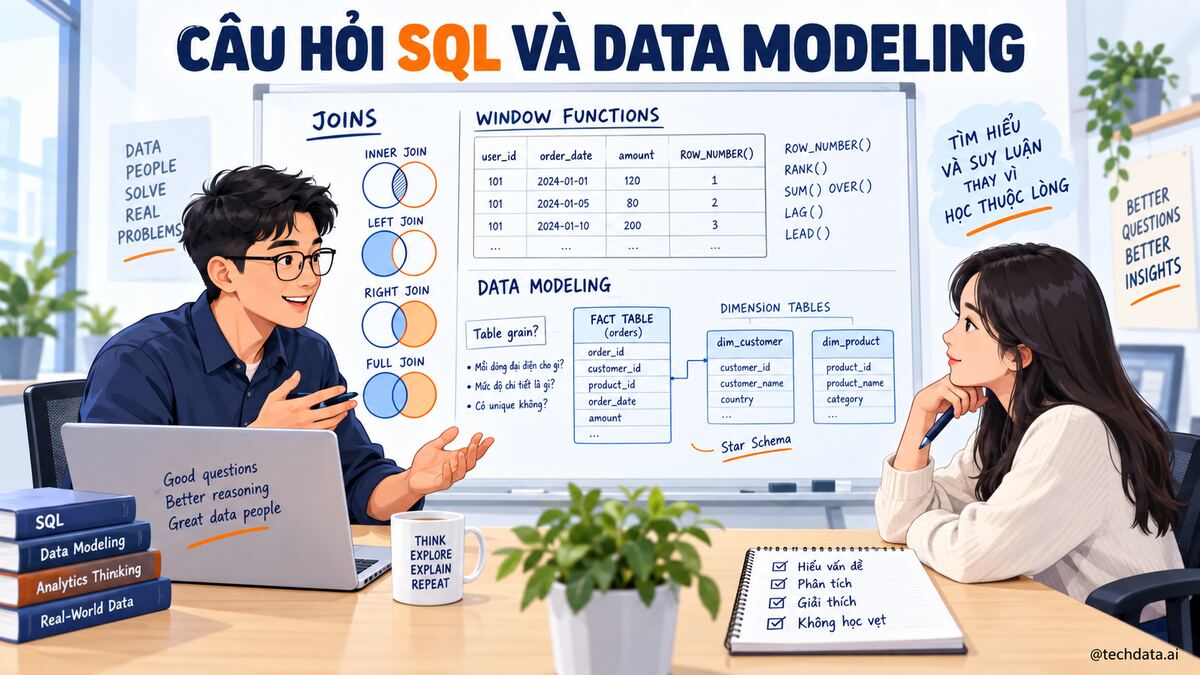
INNER JOIN chỉ giữ những dòng có khóa khớp ở hai bảng. LEFT JOIN giữ toàn bộ bảng bên trái và điền giá trị rỗng khi phía phải không khớp. Nếu cần danh sách mọi đơn hàng, kể cả đơn chưa có thanh toán, LEFT JOIN từ đơn hàng sang thanh toán phù hợp hơn.
Lỗi phổ biến là đặt điều kiện của bảng phải trong mệnh đề WHERE, vô tình biến LEFT JOIN thành kết quả giống INNER JOIN. Cần kiểm tra số dòng trước và sau khi nối, tỷ lệ không khớp và tính duy nhất của khóa để tránh nhân bản doanh thu.
7. WHERE và HAVING khác nhau ra sao?
WHERE lọc dòng trước khi nhóm; HAVING lọc kết quả sau khi GROUP BY đã tính tổng. Muốn tính doanh thu năm 2026, điều kiện ngày đặt ở WHERE. Muốn chỉ giữ cửa hàng có doanh thu trên một tỷ đồng, điều kiện tổng doanh thu đặt ở HAVING.
Lọc sớm thường giảm lượng dữ liệu phải xử lý. Tuy nhiên, điều quan trọng hơn tốc độ là đúng ý nghĩa. Ứng viên nên giải thích thứ tự logic của truy vấn và thử một bộ dữ liệu nhỏ để chứng minh kết quả.
8. Window function dùng để làm gì?
Window function, hay hàm cửa sổ, tính toán trên một nhóm dòng mà vẫn giữ từng dòng gốc. Nó hữu ích để xếp hạng, tính tổng lũy kế, so với kỳ trước hoặc chọn bản ghi mới nhất. Ví dụ, ROW_NUMBER có thể đánh số phiên bản của từng đơn theo thời gian cập nhật để giữ phiên bản cuối.
Khác với GROUP BY, hàm cửa sổ không làm giảm số dòng. Cần nói rõ PARTITION BY xác định nhóm và ORDER BY xác định thứ tự trong nhóm. Nếu thứ tự có giá trị bằng nhau, nên thêm khóa phụ để kết quả ổn định.
9. CTE và subquery nên dùng khi nào?
CTE là biểu thức bảng tạm được đặt tên bằng WITH, giúp chia truy vấn thành các bước dễ đọc. Subquery là truy vấn nằm trong truy vấn khác. Hai cách thường có thể cho cùng kết quả; lựa chọn phụ thuộc khả năng đọc, tái sử dụng và cách bộ máy dữ liệu tối ưu.
Không nên khẳng định CTE luôn nhanh hoặc luôn chậm vì mỗi hệ quản trị có cách xử lý khác nhau. Hãy xem kế hoạch thực thi, lượng dữ liệu và số lần tham chiếu. Trong mã nghiệp vụ, các bước tên rõ như orders_clean và revenue_daily thường dễ kiểm tra hơn một truy vấn lồng sâu.
10. Làm sao tìm và xử lý bản ghi trùng?
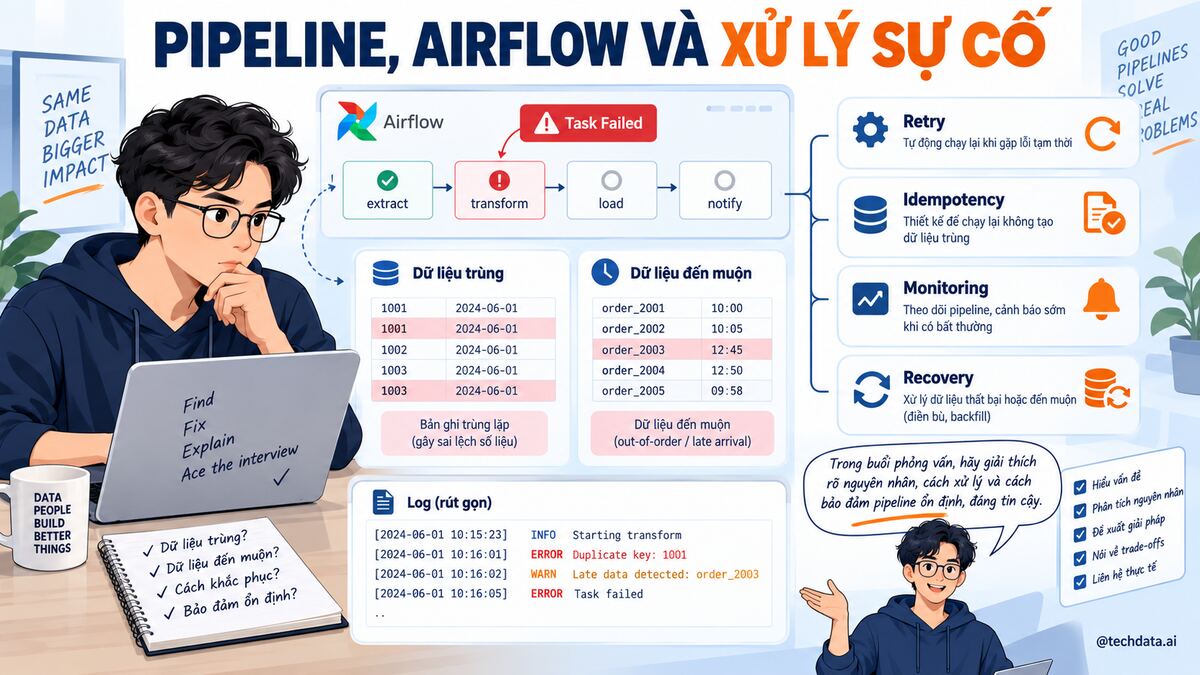
Trước tiên phải xác định “trùng” theo nghiệp vụ: cùng mã sự kiện, cùng đơn hàng hay toàn bộ cột giống nhau. Có thể GROUP BY khóa và HAVING COUNT lớn hơn một để phát hiện. Khi chọn bản ghi giữ lại, ROW_NUMBER theo thời điểm cập nhật và nguồn ưu tiên thường rõ ràng hơn DISTINCT.
DISTINCT có thể che lỗi nối bảng hoặc nguồn gửi lặp mà không giải quyết nguyên nhân. Pipeline tốt dùng khóa duy nhất, mã sự kiện và cơ chế ghi có tính lặp lại an toàn. Sau xử lý, cần đo tỷ lệ trùng và lưu các dòng bị loại để điều tra.
11. Primary key, foreign key và surrogate key là gì?
Primary key là khóa xác định duy nhất một dòng. Foreign key là khóa tham chiếu sang bảng khác. Surrogate key là khóa kỹ thuật do hệ thống dữ liệu tạo, thường không mang ý nghĩa nghiệp vụ, giúp quản lý lịch sử khi mã từ nguồn thay đổi hoặc trùng giữa nhiều nguồn.
Ví dụ, mã khách C001 có thể xuất hiện ở cả website và cửa hàng. Kho dữ liệu tạo customer_key riêng, đồng thời giữ source_system và source_customer_id. Khóa kỹ thuật không thay việc xác định quy tắc ghép khách; nó chỉ tạo cách tham chiếu ổn định.
12. Normalization và denormalization khác nhau thế nào?
Normalization, hay chuẩn hóa, tách dữ liệu thành các bảng để giảm lặp và cập nhật nhất quán. Nó phù hợp với hệ thống giao dịch. Denormalization, hay phi chuẩn hóa, chủ động ghép hoặc lặp một phần dữ liệu để truy vấn phân tích đơn giản và nhanh hơn.
Không có cách nào luôn đúng. Một bảng giao dịch cần tránh lưu tên khách ở hàng triệu đơn vì tên có thể đổi. Một bảng phục vụ dashboard có thể lưu sẵn nhóm sản phẩm để giảm số phép nối. Lựa chọn phải xét mẫu truy vấn, độ tươi và cách cập nhật.
13. Star schema là gì?
Star schema, hay mô hình hình sao, có bảng fact ở giữa chứa sự kiện đo lường và các bảng dimension xung quanh chứa ngữ cảnh. Fact_sales có số lượng, doanh thu và khóa ngày, sản phẩm, cửa hàng; các dimension mô tả từng đối tượng.
Thiết kế phải xác định grain, tức mức chi tiết của một dòng, trước khi chọn cột. Nếu một dòng fact là một dòng sản phẩm trong đơn, không thể nối trực tiếp bảng khuyến mại có nhiều bản ghi cho cùng dòng mà không kiểm soát. Grain rõ giúp tránh nhân số.
14. Slowly Changing Dimension là gì?
Slowly Changing Dimension là cách quản lý thuộc tính thay đổi chậm của đối tượng. Type 1 ghi đè giá trị cũ; Type 2 tạo phiên bản mới có ngày hiệu lực để giữ lịch sử. Ví dụ, muốn báo cáo doanh thu theo khu vực khách tại thời điểm mua, địa chỉ cần lịch sử Type 2.
Không phải thuộc tính nào cũng cần Type 2. Sửa lỗi chính tả có thể ghi đè; thay đổi phân khúc khách có thể cần lịch sử. Ứng viên nên nói cách tránh khoảng thời gian chồng lấn, cách chọn phiên bản đúng theo ngày giao dịch và ảnh hưởng tới dung lượng.
15. Làm sao tối ưu một truy vấn SQL chậm?
Trước hết xem kế hoạch thực thi và đo bước tốn thời gian, thay vì sửa theo cảm giác. Kiểm tra lượng dữ liệu quét, bộ lọc, khóa nối, nhân bản dòng, sắp xếp lớn và khả năng dùng partition. Partition là cách chia bảng theo cột như ngày để chỉ đọc phần cần thiết.
Tiếp theo có thể chọn cột cần dùng, lọc sớm, tạo bảng tổng hợp hoặc materialized view cho truy vấn lặp. Index hữu ích ở cơ sở dữ liệu giao dịch nhưng không phải câu trả lời chung cho kho dữ liệu cột. Cần đo trước và sau, đồng thời kiểm tra kết quả không đổi.
16. NULL gây vấn đề gì?
NULL thể hiện giá trị chưa biết hoặc không có, không giống số 0 hay chuỗi rỗng. Phép so sánh bằng NULL không cho kết quả như so với giá trị thông thường; phải dùng IS NULL. Hàm tổng hợp và phép nối cũng có hành vi riêng với NULL.
Không nên thay mọi NULL bằng 0 vì có thể biến “chưa ghi nhận doanh thu” thành “doanh thu bằng không”. Cần thống nhất ý nghĩa ở từng cột, kiểm tra tỷ lệ NULL và chỉ dùng COALESCE khi giá trị thay thế đúng với nghiệp vụ.
PHẦN III — PYTHON, LINUX VÀ GIT
17. Vì sao Data Engineer cần Python?
Python phù hợp để gọi API, xử lý tệp, điều phối tác vụ, kiểm thử và tự động hóa. Hệ sinh thái thư viện phong phú giúp kết nối nhiều hệ thống. Tuy nhiên, Python không nên thay SQL cho mọi phép biến đổi trong kho dữ liệu và không phù hợp để nạp toàn bộ bảng lớn vào bộ nhớ máy cá nhân.
Nhà tuyển dụng thường muốn thấy mã có cấu trúc, ghi nhật ký, cấu hình tách khỏi mã, xử lý lỗi và test. Một chương trình 30 dòng chạy được một lần chưa chứng minh khả năng vận hành hằng ngày.
18. List, tuple, set và dictionary khác nhau thế nào?
List là danh sách có thứ tự và thay đổi được. Tuple có thứ tự nhưng không đổi sau khi tạo. Set giữ phần tử duy nhất và hỗ trợ kiểm tra tồn tại nhanh. Dictionary lưu cặp khóa–giá trị, thích hợp để tra cấu hình hoặc ánh xạ mã.
Câu trả lời nên gắn với dữ liệu: dùng set phát hiện mã trùng trong một lô nhỏ, dictionary ánh xạ tên cột, tuple làm khóa kết hợp. Với dữ liệu lớn, không nên giả định mọi cấu trúc đều vừa bộ nhớ; có thể cần đọc từng phần hoặc đẩy xử lý xuống cơ sở dữ liệu.
19. Generator có lợi ích gì?
Generator tạo từng phần tử khi cần thay vì giữ toàn bộ kết quả trong bộ nhớ. Nó phù hợp khi đọc tệp lớn theo dòng hoặc lấy dữ liệu API theo trang. Từ khóa yield cho phép hàm tạm dừng và tiếp tục ở lần lặp sau.
Generator giúp giảm bộ nhớ nhưng không tự giải quyết mọi vấn đề hiệu năng. Cần đóng tài nguyên, xử lý lỗi giữa luồng và lưu checkpoint nếu muốn tiếp tục sau khi thất bại. Với API, vẫn phải kiểm soát giới hạn tốc độ và số lần thử lại.
20. Xử lý ngoại lệ trong pipeline thế nào?
Không nên bắt mọi lỗi rồi bỏ qua. Hãy phân loại lỗi có thể thử lại như mạng tạm thời, lỗi dữ liệu cần cách ly và lỗi cấu hình phải dừng ngay. Nhật ký cần có tên tác vụ, lô dữ liệu, thời gian, nguồn và thông báo đủ để điều tra nhưng không lộ bí mật.
Retry, tức thử lại, phải có giới hạn và thời gian chờ tăng dần. Nếu một dòng hỏng không nên làm dừng cả lô, có thể đưa vào vùng cách ly và cảnh báo. Quyết định này phụ thuộc yêu cầu nghiệp vụ; báo cáo tài chính có thể buộc dừng khi thiếu dữ liệu.
21. Những lệnh Linux nào cần biết?
Người mới nên biết điều hướng tệp, xem quyền, tìm nội dung, theo dõi tiến trình, kiểm tra dung lượng, đọc nhật ký và quản lý biến môi trường. Các lệnh như pwd, ls, cd, grep, tail, ps, top, df và chmod là nền tảng. Quan trọng hơn là hiểu đường dẫn, quyền người dùng và mã thoát của chương trình.
Trong phỏng vấn, hãy mô tả cách điều tra một tác vụ thất bại: kiểm tra trạng thái, nhật ký, dung lượng đĩa, quyền và cấu hình. Không chạy lệnh xóa hoặc đổi quyền rộng chỉ để “thử cho chạy”.
22. Biến môi trường và secret khác nhau thế nào?
Biến môi trường là một cách truyền cấu hình vào chương trình, chẳng hạn tên môi trường hoặc địa chỉ dịch vụ. Secret là dữ liệu nhạy cảm như mật khẩu và khóa API. Secret có thể được đưa vào chương trình qua biến môi trường, nhưng phải được lưu trong hệ thống quản lý bí mật và không ghi vào Git hoặc nhật ký.
Cần giới hạn quyền, xoay khóa và theo dõi truy cập. Tệp .env thuận tiện khi học trên máy cá nhân nhưng không phải kho bí mật cho production. Production là môi trường đang phục vụ người dùng thật.
23. Git giúp ích gì cho Data Engineer?
Git lưu lịch sử thay đổi của mã SQL, Python, cấu hình pipeline và tài liệu. Branch tách phần đang phát triển; pull request tạo nơi đồng đội xem xét; tag đánh dấu phiên bản phát hành. Nhờ đó đội có thể biết logic doanh thu đổi khi nào, do ai và vì sao.
Không đưa dữ liệu lớn, mật khẩu hoặc tệp sinh tự động vào Git. Commit nên nhỏ, có thông điệp rõ và đi kèm test. Khả năng quay lại mã cũ không bảo đảm quay lại dữ liệu nếu phiên bản dữ liệu và tham số chạy không được lưu.
PHẦN IV — PIPELINE, ETL, ELT VÀ DATA WAREHOUSE
24. ETL và ELT khác nhau thế nào?
ETL là trích xuất, biến đổi rồi tải vào đích. ELT tải dữ liệu thô vào nền tảng đích rồi biến đổi bằng năng lực của kho dữ liệu Cloud. ETL phù hợp khi dữ liệu phải được che hoặc chuẩn hóa trước khi rời vùng tin cậy; ELT linh hoạt khi cần giữ bản gốc để tái xử lý.
Kiến trúc thực tế có thể kết hợp cả hai. Dữ liệu thẻ được loại trước khi tải, còn log website được giữ thô và xử lý nhiều cách. Lựa chọn dựa trên độ nhạy, độ tươi, khả năng kiểm toán, kỹ năng đội ngũ và chi phí.
25. Pipeline idempotent là gì?
Idempotent nghĩa là chạy lại cùng đầu vào vẫn tạo cùng kết quả mong đợi, không nhân bản dữ liệu hoặc tác dụng phụ. Ví dụ, nạp doanh thu ngày 1/9 lần thứ hai phải thay thế hoặc hợp nhất đúng phần dữ liệu của ngày đó, không cộng thêm lần nữa.
Có thể dùng khóa duy nhất, MERGE, phân vùng thay thế hoặc mã sự kiện. Cần phân biệt chạy lại một tác vụ với chạy lại cả chuỗi, và kiểm tra cả dữ liệu lẫn tác dụng phụ như gửi email. Đây là năng lực quan trọng khi phục hồi sự cố.
26. Full load và incremental load khác nhau ra sao?
Full load đọc và tải lại toàn bộ dữ liệu. Cách này đơn giản nhưng chậm và tốn chi phí khi bảng lớn. Incremental load chỉ lấy phần mới hoặc thay đổi kể từ mốc trước, nhanh hơn nhưng phải quản lý cập nhật, xóa, dữ liệu đến muộn và checkpoint.
Người học có thể bắt đầu full load để xác nhận logic rồi chuyển sang incremental. Khi thiết kế, hãy nói rõ khóa, cột thời gian, vùng nhìn lại và cách backfill, tức chạy bù dữ liệu lịch sử. Không dùng thời gian hiện tại một cách mù quáng vì bản ghi có thể được sửa muộn.
27. Change Data Capture là gì?
Change Data Capture, viết tắt CDC, ghi nhận các thao tác thêm, sửa và xóa ở hệ thống nguồn rồi truyền phần thay đổi sang đích. Đọc nhật ký giao dịch thường ít gây tải hơn quét toàn bộ bảng. CDC giúp dữ liệu gần thời gian thực và giữ thứ tự thay đổi tốt hơn.
Khó khăn gồm snapshot ban đầu, thay đổi cấu trúc, sự kiện trùng, xóa và ngắt kết nối. Đích cần áp dụng thay đổi theo khóa và thứ tự đúng. Không nên coi CDC là bản sao lưu; lỗi logic ở nguồn cũng có thể được truyền rất nhanh.
28. Data Lake, Data Warehouse và Lakehouse khác nhau thế nào?
Data Lake lưu dữ liệu thô hoặc bán cấu trúc với chi phí linh hoạt. Data Warehouse tổ chức dữ liệu có cấu trúc để truy vấn phân tích ổn định. Lakehouse kết hợp lưu trữ kiểu Data Lake với lớp bảng hỗ trợ giao dịch, cấu trúc và quản lý phiên bản.
Tên gọi không thay yêu cầu quản trị. Dù chọn nền tảng nào, dữ liệu cần owner, catalog, quyền, chất lượng và chính sách lưu giữ. Một doanh nghiệp nhỏ chỉ có báo cáo định kỳ có thể dùng Data Warehouse đơn giản thay vì xây Lakehouse phức tạp.
29. Partition và clustering dùng để làm gì?
Partition chia bảng thành các phần lớn theo cột như ngày. Clustering hoặc sắp cụm tổ chức dữ liệu theo một số cột để hệ thống bỏ qua phần không liên quan. Cả hai có thể giảm dữ liệu quét và thời gian truy vấn nếu phù hợp mẫu sử dụng.
Chia quá nhỏ tạo nhiều tệp hoặc metadata; chọn cột có quá nhiều giá trị không phải lúc nào cũng hiệu quả. Cần quan sát truy vấn thật, yêu cầu cập nhật và cách dữ liệu phân bố. Luôn lọc cột partition trong dashboard nếu muốn hưởng lợi.
30. Data quality nên kiểm tra gì?
Kiểm tra cơ bản gồm cấu trúc, kiểu dữ liệu, khóa duy nhất, giá trị rỗng, phạm vi, tính toàn vẹn khi nối, độ tươi và số lượng. Kiểm tra nghiệp vụ gồm tổng tiền, trạng thái hợp lệ, cân đối với nguồn và quan hệ giữa các chỉ số. Một pipeline chạy thành công vẫn có thể tạo số sai.
Không phải lỗi nào cũng cần dừng toàn bộ. Hãy phân mức cảnh báo, xác định owner và tài sản bị ảnh hưởng. Ngưỡng phải dựa vào biến động bình thường; ngưỡng cứng có thể gây quá nhiều cảnh báo rồi bị bỏ qua.
31. Data lineage là gì?
Data lineage, hay dòng dõi dữ liệu, cho biết một cột hoặc chỉ số đến từ nguồn nào, qua phép biến đổi nào và được dùng ở đâu. Khi doanh thu trên dashboard sai, lineage giúp lần ngược về bảng, tác vụ và phiên bản mã liên quan.
Lineage tự động từ công cụ rất hữu ích nhưng không hiểu hết ý nghĩa nghiệp vụ. Đội vẫn cần mô tả định nghĩa, owner và lý do thay đổi. Lineage cũng hỗ trợ đánh giá tác động trước khi xóa hoặc đổi một cột.
32. Schema evolution xử lý thế nào?
Schema evolution là việc cấu trúc dữ liệu thay đổi theo thời gian: thêm cột, đổi kiểu, đổi tên hoặc bỏ cột. Thêm cột tùy chọn thường ít rủi ro hơn đổi kiểu hoặc ý nghĩa. Pipeline cần kiểm tra hợp đồng dữ liệu, cảnh báo và có khoảng chuyển tiếp cho bên sử dụng.
Không nên tự động chấp nhận mọi thay đổi. Có thể lưu dữ liệu lỗi vào vùng cách ly, hỗ trợ hai phiên bản trong thời gian ngắn và chạy kiểm thử tương thích. Chủ dữ liệu nguồn phải thông báo lịch đổi và người dùng hạ nguồn cần biết tác động.
33. Làm sao đối soát dữ liệu nguồn và đích?
Đếm số dòng là điểm bắt đầu nhưng chưa đủ vì lỗi nối có thể vừa tăng vừa giảm. Cần so tổng tiền, số khóa duy nhất, phân phối theo ngày hoặc đơn vị, giá trị nhỏ nhất–lớn nhất và một mẫu bản ghi theo khóa. Với dữ liệu thay đổi, phải so cùng thời điểm hoặc snapshot.
Ngưỡng sai lệch cần người nghiệp vụ chấp nhận. Kết quả đối soát nên được lưu để kiểm toán, không chỉ in trên màn hình. Khi sai, hệ thống phải chỉ ra phạm vi và cho phép chạy bù có kiểm soát.
PHẦN V — AIRFLOW, DOCKER VÀ KIỂM THỬ
34. Airflow dùng để làm gì?
Apache Airflow điều phối các tác vụ theo một đồ thị phụ thuộc có hướng. Nó lên lịch, theo dõi trạng thái, thử lại và cho phép vận hành lại theo khoảng thời gian. Airflow không phải công cụ xử lý dữ liệu chính; tác vụ nên gọi SQL, Spark hoặc dịch vụ khác thay vì kéo dữ liệu lớn qua bộ nhớ của Airflow.
DAG là định nghĩa chuỗi phụ thuộc. Một DAG tốt có tác vụ đủ nhỏ để quan sát nhưng không vụn, có thời gian chờ, số lần thử lại hợp lý, cảnh báo và khả năng chạy lại. Mã DAG cũng cần được lưu trên Git, phản biện và kiểm thử.
35. Catchup và backfill trong Airflow là gì?
Catchup cho phép scheduler tạo các lần chạy còn thiếu theo lịch kể từ ngày bắt đầu. Backfill là chạy lại dữ liệu cho một khoảng quá khứ, thường có chủ đích khi sửa logic hoặc bổ sung lịch sử. Hai khái niệm liên quan nhưng không hoàn toàn giống nhau.
Pipeline phải dùng khoảng dữ liệu của lần chạy thay vì lấy “hôm nay”, nếu không backfill sẽ tạo sai. Trước khi chạy bù nhiều ngày, cần ước tính tải lên nguồn, đích và chi phí, đồng thời xác định cách xử lý dữ liệu đã tồn tại.
36. Docker giải quyết vấn đề gì?
Docker đóng gói ứng dụng cùng thư viện và cấu hình hệ thống cần thiết thành image, giúp môi trường phát triển, kiểm thử và triển khai nhất quán hơn. Container là phiên bản đang chạy từ image. Nó giảm tình trạng “máy tôi chạy được” nhưng không tự bảo đảm bảo mật hoặc độ tin cậy.
Image nên nhỏ, cố định phiên bản, không chứa secret và chạy bằng người dùng ít quyền. Dữ liệu lâu dài không nên chỉ nằm trong lớp ghi tạm của container. Cần quét lỗ hổng và cập nhật image nền.
37. Unit test, integration test và data test khác nhau thế nào?
Unit test kiểm tra một hàm hoặc quy tắc nhỏ trong điều kiện cô lập. Integration test kiểm tra nhiều thành phần kết nối thật hoặc gần thật. Data test kiểm tra đặc tính của dữ liệu như khóa, NULL, quan hệ và ngưỡng nghiệp vụ.
Một pipeline đáng tin cậy cần cả ba lớp. Unit test không phát hiện quyền Cloud sai; integration test không bảo đảm doanh thu đúng; data test sau chạy không thay kiểm tra mã. Bộ test nên chạy nhanh ở pull request và có bộ đầy đủ trước khi phát hành.
38. CI/CD cho pipeline dữ liệu là gì?
CI là tích hợp liên tục: mỗi thay đổi được tự động kiểm tra định dạng, test và quy tắc an toàn. CD là chuyển giao hoặc triển khai liên tục qua các môi trường. Mục tiêu là giảm thay đổi thủ công khó truy vết và phát hiện lỗi trước production.
Pipeline dữ liệu cần thêm so sánh cấu trúc, kế hoạch SQL, mẫu kết quả và migration. Triển khai mã mới không đồng nghĩa dữ liệu cũ tự phù hợp. Vì vậy cần kế hoạch chạy bù, kiểm tra song song và khả năng quay lại.
PHẦN VI — CLOUD, BẢO MẬT VÀ CHI PHÍ
39. Khi nào nên dùng dịch vụ được quản lý trên Cloud?
Dịch vụ được quản lý giúp giảm việc cài đặt, nâng cấp, sao lưu và mở rộng hạ tầng. Nó phù hợp khi doanh nghiệp muốn đội tập trung vào dữ liệu và chấp nhận cách vận hành của nhà cung cấp. Đổi lại là chi phí, giới hạn cấu hình và nguy cơ phụ thuộc nền tảng.
Hãy so tổng chi phí sở hữu, gồm nhân lực trực vận hành, thời gian khắc phục và cơ hội bị chậm, không chỉ giá máy chủ. Dữ liệu nhạy cảm và quy định vị trí lưu trữ cũng ảnh hưởng lựa chọn.
40. Nguyên tắc least privilege là gì?
Least privilege, hay đặc quyền tối thiểu, nghĩa là mỗi người hoặc dịch vụ chỉ có đúng quyền cần thiết trong đúng thời gian cần thiết. Pipeline chỉ đọc bảng nguồn liên quan và ghi vào vùng đích của nó, không dùng tài khoản quản trị chung.
Cần tách danh tính theo dịch vụ, quản lý bằng nhóm, ghi nhật ký truy cập và xem xét quyền định kỳ. Khi xảy ra lộ khóa hoặc lỗi chương trình, phạm vi thiệt hại sẽ nhỏ hơn. Quyền quá chặt nhưng không có quy trình cấp nhanh cũng làm đội tìm cách lách, nên quản trị phải thực dụng.
41. Mã hóa khi truyền và khi lưu là gì?
Mã hóa khi truyền bảo vệ dữ liệu trên đường mạng, thường bằng TLS. Mã hóa khi lưu bảo vệ dữ liệu trên đĩa, bản sao và backup. Hai lớp giải quyết các rủi ro khác nhau và không thay thế phân quyền.
Khóa mã hóa cần được quản lý, xoay và giới hạn người sử dụng. Nếu ứng dụng đã được cấp quyền đọc, mã hóa không ngăn nó đọc dữ liệu. Với trường đặc biệt nhạy cảm, có thể dùng token hóa hoặc che dữ liệu trước khi phân tích.
42. Làm sao kiểm soát chi phí Data Platform?
Trước hết gắn chi phí với workload, dự án và phòng ban bằng nhãn hoặc tài khoản tách biệt. Theo dõi dữ liệu quét, thời gian tính toán, lưu trữ, truyền dữ liệu và các lần chạy lại. Thiết lập ngân sách, cảnh báo và quota để phát hiện bất thường sớm.
Về kỹ thuật, dùng partition, định dạng cột, vòng đời lưu trữ, kích thước cụm phù hợp và tự dừng tài nguyên nhàn rỗi. Không tối ưu tới mức làm dữ liệu chậm hoặc khó dùng; chi phí cần được so với giá trị và SLA của từng use case.
PHẦN VII — SPARK, KAFKA VÀ XỬ LÝ QUY MÔ LỚN
43. Khi nào cần Apache Spark?
Spark là công cụ xử lý phân tán, phù hợp khi dữ liệu hoặc phép tính không thể xử lý hiệu quả trên một máy và cần mở rộng qua nhiều máy. Nó hỗ trợ batch, SQL và streaming. Với vài triệu dòng trong một kho dữ liệu mạnh, SQL hoặc Python theo từng phần có thể đơn giản hơn.
Câu trả lời tốt bắt đầu từ khối lượng, thời gian và loại xử lý, không từ mong muốn dùng Big Data. Spark thêm chi phí khởi động, xáo trộn dữ liệu, cấu hình và vận hành. Chỉ chọn khi lợi ích lớn hơn độ phức tạp.
44. Partition trong Spark ảnh hưởng thế nào?
Partition là đơn vị dữ liệu được xử lý song song. Quá ít partition làm một số máy nhàn rỗi; quá nhiều tạo chi phí lập lịch và nhiều tệp nhỏ. Partition lệch, khi một khóa chứa phần lớn dữ liệu, làm một tác vụ chậm hơn hẳn các tác vụ khác.
Cần xem kích thước, phân phối khóa và kế hoạch thực thi. Có thể repartition trước phép nối lớn, xử lý khóa lệch hoặc broadcast bảng nhỏ. Mọi thay đổi phải được đo vì tăng song song không luôn làm nhanh hơn.
45. Shuffle là gì và vì sao đắt?
Shuffle xảy ra khi Spark phải chuyển dữ liệu giữa các máy để nhóm, nối hoặc sắp xếp theo khóa. Hoạt động này tốn mạng, đĩa, bộ nhớ và dễ tạo nút thắt. GROUP BY và JOIN lớn thường gây shuffle.
Giảm shuffle bằng cách lọc sớm, chọn cột cần thiết, broadcast bảng nhỏ hoặc tổ chức partition phù hợp. Không nên né mọi shuffle vì nhiều phép tính bắt buộc cần nó. Mục tiêu là hiểu và kiểm soát thay vì tối ưu mù quáng.
46. Kafka topic, partition và consumer group là gì?
Topic là luồng sự kiện được đặt tên. Partition chia topic thành nhiều phần để tăng thông lượng; thứ tự chỉ được bảo đảm trong từng partition. Consumer group là nhóm thành phần đọc chia nhau các partition, nhờ đó mở rộng xử lý.
Khóa sự kiện quyết định partition và ảnh hưởng cả thứ tự lẫn cân bằng tải. Nếu mọi sự kiện của một khách cần đúng thứ tự, có thể dùng customer_id làm khóa. Cần cân nhắc một khách quá lớn gây lệch tải.
47. At-most-once, at-least-once và exactly-once là gì?
At-most-once có thể mất sự kiện nhưng không xử lý lặp. At-least-once bảo đảm sự kiện được xử lý ít nhất một lần nhưng có thể lặp. Exactly-once hướng tới hiệu ứng cuối cùng như chỉ xử lý một lần, đòi hỏi phối hợp giữa đọc, xử lý và ghi.
Trong thực tế, at-least-once kết hợp đích idempotent thường dễ vận hành. “Exactly-once” của một công cụ không tự bảo đảm toàn bộ hệ thống đầu cuối. Hãy xác định đơn vị giao dịch, mã sự kiện và hành vi khi retry.
PHẦN VIII — THIẾT KẾ HỆ THỐNG VÀ VẬN HÀNH
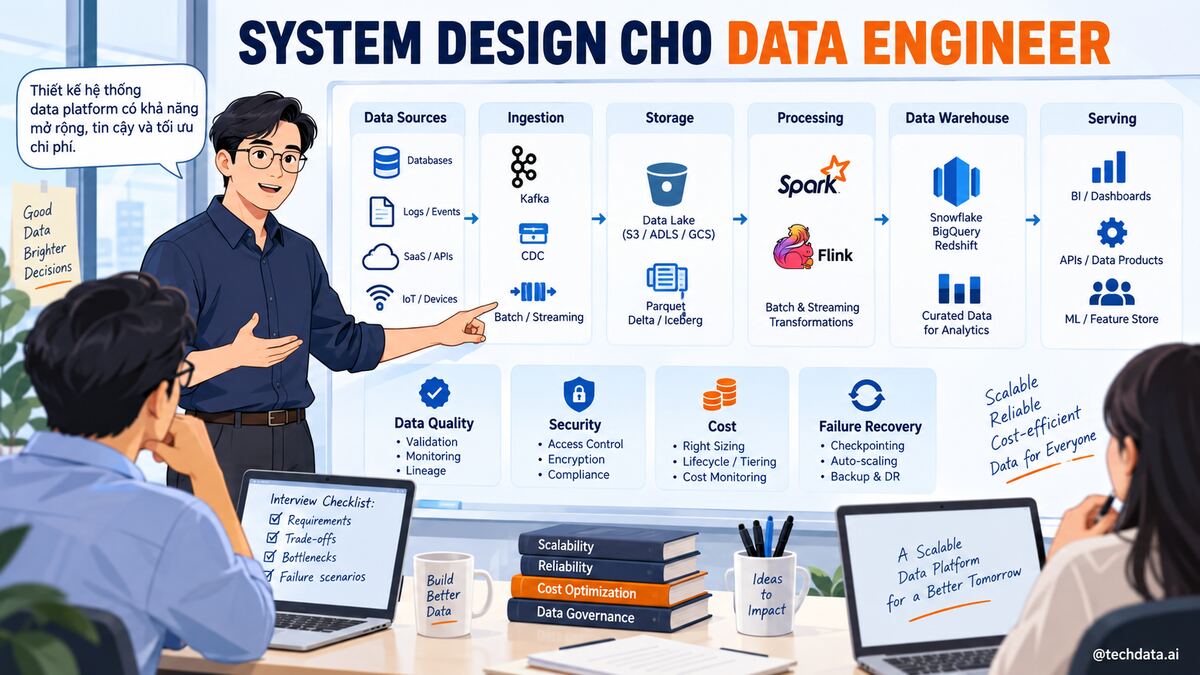
Ở cấp Middle và Senior, câu hỏi thường không có một đáp án duy nhất. Người phỏng vấn quan sát cách ứng viên làm rõ yêu cầu, chia hệ thống thành phần nhỏ và cân bằng độ tươi, độ đúng, chi phí cùng khả năng vận hành. Một sơ đồ đẹp nhưng thiếu cách kiểm tra và phục hồi vẫn là thiết kế chưa hoàn chỉnh.
48. Hãy thiết kế pipeline doanh thu cho chuỗi 100 cửa hàng
Trước tiên làm rõ nguồn POS, website, ERP; định nghĩa doanh thu; độ trễ; khối lượng; dữ liệu đến muộn và người dùng. Có thể lấy thay đổi từ nguồn, lưu vùng raw bất biến, chuẩn hóa mã sản phẩm–cửa hàng, tạo fact doanh thu ở mức dòng đơn và bảng tổng hợp cho dashboard.
Thiết kế phải có kiểm tra số đơn, tổng tiền, khóa và độ tươi; đối soát với báo cáo nguồn; phân quyền theo vai trò; lineage; cảnh báo và chạy bù. Batch mỗi 15 phút có thể đủ thay vì streaming. Người phỏng vấn quan tâm cách cân bằng độ tin cậy, chi phí và độ phức tạp hơn một sơ đồ nhiều dịch vụ.
49. Xử lý sự cố dashboard doanh thu giảm 40% thế nào?
Đầu tiên xác nhận phạm vi, thời điểm và liệu biến động có thật về kinh doanh hay là lỗi dữ liệu. Kiểm tra độ tươi nguồn, số dòng từng bước, thay đổi cấu trúc, phép nối, lịch chạy và đợt triển khai gần nhất. So với một nguồn độc lập hoặc mẫu giao dịch để khoanh vùng.
Nếu số sai ảnh hưởng quyết định, thông báo người dùng và đánh dấu dashboard trước khi sửa. Sau phục hồi, chạy bù, đối soát và ghi biên bản nguyên nhân. Hành động phòng ngừa có thể là test khối lượng, hợp đồng dữ liệu hoặc cảnh báo sớm hơn; không dừng ở việc chạy lại tác vụ.
PHẦN IX — CÂU HỎI HÀNH VI VÀ CẤP SENIOR
Năng lực Senior không chỉ được đo bằng quy mô hệ thống từng sử dụng. Doanh nghiệp cần người biết ưu tiên, giao tiếp rủi ro, hướng dẫn đồng đội và thay đổi quyết định khi có bằng chứng mới. Câu hỏi hành vi vì vậy phải được trả lời bằng tình huống thật, hành động cụ thể và kết quả có thể kiểm chứng.
50. Hãy kể về một quyết định kỹ thuật không thành công
Nhà tuyển dụng không tìm một người chưa từng sai. Họ muốn thấy khả năng nhận trách nhiệm, đo tác động, sửa hệ thống và thay đổi cách làm. Hãy dùng cấu trúc bối cảnh, mục tiêu, hành động, kết quả và bài học; nói rõ phần mình chịu trách nhiệm mà không đổ lỗi.
Ví dụ, đội chọn streaming cho dashboard theo giờ, khiến chi phí và sự cố tăng. Sau khi đo nhu cầu, ứng viên đề xuất micro-batch 15 phút, đơn giản hóa vận hành và bổ sung bước đánh giá SLA trước thiết kế. Một câu chuyện có số liệu, đánh đổi và thay đổi quy trình đáng tin hơn câu “điểm yếu của tôi là quá cầu toàn”.
PHẦN X — KẾ HOẠCH ÔN TẬP VÀ ỨNG TUYỂN
Biến 50 câu hỏi thành năng lực như thế nào?
Không nên học thuộc cả bài. Hãy tạo một bảng ba cột: câu hỏi, ví dụ dự án của bản thân và phần còn yếu. Mỗi ngày chọn năm câu, trả lời thành tiếng trong hai phút rồi tự hỏi thêm về lỗi, bảo mật, chi phí và khả năng chạy lại. Nếu câu trả lời không gắn được với dữ liệu cụ thể, kiến thức vẫn còn hời hợt.
Với câu SQL và Python, cần thực hành trên dữ liệu thật hoặc dữ liệu giả lập đủ có lỗi. Với câu kiến trúc, vẽ sơ đồ nhỏ và ghi rõ giả định. Với câu hành vi, chuẩn bị bốn câu chuyện về học nhanh, xử lý lỗi, bất đồng và cải tiến.
Kế hoạch ôn tập bốn tuần
Tuần đầu tập trung SQL, mô hình dữ liệu và một dự án batch hoàn chỉnh. Tuần hai ôn Python, Linux, Git, Docker, Airflow và kiểm thử. Tuần ba học Cloud, bảo mật, chi phí, Spark và Kafka ở mức hiểu nguyên lý. Tuần bốn dành cho thiết kế hệ thống, phỏng vấn thử và sửa Portfolio.
Mỗi tuần cần một đầu ra nhìn thấy được: truy vấn có test, kho GitHub có hướng dẫn chạy, sơ đồ có lý do lựa chọn và bản ghi buổi trả lời thử. Không học thêm công cụ mới ở những ngày cuối nếu nền tảng chưa vững.
Khi nào nên bắt đầu ứng tuyển?
Ứng viên Junior không cần biết hết mọi công nghệ trong mô tả việc làm. Có thể bắt đầu khi đã dùng SQL và Python để hoàn thành ít nhất hai dự án, hiểu một pipeline đầu cuối, có thể giải thích lỗi và biết nền tảng Cloud cơ bản. Ứng tuyển cũng là cách nhận phản hồi về thị trường.
Tuy nhiên, không nên nộp hàng loạt một CV chung. Đọc yêu cầu, chọn dự án liên quan và điều chỉnh phần mô tả bằng kết quả đo được. Nếu vị trí dùng Azure nhưng dự án dùng AWS, hãy chỉ ra khái niệm tương ứng và kế hoạch chuyển đổi thay vì tự loại mình.
Khóa học và người hướng dẫn giúp ở đâu?
Khóa học có cấu trúc giúp giảm thời gian chọn tài liệu, tạo thứ tự học và cung cấp bài tập gần công việc. Mentor, tức người hướng dẫn có kinh nghiệm, hữu ích nhất khi phản biện thiết kế, chỉ ra lỗi vận hành và buộc người học tự bảo vệ lựa chọn. Giá trị không nằm ở số video hoặc số công cụ ghi trên quảng cáo.
Người học nên xem chương trình có dự án đầu cuối, phản biện mã, tiêu chí đánh giá, hỗ trợ sửa lỗi và đầu ra Portfolio hay không. Trang chương trình Data Engineer của TechData.AI có thể được dùng để đối chiếu lộ trình với năng lực đang thiếu, trước khi quyết định tự học hay tham gia đào tạo.
Một buổi phỏng vấn giả định từ Junior đến Senior
Giả sử doanh nghiệp bán lẻ cần báo cáo doanh thu từ 100 cửa hàng trước 8 giờ sáng. Ứng viên Junior được hỏi cách nối bảng đơn hàng với thanh toán. Câu trả lời cần xác định khóa, dùng LEFT JOIN nếu muốn giữ đơn chưa thanh toán, rồi kiểm tra số dòng và tổng tiền để tránh nhân bản.
Ứng viên Middle được hỏi cách xây pipeline. Người này đề xuất lấy dữ liệu tăng dần, lưu raw, chuẩn hóa mã, tạo fact doanh thu, kiểm tra độ tươi và đối soát theo cửa hàng. Khi tác vụ lỗi, pipeline có thể chạy lại theo ngày mà không tạo trùng. Câu trả lời đã mở rộng từ truy vấn sang vận hành.
Ứng viên Senior được hỏi liệu có nên dùng streaming. Người này làm rõ dashboard chỉ cần trước 8 giờ, trong khi cảnh báo gian lận mới cần vài phút. Senior chọn batch cho báo cáo tài chính, dành streaming cho sự kiện rủi ro, đồng thời nêu chi phí, quyền, SLA, owner và quy trình sự cố. Điểm khác biệt không nằm ở việc biết thêm tên công cụ mà ở khả năng đặt đúng câu hỏi và chịu trách nhiệm cho hệ thống.
Những lỗi phổ biến khi phỏng vấn Data Engineer
Lỗi đầu tiên là trả lời bằng tên công nghệ. “Dùng Kafka, Spark và Kubernetes” không cho biết dữ liệu nào, vì sao cần thời gian thực hoặc ai vận hành. Lỗi thứ hai là chỉ nói trường hợp thuận lợi, không nhắc dữ liệu trùng, đến muộn, thay cấu trúc và chạy lại.
Lỗi thứ ba là bỏ qua nghiệp vụ. Pipeline nhanh nhưng định nghĩa doanh thu sai vẫn thất bại. Lỗi thứ tư là dùng thuật ngữ nhưng không giải thích được bằng ví dụ. Nếu không thể nói partition hay idempotent bằng ngôn ngữ đơn giản, kiến thức có thể mới dừng ở mức ghi nhớ.
Cuối cùng, nhiều ứng viên cố che phần chưa biết. Một câu trả lời trung thực như “chưa vận hành Kafka trong production, nhưng đã mô phỏng và hiểu các rủi ro về thứ tự, trùng và checkpoint” đáng tin hơn kinh nghiệm phóng đại. Sau đó cần trình bày cách kiểm chứng trước khi áp dụng.
Tài liệu tham khảo
- PostgreSQL Documentation — Queries
- Python Documentation — Tutorial
- Git Documentation
- Apache Airflow Documentation — Core Concepts
- Docker Documentation — Get Started
- Apache Spark Documentation
- Apache Kafka Documentation
- Google Cloud Architecture Framework
- AWS Well-Architected Framework
- Microsoft Azure Architecture Center
Kết luận
Năm mươi câu hỏi phỏng vấn Data Engineer chỉ có giá trị khi giúp ứng viên kết nối nền tảng với một hệ thống cụ thể. SQL đúng là điều kiện cần; năng lực thật còn nằm ở mô hình dữ liệu, chất lượng, bảo mật, chi phí, khả năng phục hồi và cách phối hợp với nghiệp vụ.
Đừng cố tạo cảm giác biết mọi công cụ. Hãy chứng minh rằng có thể làm rõ yêu cầu, chọn phương án vừa đủ, đo kết quả và nhận trách nhiệm khi dữ liệu sai. Một câu trả lời có giả định, ví dụ và giới hạn luôn thuyết phục hơn một định nghĩa thuộc lòng.
Câu hỏi nên bắt đầu trước buổi phỏng vấn không phải “nhà tuyển dụng sẽ hỏi công nghệ nào”, mà là: “Dự án nào chứng minh rõ nhất rằng mình có thể đưa dữ liệu từ nguồn tới quyết định một cách đáng tin cậy?”. Khi trả lời được bằng sản phẩm do chính mình xây và bảo vệ được, người học đã có nền tảng để bước vào nghề.
TechData.AI - Leading the Future.
Tham khảo khoá học theo link: https://techdata.ai/data-engineer/
Hoàng Minh.