




Data Warehouse, Data Lake và Data Lakehouse: Doanh nghiệp nên chọn kiến trúc nào?
Data Warehouse, Data Lake và Data Lakehouse thường được giới thiệu như ba thế hệ công nghệ cạnh tranh nhau. Cách nhìn này dễ dẫn tới quyết định cực đoan: doanh nghiệp bỏ kiến trúc đang hoạt động để chạy theo Lakehouse, hoặc giữ Warehouse cho mọi loại dữ liệu dù nhu cầu đã thay đổi. Thực tế, ba khái niệm giải quyết những ưu tiên khác nhau và có thể cùng tồn tại.
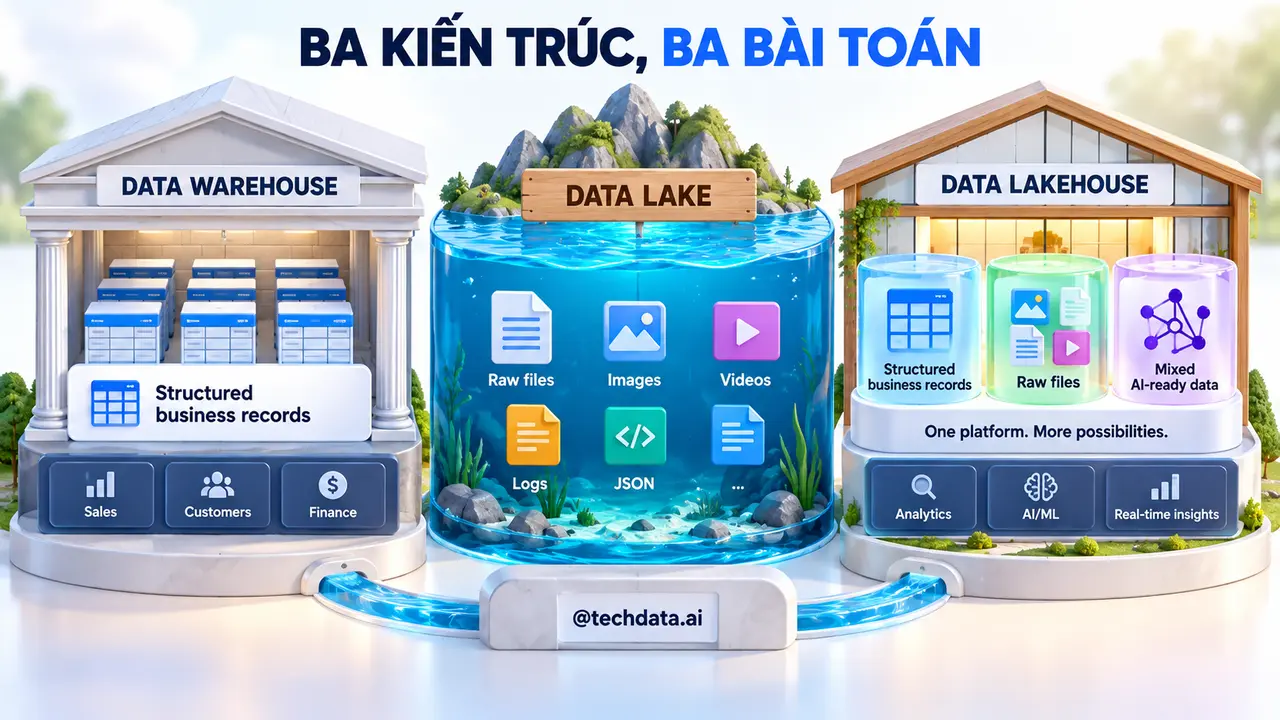
Data Warehouse tổ chức dữ liệu có cấu trúc cho báo cáo và phân tích ổn định. Data Lake lưu nhiều loại dữ liệu ở trạng thái gần nguồn với chi phí linh hoạt. Data Lakehouse bổ sung lớp quản lý bảng, giao dịch và hiệu năng lên lưu trữ kiểu Lake để phục vụ cả BI, khoa học dữ liệu và AI tốt hơn.
Tên kiến trúc không tự tạo giá trị. Một Data Lake thiếu catalog, owner và chất lượng dễ trở thành “data swamp”, tức đầm lầy dữ liệu không ai tìm hoặc tin. Một Warehouse có hàng nghìn bảng nhưng mỗi dashboard tính khác nhau cũng thất bại. Lakehouse hiện đại vẫn cần mô hình dữ liệu và governance.
Bài viết so sánh ba kiến trúc theo loại dữ liệu, workload, người dùng, chi phí, kỹ năng và rủi ro. Phần cuối đưa ra cây quyết định thực dụng để doanh nghiệp chọn kiến trúc tối thiểu đủ dùng, thay vì chọn theo xu hướng.
Mục lục
- PHẦN I — Ba kiến trúc thực chất là gì?
- PHẦN II — So sánh trên cùng một bộ tiêu chí
- PHẦN III — Workload phù hợp với từng kiến trúc
- PHẦN IV — Vì sao kiến trúc thường được kết hợp?
- PHẦN V — Data Quality, Governance và Security
- PHẦN VI — Chi phí và năng lực đội ngũ
- PHẦN VII — AI ảnh hưởng lựa chọn thế nào?
- PHẦN VIII — Cây quyết định và roadmap 90 ngày
- PHẦN IX — Case tổng thể
PHẦN I — BA KIẾN TRÚC THỰC CHẤT LÀ GÌ?
1. Data Warehouse
Data Warehouse, hay kho dữ liệu, tập trung dữ liệu từ nhiều hệ thống, chuẩn hóa và tổ chức để báo cáo. Nó thường có bảng fact chứa sự kiện và dimension chứa ngữ cảnh, hoặc một mô hình lõi khác rồi tạo data mart theo phòng ban. Người dùng nhận dữ liệu đã được kiểm soát thay vì tự xử lý raw.
Warehouse mạnh ở SQL, mô hình chỉ số, hiệu năng BI và quản trị dữ liệu có cấu trúc. Đổi lại, việc đưa loại dữ liệu mới vào thường cần thiết kế và biến đổi trước khi người dùng khai thác ổn định.
2. Data Lake
Data Lake là vùng lưu trữ có thể giữ file, log, ảnh, văn bản, dữ liệu bán cấu trúc và bảng với quy mô lớn. Dữ liệu có thể được lưu gần bản nguồn rồi xử lý theo nhiều mục đích. Chi phí lưu trữ đối tượng thường linh hoạt hơn hệ thống phân tích truyền thống.
Lake phù hợp cho khám phá, khoa học dữ liệu, lưu raw và tái xử lý. Tuy nhiên, nếu chỉ đổ dữ liệu mà không có catalog, cấu trúc, quyền và vòng đời, người dùng không biết dữ liệu nào đúng. Khả năng lưu mọi thứ không phải lý do để giữ mọi thứ.
3. Data Lakehouse
Data Lakehouse là cách kết hợp lưu trữ kiểu Data Lake với lớp bảng hỗ trợ cấu trúc, giao dịch, quản lý phiên bản và tối ưu truy vấn. Mục tiêu là để BI, Data Science và AI sử dụng cùng một nền tảng dữ liệu tốt hơn, giảm việc sao chép giữa Lake và Warehouse.
Các định dạng bảng mở và nền tảng Lakehouse có thể hỗ trợ cập nhật, kiểm soát cấu trúc và time travel, tức truy cập phiên bản dữ liệu trước. Nhưng Lakehouse không tự tạo định nghĩa doanh thu, data mart hay trải nghiệm tốt cho người nghiệp vụ. Những phần đó vẫn phải được thiết kế.
4. Ba khái niệm không hoàn toàn loại trừ nhau
Một Cloud Data Warehouse có thể đọc dữ liệu trên lưu trữ đối tượng. Một Lakehouse có thể cung cấp SQL Warehouse cho BI. Một doanh nghiệp có thể giữ raw ở Lake và bảng quản trị ở Warehouse. Biên giới sản phẩm ngày càng giao nhau.
Vì vậy, không nên chọn chỉ theo nhãn. Hãy mô tả năng lực cần có: lưu loại dữ liệu nào, ai dùng, cần giao dịch bảng không, độ trễ bao nhiêu, định nghĩa ra sao và ai vận hành.
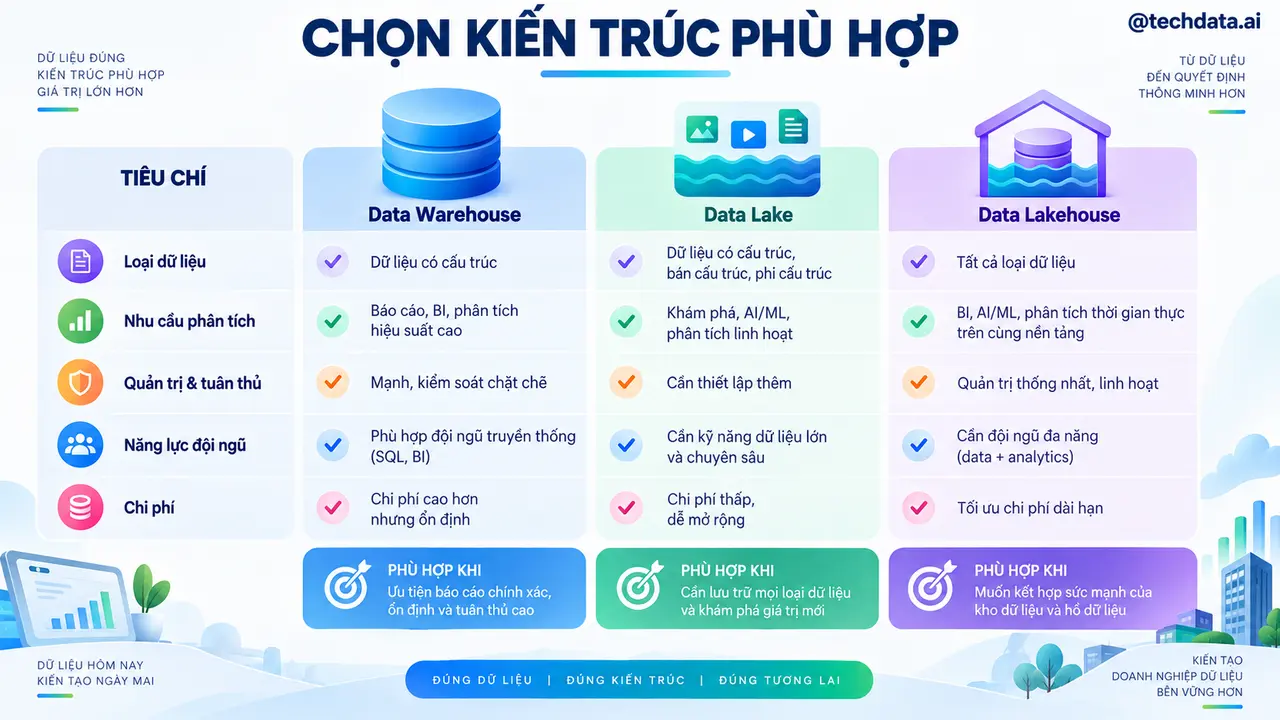
PHẦN II — SO SÁNH TRÊN CÙNG MỘT BỘ TIÊU CHÍ
5. Bảng so sánh tổng quan
| Tiêu chí | Data Warehouse | Data Lake | Data Lakehouse |
|---|---|---|---|
| Dữ liệu chính | Có cấu trúc, đã chuẩn hóa | Mọi loại, thường gần nguồn | Có cấu trúc và bán cấu trúc trên Lake |
| Người dùng | BI, Analyst, quản lý | Engineer, Data Scientist | BI, Engineer, Data Scientist, AI |
| Điểm mạnh | SQL, báo cáo, định nghĩa ổn định | Lưu raw, linh hoạt, quy mô | Hợp nhất workload, quản lý bảng tốt hơn |
| Thách thức | Schema và biến đổi cần thiết kế | Dễ thành data swamp | Vận hành và tối ưu phức tạp |
| Quản trị | Thường trưởng thành cho BI | Phải bổ sung mạnh | Có công cụ nhưng vẫn cần quy trình |
| Chi phí | Theo lưu trữ và tính toán phân tích | Lưu rẻ hơn, xử lý tính riêng | Linh hoạt nhưng có nhiều lớp chi phí |
Bảng không thay thử nghiệm. Một truy vấn BI lặp lại có thể chạy tốt ở Warehouse; một tác vụ xử lý tệp lớn có thể hợp Lakehouse; lưu raw ở Lake có thể rẻ nhưng chi phí tìm, làm sạch và vận hành lại cao.
6. Schema-on-write và schema-on-read
Schema-on-write nghĩa là cấu trúc được kiểm soát trước hoặc trong lúc ghi vào lớp phục vụ. Đây là cách thường gắn với Warehouse. Schema-on-read nghĩa là cấu trúc được áp khi đọc, tạo linh hoạt cho raw trong Lake.
Lakehouse đưa hai cách lại gần nhau: raw có thể linh hoạt, còn bảng được quản lý có cấu trúc và kiểm soát thay đổi. Không nên hiểu schema-on-read là không cần cấu trúc; cấu trúc chỉ được quyết định muộn hơn và vẫn phải chịu trách nhiệm.
7. Hiệu năng BI
Warehouse được tối ưu cho truy vấn SQL tổng hợp, mô hình đồng thời và công cụ BI. Cache, định dạng cột, partition và cơ chế quản lý workload giúp dashboard ổn định. Lake thuần túy có thể cần engine truy vấn và tối ưu file để đạt trải nghiệm tương tự.
Lakehouse cải thiện bằng metadata bảng, thống kê, sắp xếp và SQL endpoint. Nhưng hiệu năng vẫn phụ thuộc thiết kế bảng, kích thước file và số người dùng. Một kiến trúc linh hoạt không miễn trừ tối ưu.
8. Hỗ trợ dữ liệu phi cấu trúc
Ảnh, âm thanh, log và tài liệu không phù hợp với mô hình hàng–cột truyền thống. Data Lake là nơi lưu tự nhiên hơn. Metadata và kết quả trích xuất có thể được đưa vào Warehouse để phân tích.
Lakehouse phù hợp khi xử lý dữ liệu này cùng bảng và mô hình AI trên một nền tảng. Tuy nhiên, người dùng BI không cần truy cập toàn bộ file gốc. Quyền và lớp phục vụ phải tách theo mục đích.
PHẦN III — WORKLOAD PHÙ HỢP VỚI TỪNG KIẾN TRÚC
9. Báo cáo tài chính và quản trị
Các báo cáo cần định nghĩa ổn định, lịch chốt, đối soát và khả năng kiểm toán. Data Warehouse thường là lựa chọn tự nhiên vì mô hình quan hệ và SQL dễ quản lý. Lakehouse cũng có thể đáp ứng nếu lớp bảng và quy trình đủ trưởng thành.
Không nên cho báo cáo tài chính đọc trực tiếp dữ liệu raw. Dữ liệu phải qua kiểm tra, xử lý kỳ kế toán và phê duyệt. Nền tảng nào cũng cần lớp “gold” hoặc serving rõ.
10. Lưu lịch sử nguồn và tái xử lý
Data Lake mạnh ở lưu bản nguồn dài hạn với định dạng phù hợp, giúp tái xử lý khi logic thay đổi. Ví dụ, doanh nghiệp có thể tính lại phân khúc khách từ log giao dịch mà không trích lại ERP. Warehouse Cloud cũng có thể giữ raw, nhưng cần so chi phí và cách truy cập.
Retention phải được áp dụng. Raw có dữ liệu cá nhân không nên giữ vô hạn chỉ vì “sau này AI có thể cần”. Mục đích, thời hạn và quyền phải rõ.
11. Data Science và Machine Learning
Data Scientist cần thử nhiều loại dữ liệu, thư viện và đặc trưng. Lake hoặc Lakehouse thường linh hoạt cho notebook, Spark và huấn luyện. Warehouse vẫn hữu ích để cung cấp dữ liệu có cấu trúc, mẫu nhãn và chỉ số đã chuẩn.
Kiến trúc hiệu quả nối hai phía: dữ liệu chuẩn từ Warehouse, tệp và lịch sử ở Lake, feature có phiên bản và lớp phục vụ mô hình. Không sao chép thiếu kiểm soát giữa môi trường.
12. Streaming và dữ liệu gần thời gian thực
Cả ba kiến trúc có thể nhận dữ liệu streaming qua dịch vụ bổ sung. Câu hỏi là cần độ trễ nào và trạng thái tạm được thể hiện ra sao. Dữ liệu click vài phút có thể vào Lakehouse; báo cáo tài chính vẫn cần bước chốt trong Warehouse.
Sự kiện có thể đến trùng, muộn hoặc sai thứ tự. Kiến trúc phải dùng mã sự kiện, thời điểm phát sinh, checkpoint và cách hợp nhất. “Real-time” không chỉ là tốc độ ingest.
13. Data sharing
Doanh nghiệp có thể chia sẻ dữ liệu với đối tác hoặc công ty con qua bảng, file hoặc cơ chế chia sẻ không sao chép. Warehouse thuận lợi cho tập dữ liệu có cấu trúc; Lakehouse có thể chia sẻ bảng mở và file lớn.
Trước khi chia sẻ, cần hợp đồng dữ liệu, phân loại, thời hạn và quyền thu hồi. Công nghệ không quyết định dữ liệu nào được phép ra ngoài.
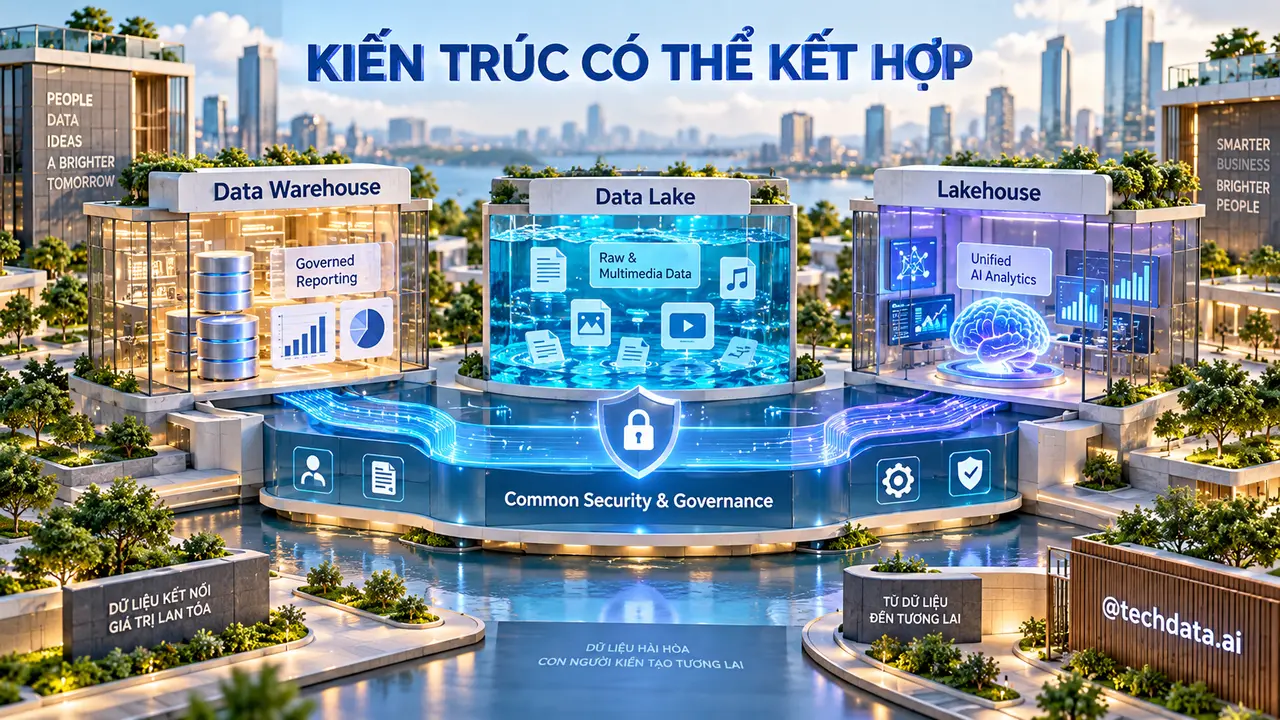
PHẦN IV — VÌ SAO KIẾN TRÚC THƯỜNG ĐƯỢC KẾT HỢP?
14. Mô hình Lake cộng Warehouse
Raw, log và tệp được lưu ở Lake; dữ liệu đã chuẩn hóa và mô hình hóa được đưa vào Warehouse cho BI. Cách này tách linh hoạt lưu trữ khỏi trải nghiệm báo cáo. Nó phổ biến vì mỗi lớp làm đúng điểm mạnh.
Nhược điểm là sao chép, độ trễ và hai hệ thống quyền. Data Lineage phải nối được từ dashboard qua Warehouse về Lake và nguồn. Nếu đội nhỏ, kiến trúc có thể quá nặng.
15. Warehouse đọc trực tiếp Lake
Nhiều nền tảng Cloud cho phép Warehouse truy vấn file trên object storage. Đội có thể giữ raw ở Lake và chỉ vật chất hóa bảng dùng thường xuyên. Điều này giảm một số lần sao chép nhưng hiệu năng và chi phí cần được đo.
Không nên để mọi dashboard đọc file raw. Bảng phục vụ cần schema, test và owner. Khả năng kỹ thuật không thay nguyên tắc dữ liệu.
16. Lakehouse với các lớp bronze, silver, gold
Bronze giữ gần nguồn, silver làm sạch và tích hợp, gold phục vụ use case. Cấu trúc này giúp phân biệt mức tin cậy. Nhưng số lớp không tự đảm bảo dữ liệu tốt.
Mỗi lớp cần điều kiện chuyển, test, quyền và retention. Người nghiệp vụ chủ yếu dùng gold; Data Engineer có thể điều tra ở silver; raw nhạy cảm có quyền hạn chế.
17. Kiến trúc theo domain
Doanh nghiệp lớn có thể cho domain như sales hoặc supply chain sở hữu Data Product, tức tập dữ liệu có người dùng, owner và SLA. Nền tảng chung cung cấp lưu trữ, bảo mật và chuẩn. Đây là hướng của Data Mesh, không phải lý do bỏ Warehouse.
Nếu domain chưa có năng lực kỹ thuật và định nghĩa còn mâu thuẫn, phân quyền sớm tạo nhiều silo mới. Tổ chức phải sẵn sàng trước cấu trúc phân tán.
PHẦN V — DATA QUALITY, GOVERNANCE VÀ SECURITY
18. Chất lượng không thuộc riêng kiến trúc nào
Warehouse thường đưa dữ liệu qua quy trình chặt trước khi công bố. Lake có nguy cơ nhiều dữ liệu chưa rõ chất lượng. Lakehouse cung cấp constraint và quản lý bảng tốt hơn, nhưng quy tắc nghiệp vụ vẫn phải được viết và duyệt.
Kiểm tra gồm schema, khóa, NULL, độ tươi, khối lượng, phân phối và đối soát. Người dùng phải biết dữ liệu nào “đã chứng nhận” và dữ liệu nào đang khám phá.
19. Catalog và Lineage
Catalog giúp tìm bảng, mô tả owner, độ tươi và mức nhạy cảm. Lineage cho biết nguồn và tài sản hạ nguồn. Cả ba kiến trúc đều cần hai năng lực này; Lake càng lớn càng không thể dựa vào tên file.
Metadata tự động cần bổ sung ngữ nghĩa. Tên cột net_sales chưa nói rõ thuế, hoàn trả và chiết khấu đã xử lý thế nào.
20. Quyền truy cập
Raw thường chứa nhiều trường nhạy cảm hơn lớp phục vụ. Quyền cần thu hẹp theo vai trò, hàng, cột và môi trường. Tài khoản dịch vụ chỉ có quyền cần cho pipeline của nó.
Lake dựa trên file và Warehouse dựa trên bảng có cách cấp quyền khác nhau. Kiến trúc kết hợp phải tránh khoảng trống, chẳng hạn bảng gold bị hạn chế nhưng file nguồn vẫn mở rộng.
21. Xóa và vòng đời dữ liệu
Yêu cầu xóa phải đi qua file, bảng, bản sao, cache, feature và backup theo chính sách. Kiến trúc càng nhiều lớp, quy trình càng phức tạp. Cần lập bản đồ vị trí dữ liệu từ đầu.
Định dạng bảng Lakehouse hỗ trợ xóa logic và quản lý phiên bản, nhưng file cũ có thể tồn tại tới lúc dọn. Đội phải hiểu hành vi thật, không chỉ câu lệnh trả về thành công.
PHẦN VI — CHI PHÍ VÀ NĂNG LỰC ĐỘI NGŨ
22. Không so bằng giá lưu trữ
Lake thường có giá lưu trữ thấp hơn, nhưng tổng chi phí gồm compute, engine truy vấn, catalog, bảo mật, tối ưu file và nhân lực. Warehouse có thể đắt hơn khi truy vấn nhưng giảm công vận hành. Lakehouse có thể hợp nhất workload nhưng cần kỹ năng sâu.
Hãy chạy workload thật: ingest, cập nhật, dashboard, backfill và xóa. Tính cả lần lỗi, môi trường thử nghiệm và dữ liệu truyền. Tổng chi phí sở hữu quan trọng hơn một đơn giá.
23. Kỹ năng đội ngũ
Đội mạnh SQL và BI có thể tạo giá trị nhanh với Warehouse. Đội làm Spark, ML và dữ liệu lớn có thể khai thác Lakehouse. Lake thuần túy cần kỷ luật metadata và xử lý file cao hơn vẻ ngoài “chỉ cần lưu”.
Kiến trúc lý tưởng trên sơ đồ nhưng đội không trực được sẽ tạo nợ kỹ thuật. Kế hoạch phải có đào tạo, tài liệu, on-call và bàn giao.
24. Phụ thuộc nhà cung cấp
Warehouse quản lý sâu có thể dùng tính năng riêng để đạt hiệu năng. Lakehouse với định dạng mở tăng khả năng di chuyển dữ liệu, nhưng engine, catalog và quyền vẫn có phụ thuộc. Không có kiến trúc hoàn toàn trung lập.
Doanh nghiệp nên biết phần nào chấp nhận phụ thuộc để lấy tốc độ và phần nào cần khả năng di chuyển. Ghi biên bản quyết định cùng điều kiện đánh giá lại.
PHẦN VII — AI ẢNH HƯỞNG LỰA CHỌN THẾ NÀO?
25. AI cần cả dữ liệu có cấu trúc và phi cấu trúc
AI doanh nghiệp có thể cần bảng doanh thu từ Warehouse, tài liệu hợp đồng từ Lake và vector phục vụ tìm kiếm. Lakehouse hấp dẫn vì hợp nhất nhiều kiểu xử lý. Tuy nhiên, dữ liệu tài chính vẫn cần lớp định nghĩa ổn định.
Kiến trúc lai thường thực tế: tài liệu và raw ở Lake hoặc Lakehouse, chỉ số quản trị ở Warehouse, quyền và catalog nối xuyên suốt. Không đưa toàn bộ dữ liệu vào mô hình chỉ vì có thể.
26. AI Assistant và AI Agent
Assistant trả lời và tóm tắt; Agent có thể thực hiện nhiều bước bằng công cụ. Agent cần dữ liệu đúng, quyền hẹp và nhật ký. Kiến trúc nào cũng phải cung cấp lớp serving an toàn thay vì cho Agent tự khám phá toàn bộ raw.
Agent có thể phát hiện pipeline trễ và mở ticket. Nó không nên tự xóa dữ liệu, đổi định nghĩa hoặc thực hiện giao dịch lớn mà không có phê duyệt.
27. Feature và lịch sử
Feature là biến đầu vào cho mô hình Machine Learning, tức phương pháp để máy học quy luật từ dữ liệu. Feature cần tính đúng theo thời điểm để tránh dùng thông tin tương lai. Warehouse và Lakehouse đều có thể tạo feature nếu logic được quản lý.
Huấn luyện và vận hành phải dùng cùng cách tính. Phiên bản dữ liệu, mã và mô hình cần liên kết để kiểm tra. Đây là vấn đề quản trị, không chỉ lưu trữ.
PHẦN VIII — CÂY QUYẾT ĐỊNH VÀ ROADMAP 90 NGÀY
28. Khi nên ưu tiên Data Warehouse
Ưu tiên Warehouse nếu phần lớn nhu cầu là BI, dữ liệu có cấu trúc, người dùng chính dùng SQL hoặc dashboard và định nghĩa cần ổn định. Đây thường là điểm bắt đầu phù hợp doanh nghiệp muốn thống nhất doanh thu, tài chính, sales và tồn kho.
Kho Cloud hiện đại có thể lưu raw và mở rộng đủ cho nhiều nhu cầu. Không cần thêm Lake chỉ để kiến trúc trông hiện đại.
29. Khi cần Data Lake
Cần Lake nếu phải giữ nhiều tệp, log, ảnh, văn bản hoặc raw quy mô lớn cho nhiều cách xử lý. Lake cũng hữu ích làm vùng hạ cánh và lưu lịch sử nguồn. Nhưng phải có catalog, quyền, định dạng, partition và retention ngay từ đầu.
Nếu chưa có use case dùng dữ liệu này, chỉ lưu “để dành” có thể tạo rủi ro. Hãy xác định mục đích và người chịu trách nhiệm.
30. Khi cân nhắc Lakehouse
Lakehouse phù hợp khi BI, Data Science, ML và xử lý dữ liệu lớn cần dùng chung nền tảng; đội có năng lực Spark hoặc engine tương ứng; và việc giảm sao chép tạo giá trị rõ. Nó cũng hợp với dữ liệu bán cấu trúc và yêu cầu phiên bản bảng.
Không nên chọn chỉ vì vendor định vị đây là kiến trúc tương lai. Chạy thử workload, đo hiệu năng, chi phí, quyền, lineage và khả năng vận hành.
31. Roadmap 90 ngày
Trong 30 ngày đầu, chọn use case, dữ liệu và tiêu chí. Ngày 31–60 xây một lát cắt trên hai phương án nếu cần, gồm ingest, update, lỗi, backfill và truy vấn. Ngày 61–90 chạy song song, đo và chốt biên bản kiến trúc.
Proof of Concept chỉ có giá trị khi dùng dữ liệu và khối lượng đại diện. Demo tải một file sạch không đủ chứng minh quản trị hay vận hành.
PHẦN IX — CASE TỔNG THỂ
32. Công ty thương mại điện tử
Công ty có đơn hàng, ERP và CRM dạng bảng; đồng thời có log click, ảnh sản phẩm và hội thoại chăm sóc. Tài chính cần báo cáo ngày; Data Science muốn dự đoán rời bỏ; đội marketing muốn phân tích hành trình.
Nếu chọn Warehouse thuần, phần BI nhanh nhưng log và tệp khó linh hoạt. Nếu chọn Lake thuần, khoa học dữ liệu thuận lợi nhưng dashboard và định nghĩa cần nhiều lớp bổ sung. Lakehouse có thể hợp nhất, nhưng đội hiện chỉ có SQL và BI.
33. Kiến trúc thực dụng
Doanh nghiệp giữ đơn, khách, tài chính trong Cloud Data Warehouse; lưu log, ảnh và văn bản ở object storage. Dữ liệu đã chọn từ Lake được xử lý rồi đưa metadata hoặc feature vào lớp phục vụ. Catalog và quyền nối hai vùng.
Sau sáu tháng, khi workload ML tăng và đội có năng lực, doanh nghiệp thử lớp bảng Lakehouse cho log. Báo cáo tài chính vẫn dùng mart đã kiểm soát. Kiến trúc tiến hóa theo nhu cầu thay vì thay toàn bộ một lần.
34. Tiêu chí thành công
BI phải đạt SLA và đối soát; Data Scientist tìm được dữ liệu và tái tạo feature; chi phí theo workload; quyền được kiểm tra; sự cố có owner. Số công nghệ không phải KPI.
Quyết định kiến trúc được xem lại khi khối lượng, đội ngũ hoặc yêu cầu thay đổi. Không có lựa chọn vĩnh viễn, chỉ có lựa chọn phù hợp bối cảnh hiện tại và đường mở rộng hợp lý.
Tài liệu tham khảo
- Google Cloud — Data Lake
- Google Cloud — Data Warehouse
- AWS — What is a Data Lake?
- AWS — What is a Data Warehouse?
- Microsoft — Data Lake
- Databricks — What Is a Data Lakehouse?
- Apache Iceberg Documentation
- Delta Lake Documentation
- Microsoft Fabric Documentation
Kết luận
Data Warehouse phù hợp dữ liệu có cấu trúc và báo cáo ổn định; Data Lake phù hợp raw và nhiều loại dữ liệu; Data Lakehouse đưa khả năng quản lý bảng và nhiều workload lên lưu trữ kiểu Lake. Không kiến trúc nào tự động tốt hơn cho mọi doanh nghiệp.
Lựa chọn phải đi từ use case, người dùng, chất lượng, quyền, chi phí và năng lực đội. Doanh nghiệp có thể kết hợp, nhưng mỗi lớp thêm vào phải có trách nhiệm rõ. Kiến trúc đơn giản được vận hành tốt luôn có giá trị hơn sơ đồ hiện đại nhưng không ai tin dữ liệu.
Câu hỏi chiến lược là: “Workload nào đang tạo giá trị, loại dữ liệu nào thực sự cần và đội có thể vận hành mức phức tạp nào?”. Trả lời bằng dữ liệu thử nghiệm sẽ giúp doanh nghiệp chọn đúng hơn một bảng so sánh tính năng.
TechData.AI - Leading the Future.
Hoàng Minh.