




Evaluation và Observability cho AI Agent là chủ đề trọng tâm của bài viết này. Một AI Agent có thể Demo rất ấn tượng nhưng vẫn thất bại khi gặp dữ liệu thật. Câu trả lời tự nhiên không đủ chứng minh chất lượng. Đội ngũ cần Evaluation để đo đúng sai và Observability để biết Agent đã làm gì trong từng bước.
Evaluation trả lời "hệ thống có đạt tiêu chuẩn không?". Observability trả lời "chuyện gì đã xảy ra trong lần chạy này?". Hai năng lực kết hợp biến việc phát triển Agent từ thử Prompt thành một quy trình Engineering có thể lặp lại.
Mục lục
- Vì sao Agent khó đánh giá?
- Đơn vị đánh giá
- Offline và Online Evaluation
- Thiết kế Test Set
- Reference Answer và Rubric
- Deterministic Grader
- Model-based Grader
- Human Evaluation
- Tool Calling Metrics
- RAG Metrics
- Agent Task Metrics
- Tracing
- Logs, Metrics và Alerts
- Regression Testing
- Production Feedback Loop
- Ví dụ Scorecard
- Kết luận
- Tài liệu tham khảo
Vì sao Agent khó đánh giá?
Phần mềm truyền thống thường có Input và Output xác định. Agent có thể chọn nhiều đường đi và tạo nhiều câu trả lời hợp lệ. Một Task có thể đúng kết luận nhưng gọi Tool thừa, dùng nguồn sai hoặc vi phạm Policy. Vì vậy chỉ so sánh Final Text là chưa đủ.
Evaluation phải kiểm tra Outcome, Trajectory và Policy. Outcome là kết quả cuối. Trajectory là chuỗi quyết định và Tool Calls. Policy là giới hạn về quyền, dữ liệu và hành động.
Đơn vị đánh giá
Evaluation Case nên có Input, Initial State, User Identity, Expected Behavior, Reference Data và Rubric. Với Agent doanh thu, Expected Behavior có thể yêu cầu đúng Tool, đúng khoảng ngày, đúng Branch Filter, đúng phép tính và Citation.
{
  "case_id": "sales_018",
  "input": "Chi nhánh nào giảm mạnh nhất tuần trước?",
  "identity": "regional_manager_south",
  "expected_tools": ["get_revenue"],
  "forbidden_branches": ["Ha Noi"],
  "reference": {"branch": "Q7", "change_pct": -18.2}
}
Offline và Online Evaluation
Offline Evaluation chạy trên Test Set trước khi triển khai. Nó nhanh, lặp lại được và phù hợp Regression. Online Evaluation sử dụng Traffic thật, Feedback và Production Metrics. Offline không bao phủ mọi tình huống, còn Online không nên là nơi đầu tiên phát hiện lỗi nguy hiểm.
Một Release Gate có thể yêu cầu không giảm Task Success, không có Policy Violation, Cost không tăng quá ngưỡng và P95 Latency đạt mục tiêu. Sau triển khai, Canary giúp giới hạn phạm vi rủi ro.
Thiết kế Test Set
Test Set nên lấy từ nhiệm vụ thật và Failure Logs, không chỉ do Developer tự nghĩ. Nó cần trường hợp phổ biến, Edge Case, câu mơ hồ, dữ liệu thiếu, Tool timeout, yêu cầu vượt quyền và Prompt Injection trong tài liệu.
Dataset phải có Version và phân nhóm theo Task Type, Risk Level, Department và Language. Giữ một Holdout Set để tránh tối ưu quá mức vào bộ test quen thuộc.
Reference Answer và Rubric
Reference Answer hữu ích khi có một đáp án rõ. Với nhiệm vụ mở, Rubric phù hợp hơn. Rubric chia tiêu chí như Correctness, Completeness, Groundedness, Relevance và Safety, mỗi tiêu chí có mô tả mức điểm.
Rubric phải cụ thể. "Câu trả lời tốt" quá mơ hồ. "Nêu đúng chi nhánh, phần trăm thay đổi, khoảng thời gian và Source ID" có thể đánh giá nhất quán hơn.
Deterministic Grader
Deterministic Grader dùng code kiểm tra Exact Match, JSON Schema, SQL Result, Tool Name, Arguments, Citation ID hoặc Policy. Nó nhanh, rẻ và lặp lại được.
def grade_tool_call(actual, expected):
    return (
        actual.name == expected.name
        and actual.arguments["branch"] == expected.arguments["branch"]
        and actual.arguments["start_date"] == expected.arguments["start_date"]
    )
Nên dùng Grader deterministic bất cứ khi nào tiêu chí có thể viết bằng code. Không cần gọi thêm LLM để kiểm tra JSON có đúng schema hay không.
Model-based Grader
LLM-as-a-Judge phù hợp với tiêu chí ngữ nghĩa như chất lượng giải thích. Judge nhận Rubric, Input, Output và Source. Kết quả nên có Score cùng lý do có cấu trúc.
Judge cũng có Bias và sai số. Cần kiểm định bằng mẫu do con người chấm, tránh để Judge thấy thông tin không có trong Context của Agent và không dùng một điểm tổng hợp che giấu lỗi an toàn.
Human Evaluation
Con người cần thiết cho trường hợp chủ quan, rủi ro cao hoặc tạo Rubric mới. Người chấm nên được hướng dẫn và đo Inter-rater Agreement. Khi hai người thường bất đồng, tiêu chí có thể chưa rõ.
Active Sampling ưu tiên mẫu Judge không chắc, User khiếu nại hoặc Agent có hành vi lạ. Cách này dùng nguồn lực hiệu quả hơn chấm ngẫu nhiên mọi Task.
Tool Calling Metrics
- Tool Selection Accuracy đo chọn đúng công cụ.
- Argument Accuracy đo đúng tham số.
- Execution Success đo Tool chạy thành công.
- Permission Compliance đo không vượt quyền.
- Tool Efficiency đo số lời gọi cần thiết.
- Idempotency Violation đo hành động bị lặp.
Nên đánh giá theo Task, không chỉ từng Call. Agent có thể gọi một Tool sai rồi tự sửa, nhưng vẫn tăng cost và rủi ro.
RAG Metrics
Retrieval Metrics gồm Recall@K, Precision@K, MRR và nDCG. Generation Metrics gồm Faithfulness, Answer Relevance, Citation Correctness và Completeness. Phân tách giúp biết lỗi nằm ở Retrieval hay Model.
Agent Task Metrics
- Task Completion Rate.
- Correct Resolution Rate.
- Human Escalation Rate.
- Human Correction Rate.
- Average Steps và Tool Calls.
- Cost per Completed Task.
- P50 và P95 Latency.
- Policy Violation Rate.
Số lượt dùng không chứng minh giá trị nếu người dùng phải kiểm tra lại từ đầu. KPI cần có Baseline trước triển khai và được chia theo nhiệm vụ, rủi ro, bộ phận và phiên bản.
Tracing
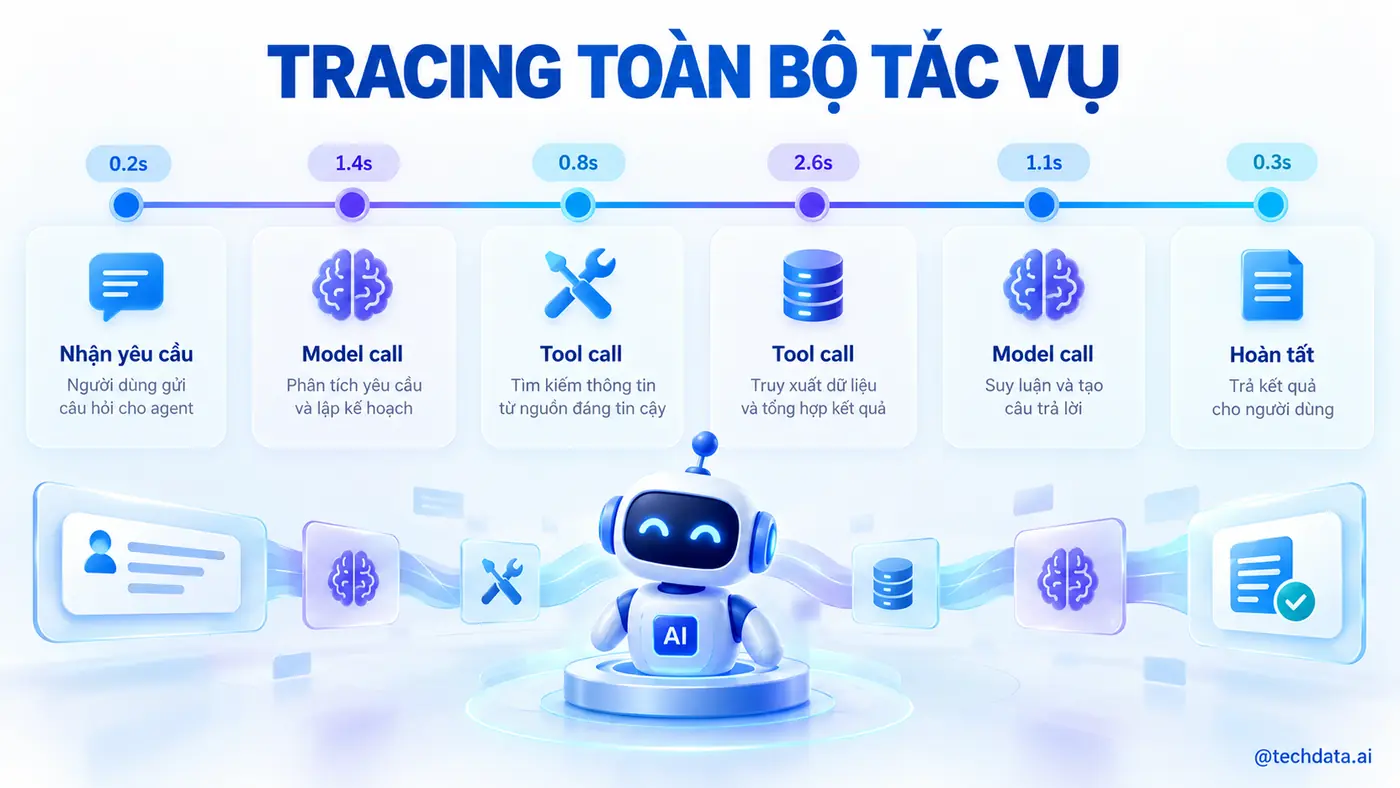
Mỗi Task tạo một Trace. Mỗi Model Call, Tool Call, Retrieval và Approval là một Span. Span có Start Time, Duration, Status, Input Metadata, Output Metadata, Token, Cost và Error.
Trace task_82931
  Span classify_request
  Span model_plan
  Span tool_get_revenue
  Span model_analyze
  Span approval_check
  Span final_answer
Trace phải liên kết Model Version, Prompt Version, Tool Version và Dataset Version. Dữ liệu nhạy cảm cần Redaction. Observability không được biến thành một kho sao chép bí mật.
Logs, Metrics và Alerts
Logs ghi sự kiện chi tiết. Metrics tổng hợp xu hướng. Traces nối toàn bộ hành trình. Alerts phát tín hiệu khi tỷ lệ lỗi, latency, cost hoặc Policy Violation vượt ngưỡng.
Alert phải Actionable. "Agent Quality giảm" quá chung. "Tool Argument Accuracy của get_revenue giảm từ 96 xuống 81 phần trăm sau Prompt Version 12" giúp đội ngũ điều tra.
Regression Testing
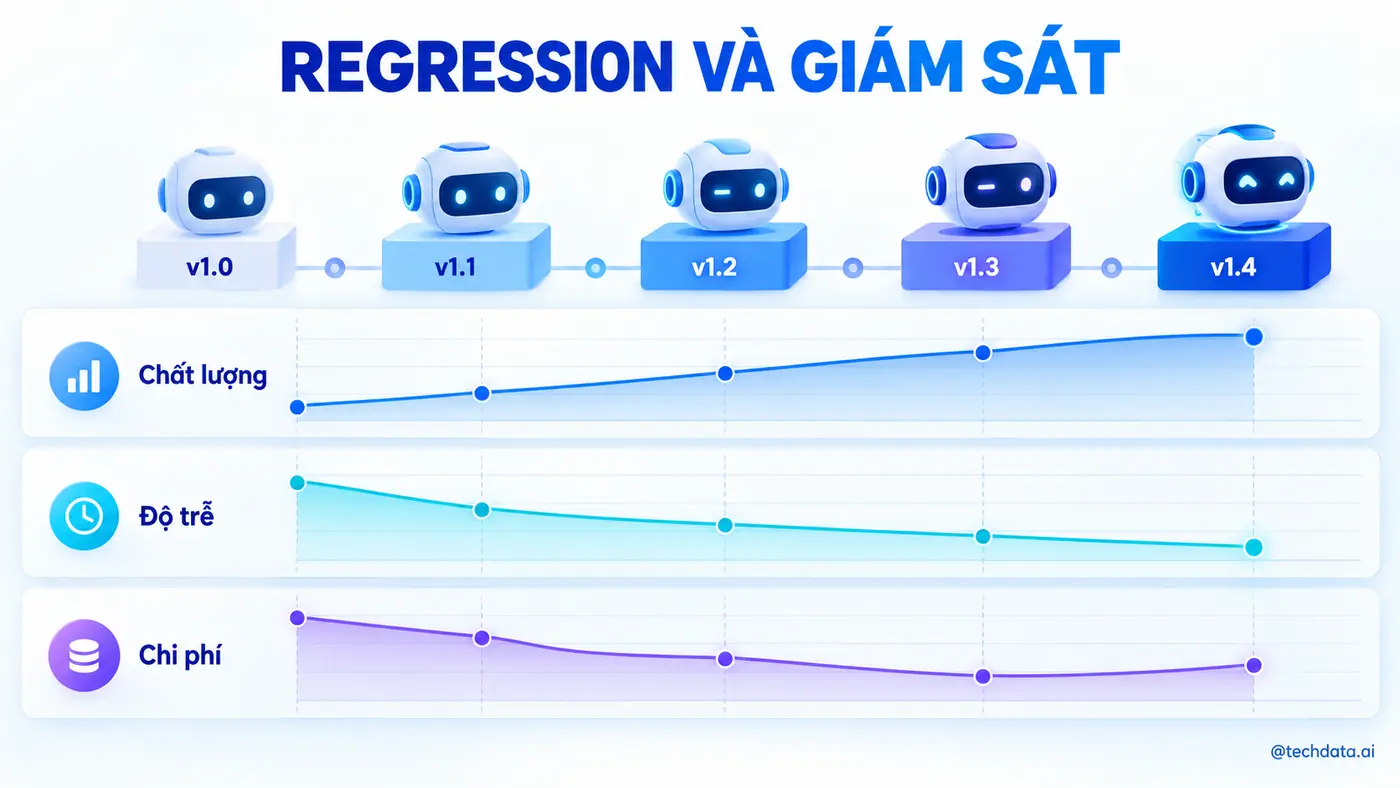
Mỗi thay đổi Model, Prompt, Tool Schema, Retrieval hoặc Code đều có thể làm hành vi thay đổi. CI nên chạy Evaluation Suite và so sánh với Baseline. Kết quả cần phân nhóm, không chỉ một điểm trung bình.
Failure Case mới từ Production nên được ẩn danh, gắn nhãn và thêm vào Regression Set. Đây là vòng lặp giúp hệ thống trưởng thành theo dữ liệu thật.
Production Feedback Loop
User Feedback như đúng, sai hoặc cần sửa phải gắn với Trace. Outcome kinh doanh như Ticket được giải quyết, báo cáo được chấp nhận hoặc hành động bị hoàn tác cung cấp tín hiệu mạnh hơn nút Like đơn lẻ.
Ví dụ Scorecard
Task completion             92%
Correct resolution          88%
Tool selection accuracy     96%
Argument accuracy           94%
Citation correctness        91%
Policy violations            0%
P95 latency                 8.4s
Cost per completed task     $0.07
Scorecard phải đi kèm số lượng mẫu, khoảng tin cậy và phiên bản hệ thống. Không so sánh hai tỷ lệ từ tập nhiệm vụ khác nhau mà không phân tầng.
Kết luận
Evaluation xác định chất lượng, Observability cung cấp bằng chứng để giải thích chất lượng. Một Agent production cần cả Test Set trước triển khai và Trace sau triển khai. Đánh giá phải bao phủ kết quả, quá trình, quyền, chi phí và tốc độ.
Hãy bắt đầu bằng 30 đến 50 nhiệm vụ thật, định nghĩa Rubric và ghi Trace từng bước. Mỗi lỗi production trở thành bài kiểm thử mới. Khi đó đội ngũ cải tiến dựa trên dữ liệu thay vì cảm giác.
Ghi nhớ về Evaluation và Observability cho AI Agent
Evaluation và Observability cho AI Agent cần được thiết kế cùng lúc. Evaluation xác định tiêu chuẩn đúng, còn Observability cung cấp Trace và bằng chứng để tìm nguyên nhân khi Agent không đạt tiêu chuẩn.
Đọc thêm: xây dựng AI Agent bằng Python và bảo mật AI Agent.
Tài liệu tham khảo
- OpenAI Documentation. Evals.
- Anthropic. Building Effective Agents.
- OpenTelemetry. Observability primer.
- Google Cloud Architecture Framework. Generative AI.
- NIST AI Risk Management Framework.
- Zheng và cộng sự. Judging LLM-as-a-Judge.
TechData.AI - Leading The Future.
Hoàng Minh.