



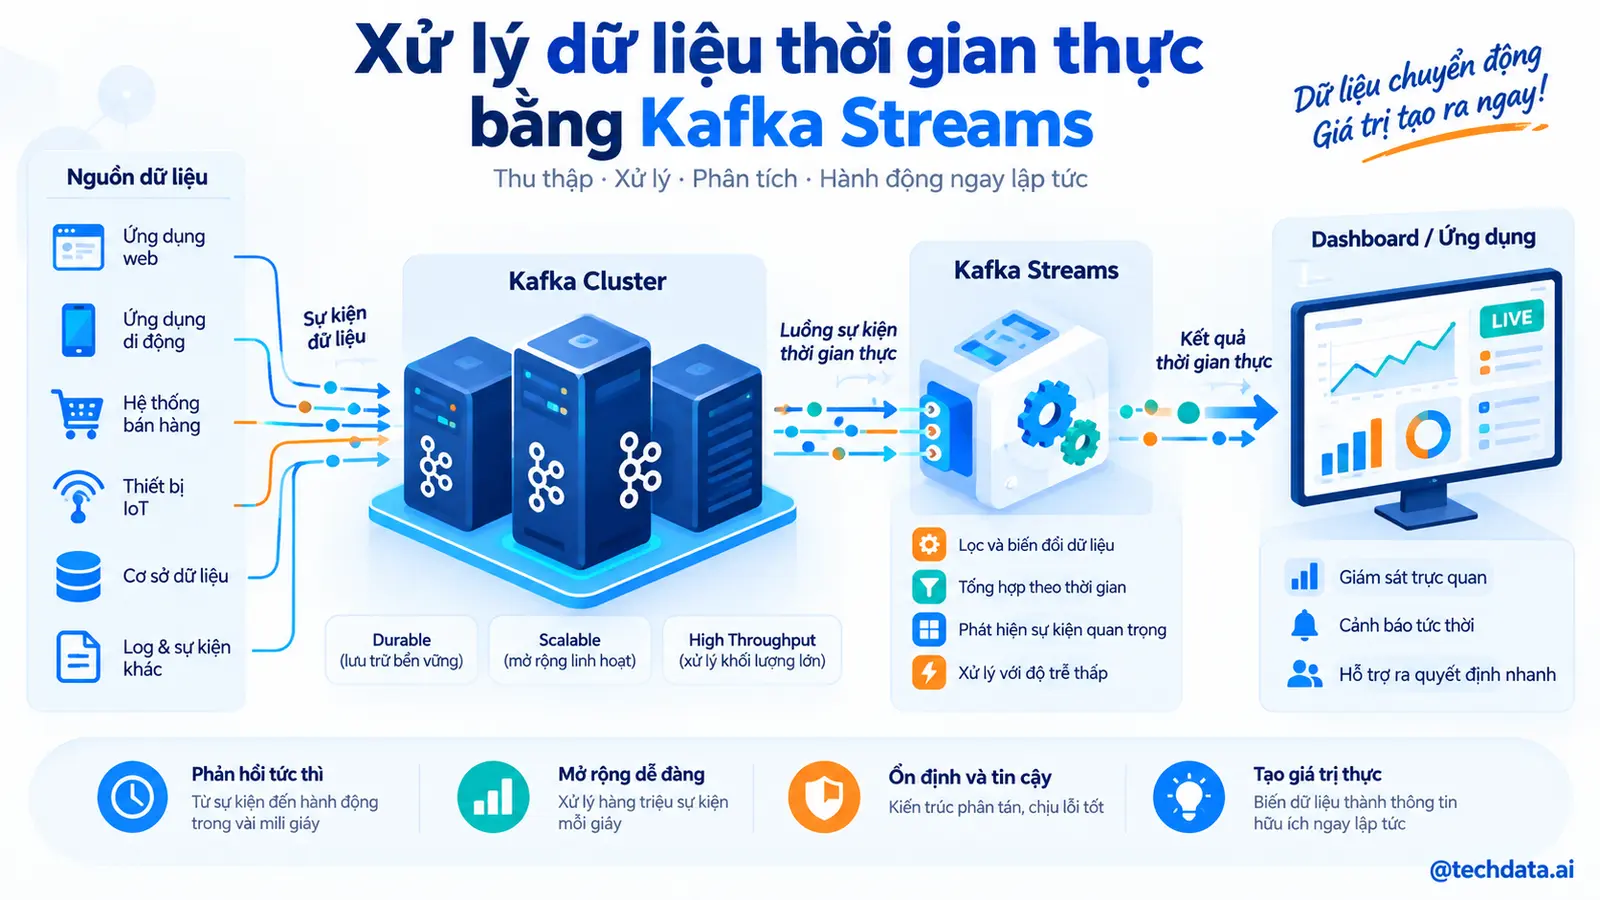

Đơn vị biên soạn: TechData.AI
Chủ đề: Real-time Stream Processing
Đối tượng: Data Engineer, Java Developer và Streaming Engineer
Phiên bản tham chiếu: Apache Kafka 4.x
MỤC LỤC
- Mục tiêu bài học
- Stream Processing là gì
- Kafka Streams là gì
- Topology, Source, Processor và Sink
- KStream, KTable và GlobalKTable
- Stateless Processing
- Stateful Processing
- Grouping và Aggregation
- Windowing
- Event Time, Processing Time và dữ liệu đến muộn
- Stream Join và Table Join
- State Store và Changelog Topic
- Repartition Topic
- Exactly Once Processing
- Xây dựng ứng dụng doanh thu thời gian thực
- Scale và phục hồi
- Kafka Streams, Flink và Spark
- Testing và Monitoring
- Lỗi thường gặp
- Tổng kết
- Câu hỏi ôn tập
- Tài liệu tham khảo
1. Mục tiêu bài học
Đưa Event vào Kafka mới chỉ giải quyết việc vận chuyển và lưu trữ dữ liệu. Nhiều bài toán cần biến đổi, tổng hợp, kết hợp và phản ứng với Event ngay khi chúng xuất hiện.
Ví dụ, doanh nghiệp muốn tính doanh thu từng phút, phát hiện khách hàng đặt quá nhiều đơn trong thời gian ngắn, kết hợp đơn hàng với thông tin khách hàng hoặc tạo bảng trạng thái đơn hàng mới nhất.
Kafka Streams là thư viện Java và Scala dùng để xây dựng ứng dụng Stream Processing trên dữ liệu Kafka. Bài này giải thích mô hình KStream, KTable, Window, Join, State Store và Exactly Once.
2. Stream Processing là gì
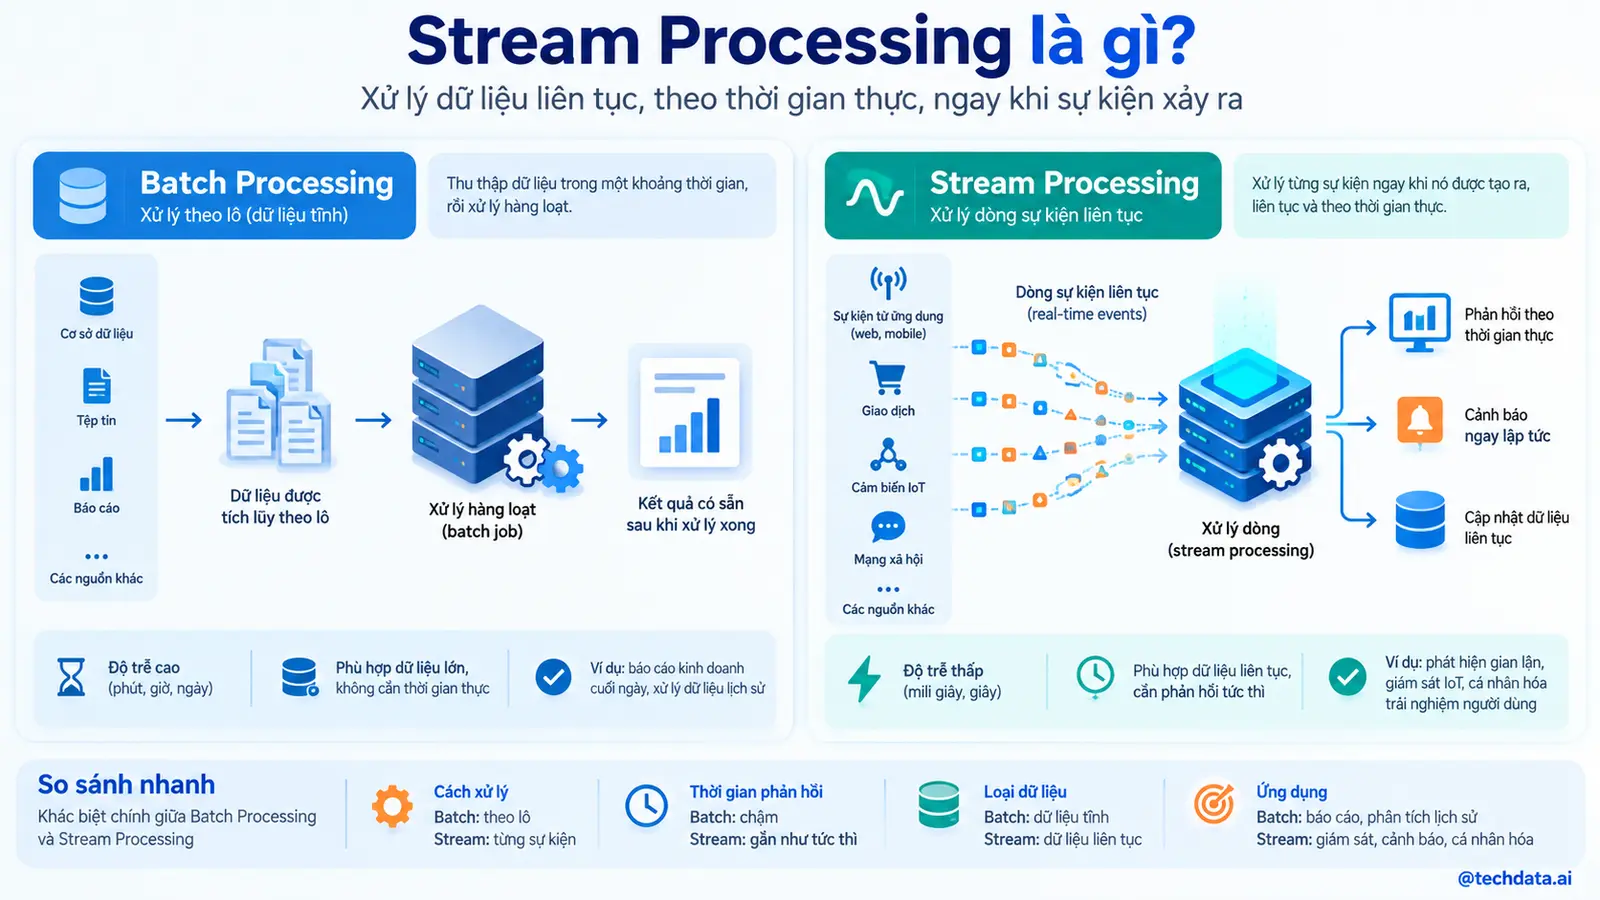
Batch Processing xử lý một tập dữ liệu hữu hạn tại một thời điểm. Stream Processing xử lý dữ liệu liên tục khi Event đến.
Stream không nhất thiết phải vô hạn về mặt vật lý. Nó là mô hình coi dữ liệu như chuỗi sự kiện liên tục, thay vì chờ đủ một file hoặc một ngày dữ liệu.
Một ứng dụng Stream Processing thường thực hiện:
- Filter Event.
- Chuyển đổi cấu trúc.
- Nhóm theo Key.
- Tính Aggregate.
- Join nhiều Stream.
- Xử lý theo cửa sổ thời gian.
- Duy trì trạng thái.
- Ghi kết quả sang Topic mới.
Stream Processing không thay thế mọi Batch Job. Báo cáo lịch sử lớn, backfill phức tạp hoặc truy vấn ad hoc vẫn có thể phù hợp với Data Warehouse và Batch Engine.
3. Kafka Streams là gì
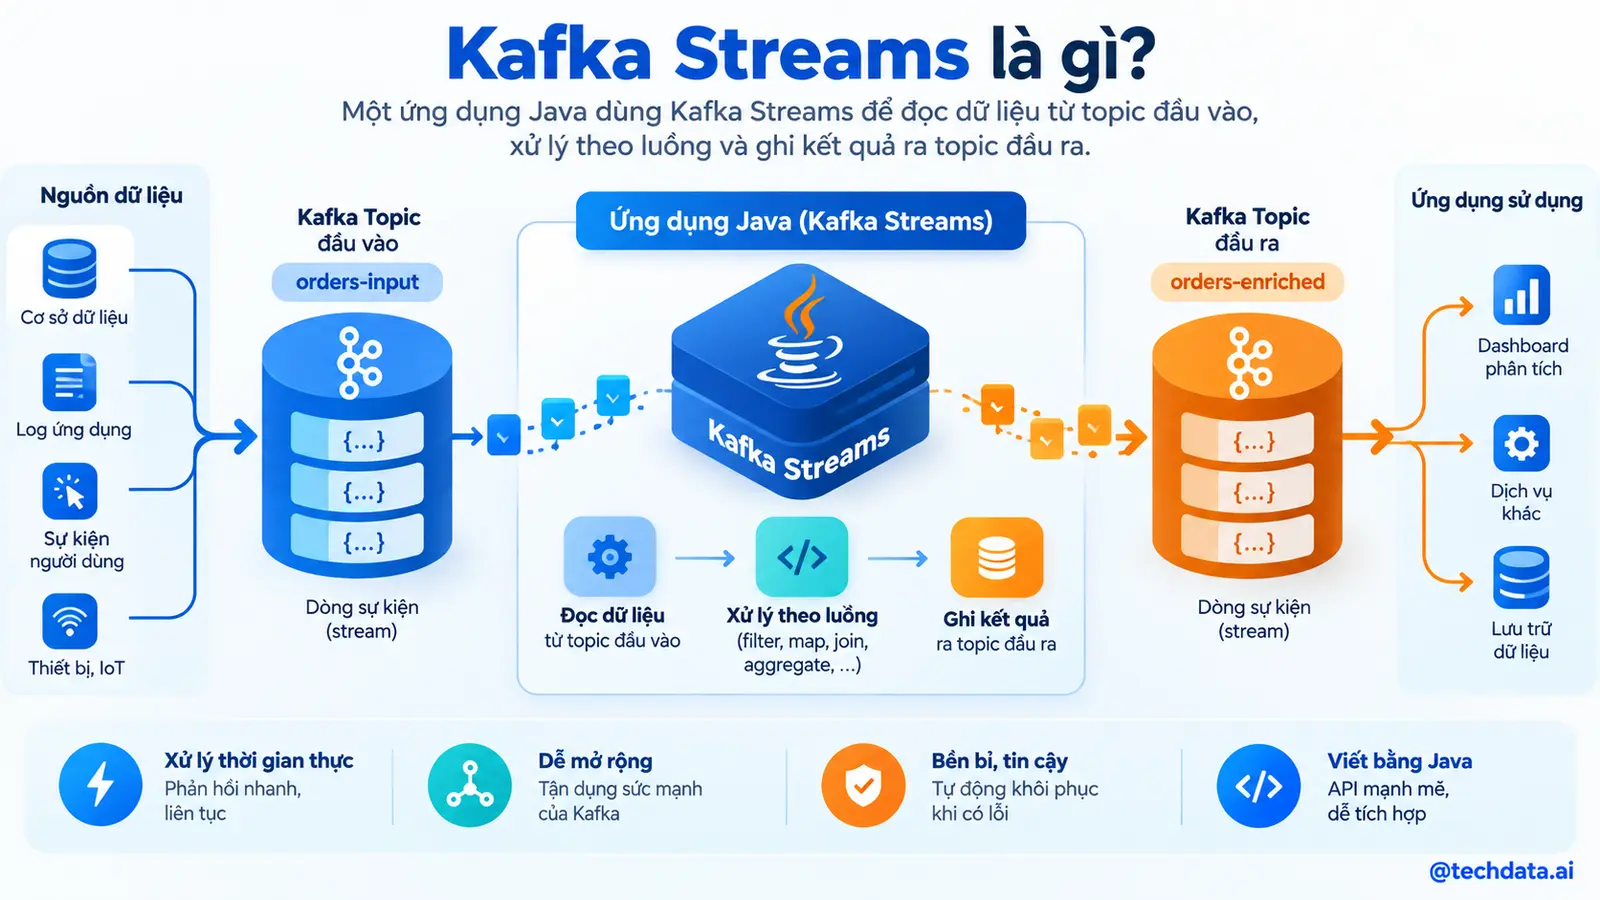
Kafka Streams là Client Library, không phải một Cluster xử lý riêng. Ứng dụng Kafka Streams được build và deploy như ứng dụng Java thông thường.
Kafka cung cấp dữ liệu, Partition, Consumer Group, Changelog và cơ chế phân phối. Kafka Streams cung cấp DSL cùng Processor API để mô tả Topology xử lý.
Ưu điểm:
- Không cần vận hành Cluster Compute riêng.
- Scale bằng cách chạy thêm application instance.
- Tích hợp chặt với Partition và Consumer Group.
- Hỗ trợ Stateful Processing.
- Hỗ trợ Exactly Once.
- State cục bộ giúp truy vấn và xử lý nhanh.
Hạn chế:
- Chủ yếu phục vụ JVM.
- Nguồn và đích tập trung vào Kafka.
- Bài toán event-time rất phức tạp hoặc nhiều connector có thể phù hợp hơn với Flink.
4. Topology, Source, Processor và Sink
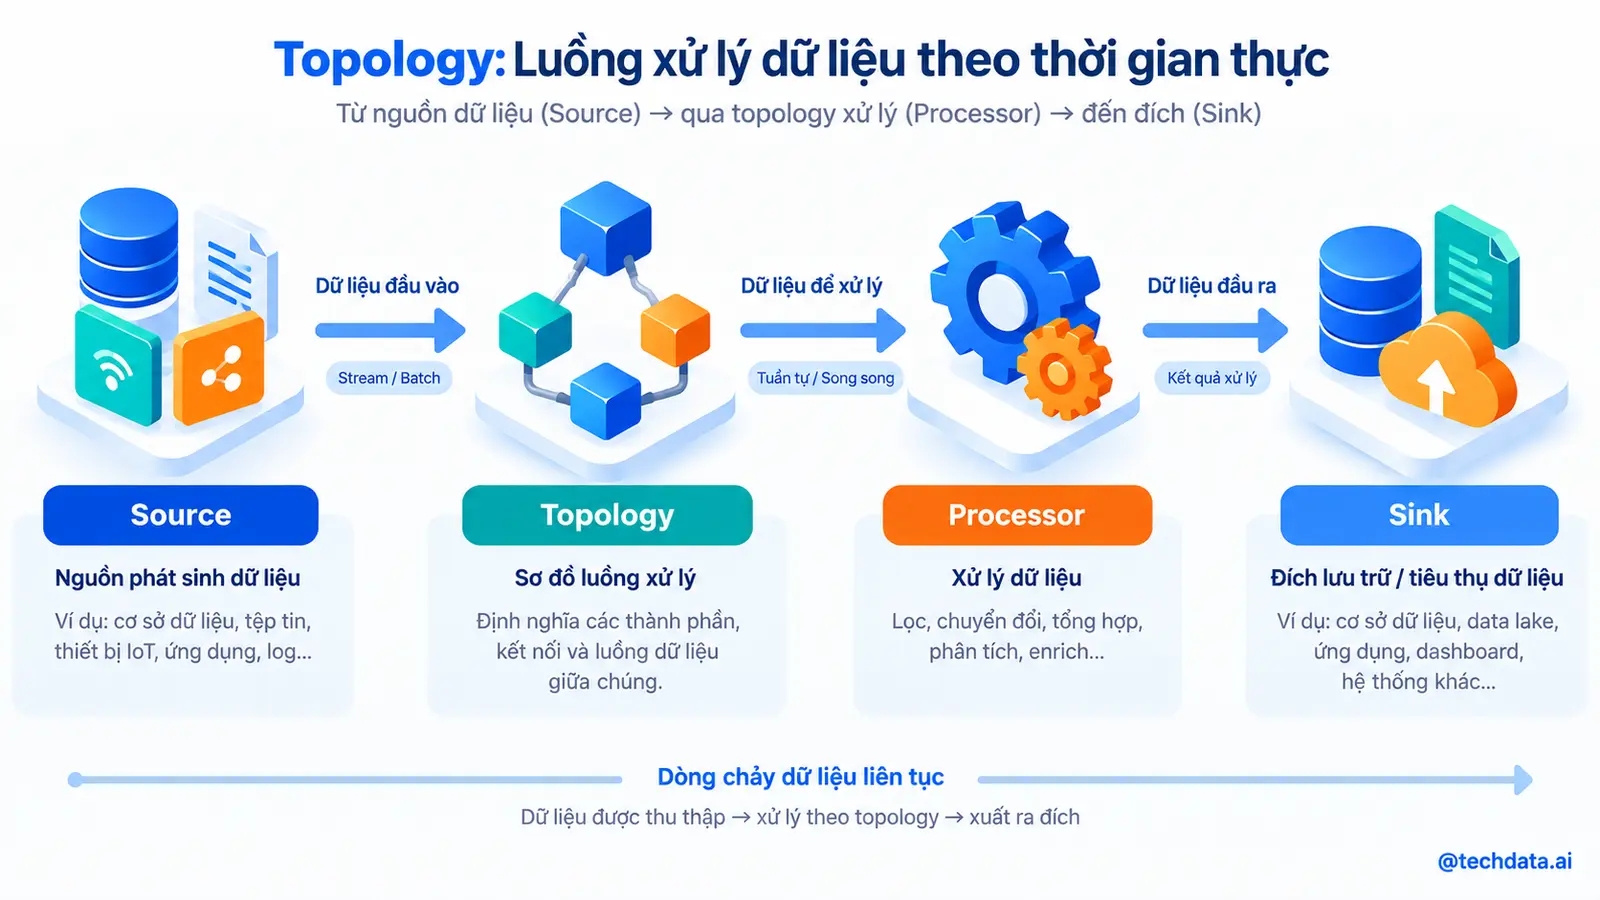
Topology là đồ thị xử lý.
Source Node đọc record từ Topic. Processor Node thực hiện filter, map, join hoặc aggregate. Sink Node ghi kết quả vào Topic.
Ví dụ:
StreamsBuilder builder = new StreamsBuilder();

KStream<String, Order> orders = builder.stream("order-created");

orders
    .filter((key, order) -> order.totalAmount() > 0)
    .mapValues(Order::normalize)
    .to("order-valid");
Khi KafkaStreams khởi động, thư viện chuyển Topology thành Processor Task. Số Task gắn với Partition đầu vào và được phân phối giữa các instance.
5. KStream, KTable và GlobalKTable
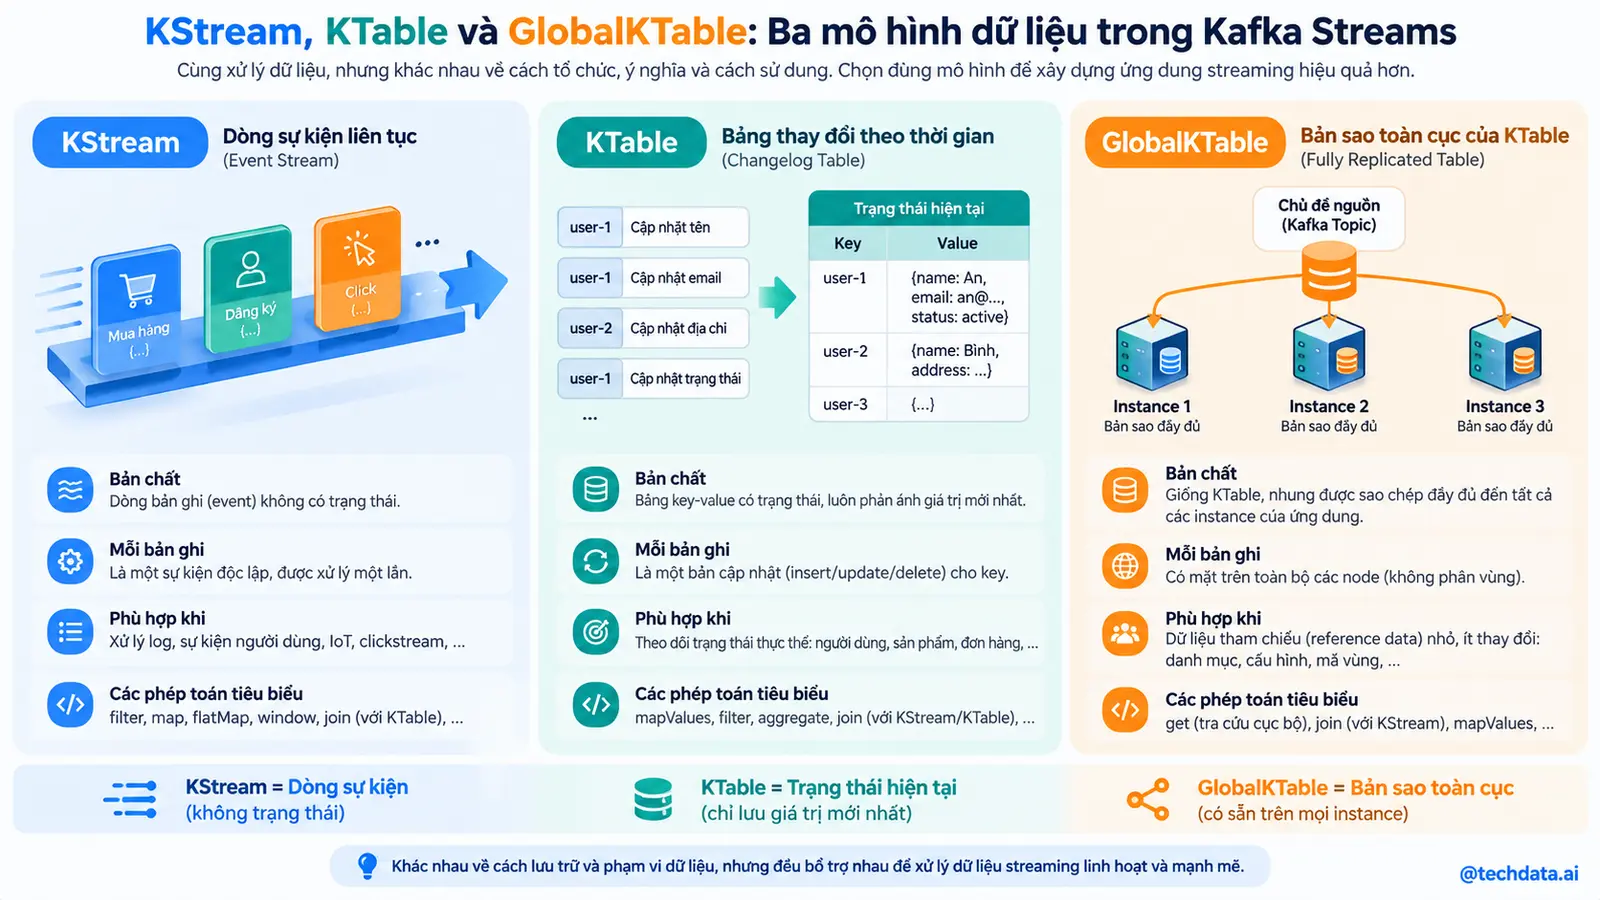
KStream
KStream xem mỗi record là một sự kiện độc lập. Hai record cùng Key vẫn là hai Event.
KStream phù hợp với click, giao dịch, trạng thái thay đổi và dữ liệu lịch sử.
KTable
KTable xem record như cập nhật mới nhất của một Key. Record mới cùng Key thay thế giá trị logic trước đó.
KTable phù hợp với trạng thái khách hàng, cấu hình sản phẩm hoặc số dư hiện tại.
GlobalKTable
GlobalKTable sao chép toàn bộ dữ liệu bảng đến mỗi instance. Nó hữu ích cho bảng tham chiếu nhỏ khi cần join mà không phụ thuộc co-partitioning.
Không nên dùng GlobalKTable cho bảng rất lớn vì mỗi instance phải lưu toàn bộ dữ liệu.
6. Stateless Processing
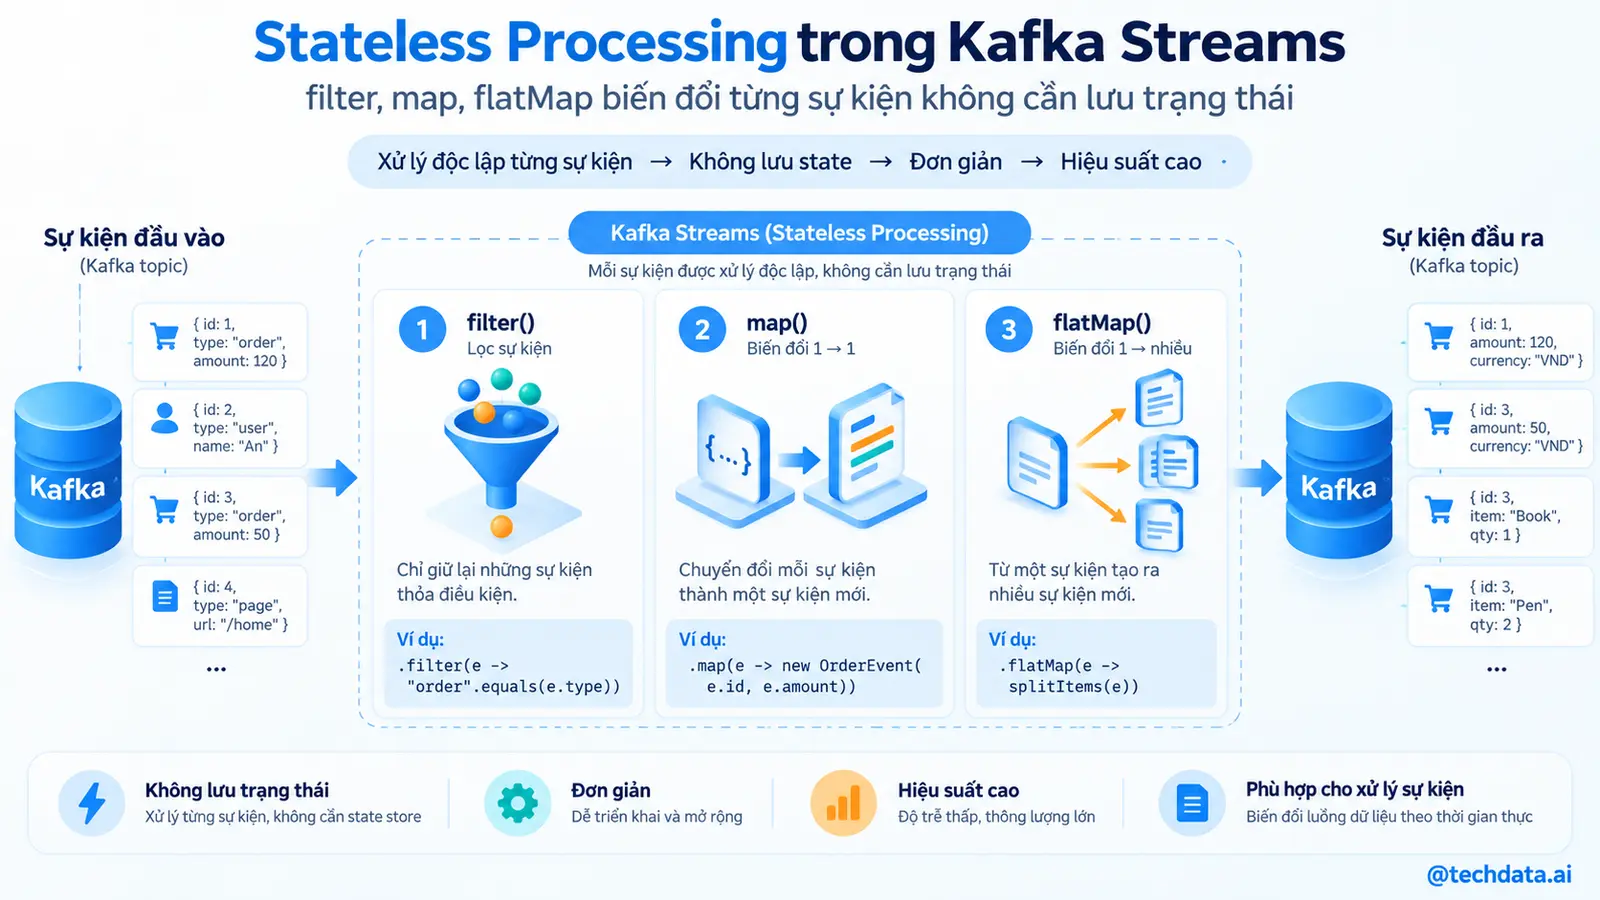
Stateless Operation không cần nhớ record trước.
Các thao tác thường gặp:
filtermapmapValuesflatMapselectKeybranchpeek
Ví dụ lọc đơn hợp lệ:
KStream<String, Order> validOrders = orders.filter(
    (orderId, order) ->
        order != null && order.totalAmount() > 0
);
Stateless Processing dễ scale vì mỗi record được xử lý độc lập. Tuy nhiên, thay đổi Key bằng selectKey có thể yêu cầu repartition trước Group hoặc Join.
7. Stateful Processing
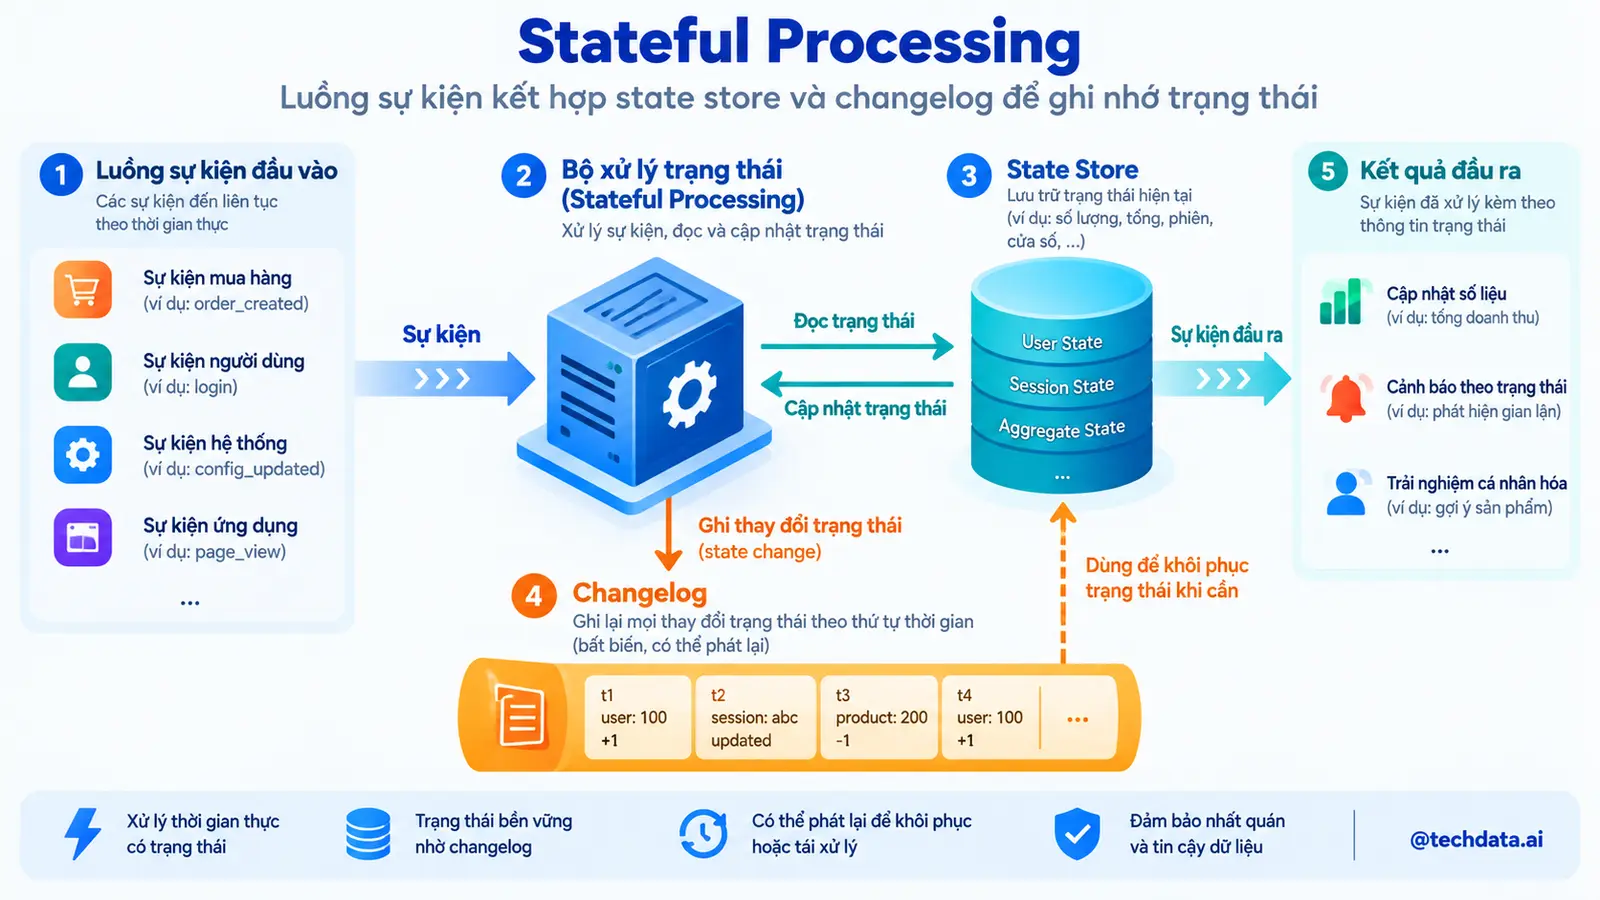
Stateful Operation cần nhớ dữ liệu trước, ví dụ tổng doanh thu, số lần đăng nhập thất bại hoặc trạng thái mới nhất.
State được lưu trong State Store cục bộ, thường dùng RocksDB hoặc bộ nhớ tùy loại Store. Kafka duy trì Changelog Topic để phục hồi state khi instance hỏng.
Stateful Processing yêu cầu thiết kế kỹ:
- Kích thước state.
- Disk local.
- Changelog retention.
- Restore time.
- Standby Replica.
- Key distribution.
- Window retention.
Nếu state hàng TB nhưng Pod chỉ có disk tạm nhỏ, ứng dụng sẽ không vận hành ổn định dù code đúng.
8. Grouping và Aggregation
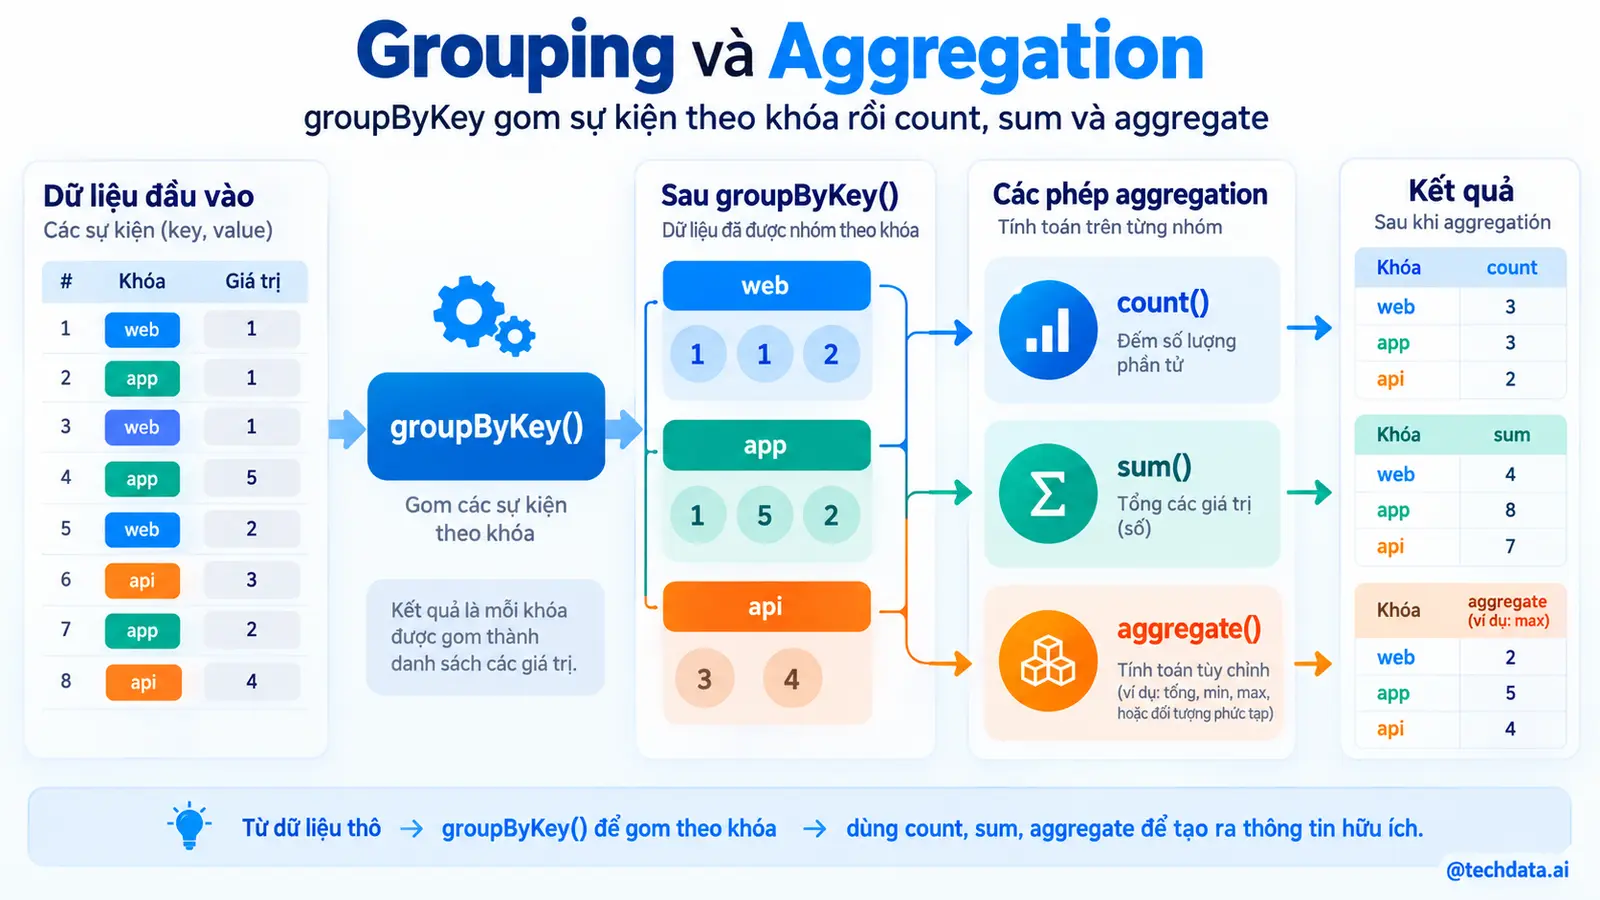
Tính tổng doanh thu theo khách hàng:
KTable<String, Long> revenueByCustomer = orders
    .selectKey((orderId, order) -> order.customerId())
    .groupByKey(Grouped.with(Serdes.String(), orderSerde))
    .aggregate(
        () -> 0L,
        (customerId, order, total) -> total + order.totalAmount(),
        Materialized.with(Serdes.String(), Serdes.Long())
    );
Khi đổi Key từ order_id sang customer_id, Kafka Streams thường tạo Repartition Topic để record cùng khách hàng về cùng Task.
Aggregate cần chịu được duplicate nếu pipeline không dùng Exactly Once hoặc nguồn có Event lặp. Có thể deduplicate theo Event ID trong State Store trước khi cộng.
9. Windowing
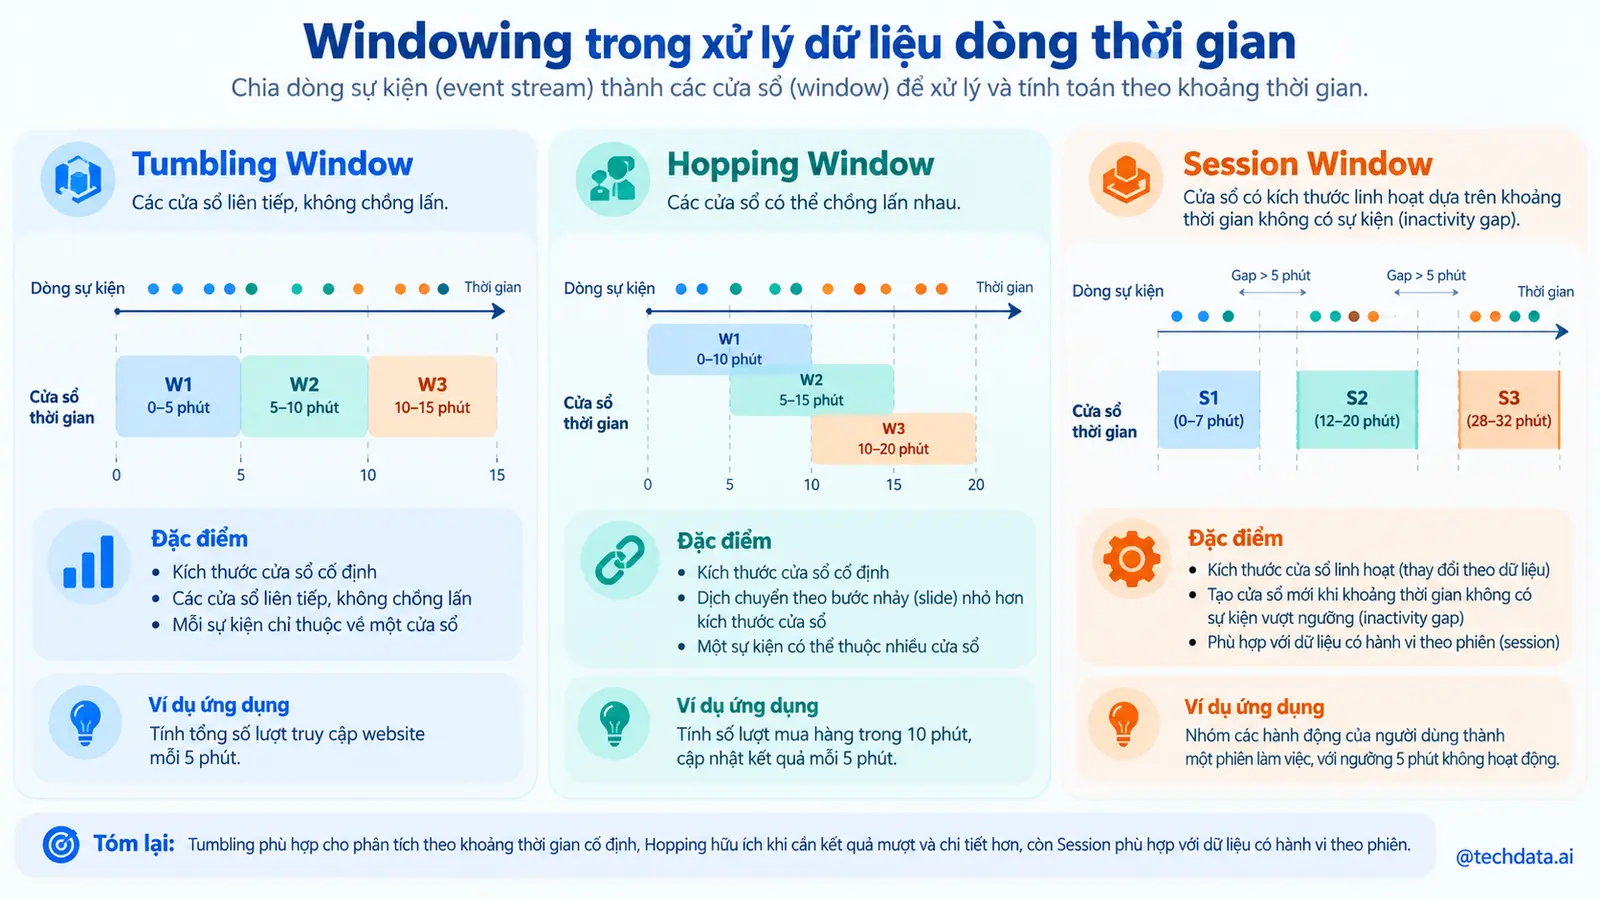
Window giới hạn Aggregate theo thời gian.
Tumbling Window
Các cửa sổ liên tiếp, không chồng lấp. Ví dụ doanh thu mỗi năm phút.
Hopping Window
Cửa sổ có thể chồng lấp. Ví dụ tổng giao dịch trong mười phút, cập nhật mỗi phút.
Sliding Window
Cửa sổ trượt dựa trên khoảng cách thời gian giữa record.
Session Window
Nhóm Event theo phiên hoạt động, kết thúc khi không có Event trong một khoảng thời gian.
Ví dụ Tumbling Window:
orders
    .groupBy((key, order) -> order.storeId())
    .windowedBy(TimeWindows.ofSizeWithNoGrace(Duration.ofMinutes(5)))
    .aggregate(
        () -> 0L,
        (storeId, order, total) -> total + order.totalAmount()
    );
Window Size, Advance Interval, Grace Period và Retention cần phù hợp với độ trễ dữ liệu thật.
10. Event Time, Processing Time và dữ liệu đến muộn
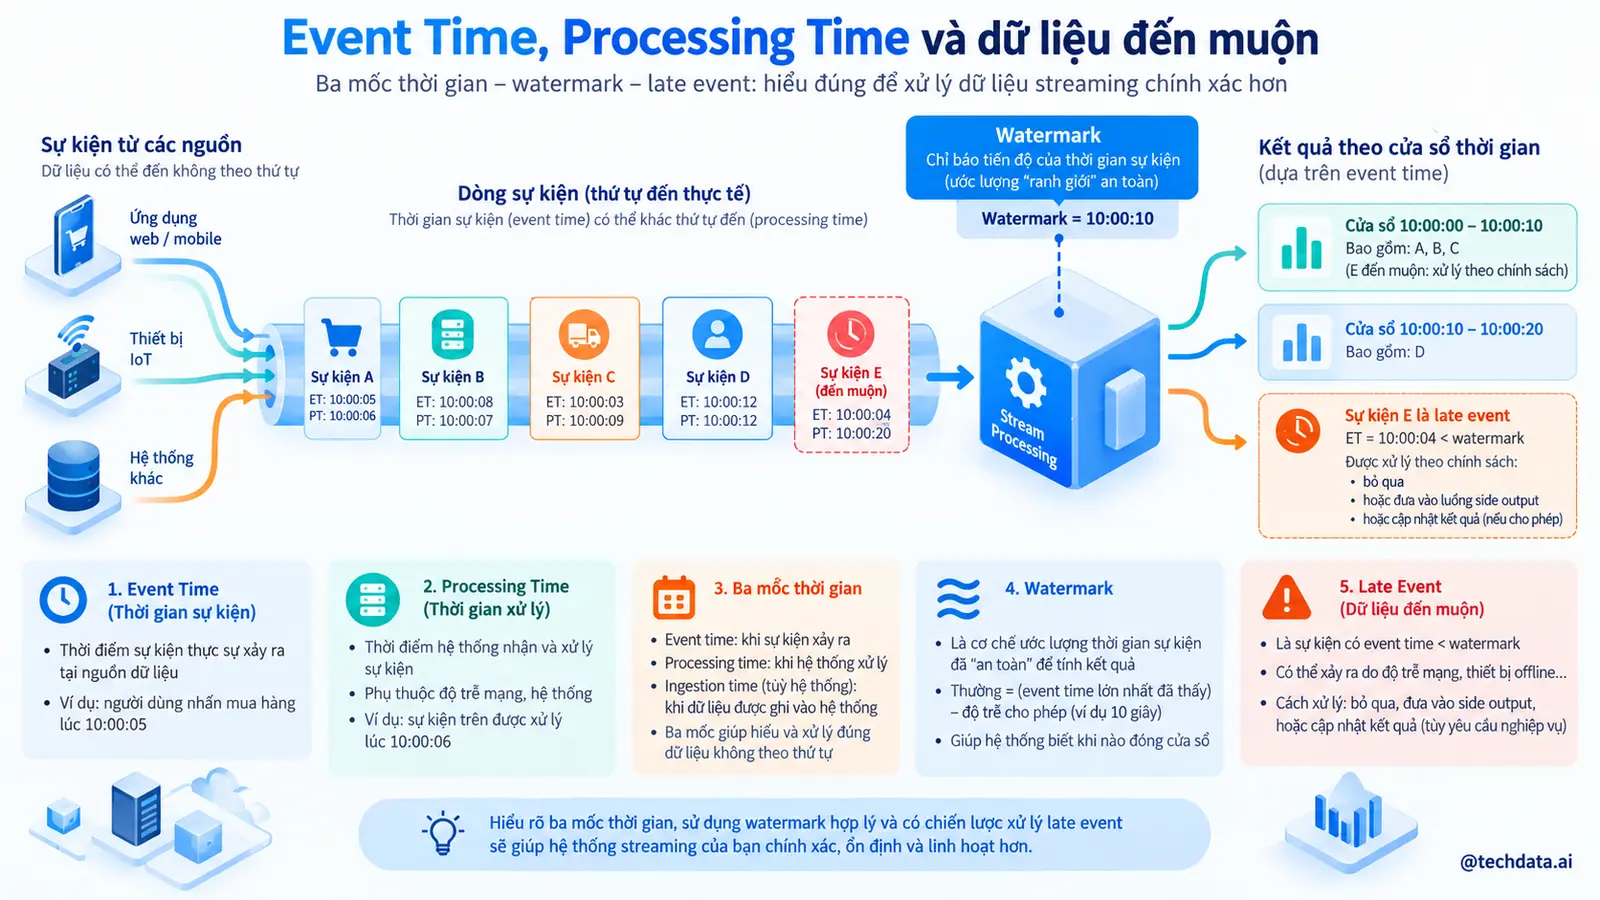
Event Time là thời điểm nghiệp vụ xảy ra. Processing Time là lúc ứng dụng xử lý. Ingestion Time là lúc Kafka nhận record.
Nếu mạng di động mất kết nối, Event có thể đến Kafka sau thời điểm phát sinh nhiều phút. Dùng Processing Time sẽ đưa Event vào cửa sổ sai so với nghiệp vụ.
Kafka Streams sử dụng Timestamp Extractor để xác định timestamp. Event nên chứa thời gian rõ, có timezone và được validate.
Grace Period cho phép Window tiếp nhận record đến muộn trong một khoảng. Sau Grace Period, record có thể bị loại khỏi kết quả Window. Grace quá ngắn làm thiếu dữ liệu, quá dài giữ state lâu và chậm phát kết quả cuối.
Cần đo phân phối lateness từ dữ liệu thật trước khi chọn Grace.
11. Stream Join và Table Join
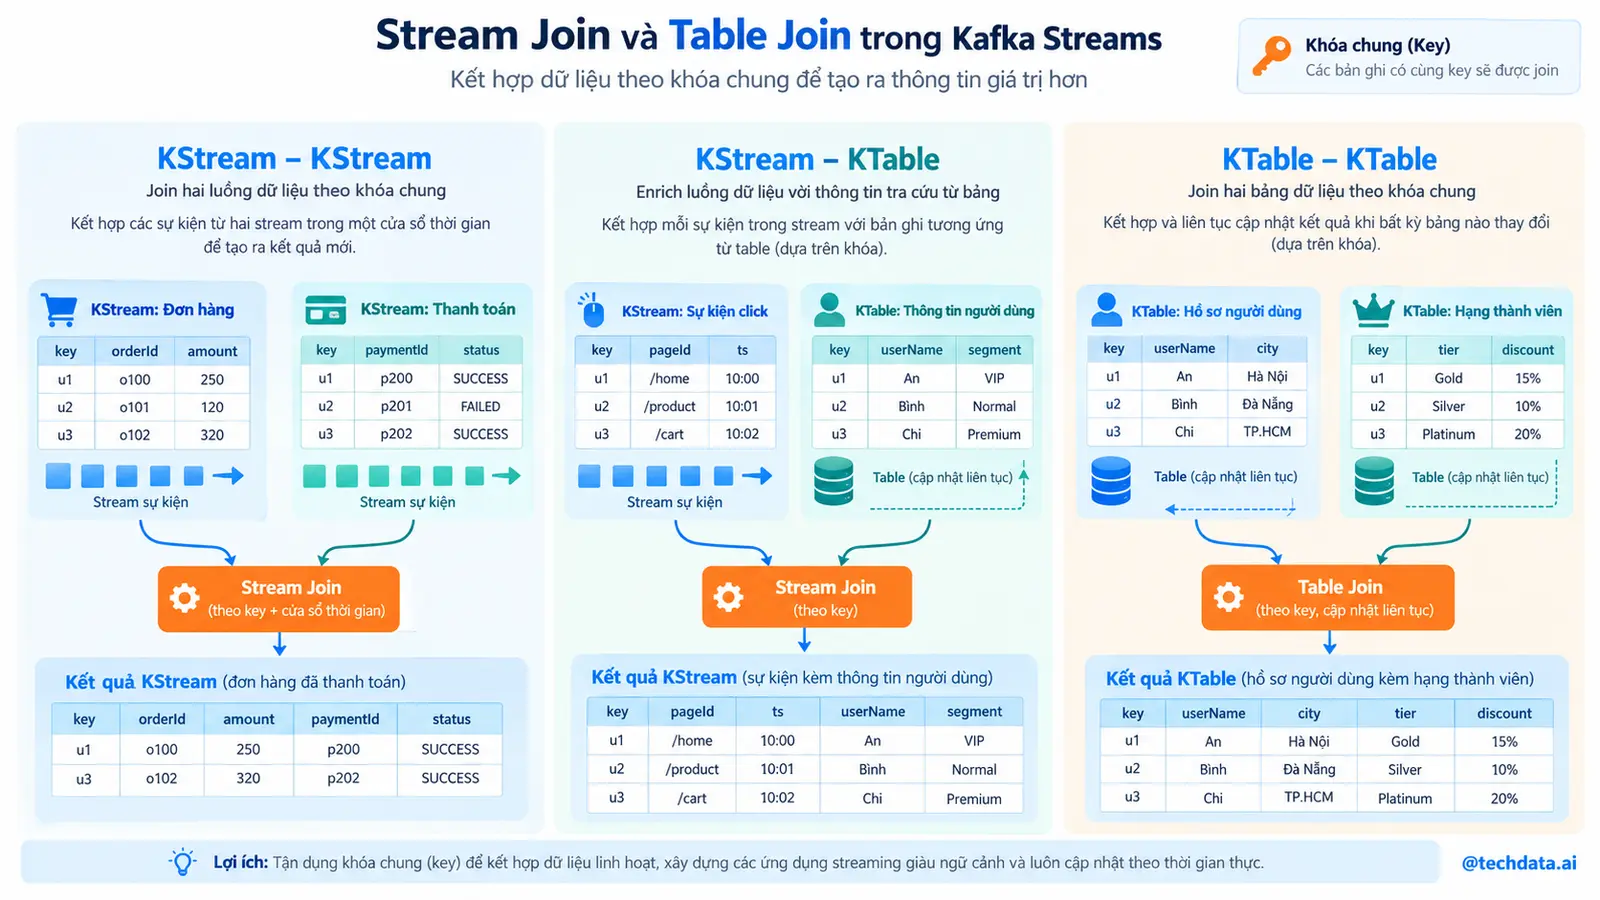
KStream với KTable thường dùng để enrich Event bằng trạng thái hiện tại. Ví dụ đơn hàng kết hợp hồ sơ khách hàng.
KStream<String, EnrichedOrder> enriched = orders.join(
    customers,
    (order, customer) -> EnrichedOrder.of(order, customer)
);
Hai nguồn cần Key tương thích. Nếu orders dùng order_id còn customers dùng customer_id, phải rekey orders trước.
Stream Stream Join cần Window vì hai Event có thể đến tại thời điểm khác nhau. Table Table Join tạo bảng kết quả cập nhật khi một trong hai phía thay đổi.
Co-partitioning yêu cầu số Partition và partitioning strategy tương thích. Nếu không, ứng dụng cần repartition hoặc dùng GlobalKTable cho dữ liệu tham chiếu nhỏ.
12. State Store và Changelog Topic
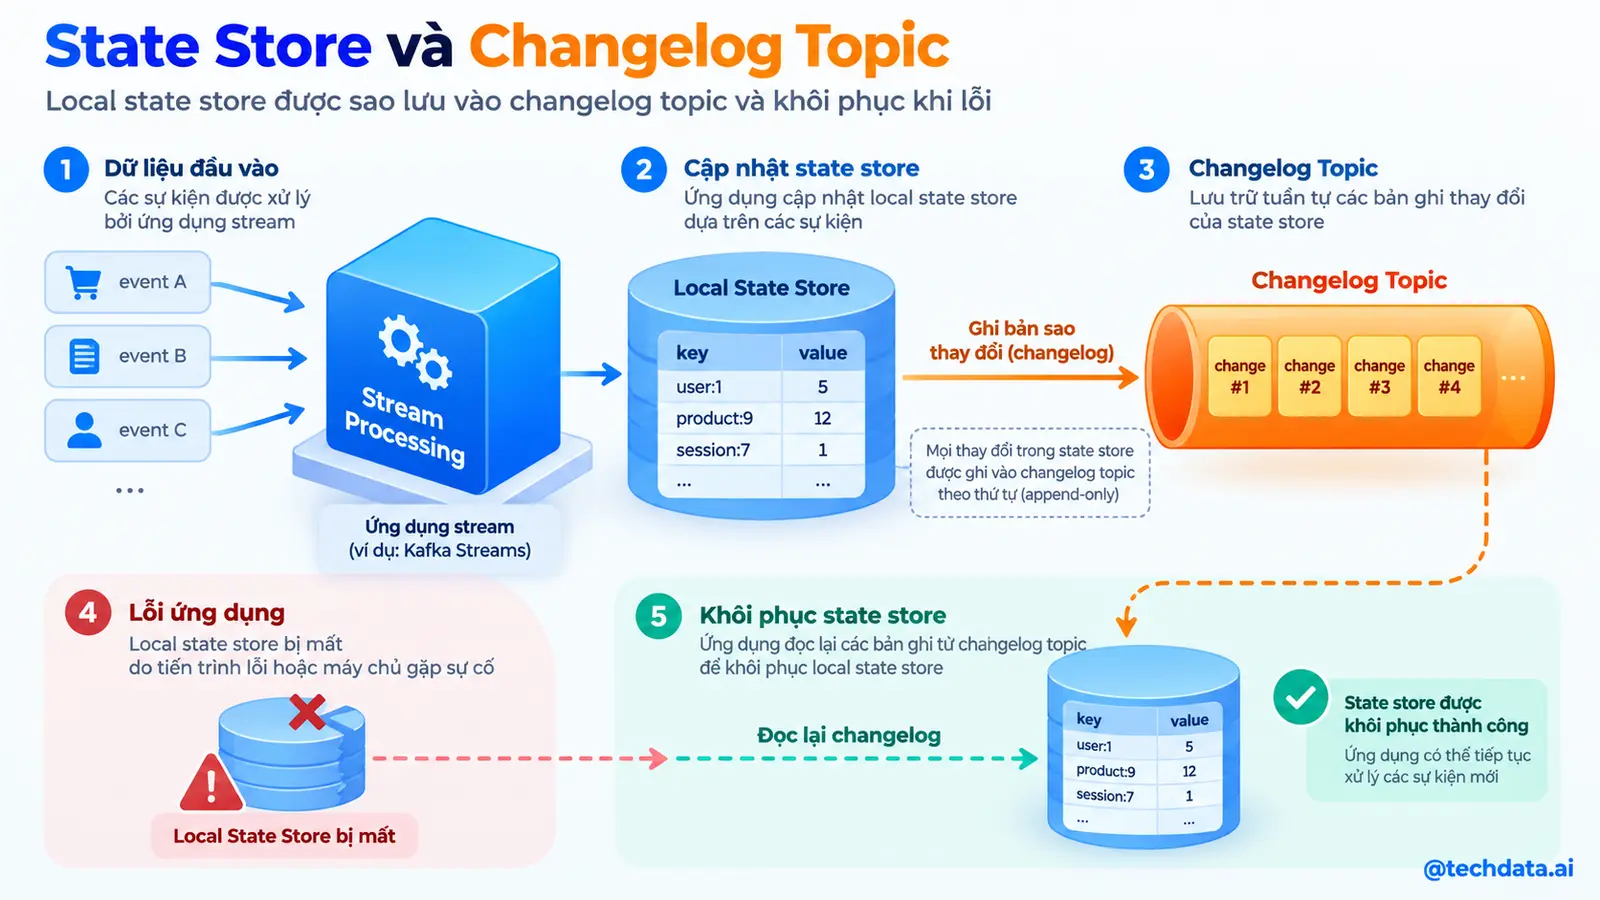
State Store lưu Aggregate, Window hoặc bảng đã materialize. Local Store cho phép xử lý nhanh mà không gọi database từ xa cho mỗi record.
Changelog Topic ghi lại thay đổi state. Khi Task chuyển sang instance khác, Kafka Streams replay Changelog để phục hồi Store.
Thời gian phục hồi phụ thuộc:
- Kích thước State Store.
- Tốc độ đọc Changelog.
- Disk và network.
- Số Task phục hồi đồng thời.
- Standby Replica.
Production nên sử dụng persistent volume phù hợp hoặc chấp nhận thời gian restore. Không nên coi local state là cache không quan trọng nếu ứng dụng phụ thuộc vào nó.
Interactive Queries cho phép truy vấn State Store, nhưng caller cần định tuyến đến instance đang giữ Key. Đây là kiến trúc nâng cao và cần service discovery.
13. Repartition Topic
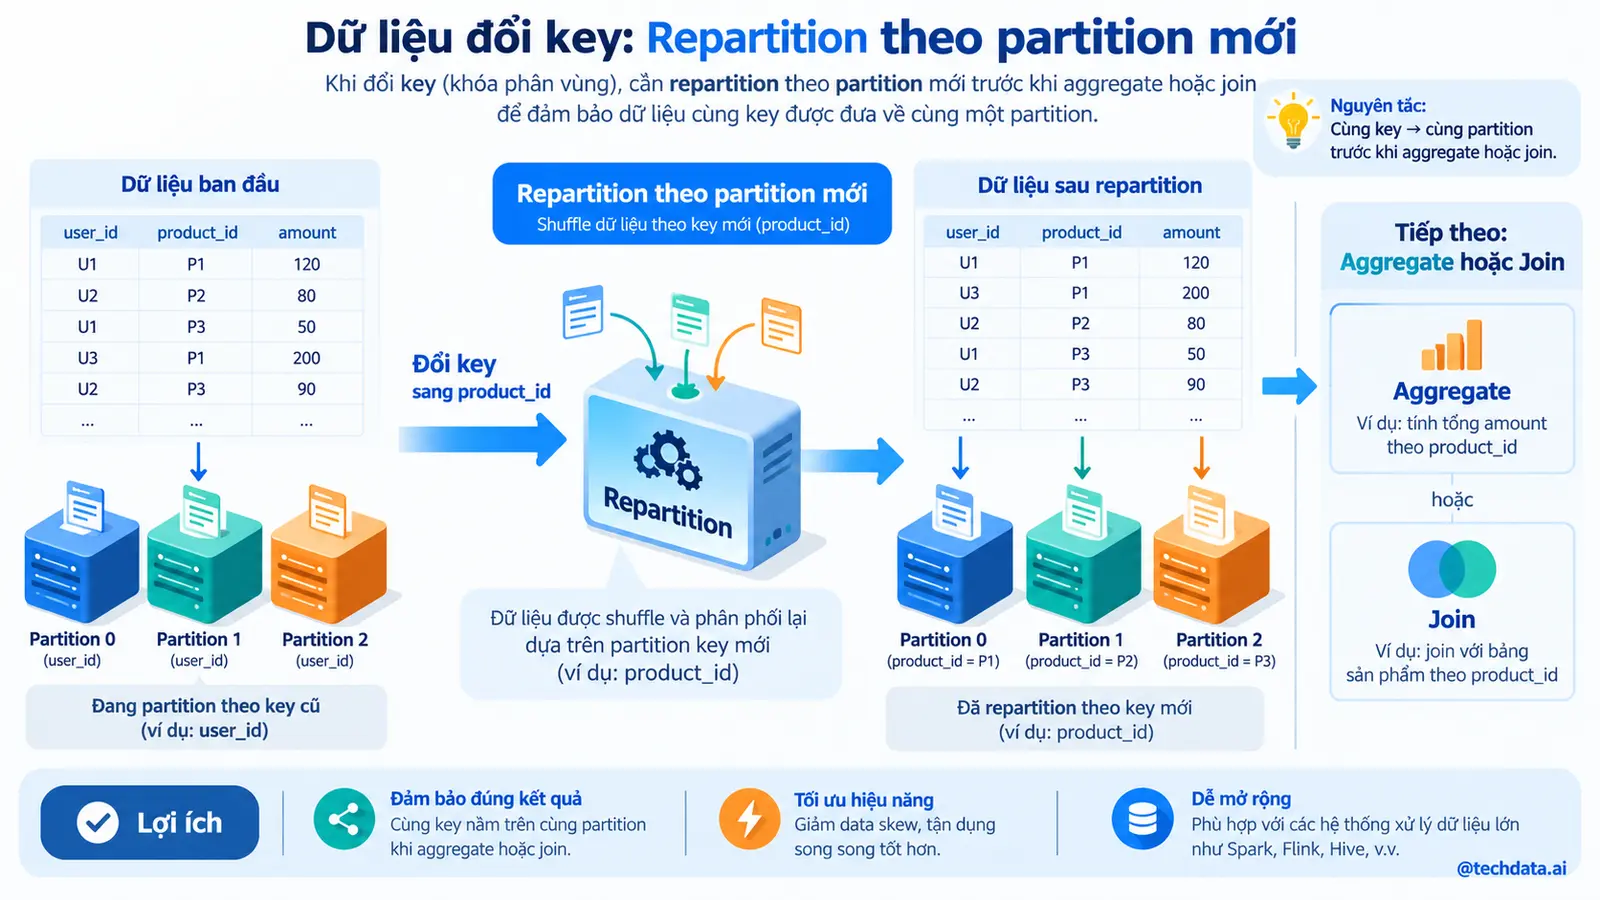
Khi một operation thay đổi Key trước Group hoặc Join, dữ liệu phải được phân phối lại. Kafka Streams ghi vào Internal Repartition Topic rồi đọc lại.
Repartition tạo thêm network, storage và latency. Topology có nhiều lần đổi Key có thể tốn chi phí lớn.
Hãy kiểm tra Topology Description:
System.out.println(builder.build().describe());Tối ưu bằng cách chọn Key phù hợp từ Producer, kết hợp các operation liên tiếp và tránh repartition không cần thiết. Không xóa Internal Topic khi ứng dụng đang hoạt động.
14. Exactly Once Processing
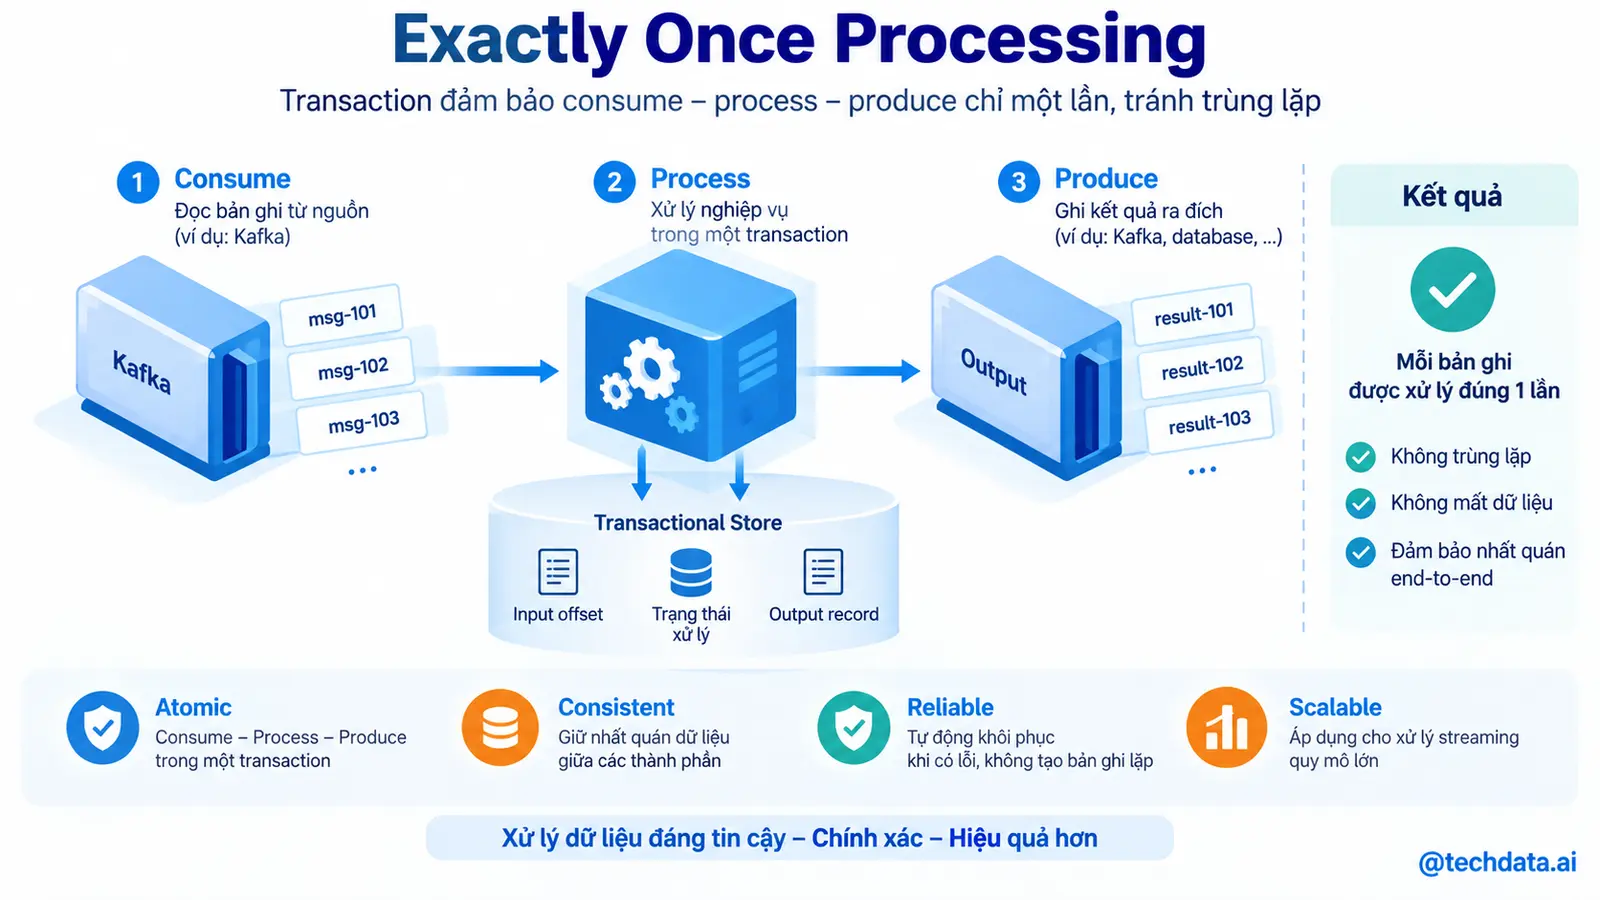
Kafka Streams có chế độ Exactly Once để phối hợp input Offset, State Store Changelog và output record trong Kafka Transaction.
Cấu hình:
props.put(
    StreamsConfig.PROCESSING_GUARANTEE_CONFIG,
    StreamsConfig.EXACTLY_ONCE_V2
);
Exactly Once bảo đảm trong phạm vi Kafka Streams và Kafka. Nếu Processor gọi REST API hoặc ghi database ngoài Transaction Kafka, tác động ngoài đó vẫn cần idempotency.
Chế độ này tăng chi phí Transaction. Cần benchmark throughput và latency, đồng thời cấu hình Broker Transaction State Log phù hợp.
15. Xây dựng ứng dụng doanh thu thời gian thực
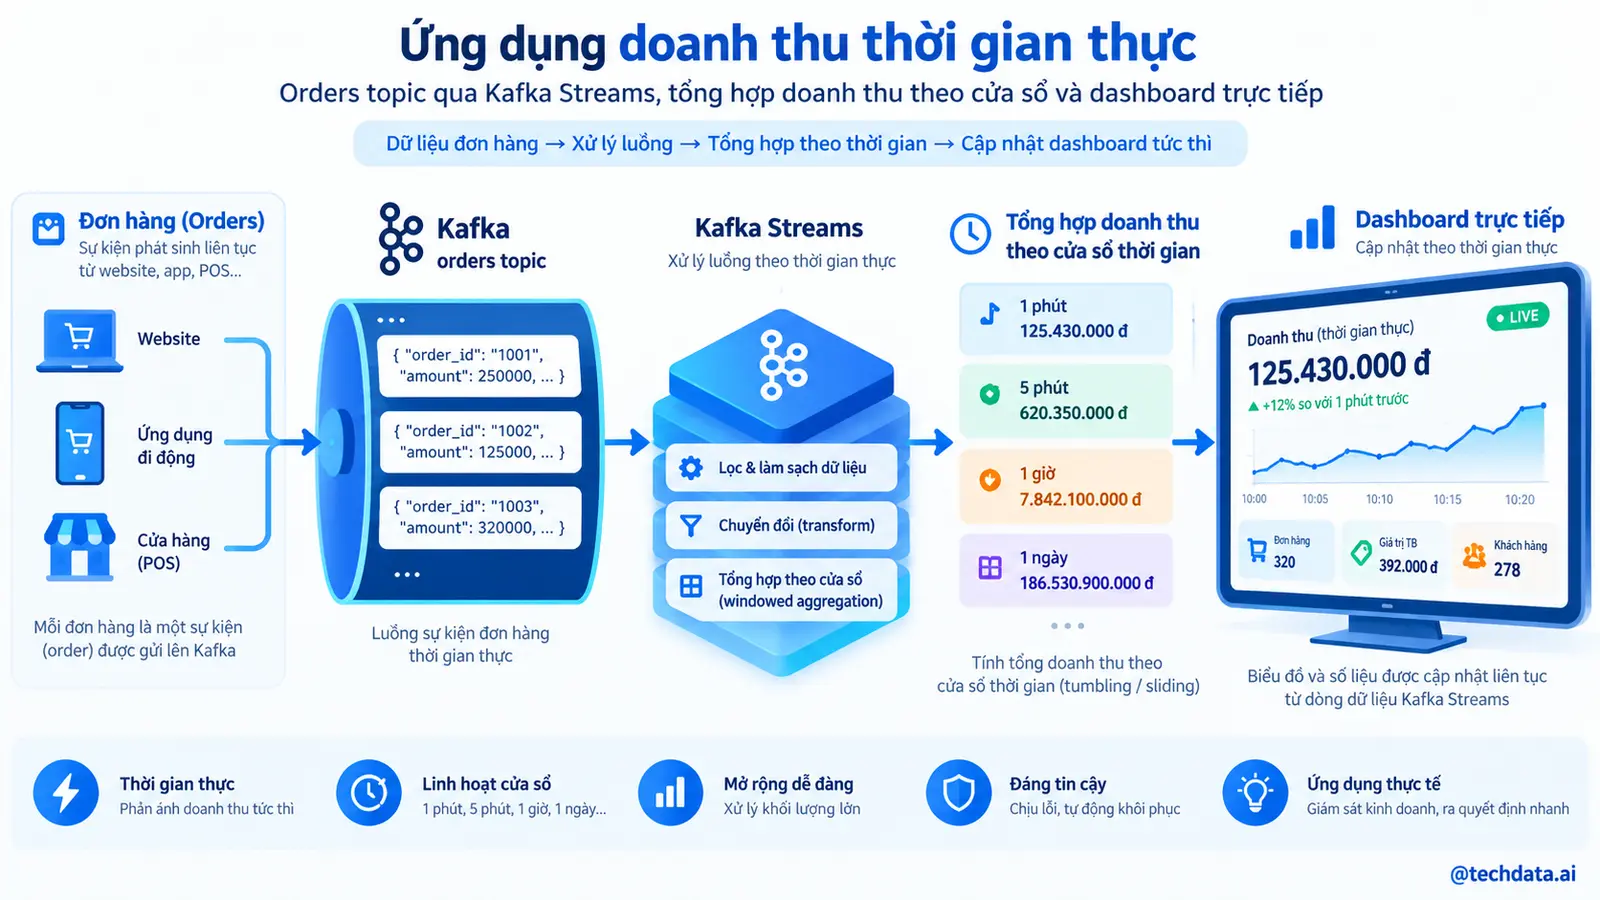
Yêu cầu:
- Đọc
payment-completed. - Chỉ nhận giao dịch thành công.
- Nhóm theo cửa hàng.
- Tính doanh thu theo cửa sổ năm phút.
- Cho phép Event đến muộn hai phút.
- Ghi kết quả vào
store-revenue-5m.
KStream<String, Payment> payments = builder.stream(
    "payment-completed",
    Consumed.with(Serdes.String(), paymentSerde)
);

payments
    .filter((key, payment) -> payment.status().equals("completed"))
    .selectKey((key, payment) -> payment.storeId())
    .groupByKey(Grouped.with(Serdes.String(), paymentSerde))
    .windowedBy(
        TimeWindows
            .ofSizeAndGrace(
                Duration.ofMinutes(5),
                Duration.ofMinutes(2)
            )
    )
    .aggregate(
        () -> 0L,
        (storeId, payment, total) -> total + payment.amount(),
        Materialized.with(Serdes.String(), Serdes.Long())
    )
    .toStream()
    .to("store-revenue-5m", Produced.with(windowedSerde, Serdes.Long()));
Production cần xử lý refund, currency, duplicate và điều chỉnh giao dịch. Tổng doanh thu không nên chỉ cộng mọi Event nếu cùng Payment có thể phát lại.
16. Scale và phục hồi
Kafka Streams scale bằng nhiều instance có cùng application.id. application.id cũng xác định Consumer Group và tên Internal Topic, vì vậy không nên đổi tùy tiện.
Số active Task bị giới hạn bởi Partition đầu vào. Thêm instance vượt số Task không tăng throughput, nhưng có thể dùng làm nơi chứa Standby Task.
Khi instance hỏng, Task được chuyển sang instance khác. State được phục hồi từ Changelog hoặc Standby Store. Cần đo Restore Time như một SLO vận hành.
17. Kafka Streams, Flink và Spark
Kafka Streams phù hợp khi:
- Dữ liệu chủ yếu nằm trong Kafka.
- Đội ngũ dùng Java hoặc Scala.
- Muốn deploy ứng dụng như microservice.
- Topology không cần Cluster Compute riêng.
Apache Flink phù hợp với Event Time phức tạp, nhiều nguồn, state lớn và nhu cầu Stream Processing chuyên sâu.
Spark Structured Streaming phù hợp khi tổ chức đã dùng Spark, cần kết hợp Batch và Streaming, hoặc xử lý gắn với Data Lake.
Lựa chọn cần dựa trên use case, kỹ năng và vận hành, không dựa trên bảng tính năng đơn giản.
18. Testing và Monitoring
TopologyTestDriver cho phép kiểm thử Topology không cần Cluster thật. Test cần bao phủ record đúng, record lỗi, dữ liệu đến muộn, duplicate, Window và Join.
Integration Test vẫn cần Kafka thật để kiểm tra serialization, Internal Topic và Rebalance.
Metrics quan trọng:
- Process Rate.
- Process Latency.
- Commit Rate.
- Poll Latency.
- State Restore Rate.
- Rebalance Count.
- Record Lateness.
- Dropped Record Rate.
- Changelog và Repartition throughput.
19. Lỗi thường gặp
- Nhầm KStream với KTable.
- Aggregate Event lặp mà không deduplicate.
- Chọn Grace Period tùy ý.
- Không kiểm tra Internal Topic.
- Đổi
application.idvà vô tình tạo ứng dụng mới đọc lại dữ liệu. - Dùng GlobalKTable cho bảng quá lớn.
- Gọi API chậm trong Processor và làm Task nghẽn.
- Tin rằng Exactly Once bao phủ database bên ngoài.
- Không tính thời gian restore State Store.
20. Tổng kết
Kafka Streams biến Topic thành ứng dụng xử lý dữ liệu thời gian thực. KStream biểu diễn chuỗi Event, KTable biểu diễn trạng thái theo Key, Window giới hạn tính toán theo thời gian và State Store duy trì dữ liệu cần cho Aggregate hoặc Join.
Các điểm cần nhớ:
- Kafka Streams là thư viện, không phải Cluster riêng.
- Stateful Processing sử dụng State Store và Changelog.
- Đổi Key thường tạo Repartition.
- Event Time và Grace quyết định xử lý dữ liệu đến muộn.
- Scale bị giới hạn bởi số Task và Partition.
- Exactly Once chỉ có phạm vi cụ thể.
- Topology cần test cả dữ liệu trễ, duplicate và failure.
Bài cuối sẽ triển khai Kafka Production với Security, Monitoring, Capacity Planning, High Availability và Disaster Recovery.
21. Câu hỏi ôn tập
- KStream và KTable khác nhau thế nào?
- Khi nào nên dùng GlobalKTable?
- Vì sao Aggregate cần State Store?
- Changelog Topic có vai trò gì?
- Grace Period giải quyết vấn đề nào?
- Khi nào Kafka Streams tạo Repartition Topic?
application.idảnh hưởng những thành phần nào?- Exactly Once của Kafka Streams có bao phủ REST API không?
22. Tài liệu tham khảo
- Apache Kafka Streams: https://kafka.apache.org/documentation/streams/
- Kafka Streams Core Concepts: https://kafka.apache.org/documentation/streams/core-concepts
- Kafka Streams Developer Guide: https://kafka.apache.org/documentation/streams/developer-guide/
- Kafka Streams Configuration: https://kafka.apache.org/documentation/#streamsconfigs
- Apache Flink Documentation: https://flink.apache.org/what-is-flink/flink-architecture/
Hoàng Minh | TechData.AI