



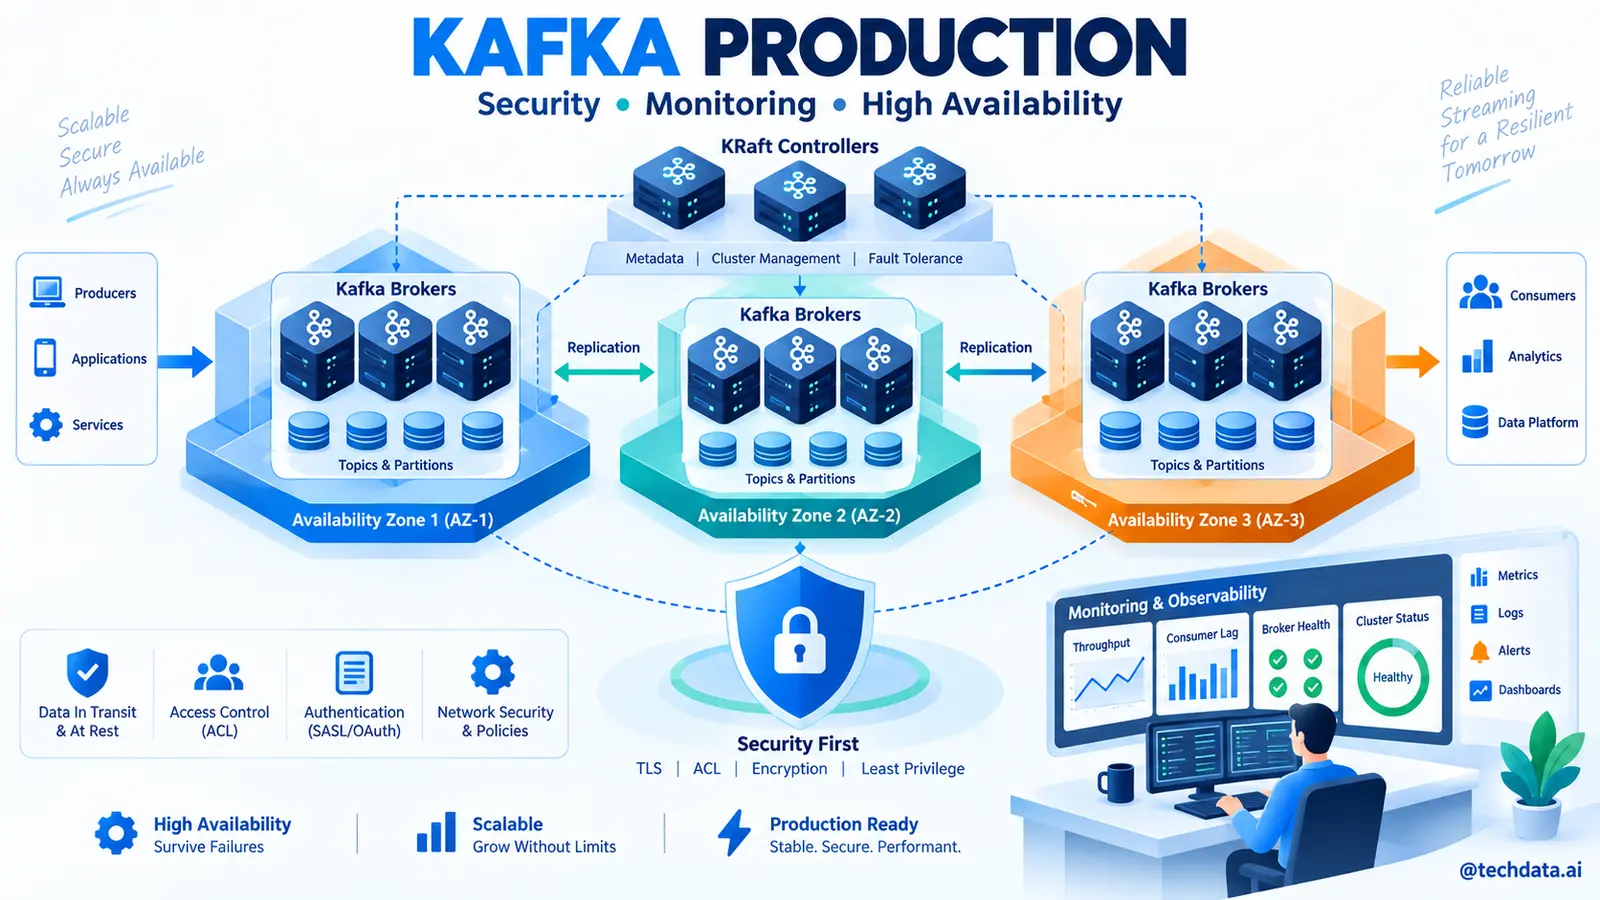

Đơn vị biên soạn: TechData.AI
Chủ đề: Kafka Production Architecture và Operations
Đối tượng: Data Engineer, Platform Engineer, DevOps Engineer và Solution Architect
Phiên bản tham chiếu: Apache Kafka 4.x
MỤC LỤC
- Mục tiêu bài học
- Production khác môi trường thực hành như thế nào
- Kiến trúc Broker và Controller
- Capacity Planning
- Storage và filesystem
- Network và giới hạn băng thông
- High Availability
- Rack Awareness
- Authentication
- Encryption bằng TLS
- Authorization bằng ACL
- Quản lý Secret
- Monitoring Broker
- Monitoring Producer và Consumer
- Logging và Audit
- Alerting và SLO
- Backup và Disaster Recovery
- Multi-cluster và replication
- Rolling Upgrade
- Quy trình Incident Response
- Checklist Production
- Tổng kết
- Câu hỏi ôn tập
- Tài liệu tham khảo
1. Mục tiêu bài học
Một Kafka Cluster chạy được chưa phải một Kafka Platform sẵn sàng cho Production. Production yêu cầu khả năng chịu lỗi, bảo mật, quan sát, mở rộng, phục hồi và quy trình vận hành rõ ràng.
Bài cuối tổng hợp toàn bộ series thành kiến trúc triển khai thực tế. Học viên sẽ biết cách tách Controller và Broker, ước lượng dung lượng, bảo vệ kết nối bằng TLS và SASL, cấp quyền bằng ACL, theo dõi Consumer Lag, thiết kế Disaster Recovery và thực hiện Rolling Upgrade.
2. Production khác môi trường thực hành như thế nào
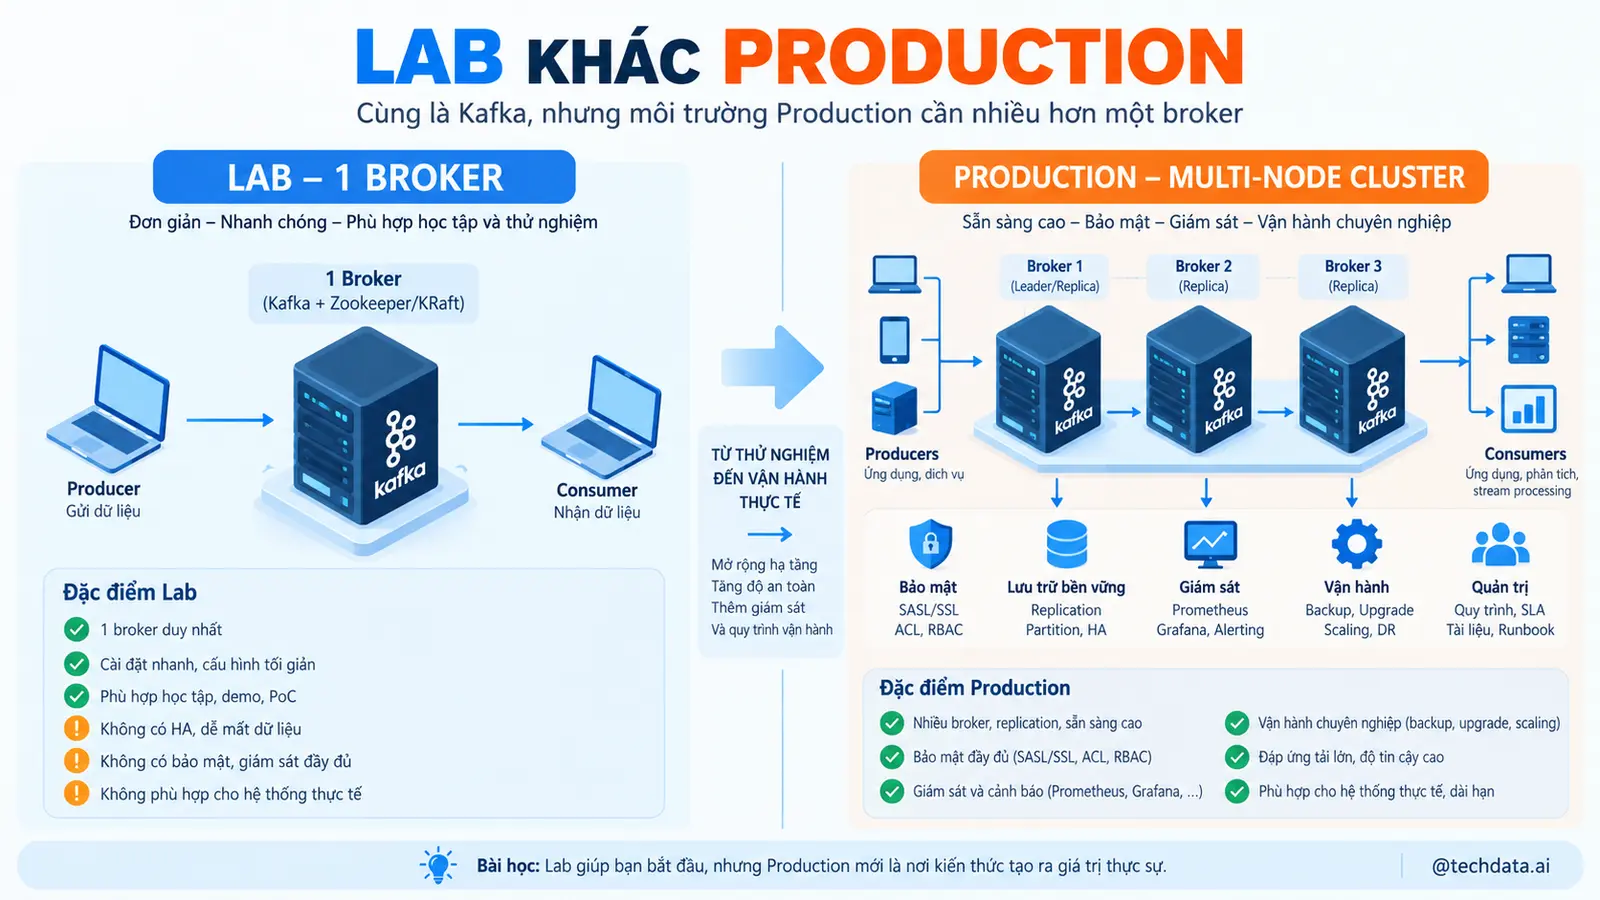
Môi trường Docker một Broker ưu tiên đơn giản. Production ưu tiên mục tiêu dịch vụ và quản trị rủi ro.
Production cần trả lời:
- Nếu một Broker hỏng, hệ thống có tiếp tục ghi và đọc không?
- Nếu một Availability Zone mất, dữ liệu còn đủ Replica không?
- Ai được tạo Topic?
- Producer nào được ghi vào Topic thanh toán?
- Consumer nào được đọc dữ liệu khách hàng?
- Lag bao nhiêu thì cảnh báo?
- Ổ đĩa đầy sau bao lâu?
- Phục hồi Cluster trong bao lâu?
- Dữ liệu có thể mất tối đa bao nhiêu?
- Nâng cấp Kafka có cần downtime không?
Nếu chưa có câu trả lời, hệ thống vẫn đang ở mức thử nghiệm dù dùng nhiều máy chủ.
3. Kiến trúc Broker và Controller
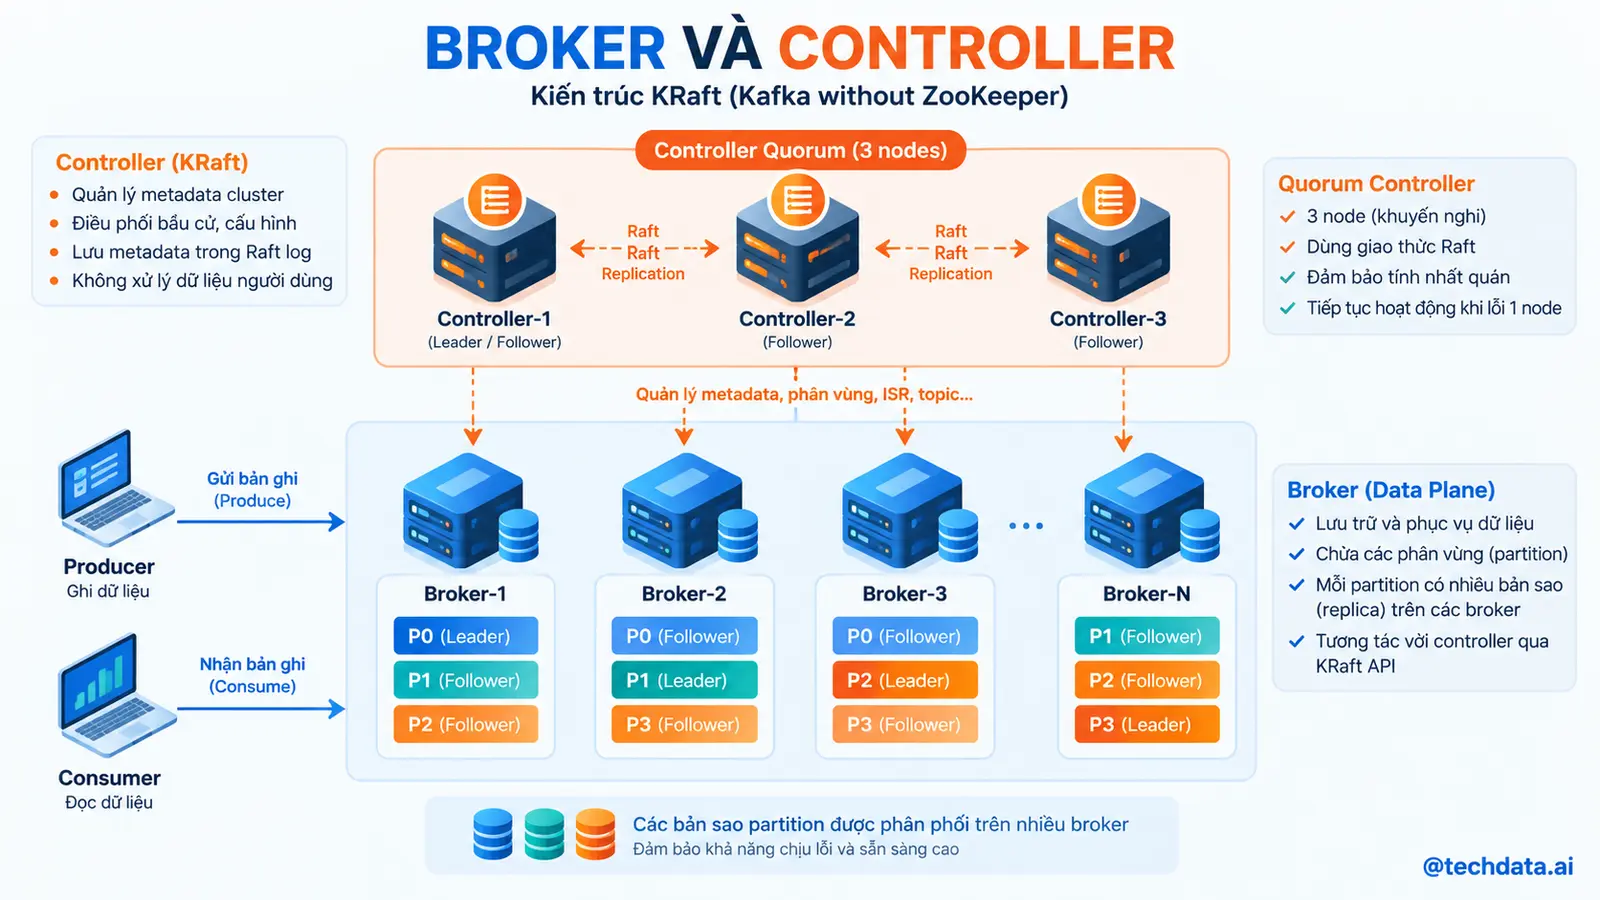
Kafka 4 sử dụng KRaft. Production thường tách Controller khỏi Broker.
Controller Quorum nên có số Node lẻ, thường là ba hoặc năm. Quorum ba Controller chịu được một Node mất. Quorum năm chịu được hai Node mất nhưng tăng chi phí và latency phối hợp.
Broker lưu Partition và xử lý request Client. Số Broker phụ thuộc throughput, storage, Replication Factor và Failure Domain.
Một kiến trúc khởi đầu có thể gồm:
- Ba Controller chuyên dụng.
- Ba hoặc nhiều Broker.
- Ba Availability Zone nếu hạ tầng hỗ trợ.
- Kafka Connect Cluster riêng.
- Schema Registry có High Availability.
- Monitoring và Log Platform riêng.
Không đặt tất cả thành phần trên cùng một máy chỉ để có sơ đồ nhiều Node. Fault Domain vật lý mới quyết định khả năng chịu lỗi.
4. Capacity Planning
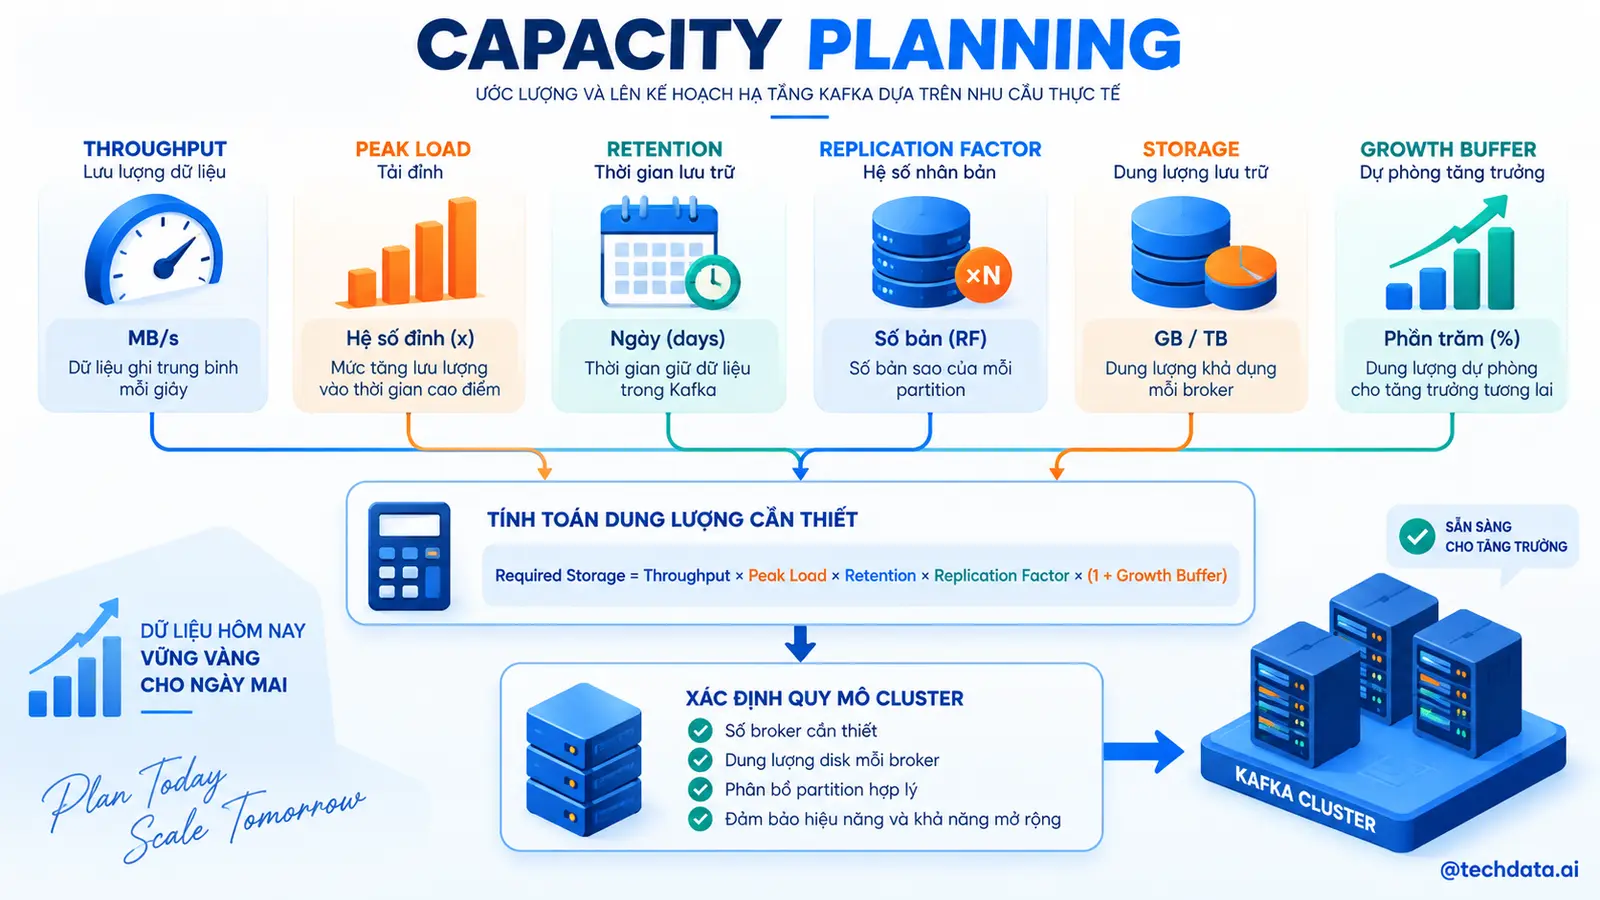
Capacity Planning cần dữ liệu đầu vào:
- Event mỗi giây ở mức trung bình và cao điểm.
- Kích thước Event trước và sau compression.
- Retention theo Topic.
- Replication Factor.
- Số Consumer Group.
- Tốc độ tăng trưởng.
- Thời gian phục hồi mục tiêu.
Ước lượng dung lượng:
daily_ingest = events_per_second x average_event_size x 86,400

raw_storage = daily_ingest x retention_days

cluster_storage = raw_storage x replication_factor
Sau đó cộng index, biên an toàn, dữ liệu tăng trưởng và khoảng trống khi tái phân phối Replica.
Ví dụ, 20.000 Event mỗi giây, trung bình 1 KB tạo khoảng 1,728 TB dữ liệu thô mỗi ngày trước khi xét cách đo KB và compression. Retention bảy ngày cùng Replication Factor 3 cần hàng chục TB sau khi cộng overhead và dự phòng.
Không mua hạ tầng chỉ theo dung lượng. Broker còn bị giới hạn bởi network, disk throughput, CPU compression, số Partition và request rate.
5. Storage và filesystem
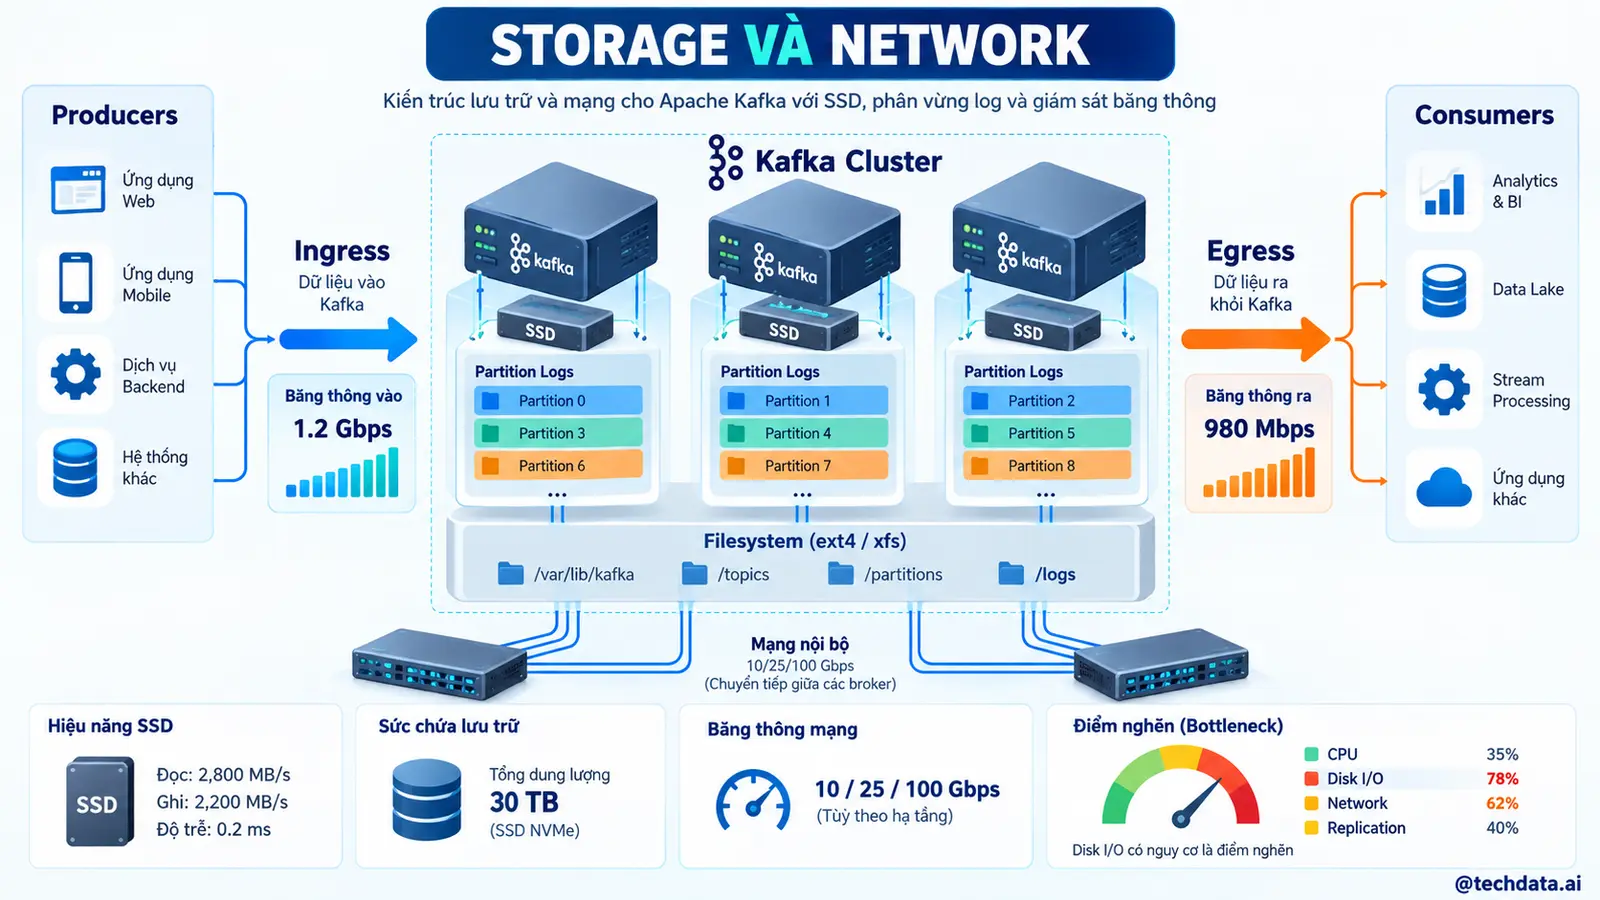
Kafka phụ thuộc mạnh vào I/O tuần tự và Page Cache. Ổ NVMe cho throughput cùng latency tốt, nhưng lựa chọn còn phụ thuộc ngân sách và retention.
Cần theo dõi:
- Disk utilization.
- Disk latency.
- Read và Write throughput.
- I/O wait.
- Page Cache.
- Log directory failure.
Không để ổ đĩa gần đầy. Khi Broker hỏng, Cluster cần tài nguyên để Leader Election, Replica Catch-up và Reassignment.
Nhiều log directory trên một Broker có thể phân phối Partition giữa các disk, nhưng không thay thế Replica trên Broker khác. Nếu máy chủ hỏng, mọi disk trên máy đều mất khả dụng.
Kafka không yêu cầu RAID cho mọi kiến trúc vì Replication đã bảo vệ ở tầng ứng dụng, nhưng quyết định RAID phụ thuộc hạ tầng, tốc độ thay disk, chi phí và Failure Model.
6. Network và giới hạn băng thông
Network phục vụ:
- Producer ghi dữ liệu.
- Consumer đọc dữ liệu.
- Follower sao chép từ Leader.
- Replica Reassignment.
- State Restore và Kafka Connect.
Nếu một Event được ba Consumer Group đọc, lưu lượng đọc có thể gấp nhiều lần lưu lượng ghi. Replication cũng tạo lưu lượng giữa Broker.
Network thường trở thành bottleneck khi Broker phục hồi. Một Broker mới cần sao chép lượng dữ liệu lớn trong khi vẫn phục vụ tải Production.
Cần giới hạn tốc độ reassignment nếu việc phục hồi làm ảnh hưởng traffic chính. Đồng thời, giới hạn quá thấp kéo dài thời gian Cluster ở trạng thái thiếu Replica.
7. High Availability
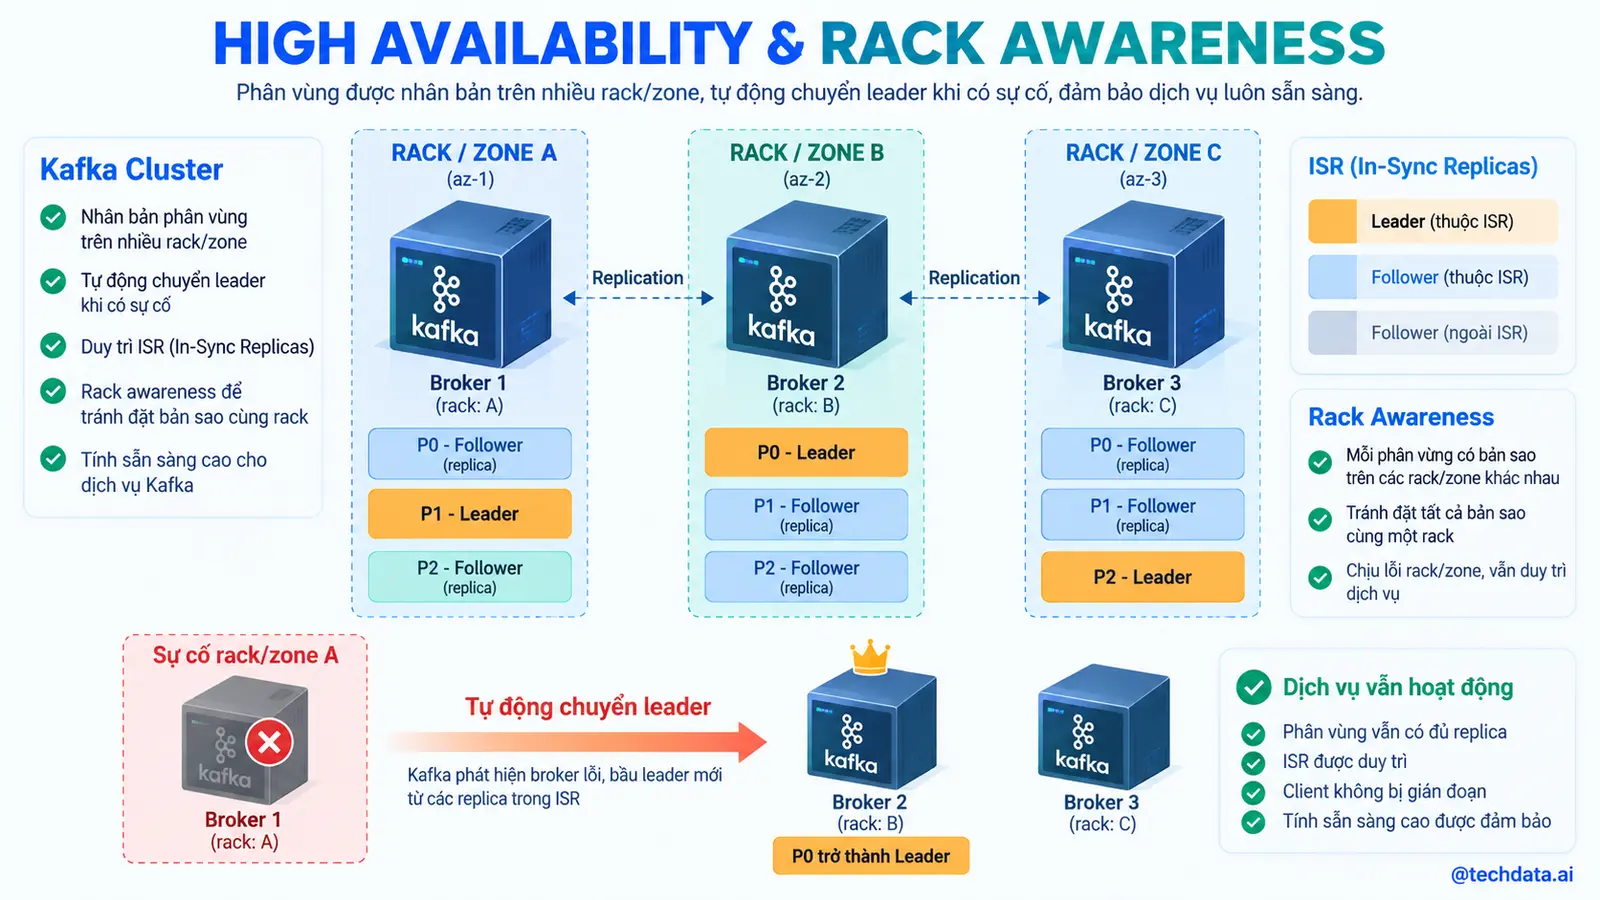
High Availability không chỉ là có ba Broker. Topic quan trọng cần:
- Replication Factor phù hợp.
- Replica phân phối giữa Broker.
min.insync.replicashợp lý.- Producer dùng
acks=all. - Unclean Leader Election được kiểm soát.
- Controller Quorum khỏe mạnh.
- Capacity đủ khi mất một Node.
Một cấu hình thường gặp:
replication.factor=3
min.insync.replicas=2
acks=all
Khi một Broker mất, Cluster vẫn có thể ghi nếu còn hai ISR. Nếu mất thêm Replica và ISR xuống dưới mức tối thiểu, Kafka từ chối ghi để bảo vệ Durability.
Doanh nghiệp phải quyết định ưu tiên Availability hay tránh mất dữ liệu theo từng nhóm Topic. Log ứng dụng và giao dịch tài chính có thể có chính sách khác nhau.
8. Rack Awareness
Rack Awareness giúp Kafka đặt Replica của cùng Partition ở các Failure Domain khác nhau.
Failure Domain có thể là:
- Rack vật lý.
- Availability Zone.
- Nhóm nguồn điện.
- Host Group.
Nếu ba Replica đều nằm trong một Zone, Replication Factor 3 không bảo vệ khỏi sự cố toàn Zone.
Mỗi Broker cần broker.rack phù hợp. Khi tạo hoặc reassignment Partition, Kafka sử dụng thông tin này để phân phối Replica.
Rack Awareness không tự động tạo Multi-region Disaster Recovery. Latency giữa Region thường cao hơn và cần kiến trúc replication riêng.
9. Authentication
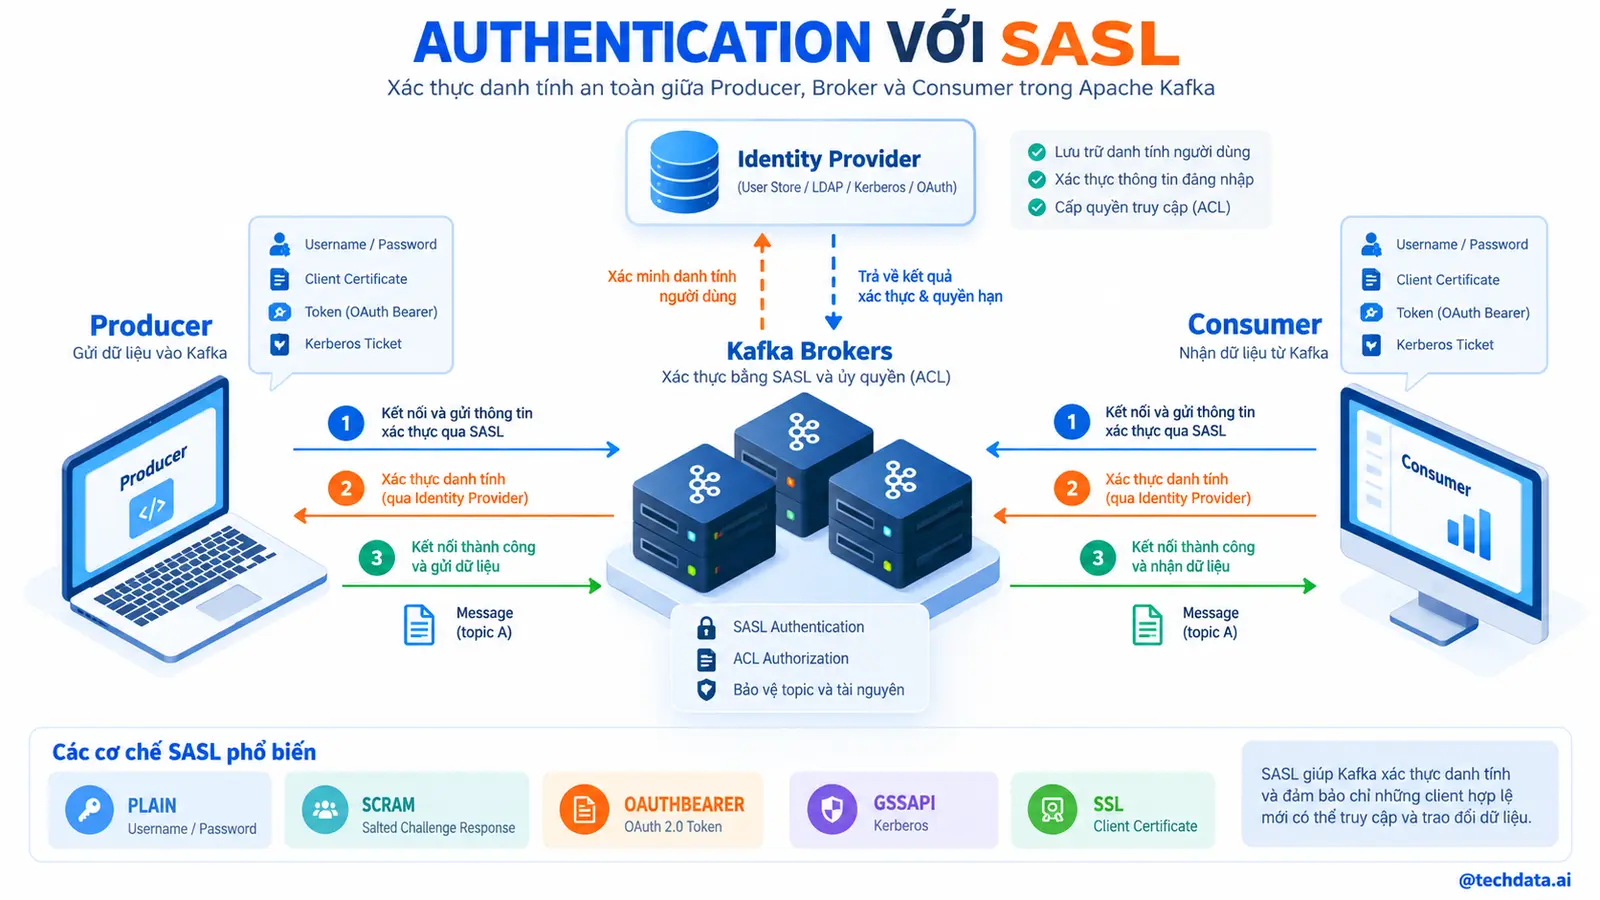
Authentication xác minh Client là ai. Kafka hỗ trợ nhiều cơ chế SASL như SCRAM, GSSAPI và OAUTHBEARER tùy môi trường.
Không dùng chung một tài khoản cho mọi Producer và Consumer. Mỗi ứng dụng hoặc nhóm dịch vụ nên có Principal riêng để:
- Thu hồi độc lập.
- Audit rõ ràng.
- Cấp quyền tối thiểu.
- Xoay credential có kiểm soát.
Trong môi trường hỗ trợ Identity Provider, OAuth có thể tích hợp danh tính tập trung. SCRAM đơn giản hơn nhưng cần quản lý password và rotation.
Chỉ bật Authentication mà không mã hóa network vẫn có thể để lộ credential hoặc dữ liệu. Authentication cần kết hợp TLS.
10. Encryption bằng TLS
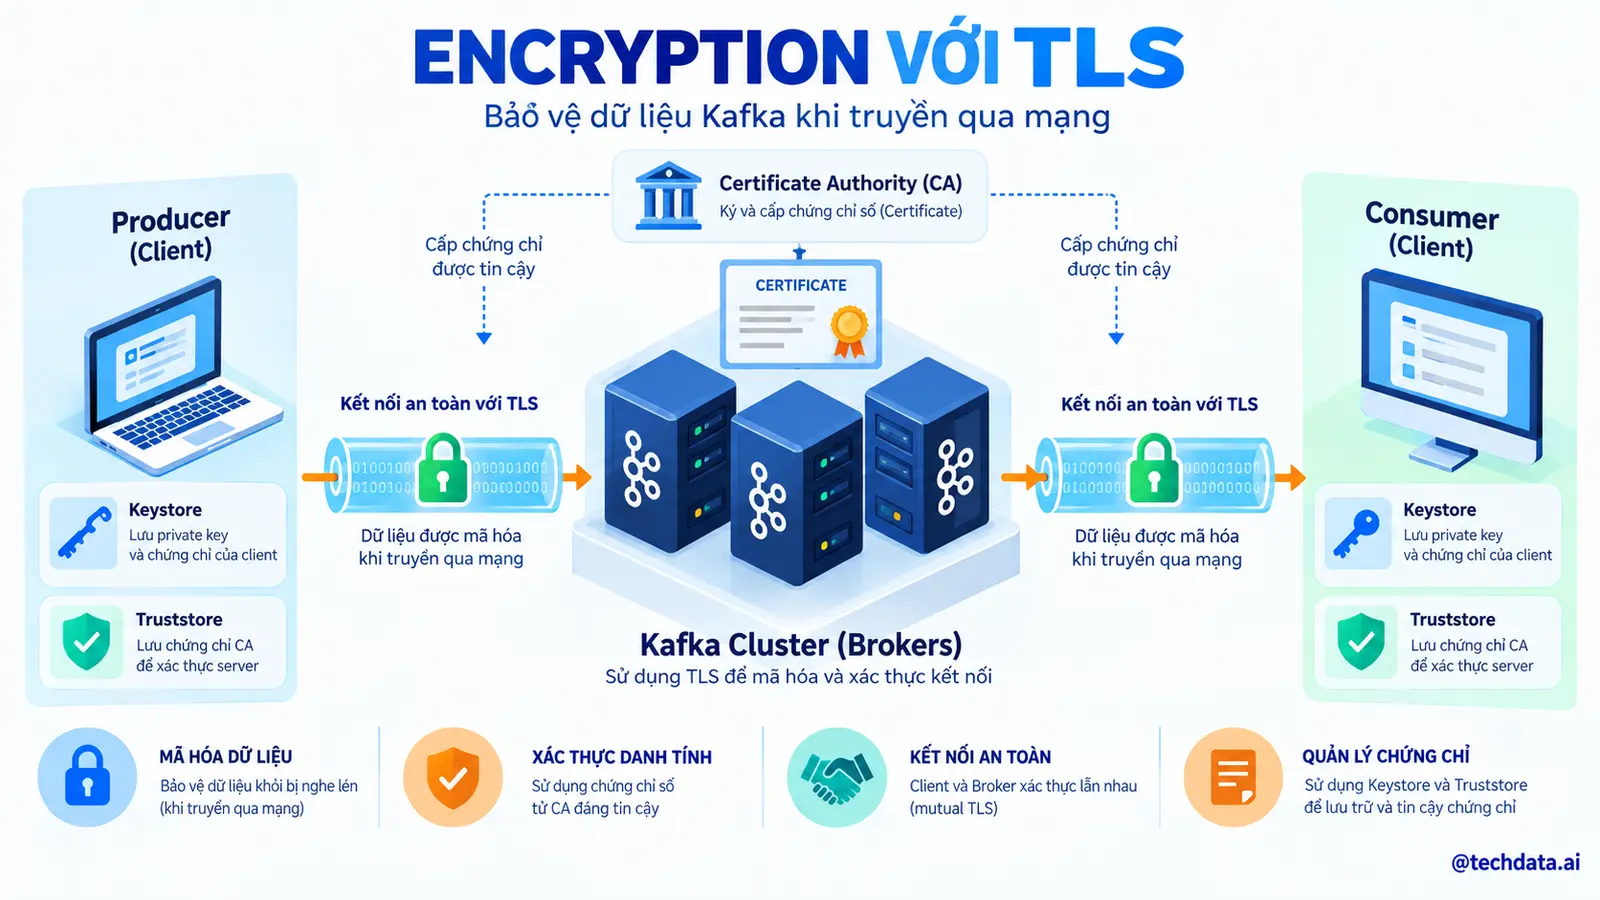
TLS bảo vệ dữ liệu khi truyền và xác thực Broker bằng certificate. Mutual TLS còn cho phép Broker xác thực certificate Client.
Production cần quản lý:
- Certificate Authority.
- Certificate của Broker.
- Hostname Verification.
- Truststore và Keystore.
- Thời hạn certificate.
- Rotation trước khi hết hạn.
- TLS version và cipher policy.
Một lỗi phổ biến là tắt hostname verification để kết nối cho nhanh. Điều này làm giảm giá trị bảo mật của TLS. Hãy cấp certificate có Subject Alternative Name đúng với DNS Client sử dụng.
Theo dõi ngày hết hạn và thử quy trình rotation trước khi Production. Certificate hết hạn có thể làm toàn bộ Client mất kết nối cùng lúc.
11. Authorization bằng ACL
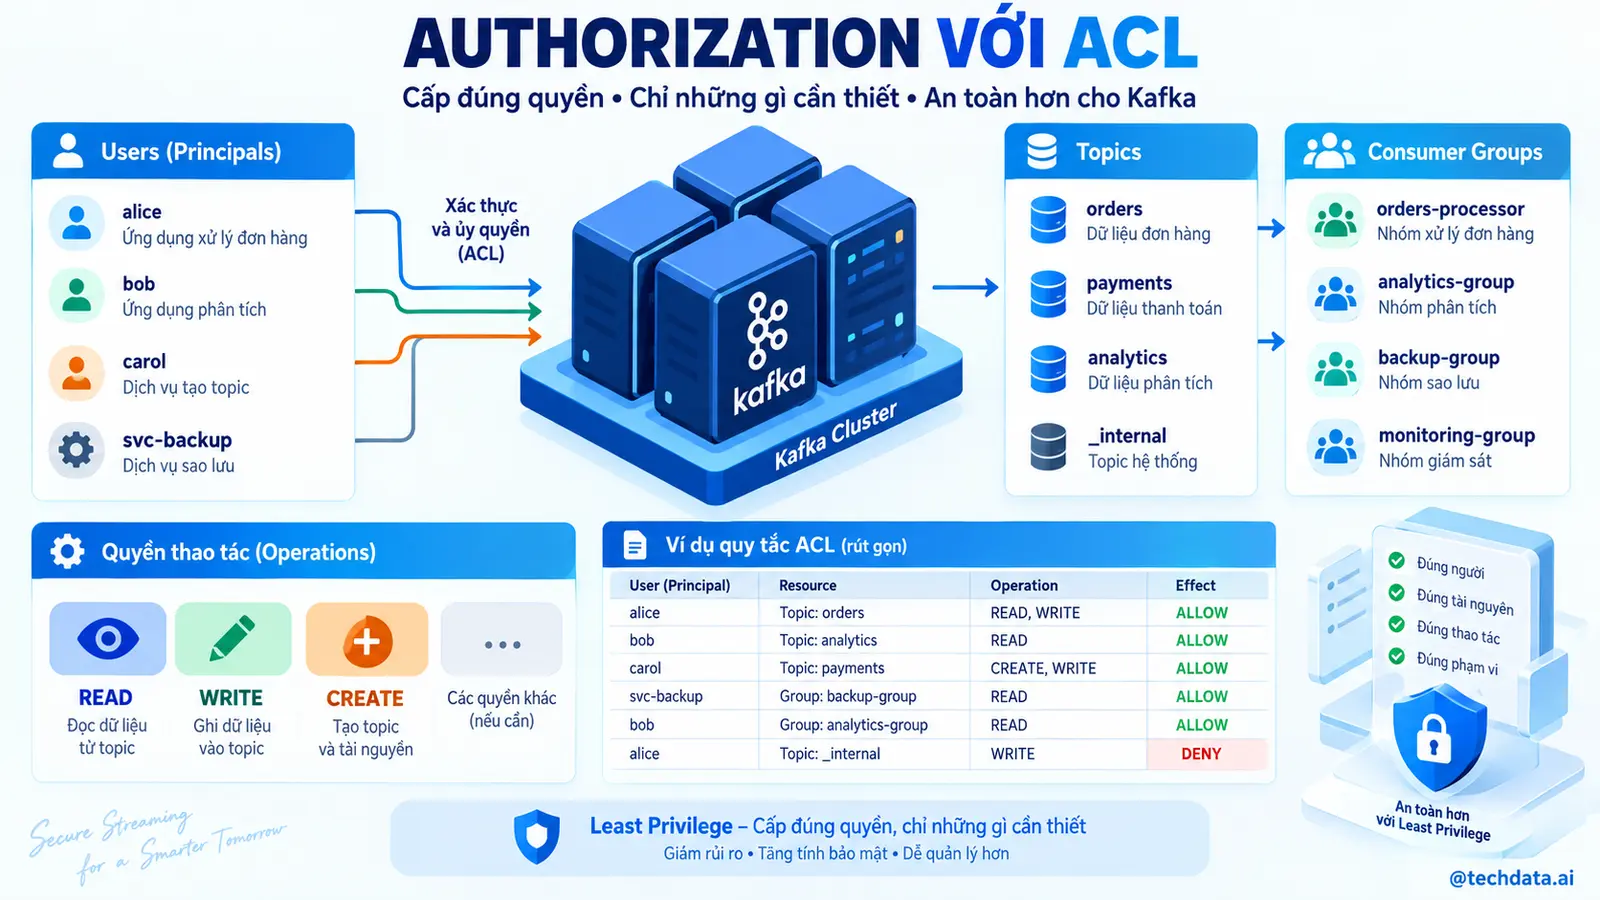
Authorization quyết định Principal được làm gì. Kafka ACL có thể kiểm soát quyền đọc, ghi, tạo, mô tả Topic và sử dụng Consumer Group.
Nguyên tắc Least Privilege:
- Order Service chỉ được ghi
order-created. - Inventory Service chỉ được đọc Topic cần thiết bằng Group đã định.
- Data Platform Admin mới được tạo hoặc thay đổi Topic.
- Kafka Connect được cấp quyền cho Topic dữ liệu và Topic nội bộ của Connect.
Không cấp wildcard rộng vì tiện triển khai. Quyền quá rộng khiến một credential bị lộ có thể đọc toàn bộ dữ liệu hoặc xóa tài nguyên quan trọng.
ACL nên được quản lý bằng code và review qua Git thay vì chỉnh thủ công không có lịch sử.
12. Quản lý Secret
Secret gồm password, token, private key và credential của Connector.
Nguyên tắc:
- Không ghi Secret vào source code.
- Không đưa Secret vào Docker Image.
- Không hiển thị Secret trong log.
- Dùng Secret Manager hoặc Kubernetes Secret có mã hóa phù hợp.
- Xoay vòng định kỳ.
- Phân quyền người và workload riêng.
- Có quy trình thu hồi khẩn cấp.
Kafka Connect cần đặc biệt chú ý vì cấu hình Connector có thể chứa database password. REST API Connect phải được bảo vệ và không công khai ra Internet.
13. Monitoring Broker
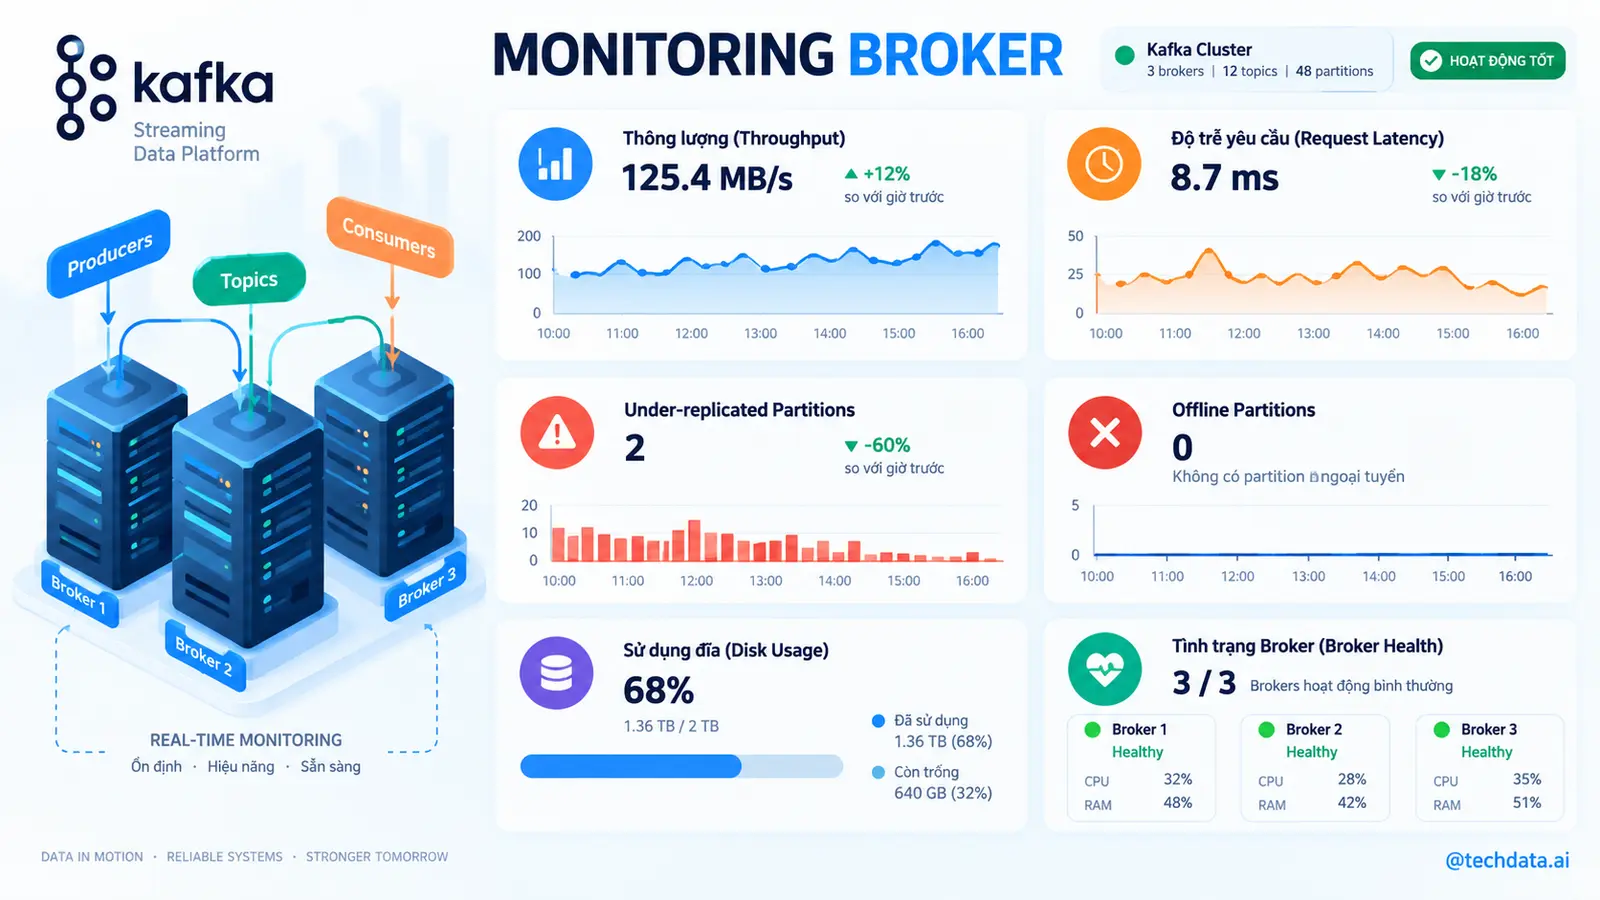
Các nhóm metric quan trọng:
Availability
- Active Controller Count.
- Offline Partition Count.
- Under Replicated Partition.
- Under Min ISR Partition.
- ISR Shrink và Expand.
Performance
- Bytes In và Bytes Out.
- Requests Per Second.
- Request Latency.
- Network Processor Idle.
- Request Handler Idle.
Storage
- Disk usage.
- Log size theo Topic.
- I/O latency.
- Log directory failure.
KRaft
- Controller Quorum health.
- Metadata Log lag.
- Broker registration.
- Controller election.
Một metric riêng lẻ không đủ. Under Replicated Partition tăng cùng Disk Latency thường gợi ý bottleneck storage. Request Latency tăng nhưng disk bình thường có thể liên quan network, quota hoặc GC.
14. Monitoring Producer và Consumer
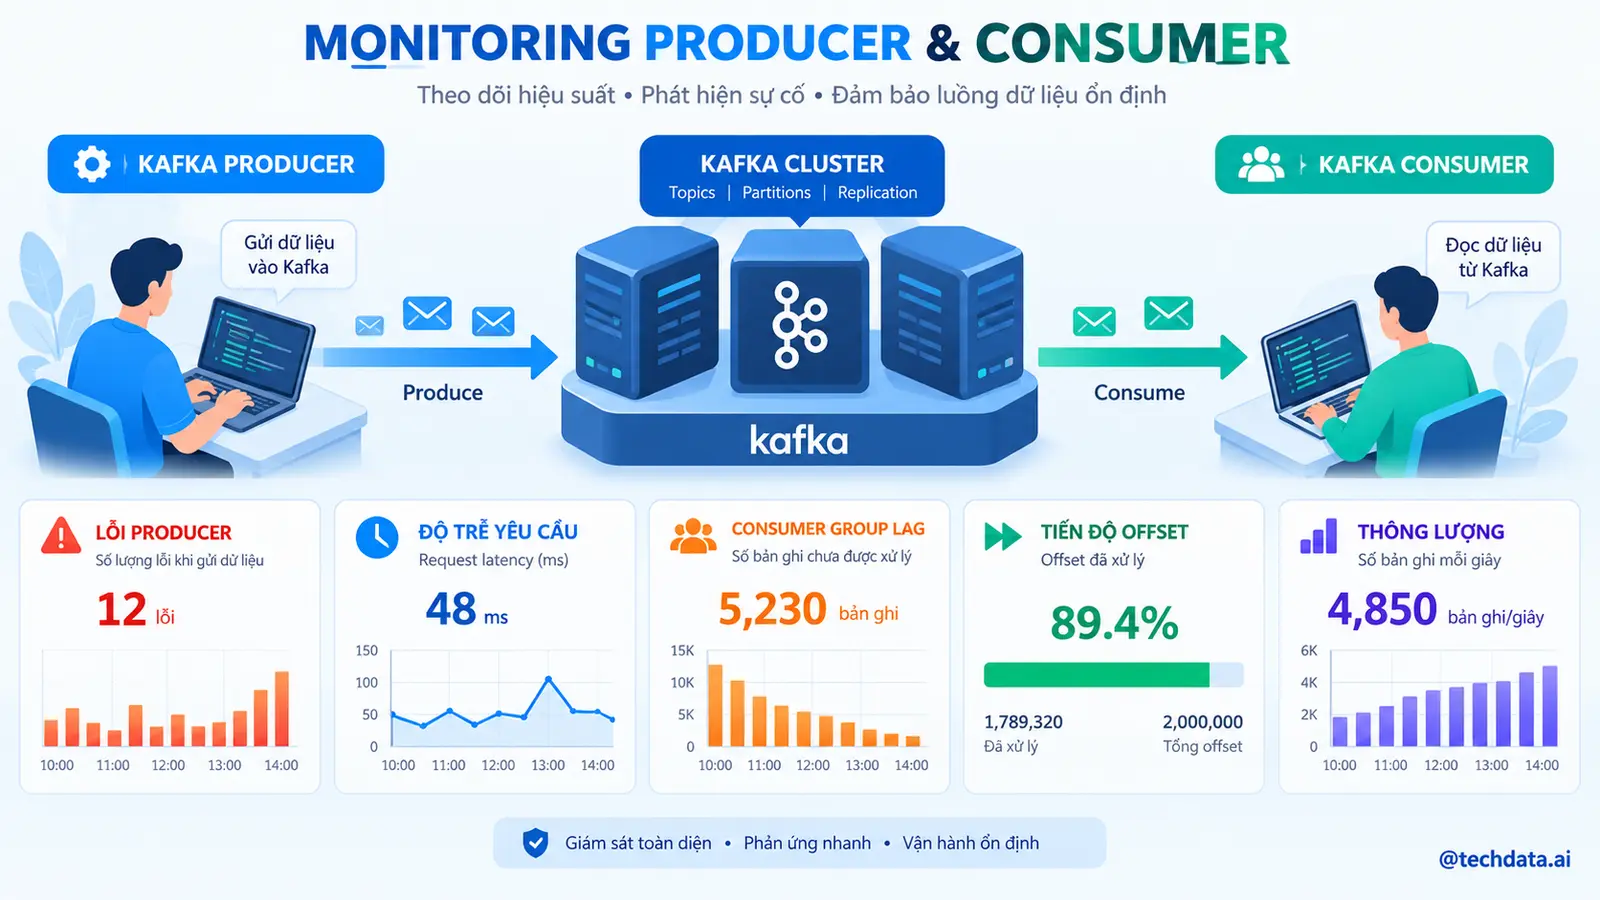
Producer cần theo dõi:
- Record Send Rate.
- Error Rate.
- Retry Rate.
- Request Latency.
- Batch Size.
- Compression Ratio.
- Buffer Available.
- Record Queue Time.
Consumer cần theo dõi:
- Consumer Lag theo Partition.
- Tuổi của Event chưa xử lý.
- Processing Rate.
- Processing Latency.
- Commit Rate và lỗi commit.
- Rebalance Count.
- Poll Interval.
- DLT Rate.
Lag chỉ có ý nghĩa khi kết hợp với throughput và thời gian. Cảnh báo lag > 10.000 có thể quá nhạy cho Topic lớn và quá muộn cho thanh toán. SLO nên thể hiện thời gian dữ liệu phải được xử lý.
15. Logging và Audit
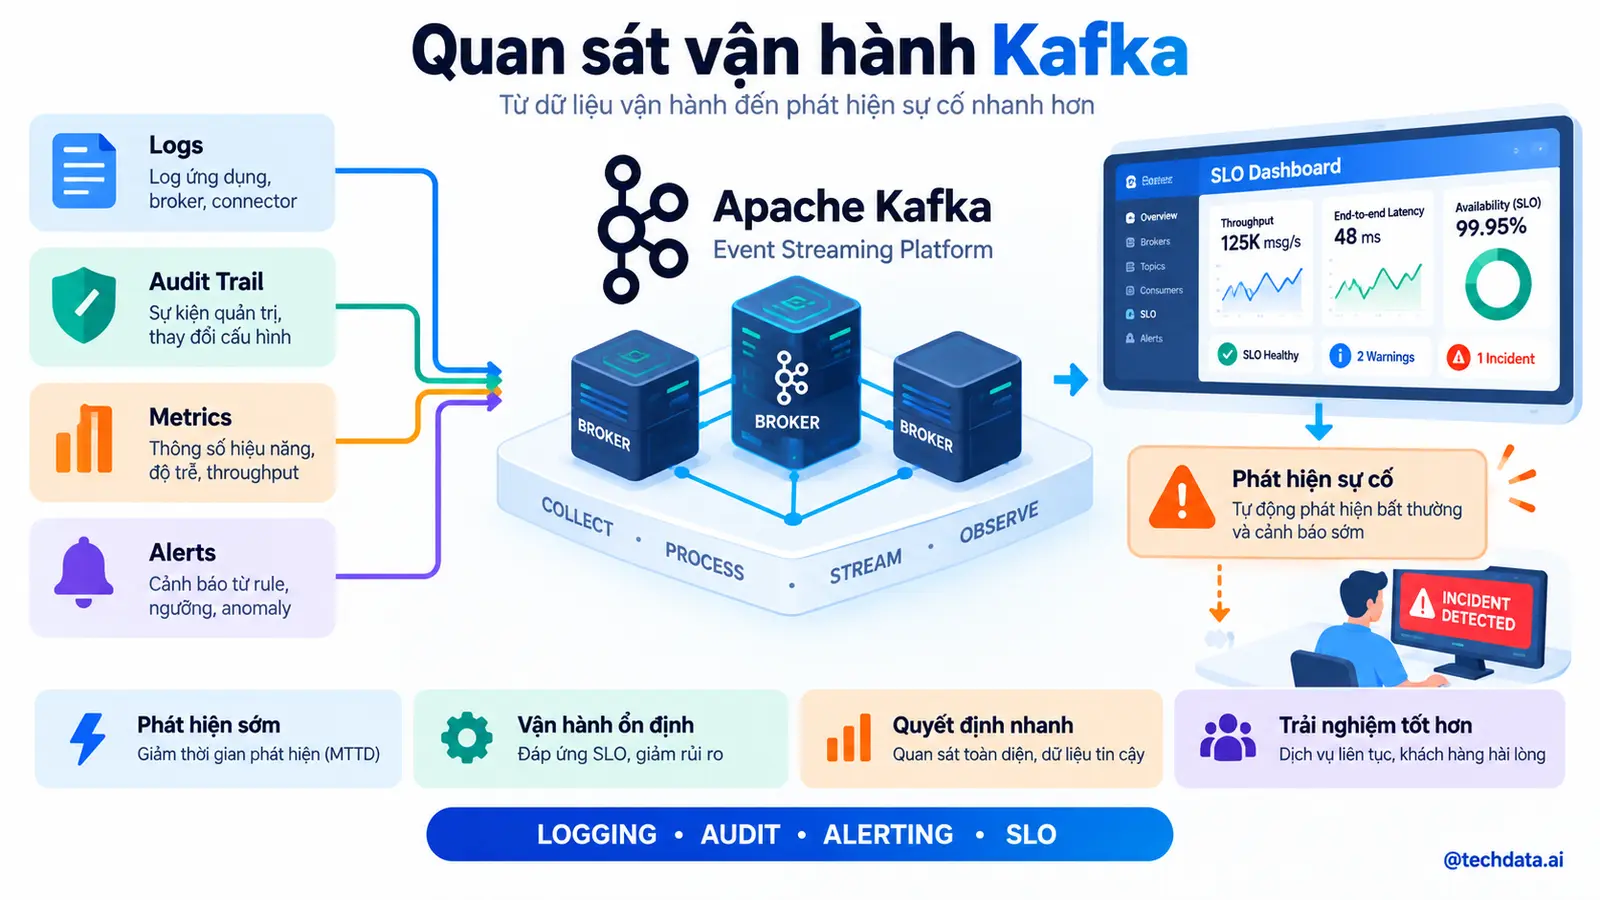
Log ứng dụng cần có:
- Timestamp.
- Service và Client ID.
- Topic, Partition, Offset.
- Event ID và Correlation ID.
- Error Code.
- Processing Duration.
Không ghi toàn bộ payload nếu chứa PII hoặc dữ liệu tài chính. Có thể log Event ID và hash phù hợp để truy vết.
Audit cần trả lời ai đã tạo Topic, đổi cấu hình, cấp ACL hoặc thay Connector. Log quản trị phải được lưu tập trung, bảo vệ khỏi chỉnh sửa và có retention theo chính sách.
16. Alerting và SLO
Cảnh báo nên gắn với tác động:
- Offline Partition lớn hơn 0.
- Under Min ISR trên Topic quan trọng.
- Controller Quorum mất majority.
- Disk dự kiến đầy trong thời gian ngắn.
- Consumer vượt SLO độ trễ.
- Producer Error Rate tăng.
- Connector Failed.
- Certificate sắp hết hạn.
Tránh cảnh báo mọi dao động nhỏ. Alert Fatigue làm đội vận hành bỏ qua tín hiệu thật.
Ví dụ SLO:
- 99,9 phần trăm Event đơn hàng xuất hiện trong Kafka dưới 5 giây.
- 99 phần trăm Event thanh toán được Consumer xử lý dưới 30 giây.
- Không có acknowledged Event bị mất trong Failure Model đã công bố.
17. Backup và Disaster Recovery
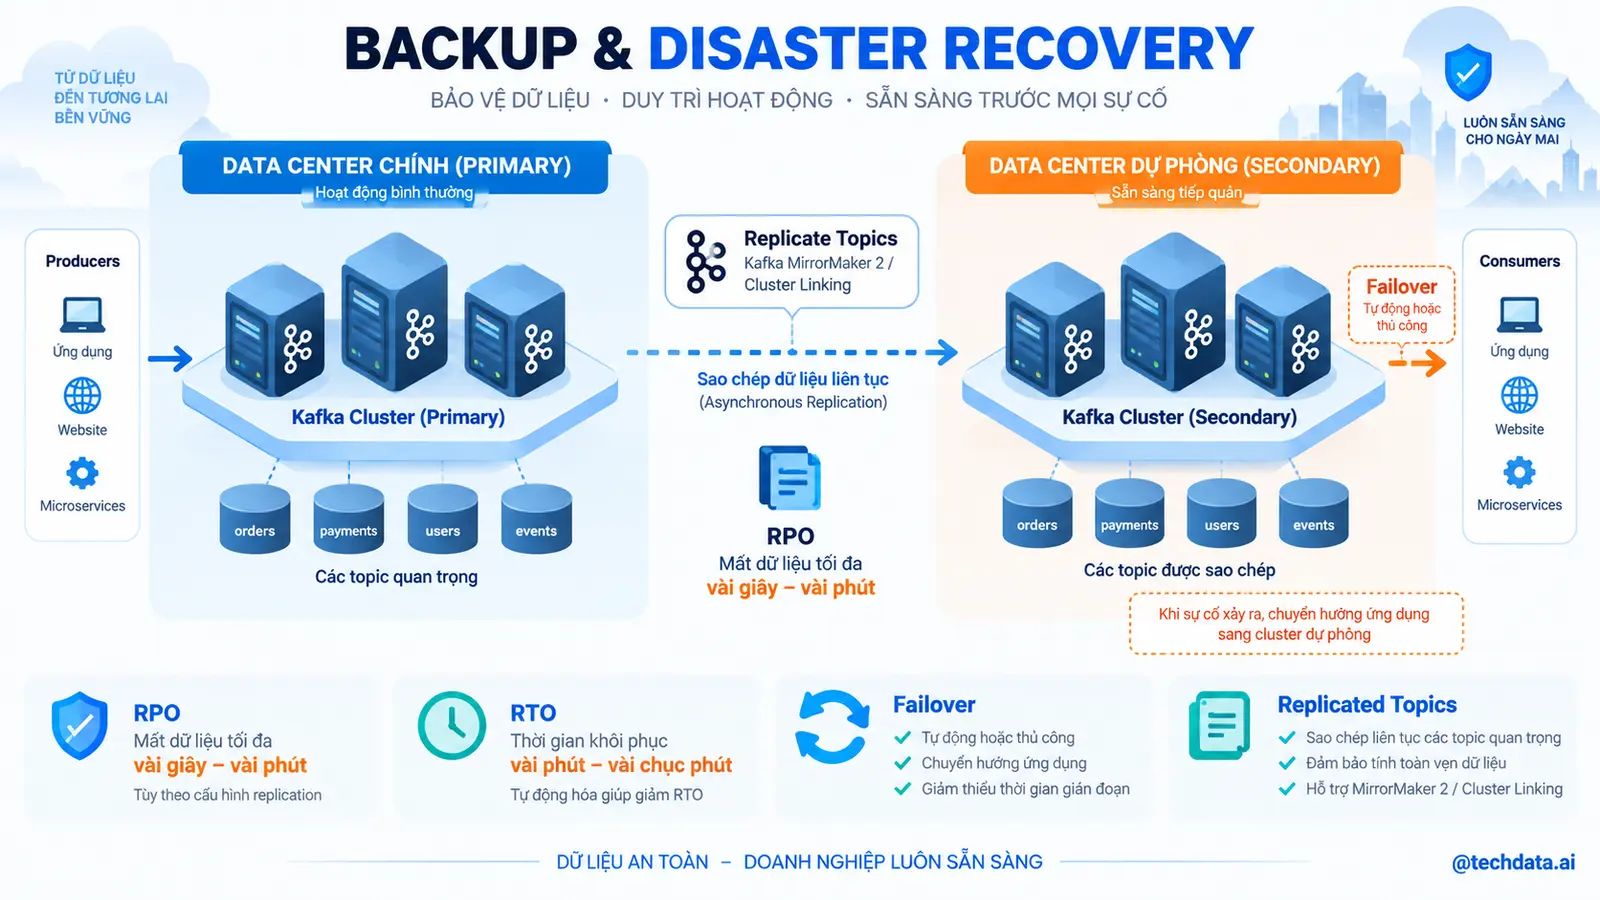
Replication trong một Cluster không phải Backup. Nếu người vận hành xóa Topic hoặc Producer ghi dữ liệu sai, các Replica cùng phản ánh thay đổi đó.
Disaster Recovery cần xác định:
- RPO, lượng dữ liệu tối đa chấp nhận mất.
- RTO, thời gian tối đa để phục hồi.
- Region dự phòng.
- Cách replication dữ liệu.
- Cách đồng bộ Topic configuration, ACL và schema.
- Cách chuyển Client.
- Cách xử lý Offset Consumer.
- Quy trình failback.
Một số dữ liệu cũng nên được lưu dài hạn trong Object Storage hoặc Data Lake để có thể replay và tái tạo Topic.
DR phải được diễn tập. Một Runbook chưa từng chạy không chứng minh hệ thống có thể phục hồi.
18. Multi-cluster và replication
Doanh nghiệp có thể dùng nhiều Cluster để tách môi trường, vùng địa lý, workload hoặc mức nhạy cảm.
MirrorMaker 2 hoặc công cụ replication khác có thể sao chép Topic giữa Cluster. Cần hiểu:
- Replication là bất đồng bộ.
- Có độ trễ và khả năng mất phần dữ liệu mới nhất khi Region hỏng.
- Topic name có thể được đổi theo alias.
- Consumer Offset replication cần kiểm thử.
- Active Active tạo bài toán conflict và ordering phức tạp.
Active Passive thường đơn giản hơn. Active Active chỉ nên dùng khi yêu cầu nghiệp vụ xứng đáng với độ phức tạp.
19. Rolling Upgrade
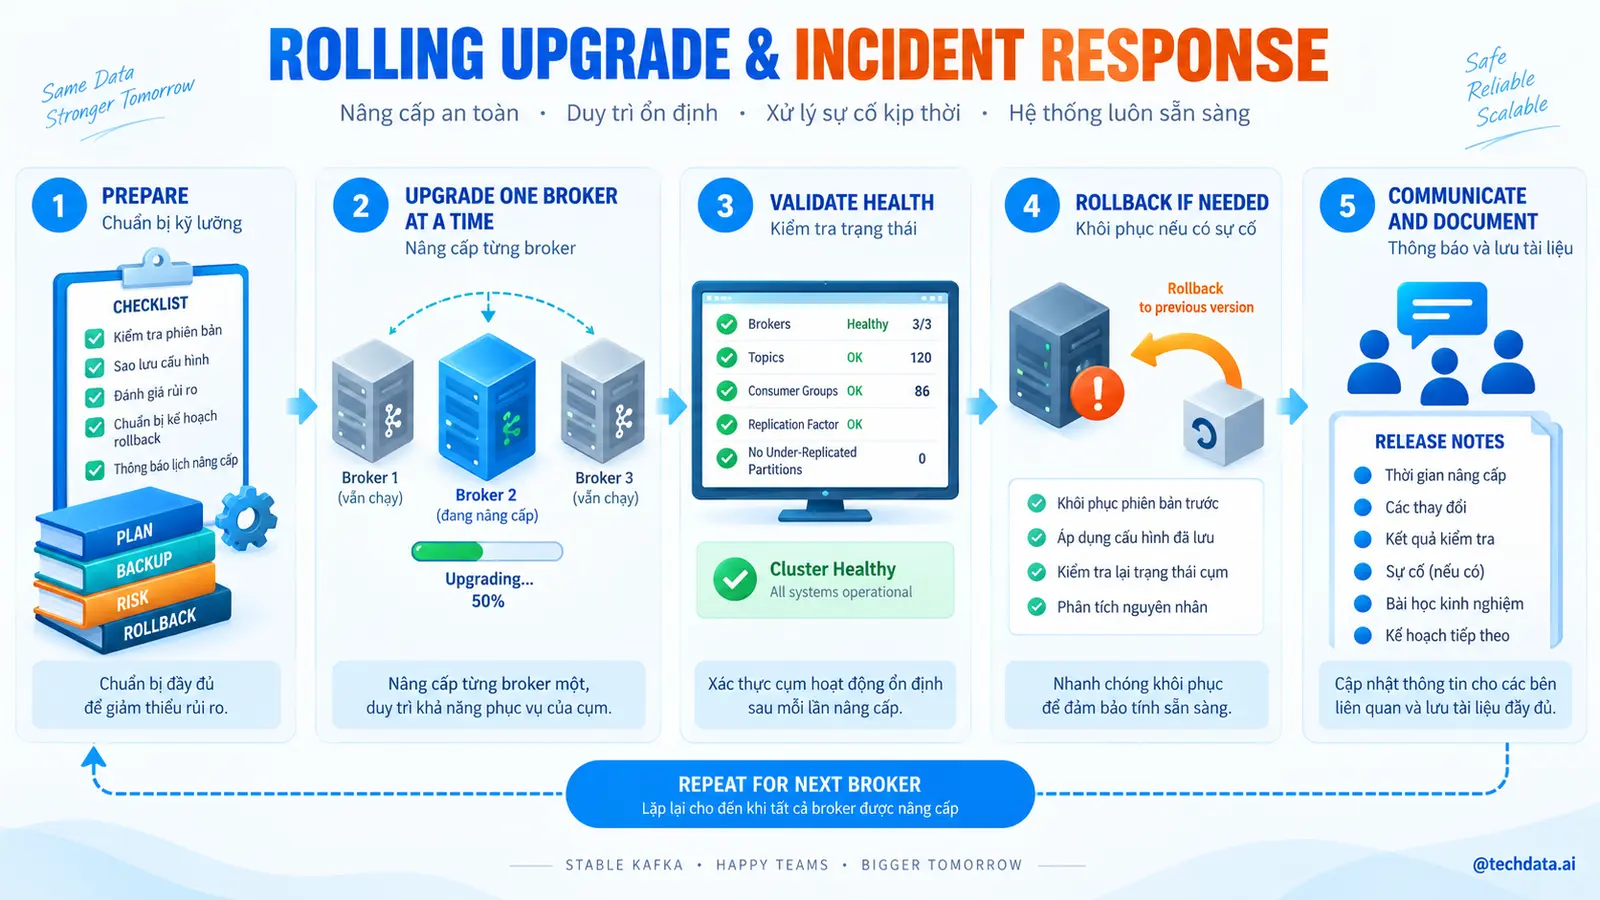
Rolling Upgrade thay từng Node mà không dừng toàn Cluster.
Quy trình tổng quát:
- Đọc Release Note và Compatibility Matrix.
- Backup cấu hình và kiểm tra Cluster health.
- Nâng cấp môi trường staging.
- Chạy regression và load test.
- Nâng cấp từng Controller hoặc Broker theo hướng dẫn phiên bản.
- Chờ Replica và Cluster ổn định trước Node tiếp theo.
- Theo dõi error, latency và ISR.
- Chỉ bật feature hoặc protocol mới sau khi mọi Node tương thích.
Không nâng cấp nhiều phiên bản lớn trong một bước nếu tài liệu không hỗ trợ. Client, Connector và Schema Registry cũng cần kiểm tra compatibility.
20. Quy trình Incident Response
Khi Cluster gặp sự cố:
- Xác định tác động nghiệp vụ.
- Kiểm tra Controller, Offline Partition và ISR.
- Bảo vệ dữ liệu trước khi tối ưu Availability.
- Không xóa Topic nội bộ hoặc reset Offset tùy tiện.
- Ghi lại mọi thay đổi trong Incident Timeline.
- Khôi phục dịch vụ theo Runbook.
- Xác nhận Producer, Consumer và dữ liệu downstream.
- Thực hiện Post Incident Review.
Không nên restart toàn bộ Broker cùng lúc như phản xạ đầu tiên. Hành động này có thể biến lỗi cục bộ thành mất toàn Cluster.
21. Checklist Production
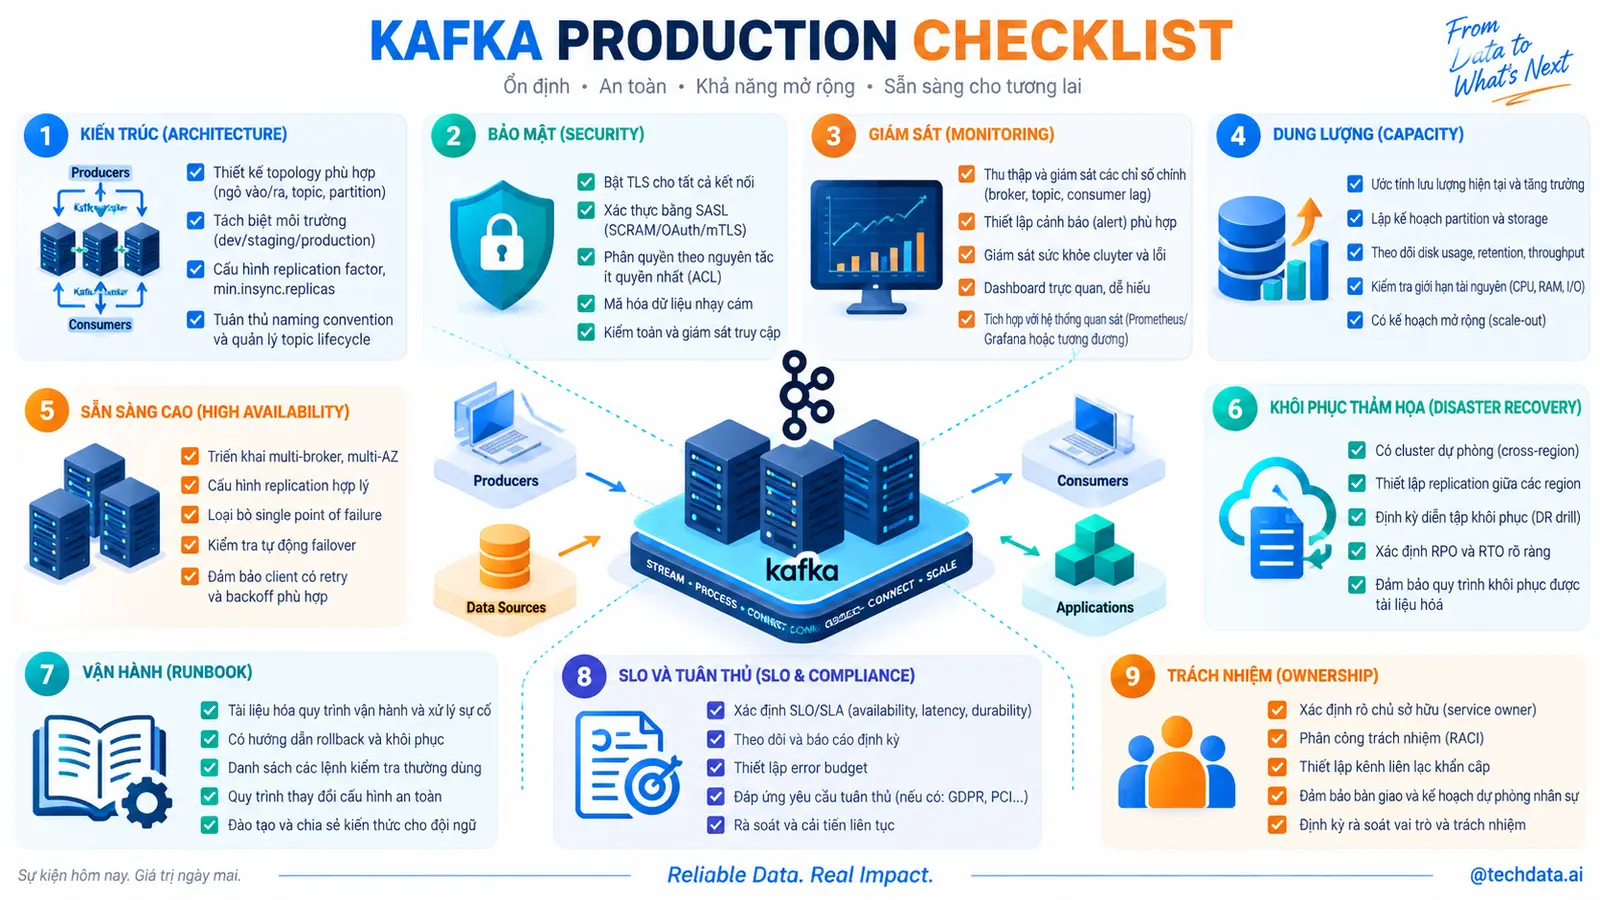
Kiến trúc
- Controller Quorum có số Node lẻ.
- Broker phân phối qua Failure Domain.
- Topic quan trọng có Replication Factor phù hợp.
- Rack Awareness được cấu hình.
- Capacity còn biên an toàn.
Bảo mật
- TLS bật cho traffic cần bảo vệ.
- Client có Principal riêng.
- ACL theo Least Privilege.
- Secret không nằm trong Git.
- Certificate có cảnh báo hết hạn.
Dữ liệu
- Retention được phê duyệt theo Topic.
- Schema Compatibility được enforce.
- Producer quan trọng dùng cấu hình độ bền phù hợp.
- Consumer idempotent.
- DLT có owner và quy trình replay.
Vận hành
- Dashboard Broker, Producer, Consumer và Connect.
- Alert gắn với SLO.
- Runbook cho Broker failure, disk full và lag.
- Rolling Upgrade đã thử ở staging.
- DR được diễn tập.
- Topic, ACL và config được quản lý bằng code.
22. Tổng kết
Kafka Production là một hệ thống dữ liệu phân tán cần được vận hành như nền tảng trọng yếu. Số Broker không tự tạo High Availability, TLS không tự tạo Security hoàn chỉnh và Replication không thay thế Disaster Recovery.
Các điểm cần ghi nhớ:
- KRaft Production nên có Controller Quorum khỏe mạnh.
- Capacity Planning phải xét storage, network, Partition và recovery.
- Replication cần kết hợp ISR,
min.insync.replicasvàacks. - Rack Awareness bảo vệ trước Failure Domain.
- Authentication, TLS và ACL tạo ba lớp bảo mật khác nhau.
- Consumer Lag phải gắn với SLO thời gian.
- Replication trong Cluster không phải Backup.
- DR và Rolling Upgrade cần được diễn tập.
- Mọi thay đổi quan trọng nên có code, review và audit.
Hoàn thành series này, học viên đã đi từ kiến trúc Kafka căn bản đến Producer, Consumer, Partition, Delivery Semantics, CDC, Schema, Stream Processing và vận hành Production. Bước tiếp theo là triển khai project hoàn chỉnh, tạo dữ liệu tải thật và kiểm thử sự cố có chủ đích.
23. Câu hỏi ôn tập
- Vì sao nên tách Controller và Broker trong Production?
- Capacity Planning Kafka cần những dữ liệu đầu vào nào?
- Rack Awareness bảo vệ hệ thống khỏi rủi ro gì?
- Authentication, Encryption và Authorization khác nhau thế nào?
- Vì sao Consumer Lag bằng 0 chưa chắc hệ thống khỏe?
- Replication trong Cluster khác Backup như thế nào?
- RPO và RTO có ý nghĩa gì?
- Vì sao không nên restart toàn bộ Broker cùng lúc?
24. Tài liệu tham khảo
- Apache Kafka Operations: https://kafka.apache.org/documentation/#operations
- Apache Kafka Security: https://kafka.apache.org/documentation/#security
- Apache Kafka Broker Configurations: https://kafka.apache.org/documentation/#brokerconfigs
- Apache Kafka KRaft: https://kafka.apache.org/documentation/#kraft
- Apache Kafka Monitoring: https://kafka.apache.org/documentation/#monitoring
- Apache Kafka MirrorMaker: https://kafka.apache.org/documentation/#georeplication
Hoàng Minh,
TechData.AI