



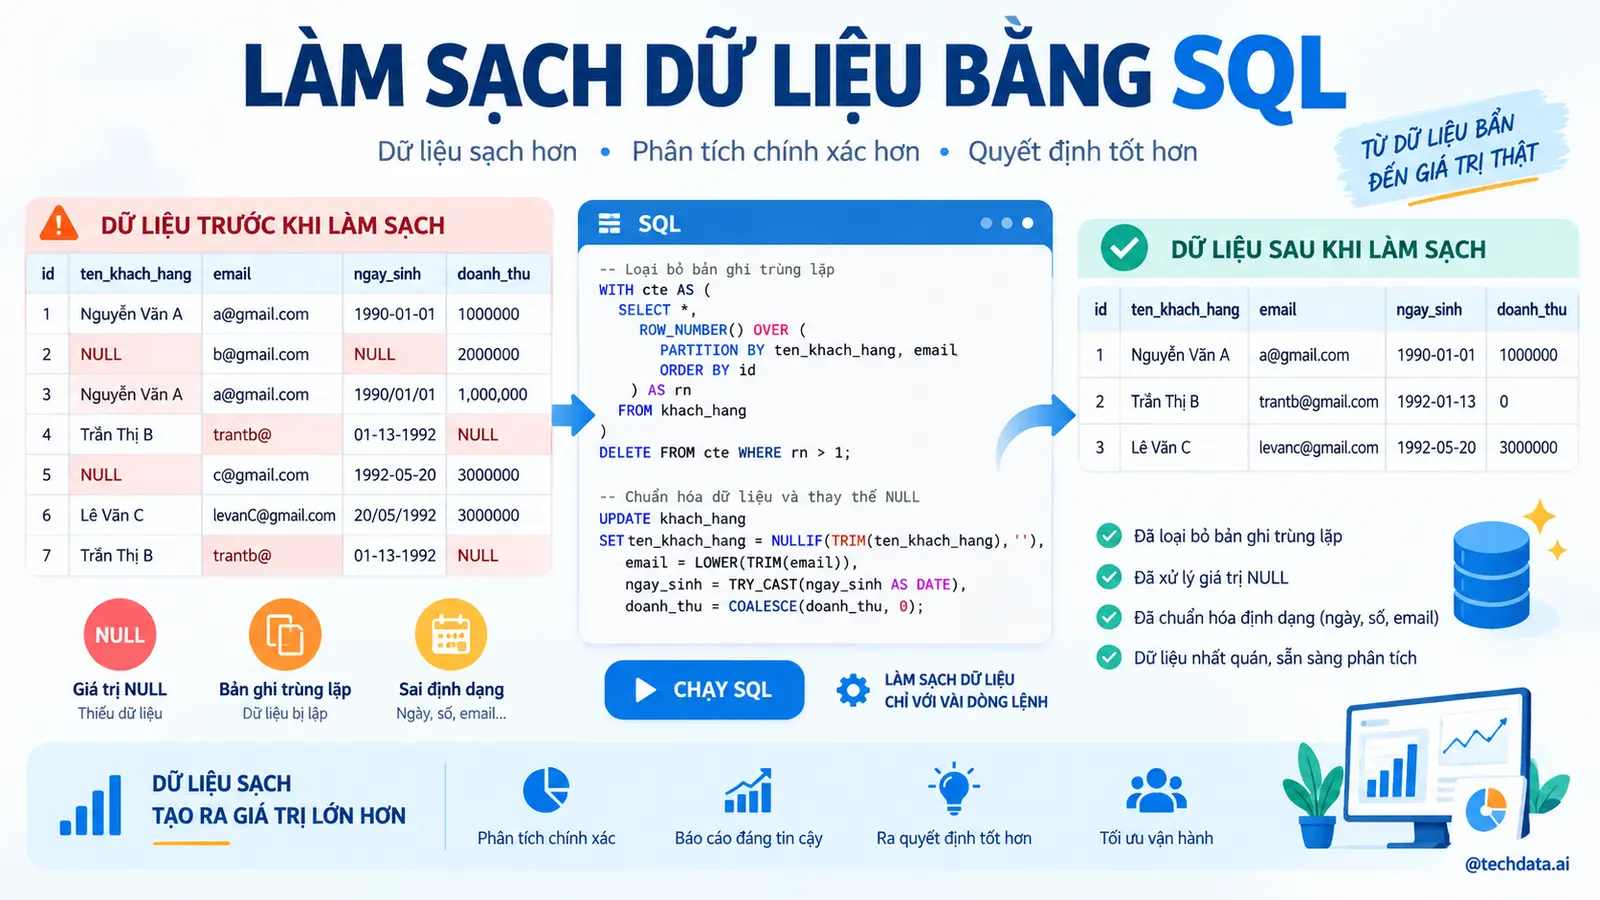

Làm sạch dữ liệu bằng SQL không phải biến mọi ô trống thành 0. Bài viết xây quy trình chuẩn hóa khách hàng từ bảng staging, phát hiện email sai, chuẩn hóa số điện thoại, chọn bản ghi đại diện khi trùng và lưu bản ghi lỗi vào quarantine.
Mục lục
- Bài toán thực tế
- Sản phẩm hoàn thành
- Kiến thức cần dùng
- Chuẩn bị môi trường
- Dữ liệu thực hành
- Xây dựng từng bước
- Chương trình hoàn chỉnh
- Kiểm tra kết quả
- Lỗi thường gặp
- Đưa vào thực tế
- Bài tập thực hành
- Project mở rộng
- Tổng kết
- Tài liệu tham khảo
1. Bài toán thực tế
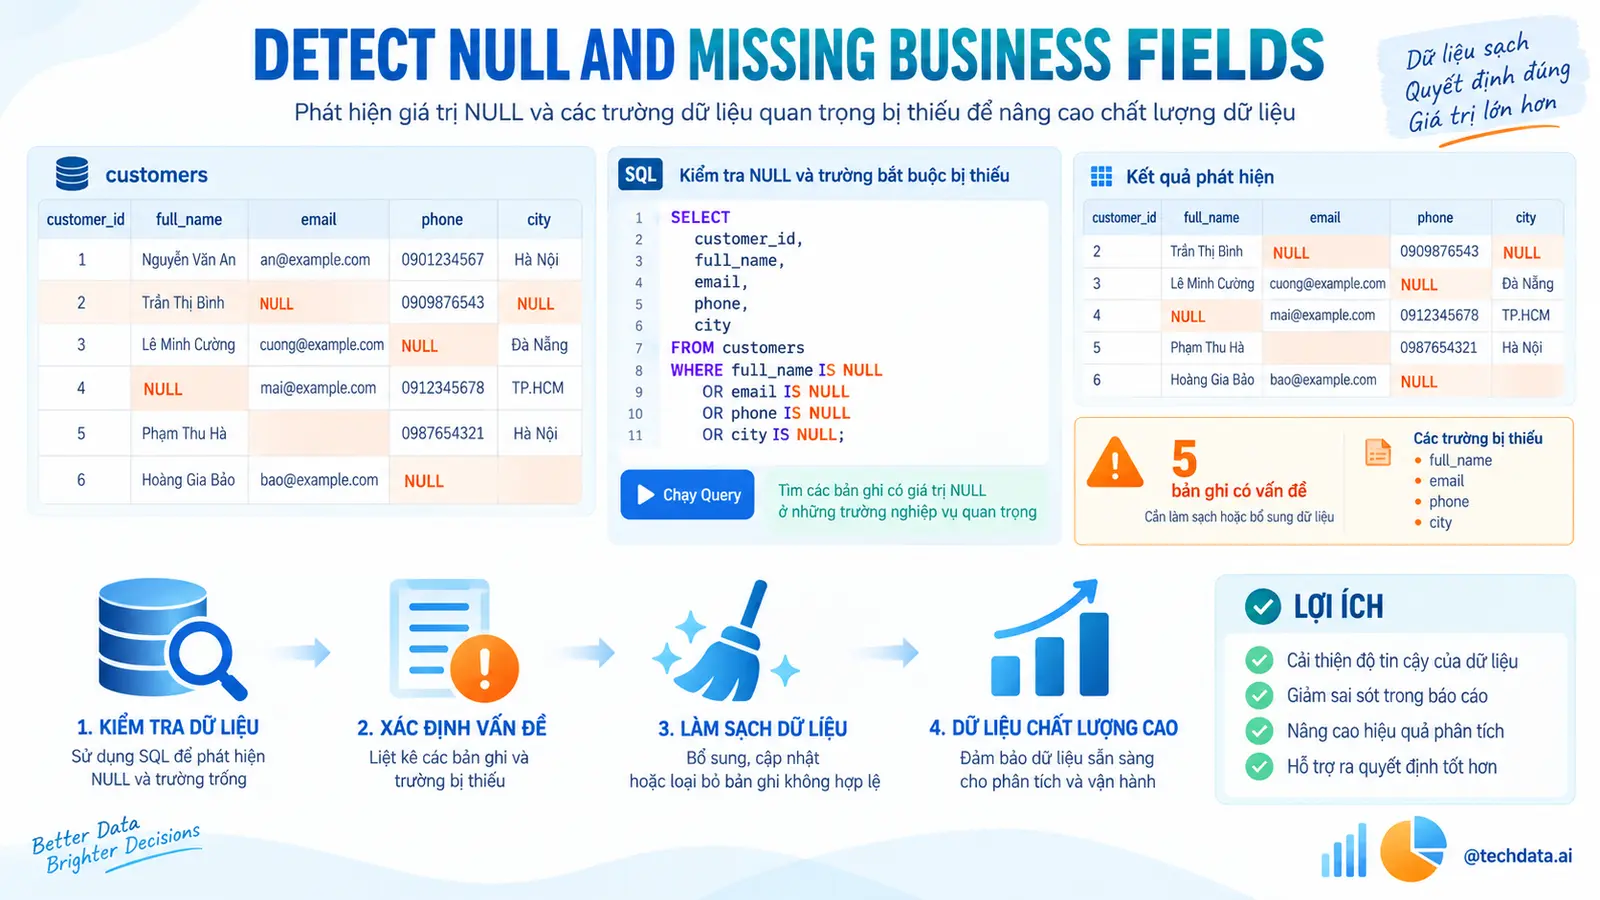
Ba hệ thống gửi dữ liệu khách hàng với cách viết khác nhau: email có chữ hoa và khoảng trắng, điện thoại có dấu cách hoặc mã quốc gia, ngày sinh là chuỗi và cùng một email xuất hiện nhiều lần.
Nếu xóa duplicate ngay, doanh nghiệp có thể mất bản ghi mới nhất hoặc bản ghi đầy đủ hơn. Quy trình cần giữ raw bất biến, tạo lý do lỗi và có quy tắc chọn survivor.
2. Sản phẩm hoàn thành
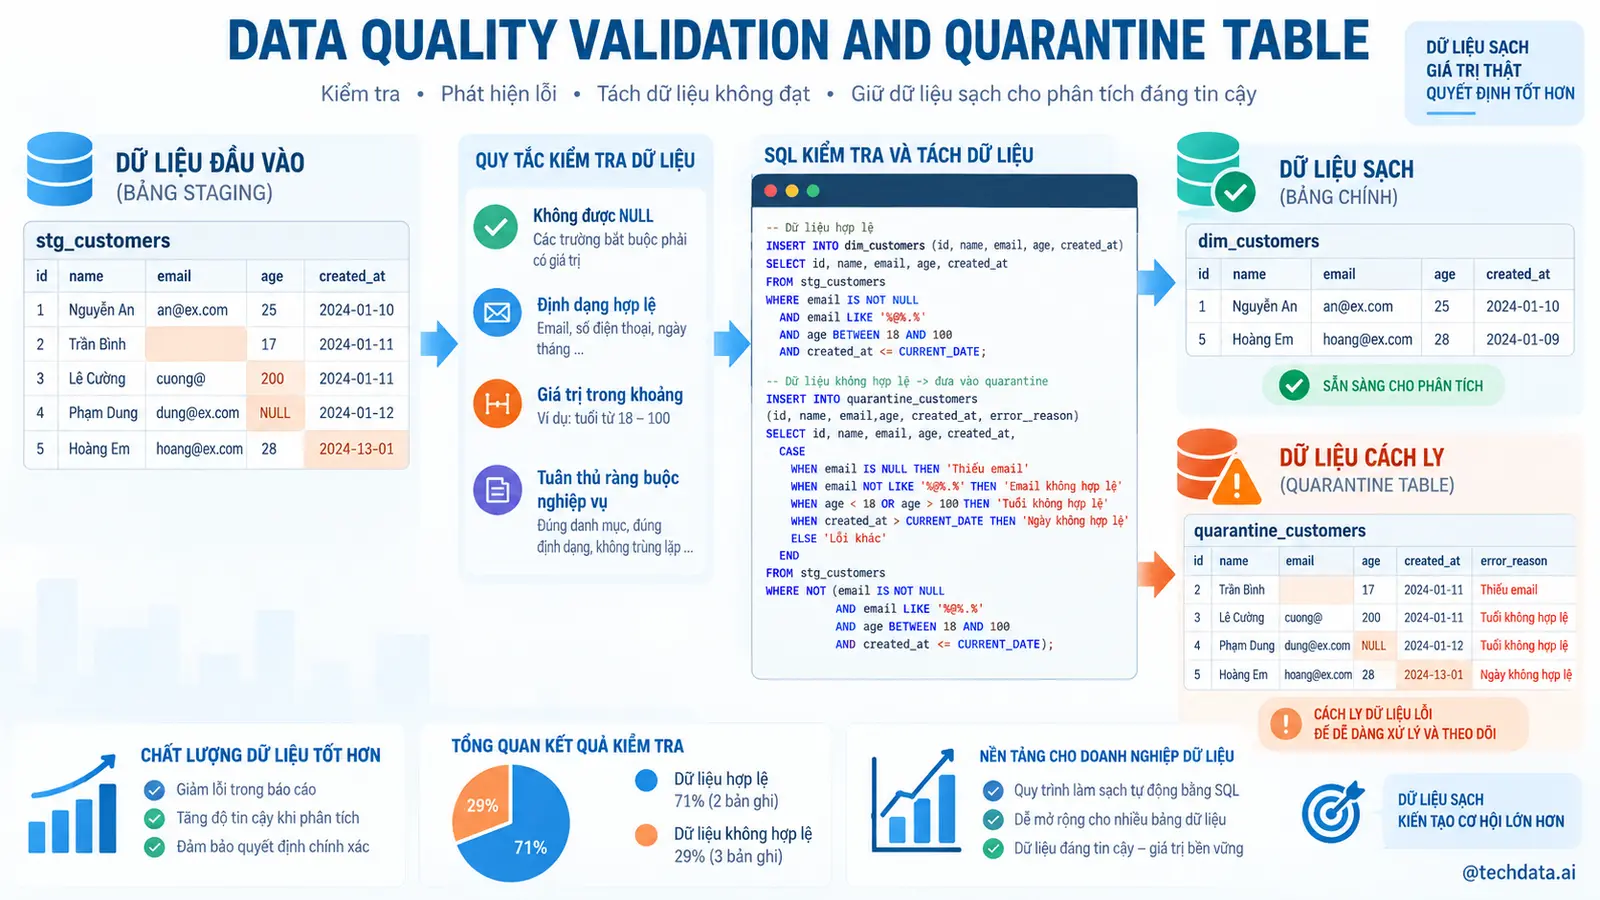
Sản phẩm gồm stg_customers_raw, customers_clean và customers_quarantine. Mỗi lần chạy gắn batch_id để truy vết.
Bản ghi sạch duy nhất theo normalized_email; quarantine lưu source_id, error_reason và raw payload cần sửa.
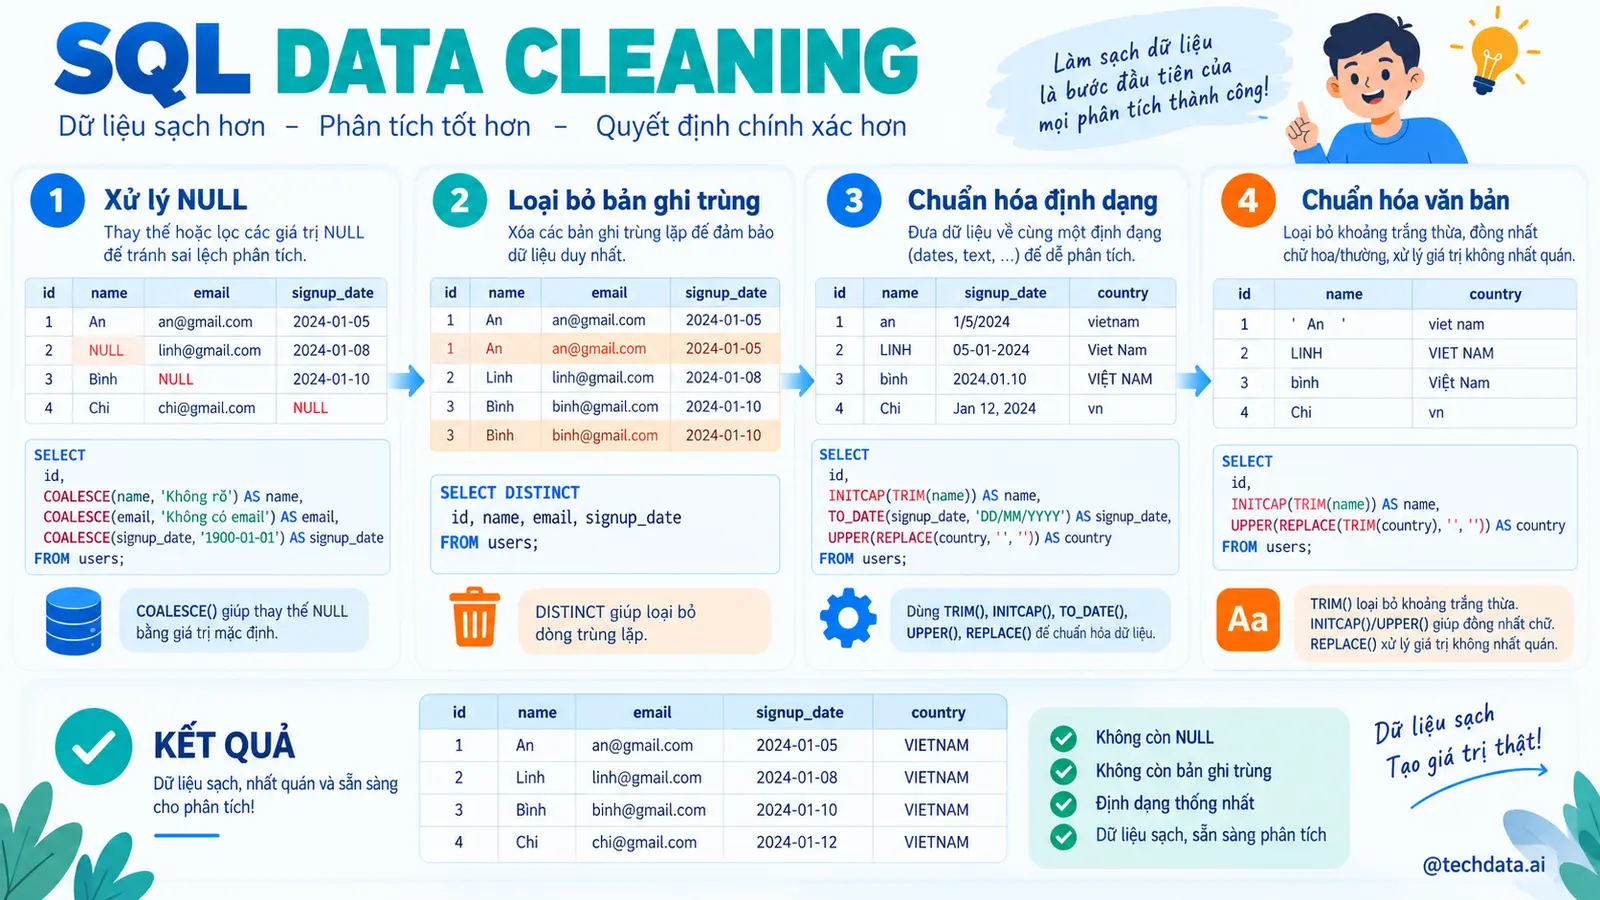
- Phân biệt NULL, chuỗi rỗng và giá trị không hợp lệ.
- Chuẩn hóa chuỗi bằng TRIM, LOWER và regexp_replace.
- Ép kiểu có kiểm soát.
- Deduplicate bằng ROW_NUMBER với tiêu chí rõ.
- Tạo báo cáo chất lượng trước và sau.
3. Kiến thức cần dùng
Raw layer không sửa dữ liệu nguồn. Standardized layer tạo cột chuẩn hóa bên cạnh cột gốc. Curated layer chỉ nhận bản ghi vượt quy tắc; quarantine giữ phần còn lại.
NULL nghĩa là chưa biết hoặc không có giá trị; chuỗi rỗng vẫn là một chuỗi. NULLIF(TRIM(col),'') chuyển khoảng trắng và chuỗi rỗng thành NULL có chủ đích.
Deduplication cần business key và thứ tự ưu tiên. Email có thể là khóa cho bài tập, nhưng hệ thống thật phải xem email dùng chung hoặc thay đổi theo thời gian.
4. Chuẩn bị môi trường
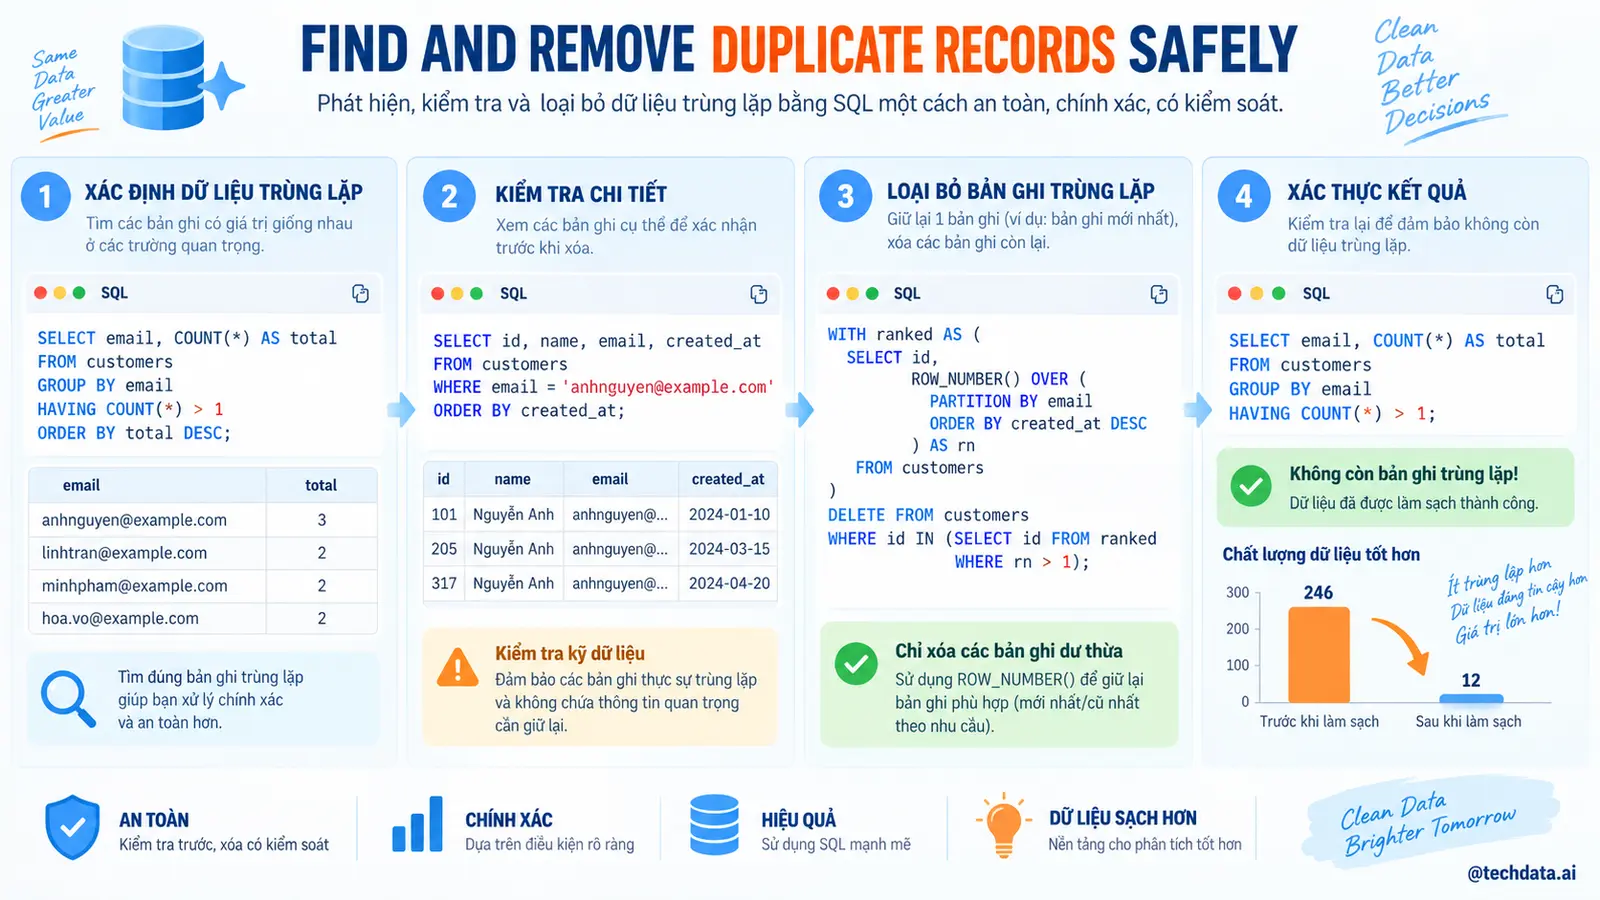
Nạp CSV vào staging với hầu hết cột dạng text để một giá trị sai không làm cả batch thất bại. Thêm source_system, source_id, batch_id và loaded_at.
Không UPDATE raw. Mỗi rule được viết trong CTE để có thể xem dữ liệu ở từng trạng thái.
SELECT batch_id,COUNT(*) rows,COUNT(DISTINCT source_id) source_ids
FROM stg_customers_raw GROUP BY batch_id ORDER BY batch_id;
5. Dữ liệu thực hành
Dữ liệu gồm customer_name, email, phone, birth_date_text và updated_at. updated_at quyết định bản ghi mới hơn; source_priority phá hòa khi hai nguồn cùng thời gian.
Email hợp lệ trong bài dùng regex đơn giản, không cố mô tả toàn bộ chuẩn email. Mục tiêu là bắt lỗi phổ biến chứ không tuyên bố xác thực hộp thư.
CREATE TABLE customers_quarantine (
 batch_id bigint NOT NULL, source_id text NOT NULL,
 error_reason text NOT NULL, raw_record jsonb NOT NULL,
 quarantined_at timestamptz NOT NULL DEFAULT now()
);
6. Xây dựng từng bước
Bước 1: Chuẩn hóa chuỗi
Giữ cột gốc để điều tra và tạo cột normalized riêng.
SELECT source_id,
 NULLIF(TRIM(customer_name),'') normalized_name,
 LOWER(NULLIF(TRIM(email),'')) normalized_email,
 REGEXP_REPLACE(COALESCE(phone,''),'[^0-9]','','g') phone_digits
FROM stg_customers_raw;
Kết quả mong đợi: Khoảng trắng thừa được bỏ và email viết thường.
Bước 2: Chuẩn hóa số điện thoại Việt Nam
Ví dụ chuyển +84 về 0 sau khi đã giữ chữ số. Rule thực tế cần thư viện mã quốc gia nếu có nhiều thị trường.
CASE
 WHEN phone_digits LIKE '84%' AND length(phone_digits)=11 THEN '0'||substring(phone_digits from 3)
 WHEN phone_digits LIKE '0%' AND length(phone_digits)=10 THEN phone_digits
 ELSE NULL
END AS normalized_phone
Kết quả mong đợi: Số hợp lệ về định dạng 10 chữ số bắt đầu bằng 0.
Bước 3: Gắn lý do lỗi
CASE ưu tiên lỗi khóa trước. Nếu cần nhiều lý do trên một dòng, tạo mảng lỗi thay vì một nhãn.
CASE
 WHEN normalized_email IS NULL THEN 'missing_email'
 WHEN normalized_email !~ '^[^@\s]+@[^@\s]+\.[^@\s]+$' THEN 'invalid_email'
 WHEN normalized_name IS NULL THEN 'missing_name'
 WHEN normalized_phone IS NULL THEN 'invalid_phone'
 ELSE NULL END AS error_reason
Kết quả mong đợi: Bản ghi hợp lệ có error_reason NULL.
Bước 4: Xếp hạng duplicate
Bản ghi mới nhất thắng; source_priority và source_id tạo thứ tự ổn định.
ROW_NUMBER() OVER (
 PARTITION BY normalized_email
 ORDER BY updated_at DESC,source_priority ASC,source_id DESC
) AS duplicate_rank
Kết quả mong đợi: Mỗi email có đúng một dòng rank 1.
Bước 5: Tách clean và quarantine
Ghi trong transaction để hai đầu ra thuộc cùng một phiên xử lý.
INSERT INTO customers_clean (...)
SELECT ... FROM classified
WHERE error_reason IS NULL AND duplicate_rank=1;

INSERT INTO customers_quarantine (...)
SELECT ... FROM classified
WHERE error_reason IS NOT NULL OR duplicate_rank>1;
Kết quả mong đợi: Mọi dòng nguồn được giải thích ở clean hoặc quarantine.
Quarantine là sản phẩm, không phải thùng rác
Mỗi bản ghi lỗi cần owner, reason, first_seen và trạng thái xử lý. Nếu quarantine chỉ tăng mà không ai xem, pipeline đang chuyển lỗi sang nơi khác chứ chưa quản trị chất lượng.
Dashboard chất lượng nên hiển thị tỷ lệ lỗi theo nguồn và rule, không chỉ tổng số. Một nguồn nhỏ có 50% lỗi cần ưu tiên hơn nguồn lớn có 0,1% lỗi.
Deduplicate không đồng nghĩa merge
Chọn dòng mới nhất chỉ là một chiến lược survivor. Dòng cũ có thể có điện thoại hợp lệ trong khi dòng mới chỉ cập nhật tên. Golden record theo thuộc tính cần provenance cho từng trường.
Giữ mapping source_id đến golden_customer_id để những giao dịch lịch sử từ các nguồn vẫn liên kết đúng sau hợp nhất.
Kiểm thử khả năng chạy lại
Chạy batch hai lần và so sánh checksum của customers_clean. Nếu kết quả thay đổi dù raw và rule không đổi, thứ tự dedup có thể thiếu tie-breaker hoặc truy vấn phụ thuộc thời gian hiện tại.
Rule version phải là đầu vào của pipeline. Khi rule đổi, kết quả thay đổi có giải thích thay vì trở thành sai lệch khó truy vết.
Ngày tháng sai định dạng mà không làm dừng batch
Ép trực tiếp '31/02/2026'::date làm câu lệnh lỗi. PostgreSQL không có TRY_CAST mặc định, vì vậy pipeline có thể kiểm tra regex và miền cơ bản trước, hoặc dùng hàm safe cast được kiểm soát. Regex chỉ xác nhận hình dạng, không xác nhận ngày tồn tại.
Một giải pháp đáng tin cậy là ingest text, chạy rule theo nguồn và quarantine giá trị không chuyển được. Không đổi datestyle toàn session chỉ để cứu một nguồn thiếu chuẩn.
SELECT source_id,birth_date_text,
 CASE WHEN birth_date_text~'^\d{4}-\d{2}-\d{2}$' THEN birth_date_text ELSE NULL END candidate_date
FROM stg_customers_raw;
Chuẩn hóa Unicode và dấu tiếng Việt
LOWER và TRIM không giải quyết mọi biến thể Unicode. Hai chuỗi nhìn giống nhau có thể có dạng tổ hợp khác nhau. PostgreSQL core không cung cấp normalization đầy đủ ở mọi phiên bản; ứng dụng hoặc extension cần chuẩn hóa trước khi so sánh.
Không bỏ dấu trên tên gốc. Tạo search_name riêng bằng unaccent và lower để tìm kiếm, còn customer_name giữ cách viết chuẩn phục vụ hiển thị.
CREATE EXTENSION IF NOT EXISTS unaccent;
SELECT customer_name,LOWER(unaccent(customer_name)) search_name
FROM customers_clean;
Data quality score có trọng số
Không phải lỗi nào cũng nghiêm trọng như nhau. Thiếu email có thể chặn kích hoạt marketing; thiếu ngày sinh chỉ làm giảm khả năng phân khúc. Gán severity và trọng số giúp ưu tiên xử lý.
Score không thay thế reason. Luôn giữ từng cờ rule để người dùng biết cần sửa gì, còn score phục vụ xếp hạng hoặc SLA.
SELECT source_id,
 (CASE WHEN normalized_email IS NULL THEN 50 ELSE 0 END +
  CASE WHEN normalized_phone IS NULL THEN 30 ELSE 0 END +
  CASE WHEN normalized_name IS NULL THEN 20 ELSE 0 END) quality_penalty
FROM classified;
So sánh snapshot để phát hiện drift
Profile batch hiện tại với bảy batch gần nhất: tỷ lệ NULL, duplicate và invalid. Cảnh báo khi vượt baseline theo phần trăm hoặc độ lệch chuẩn. Một rule luôn có 1% lỗi có thể bình thường; tăng lên 20% là sự cố.
Lưu data_quality_metrics nhỏ hơn nhiều so với lưu toàn bộ kết quả kiểm tra và phù hợp dashboard vận hành.
SELECT batch_id,rule_id,failed_rows,total_rows,
 ROUND(100.0*failed_rows/NULLIF(total_rows,0),2) failure_pct
FROM data_quality_metrics
ORDER BY batch_id DESC,rule_id;
Quyền riêng tư trong môi trường học và thật
Dataset mẫu phải là dữ liệu giả. Không lấy email khách thật đưa lên Git hoặc notebook. Trong production, bảng raw và quarantine thường nhạy cảm hơn bảng mart vì chứa dữ liệu chưa che.
Cấp quyền theo schema, mask email khi người phân tích chỉ cần domain và đặt retention cho raw payload. Chất lượng dữ liệu không phải lý do để sao chép PII sang mọi log.
SELECT customer_id,
 REGEXP_REPLACE(email,'(^.).*(@.*$)','\1***\2') masked_email,
 RIGHT(phone,4) phone_last4
FROM customers_clean;
7. Chương trình hoàn chỉnh
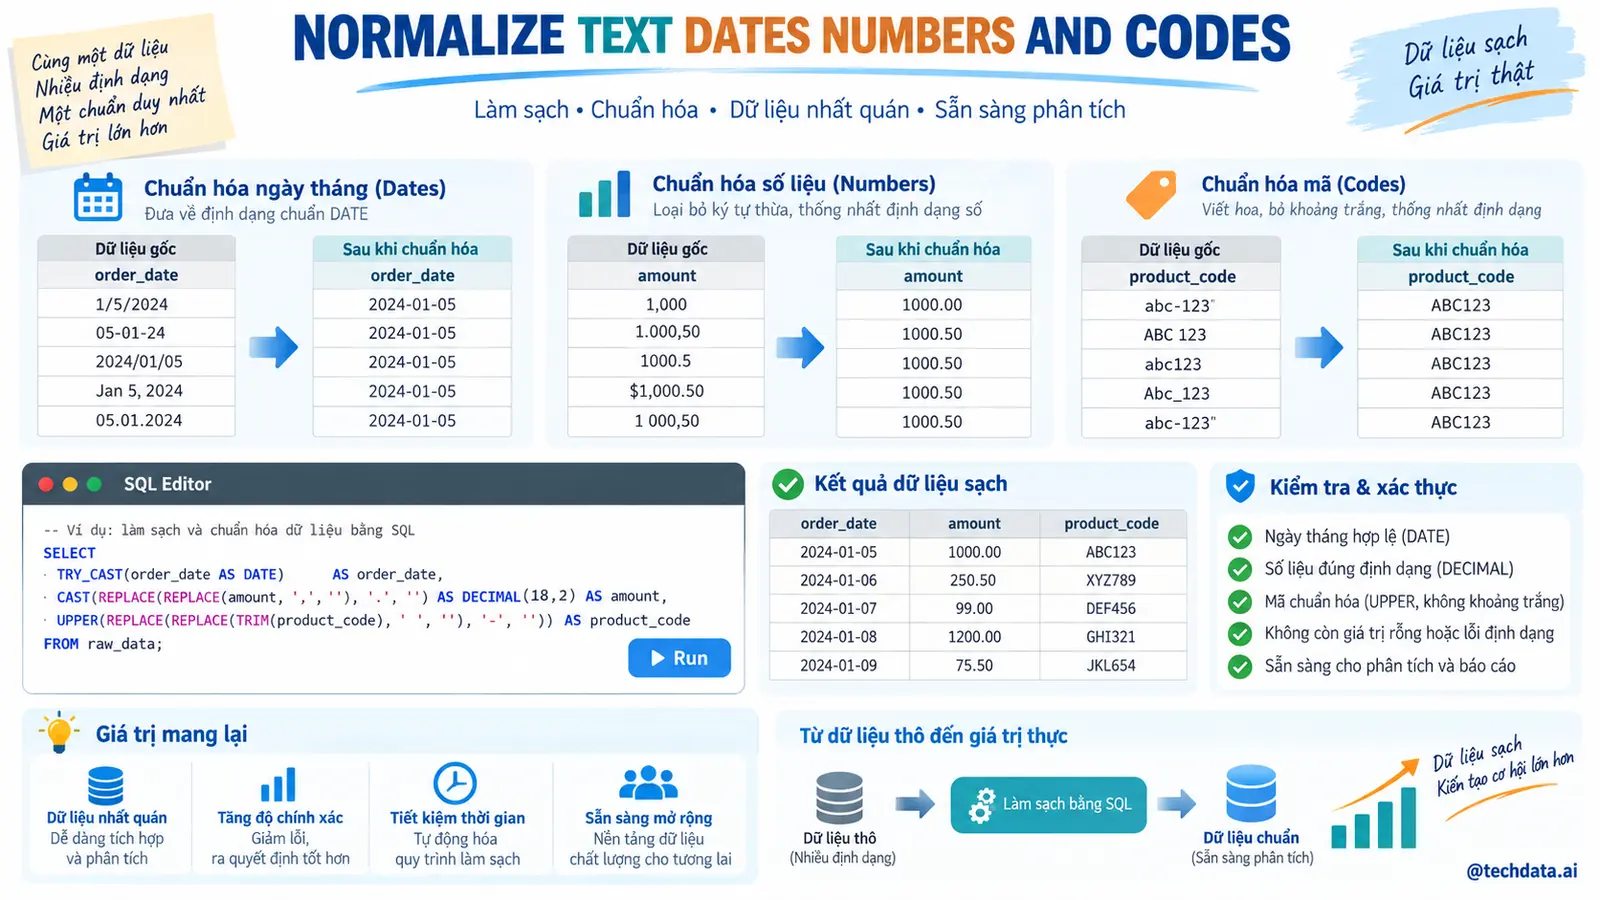
Pipeline dùng các CTE normalized, validated và ranked. Một SELECT debug có thể hiển thị toàn bộ cột trung gian trước khi INSERT.
Duplicate không nhất thiết là lỗi bỏ đi; quarantine ghi duplicate_of hoặc tiêu chí chọn để có thể merge thuộc tính sau này.
WITH normalized AS (
 SELECT r.*,NULLIF(TRIM(customer_name),'') normalized_name,
 LOWER(NULLIF(TRIM(email),'')) normalized_email,
 REGEXP_REPLACE(COALESCE(phone,''),'[^0-9]','','g') phone_digits
 FROM stg_customers_raw r WHERE batch_id=:batch_id
), validated AS (
 SELECT *,CASE WHEN normalized_email IS NULL THEN 'missing_email'
 WHEN normalized_email !~ '^[^@\s]+@[^@\s]+\.[^@\s]+$' THEN 'invalid_email'
 WHEN normalized_name IS NULL THEN 'missing_name' ELSE NULL END error_reason
 FROM normalized
), ranked AS (
 SELECT *,ROW_NUMBER() OVER(PARTITION BY normalized_email ORDER BY updated_at DESC,source_priority,source_id DESC) duplicate_rank
 FROM validated
)
SELECT * FROM ranked;
8. Kiểm tra kết quả
Conservation check: số dòng raw của batch phải bằng clean accepted cộng quarantine. Kiểm tra clean không có normalized_email NULL hoặc trùng.
Báo cáo tỷ lệ lỗi theo reason và source_system. Nếu invalid_email tăng đột ngột ở một nguồn, cảnh báo upstream thay vì âm thầm loại.
SELECT normalized_email,COUNT(*) FROM customers_clean
GROUP BY normalized_email HAVING COUNT(*)>1;

SELECT error_reason,COUNT(*) FROM customers_quarantine
WHERE batch_id=:batch_id GROUP BY error_reason;

SELECT
 (SELECT COUNT(*) FROM stg_customers_raw WHERE batch_id=:batch_id) raw_rows,
 :accepted_rows+:quarantine_rows accounted_rows;
9. Lỗi thường gặp
- Ghi đè raw: Mất khả năng truy vết và sửa rule.
- COALESCE mọi NULL thành 0: Che giấu dữ liệu không được cung cấp.
- Dedup không có tie-breaker: Kết quả có thể thay đổi giữa lần chạy.
- Regex email quá tham vọng: Từ chối địa chỉ hợp lệ hoặc tạo cảm giác xác thực giả.
- Xóa quarantine: Mất bằng chứng và cơ hội sửa dữ liệu.
10. Đưa vào thực tế
Mỗi rule có rule_id, version, severity và owner. Critical rule có thể dừng pipeline; warning vẫn nạp nhưng tạo cảnh báo.
Dữ liệu cá nhân trong quarantine cần hạn chế quyền và thời hạn lưu. Không đưa email, điện thoại đầy đủ vào log hoặc thông báo lỗi.
11. Bài tập thực hành
- Tạo mảng chứa nhiều error_reason.
- Chuẩn hóa tên bằng initcap nhưng giữ tên gốc.
- Viết rule ngày sinh không nằm trong tương lai.
- Merge trường đầy đủ nhất từ các duplicate.
- Tạo dashboard chất lượng theo batch và nguồn.
12. Project mở rộng
Xây customer golden record có survivorship theo từng thuộc tính, không chỉ chọn toàn bộ một dòng. Email lấy từ nguồn xác thực, điện thoại lấy bản ghi mới nhất, tên lấy bản ghi đầy đủ nhất.
13. Tổng kết
Làm sạch dữ liệu tốt phải bảo toàn raw, giải thích quyết định và đo được số dòng qua mỗi nhánh. Một bảng clean không có lineage chưa phải sản phẩm đáng tin cậy.
Sau khi dữ liệu sạch, thiết kế khóa, constraint và index giúp ngăn lỗi quay trở lại ở lớp database.
14. Tài liệu tham khảo
TechData.AI - Leading the Future.
Tham khảo các khoá học theo link: https://techdata.ai/techdata-ai-course/
Hoàng Minh.