


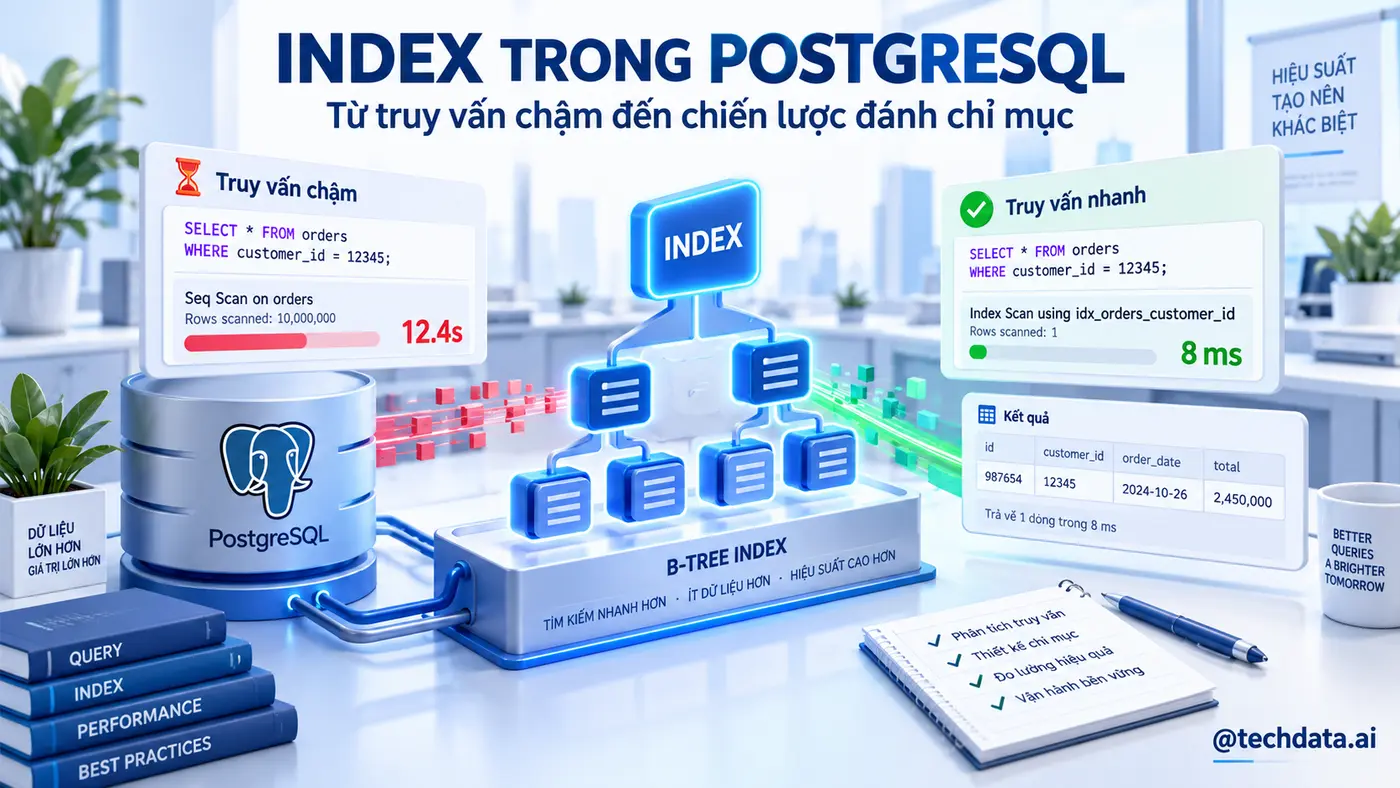

Index có thể biến một truy vấn từ vài giây xuống vài mili giây, nhưng cũng có thể làm chậm ghi dữ liệu và tiêu tốn bộ nhớ nếu được tạo theo cảm tính.
Bài viết dùng bảng đơn hàng tăng từ vài dòng lên hàng triệu dòng để giải thích PostgreSQL tìm dữ liệu như thế nào. Trọng tâm là cách chọn index dựa trên truy vấn thật, đo trước và sau, rồi kiểm tra index có thực sự được sử dụng.
Mục lục
- Index là gì và PostgreSQL phải trả giá gì?
- Tạo dữ liệu đủ lớn để nhìn thấy khác biệt
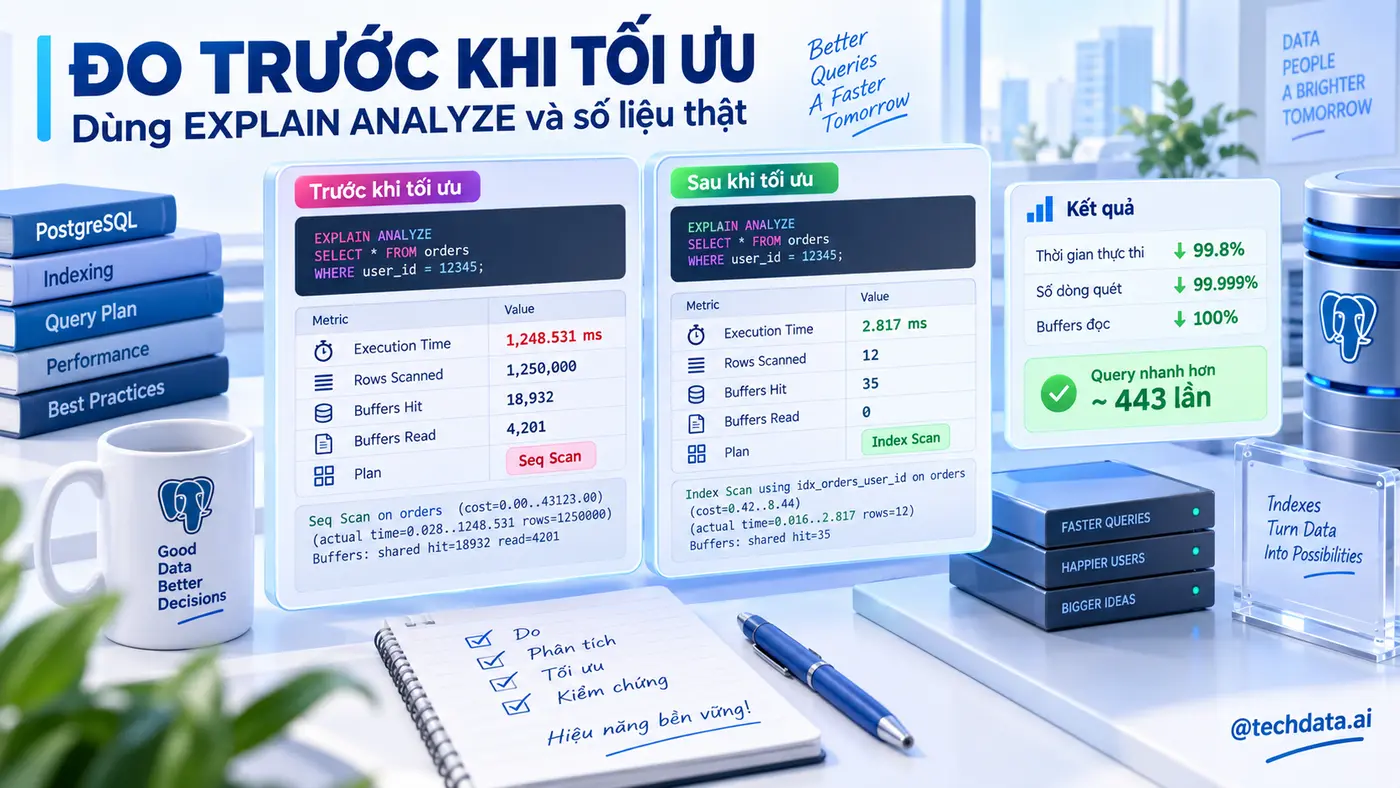
- Đo baseline trước khi tối ưu
- B-tree index cho điều kiện bằng và khoảng
- Partial index khi chỉ một phần dữ liệu thực sự quan trọng
- Covering index và INCLUDE để giảm đọc heap
- Vì sao có index nhưng PostgreSQL vẫn quét bảng?
- Expression index và GIN cho nhu cầu đặc thù
- Theo dõi bloat, index thừa và thao tác an toàn
- Quy trình review index cho một truy vấn chậm
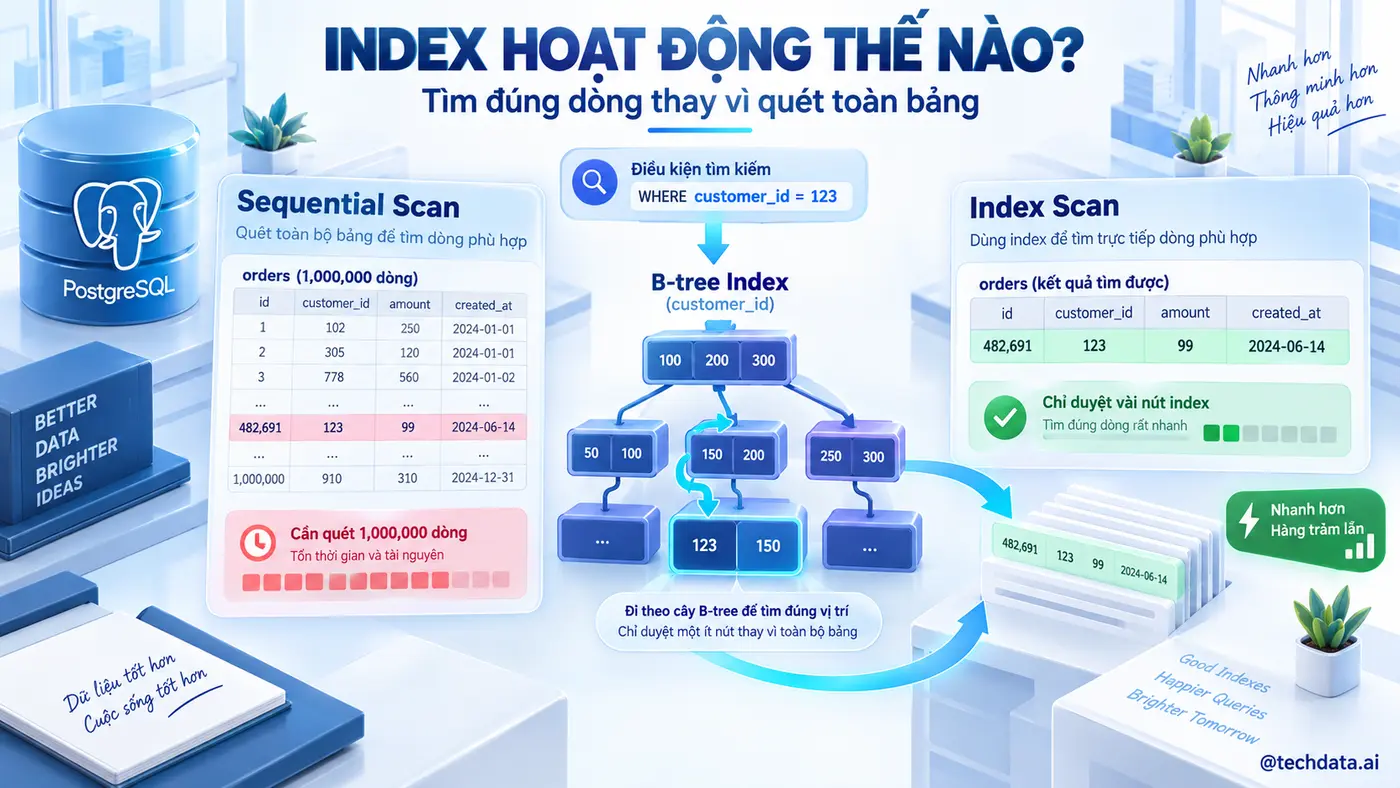
Index là gì và PostgreSQL phải trả giá gì?
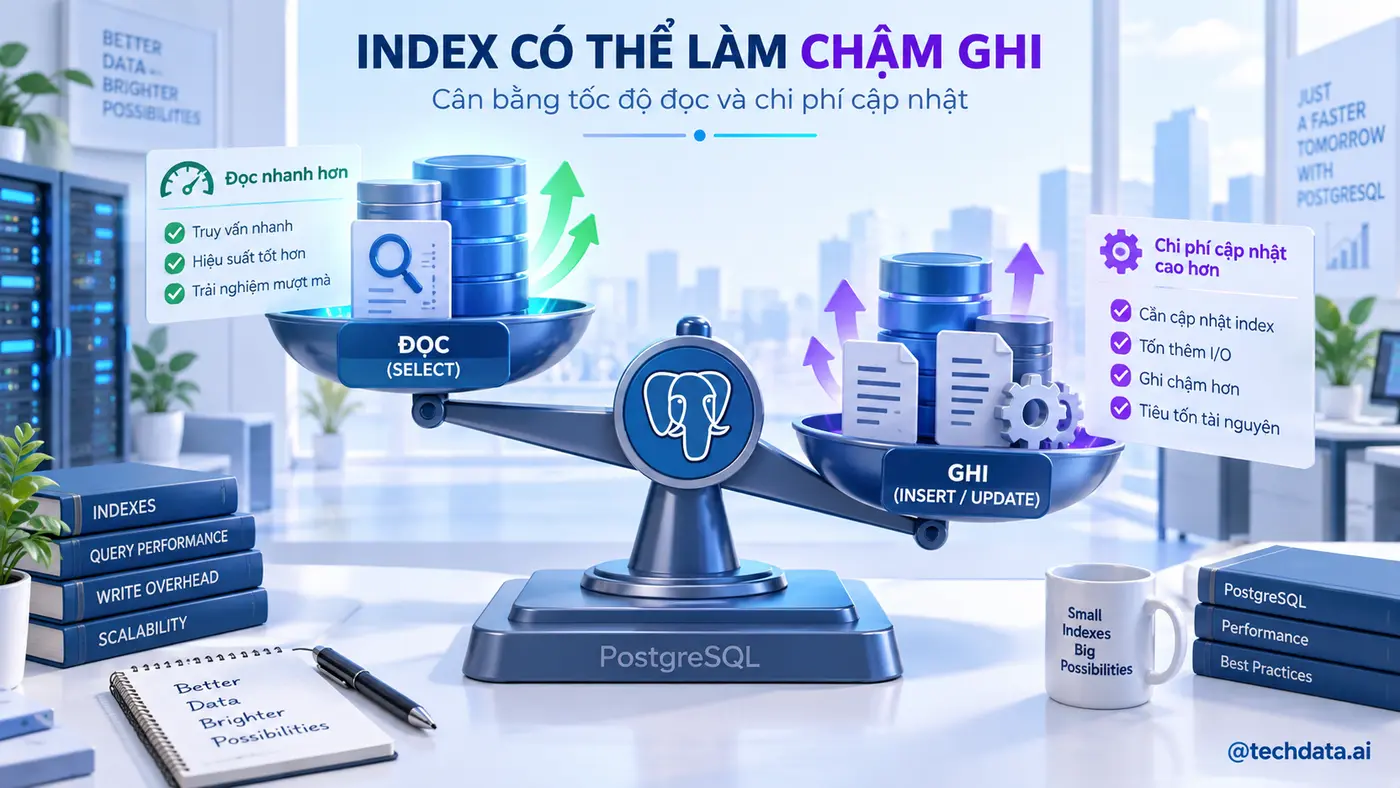
Index là cấu trúc dữ liệu phụ giúp PostgreSQL định vị bản ghi mà không phải đọc toàn bộ bảng. B-tree là loại mặc định, phù hợp với so sánh bằng, khoảng và sắp xếp. Lợi ích khi đọc đi kèm chi phí: mỗi lần INSERT, UPDATE hoặc DELETE, database phải duy trì thêm index.
Vì vậy mục tiêu không phải tạo càng nhiều index càng tốt. Một index có giá trị khi nó phục vụ truy vấn quan trọng đủ thường xuyên để bù cho chi phí ghi, lưu trữ và cache.
Tạo dữ liệu đủ lớn để nhìn thấy khác biệt
Với bảng vài trăm dòng, sequential scan thường nhanh hơn đi qua index. Bài thử nghiệm cần đủ dữ liệu để planner có lựa chọn thực sự.
CREATE TABLE sales.orders_bench AS
SELECT g AS order_id,
       (1 + random()*99999)::bigint AS customer_id,
       date '2024-01-01' + (random()*900)::int AS order_date,
       (ARRAY['pending','paid','cancelled'])[1+(random()*2)::int] AS status,
       round((100000 + random()*9900000)::numeric,2) AS total_amount
FROM generate_series(1,1000000) g;
ANALYZE sales.orders_bench;
ANALYZE cập nhật thống kê để planner ước lượng đúng phân bố dữ liệu. Benchmark thiếu bước này dễ đưa ra kết luận sai.
Đo baseline trước khi tối ưu
Truy vấn mẫu lấy đơn đã thanh toán của một khách hàng trong khoảng thời gian. Hãy chạy nhiều lần và ghi lại execution time, số block đọc và loại scan.
EXPLAIN (ANALYZE, BUFFERS)
SELECT order_id, order_date, total_amount
FROM sales.orders_bench
WHERE customer_id = 42017
  AND status = 'paid'
  AND order_date >= date '2026-01-01'
ORDER BY order_date DESC;
Baseline thường là sequential scan vì bảng chưa có index. Con số cụ thể phụ thuộc máy, cache và dữ liệu; điều cần so sánh là cùng một môi trường và cùng truy vấn.
B-tree index cho điều kiện bằng và khoảng
CREATE INDEX idx_orders_customer_date
ON sales.orders_bench(customer_id, order_date DESC);
ANALYZE sales.orders_bench;
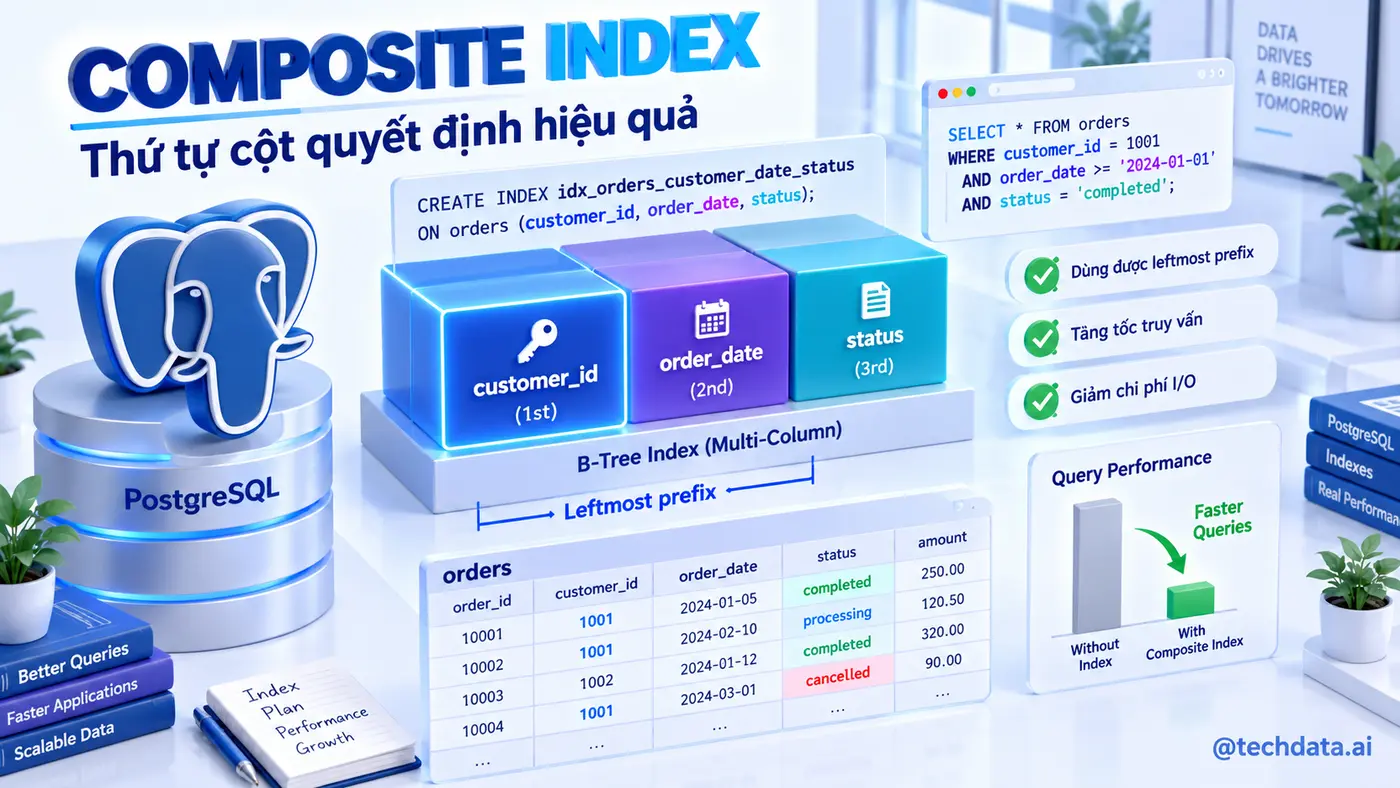
Trong composite index, cột dùng điều kiện bằng thường đặt trước, cột khoảng hoặc sắp xếp đặt sau. Index này giúp thu hẹp theo khách hàng rồi đọc các ngày theo thứ tự đã cần.
Quy tắc cột trái rất quan trọng: index trên (customer_id, order_date) hữu ích khi lọc customer_id, nhưng không phải lựa chọn tốt cho truy vấn chỉ lọc order_date trên toàn bộ bảng.
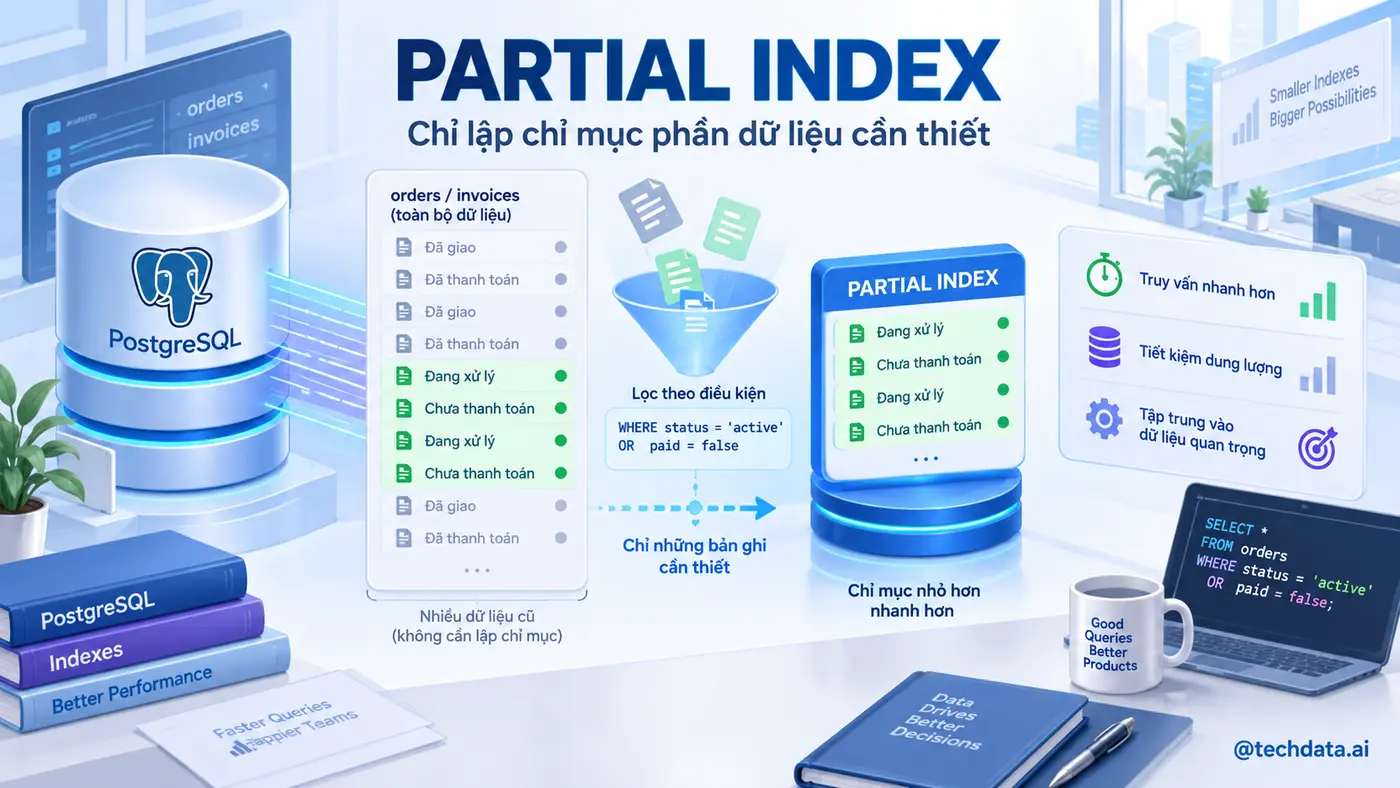
Partial index khi chỉ một phần dữ liệu thực sự quan trọng
Nếu dashboard chủ yếu đọc đơn paid, partial index chỉ lưu nhóm đó, nhỏ hơn và rẻ hơn index toàn bảng.
CREATE INDEX idx_paid_orders_customer_date
ON sales.orders_bench(customer_id, order_date DESC)
WHERE status='paid';
Điều kiện truy vấn phải tương thích với predicate của index. Nếu ứng dụng truyền logic quá trừu tượng khiến planner không chứng minh được điều kiện, index có thể không được dùng.
Covering index và INCLUDE để giảm đọc heap
CREATE INDEX idx_paid_orders_cover
ON sales.orders_bench(customer_id, order_date DESC)
INCLUDE (order_id,total_amount)
WHERE status='paid';
INCLUDE lưu thêm cột phục vụ kết quả nhưng không đưa chúng vào khóa sắp xếp. Khi visibility map phù hợp, PostgreSQL có thể dùng index-only scan và tránh đọc bảng chính. Đổi lại, index lớn hơn và tốn chi phí bảo trì.
Vì sao có index nhưng PostgreSQL vẫn quét bảng?
Planner có thể chọn sequential scan khi truy vấn trả về phần lớn bảng, thống kê cũ, biểu thức không khớp index hoặc bảng quá nhỏ. Đây không mặc định là lỗi. Database chọn kế hoạch có chi phí ước lượng thấp nhất.
SELECT schemaname, relname, indexrelname, idx_scan
FROM pg_stat_user_indexes
WHERE relname='orders_bench'
ORDER BY idx_scan DESC;
Không nên ép planner bằng cách tắt sequential scan trong production. Hãy kiểm tra selectivity, kiểu dữ liệu, phép cast và thống kê trước.
Expression index và GIN cho nhu cầu đặc thù
Truy vấn không phân biệt hoa thường có thể dùng index trên biểu thức. Dữ liệu JSONB, mảng hoặc tìm kiếm toàn văn thường phù hợp với GIN hơn B-tree.
CREATE INDEX idx_customers_email_lower
ON sales.customers (lower(email));
SELECT * FROM sales.customers WHERE lower(email)=lower('AN@example.com');
Mỗi loại index giải quyết một dạng toán tử. Chọn loại index từ pattern truy vấn, không từ tên kiểu dữ liệu đơn thuần.
Theo dõi bloat, index thừa và thao tác an toàn
Index không dùng làm tăng thời gian ghi và backup. Hãy quan sát pg_stat_user_indexes qua chu kỳ tải đủ dài trước khi xóa. Khi tạo index trên bảng production lớn, CREATE INDEX CONCURRENTLY giảm khóa ghi nhưng chạy lâu hơn và không được đặt trong transaction block.
REINDEX, VACUUM và autovacuum liên quan trực tiếp đến sức khỏe index. Đừng tối ưu một truy vấn riêng lẻ mà bỏ qua tác động tổng thể đến workload.
Quy trình review index cho một truy vấn chậm
Đầu tiên lưu SQL và tham số thật, lấy EXPLAIN ANALYZE BUFFERS, đo tỷ lệ bản ghi được chọn và kiểm tra index hiện có. Sau đó tạo một index tối thiểu trên môi trường thử nghiệm, chạy lại nhiều lần và so sánh thời gian, block đọc, kích thước index và chi phí ghi.
Bài thực hành đạt khi kế hoạch chuyển sang scan phù hợp, kết quả không đổi, thời gian và block đọc giảm có ý nghĩa, đồng thời giải thích được vì sao thứ tự cột được chọn. Đây là bằng chứng tốt hơn mọi quy tắc thuộc lòng.
Kết luận
Index hiệu quả là kết quả của quan sát workload, không phải một danh sách mẹo. Khi biết đo baseline, đọc kế hoạch và cân bằng đọc với ghi, người làm dữ liệu có thể tối ưu đúng điểm nghẽn mà không biến database thành một tập index khó vận hành.
TechData.AI - Leading the Future.
Tham khảo các khoá học theo link: https://techdata.ai/techdata-ai-course/
Hoàng Minh.