


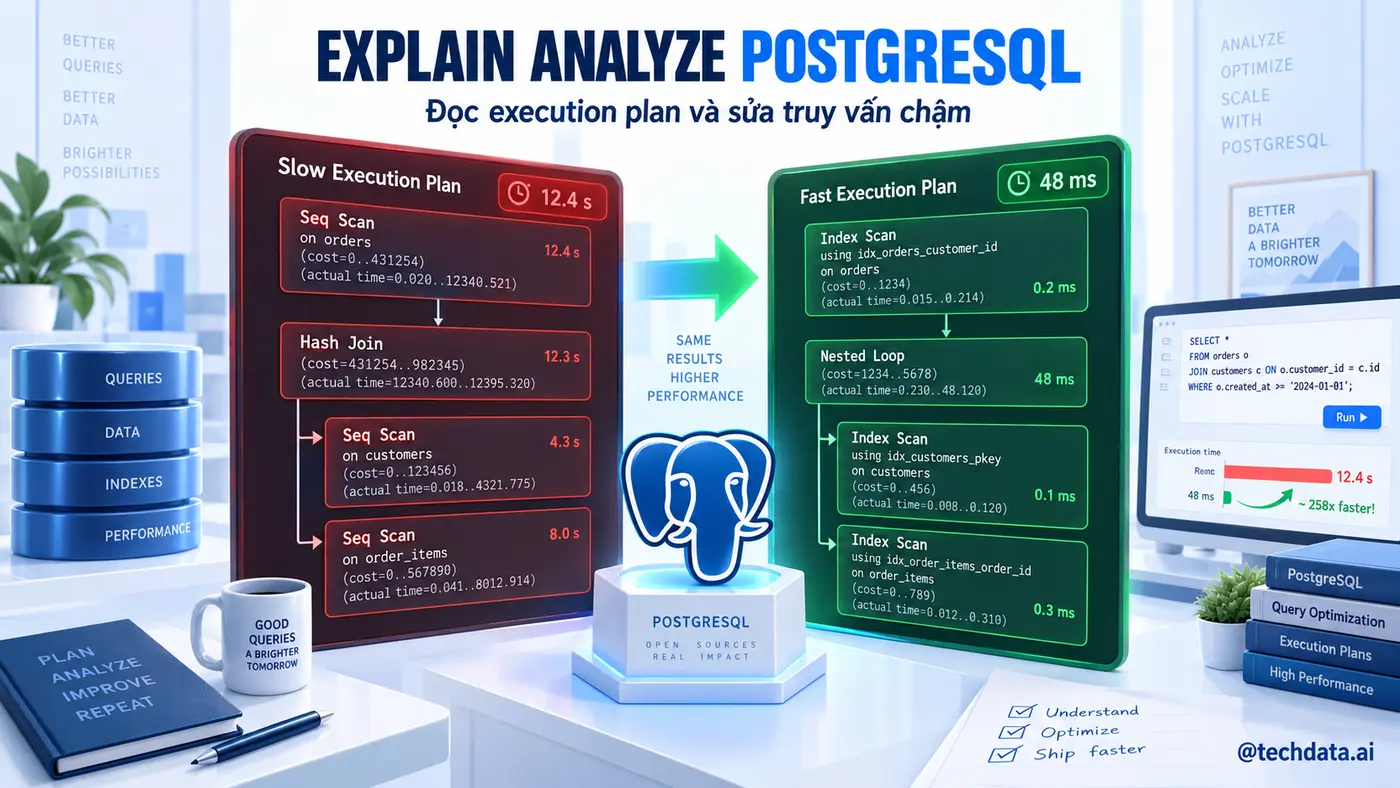

EXPLAIN ANALYZE PostgreSQL là công cụ cốt lõi để đọc execution plan, xác định nơi truy vấn tiêu tốn thời gian và tối ưu bằng bằng chứng.
Tối ưu SQL không bắt đầu bằng việc thêm index. Nó bắt đầu bằng bằng chứng về nơi PostgreSQL đang dành thời gian, đọc dữ liệu và ước lượng sai.
Bài viết giải phẫu execution plan của một báo cáo doanh thu, từ node ngoài cùng đến từng phép scan và join. Người đọc sẽ biết cách phân biệt cost với thời gian thật, phát hiện sai lệch cardinality và kiểm chứng một thay đổi tối ưu.
Mục lục
- 1. EXPLAIN khác EXPLAIN ANALYZE như thế nào?
- 2. Đọc execution plan từ trong ra ngoài
- 3. Cost, time và rows: ba nhóm số không được trộn lẫn
- 4. BUFFERS cho biết dữ liệu đến từ cache hay ổ đĩa
- 5. Seq Scan, Index Scan và Bitmap Scan
- 6. Nested Loop, Hash Join và Merge Join
- 7. Nhận biết Sort, Aggregate và spill ra đĩa
- 8. Sửa ước lượng cardinality sai
- 9. Quy trình tối ưu truy vấn có thể lặp lại
- 10. Bài tập review plan và tiêu chí đạt
EXPLAIN khác EXPLAIN ANALYZE như thế nào?
EXPLAIN hiển thị kế hoạch ước lượng mà không chạy truy vấn. EXPLAIN ANALYZE thực thi thật và bổ sung actual time, rows, loops. Vì vậy cần thận trọng với UPDATE, DELETE và INSERT; có thể bọc trong transaction rồi rollback khi thử nghiệm.
BEGIN;
EXPLAIN (ANALYZE, BUFFERS, VERBOSE)
UPDATE sales.orders SET status='paid' WHERE order_id=1001;
ROLLBACK;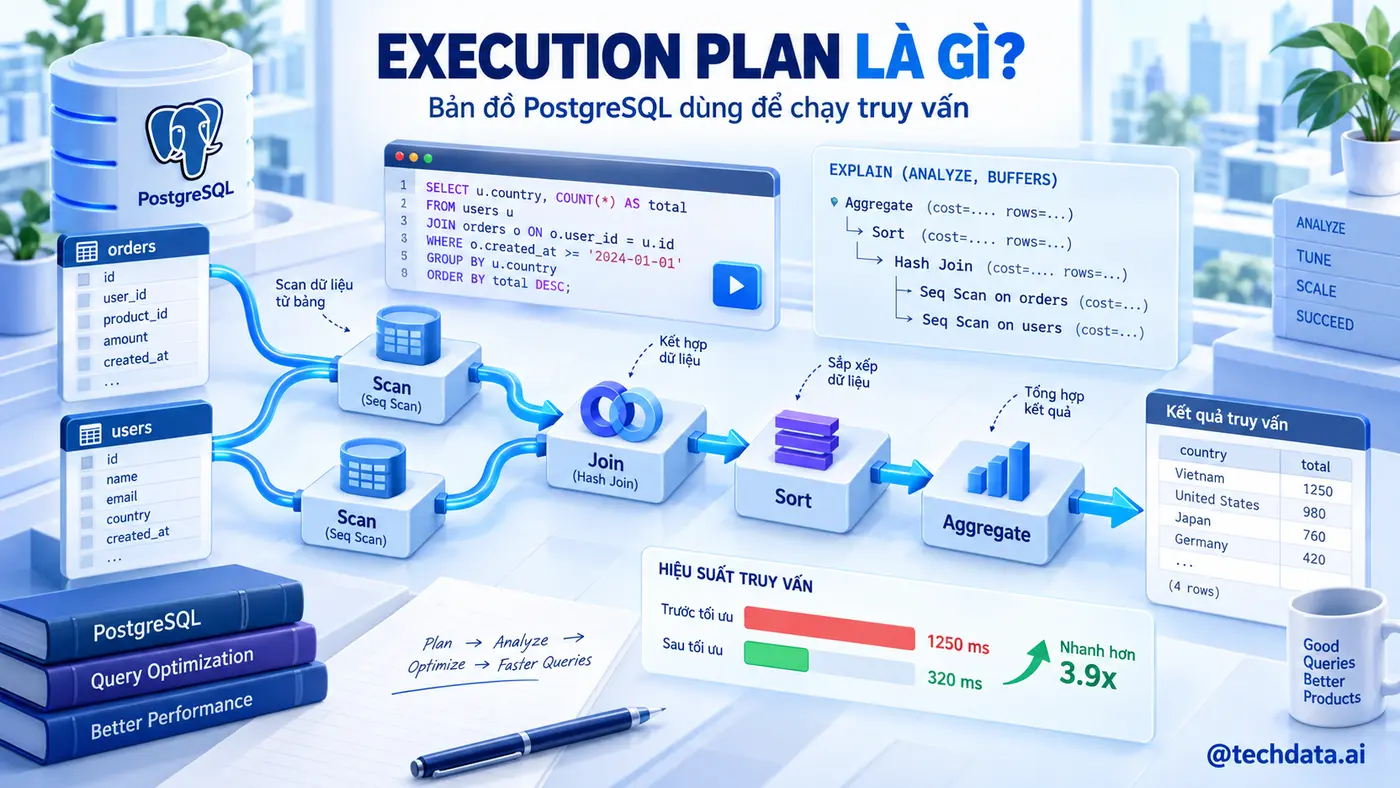
Đọc execution plan từ trong ra ngoài
Mỗi node nhận dữ liệu từ node con, xử lý rồi chuyển lên trên. Nên bắt đầu ở node sâu nhất để biết dữ liệu được lấy thế nào, sau đó theo dòng chảy lên join, aggregate, sort và node gốc.
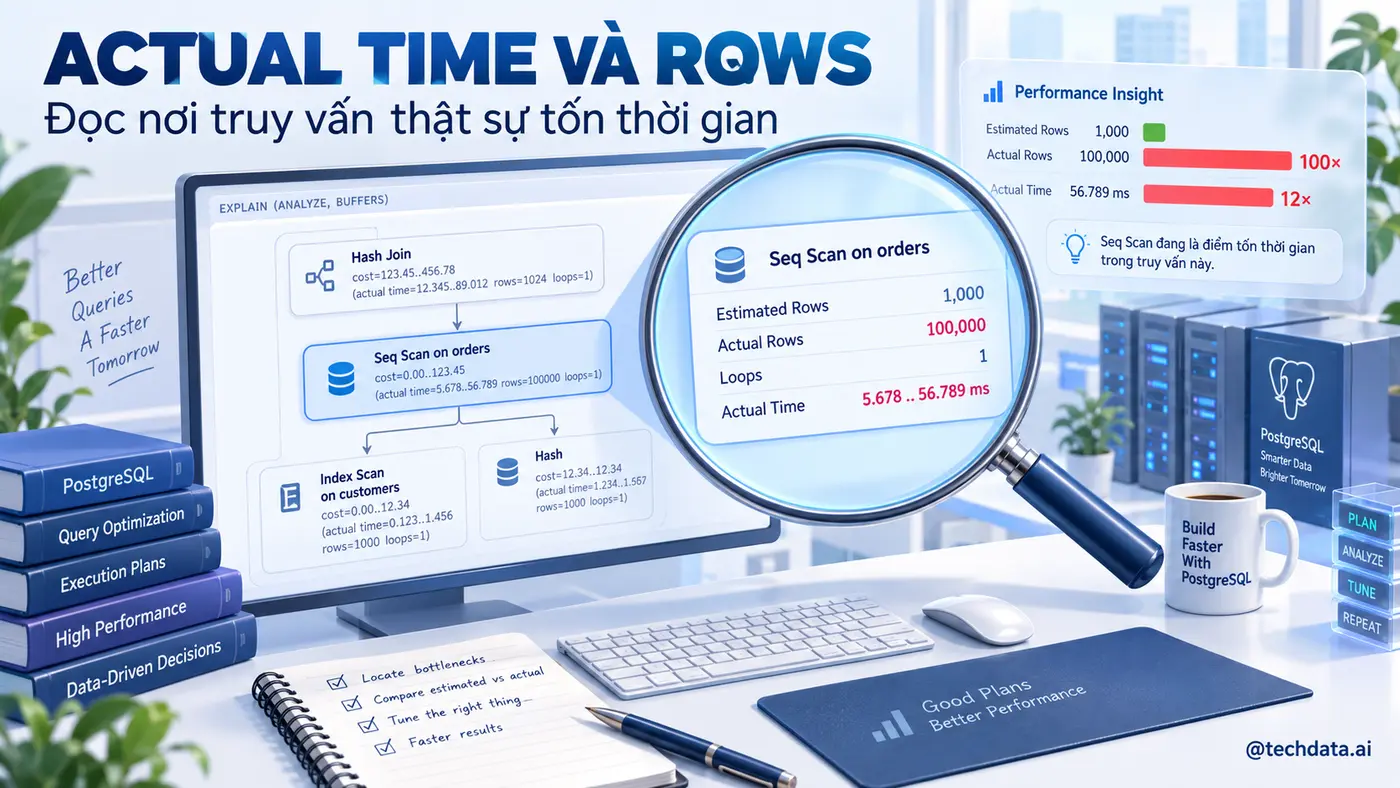
actual time=a..b cho biết thời điểm xuất hiện dòng đầu và kết thúc node. rows là số dòng mỗi vòng; tổng công việc cần xét cùng loops. Node chậm chưa chắc là nguyên nhân gốc nếu đầu vào của nó đã bị phình từ node dưới.
Cost, time và rows: ba nhóm số không được trộn lẫn
Cost là đơn vị nội bộ để planner so sánh kế hoạch, không phải mili giây. Actual time là thời gian quan sát trong lần chạy. Estimated rows so với actual rows cho biết planner hiểu dữ liệu tốt đến đâu.
Nếu ước lượng 10 dòng nhưng thực tế 500.000 dòng, PostgreSQL có thể chọn nested loop sai chỗ hoặc cấp thiếu bộ nhớ cho sort. Khi đó, sửa thống kê hoặc mô hình dữ liệu có thể quan trọng hơn thêm index.
BUFFERS cho biết dữ liệu đến từ cache hay ổ đĩa
EXPLAIN (ANALYZE, BUFFERS)
SELECT c.customer_id, SUM(i.quantity*i.unit_price) revenue
FROM sales.customers c
JOIN sales.orders o USING(customer_id)
JOIN sales.order_items i USING(order_id)
WHERE o.status='paid'
GROUP BY c.customer_id
ORDER BY revenue DESC
LIMIT 20;
Shared hit là block đã có trong cache; shared read là block phải đọc vào. Hai lần chạy liên tiếp có thể khác mạnh do cache, vì vậy benchmark cần warm-up và ghi rõ điều kiện thử nghiệm.
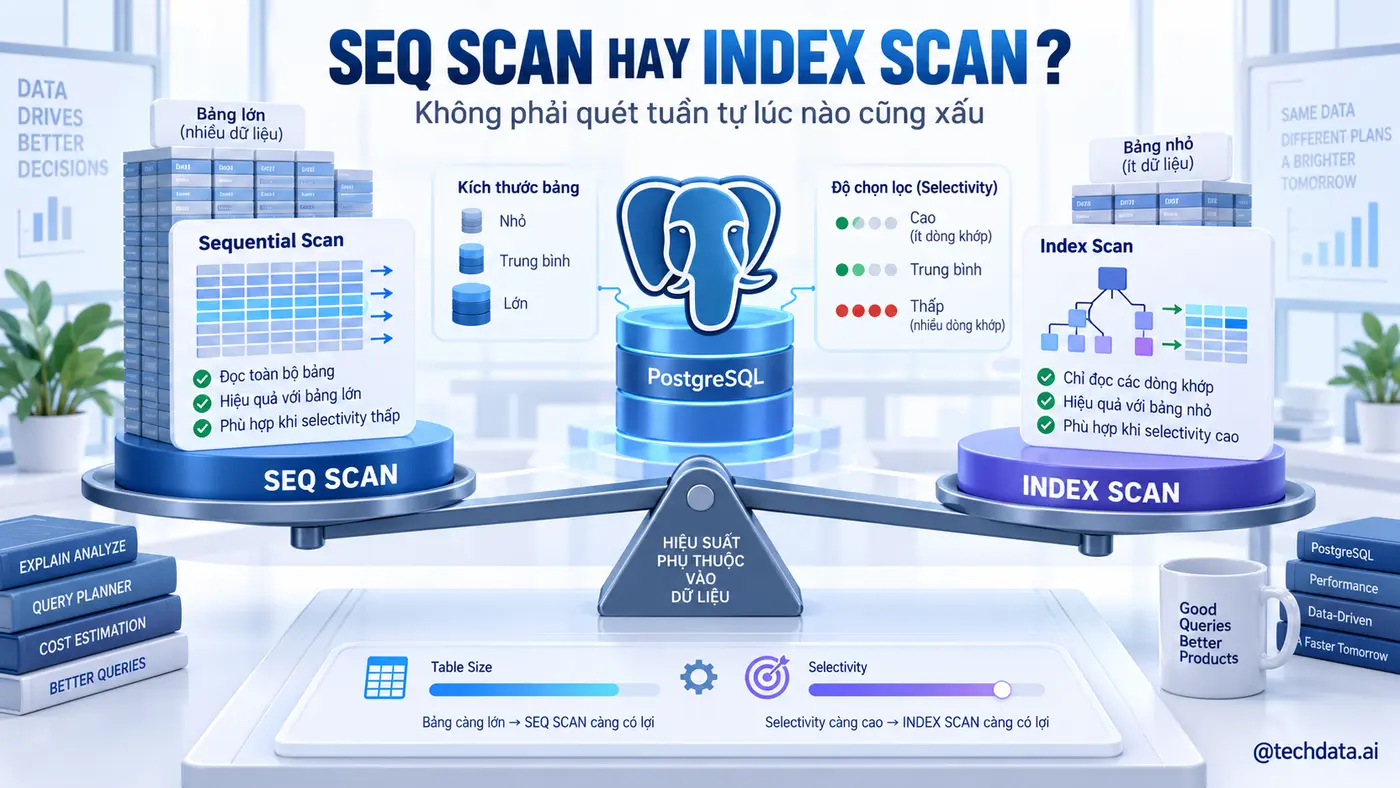
Seq Scan, Index Scan và Bitmap Scan
Seq Scan đọc tuần tự toàn bảng, hiệu quả khi cần tỷ lệ lớn dữ liệu. Index Scan đi qua index rồi lấy dòng từ heap, phù hợp với tập kết quả nhỏ. Bitmap Index Scan gom vị trí trước khi đọc heap, thường hiệu quả ở khoảng giữa.
Không đánh giá plan bằng tên node. Cần hỏi bao nhiêu block được đọc, bao nhiêu dòng bị loại và tổng thời gian ra sao.
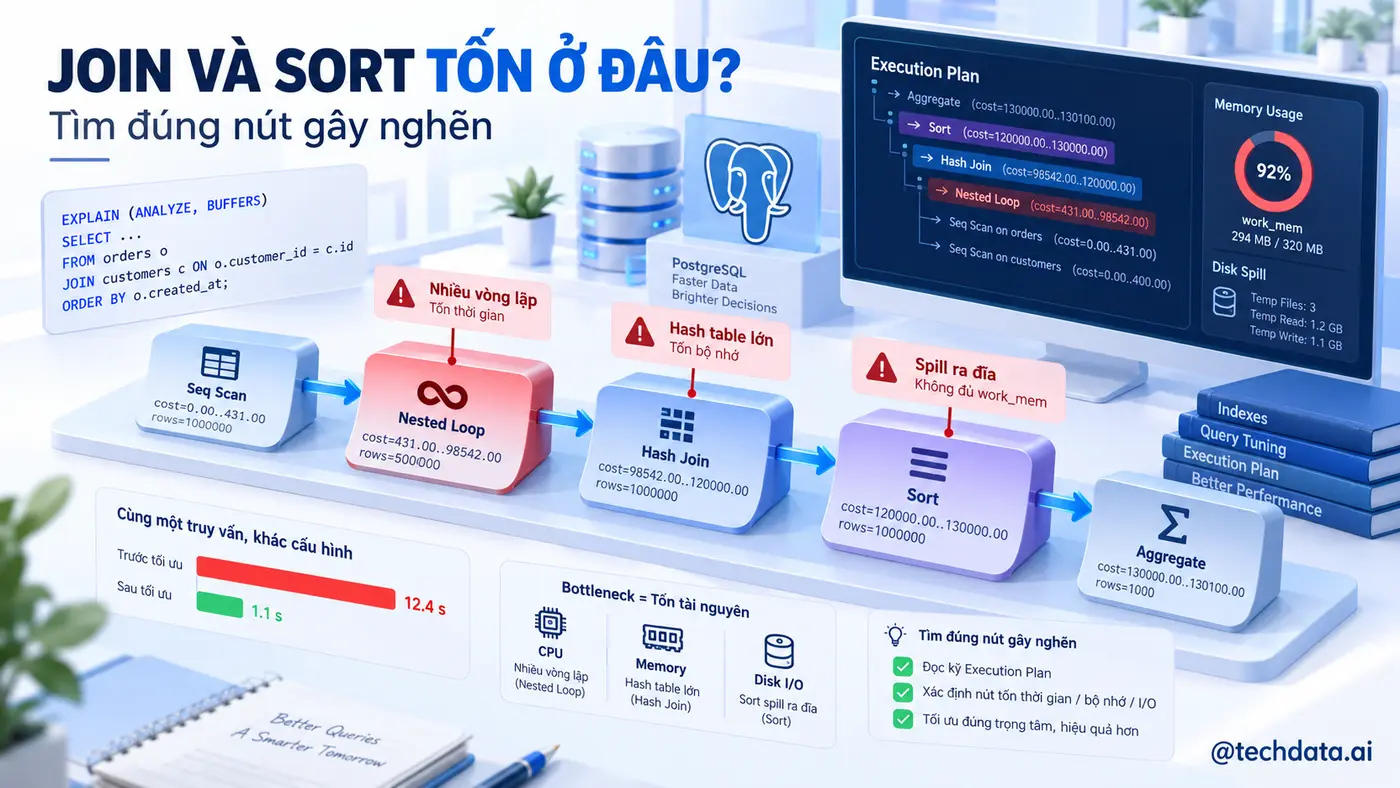
Nested Loop, Hash Join và Merge Join
Nested Loop tốt khi đầu ngoài nhỏ và phía trong có index. Hash Join phù hợp với phép bằng trên tập lớn, nhưng có thể spill ra đĩa nếu thiếu work_mem. Merge Join tận dụng hai nguồn đã sắp xếp và hiệu quả cho một số dữ liệu lớn.
SET LOCAL work_mem='64MB';
EXPLAIN (ANALYZE, BUFFERS)
SELECT ... ;
Không đặt work_mem toàn hệ thống ở mức cao chỉ vì một truy vấn. Giá trị này có thể được dùng nhiều lần trong một truy vấn và đồng thời bởi nhiều phiên.
Nhận biết Sort, Aggregate và spill ra đĩa
Plan sẽ ghi “Sort Method” và lượng bộ nhớ. External merge hoặc temp read/write là dấu hiệu dữ liệu tràn ra đĩa. HashAggregate cũng có thể chia batch khi bộ nhớ không đủ.
Giải pháp có thể là giảm dữ liệu sớm, tạo index hỗ trợ thứ tự, thay đổi truy vấn hoặc điều chỉnh bộ nhớ ở phạm vi phiên. Cần đo lại vì mỗi lựa chọn có trade-off.
Sửa ước lượng cardinality sai
Chạy ANALYZE khi thống kê cũ. Tăng statistics target cho cột phân bố lệch hoặc tạo extended statistics khi các cột tương quan mạnh.
ALTER TABLE sales.orders ALTER COLUMN status SET STATISTICS 500;
CREATE STATISTICS st_orders_customer_status (dependencies)
ON customer_id, status FROM sales.orders;
ANALYZE sales.orders;
Thống kê chi tiết hơn cũng tốn thời gian analyze và dung lượng catalog, nên áp dụng cho cột thực sự gây sai lệch.
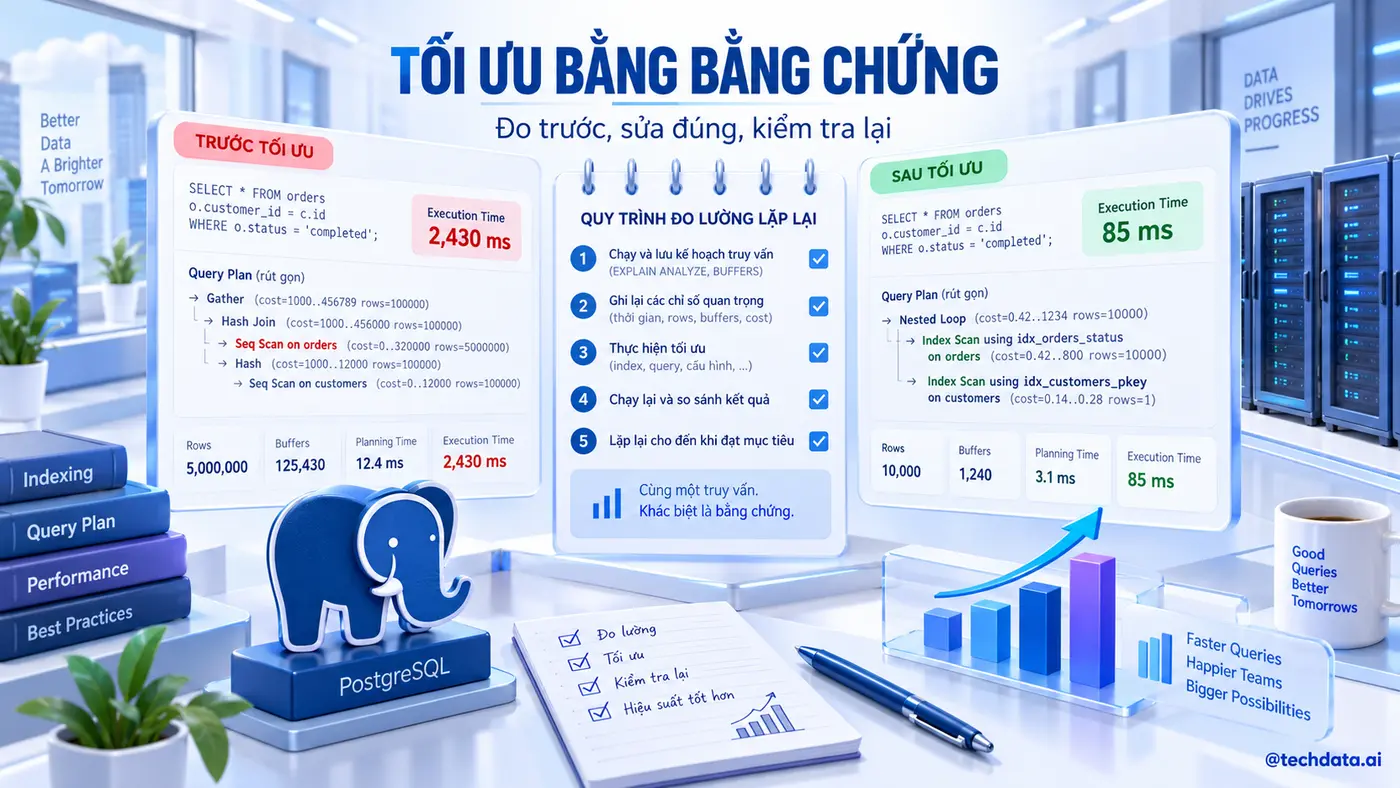
Quy trình tối ưu truy vấn có thể lặp lại
Chụp baseline với SQL và tham số thật; đọc node từ dưới lên; tìm chênh lệch estimate/actual; xác định I/O, CPU, sort hay lock là nút thắt; thay đổi một yếu tố; chạy lại trong cùng điều kiện; so sánh kết quả và chi phí ghi.
Luôn kiểm tra truy vấn tối ưu trả về đúng cùng dữ liệu. Một câu SQL nhanh hơn vì vô tình loại mất dòng không phải là thành công.
Bài tập review plan và tiêu chí đạt
Tạo một triệu đơn hàng, chạy báo cáo doanh thu theo khách hàng khi chưa có index, sau đó thêm partial covering index cho đơn paid. Ghi lại execution time, shared read/hit, loại scan, estimated rows và actual rows ở cả hai lần.
Bài làm đạt khi giải thích được node tốn thời gian nhất, nguyên nhân, bằng chứng trước–sau và tác động phụ. Không chấp nhận kết luận chỉ dựa trên việc score hoặc thời gian của một lần chạy giảm.
Kết luận
EXPLAIN ANALYZE biến tối ưu từ đoán mò thành một quy trình kỹ thuật. Người đọc plan tốt không tìm node “xấu” theo công thức; họ đối chiếu ước lượng với thực tế, hiểu luồng dữ liệu và chỉ thay đổi khi có thể đo được lợi ích.
TechData.AI - Leading the Future.
Tham khảo các khoá học theo link: https://techdata.ai/techdata-ai-course/
Hoàng Minh.