



Một khách hàng mua laptop giá 15 triệu đồng. Tuần sau, cửa hàng đổi tên sản phẩm và tăng giá lên 16 triệu. Khi mở lại đơn cũ, bạn muốn thấy giá nào? Nếu câu trả lời là 15 triệu, cấu trúc document phải thể hiện được điều đó ngay từ lúc thiết kế.
Ở bài 1 về MongoDB và CRUD, bạn đã thao tác trên một danh mục sản phẩm. Bài 2 mở rộng thành khách hàng, đơn hàng và đánh giá. Mục tiêu là tự giải thích được vì sao một thông tin được nhúng vào document, còn thông tin khác được đặt ở collection riêng.
Vị trí trong chuỗi: bài 2/6. Sau thiết kế dữ liệu, chúng ta sẽ lần lượt học truy vấn nâng cao, aggregation, index và transaction.
1. Mục tiêu và điều kiện thực hành
- Đọc yêu cầu nghiệp vụ để xác định cách truy cập dữ liệu.
- Thiết kế mô hình kết hợp embedding và references.
- Lưu thông tin đơn hàng theo thời điểm mua bằng snapshot.
- Tách đánh giá để tránh mảng tăng không giới hạn.
- Thêm schema validation và chủ động kiểm tra dữ liệu sai.
Cần biết trước: database, collection, document, insertOne, find và updateOne. Môi trường minh họa: MongoDB Community 8.0, mongosh. Bài dùng database mới techdata_mongodb_modeling_lab, không thay đổi dữ liệu của bài 1. Các tên người, địa chỉ và sản phẩm đều là dữ liệu giả lập phục vụ học tập.
Mục lục
- Bắt đầu từ cách ứng dụng dùng dữ liệu
- Embedding và references khác nhau thế nào?
- Chuẩn bị môi trường
- Tạo khách hàng và sản phẩm mẫu
- Nhúng dòng hàng và lưu snapshot
- Đọc dữ liệu tham chiếu với $lookup
- Tách đánh giá thành collection riêng
- Kiểm soát schema bằng validation
- Review mô hình và lỗi thường gặp
- Bài tập và gợi ý lời giải
- Tổng kết và bài tiếp theo
- Tài liệu tham khảo
2. Bắt đầu từ cách ứng dụng dùng dữ liệu
Trước khi tạo collection, hãy viết ra ba màn hình mà cửa hàng cần: xem chi tiết một đơn, xem hồ sơ hiện tại của khách và xem đánh giá gần đây của một sản phẩm. Đây là access pattern: cách ứng dụng đọc và ghi dữ liệu để thực hiện một chức năng.
| Chức năng | Dữ liệu cần đọc | Câu hỏi thiết kế |
|---|---|---|
| Chi tiết đơn hàng | Dòng hàng, giá lúc mua, địa chỉ giao | Cần giữ thông tin nào khi danh mục thay đổi? |
| Hồ sơ khách hàng | Tên và địa chỉ liên hệ hiện tại | Thông tin nào được dùng chung giữa nhiều đơn? |
| Đánh giá sản phẩm | Một nhóm đánh giá, thường là mới nhất | Số đánh giá có giới hạn thực tế không? |
Hãy thử làm ngược lại: tạo một document khách hàng rồi nhúng toàn bộ đơn, mọi sản phẩm và tất cả đánh giá vào đó. Lúc đầu có vẻ tiện vì mọi thứ ở một chỗ. Nhưng một khách mua nhiều năm sẽ làm document phình lên; cập nhật sản phẩm cũng không còn có một vị trí rõ ràng.
Khuyến nghị của bài là ghi rõ chức năng, dữ liệu cần đọc, tần suất cập nhật và mức tăng số lượng trước khi quyết định cấu trúc. Viết được các giả định này sẽ giúp bạn nhận ra khi mô hình cần thay đổi, thay vì tranh luận chung chung rằng SQL hay NoSQL nhanh hơn.
3. Embedding và references khác nhau thế nào?
Embedding là đặt dữ liệu liên quan ngay trong document cha. References là lưu một định danh để liên hệ với document khác. Hướng dẫn MongoDB đề xuất cân nhắc dữ liệu thường dùng cùng nhau, số lượng dữ liệu con, mức tăng trưởng và chi phí cập nhật bản sao khi lựa chọn. [1]
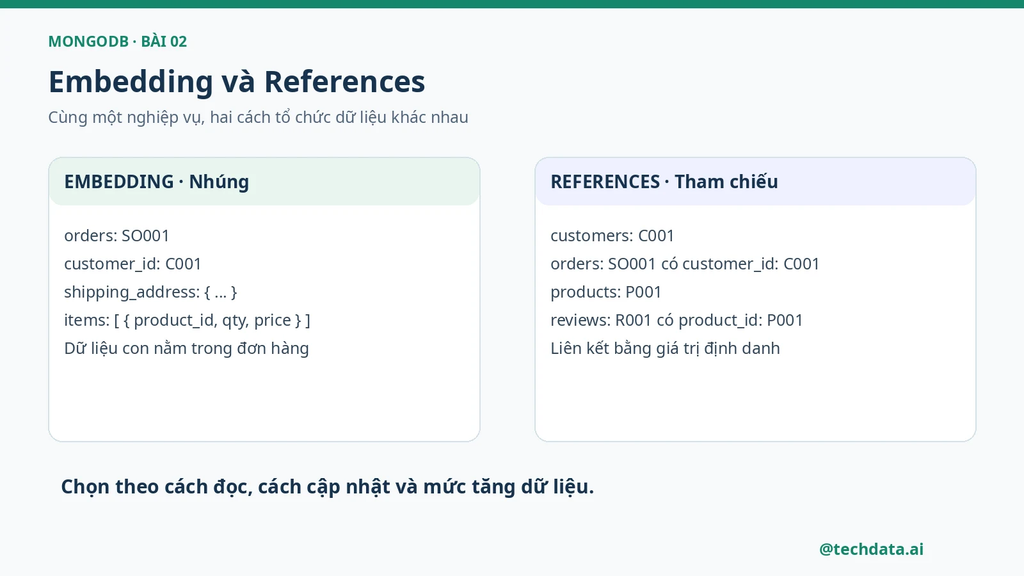
Trong mô hình của bài, một đơn hàng chứa mảng items và shipping_address. Đơn cũng có customer_id để liên hệ với khách hàng. Một dòng hàng chứa product_id, nhưng vẫn giữ tên và giá tại thời điểm mua.
Như vậy, embedding và references có thể cùng xuất hiện trong một document. Điều cần thống nhất là ý nghĩa: product_id dùng để nhận diện sản phẩm, còn unit_price_vnd trong dòng hàng là mức giá đã chốt của giao dịch đó.
Đừng chỉ hỏi “một-nhiều thì dùng gì?”. Một sản phẩm có vài thuộc tính kỹ thuật và một sản phẩm có hàng triệu đánh giá đều là quan hệ một-nhiều theo cách nói rộng. Tuy nhiên, mức tăng và cách đọc hai loại dữ liệu này rất khác nhau.
4. Chuẩn bị môi trường
Nếu đã làm bài 1, chạy các lệnh dưới ở terminal hệ điều hành để khởi động container và mở mongosh:
docker start techdata-mongo-lab
docker exec -it techdata-mongo-lab mongosh
Nếu chưa có container, dùng lệnh sau thay cho docker start, rồi mở mongosh bằng lệnh docker exec phía trên:
docker run -d --name techdata-mongo-lab -v techdata_mongo_lab_data:/data/db mongo:8.0Đây là lab cục bộ không mở cổng ra ngoài và không bật xác thực. Cấu hình này không dùng để triển khai dịch vụ thật. Nếu tiến trình chưa sẵn sàng, kiểm tra docker logs techdata-mongo-lab trước khi mở lại mongosh.
Từ đây trở đi, chạy các lệnh trong mongosh. Chọn database mới và kiểm tra tên:
use techdata_mongodb_modeling_lab
db.getName()
show collections
Tên cần là techdata_mongodb_modeling_lab. Trong lần đầu thực hành, database này chưa có collection. Nếu đã có dữ liệu từ một lần học trước, hãy dùng tên database lab mới rồi chạy từ đầu; không xóa dữ liệu để xử lý lỗi trùng khóa theo thói quen.
5. Tạo khách hàng và sản phẩm mẫu
db.customers.insertOne({
  _id: "C001",
  full_name: "Khách hàng mẫu",
  contact_address: { city: "TP.HCM", line1: "Địa chỉ liên hệ mẫu A" }
})

db.products.insertMany([
  {
    _id: "P001", name: "Laptop học Data",
    price_vnd: 15000000,
    specs: { ram_gb: 16, cpu: "Core i5" }
  },
  {
    _id: "P002", name: "Sách MongoDB cơ bản",
    price_vnd: 200000,
    specs: { author: "Tác giả mẫu", pages: 250 }
  }
])

db.customers.countDocuments({})
db.products.countDocuments({})
Kết quả mong đợi: lần lượt là 1 khách và 2 sản phẩm. Địa chỉ liên hệ thuộc hồ sơ hiện tại của khách. Các thuộc tính ram_gb hoặc pages nằm trong specs vì chúng mô tả sản phẩm cụ thể.
Ở đây ta dùng _id dạng chuỗi để dễ theo dõi. Vì C001 và P001 là chuỗi, các trường tham chiếu về sau cũng phải là chuỗi. Nếu một nơi lưu ObjectId còn nơi khác lưu chuỗi trông giống nhau, phép ghép theo giá trị sẽ không tự chuyển kiểu giúp bạn.
6. Nhúng dòng hàng và lưu snapshot
6.1. Thiết kế document đơn hàng
Ta quyết định đơn hàng trong ví dụ có số dòng hàng nhỏ và bị giới hạn theo chính sách ứng dụng. Màn hình chi tiết thường đọc các dòng cùng lúc. Địa chỉ giao và giá mua cần thể hiện thông tin đã chốt.
db.orders.insertOne({
  _id: "SO001",
  schema_version: 1,
  customer_id: "C001",
  created_at: ISODate("2026-11-12T02:00:00Z"),
  status: "confirmed",
  shipping_address: {
    recipient: "Người nhận mẫu",
    city: "TP.HCM",
    line1: "Địa chỉ giao hàng mẫu A"
  },
  items: [
    {
      product_id: "P001",
      name_at_purchase: "Laptop học Data",
      unit_price_vnd: 15000000,
      qty: 1
    },
    {
      product_id: "P002",
      name_at_purchase: "Sách MongoDB cơ bản",
      unit_price_vnd: 200000,
      qty: 2
    }
  ]
})

db.orders.findOne({ _id: "SO001" })
Kết quả mong đợi: một đơn có hai dòng hàng. Giá trị hàng hóa trước phí và giảm giá là 15.000.000 × 1 + 200.000 × 2 = 15.400.000 VND. Bài chưa lưu total_vnd để tránh tạo thêm một giá trị phải đồng bộ trong ví dụ nhập tay.
Trong ứng dụng thật, backend phải đọc giá từ nguồn đáng tin cậy và áp dụng quy tắc tính tiền; không lấy giá do trình duyệt khách hàng gửi lên làm giá chốt. Lệnh insertOne ở đây chỉ tạo bộ dữ liệu để học mô hình, chưa phải quy trình checkout hoàn chỉnh.
6.2. Kiểm tra điều gì xảy ra khi danh mục thay đổi
db.products.updateOne(
  { _id: "P001" },
  { $set: {
    name: "Laptop học Data phiên bản mới",
    price_vnd: 16000000
  } }
)

db.customers.updateOne(
  { _id: "C001" },
  { $set: { "contact_address.line1": "Địa chỉ liên hệ mẫu B" } }
)

db.products.findOne({ _id: "P001" })
db.orders.findOne({ _id: "SO001" })
Sản phẩm hiện tại có tên mới và giá 16 triệu. Trong đơn SO001, tên lúc mua vẫn là Laptop học Data, giá vẫn là 15 triệu và địa chỉ giao vẫn là mẫu A. MongoDB không tự sao chép các thay đổi vừa chạy sang document đơn hàng.
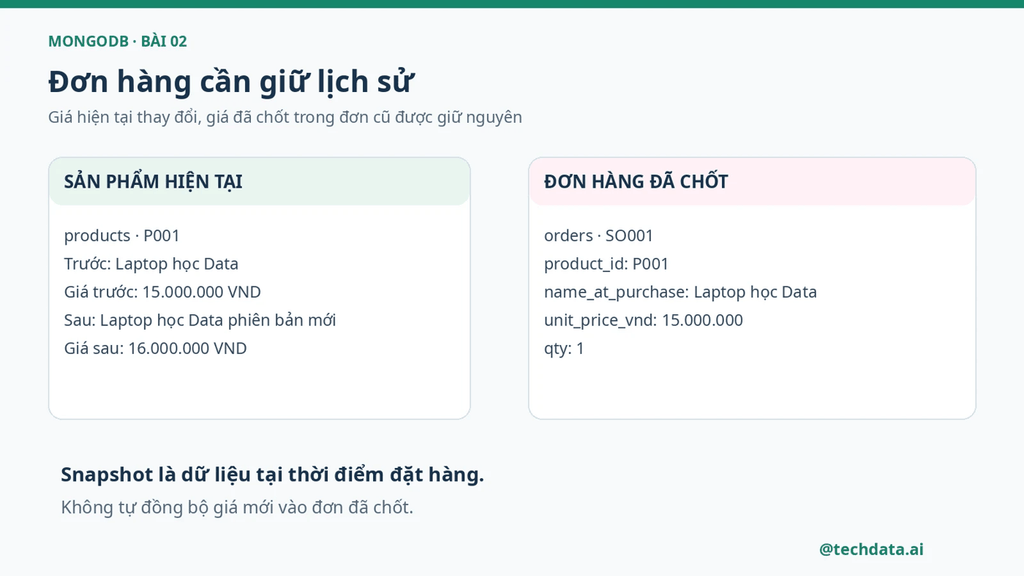
Snapshot là bản ghi giá trị ở một thời điểm. Đây là lựa chọn nghiệp vụ cho dữ liệu lịch sử: một thay đổi trong hồ sơ hiện tại không nhất thiết phải sửa quá khứ. [1] Nếu nghiệp vụ cho phép sửa đơn trước khi giao, cần quy định ai được sửa, sửa trường nào và lưu dấu vết ra sao.
6.3. Phân biệt snapshot với dữ liệu sao chép để tăng tốc
Giả sử trang tài khoản lưu thêm tổng số đơn để hiển thị nhanh. Con số đó cần thay đổi khi có đơn mới; nó là dữ liệu dẫn xuất cần cơ chế cập nhật. Ngược lại, giá đã chốt trên đơn cũ thường được giữ nguyên theo chính sách giao dịch.
Do đó, với mỗi trường sao chép, hãy ghi một trong hai ý nghĩa: giữ giá trị lịch sử hay phản ánh trạng thái hiện tại. Không thể dùng cùng một quy tắc “đồng bộ mọi bản sao” cho hai trường có mục đích khác nhau.
7. Đọc dữ liệu tham chiếu với $lookup
Màn hình hỗ trợ khách hàng có thể cần cả đơn cũ và tên khách hiện tại. Ta dùng customer_id trong orders để ghép với _id trong customers. $lookup thêm kết quả khớp vào một mảng; một quan hệ dự kiến một-một vẫn được trả về dưới dạng mảng trong cách dùng này. [2]
db.orders.aggregate([
  { $match: { _id: "SO001" } },
  {
    $lookup: {
      from: "customers",
      localField: "customer_id",
      foreignField: "_id",
      as: "customer_current"
    }
  },
  {
    $project: {
      _id: 1,
      shipping_address: 1,
      "customer_current.full_name": 1,
      "customer_current.contact_address": 1
    }
  }
])
Kết quả cần quan sát: shipping_address.line1 vẫn là địa chỉ giao mẫu A, trong khi phần contact_address của customer_current đã là địa chỉ liên hệ mẫu B. Đây là hai thông tin đúng cho hai mục đích khác nhau.
Trong đoạn này, $match chọn đơn; $lookup tìm khách; $project chọn trường hiển thị. Bài 4 sẽ giải thích sâu hơn cách các stage trong aggregation kết hợp với nhau.
Tham chiếu không phải khóa ngoại tự kiểm tra. Việc gán customer_id bằng C999 không tự chứng minh khách C999 tồn tại. Thiết kế ứng dụng cần xử lý kiểm tra tham chiếu, quy tắc xóa và trường hợp dữ liệu liên quan đã bị ẩn hoặc xóa. $lookup cũng có chi phí; hãy đo truy vấn thay vì kết luận rằng tách collection luôn nhanh. [2]
8. Tách đánh giá thành collection riêng
8.1. Vì sao không đưa mọi đánh giá vào products.reviews?
Một sản phẩm có thể nhận đánh giá qua nhiều năm. Nếu giữ toàn bộ trong một mảng, bạn đang cho phép kích thước document tăng theo hoạt động người dùng. MongoDB cảnh báo về mô hình mảng tăng không giới hạn; tách dữ liệu con hoặc chỉ giữ một tập con có giới hạn là các hướng cần cân nhắc. [3]
Giới hạn BSON document là 16 MiB, nhưng đó không phải mức kích thước mục tiêu để cố lấp đầy. [4] Một document chưa chạm giới hạn vẫn có thể không phù hợp với lượng dữ liệu mà màn hình thực sự cần đọc.
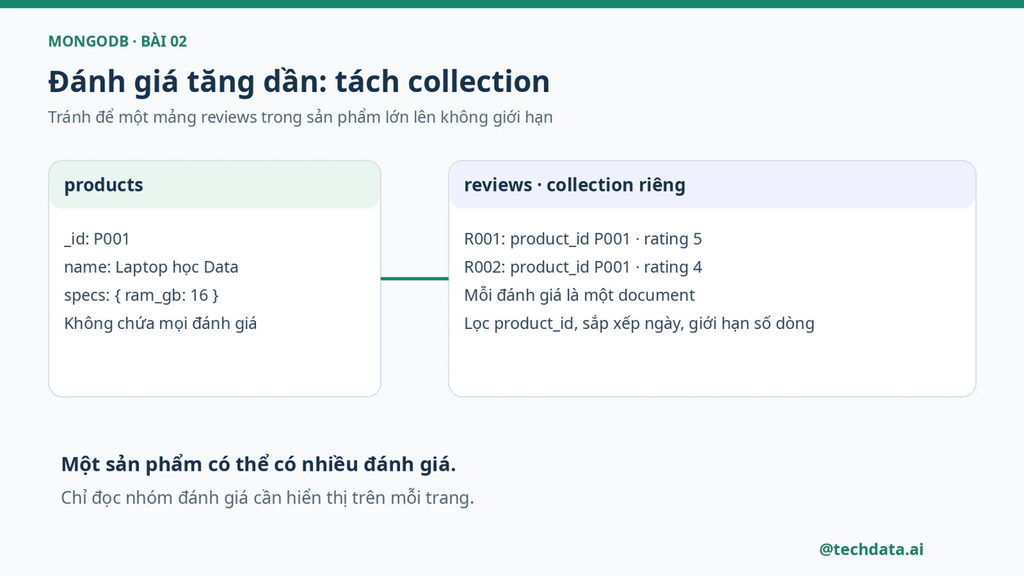
8.2. Tạo collection đánh giá và đọc một nhóm nhỏ
db.reviews.insertMany([
  {
    _id: "R001", product_id: "P001", customer_id: "C001",
    rating: 5, content: "Phù hợp học dữ liệu",
    created_at: ISODate("2026-11-12T02:10:00Z")
  },
  {
    _id: "R002", product_id: "P001", customer_id: "C001",
    rating: 4, content: "Đánh giá thử nghiệm thứ hai",
    created_at: ISODate("2026-11-12T02:20:00Z")
  }
])

db.reviews.createIndex({ product_id: 1, created_at: -1, _id: -1 })

db.reviews.find(
  { product_id: "P001" },
  { _id: 1, rating: 1, content: 1, created_at: 1 }
).sort({ created_at: -1, _id: -1 }).limit(5)
Kết quả mong đợi: có hai đánh giá, R002 xuất hiện trước R001. limit(5) giới hạn tối đa năm kết quả, không tạo thêm dữ liệu cho đủ năm. Hai bản ghi cùng một khách được cho phép trong bộ dữ liệu lab; bài chưa áp dụng chính sách mỗi khách chỉ đánh giá một lần.
Chỉ mục được đặt theo bộ lọc và thứ tự đọc của ví dụ. Đây là điểm xuất phát cho bài học, không phải bằng chứng đã tối ưu workload thực tế. Khi dữ liệu lớn hơn, bạn cần xem execution plan, lượng document được đọc và chi phí ghi; đó là trọng tâm bài 5.
Không nên thay mảng nội dung bằng một mảng review_ids cũng tăng mãi rồi cho rằng vấn đề đã được giải quyết. Trong mô hình này, mỗi review giữ product_id, còn product không cần lưu danh sách mọi review. Khi cần xem trang tiếp theo, ứng dụng truy vấn collection reviews theo điều kiện phù hợp.
9. Kiểm soát schema bằng validation
9.1. Linh hoạt không có nghĩa là chấp nhận mọi dữ liệu
Schema validation cho phép ràng buộc kiểu, trường bắt buộc hoặc miền giá trị. Mặc định, dữ liệu ghi vi phạm quy tắc có thể bị từ chối; cách áp dụng còn phụ thuộc validationLevel và validationAction. [5] Ta thử trên collection mới để không làm thay đổi bộ dữ liệu đã nhập.
Quy ước của bài: sku và name là chuỗi không rỗng; price_vnd là số nguyên không âm; stock là số nguyên không âm; specs là object tùy chọn. Ta dùng Int32 và Long rõ ràng để tránh nhập nhằng kiểu số trong mongosh.
db.createCollection("products_validated", {
  validator: {
    $jsonSchema: {
      bsonType: "object",
      required: ["sku", "name", "price_vnd", "stock"],
      properties: {
        sku: { bsonType: "string", minLength: 1 },
        name: { bsonType: "string", minLength: 1 },
        price_vnd: { bsonType: ["int", "long"], minimum: 0 },
        stock: { bsonType: "int", minimum: 0 },
        specs: { bsonType: "object" }
      }
    }
  },
  validationLevel: "strict",
  validationAction: "error"
})

db.products_validated.createIndex({ sku: 1 }, { unique: true })
$jsonSchema mô tả quy tắc, required liệt kê các trường phải có, properties khai báo yêu cầu cho từng trường. [6] Unique index bổ sung quy tắc sku không trùng; kiểm tra cấu trúc document và kiểm tra tính duy nhất là hai yêu cầu khác nhau.
9.2. Ghi dữ liệu hợp lệ và cố tình thử dữ liệu sai
db.products_validated.insertOne({
  _id: "V001", sku: "LAP-001", name: "Laptop học Data",
  price_vnd: Long("15000000"), stock: Int32(2),
  specs: { ram_gb: 16 }
})
Lệnh trên cần ghi thành công. Tiếp theo, chạy riêng lệnh sai dưới đây; giá được nhập thành chuỗi và tồn kho bị âm:
db.products_validated.insertOne({
  _id: "V002", sku: "LAP-002", name: "Laptop nhập sai",
  price_vnd: "15000000", stock: Int32(-1)
})
Kết quả mong đợi: lỗi Document failed validation; V002 không được thêm. Hãy kiểm tra lại dữ liệu sau lỗi:
db.products_validated.countDocuments({})
db.products_validated.findOne({ _id: "V002" })
Phép đếm bằng 1 và findOne trả về null. Nếu có nhiều vi phạm, hãy đọc phần chi tiết của lỗi để biết trường và điều kiện nào không đạt, thay vì sửa ngẫu nhiên cho đến khi câu lệnh chạy.
9.3. Những gì validator này chưa bảo vệ
Quy tắc trên chưa yêu cầu ram_gb phải là số, chưa xác minh product_id ở collection khác và chưa tính tổng đơn hàng. Trường chưa khai báo vẫn có thể xuất hiện vì ta không đặt additionalProperties bằng false. Đây là phạm vi chủ động để học kiểm soát phần lõi trước.
Khi áp dụng validator cho collection đã có dữ liệu, cần kiểm kê và xử lý dữ liệu cũ; việc thêm quy tắc không tự sửa các document hiện có. [5] Hãy thử trên bản sao dữ liệu và xác định cách ứng dụng xử lý lỗi trước khi siết quy tắc ở môi trường thật.
10. Review mô hình và lỗi thường gặp
| Quyết định trong bài | Lý do nghiệp vụ | Khi nào cần xem lại? |
|---|---|---|
| Nhúng items vào orders | Đọc cùng đơn và số dòng bị giới hạn | Đơn có quá nhiều dòng hoặc dòng có vòng đời xử lý riêng |
| Giữ snapshot giá và địa chỉ giao | Tái hiện thông tin lúc chốt đơn | Chính sách sửa đơn thay đổi; cần thêm lịch sử chỉnh sửa |
| customer_id tham chiếu customers | Tra cứu hồ sơ khách hiện tại | Cần quyết định quyền riêng tư, ẩn hoặc xóa khách |
| reviews là collection riêng | Số lượng tăng, màn hình chỉ đọc từng nhóm | Cần tối ưu phân trang hoặc thêm tập đánh giá nổi bật có giới hạn |
| Validator cho trường lõi | Chặn sai kiểu và miền giá trị cơ bản | Có thêm loại sản phẩm hoặc thêm quy tắc nghiệp vụ |
Đây là các quyết định của cửa hàng mẫu với những giả định đã nêu, không phải một schema dùng chung cho mọi cửa hàng.
| Dấu hiệu | Nguyên nhân cần kiểm tra | Hướng xử lý |
|---|---|---|
| $lookup trả mảng rỗng | Sai tên collection, sai giá trị hoặc sai kiểu định danh | Đọc riêng document hai bên rồi đối chiếu customer_id với _id |
| Đơn cũ hiển thị giá mới | Ứng dụng đang lấy giá hiện tại từ products | Hiển thị unit_price_vnd trong dòng hàng đã chốt |
| Document tăng mãi | Nhúng lịch sử hoặc đánh giá không giới hạn | Xác định giới hạn hoặc chuyển dữ liệu con sang collection riêng |
| Validation từ chối số | Kiểu BSON không khớp quy ước | Dùng kiểu phù hợp; không đổi thành chuỗi để né lỗi |
| Collection already exists | Chạy lại createCollection trong lab cũ | Tiếp tục với collection hiện có hoặc dùng database lab mới |
Phạm vi nhất quán: nhúng dữ liệu không tự giải quyết mọi thao tác trên nhiều collection. Lab chỉ quan sát mô hình và các cập nhật riêng lẻ, chưa kiểm thử checkout đồng thời, trừ kho nhiều sản phẩm hay retry yêu cầu. Một thao tác ghi một document có tính nguyên tử; các thay đổi nhiều document cần thiết kế transaction hoặc cơ chế nhất quán phù hợp. [7]
11. Bài tập tự luyện và gợi ý lời giải
Bài 1: đọc đúng giá trị lịch sử
Hãy lấy tên và giá các dòng hàng của SO001 sau khi giá P001 đã đổi. Đầu ra phải vẫn có laptop 15 triệu và sách 200.000, số lượng tương ứng 1 và 2.
db.orders.findOne(
  { _id: "SO001" },
  { _id: 0, "items.name_at_purchase": 1,
    "items.unit_price_vnd": 1, "items.qty": 1 }
)
Tự kiểm tra: nếu xóa phần unit_price_vnd rồi dùng giá từ products để tính lại, điều gì xảy ra với giá trị đơn hàng cũ? Viết câu trả lời bằng một ví dụ số cụ thể.
Bài 2: giới hạn số đánh giá trả về
Chỉ lấy một đánh giá mới nhất của P001. Với dữ liệu mẫu, kết quả phải là R002 có rating bằng 4.
db.reviews.find(
  { product_id: "P001" },
  { _id: 1, rating: 1 }
).sort({ created_at: -1, _id: -1 }).limit(1)
Giải thích vì sao giới hạn kết quả truy vấn không giống giới hạn tổng số document được phép lưu. Sau đó suy nghĩ cách hiển thị “xem thêm” khi có nhiều đánh giá hơn.
Bài 3: kiểm tra quy tắc không trùng mã
Thêm document V003 có sku bằng LAP-001, giá và tồn kho hợp lệ. MongoDB cần từ chối do unique index, thay vì do kiểu dữ liệu:
db.products_validated.insertOne({
  _id: "V003", sku: "LAP-001", name: "Sản phẩm trùng mã",
  price_vnd: Long("12000000"), stock: Int32(1)
})
Kết quả mong đợi là lỗi E11000 duplicate key. Số document hợp lệ trong products_validated vẫn bằng 1. Qua hai lần cố tình nhập sai, bạn phải phân biệt được lỗi vi phạm schema và lỗi vi phạm tính duy nhất.
Bài 4: tự thiết kế dữ liệu cho nền tảng đào tạo
Một khóa học có danh sách bài học, học viên đăng ký và lịch sử làm bài. Hãy lập bảng gồm: dữ liệu, số lượng dự kiến, cách đọc, cách cập nhật và đề xuất nhúng hoặc tham chiếu. Không cần chọn giống một đáp án duy nhất.
Gợi ý: thử nhúng một danh sách tóm tắt bài học có giới hạn; tách lượt đăng ký và lượt làm bài khi chúng tăng theo học viên và thời gian. Sau đó nêu một yêu cầu mới khiến bạn phải xem lại lựa chọn ban đầu. Phần quan trọng là giải thích giả định của mình.
12. Tổng kết và bài tiếp theo
Thiết kế dữ liệu bắt đầu từ ý nghĩa nghiệp vụ và cách ứng dụng sử dụng thông tin. Trong bài này, bạn dùng tham chiếu để nhận diện khách và sản phẩm, nhúng dòng hàng để đọc cùng đơn, giữ snapshot để bảo toàn lịch sử và tách đánh giá để kiểm soát tăng trưởng.
Trước khi mang mô hình vào dự án thật, hãy trả lời: trường nào thể hiện hiện tại, trường nào thể hiện quá khứ; dữ liệu con có tăng mãi không; thao tác nào phải nhất quán cùng nhau; quy tắc nào đã được database kiểm tra và quy tắc nào còn thuộc ứng dụng?
Bài 3 sẽ đi sâu vào truy vấn MongoDB: lọc document lồng nhau, làm việc với mảng, phân biệt điều kiện trên nhiều phần tử và cùng một phần tử bằng $elemMatch, cùng cách chọn trường và phân trang.
Muốn học theo lộ trình có nền tảng và dự án thực hành, bạn có thể tham khảo các chương trình đào tạo Data & AI tại TechData.AI.
13. Tài liệu tham khảo
- Best Practices for Data Modeling: lựa chọn mô hình và dữ liệu sao chép.
- $lookup: ghép dữ liệu giữa các collection.
- Avoid Unbounded Arrays: kiểm soát mảng tăng không giới hạn.
- MongoDB Limits and Thresholds: giới hạn BSON document.
- Schema Validation: thời điểm kiểm tra và xử lý vi phạm.
- Specify JSON Schema Validation: cú pháp $jsonSchema.
- Atomicity and Transactions: giới hạn nguyên tử của thao tác ghi.
Comments are closed!