


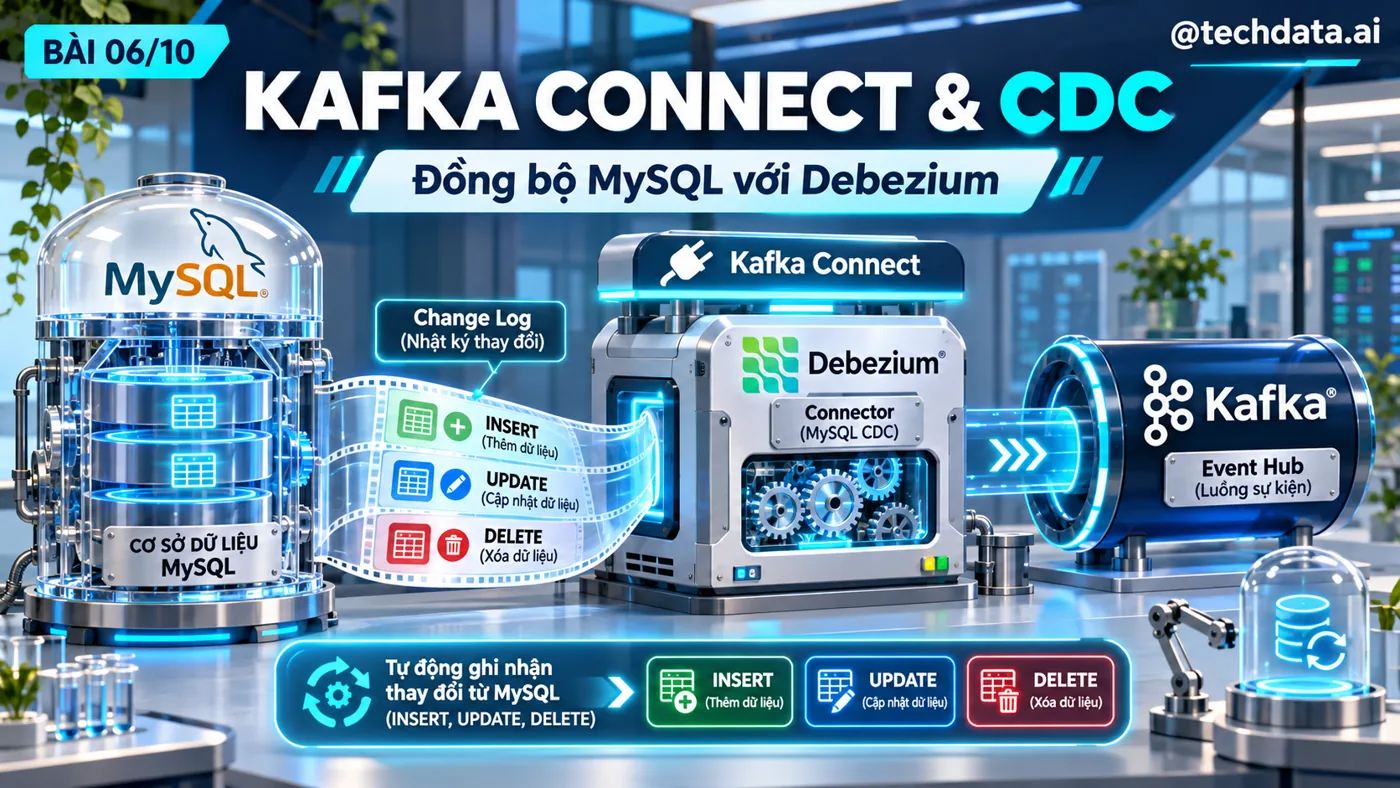

Series Apache Kafka · Bài 6/10. Một ứng dụng đã ghi dữ liệu vào MySQL nhưng không có code phát event. Làm sao đưa thay đổi sang Kafka mà không chạy SELECT tìm dòng mới mỗi vài giây? CDC đọc nhật ký thay đổi của database. Bài này dùng Kafka Connect và Debezium để quan sát dữ liệu ban đầu, INSERT, UPDATE và DELETE thành các event Kafka.
Lab dựng một môi trường riêng bằng Docker Compose, dùng bộ image Debezium 3.3 theo hướng dẫn chính thức. Không sửa broker localhost của bài 2: các dịch vụ CDC giao tiếp trong mạng Compose qua hostname kafka và mysql. Cổng REST Connect mở ở localhost:8083; Kafka lab này không publish cổng 9092 ra host nên không trùng broker cũ.
Mục lục
- Connect, connector và CDC
- Dựng môi trường Docker
- Đăng ký MySQL connector
- Đọc snapshot ban đầu
- Thử INSERT, UPDATE, DELETE
- Hiểu cấu trúc CDC event
- Offset, schema history và restart
- Vận hành và lỗi thường gặp
- Bài tập
- Tài liệu tham khảo
1. Kafka Connect, connector và CDC khác nhau thế nào?
Kafka Connect là runtime chạy các connector tích hợp dữ liệu. Source connector đưa dữ liệu vào Kafka; sink connector đưa dữ liệu từ Kafka sang hệ thống khác. Debezium MySQL connector là source connector chuyên đọc thay đổi MySQL. Bạn khai báo cấu hình qua REST API; không cần tự viết vòng lặp Python đọc từng dòng nguồn.
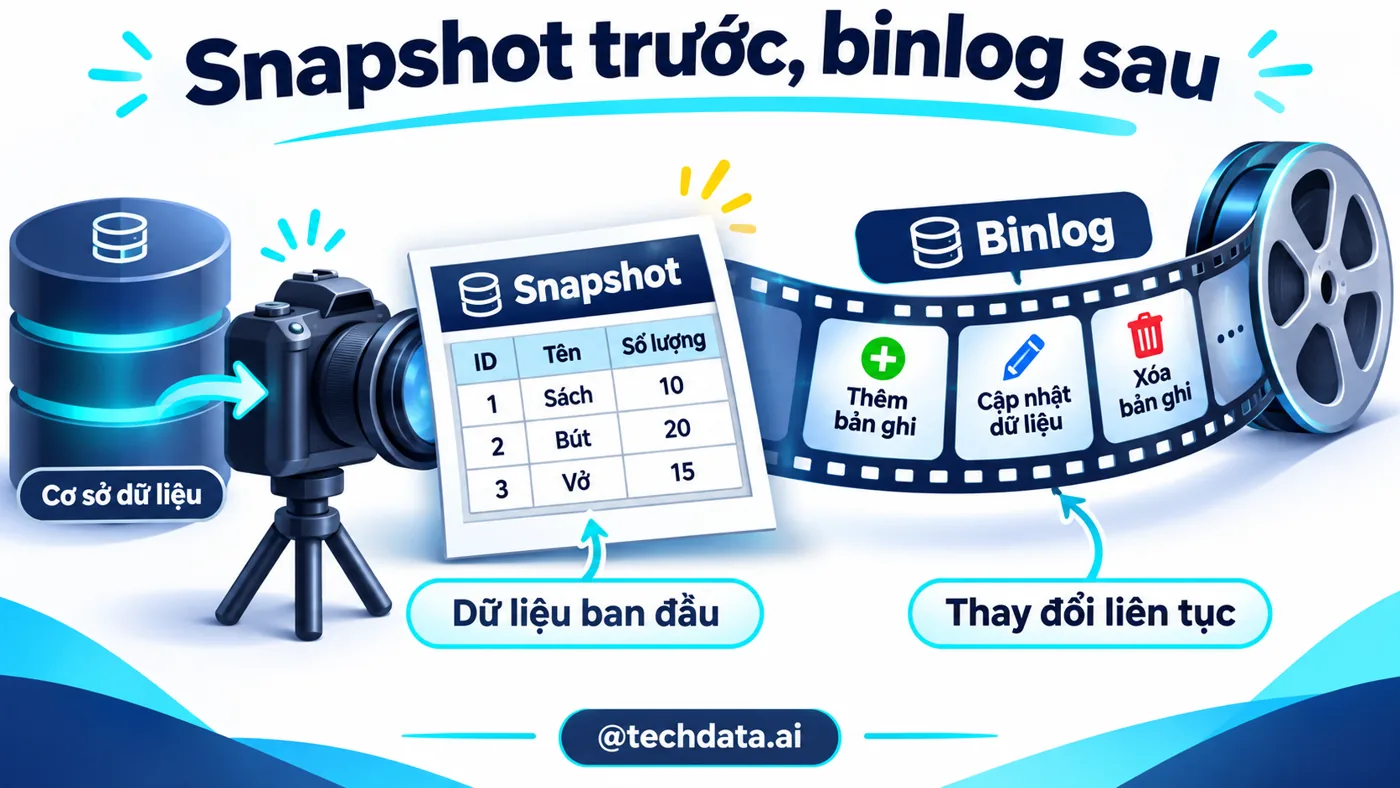
CDC là Change Data Capture. MySQL ghi các thay đổi đã commit vào binary log theo cấu hình. Debezium đọc binlog để tạo sự kiện, thay vì liên tục SELECT toàn bộ bảng rồi so sánh. Điều này không có nghĩa CDC hoàn toàn không đọc bảng: snapshot ban đầu vẫn cần đọc dữ liệu hiện có.
Connector là cấu hình tích hợp; task là đơn vị thực thi; worker là tiến trình Kafka Connect chạy task. MySQL connector đọc binlog bằng một task để giữ xử lý phù hợp với luồng nguồn. Tăng tasks.max không tự chia một MySQL binlog thành nhiều reader song song. Mở rộng Connect worker giúp chạy và phục hồi nhiều connector, không làm mọi connector tự tăng tốc.
2. Dựng môi trường Docker riêng
Tạo thư mục kafka-cdc-lab và file compose.yaml. Image example-mysql là database mẫu của Debezium, đã chuẩn bị inventory và tài khoản phục vụ tutorial. Nó không phải image MySQL production để dùng nguyên cấu hình. Mật khẩu trong bài chỉ dùng local.
services:
  kafka:
    image: quay.io/debezium/kafka:3.3
    hostname: kafka
    environment:
      CLUSTER_ID: MkU3OEVBNTcwNTJENDM2Qk
      NODE_ID: 1
      NODE_ROLE: combined
      KAFKA_CONTROLLER_QUORUM_VOTERS: 1@kafka:9093
      KAFKA_LISTENERS: PLAINTEXT://kafka:9092,CONTROLLER://kafka:9093
      KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://kafka:9092
    volumes:
      - kafka_data:/kafka/data
  mysql:
    image: quay.io/debezium/example-mysql:3.3
    environment:
      MYSQL_ROOT_PASSWORD: debezium
      MYSQL_USER: mysqluser
      MYSQL_PASSWORD: mysqlpw
    volumes:
      - mysql_data:/var/lib/mysql
  connect:
    image: quay.io/debezium/connect:3.3
    ports:
      - "127.0.0.1:8083:8083"
    environment:
      BOOTSTRAP_SERVERS: kafka:9092
      GROUP_ID: cdc-lab
      CONFIG_STORAGE_TOPIC: cdc_connect_configs
      OFFSET_STORAGE_TOPIC: cdc_connect_offsets
      STATUS_STORAGE_TOPIC: cdc_connect_statuses
      CONFIG_STORAGE_REPLICATION_FACTOR: 1
      OFFSET_STORAGE_REPLICATION_FACTOR: 1
      STATUS_STORAGE_REPLICATION_FACTOR: 1
      KEY_CONVERTER: org.apache.kafka.connect.json.JsonConverter
      VALUE_CONVERTER: org.apache.kafka.connect.json.JsonConverter
      KEY_CONVERTER_SCHEMAS_ENABLE: "false"
      VALUE_CONVERTER_SCHEMAS_ENABLE: "false"
    depends_on:
      - kafka
      - mysql
volumes:
  kafka_data:
  mysql_data:
Cấu hình dùng listener nội bộ kafka:9092 vì Connect và công cụ đọc trong bài đều chạy trong mạng Compose. localhost bên trong Connect sẽ trỏ vào Connect, nên không dùng localhost:9092 để tìm broker ở container khác. Ba topic nội bộ Connect lưu config, source offset và trạng thái task; replication factor 1 chỉ phù hợp broker lab duy nhất.
docker compose config --quiet
docker compose up -d
docker compose ps
docker compose logs --tail=100 connect
curl -s http://localhost:8083/connector-plugins
depends_on chỉ sắp thứ tự tạo container, không bảo đảm MySQL và Kafka đã ready. Nếu REST chưa phản hồi, xem log và đợi dịch vụ khởi động. Danh sách connector-plugins phải có io.debezium.connector.mysql.MySqlConnector. Nếu thiếu, kiểm tra image Connect đang dùng; Kafka Connect thông thường không mặc định có mọi plugin Debezium.
Tag 3.3 gắn nhánh tutorial đã chọn. Khi dùng thực tế, pin patch hoặc digest và kiểm tra compatibility matrix của Debezium với Kafka Connect và MySQL. Nâng cấp connector cần kế hoạch cho state, schema history và dữ liệu nguồn.
3. Đăng ký MySQL connector
Tạo connector.json. database.hostname là mysql theo tên dịch vụ; database.server.id là ID của client replication cần duy nhất trong topology nguồn. topic.prefix tạo namespace cho event. table.include.list giới hạn customers để bài lab dễ đọc. Bộ lọc là biểu thức chính quy; dùng [.] để biểu diễn dấu chấm giữa schema và tên bảng.
{
  "name": "inventory-connector",
  "config": {
    "connector.class": "io.debezium.connector.mysql.MySqlConnector",
    "tasks.max": "1",
    "database.hostname": "mysql",
    "database.port": "3306",
    "database.user": "debezium",
    "database.password": "dbz",
    "database.server.id": "184054",
    "topic.prefix": "dbserver1",
    "database.include.list": "inventory",
    "table.include.list": "inventory[.]customers",
    "schema.history.internal.kafka.bootstrap.servers": "kafka:9092",
    "schema.history.internal.kafka.topic": "schemahistory.inventory",
    "include.schema.changes": "false",
    "snapshot.mode": "initial"
  }
}
curl -i -X POST -H "Content-Type: application/json" --data @connector.json http://localhost:8083/connectors
curl -s http://localhost:8083/connectors/inventory-connector/statusPOST tạo connector mới; nếu tên đã tồn tại, API báo conflict. Không liên tục POST cùng tên để restart. Cần kiểm tra cả connector.state và từng task.state. Connector RUNNING nhưng task FAILED vẫn có nghĩa pipeline không xử lý được. Trace trong status và log connect giúp tìm nguyên nhân.
Tài khoản debezium/dbz được chuẩn bị trong example image của tutorial. Database doanh nghiệp cần tạo tài khoản riêng và cấp đúng các quyền snapshot/replication theo tài liệu; không lấy tài khoản root làm mặc định. MySQL phải bật binary log, row format và row image phù hợp. Secrets nên được externalize qua cơ chế cấu hình của Connect thay vì ghi plaintext vào JSON production.
4. Đọc dữ liệu snapshot ban đầu
Ở lần chạy đầu khi chưa có source offset, snapshot.mode=initial lấy dữ liệu sẵn trong bảng, sau đó tiếp tục binlog. Snapshot record có op=r; r nghĩa read của snapshot, không phải INSERT mới vừa xảy ra. Topic mặc định cho bảng này là dbserver1.inventory.customers.
docker compose exec kafka /kafka/bin/kafka-console-consumer.sh --bootstrap-server kafka:9092 --topic dbserver1.inventory.customers --from-beginning --property print.key=trueGiữ terminal consumer mở. JSON converter trong lab tắt schema wrapper để dễ đọc; value vẫn là envelope Debezium chứa before, after, source và op. Nếu dùng cấu hình converter khác, bạn có thể thấy schema/payload bao ngoài. Đừng copy đường dẫn JSON của một cấu hình sang cấu hình khác mà không kiểm tra.
5. Thực hiện INSERT, UPDATE và DELETE
Mở terminal khác vào MySQL. Lệnh -p yêu cầu nhập mật khẩu root lab debezium. Dùng ID 2001 dành cho dữ liệu thử; kiểm tra ID chưa có trước khi insert.
docker compose exec mysql mysql -uroot -p inventorySELECT * FROM customers WHERE id=2001;
INSERT INTO customers(id,first_name,last_name,email) VALUES (2001,'Tin','Nguyen','tin-lab@example.com');
UPDATE customers SET first_name='Trung Tin' WHERE id=2001;
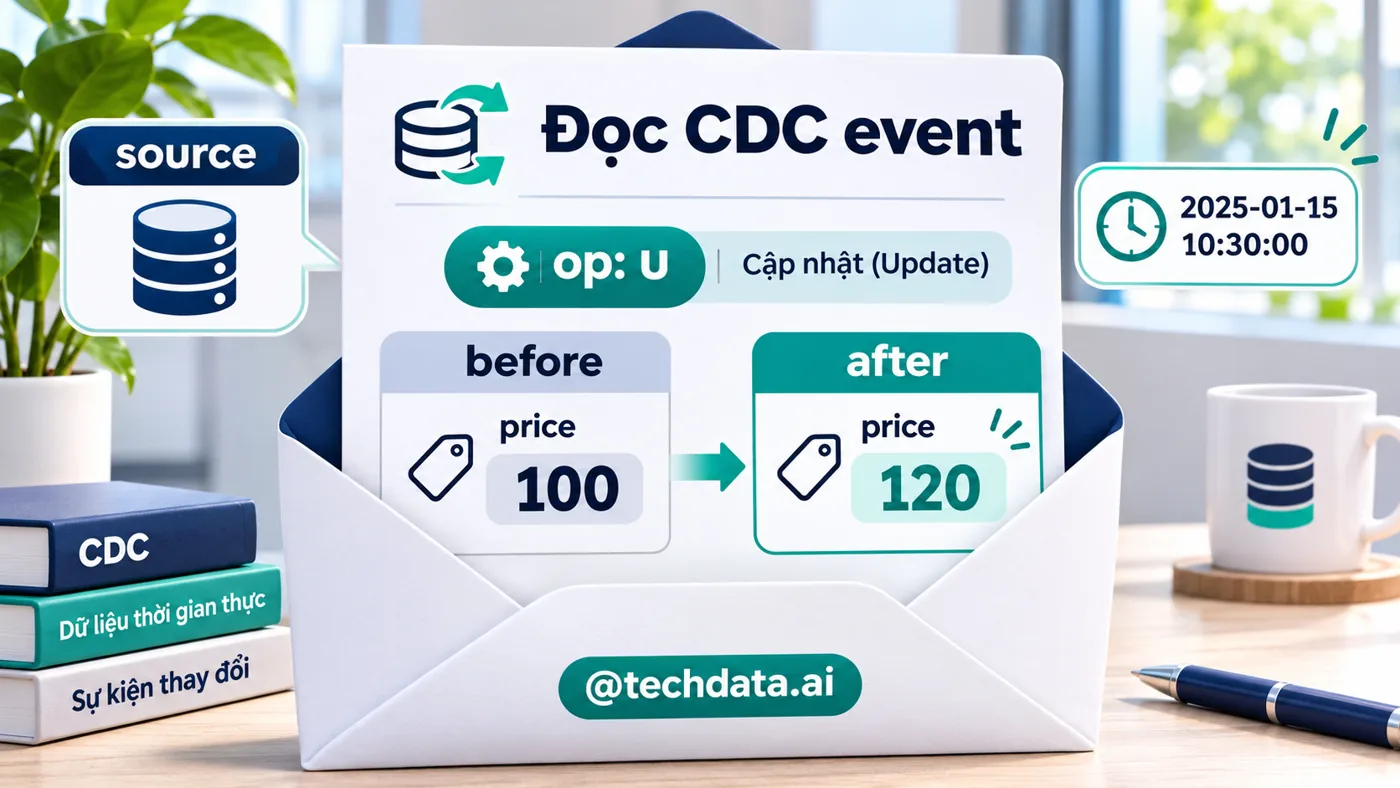
DELETE FROM customers WHERE id=2001;Chạy từng câu và quan sát consumer sau mỗi bước. INSERT thường tạo op=c với after chứa dòng mới; UPDATE tạo op=u với before và after; DELETE tạo op=d với before và after=null. Với cấu hình mặc định tombstone, sau delete còn có record cùng key và value=null để hỗ trợ log compaction. Tombstone không phải JSON có chuỗi "null" và không có trường op để parse.
Những gì bạn thấy là thay đổi ở mức bảng. Nó không tự diễn giải “khách đã hủy đơn” hoặc “thanh toán thành công”. Một UPDATE status có thể mang ý nghĩa nghiệp vụ, nhưng CDC không biết lý do thao tác đó. Nếu cần business event ổn định, thường dùng outbox hoặc lớp chuẩn hóa thay vì để mọi consumer phụ thuộc trực tiếp schema bảng nguồn.
6. Đọc envelope và tránh lỗi khi dựng bảng đích
before mô tả dữ liệu trước thay đổi khi nguồn/cấu hình cung cấp; after mô tả sau thay đổi; op cho biết loại thao tác; source chứa vị trí và ngữ cảnh nguồn. Các timestamp có ý nghĩa khác nhau giữa thời điểm database thay đổi và thời điểm connector xử lý. Đo latency phải xác định chính xác trường, đơn vị và đồng bộ đồng hồ.
Consumer dựng trạng thái hiện tại thường upsert theo primary key với c/u/r và xóa hoặc soft delete với d. Chỉ lấy after rồi bỏ qua mọi null sẽ làm dòng đã xóa vẫn còn ở bảng đích. Snapshot r phải được xem như dữ liệu khởi tạo, không cộng doanh thu như một giao dịch mới. CDC cũng có thể được giao lại sau restart; sink cần idempotent và chiến lược thứ tự/phục hồi.
Thêm một cột vào bảng nguồn có thể thay đổi schema event. Việc consumer đọc JSON linh hoạt không thay thế hợp đồng dữ liệu. Bạn cần kiểm tra schema evolution, kiểu decimal/time và dữ liệu nhạy cảm trước khi đưa CDC vào phân tích.
7. Giữ state để restart đúng vị trí
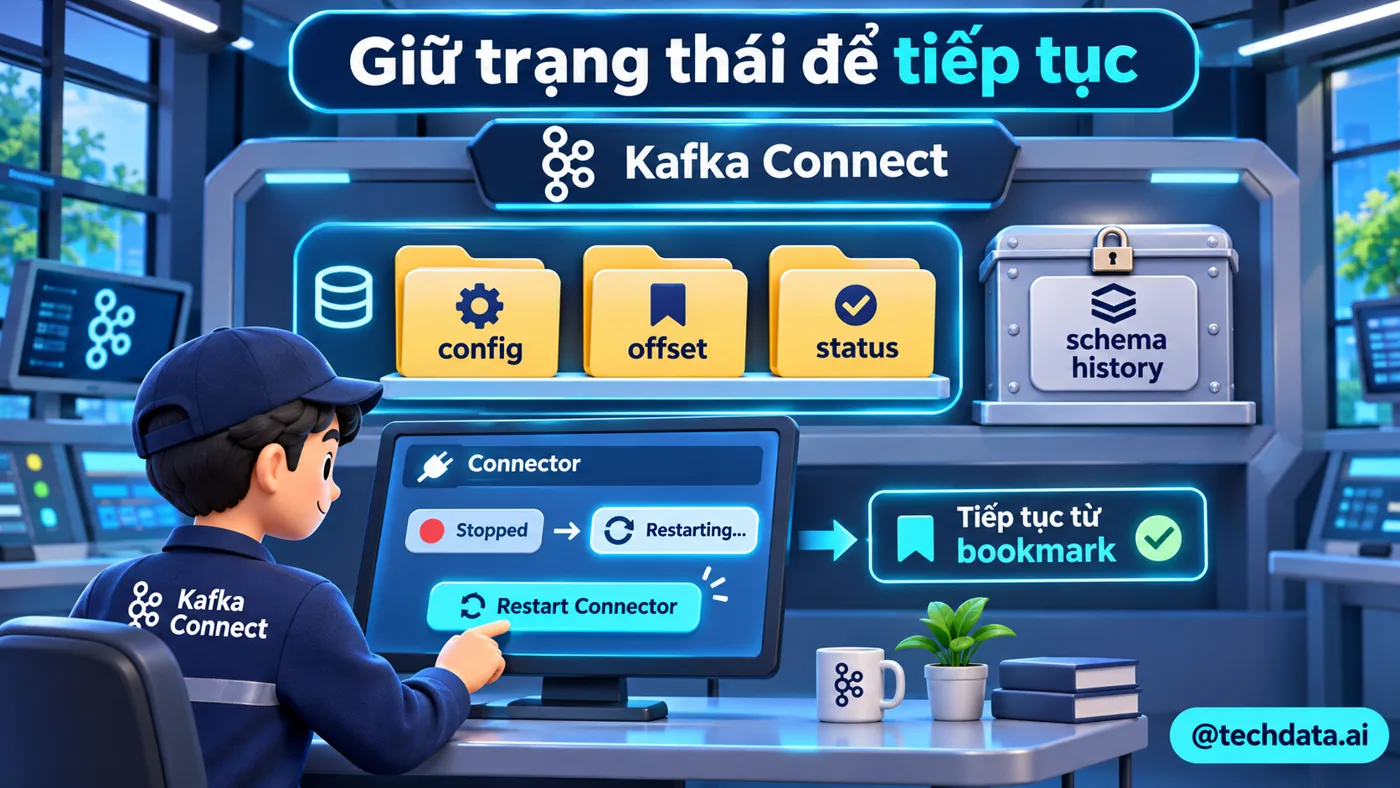
Connect source offset ghi tiến độ đọc nguồn, khác với offset của một consumer group ứng dụng đang đọc topic CDC. Schema history lưu thông tin DDL để connector giải mã binlog ở vị trí cần khôi phục. Đây là topic nội bộ, không phải bảng dữ liệu dành cho dashboard và không nên áp retention tùy tiện như topic event thông thường.
docker compose restart connect
curl -s http://localhost:8083/connectors/inventory-connector/status
Sau khi Connect sẵn sàng, tạo thay đổi mới trong MySQL và xác nhận pipeline tiếp tục. Không kỳ vọng restart làm mất state rồi snapshot lại từ đầu. Nếu offset, schema history và dữ liệu Kafka được giữ, connector có thể tiếp tục từ vị trí đã ghi nhận; khi lỗi ở ranh giới commit, downstream vẫn cần xử lý lặp.
Nếu MySQL đã purge binlog trước vị trí connector cần đọc, restart không thể tự tạo lại lịch sử đã mất. Cần kế hoạch snapshot/recovery có kiểm soát và đối soát bảng đích. Đừng xóa topic history hay offsets chỉ để trạng thái chuyển xanh vì việc đó thay đổi semantics phục hồi.
8. Vận hành và lỗi thường gặp
Connection refused thường là hostname/cổng hoặc dịch vụ chưa ready. Access denied thường là user, password hoặc privilege. Task FAILED với binlog không hợp lệ cần xem binary log configuration. REST RUNNING không thay thế kiểm tra event mới thực sự tới Kafka.
Theo dõi lag của connector so với nguồn, thời gian snapshot, lỗi task, dung lượng binlog và Kafka disk. Binlog retention phải đủ dài cho thời gian connector có thể gián đoạn và phục hồi. Kafka retention cho topic dữ liệu phải đủ cho consumer downstream bắt kịp. Đây là hai vòng đời lưu trữ riêng.
Dừng lab bằng docker compose down để giữ named volumes. Tránh down -v nếu muốn giữ state. Không tái sử dụng topic.prefix của một database khác hoặc đổi prefix tùy tiện sau khi đã chạy; namespace, schema history và source identity cần ổn định theo thiết kế.
9. Bài tập có cách đối chiếu
Bài 1: chèn ID 2002, sửa email rồi xóa. Ghi lại key, op, before và after của từng event. Kỳ vọng có c/u/d và tombstone theo cấu hình mặc định, không chỉ một dòng trạng thái cuối.
Bài 2: dừng Connect, thay đổi một dòng rồi mở lại. Đối chiếu connector task RUNNING và event phát ra. Giải thích điều kiện để đọc được thay đổi: binlog cần còn, offset và schema history cần khả dụng.
Bài 3: thiết kế consumer dựng customers_current. Nêu rõ xử lý r/c/u/d và tombstone. Gợi ý: upsert theo id, delete/soft delete khi op=d, không parse tombstone như JSON object.
Bài tiếp theo kết hợp Kafka, Python, PostgreSQL và Power BI để dựng pipeline phân tích doanh thu gần thời gian thực, đồng thời phân biệt thời điểm event với thời điểm dashboard refresh.
Tài liệu tham khảo
- Debezium 3.3 Tutorial — môi trường mẫu và đăng ký connector.
- Debezium MySQL Connector — snapshot, binlog, event và schema history.
- Apache Kafka Connect — runtime tích hợp dữ liệu.
@techdata.ai · Series Apache Kafka