



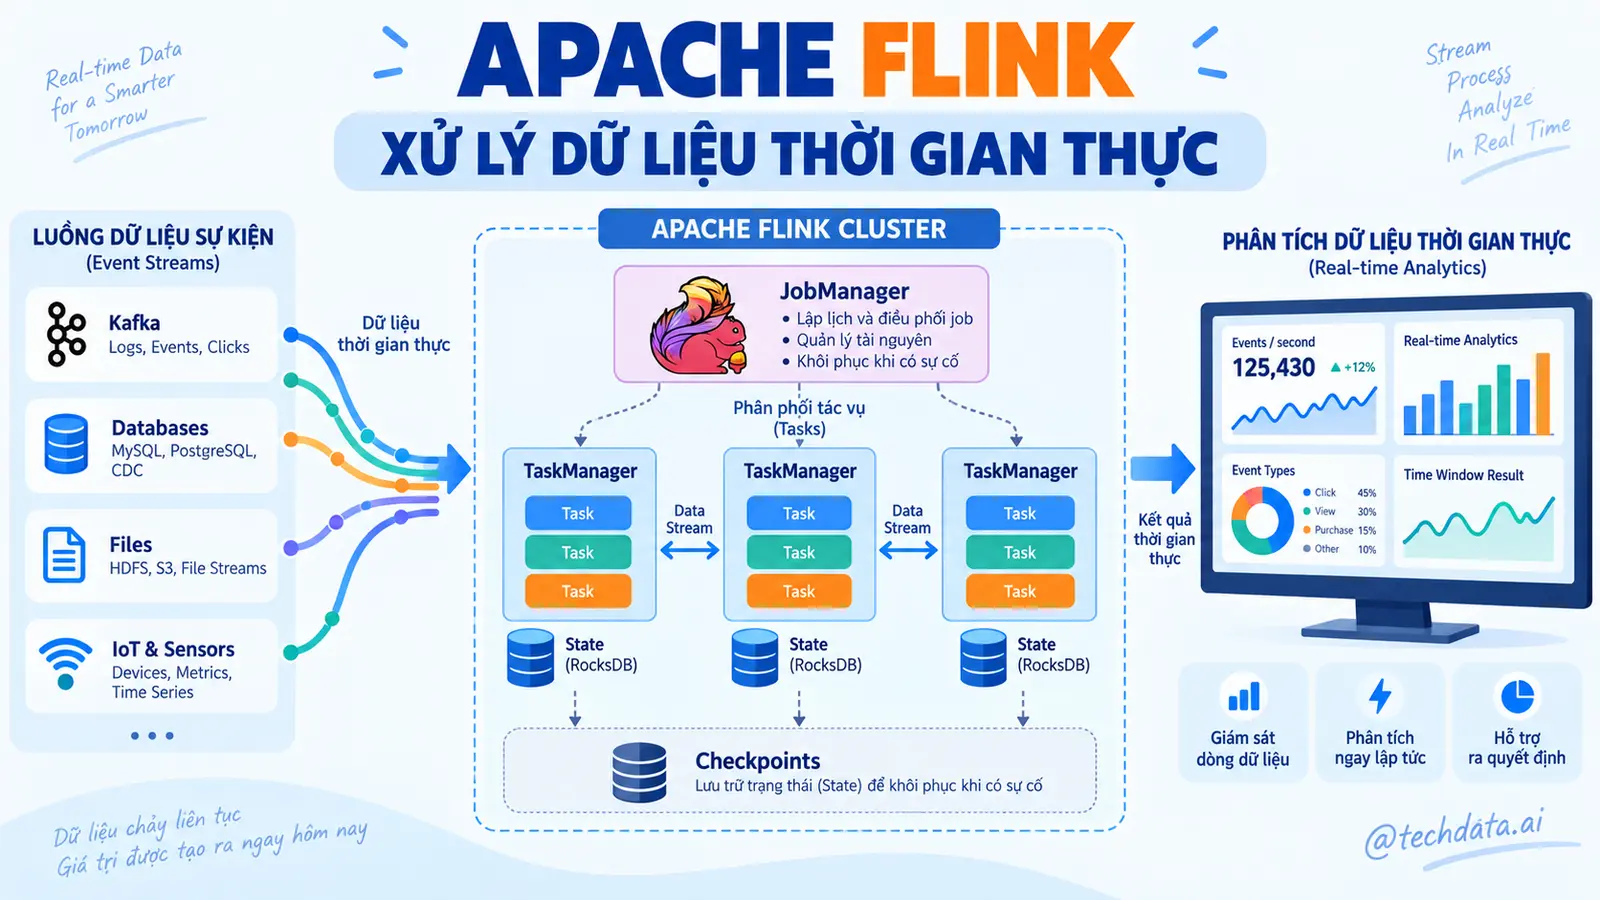

Apache Flink là gì? Kiến trúc xử lý dữ liệu thời gian thực từ nền tảng đến Production
Đơn vị biên soạn: TechData.AI
Chủ đề: Data Engineering và Real-time Stream
Processing
Đối tượng: Data Engineer, Software Engineer, Solution
Architect và người đã có kiến thức cơ bản về Apache Kafka
Phiên bản tham chiếu: Apache Flink 2.x, các nguyên lý
kiến trúc có thể áp dụng cho nhiều phiên bản gần đây
Phương pháp: Học từ bài toán, kiến trúc, mã nguồn và
yêu cầu vận hành thực tế
MỤC LỤC
- Vì sao doanh nghiệp cần xử lý dữ liệu thời gian thực?
- Apache Flink là gì?
- Flink không chỉ là một công cụ đọc Kafka
- Bounded Stream và Unbounded Stream
- Streaming-first và xử lý hợp nhất Batch với Streaming
- Apache Kafka và Apache Flink khác nhau như thế nào?
- Những bài toán phù hợp với Apache Flink
- Từ chương trình đến Distributed Dataflow
- Bốn lớp biểu diễn của một Flink Job
- Kiến trúc Flink Cluster
- Dispatcher, ResourceManager và JobMaster
- TaskManager và Task Slot
- Parallelism, Subtask và Max Parallelism
- Data Partitioning và chi phí Network Shuffle
- Operator Chaining
- State trong Stream Processing
- Keyed State, Operator State và Broadcast State
- Event Time, Processing Time và Watermark
- Window không phải là cách duy nhất xử lý thời gian
- Checkpoint và cơ chế phục hồi
- Exactly-once cần được hiểu như thế nào?
- Checkpoint và Savepoint khác nhau ra sao?
- Backpressure và khả năng điều tiết luồng dữ liệu
- DataStream API, Table API và Flink SQL
- Kiến trúc Kafka và Flink cho hệ thống đơn hàng
- Ví dụ Flink Job bằng Java
- Vòng đời triển khai một Flink Job
- Khi nào nên và không nên sử dụng Flink?
- Những sai lầm kiến trúc thường gặp
- Checklist Production
- Lộ trình học Apache Flink
- Tổng kết
- Câu hỏi ôn tập
- Tài liệu tham khảo
1. Vì sao doanh nghiệp cần xử lý dữ liệu thời gian thực?
Hãy hình dung một sàn thương mại điện tử đang vận hành chương trình khuyến mãi lớn. Trong vài phút, hàng trăm nghìn người dùng đồng thời xem sản phẩm, thêm hàng vào giỏ, đặt hàng, thanh toán, hủy đơn và yêu cầu hoàn tiền. Mỗi hành động tạo ra một sự kiện dữ liệu. Dòng sự kiện đó không dừng lại để chờ hệ thống phân tích xử lý xong.
Doanh nghiệp có thể lưu toàn bộ dữ liệu rồi chạy ETL vào cuối ngày. Cách này phù hợp với báo cáo tài chính theo ngày hoặc những chỉ số không cần phản ứng ngay. Tuy nhiên, nhiều quyết định mất giá trị nếu được đưa ra quá trễ. Một giao dịch gian lận cần được phát hiện trước khi tiền rời khỏi hệ thống. Một sản phẩm bán nhanh cần được cảnh báo trước khi tồn kho trở thành số âm. Một dịch vụ thanh toán đang lỗi cần được nhận biết trong vài phút, không phải trong báo cáo sáng hôm sau.
Một nền tảng xử lý thời gian thực thường phải trả lời đồng thời nhiều loại câu hỏi:
- Doanh thu trong năm phút gần nhất của từng cửa hàng là bao nhiêu?
- Tỷ lệ thanh toán thất bại có vượt ngưỡng bình thường không?
- Khách hàng có thực hiện một chuỗi giao dịch bất thường trong thời gian ngắn không?
- Đơn hàng nào đã thanh toán nhưng chưa tạo yêu cầu giao vận?
- Sự kiện đến trễ có cần cập nhật lại kết quả đã phát ra không?
- Nếu một máy chủ hỏng, hệ thống có tính thiếu hoặc tính trùng doanh thu không?
- Khi tăng từ một nghìn lên một trăm nghìn sự kiện mỗi giây, state được phân phối như thế nào?
Khó khăn không chỉ nằm ở tốc độ. Hệ thống còn phải quản lý thứ tự tương đối của sự kiện, dữ liệu đến trễ, trạng thái tích lũy, khả năng mở rộng, lỗi máy chủ và tính nhất quán của kết quả. Đây là vùng vấn đề mà Apache Flink được thiết kế để giải quyết.
2. Apache Flink là gì?
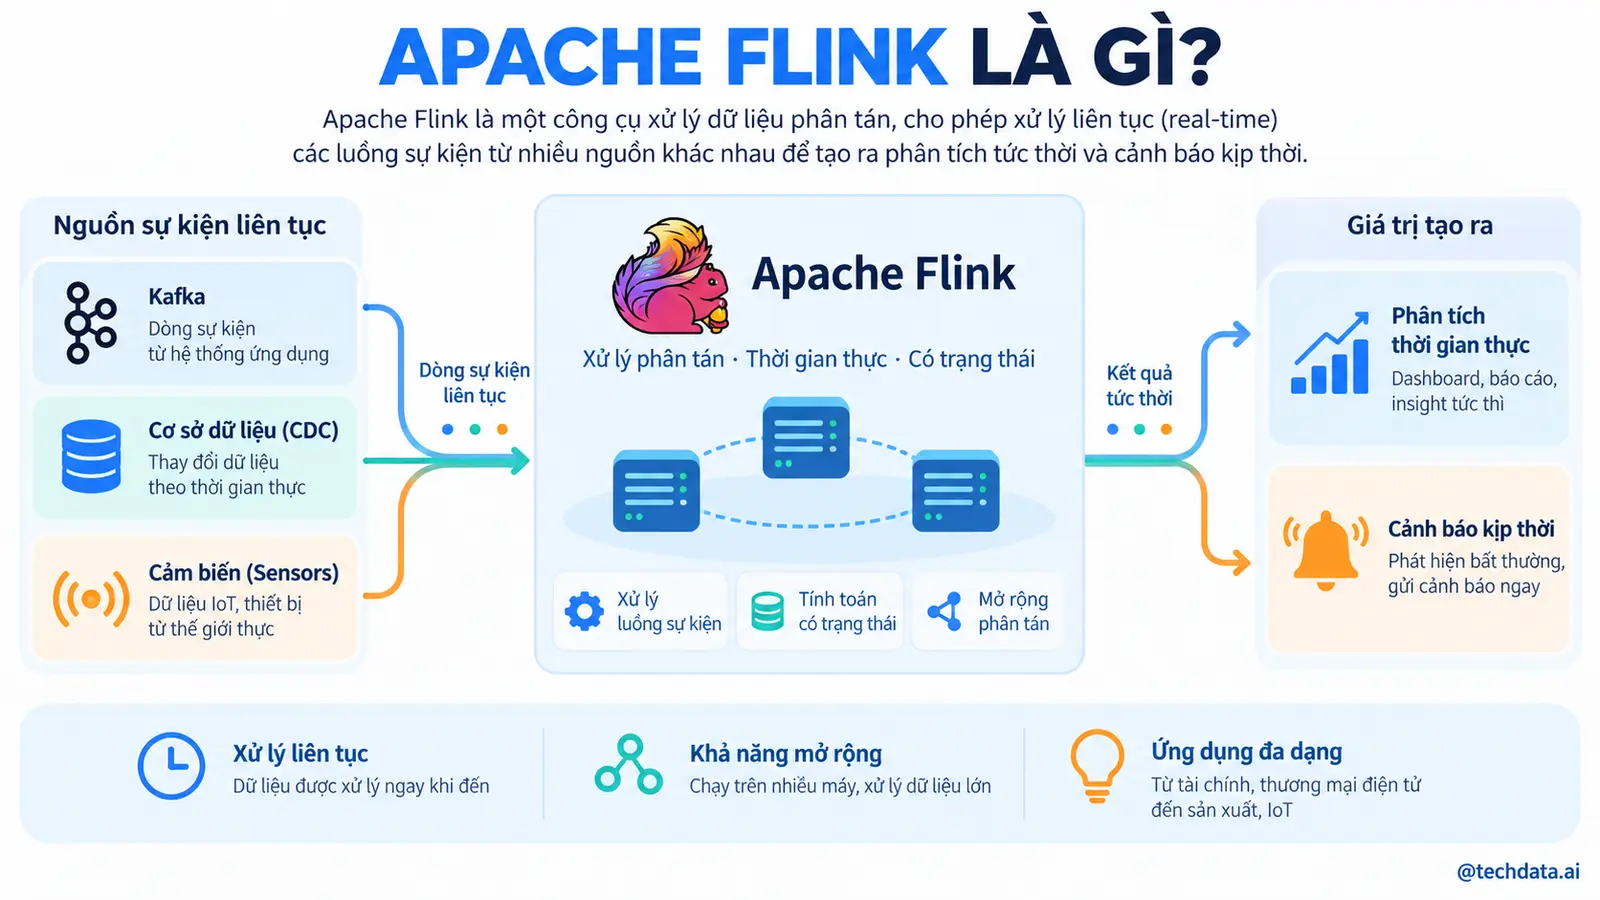
Apache Flink là một distributed processing engine dùng để thực hiện các phép tính có trạng thái trên luồng dữ liệu hữu hạn và vô hạn. Nói đơn giản hơn, Flink là bộ máy tính toán phân tán có thể xử lý dữ liệu liên tục khi dữ liệu đang được tạo ra, đồng thời ghi nhớ trạng thái cần thiết để tạo ra kết quả chính xác.
Ba cụm từ trong định nghĩa trên cần được hiểu rõ.
Thứ nhất, distributed processing engine nghĩa là công việc được chia thành nhiều task chạy song song trên nhiều tiến trình hoặc máy chủ. Người phát triển mô tả dataflow; Flink chịu trách nhiệm lập lịch, truyền dữ liệu, quản lý tài nguyên và khôi phục khi một phần hệ thống gặp lỗi.
Thứ hai, stateful computation nghĩa là phép tính có thể ghi nhớ những gì đã xảy ra. Tính tổng chi tiêu của một khách hàng, loại bỏ sự kiện trùng lặp, phát hiện chuỗi hành vi hoặc theo dõi trạng thái một đơn hàng đều cần state. Flink không xem state là một biến phụ trong bộ nhớ ứng dụng. State là thành phần được runtime quản lý, phân vùng, checkpoint và phục hồi.
Thứ ba, bounded và unbounded stream cho phép Flink xử lý cả dữ liệu có điểm kết thúc lẫn dữ liệu tiếp tục phát sinh. File giao dịch của tháng trước là bounded. Kafka topic nhận giao dịch liên tục là unbounded. Hai loại dữ liệu có đặc tính khác nhau, nhưng có thể được biểu diễn trong cùng tư duy dataflow.
Theo tài liệu đào tạo chính thức của Apache Flink, các nền tảng cốt
lõi để hiểu Flink gồm continuous stream processing, event time, stateful
stream processing và state snapshot [1]. Nếu chỉ học một số hàm
map, filter và keyBy, người học
mới biết cú pháp chứ chưa hiểu Flink.
3. Flink không chỉ là một công cụ đọc Kafka
Một mô tả quá đơn giản thường nói Flink đọc dữ liệu từ Kafka, xử lý rồi ghi ra database. Mô tả này đúng nhưng không thể hiện lý do doanh nghiệp chấp nhận vận hành thêm một distributed system.
Giá trị của Flink nằm ở tập hợp nhiều khả năng hoạt động cùng nhau:
- Thực thi pipeline song song trên cluster.
- Quản lý state cục bộ để truy cập nhanh nhưng vẫn có khả năng phục hồi.
- Phân vùng state theo khóa và phân phối lại state khi thay đổi parallelism.
- Xử lý theo Event Time thay vì phụ thuộc hoàn toàn vào thời điểm máy chủ nhận dữ liệu.
- Sử dụng watermark để cân bằng giữa độ chính xác và độ trễ.
- Tạo checkpoint nhất quán trong khi pipeline vẫn tiếp tục xử lý.
- Phục hồi state cùng vị trí đọc của source sau sự cố.
- Hỗ trợ DataStream API, Table API và SQL cho các mức trừu tượng khác nhau.
- Kết nối với Kafka, filesystem, database, Data Lake và nhiều hệ thống khác.
- Cung cấp metric, Web UI và các điểm quan sát cần thiết cho vận hành.
Một chương trình consumer Kafka thông thường cũng có thể cộng doanh
thu trong một HashMap. Vấn đề xuất hiện khi tiến trình
chết, partition được phân công lại, state lớn hơn bộ nhớ, cần nâng cấp
code hoặc cần xử lý dữ liệu đến trễ. Khi đó, đội phát triển phải tự xây
những cơ chế mà Flink đã đưa vào runtime.
Flink vì thế không thay thế business logic. Nó cung cấp nền tảng để business logic có trạng thái chạy ổn định trong môi trường phân tán.
4. Bounded Stream và Unbounded Stream
Bounded Stream có điểm bắt đầu và kết thúc xác định. Ví dụ gồm một tập file Parquet của năm 2025, một bảng snapshot được xuất lúc cuối ngày hoặc lịch sử giao dịch cần backfill. Vì toàn bộ dữ liệu cuối cùng sẽ có mặt, hệ thống có thể thực hiện các phép toán cần nhìn toàn bộ tập dữ liệu như sắp xếp toàn cục hoặc tạo kết quả cuối cùng.
Unbounded Stream có điểm bắt đầu nhưng về mặt logic không có điểm kết thúc. Kafka topic đơn hàng, log ứng dụng, dữ liệu cảm biến và Change Data Capture từ database đều có thể tiếp tục phát sinh. Hệ thống không thể chờ “đọc xong” mới tạo kết quả. Nó phải cập nhật kết quả liên tục hoặc chia dòng vô hạn thành các phạm vi hữu hạn bằng window, timer, rule hoặc trạng thái nghiệp vụ.
Sự khác biệt này ảnh hưởng trực tiếp đến thiết kế:
- Kết quả của bounded data có thể là kết quả cuối cùng. Kết quả streaming thường là bản cập nhật liên tục.
- Unbounded state cần chính sách dọn dẹp. Nếu số lượng key tăng vô hạn, state cũng có thể tăng vô hạn.
- Dữ liệu streaming có thể đến sai thứ tự hoặc đến trễ.
- Consumer downstream phải hiểu output là append, update hay retract.
- Kiểm thử không thể chỉ dựa trên một lần chạy từ đầu đến cuối; cần kiểm thử restart và replay.
Điểm mạnh của Flink là xem batch như một trường hợp đặc biệt của streaming. Tuy nhiên, điều đó không có nghĩa mọi pipeline batch nên được chuyển sang Flink. Lựa chọn vẫn phải dựa trên SLA, năng lực đội ngũ, chi phí và hệ sinh thái hiện có.
5. Streaming-first và xử lý hợp nhất Batch với Streaming
Trong kiến trúc cũ, doanh nghiệp thường xây hai codebase: một pipeline streaming tạo kết quả nhanh và một pipeline batch tạo kết quả chính xác. Mô hình này đôi khi được gọi là Lambda Architecture. Nó giải quyết được yêu cầu độ trễ nhưng tạo ra chi phí đáng kể: hai implementation cho cùng business logic, hai đường kiểm thử và nguy cơ kết quả không khớp.
Flink theo hướng streaming-first. Cùng một runtime có thể xử lý unbounded stream liên tục và bounded stream ở chế độ phù hợp. Điều này mở ra khả năng dùng một mô hình logic cho realtime processing, historical replay và backfill.
Dù vậy, “một engine cho cả hai” không tự động tạo ra một kiến trúc đơn giản. Backfill vẫn cần kế hoạch tách tài nguyên để không ảnh hưởng Job realtime. Sink phải xử lý được việc ghi lại dữ liệu lịch sử. Business key, version và quy tắc upsert phải rõ ràng. Nếu chạy lại ba tháng dữ liệu mà output không có khóa ổn định, hệ thống có thể tạo hàng triệu bản ghi trùng.
Tư duy đúng là hợp nhất semantics trước khi hợp nhất hạ tầng. Cùng một khái niệm doanh thu phải dùng cùng quy tắc lọc, timezone, tỷ giá và trạng thái đơn hàng trong cả realtime lẫn backfill.
6. Apache Kafka và Apache Flink khác nhau như thế nào?
Kafka và Flink thường xuất hiện trong cùng một sơ đồ, nhưng chúng giải quyết hai nhóm trách nhiệm khác nhau.
Kafka chủ yếu là nền tảng event streaming dùng để tiếp nhận, lưu trữ và phân phối sự kiện. Topic được chia thành partition. Producer ghi event. Consumer group đọc event và theo dõi offset. Kafka giúp tách producer khỏi consumer và cho phép đọc lại lịch sử còn trong retention.
Flink là computation engine. Nó đọc event từ source, thực hiện transformation, quản lý state, xử lý thời gian, join stream, phát hiện pattern và ghi kết quả đến sink.
Có thể hình dung Kafka là nhật ký sự kiện và hệ thống vận chuyển, còn Flink là nhà máy tính toán trên dòng sự kiện đó. Kafka lưu giao dịch. Flink tính doanh thu theo cửa hàng, phát hiện giao dịch bất thường hoặc xây trạng thái hiện tại của đơn hàng.
Sự phân biệt này giúp tránh hai ngộ nhận. Thứ nhất, triển khai Kafka không đồng nghĩa doanh nghiệp đã có stream processing platform. Thứ hai, Flink không phải message broker và thường không nên được dùng để thay vai trò lưu giữ lịch sử của Kafka.
Kafka Streams cũng có thể xử lý stream và phù hợp trong nhiều trường hợp, đặc biệt khi dữ liệu nằm chủ yếu trong Kafka và đội phát triển muốn đóng gói logic như một thư viện trong Java service. Flink phù hợp hơn khi cần một runtime độc lập, state lớn, event-time phức tạp, nhiều connector, SQL streaming, resource management và khả năng vận hành nhiều pipeline theo tiêu chuẩn chung.
7. Những bài toán phù hợp với Apache Flink
Flink thường được dùng trong bốn nhóm bài toán.
Streaming ETL đọc dữ liệu liên tục, chuẩn hóa schema, làm sạch, enrich và ghi sang Kafka, Data Lake hoặc hệ thống phân tích. Ví dụ là xử lý CDC từ MySQL rồi tạo bảng chuẩn hóa trên object storage.
Realtime analytics tính metric theo thời gian: doanh thu mỗi phút, số người dùng hoạt động, tỷ lệ lỗi hoặc top sản phẩm. Kết quả có thể phục vụ dashboard và cảnh báo.
Event-driven application duy trì trạng thái nghiệp
vụ và phản ứng với chuỗi sự kiện. Ví dụ, nếu đơn hàng đã thanh toán
nhưng sau mười phút chưa có sự kiện giao vận, hệ thống phát cảnh báo.
ProcessFunction, state và timer là nền tảng quan trọng cho
nhóm use case này.
Fraud detection và complex event processing tìm pattern trên nhiều sự kiện: giao dịch nhỏ để thử thẻ, sau đó là giao dịch lớn trong thời gian ngắn; đăng nhập từ hai vị trí xa nhau; nhiều lần thanh toán thất bại rồi thành công bất thường.
Ngoài ra, Flink có thể hỗ trợ materialized view liên tục, feature pipeline cho machine learning, quan sát hạ tầng và đồng bộ dữ liệu thời gian thực. Điểm chung không phải là “dữ liệu lớn” theo một con số cố định. Điểm chung là nhu cầu tính toán liên tục, có trạng thái, cần kiểm soát thời gian và phục hồi đáng tin cậy.
8. Từ chương trình đến Distributed Dataflow
Một Flink application được mô tả như một directed graph. Source tạo dữ liệu, operator biến đổi dữ liệu và sink đưa kết quả ra ngoài. Các cạnh thể hiện cách bản ghi di chuyển giữa operator.
Ví dụ logic:
Kafka Source
    |
Parse JSON
    |
Validate Order
    |--------------------> Invalid Event Side Output
    |
Assign Timestamp and Watermark
    |
Key By Store ID
    |
Aggregate Revenue
    |
Kafka Sink
Graph này có vẻ tuyến tính nhưng khi chạy với parallelism bằng 8, mỗi
operator có thể có tám subtask. Sau keyBy, event phải được
phân vùng lại theo store_id. Dữ liệu của cùng một cửa hàng
đến cùng một logical partition để phép tổng hợp dùng đúng state. Đây là
nơi code vài dòng biến thành một chương trình phân tán có network
shuffle, serialization, buffer và state.
Người phát triển cần nhìn pipeline ở hai cấp. Cấp logic trả lời dữ liệu được biến đổi thế nào. Cấp vật lý trả lời có bao nhiêu task, chạy ở đâu, trao đổi qua mạng ra sao và state được phân phối như thế nào.
9. Bốn lớp biểu diễn của một Flink Job
Để đọc Web UI và điều tra lỗi, nên hiểu Flink Job đi qua nhiều lớp biểu diễn.
Stream Graph được hình thành từ các lời gọi API của chương trình. Nó gần với source code, gồm source, transformation và sink.
Job Graph tối ưu Stream Graph cho việc thực thi. Những operator có thể chain được gom lại nhằm giảm chi phí chuyển giao và buffer. Job Graph được gửi đến cluster.
Execution Graph là biểu diễn song song của Job Graph. Mỗi JobVertex được mở rộng thành các ExecutionVertex theo parallelism. Đây là cấp mà scheduler theo dõi trạng thái của từng subtask và từng execution attempt.
Physical Execution là task thực sự chạy trong TaskManager slot. Khi một task lỗi và được restart, một execution attempt mới được tạo dù logical operator vẫn là operator đó.
Không cần thuộc tên mọi internal class để sử dụng Flink. Tuy nhiên, việc phân biệt logical operator, task đã chain và parallel subtask giúp trả lời các câu hỏi thực tế: Vì sao Web UI hiển thị ít task hơn số operator trong code? Vì sao chỉ một subtask bị backpressure? Vì sao thay đổi parallelism làm state được phân phối lại?
10. Kiến trúc Flink Cluster
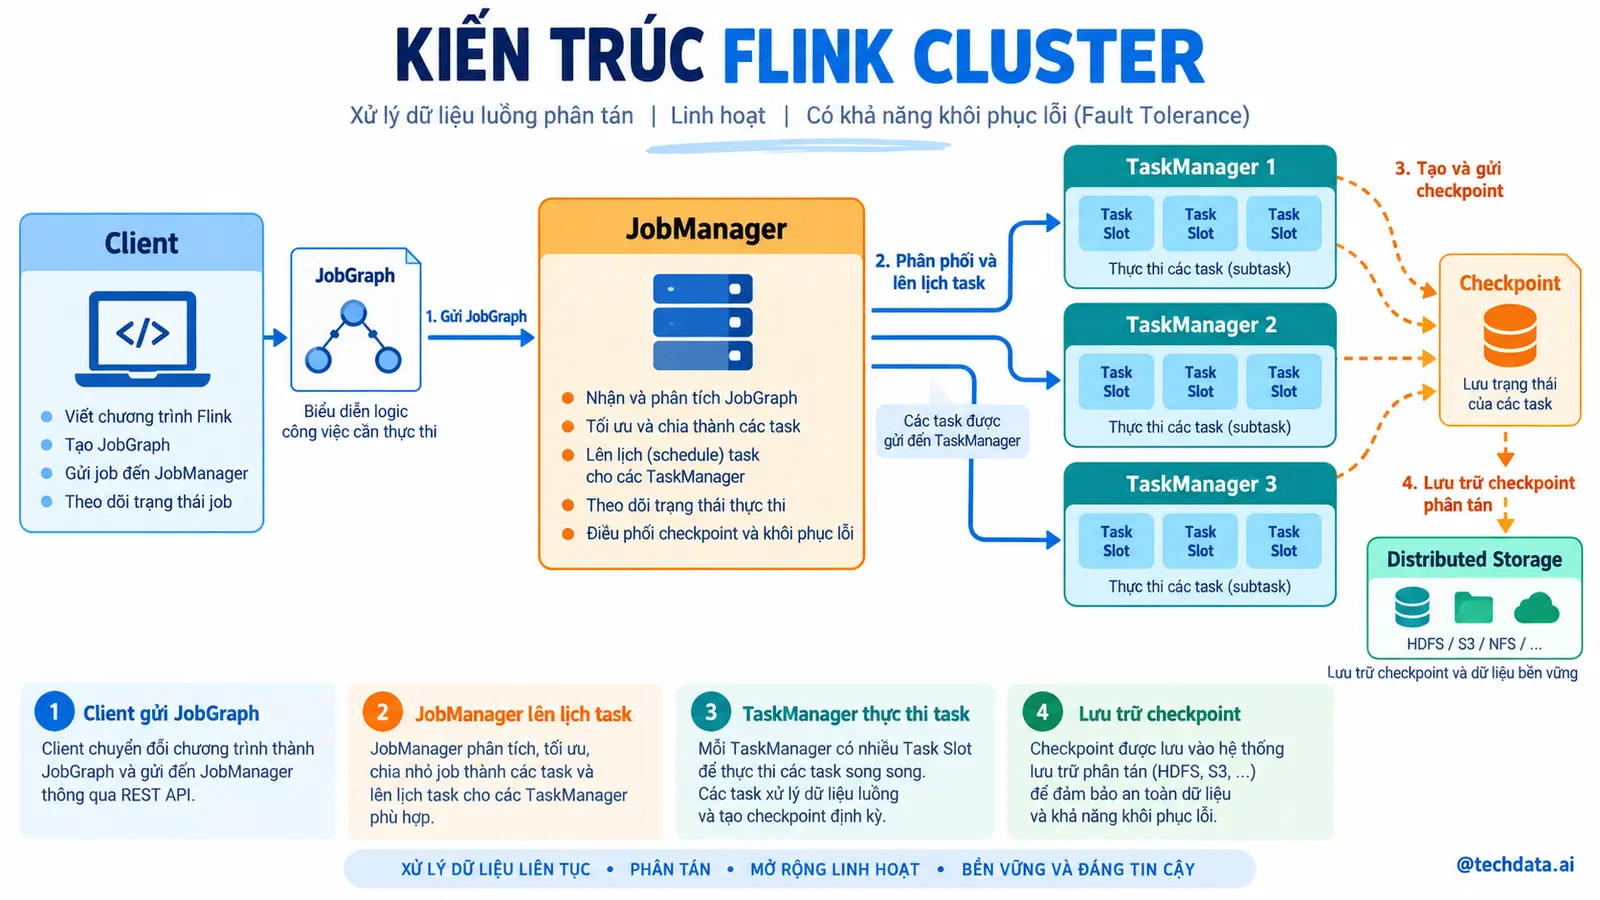
Một Flink Cluster có hai nhóm tiến trình chính: JobManager và TaskManager. JobManager điều phối; TaskManager thực thi.
Client chuẩn bị application, tạo Job Graph và gửi Job. Tùy deployment mode, client có thể chạy bên ngoài cluster hoặc một phần logic application có thể chạy trong cluster. Sau khi Job được submit, các thành phần điều phối yêu cầu tài nguyên, phân phối task và theo dõi execution.
JobManager không phải chỉ là một thread làm mọi việc. Trong kiến trúc Flink hiện đại, khái niệm JobManager bao gồm các thành phần logic như Dispatcher, ResourceManager và JobMaster. Trong cấu hình High Availability có thể có nhiều JobManager process, nhưng tại một thời điểm một leader đảm nhiệm vai trò hoạt động cho phần tương ứng.
TaskManager là worker process. Nó chạy task, quản lý vùng nhớ, duy trì state cục bộ, buffer dữ liệu và trao đổi dữ liệu với TaskManager khác. Cluster phải có ít nhất một TaskManager để thực thi công việc.
11. Dispatcher, ResourceManager và JobMaster
Dispatcher cung cấp REST interface để submit application và khởi tạo JobMaster cho mỗi Job được gửi. Nó cũng gắn với Web UI, nơi người vận hành xem execution, checkpoint và metric.
ResourceManager quản lý task slot và làm việc với môi trường cung cấp tài nguyên. Trên Kubernetes hoặc YARN, nó có thể yêu cầu hoặc giải phóng worker theo khả năng của integration. Trong standalone cluster, ResourceManager chỉ phân phối slot của những TaskManager đã có; nó không tự tạo thêm máy chủ ngoài cơ chế triển khai.
JobMaster quản lý execution của một JobGraph. Mỗi Job đang chạy có JobMaster riêng. Nó phối hợp scheduling, yêu cầu slot, theo dõi task, điều phối checkpoint và xử lý failure theo restart strategy.
Sự phân tách này có giá trị vận hành. Resource shortage không giống task exception. Không lấy được slot cần được điều tra ở resource manager và cấu hình cluster. Một operator ném lỗi liên tục cần được điều tra ở task log và dữ liệu. Checkpoint timeout có thể liên quan đến state, storage, backpressure hoặc network, không nhất thiết là JobManager “yếu”.
12. TaskManager và Task Slot
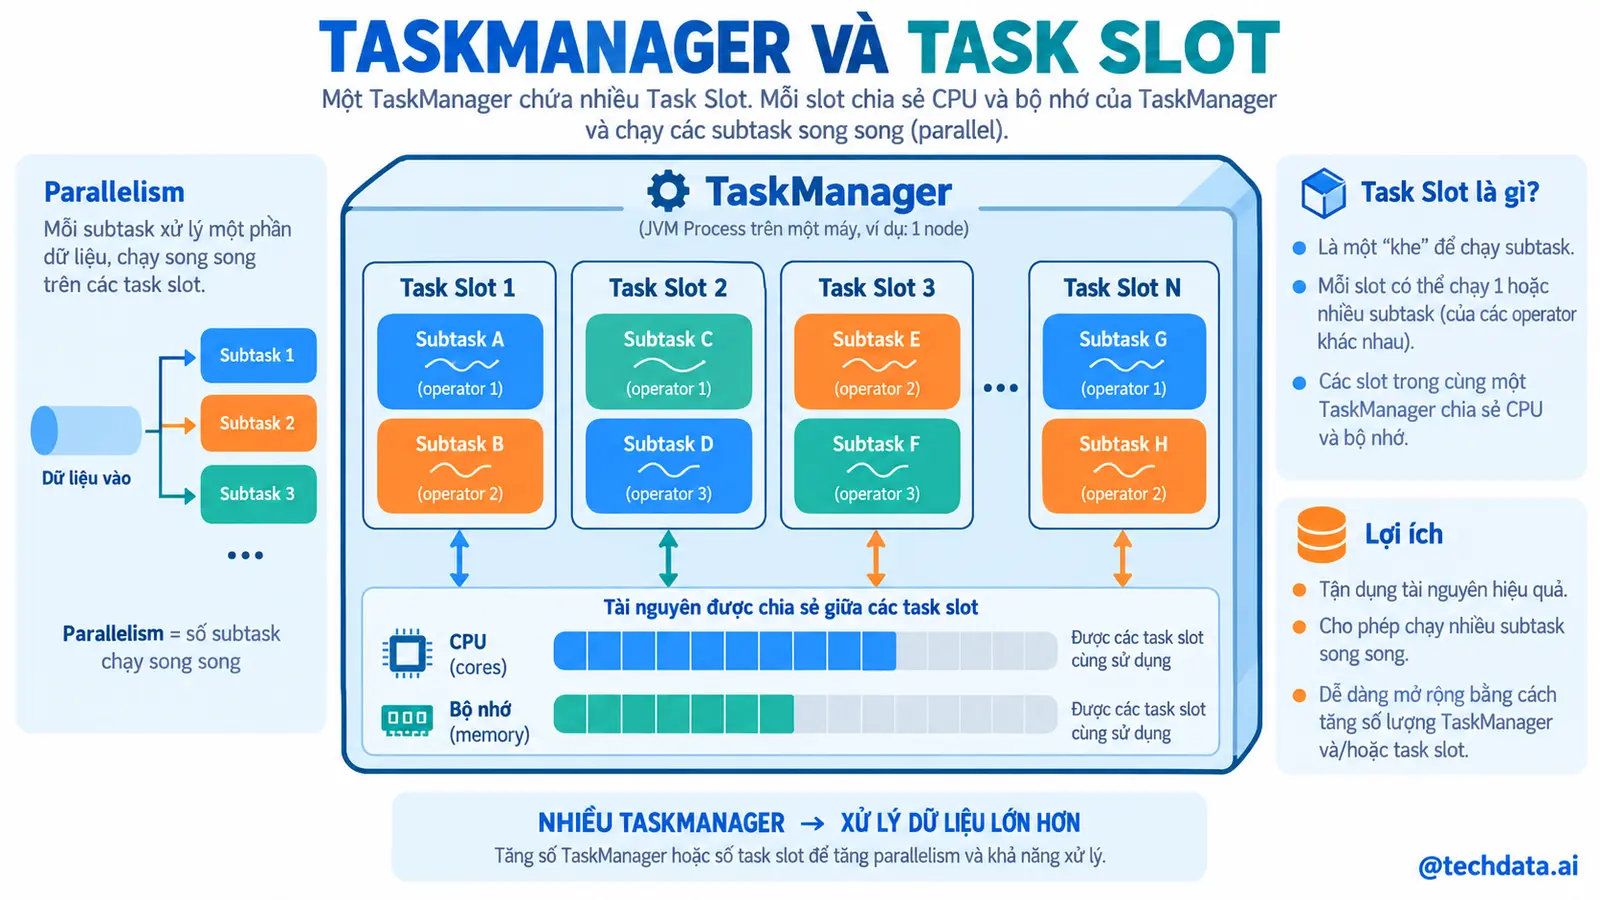
TaskManager là JVM worker thực thi các task của dataflow. Một TaskManager có một hoặc nhiều task slot. Slot là đơn vị lập lịch tài nguyên nhỏ nhất mà TaskManager cung cấp cho cluster.
Theo tài liệu kiến trúc Flink, mỗi slot đại diện cho một phần tài nguyên được quản lý của TaskManager, đặc biệt là managed memory. Slot không tạo CPU isolation cứng [2]. Vì vậy, câu nói “một slot bằng một CPU core” chỉ là quy ước sizing trong một số môi trường, không phải đảm bảo của runtime.
Mặc định, các subtask thuộc những operator khác nhau trong cùng một Job có thể chia sẻ slot thông qua slot sharing group. Nhờ đó, một pipeline gồm source, map và sink với parallelism 8 không nhất thiết cần 24 slot. Trong trường hợp thông thường, số slot cần thiết gần với parallelism lớn nhất trong slot sharing group.
Slot sharing cải thiện sử dụng tài nguyên vì operator nhẹ và operator nặng có thể cùng dùng một slot. Đổi lại, chúng có thể tranh CPU. Khi một operator thực hiện inference, compression hoặc parsing rất nặng, đội vận hành có thể cân nhắc tách slot sharing group hoặc điều chỉnh parallelism riêng.
13. Parallelism, Subtask và Max Parallelism
Parallelism của operator là số subtask chạy đồng thời cho operator đó. Nếu source có parallelism 4, Flink tạo bốn source subtask. Nếu downstream aggregate có parallelism 8, dữ liệu được phân phối đến tám aggregate subtask theo partitioning strategy.
Parallelism có thể đến từ cấu hình mặc định của environment, cấu hình cluster hoặc được đặt riêng cho operator. Đặt riêng là hợp lý khi một bước nặng hơn rõ rệt. Tuy nhiên, việc gán một con số cho từng operator mà không đo throughput sẽ làm hệ thống khó vận hành.
Max Parallelism liên quan đến số key-group của keyed state. Key-group là đơn vị Flink dùng để phân phối keyed state giữa subtask. Khi rescale, các key-group được gán lại cho parallel subtask mới. Max parallelism vì thế ảnh hưởng khả năng mở rộng và tính tương thích state.
Tăng parallelism không bảo đảm throughput tăng tuyến tính. Có ít nhất bốn giới hạn:
- Source chỉ có số partition hữu ích hữu hạn. Tám source subtask không đọc song song hiệu quả từ topic chỉ có hai partition.
- Key distribution có thể lệch. Một hot key vẫn dồn tải vào một subtask.
- Sink có thể là bottleneck do transaction, connection hoặc quota.
- Network shuffle và serialization tăng chi phí khi chia nhỏ quá mức.
Sizing đúng bắt đầu từ throughput mục tiêu, cost per record, kích thước state, phân bố key và SLA phục hồi.
14. Data Partitioning và chi phí Network Shuffle
Cách hai operator nối với nhau quyết định dữ liệu có được truyền cục bộ hay qua network.
forward giữ quan hệ một-một giữa upstream và downstream
khi parallelism tương thích. rebalance phân phối vòng tròn
để làm đều tải. rescale phân phối trong một phạm vi cục bộ
hơn giữa upstream và downstream. broadcast gửi mỗi record
đến mọi downstream subtask. keyBy hash theo key và đưa mọi
record cùng key về cùng logical partition.
keyBy là nền tảng của keyed state nhưng cũng tạo network
shuffle. Mỗi record cần serialize, đi qua buffer và có thể truyền sang
TaskManager khác. Nếu payload quá lớn hoặc pipeline liên tục đổi
partition, network và garbage collection có thể trở thành
bottleneck.
Chọn key là quyết định kiến trúc. Key cần bảo đảm tính đúng của logic
và có phân bố đủ tốt. Ví dụ, aggregate theo country_code
chỉ có vài key sẽ không tận dụng được parallelism cao. Aggregate theo
customer_id có cardinality lớn hơn nhưng state và
downstream contract khác. Không nên thêm salt vào key trước khi xác nhận
business semantics và cách gộp kết quả hai giai đoạn.
15. Operator Chaining
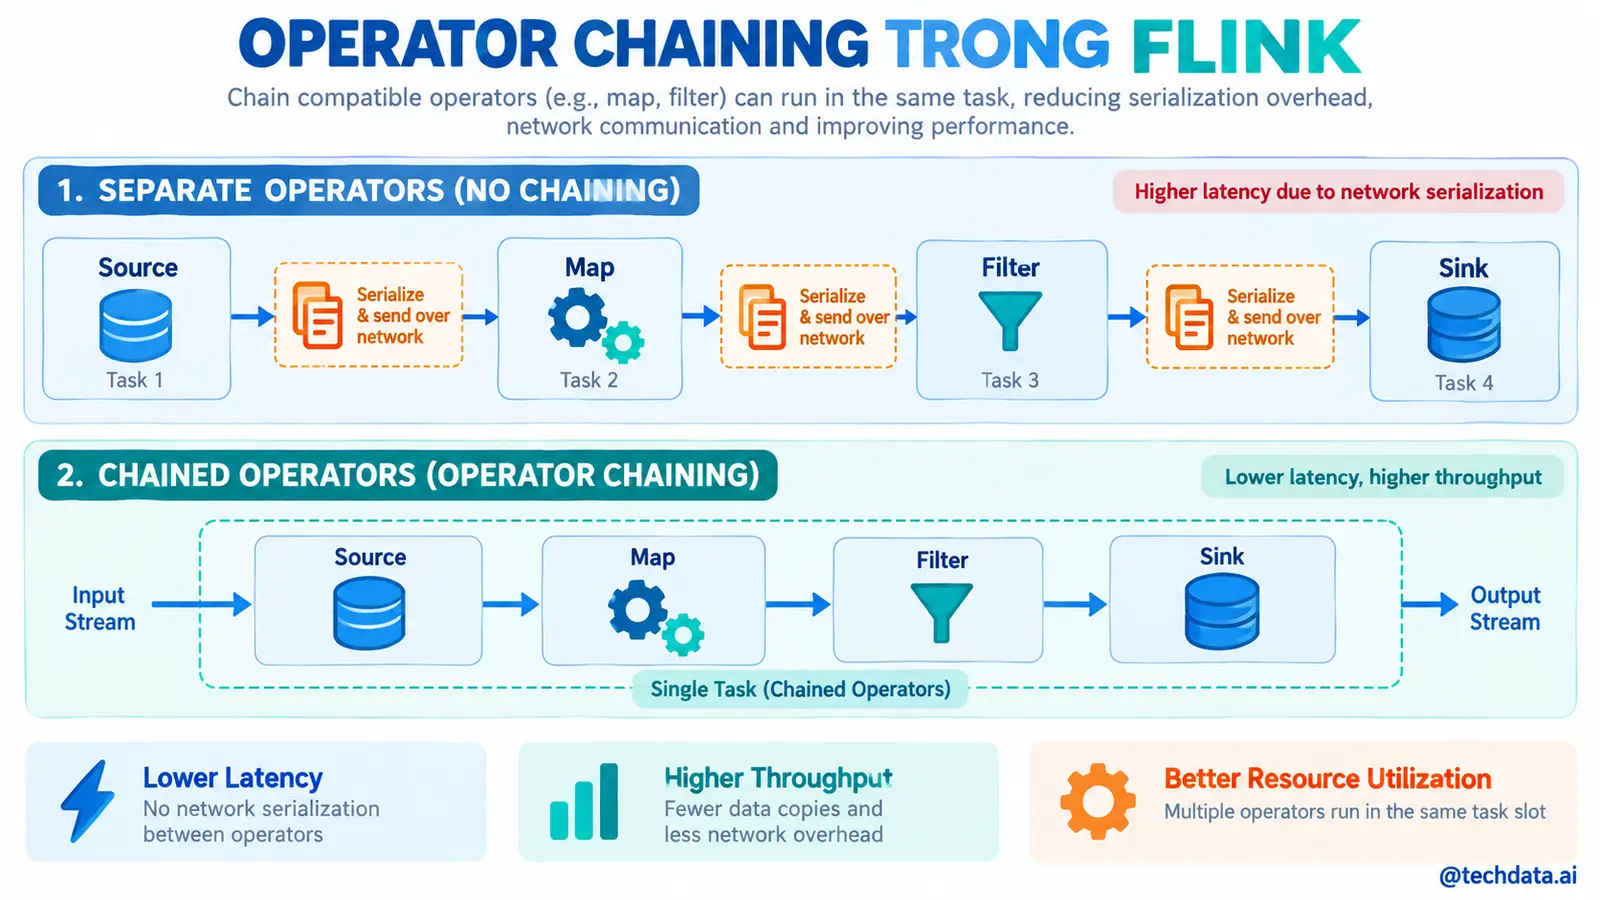
Flink có thể chain nhiều operator tương thích thành một task. Ví dụ, source, map và filter có thể chạy trong cùng thread nếu partitioning và các điều kiện khác cho phép. Chaining giảm serialization, buffer, context switching và network overhead, từ đó tăng throughput và giảm latency.
Trong Web UI, một task có thể mang tên ghép của nhiều operator. Đây là lý do số box vật lý đôi khi ít hơn số transformation trong source code.
Không nên tắt chaining trên toàn Job chỉ để graph dễ nhìn. Việc phá chain có chi phí. Tuy nhiên, tách chain có thể hữu ích khi cần cô lập operator nặng, thay đổi slot sharing, đo metric chi tiết hoặc ngăn một đoạn blocking ảnh hưởng operator khác. Quyết định phải dựa trên profiling và kiến trúc, không dựa trên cảm giác.
Tên và UID operator vẫn rất quan trọng. name() giúp quan
sát. uid() tạo định danh ổn định để Flink ánh xạ state khi
restore từ savepoint. Đổi tên hiển thị thường ít nghiêm trọng hơn đổi
hoặc mất UID của operator stateful.
16. State trong Stream Processing
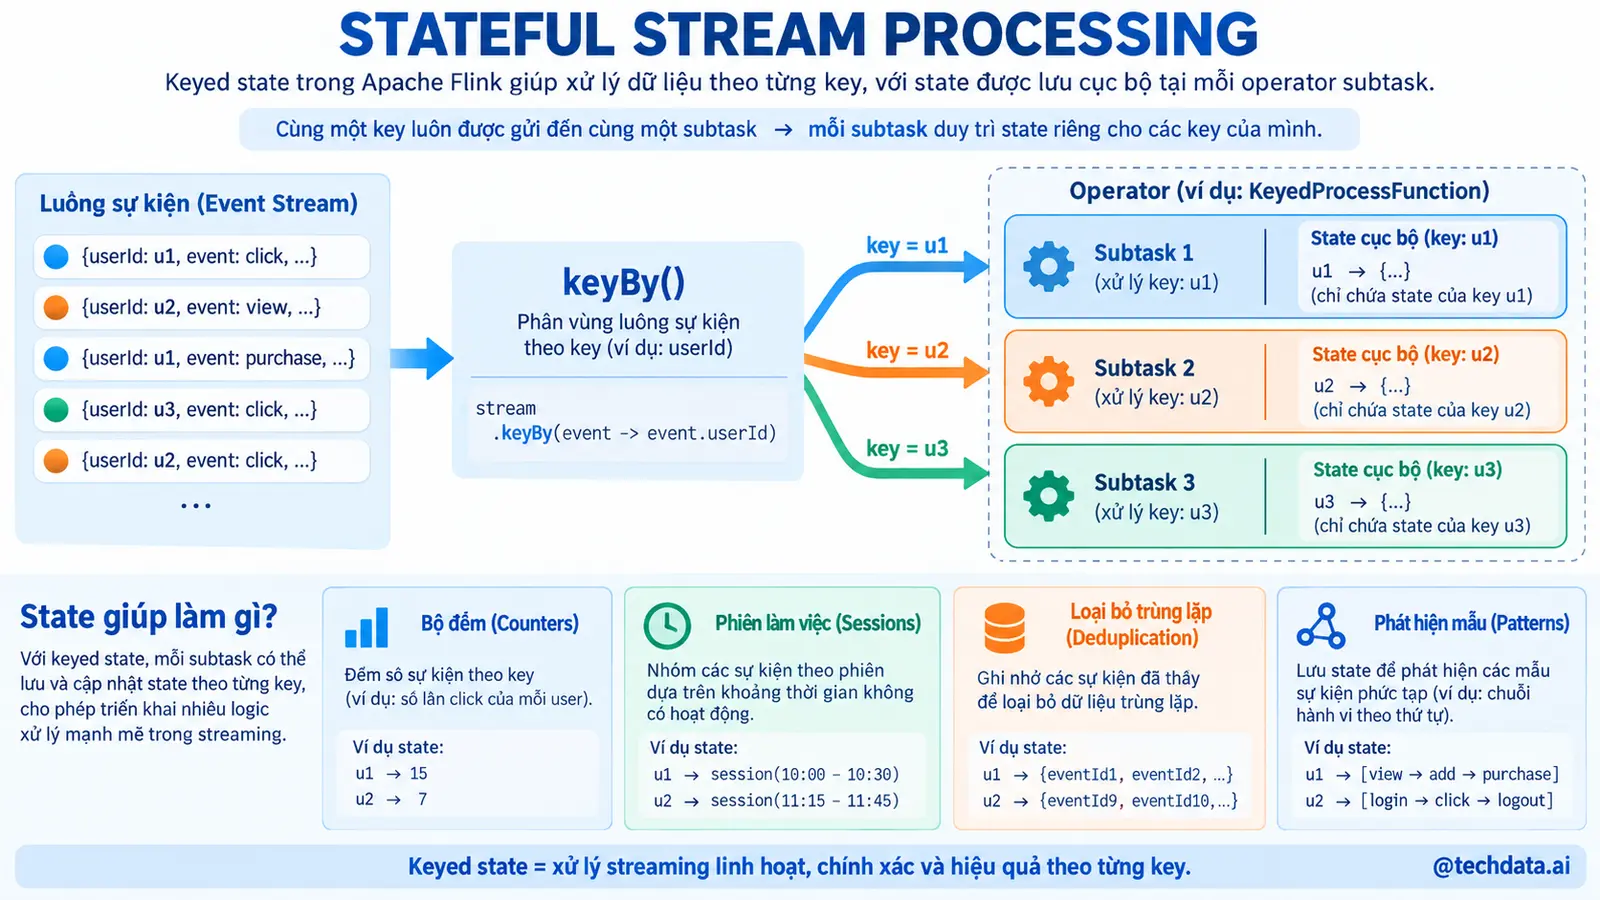
State là dữ liệu trung gian mà phép tính cần ghi nhớ giữa các event. Ví dụ:
- Tổng doanh thu hiện tại của từng cửa hàng.
- Event ID đã thấy để loại trùng.
- Trạng thái cuối cùng của từng đơn hàng.
- Bước hiện tại trong một pattern phát hiện gian lận.
- Timer đang chờ để kiểm tra timeout.
- Rule đang có hiệu lực cho từng nhóm giao dịch.
Nếu state nằm trong một HashMap do người dùng tự tạo,
Flink không biết cách phân vùng, checkpoint hoặc di chuyển nó. Khi task
restart trên worker khác, map biến mất. Khi rescale, đội phát triển phải
tự quyết định mục nào đi đâu.
Managed State giải quyết vấn đề này. Flink biết state thuộc operator và key nào, lưu state qua state backend, tạo snapshot và khôi phục state cùng execution. Theo tài liệu chính thức, state do Flink quản lý có thể được giữ gần nơi xử lý để truy cập nhanh, được checkpoint để bền vững và được phân phối lại khi cluster thay đổi quy mô [3].
State không miễn phí. Mỗi key mới có thể làm state tăng. Serializer không hiệu quả làm tăng CPU và dung lượng checkpoint. State thiếu TTL có thể giữ dữ liệu đã hết giá trị nhiều năm. Bất kỳ thiết kế stateful nào cũng phải trả lời: state được tạo khi nào, cập nhật ra sao, hết hạn lúc nào và có thể lớn tối đa bao nhiêu.
17. Keyed State, Operator State và Broadcast State
Keyed State chỉ khả dụng trên keyed stream. State
được phân vùng theo key nên code có cảm giác như mỗi key có một biến
riêng. Các kiểu thường gặp gồm ValueState,
ListState, MapState,
ReducingState và AggregatingState. Keyed State
phù hợp cho tổng theo khách hàng, trạng thái đơn hàng, deduplication
theo ID hoặc timer theo key.
Operator State gắn với parallel instance của operator thay vì business key. Nó phù hợp khi operator quản lý một tập split, offset hoặc buffer riêng. Khi rescale, Operator State được phân phối lại theo cơ chế tương ứng như list state hoặc union list state.
Broadcast State hỗ trợ trường hợp một luồng nhỏ chứa rule hoặc cấu hình cần được gửi đến mọi parallel instance của luồng chính. Ví dụ, hệ thống gian lận cập nhật rule theo thời gian mà không restart Job. Mỗi task nhận cùng broadcast state và áp dụng rule lên event đã keyBy.
State TTL giúp giới hạn vòng đời của một số keyed state. Tuy nhiên, TTL không phải công tắc “dọn ngay lập tức mọi dữ liệu hết hạn”. Cách cleanup phụ thuộc backend và hoạt động truy cập hoặc compaction. Thiết kế vẫn cần ước lượng state, giám sát kích thước và kiểm thử hành vi sau khi state hết hạn.
18. Event Time, Processing Time và Watermark
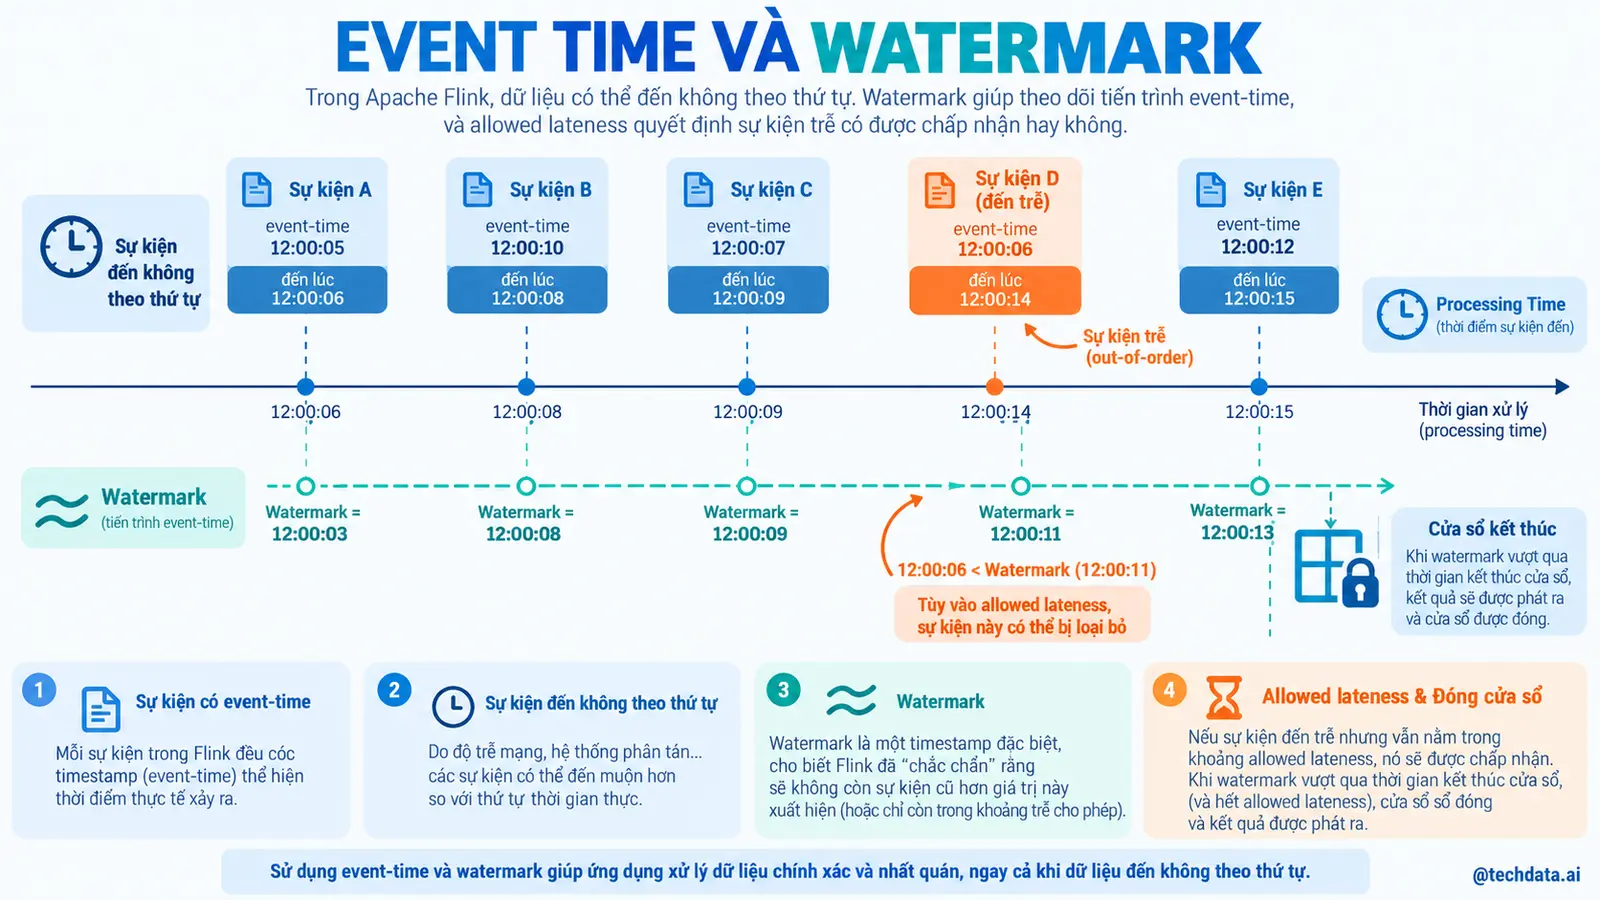
Trong hệ thống phân tán, “thời gian của event” không phải một khái niệm duy nhất.
Processing Time là thời điểm máy chạy operator xử lý record. Nó đơn giản và có latency thấp, nhưng kết quả phụ thuộc tốc độ cluster, consumer lag và sự cố. Cùng một tập dữ liệu có thể rơi vào cửa sổ khác khi chạy lại.
Event Time là thời điểm sự kiện thực sự xảy ra theo dữ liệu nghiệp vụ. Một giao dịch lúc 10:00 có thể đến Flink lúc 10:00:02 hoặc 10:05 sau gián đoạn mạng. Event Time cho phép kết quả phản ánh thời gian kinh doanh và có thể nhất quán hơn khi replay.
Thách thức là Flink không biết event cũ hơn còn đang trên đường đến
hay không. Watermark cung cấp một ước lượng về tiến độ Event Time. Có
thể hiểu watermark tại thời điểm t là tuyên bố rằng stream
có khả năng đã tương đối đầy đủ đến t [4]. Khi watermark
vượt cuối một event-time window, operator có cơ sở phát kết quả.
Watermark không bảo đảm tuyệt đối rằng sẽ không còn event cũ hơn. Event đến sau watermark là late event và cần chính sách: bỏ, cho phép cập nhật trong khoảng allowed lateness hoặc chuyển sang side output để audit và xử lý lại.
Trong pipeline song song, watermark downstream bị ảnh hưởng bởi input chậm. Một Kafka partition nhàn rỗi có thể giữ watermark không tiến. Cơ chế idleness cho phép đánh dấu partition không hoạt động sau một khoảng phù hợp. Timeout quá ngắn có thể làm event tiếp theo bị xem là muộn; timeout quá dài làm toàn pipeline chậm phát kết quả.
Watermark vì thế là quyết định nghiệp vụ kết hợp kỹ thuật. Độ trễ tối đa chấp nhận, completeness mong muốn và chi phí giữ state phải được thống nhất với người sử dụng dữ liệu.
19. Window không phải là cách duy nhất xử lý thời gian
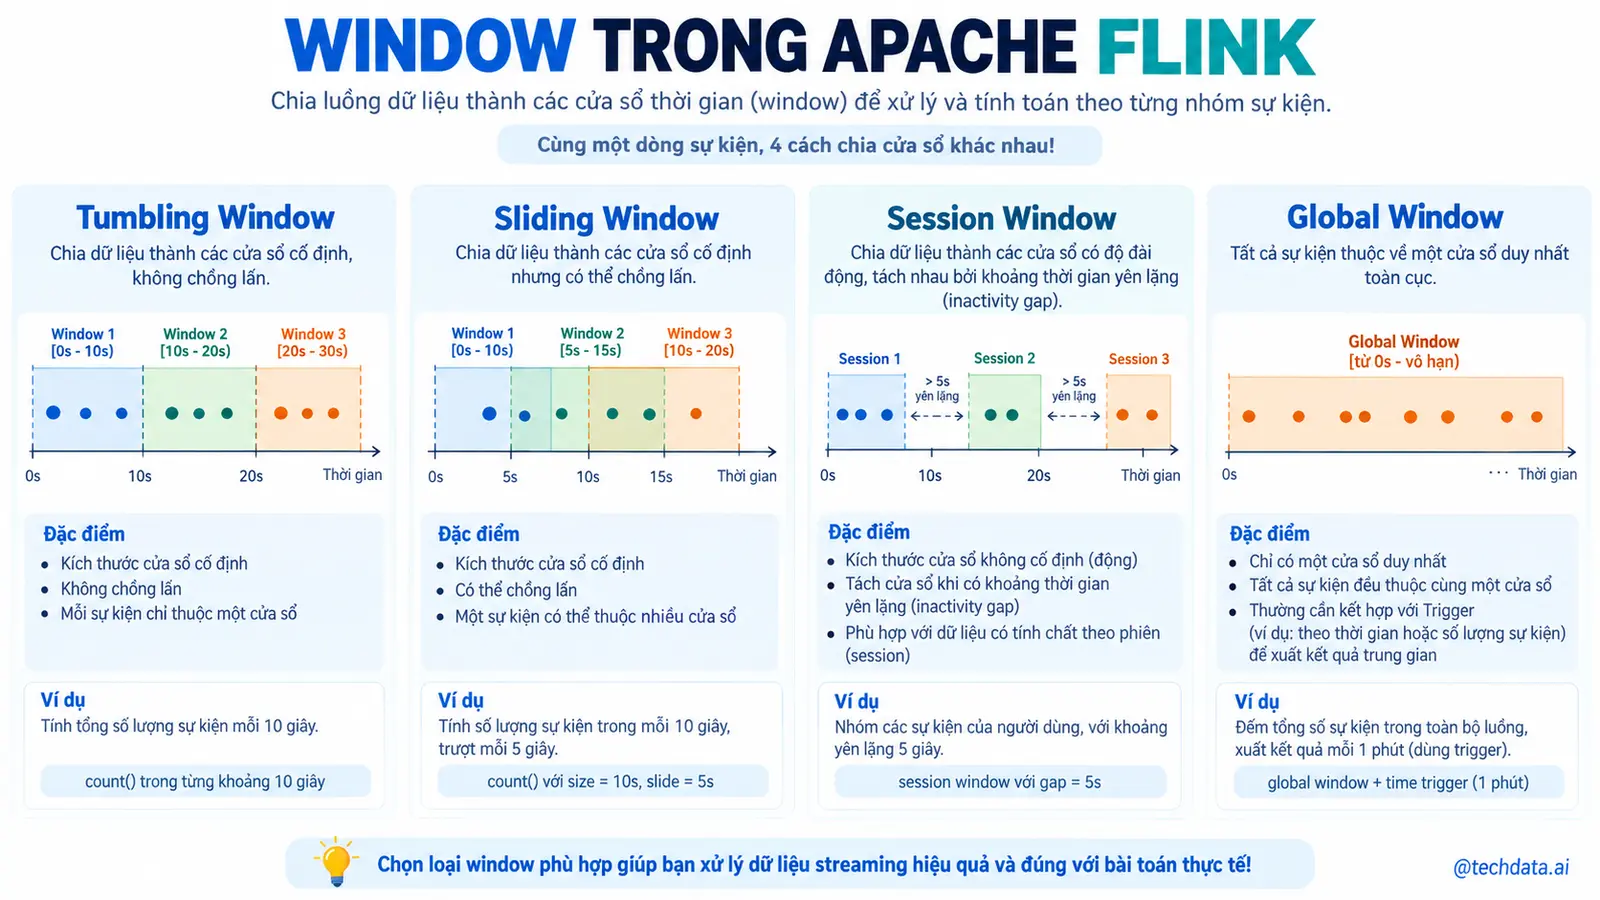
Window chia unbounded stream thành phạm vi hữu hạn. Tumbling window tạo khoảng không chồng lấp. Sliding window tạo các khoảng chồng nhau. Session window nhóm hoạt động được ngăn bởi khoảng im lặng.
Window rất hữu ích cho metric theo thời gian, nhưng không phải mọi
logic thời gian đều nên ép vào window. Theo dõi đơn hàng đã thanh toán
nhưng chưa giao sau mười phút phù hợp hơn với keyed state và timer. Phát
hiện chuỗi sự kiện có thể dùng KeyedProcessFunction hoặc
CEP. Duy trì trạng thái hiện tại của entity có thể là keyed process
không cần window.
Window cũng có chi phí state. Sliding window mười phút trượt mỗi phút
có thể đặt một event vào nhiều window logic. Nếu dùng
ProcessWindowFunction giữ toàn bộ record, state tăng nhanh.
AggregateFunction có thể tích lũy incremental và chỉ giữ
accumulator nhỏ hơn.
Thiết kế phải làm rõ trigger phát kết quả, allowed lateness và kiểu output. Early firing tạo kết quả tạm thời. Late firing có thể sửa kết quả cũ. Sink dạng append-only sẽ không biểu diễn đúng update nếu không có khóa và version.
20. Checkpoint và cơ chế phục hồi
Checkpoint là snapshot nhất quán của state và vị trí source, được tạo định kỳ để Flink phục hồi sau lỗi. Flink sử dụng biến thể của thuật toán Chandy-Lamport với checkpoint barrier chạy trong dataflow [6].
Khi bắt đầu checkpoint, source ghi lại vị trí và chèn barrier mang số checkpoint vào stream. Barrier đi qua operator cùng dữ liệu. Một operator có nhiều input cần bảo đảm snapshot phản ánh dữ liệu trước barrier trên các input theo cơ chế alignment trong checkpoint thông thường. State được snapshot và ghi đến durable storage. Pipeline vẫn tiếp tục xử lý trong phần lớn quá trình này thay vì dừng toàn bộ hệ thống.
Khi task hoặc worker lỗi, Flink khởi động lại execution theo restart strategy và phục hồi từ checkpoint thành công gần nhất. Source quay lại vị trí tương ứng. State quay về ảnh chụp tương ứng. Những event sau checkpoint có thể được đọc và xử lý lại.
Checkpoint interval là bài toán cân bằng. Interval ngắn giảm lượng dữ liệu phải replay nhưng tăng I/O và overhead. Interval dài giảm tần suất snapshot nhưng làm Recovery Point Objective lớn hơn và có thể tăng thời gian bắt kịp sau lỗi. Các metric cần theo dõi gồm duration, alignment time, start delay, bytes persisted, số checkpoint thất bại và thời gian từ checkpoint thành công gần nhất.
Checkpoint storage phải bền vững và TaskManager mới phải truy cập được. Lưu checkpoint vào filesystem cục bộ bên trong container rồi kỳ vọng phục hồi sau khi pod bị xóa là một lỗi kiến trúc nghiêm trọng.
21. Exactly-once cần được hiểu như thế nào?
Exactly-once thường bị hiểu thành “mỗi event chỉ đi qua hệ thống một lần”. Trong thực tế, sau failure, source có thể replay và event có thể được xử lý lại. Điều Flink hướng tới là tác động của mỗi event lên managed state tương đương với đúng một lần khi phục hồi từ snapshot nhất quán [6].
Đó là exactly-once state consistency. Để có end-to-end exactly-once, source phải replay được và sink phải transactional hoặc idempotent. Nếu Flink state chính xác nhưng operator gọi một HTTP API tạo thanh toán mà API không có idempotency key, request có thể được gửi lại sau recovery và tạo tác động trùng.
Kafka source kết hợp Kafka sink transactional có thể xây semantics mạnh khi cấu hình đúng checkpoint và transaction. Database sink có thể dùng upsert với unique key để đạt hiệu ứng idempotent. Một số hệ thống đích chỉ hỗ trợ at-least-once, lúc đó duplicate phải được chấp nhận hoặc loại ở downstream.
Không nên quảng bá exactly-once chỉ vì code gọi
enableCheckpointing. Cần kiểm thử failure tại các điểm khó:
TaskManager chết khi checkpoint đang chạy, sink chậm, transaction chưa
commit, Job restore và rescale. Kết quả phải được đối soát bằng event ID
và business total.
22. Checkpoint và Savepoint khác nhau ra sao?
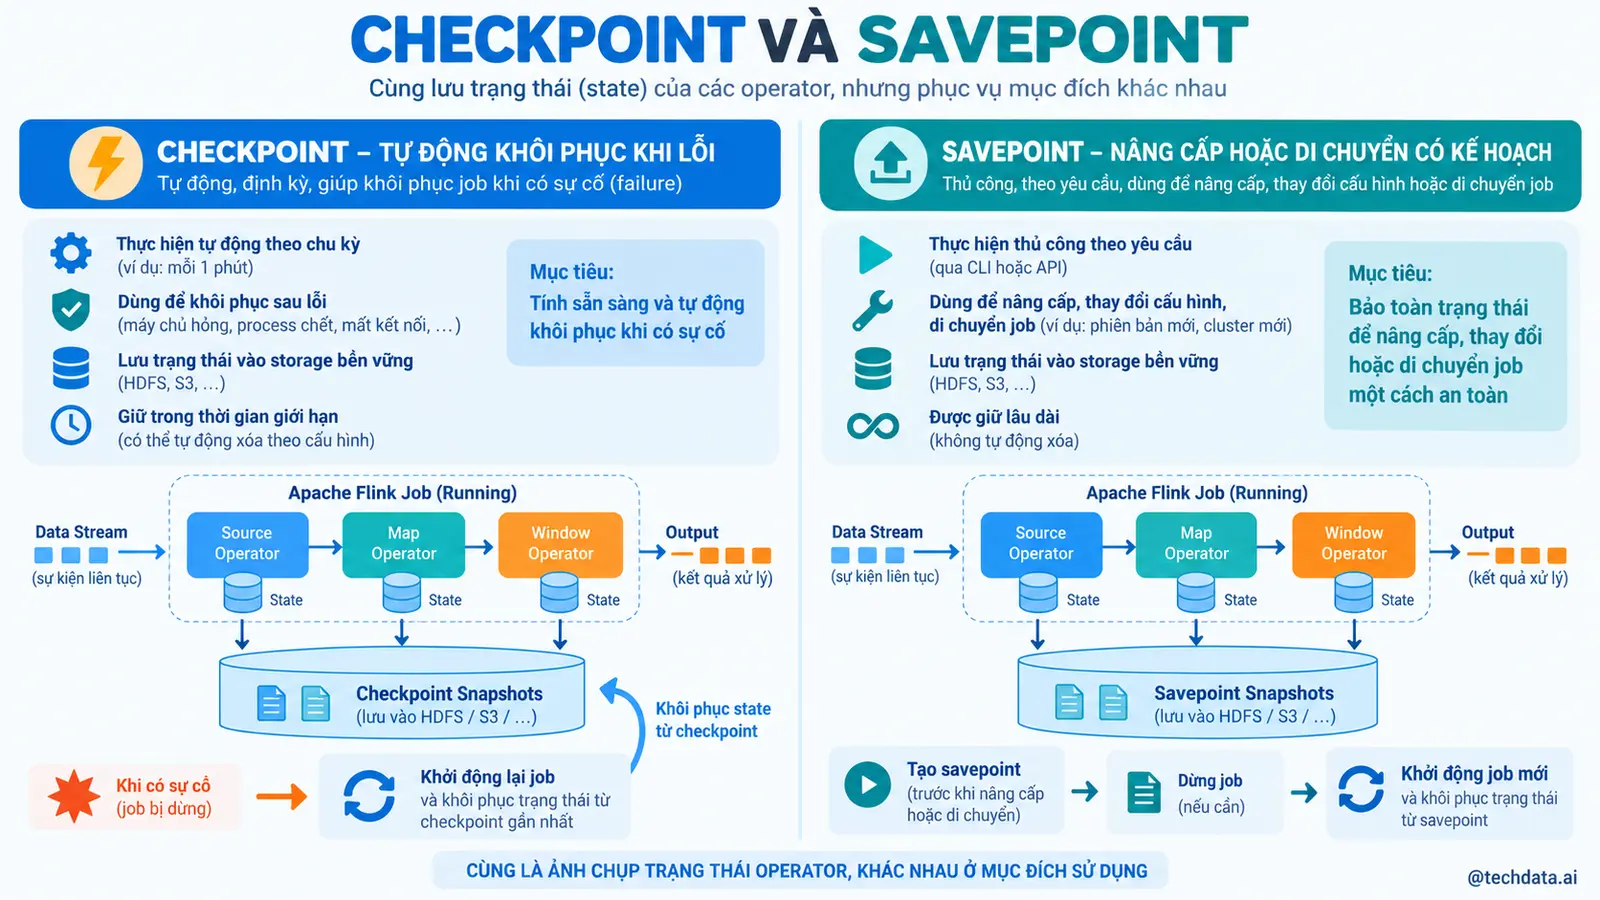
Checkpoint và savepoint đều là snapshot state nhưng mục đích vận hành khác nhau.
Checkpoint được Flink tạo và quản lý để phục hồi tự động. Nó có vòng đời gắn với Job và chính sách retention. Người vận hành thường không chọn từng checkpoint làm mốc phát hành dài hạn.
Savepoint được kích hoạt có chủ đích để nâng cấp, di chuyển, rescale hoặc dừng và khởi động lại Job có trạng thái. Savepoint là mốc vận hành mà đội ngũ cần quản lý vị trí, quyền truy cập và tính tương thích.
Khả năng restore phụ thuộc mapping operator và serializer state. Đây là lý do operator stateful nên có UID ổn định. Nếu xóa UID, đổi topology không kiểm soát hoặc thay kiểu state không tương thích, phiên bản mới có thể không dùng được savepoint cũ.
Một quy trình release an toàn cần thử restore trên staging bằng state đại diện. “Tạo savepoint thành công” chưa chứng minh “phiên bản mới restore thành công và cho kết quả đúng”.
23. Backpressure và khả năng điều tiết luồng dữ liệu
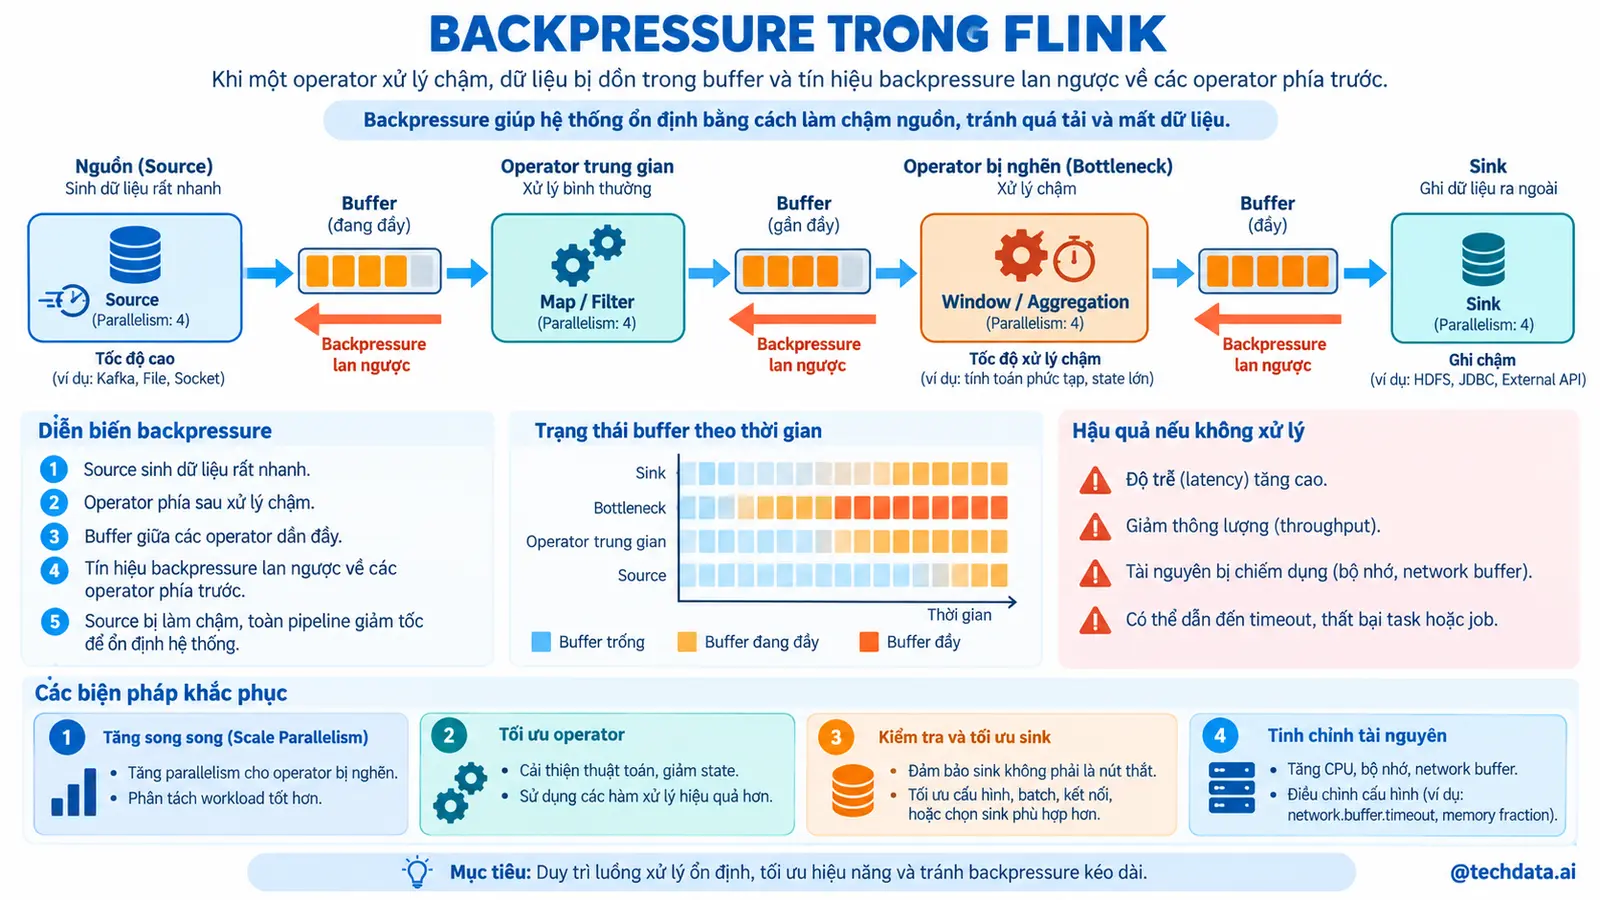
Backpressure xuất hiện khi downstream xử lý chậm hơn upstream. Buffer dần đầy và tín hiệu áp lực truyền ngược lên các operator trước, cuối cùng làm source giảm tốc độ đọc. Đây là cơ chế cần thiết để hệ thống không tiếp tục nhận vô hạn dữ liệu vào bộ nhớ khi sink đang chậm.
Backpressure là triệu chứng, không phải nguyên nhân gốc. Operator hiển thị backpressured có thể chỉ đang chờ downstream. Cần lần theo graph để tìm subtask đầu tiên có busy time cao, I/O chậm, hot key, garbage collection, synchronous external call hoặc sink quota.
Nếu Kafka source giảm tốc độ, consumer lag tăng. Khi sink phục hồi, Job cần đủ headroom để xử lý nhanh hơn tốc độ dữ liệu mới sinh, nếu không lag sẽ không bao giờ giảm.
Tăng parallelism chỉ có tác dụng khi bottleneck có thể chia nhỏ và source, sink hỗ trợ. Một hot key vẫn chạy trên một subtask. Một database chỉ cho phép mười connection không nhanh hơn khi mở một trăm sink subtask. Tuning phải dựa trên metric theo subtask, không chỉ CPU trung bình toàn cluster.
24. DataStream API, Table API và Flink SQL
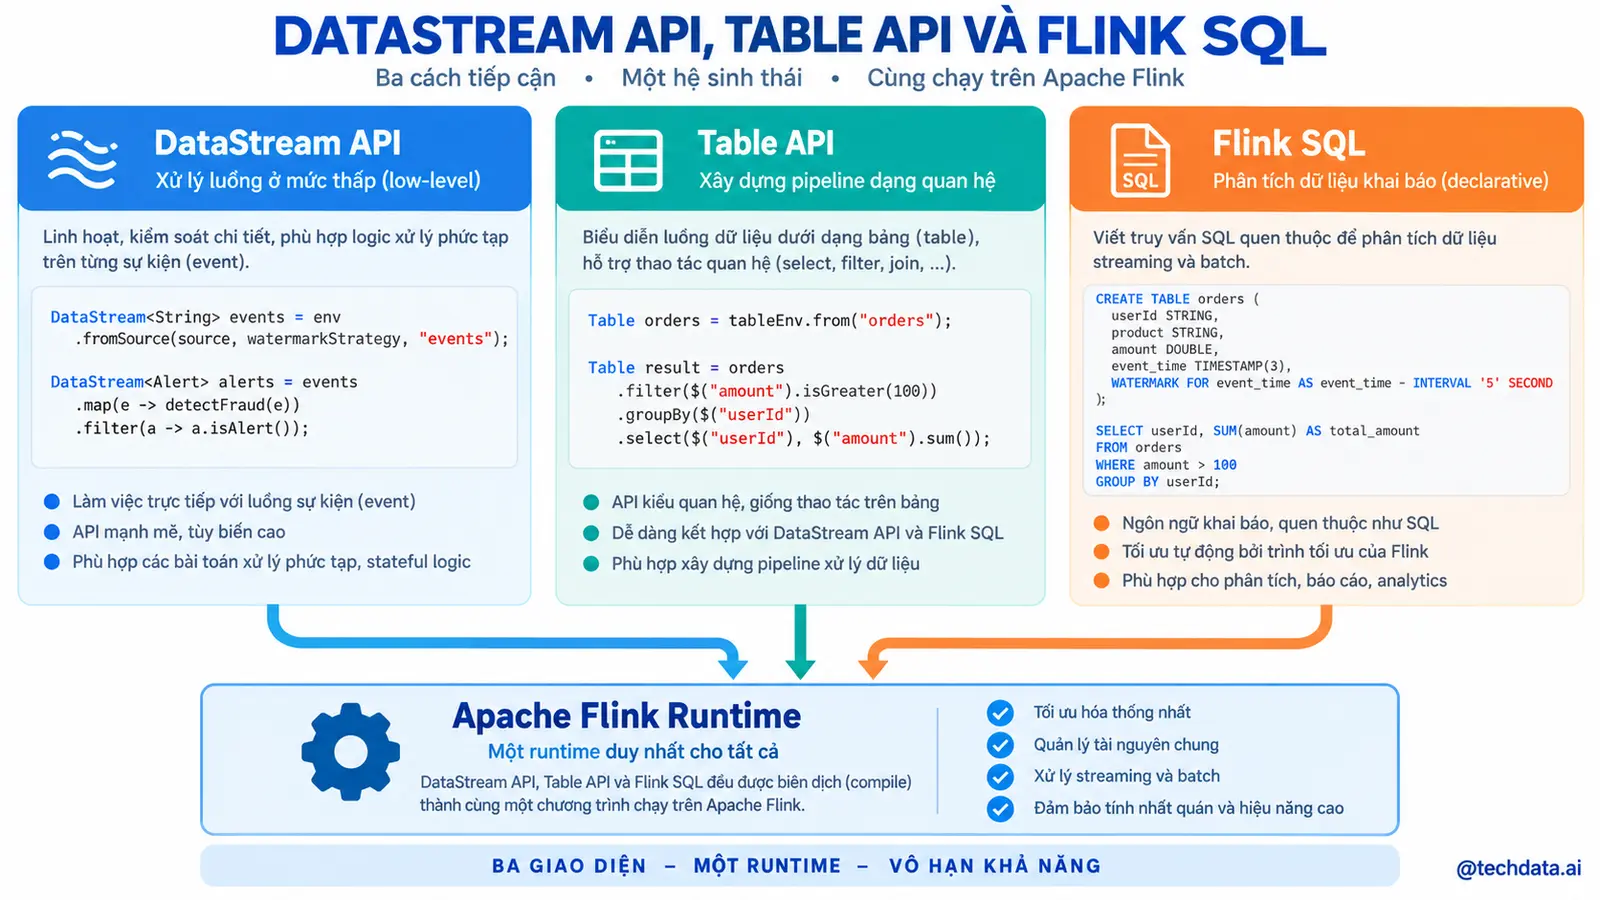
DataStream API cho phép mô tả transformation ở mức chi tiết. Người
phát triển làm việc với map, filter,
keyBy, process, window, state, timer và side
output. Nó phù hợp cho event-driven application, custom state machine,
logic cần kiểm soát từng event và integration đặc thù.
Table API cung cấp relational abstraction trên dynamic table. Flink SQL cho phép mô tả transformation bằng SQL, phù hợp với streaming ETL, aggregation, join và các nhóm Data Engineer quen hệ sinh thái SQL.
Trong streaming SQL, table thay đổi theo thời gian. Query có thể tạo insert, update và delete logic. Sink phải hỗ trợ changelog mode tương ứng. Một câu SQL chạy được không bảo đảm Elasticsearch index, Kafka topic hoặc file sink hiểu đúng semantics update.
Doanh nghiệp không nhất thiết chọn một API duy nhất. SQL có thể phục vụ tầng chuẩn hóa và metric; DataStream phục vụ fraud rule hoặc xử lý tùy biến. Điều quan trọng là chuẩn hóa deployment, catalog, schema, state, observability và quyền truy cập để hai cách làm không trở thành hai nền tảng rời rạc.
25. Kiến trúc Kafka và Flink cho hệ thống đơn hàng
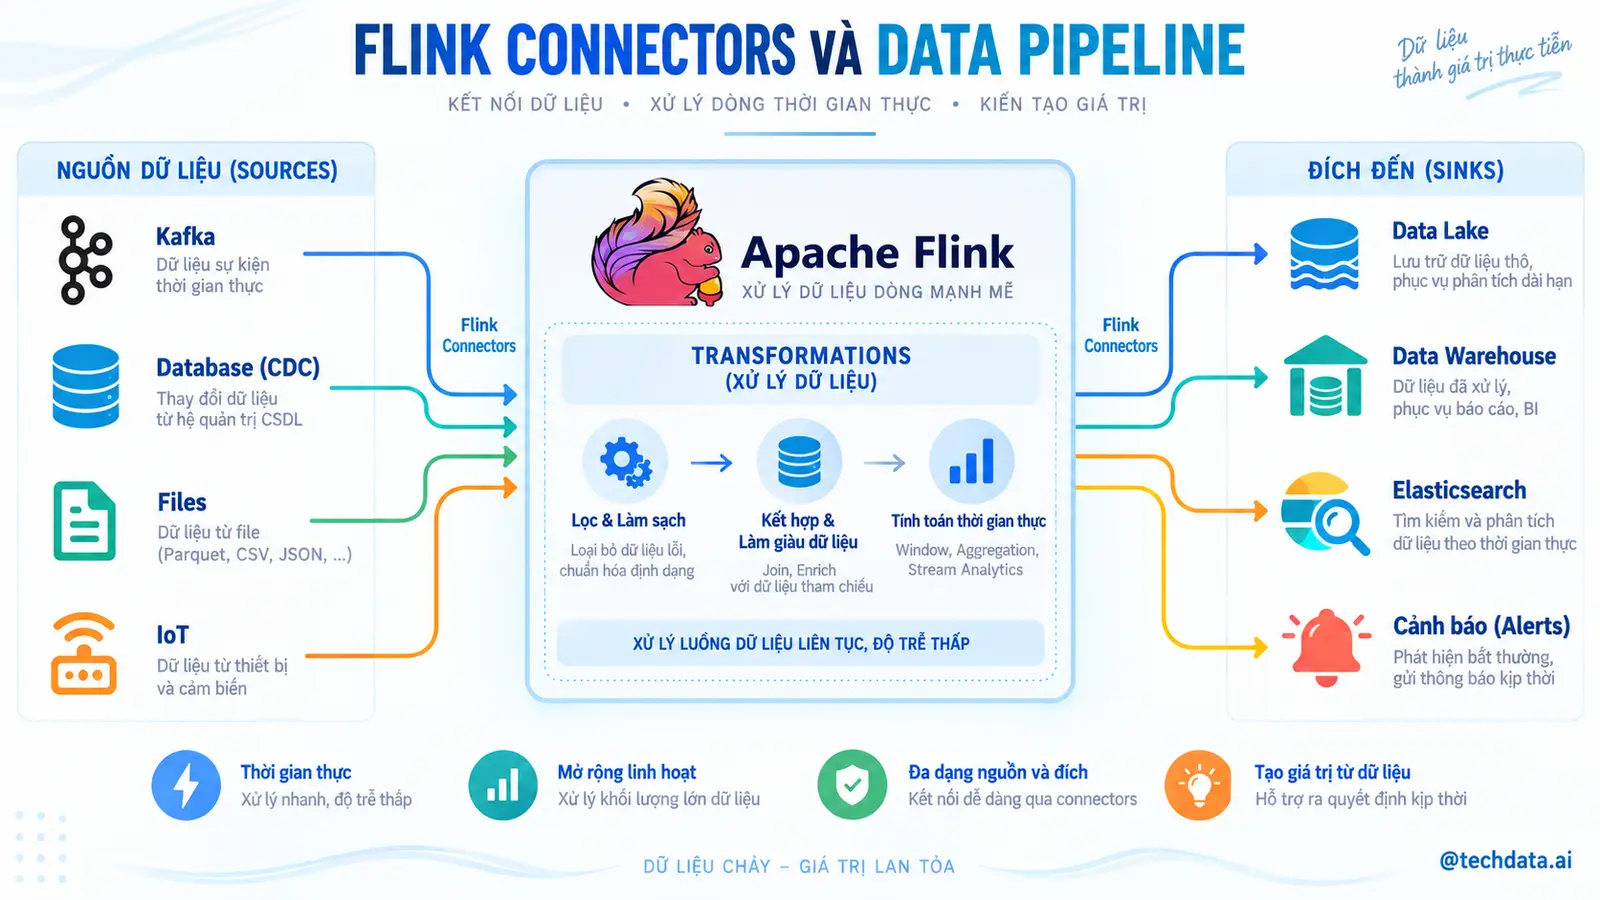
Xét một kiến trúc thương mại điện tử:
Order Service
    |
Kafka: order-events
    |
Flink Order Processing
    |-- Validate and normalize
    |-- Assign event time and watermark
    |-- Deduplicate by event_id
    |-- Aggregate revenue by store
    |-- Detect paid-but-not-shipped timeout
    |
    |----------> Kafka: invalid-order-events
    |----------> Kafka: store-revenue
    |----------> Kafka: fulfillment-alerts
    |----------> Data Lake: curated orders
order-events nên chứa domain event có schema được quản
trị. Trường tối thiểu gồm event_id, order_id,
event_type, event_time, store_id,
customer_id, amount, currency và
schema_version. Kafka key thường là order_id
nếu cần duy trì thứ tự tương đối của event trong cùng đơn hàng.
Lớp validation không âm thầm bỏ dữ liệu sai. Invalid event được đưa sang dead-letter topic cùng raw payload, error code, source topic, partition, offset và thời điểm xử lý. Metric theo error code giúp phát hiện producer rollout sai schema.
Sau validation, Flink gán timestamp và watermark. Deduplication dùng
event_id cùng TTL dựa trên khoảng replay có thể xảy ra.
Aggregate doanh thu dùng key phù hợp với business grain. Logic
paid-but-not-shipped duy trì trạng thái theo order_id và
đăng ký event-time timer. Khi sự kiện shipped đến, timer được xóa; khi
timer kích hoạt trước khi có shipped, hệ thống phát cảnh báo.
Mỗi output có contract riêng. store-revenue có thể là
upsert theo store_id và window_end.
fulfillment-alerts có alert_id ổn định để
downstream idempotent. Data Lake sink cần chính sách partition và
small-file management.
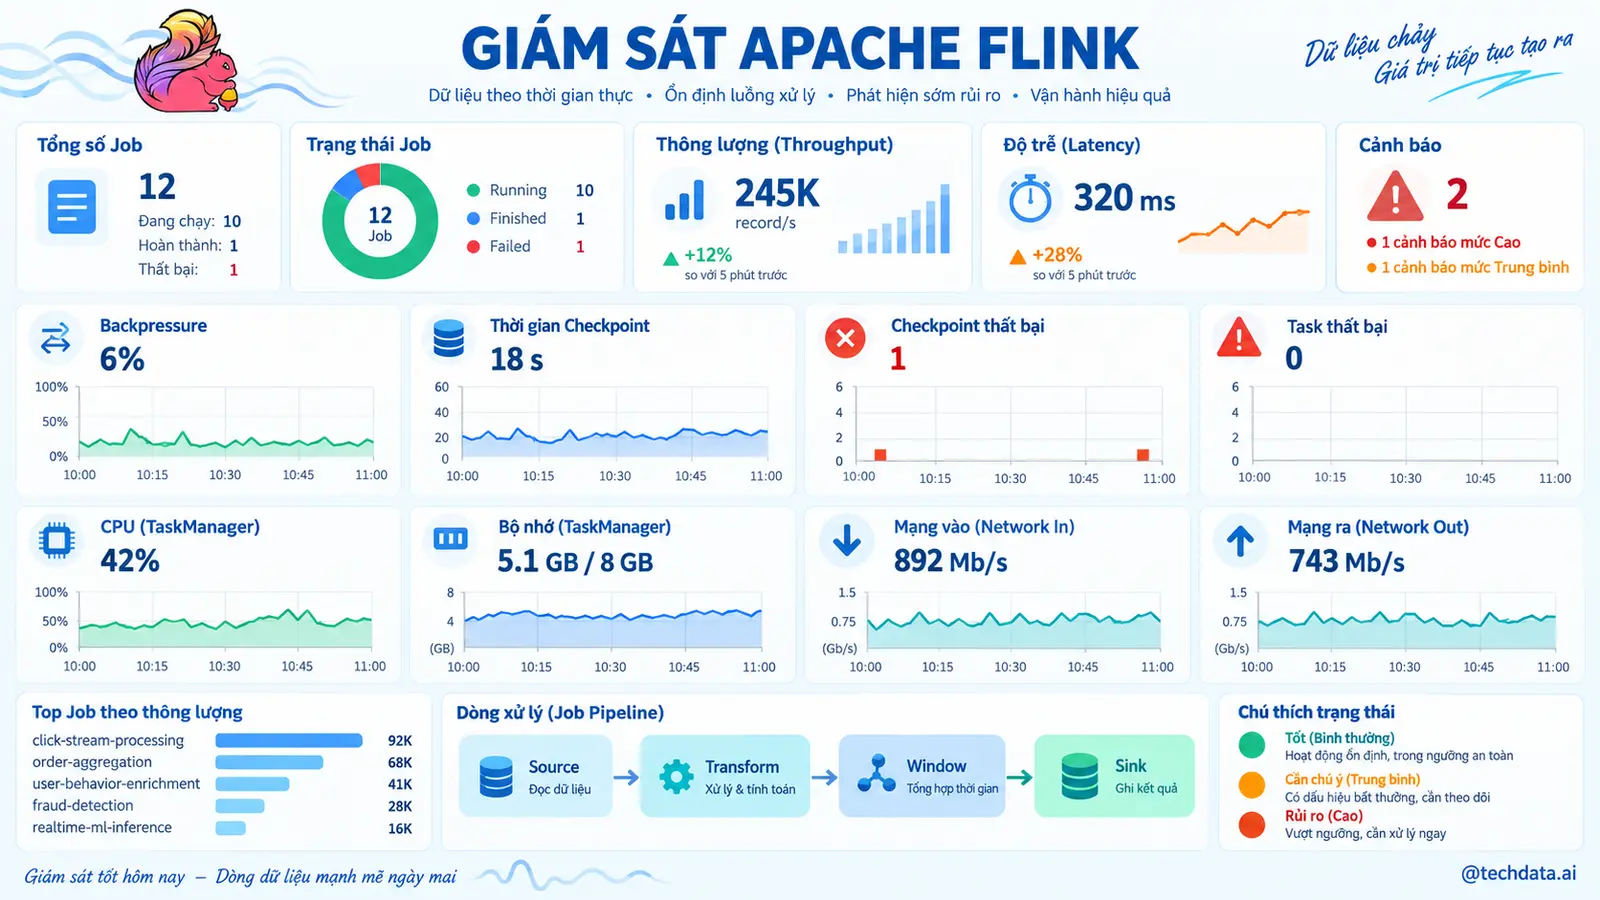
Checkpoint storage nằm trên object storage bền vững. Kafka sink transactional chỉ được bật sau khi kiểm tra transaction timeout, checkpoint duration và transactional ID prefix duy nhất cho từng Job. Dashboard theo dõi Kafka lag, records in/out, invalid rate, watermark lag, state size, checkpoint và restart.
Kiến trúc này cho thấy một Flink Job production không chỉ có transformation. Nó gồm data contract, state lifecycle, failure semantics, output semantics và observability.
26. Ví dụ Flink Job bằng Java
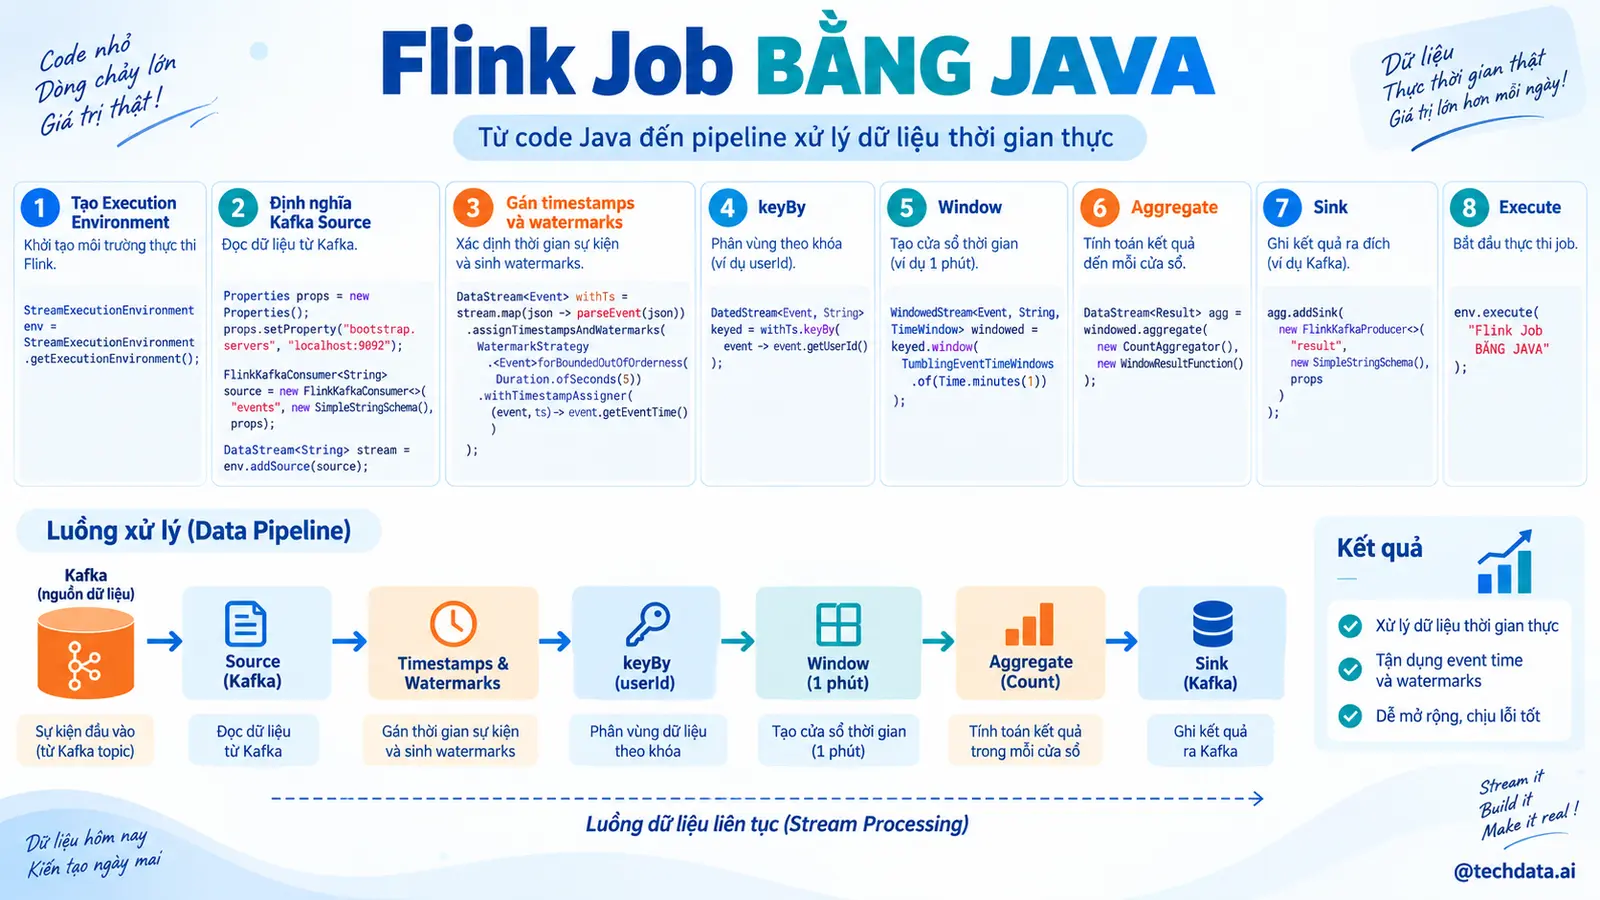
Đoạn code sau minh họa cấu trúc logic. Tên artifact và API connector cần được đối chiếu với đúng phiên bản Flink đang triển khai.
public class OrderRevenueJob {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
            StreamExecutionEnvironment.getExecutionEnvironment();

        env.enableCheckpointing(30_000L, CheckpointingMode.EXACTLY_ONCE);
        env.getCheckpointConfig().setMinPauseBetweenCheckpoints(10_000L);
        env.getCheckpointConfig().setCheckpointTimeout(120_000L);
        env.getCheckpointConfig().setMaxConcurrentCheckpoints(1);

        KafkaSource<String> source = KafkaSource.<String>builder()
            .setBootstrapServers("kafka:9092")
            .setTopics("order-events")
            .setGroupId("flink-order-revenue-v1")
            .setStartingOffsets(
                OffsetsInitializer.committedOffsets(
                    OffsetResetStrategy.EARLIEST
                )
            )
            .setValueOnlyDeserializer(new SimpleStringSchema())
            .build();

        WatermarkStrategy<OrderEvent> watermarkStrategy =
            WatermarkStrategy
                .<OrderEvent>forBoundedOutOfOrderness(
                    Duration.ofSeconds(30)
                )
                .withTimestampAssigner(
                    (event, previousTimestamp) -> event.eventTime()
                )
                .withIdleness(Duration.ofMinutes(1));

        DataStream<String> raw = env.fromSource(
                source,
                WatermarkStrategy.noWatermarks(),
                "kafka-order-source"
            )
            .name("kafka-order-source")
            .uid("kafka-order-source-v1");

        SingleOutputStreamOperator<OrderEvent> parsedOrders = raw
            .process(new ParseAndValidateOrderFunction())
            .name("parse-and-validate-order")
            .uid("parse-and-validate-order-v1");

        DataStream<InvalidOrder> invalidOrders =
            parsedOrders.getSideOutput(InvalidOrderTags.INVALID_ORDERS);

        SingleOutputStreamOperator<OrderEvent> validOrders = parsedOrders
            .assignTimestampsAndWatermarks(watermarkStrategy)
            .name("assign-order-time")
            .uid("assign-order-time-v1");

        DataStream<StoreRevenue> revenue = validOrders
            .keyBy(OrderEvent::storeId)
            .window(
                TumblingEventTimeWindows.of(Duration.ofMinutes(1))
            )
            .allowedLateness(Duration.ofSeconds(30))
            .aggregate(
                new RevenueAggregateFunction(),
                new AddWindowMetadataFunction()
            )
            .name("store-revenue-one-minute")
            .uid("store-revenue-one-minute-v1");

        revenue.sinkTo(buildRevenueKafkaSink())
            .name("store-revenue-kafka-sink")
            .uid("store-revenue-kafka-sink-v1");

        invalidOrders.sinkTo(buildInvalidOrderSink())
            .name("invalid-order-kafka-sink")
            .uid("invalid-order-kafka-sink-v1");

        env.execute("order-revenue-job");
    }
}
Điểm quan trọng không nằm ở việc sao chép code mà ở các quyết định xung quanh nó.
Source dùng committed offsets với fallback EARLIEST,
nhưng khi restore từ checkpoint, state khôi phục mới là cơ sở vị trí
đọc. Watermark cho phép tối đa ba mươi giây out-of-order và đánh dấu
partition idle sau một phút. Các con số này phải đến từ phân tích dữ
liệu, không phải chọn tùy ý.
Operator stateful có UID ổn định. Invalid record đi side output. Revenue window có allowed lateness, vì vậy sink cần hiểu một window có thể được cập nhật. Checkpoint mode là exactly-once cho state, nhưng end-to-end còn phụ thuộc implementation của hai sink.
Code production cũng cần externalized configuration, secret management, schema registry, test, metric tùy biến, restart strategy và checkpoint storage. Không nên để bootstrap server, topic và timeout nằm cứng trong class như ví dụ minh họa.
27. Vòng đời triển khai một Flink Job
Một vòng đời chuyên nghiệp nên bắt đầu từ data contract, không phải từ code.
Bước 1: Xác định semantics. Làm rõ source of truth, key, event time, timezone, rule dữ liệu trễ, duplicate và kiểu output. Ghi expected result cho một bộ event nhỏ.
Bước 2: Xây logic thuần. Parse, validate và business rule nên được test độc lập. Tách lỗi dữ liệu dự kiến khỏi lỗi hệ thống.
Bước 3: Thiết kế state. Xác định state type, key cardinality, TTL, timer, serializer và dung lượng ước tính. Đặt UID trước khi đưa Job có state vào production.
Bước 4: Integration test. Chạy với Kafka và sink thật hoặc container tương đương. Kiểm tra schema evolution, late data, duplicate và output contract.
Bước 5: Fault injection. Kill TaskManager, làm sink chậm, ngắt Kafka tạm thời và khôi phục từ checkpoint. Đối soát số liệu sau recovery.
Bước 6: Load test. Dùng phân bố key giống production. Dữ liệu ngẫu nhiên đều có thể che hot key. Đo throughput bền vững, latency, state growth, checkpoint và recovery time.
Bước 7: Release có khả năng rollback. Artifact phải bất biến. Tạo savepoint khi cần. Thử restore trước. Theo dõi metric kỹ sau rollout và giữ đường quay lại phiên bản cũ.
Bước 8: Vận hành liên tục. Review checkpoint, lag, backpressure, restart, state và data-quality metric. Diễn tập disaster recovery định kỳ thay vì chờ sự cố thật.
28. Khi nào nên và không nên sử dụng Flink?
Nên cân nhắc Flink khi hệ thống có một hoặc nhiều yêu cầu sau:
- Xử lý liên tục với latency từ dưới giây đến vài phút.
- Event Time và late data ảnh hưởng tính đúng.
- Phép tính có state lớn hoặc phức tạp.
- Cần join stream, timer, pattern hoặc materialized state.
- Cần fault tolerance và state consistency mạnh.
- Cần một runtime chung cho nhiều pipeline streaming.
- Cần replay, backfill và rescale với state được quản lý.
Không nên chọn Flink chỉ vì muốn kiến trúc trông hiện đại. Một cron job SQL có thể tốt hơn nếu dữ liệu nhỏ, chạy mỗi ngày và không có state phức tạp. Managed warehouse có thể xử lý near-real-time đủ tốt với ít chi phí vận hành hơn. Một Kafka consumer service đơn giản có thể phù hợp nếu logic stateless và đội ngũ đã có framework vận hành service mạnh.
Flink cũng đòi hỏi năng lực đáng kể: Java hoặc SQL streaming, Kubernetes hoặc cluster operations, state, checkpoint, schema, observability và incident response. Nếu doanh nghiệp chưa sẵn sàng sở hữu platform, managed service hoặc giải pháp đơn giản hơn có thể hợp lý.
Câu hỏi đúng không phải “Flink có xử lý được không?” mà là “Flink có tạo ra đủ giá trị để bù cho chi phí vận hành và độ phức tạp không?”
29. Những sai lầm kiến trúc thường gặp
Xem Flink như một script ETL chạy mãi. Streaming Job cần state lifecycle, recovery, output semantics và monitoring khác batch script.
Dùng Processing Time cho KPI nghiệp vụ cần tái lập. Kết quả thay đổi khi lag hoặc replay, làm đối soát khó khăn.
Không đặt UID cho operator stateful. Đến lúc nâng cấp mới phát hiện savepoint không ánh xạ được như mong muốn.
Giữ state vô hạn. Key space tăng dần nhưng không có TTL hoặc cleanup. Checkpoint lớn, recovery chậm và storage tăng liên tục.
Gọi dịch vụ ngoài đồng bộ cho từng event. Một API latency 200 ms giới hạn throughput của một subtask ở mức rất thấp và gây backpressure. Cần cân nhắc Async I/O, cache, batch hoặc stream join.
Cho rằng bật checkpoint là có end-to-end exactly-once. Sink không transactional hoặc không idempotent vẫn tạo duplicate.
Chọn key có skew lớn. Một khách hàng, cửa hàng hoặc tenant lớn chiếm phần lớn traffic làm một subtask quá tải dù cluster còn nhiều CPU.
Lưu checkpoint trên local disk không bền vững. Pod mới không thể truy cập snapshot cũ.
Tăng parallelism để chữa mọi vấn đề. Bottleneck có thể nằm ở sink quota, hot key, network, serialization hoặc checkpoint storage.
Không có dead-letter flow. Một bản ghi sai làm Job restart liên tục hoặc bị bỏ âm thầm. Cả hai đều gây rủi ro dữ liệu.
Không kiểm thử restore. Checkpoint thành công không bảo đảm quy trình recovery, quyền storage và phiên bản code mới hoạt động đúng.
30. Checklist Production
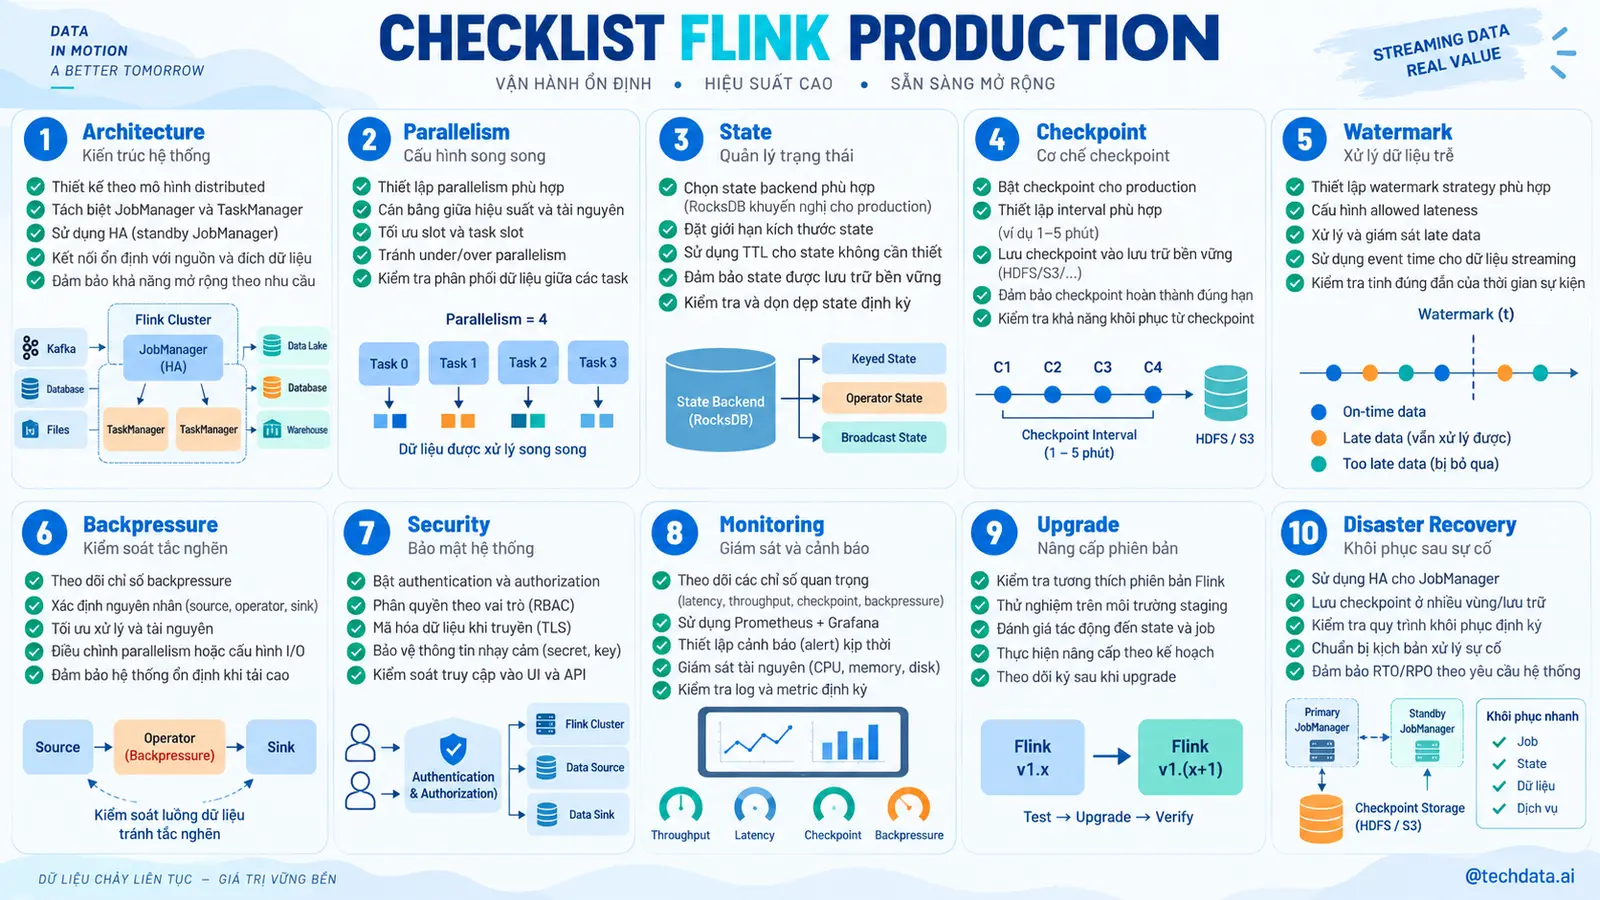
Data contract
- Event có ID, timestamp, version và business key rõ ràng.
- Schema compatibility được kiểm tra trong CI hoặc quy trình release.
- Có chính sách cho null, dữ liệu sai, duplicate và late event.
- Output được xác định là append, update, retract hoặc idempotent upsert.
State và thời gian
- Key distribution đã được đo trên dữ liệu thật.
- State có TTL hoặc cleanup rule phù hợp.
- Watermark và idleness dựa trên latency thực tế.
- Operator stateful có UID ổn định.
- Ước lượng state size ở lưu lượng và retention cao điểm.
Fault tolerance
- Checkpoint storage bền vững, có quyền truy cập từ worker mới.
- Có alert cho checkpoint failure và checkpoint age.
- Restart strategy phù hợp, tránh restart loop vô hạn.
- Đã test recovery, savepoint, rescale và rollback.
- Sink semantics được kiểm chứng bằng fault injection.
Hiệu năng
- Source partition đủ cho parallelism dự kiến.
- Dashboard có records in/out, busy time, backpressure và idle time theo subtask.
- Theo dõi Kafka consumer lag và khả năng catch up.
- Theo dõi state size, checkpoint duration và bytes persisted.
- External call có timeout, retry giới hạn và cơ chế chống retry storm.
Vận hành
- Image và JAR có version bất biến.
- Configuration tách khỏi code và secret không nằm trong repository.
- Log có Job, operator, subtask và event ID khi phù hợp.
- Runbook mô tả cách xử lý lag, checkpoint failure, schema error và sink outage.
- Có owner, SLA và lịch diễn tập recovery.
Bảo mật
- Kết nối Kafka, storage và database dùng mã hóa khi yêu cầu.
- Service account có quyền tối thiểu.
- Log và dead-letter topic không làm lộ dữ liệu nhạy cảm ngoài kiểm soát.
- Secret được quản lý và xoay vòng tập trung.
31. Lộ trình học Apache Flink
Người mới không nên học Flink bằng cách đọc toàn bộ API theo thứ tự alphabet. Một lộ trình hiệu quả hơn gồm sáu bước.
Bước 1: Nắm mô hình stream. Phân biệt bounded, unbounded, event, key, partition, state và output update.
Bước 2: Viết DataStream Job nhỏ. Thực hành source, map, filter, keyBy và sink. Quan sát Job Graph thay vì chỉ đọc console.
Bước 3: Học Event Time. Tạo dữ liệu out-of-order, watermark, window và late side output. Tự tính expected result.
Bước 4: Học managed state và timer. Xây deduplication, order timeout và fraud pattern. Theo dõi state growth.
Bước 5: Học checkpoint và recovery. Kill task, restore, tạo savepoint, đổi parallelism và kiểm tra output.
Bước 6: Học production operations. Kafka connector, schema registry, metrics, backpressure, state backend, Kubernetes, CI/CD và security.
Một project tốt xuyên suốt cả sáu bước có giá trị hơn nhiều project chỉ chạy happy path. Hãy giữ cùng domain đơn hàng và liên tục bổ sung yêu cầu. Người học sẽ thấy một pipeline đơn giản dần trở thành hệ thống production như thế nào.
32. Tổng kết
Apache Flink là một distributed processing engine dành cho stateful computation trên bounded và unbounded stream. Điểm mạnh của Flink không nằm ở một hàm API riêng lẻ mà ở cách runtime kết hợp parallel dataflow, managed state, event time, watermark, checkpoint và recovery.
Ở cấp cluster, JobManager điều phối và TaskManager thực thi. Task slot là đơn vị lập lịch tài nguyên nhưng không phải CPU isolation cứng. Parallelism quyết định số subtask; partitioning quyết định dữ liệu đi đâu; operator chaining giảm chi phí thực thi. State được phân vùng và snapshot. Watermark biểu diễn tiến độ Event Time. Checkpoint cho phép phục hồi nhất quán. End-to-end exactly-once chỉ đạt được khi source replay được và sink transactional hoặc idempotent.
Một kiến trúc Flink chuyên nghiệp phải trả lời được năm câu hỏi:
- Dữ liệu được phân vùng theo khóa nào?
- State nào được giữ và khi nào được dọn?
- Thời gian nghiệp vụ được xác định và xử lý trễ ra sao?
- Hệ thống phục hồi thế nào khi task, worker hoặc sink lỗi?
- Consumer downstream hiểu và áp dụng output theo semantics nào?
Nếu chưa trả lời được năm câu hỏi này, pipeline chưa sẵn sàng cho production dù demo đang chạy đúng.
33. Câu hỏi ôn tập
- Vì sao một Kafka consumer dùng
HashMapkhông tương đương managed state của Flink? - Bounded Stream và Unbounded Stream khác nhau ở những quyết định thiết kế nào?
- Kafka và Flink đảm nhiệm trách nhiệm gì trong cùng một kiến trúc?
- JobManager gồm những thành phần logic quan trọng nào?
- Vì sao task slot không nên được hiểu tuyệt đối là một CPU core?
- Slot sharing giúp giảm số slot cần thiết như thế nào?
keyByảnh hưởng network và state ra sao?- Khi nào operator chaining có lợi và khi nào cần cân nhắc tách chain?
- Keyed State khác Operator State ở điểm nào?
- Watermark giải quyết vấn đề gì và tại sao nó không bảo đảm stream hoàn toàn đầy đủ?
- Một Kafka partition idle có thể ảnh hưởng watermark như thế nào?
- Checkpoint barrier tạo snapshot nhất quán ra sao?
- Exactly-once state consistency khác end-to-end exactly-once như thế nào?
- Vì sao operator UID quan trọng khi restore savepoint?
- Backpressure là nguyên nhân gốc hay triệu chứng?
- Tại sao tăng parallelism không giải quyết được hot key?
- Sink append-only gặp vấn đề gì với late update?
- Những metric nào cần theo dõi cho một Flink Job production?
- Khi nào một giải pháp batch hoặc Kafka consumer đơn giản hợp lý hơn Flink?
- Bạn sẽ thiết kế fault-injection test nào cho pipeline đơn hàng?
34. Tài liệu tham khảo
- Apache Flink, Learn Flink: Overview: https://nightlies.apache.org/flink/flink-docs-stable/docs/learn-flink/overview/
- Apache Flink, Flink Architecture: https://nightlies.apache.org/flink/flink-docs-stable/docs/concepts/flink-architecture/
- Apache Flink, Data Pipelines and ETL: https://nightlies.apache.org/flink/flink-docs-stable/docs/learn-flink/etl/
- Apache Flink, Streaming Analytics and Watermarks: https://nightlies.apache.org/flink/flink-docs-stable/docs/learn-flink/streaming_analytics/
- Apache Flink, Event-driven Applications: https://nightlies.apache.org/flink/flink-docs-stable/docs/learn-flink/event_driven/
- Apache Flink, Fault Tolerance: https://nightlies.apache.org/flink/flink-docs-stable/docs/learn-flink/fault_tolerance/
- Apache Flink, DataStream API: https://nightlies.apache.org/flink/flink-docs-stable/docs/learn-flink/datastream_api/
- Apache Flink, Operations Documentation: https://nightlies.apache.org/flink/flink-docs-stable/docs/ops/
Lưu ý: API, artifact connector và cấu hình có thể thay đổi giữa các phiên bản Flink. Khi triển khai, cần đối chiếu tài liệu đúng phiên bản của cluster và connector đang sử dụng.