


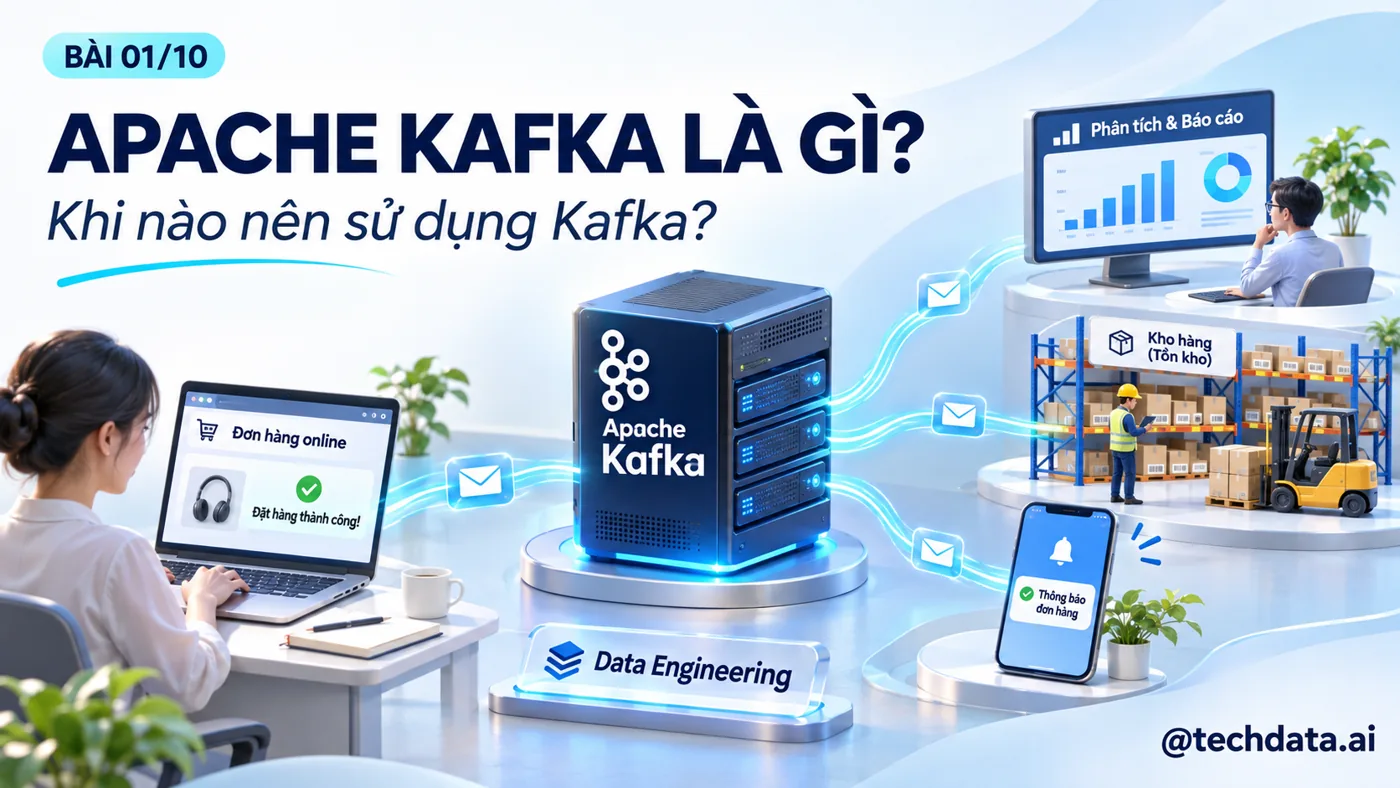

Apache Kafka: Từ cơ bản đến ứng dụng thực tế trong Data Engineering · Bài 1/10. Khi một khách đặt hàng, website cần lưu đơn, kho cần cập nhật số lượng, dashboard cần tính doanh thu, còn hệ thống chăm sóc khách hàng cần gửi xác nhận. Nếu mỗi hệ thống gọi trực tiếp tất cả hệ thống còn lại, kiến trúc nhanh chóng rối và khó chịu tải khi một thành phần chậm.
Kafka giúp các hệ thống trao đổi với nhau qua những sự kiện được lưu thành luồng. Nhưng Kafka không phải lựa chọn mặc định cho mọi ứng dụng. Bài này giúp bạn hiểu Kafka làm gì, phân biệt nó với API, database, RabbitMQ và batch, rồi dùng một bài lab Python nhỏ để chọn kiến trúc theo nhu cầu.
Mục lục
- Mục tiêu và kiến thức cần có
- Tình huống: đơn hàng vừa được tạo
- Kafka là gì?
- Kafka khác gì API, database, RabbitMQ và batch?
- Khi nào nên dùng Kafka?
- Khi nào chưa cần Kafka?
- Lab Python: chọn công cụ theo tình huống
- Chi phí và những hiểu lầm thường gặp
- Checklist trước khi quyết định
- Tổng kết và bài tập
- Tài liệu tham khảo
1. Mục tiêu và kiến thức cần có
Bạn không cần biết Kafka trước khi đọc. Sẽ có ích nếu bạn đã gặp API, database và quy trình xử lý dữ liệu theo lịch. Sau bài này, bạn có thể giải thích Kafka bằng lời của mình, nhận diện khi nào nó tạo giá trị, và tránh nhầm Kafka với một cơ sở dữ liệu hay một API nhanh hơn.
- Hiểu “sự kiện” khác với “trạng thái hiện tại” như thế nào.
- Nắm vai trò cơ bản của producer, broker, topic và consumer.
- So sánh Kafka với API, database, RabbitMQ và batch mà không gán công cụ nào là tốt nhất trong mọi trường hợp.
- Chạy bài lab Python để đánh giá một tình huống kiến trúc.
Series này dùng tình huống thương mại điện tử làm sợi dây xuyên suốt. Ở các bài sau, ta sẽ dựng Kafka bằng Docker Compose, viết producer/consumer bằng Python, hiểu partition và consumer group, rồi đưa dữ liệu đơn hàng vào PostgreSQL, analytics, CDC và Spark.
2. Tình huống: đơn hàng vừa được tạo
Giả sử website đã nhận thanh toán hoặc ghi nhận yêu cầu đặt hàng. Một cách làm trực tiếp là endpoint tạo đơn gọi lần lượt dịch vụ kho, email, phân tích doanh thu và kiểm tra gian lận. Nếu email chậm 8 giây, người mua cũng có thể phải chờ. Nếu dashboard đang bảo trì, luồng tạo đơn có thể thất bại dù phần cốt lõi vẫn hoạt động.
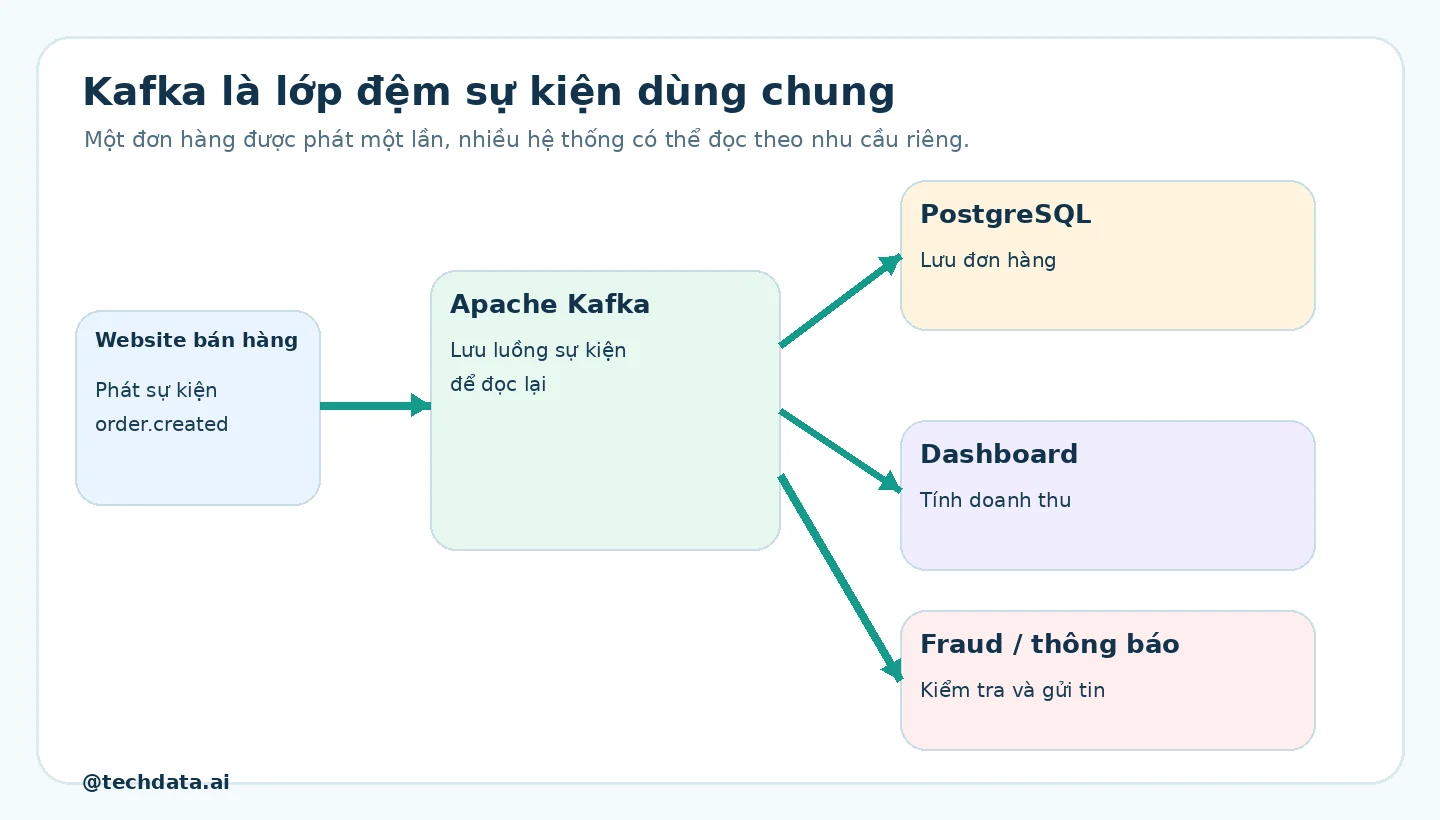
Có thể tách phần ghi nhận đơn khỏi các tác vụ phía sau. Sau khi đơn được chấp nhận, ứng dụng phát một sự kiện có ý nghĩa như order.created. Kafka lưu sự kiện trong một topic. Dịch vụ kho, dashboard, thông báo và chống gian lận có thể đọc cùng luồng theo tiến độ riêng. Producer không cần biết trước tất cả consumer nào sẽ xuất hiện sau này.
Ví dụ sự kiện minh họa:
{
  "event_id": "evt-2026-000184",
  "event_type": "order.created",
  "occurred_at": "2026-11-13T09:30:00+07:00",
  "order_id": "ORD-184",
  "customer_id": "CUS-42",
  "total_vnd": 850000,
  "items": [
    {"sku": "BOTTLE-01", "quantity": 1, "unit_price_vnd": 850000}
  ]
}
Đây là bản ghi minh họa để nói về cấu trúc, chưa phải hợp đồng dữ liệu production. Hệ thống thật cần thống nhất schema, đơn vị tiền, múi giờ, cách xử lý thông tin cá nhân, phiên bản sự kiện và quy tắc phát lại. Một sự kiện nên mô tả điều đã xảy ra: “đơn hàng được tạo”, thay vì chỉ gửi mệnh lệnh mơ hồ như “hãy làm gì đó”.
3. Kafka là gì?
Apache Kafka là một nền tảng phân tán để publish và subscribe các luồng sự kiện, lưu chúng bền vững trong một khoảng thời gian cấu hình được, và xử lý hoặc chuyển tiếp dữ liệu đang đến. Nói dễ hiểu: Kafka là một nhật ký sự kiện dùng chung, có thể nhận dữ liệu liên tục và cho nhiều ứng dụng đọc theo tốc độ riêng.
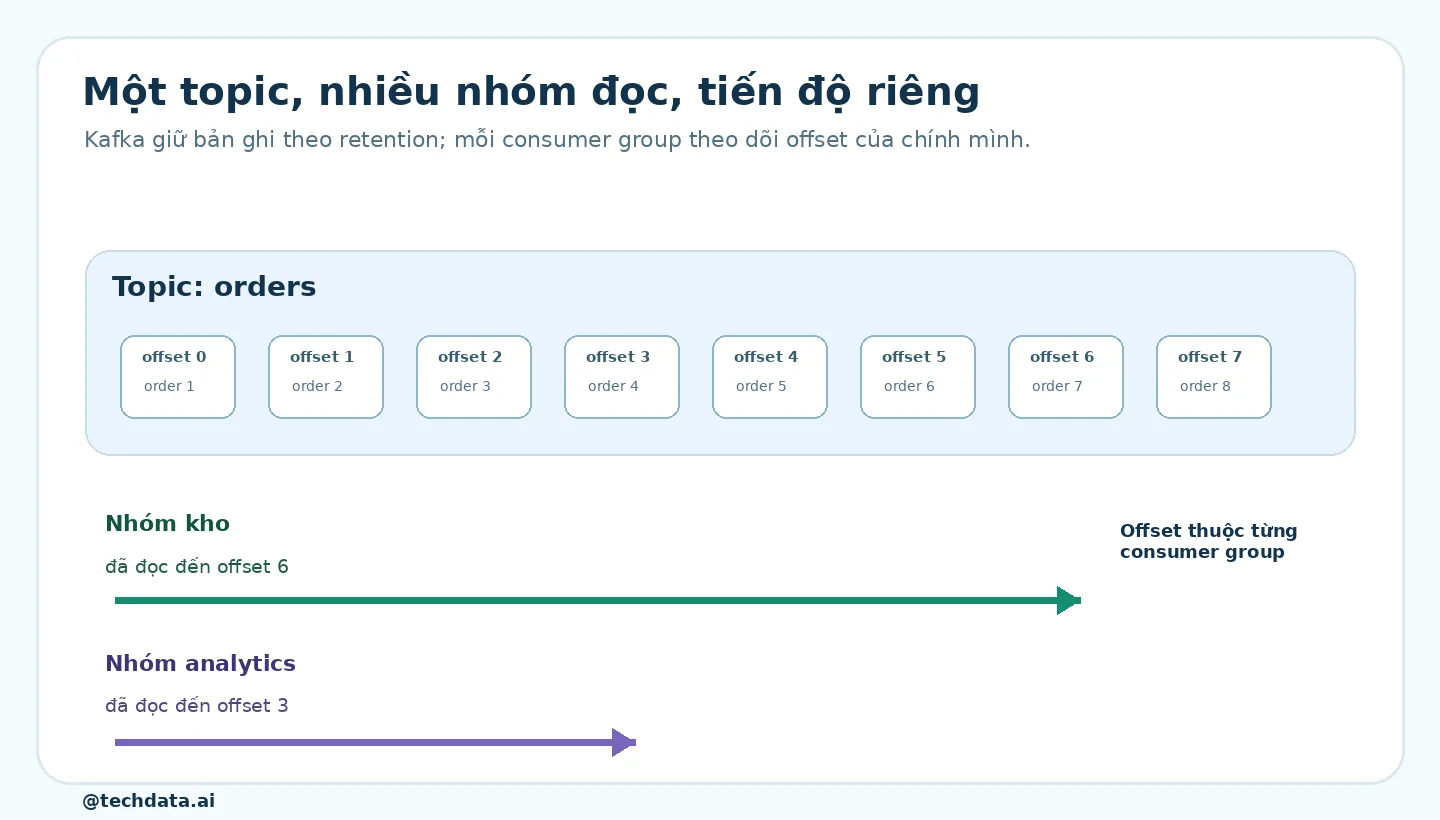
Hãy hình dung một cuốn sổ nhật ký điện tử rất lớn. Ứng dụng ghi thêm sự kiện ở cuối. Ứng dụng khác đọc cuốn sổ và tự nhớ mình đã đọc tới đâu. Một ứng dụng mới có thể bắt đầu đọc từ mốc phù hợp nếu dữ liệu vẫn còn được lưu. Kafka không tự quyết định nghiệp vụ của đơn hàng; nó cung cấp hạ tầng để ghi, giữ và phân phối luồng sự kiện.
| Thành phần | Nhiệm vụ | Ví dụ bán hàng |
|---|---|---|
| Producer | Ứng dụng gửi sự kiện | Backend phát order.created |
| Broker | Máy chủ Kafka nhận và lưu dữ liệu | Các broker giữ các phần của luồng |
| Topic | Tên luồng sự kiện có cùng chủ đề | orders |
| Consumer | Ứng dụng đọc và xử lý sự kiện | Kho, báo cáo, email |
| Consumer group | Một nhóm consumer phối hợp chia tải đọc | Ba worker xử lý topic orders |
| Offset | Vị trí của một bản ghi trong partition | Consumer biết đã đọc tới sự kiện nào |
Topic thường được chia thành partition. Trong mỗi partition, bản ghi có thứ tự và offset tăng dần. Với cách dùng key phù hợp, các sự kiện cùng một đơn hàng hoặc cùng một khách hàng có thể đi vào cùng partition để consumer xử lý theo thứ tự trong phạm vi đó. Bài 4 sẽ đào sâu cách chọn partition và giới hạn về thứ tự.
Kafka giữ bản ghi theo chính sách retention, chẳng hạn theo thời gian hoặc dung lượng. Vì vậy một sự kiện không mặc định biến mất ngay khi consumer đọc xong. Consumer group giữ offset riêng để có thể tiếp tục từ vị trí đã ghi nhận. Tuy nhiên Kafka không phải kho lưu trữ vô hạn: thiết kế retention, dung lượng đĩa, số bản sao, bảo mật và quy trình khôi phục đều cần được quản lý.
4. Kafka khác gì API, database, RabbitMQ và batch?
Điểm mấu chốt là mỗi công cụ giải quyết một kiểu câu hỏi. API trả lời “hãy thực hiện yêu cầu này và trả kết quả”. Database trả lời “trạng thái hiện tại là gì”. Kafka trả lời “những sự kiện nào đã xảy ra và ai cần đọc chúng”. Batch trả lời “hãy xử lý tập dữ liệu này theo lô”. RabbitMQ thường rất phù hợp cho hàng đợi công việc và phân phối tác vụ. Một hệ thống có thể kết hợp nhiều công cụ.
| Công cụ | Mô hình chính | Điểm mạnh | Không thay thế tốt cho |
|---|---|---|---|
| HTTP API | Request / response | Truy vấn hoặc thao tác cần phản hồi ngay | Luồng sự kiện có nhiều consumer, cần giữ và đọc lại lâu dài |
| Database | Lưu trạng thái hiện tại và truy vấn | Giao dịch, ràng buộc dữ liệu, truy vấn theo mô hình dữ liệu | Phân phối độc lập một luồng sự kiện đến nhiều ứng dụng |
| RabbitMQ | Broker định tuyến message và hàng đợi | Phân phối tác vụ, ack, routing và điều tiết consumer | Không phải lựa chọn thay thế trực tiếp cho mọi trường hợp; RabbitMQ cũng có stream |
| Batch (Airflow, Spark…) | Xử lý dữ liệu theo đợt hoặc lịch | Tính lại khối lượng lớn, ETL theo lịch, báo cáo định kỳ | Phản ứng liên tục ngay khi sự kiện mới đến |
| Kafka | Nhật ký sự kiện phân tán, đọc theo offset | Nhiều consumer độc lập, lưu luồng, mở rộng xử lý và phát lại trong thời gian retention | Không phải database nghiệp vụ hay API request/response đồng bộ |
4.1 Kafka và API
Nếu màn hình cần hỏi “đơn hàng ORD-184 đang ở trạng thái nào?” thì API đọc database thường phù hợp. Nếu một sự kiện tạo đơn cần được tiếp nhận một lần và xử lý bởi nhiều hệ thống độc lập, Kafka có thể làm lớp phân phối. Trong thực tế API có thể nhận yêu cầu, ghi đơn, sau đó phát sự kiện. Kafka bổ sung cho API thay vì loại bỏ API.
4.2 Kafka và database
Database tối ưu cho trạng thái và truy vấn hiện tại. Kafka giữ chuỗi sự kiện trong một khoảng retention để các hệ thống đọc. Một database có thể lưu đơn hàng hiện tại, trong khi Kafka chuyển sự kiện thay đổi tới kho dữ liệu hoặc dịch vụ thông báo. Đừng dùng topic thay cho database chỉ vì Kafka có lưu dữ liệu; topic không tự cung cấp đầy đủ trải nghiệm truy vấn nghiệp vụ, quan hệ, cập nhật tùy ý và ràng buộc như PostgreSQL.
4.3 Kafka và RabbitMQ
RabbitMQ thường được chọn khi cần đưa một công việc vào queue, định tuyến theo quy tắc, xác nhận đã xử lý (ack) và điều tiết lượng message gửi tới worker. Kafka phù hợp khi cần lưu luồng sự kiện để một hoặc nhiều nhóm ứng dụng đọc độc lập, mỗi nhóm theo offset riêng và có thể đọc lại nếu dữ liệu còn trong retention. Cách so sánh này là định hướng chứ không phải ranh giới tuyệt đối: RabbitMQ hỗ trợ stream, còn Kafka có thể được dùng trong kiến trúc xử lý tác vụ. Hãy chọn theo semantics, yêu cầu giao nhận, khả năng vận hành và hệ sinh thái hiện có.
4.4 Kafka và batch
Batch gom dữ liệu thành đợt, thường chạy theo lịch hoặc theo điều kiện. Nó hiệu quả khi độ trễ vài phút hoặc vài giờ chấp nhận được, ví dụ tổng hợp doanh thu mỗi đêm. Kafka và xử lý streaming phù hợp khi cần phản ứng thường xuyên hơn. Hai cách làm có thể cùng tồn tại: Kafka thu sự kiện liên tục; job batch đọc dữ liệu đã lưu để tính lại lịch sử hoặc đối soát.
5. Khi nào nên dùng Kafka?
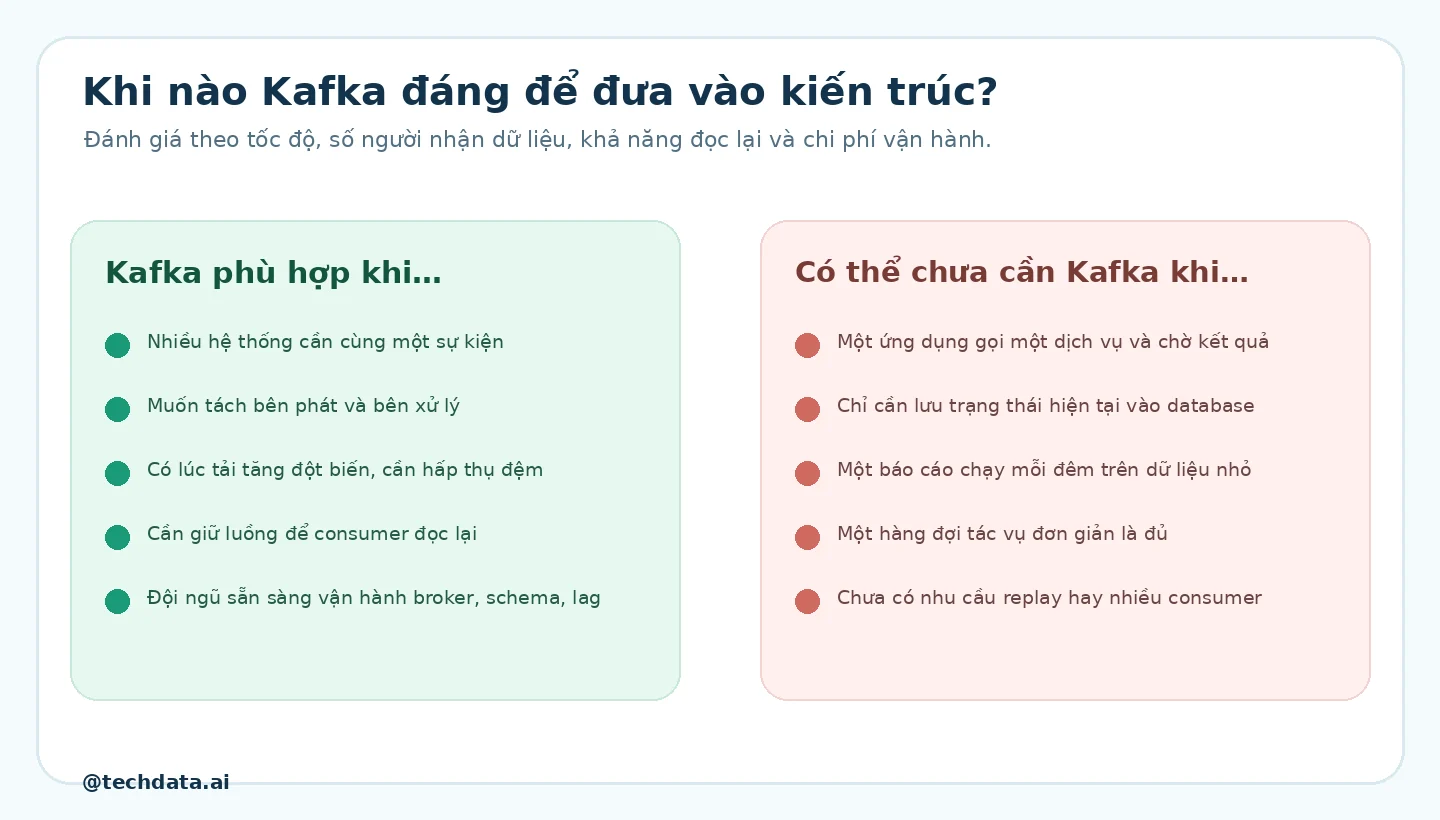
Kafka đáng cân nhắc khi có một hoặc nhiều nhu cầu sau:
- Một sự kiện có nhiều người nhận. Ví dụ đơn hàng mới vừa cần ghi sang hệ thống phân tích, vừa cần thông báo, đối soát và phát hiện gian lận.
- Muốn tách thời điểm phát và xử lý. Producer có thể gửi sự kiện mà không phải chờ từng consumer hoàn tất công việc.
- Tải đến không đều. Luồng dữ liệu có thể được lưu đệm để consumer xử lý theo năng lực; điều này không làm biến mất giới hạn dung lượng hay yêu cầu giám sát lag.
- Cần đọc lại dữ liệu. Có thể chạy lại consumer từ offset cũ khi còn dữ liệu và chính sách retention cho phép. Consumer cần thiết kế idempotent để không tạo tác dụng phụ trùng.
- Cần tích hợp dữ liệu liên tục. Kafka Connect và các connector có thể đưa dữ liệu vào/ra hệ thống khác, như database, object storage hoặc nền tảng phân tích.
Trong Data Engineering, Kafka thường đóng vai trò lớp ingest hoặc event backbone. Ví dụ: ứng dụng bán hàng phát sự kiện; Kafka lưu và phân phối; consumer làm sạch, bổ sung thuộc tính, ghi PostgreSQL hoặc warehouse; hệ thống dashboard đọc bảng đã chuẩn hóa. Kafka không tự thay thế mô hình dữ liệu, chất lượng dữ liệu hay công cụ BI.
6. Khi nào chưa cần Kafka?
- Website nhỏ chỉ cần API ghi vào PostgreSQL, lượng request vừa phải và không có nhiều hệ thống nhận sự kiện.
- Yêu cầu là đọc hoặc cập nhật trạng thái đơn hàng. Hãy bắt đầu từ database và API phù hợp.
- Chỉ chạy một báo cáo mỗi ngày trên vài bảng nhỏ. Một job batch có thể đơn giản hơn.
- Cần giao một tác vụ cho worker với routing, retry và ack rõ ràng nhưng chưa cần lưu stream hoặc replay; một broker queue nhẹ hơn có thể hợp lý.
- Đội ngũ chưa có năng lực vận hành cluster, theo dõi disk, partition, consumer lag, schema, bảo mật và backup. Một nền tảng mạnh nhưng vận hành sai tạo thêm rủi ro và chi phí.
Đưa Kafka vào chỉ vì muốn “real-time” không đảm bảo nghiệp vụ sẽ chính xác hoặc nhanh hơn. Độ trễ đầu cuối còn phụ thuộc vào ứng dụng, network, cấu hình producer, số partition, xử lý của consumer, database đích và cách đo.
7. Lab Python: chọn công cụ theo tình huống
Lab này không giả lập broker Kafka. Nó là một checklist có thể chạy ngay để buộc ta làm rõ yêu cầu trước khi chọn hạ tầng. Tạo tệp choose_architecture.py, dán đoạn mã dưới đây và chạy bằng Python 3.10 trở lên với lệnh python choose_architecture.py.
from dataclasses import dataclass


@dataclass
class Workload:
    name: str
    needs_immediate_reply: bool
    readers: int
    needs_replay: bool
    continuous_events: bool
    needs_task_ack: bool
    processing_can_wait_minutes: int


def recommend(workload: Workload) -> str:
    if workload.needs_immediate_reply:
        return "API + database: cần phản hồi đồng bộ cho người gọi."

    if workload.processing_can_wait_minutes >= 60 and not workload.continuous_events:
        return "Batch: gom dữ liệu và xử lý theo lịch có thể đơn giản hơn."

    if workload.needs_task_ack and workload.readers <= 2 and not workload.needs_replay:
        return "Queue broker: cân nhắc RabbitMQ hoặc dịch vụ hàng đợi được quản lý."

    if workload.readers > 1 or workload.needs_replay or workload.continuous_events:
        return "Kafka đáng để đánh giá: có luồng liên tục, nhiều nhóm đọc hoặc nhu cầu replay."

    return "Bắt đầu với API + database hoặc một queue đơn giản; đo nhu cầu trước khi thêm Kafka."


cases = [
    Workload("Tra cứu trạng thái đơn", True, 1, False, False, False, 0),
    Workload("Gửi báo cáo doanh thu lúc 2 giờ sáng", False, 1, False, False, False, 600),
    Workload("Gửi email xác nhận qua worker", False, 1, False, False, True, 5),
    Workload("Sự kiện đơn hàng cho kho, BI và chống gian lận", False, 3, True, True, False, 1),
]

for case in cases:
    print(f"{case.name}: {recommend(case)}")
7.1 Đọc kết quả
Case tra cứu cần phản hồi ngay nên bắt đầu với API và database. Báo cáo chạy vào ban đêm phù hợp với batch. Tác vụ gửi email cho một worker có thể hợp với queue. Luồng đơn hàng có nhiều nhóm độc lập và yêu cầu phát lại là ứng viên để đánh giá Kafka.
Đây là quy tắc gợi ý cho việc học, không phải bộ chọn kiến trúc tự động. Một ứng dụng có thể vừa dùng API vừa dùng queue hoặc Kafka. Hãy thêm các ràng buộc thật: sản lượng trung bình và đỉnh, thời gian trễ cho phép, yêu cầu bảo toàn thứ tự, hậu quả khi trùng/lost event, đội ngũ vận hành, chi phí cloud và dữ liệu nhạy cảm. Sau đó kiểm tra bằng thử nghiệm có đo đạc.
8. Chi phí và những hiểu lầm thường gặp
Kafka không tự làm mọi thứ real-time
Kafka có thể chuyển sự kiện liên tục với độ trễ thấp, nhưng không nên hứa thời gian phản hồi cứng như một hệ thống điều khiển thời gian thực. Consumer có thể chậm, database đích có thể quá tải, partition có thể lệch tải. Cần đo end-to-end latency và consumer lag.
Kafka không tự bảo đảm nghiệp vụ “chỉ xử lý đúng một lần”
Producer retry, consumer restart hoặc lỗi sau khi ghi database nhưng trước khi commit offset có thể khiến cùng một sự kiện được giao lại. Cần idempotency key, unique constraint, transaction phù hợp và quy trình xử lý lỗi. Các guarantee exactly-once có phạm vi cụ thể; chúng không tự động bao trùm side effect ở một hệ thống ngoài Kafka.
Kafka không xóa sự kiện sau mỗi lần đọc
Thông thường consumer tiến offset của mình, trong khi bản ghi tiếp tục được lưu theo retention. Điều đó khác với một queue truyền thống ở cách quản lý vòng đời message, nhưng cũng có nhiều cấu hình và semantics khác nhau. Đừng suy luận rằng đã đọc thì dữ liệu sẽ còn mãi: retention có giới hạn.
Kafka không phải một hộp đen “cài xong là chạy”
Production cần tính tới broker, partition, replication, controller, ACL/TLS, quota, schema compatibility, dung lượng đĩa, backup/restore và quy trình nâng cấp. Consumer group cần monitor lag; producer cần xử lý lỗi và serialization. Dịch vụ Kafka managed có thể giảm gánh vận hành nhưng vẫn cần thiết kế đúng.
9. Checklist trước khi quyết định
- Ai phát dữ liệu? Sự kiện nào có ý nghĩa với nghiệp vụ?
- Có bao nhiêu ứng dụng cần đọc? Mỗi ứng dụng cần dữ liệu gì?
- Consumer cần nhận trong bao lâu? Có thể chậm hoặc tạm dừng bao lâu?
- Có cần phát lại? Giữ dữ liệu bao lâu và dung lượng dự kiến là bao nhiêu?
- Yêu cầu thứ tự nằm ở phạm vi nào: toàn hệ thống, từng khách hàng hay từng đơn?
- Nếu xử lý lại một sự kiện, làm sao ngăn ghi trùng hoặc gửi thông báo trùng?
- Ai vận hành và cảnh báo khi broker, disk, network hoặc consumer có vấn đề?
Nếu chưa trả lời được, chưa cần bắt đầu bằng số lượng broker hay partition. Hãy chốt semantics và SLA trước; phần cấu hình có ý nghĩa khi ta biết hệ thống phải bảo vệ điều gì.
10. Tổng kết và bài tập
Kafka là nền tảng lưu và phân phối luồng sự kiện. Nó giúp tách producer khỏi nhiều consumer, hấp thụ dữ liệu liên tục và cho phép consumer đọc theo offset trong thời gian lưu dữ liệu. API, database, RabbitMQ và batch vẫn có vai trò riêng; Kafka có giá trị khi yêu cầu thực sự cần event stream, nhiều nhóm đọc hoặc replay và đội ngũ sẵn sàng vận hành.
Bài tập: chọn một quy trình bạn biết, chẳng hạn đặt lịch học, giao hàng hoặc thanh toán. Liệt kê trạng thái hiện tại cần đọc từ database; yêu cầu cần API trả lời ngay; sự kiện có thể phát; và tác vụ có thể chạy batch. Sau đó giải thích vì sao Kafka có hoặc chưa có ích. Đừng chỉ trả lời “vì cần real-time”.
Gợi ý đáp án: khi khách đặt khóa học, API có thể xác nhận chỗ học và database lưu đăng ký. Sự kiện enrollment.created có thể được Kafka phân phối cho email, báo cáo tuyển sinh và hệ thống chăm sóc học viên. Nếu cơ sở nhỏ chỉ gửi một email và cuối ngày xuất báo cáo Excel, Kafka có thể chưa đáng để vận hành.
Bài tiếp theo: cài Kafka bằng Docker Compose ở chế độ KRaft, tạo topic, gửi message bằng producer console và đọc bằng consumer console. Ta sẽ chuyển từ khái niệm sang broker thật trên máy local.
Tài liệu tham khảo
- Apache Kafka Documentation: Introduction — event streaming, producers, consumers, topics, partition, retention và replication.
- Apache Kafka 4.4: Getting Started — hướng dẫn nền tảng, quick start, KRaft và Docker.
- RabbitMQ Tutorials — queue, work queues, publish/subscribe, routing, RPC và streams.
- RabbitMQ: Consumer Acknowledgements and Publisher Confirms — xác nhận giao nhận và xử lý lại message.
- PostgreSQL Documentation: CREATE MATERIALIZED VIEW — ví dụ về truy vấn trạng thái/tổng hợp trong database và refresh theo nhu cầu.
Series Apache Kafka: Từ cơ bản đến ứng dụng thực tế trong Data Engineering · @techdata.ai