



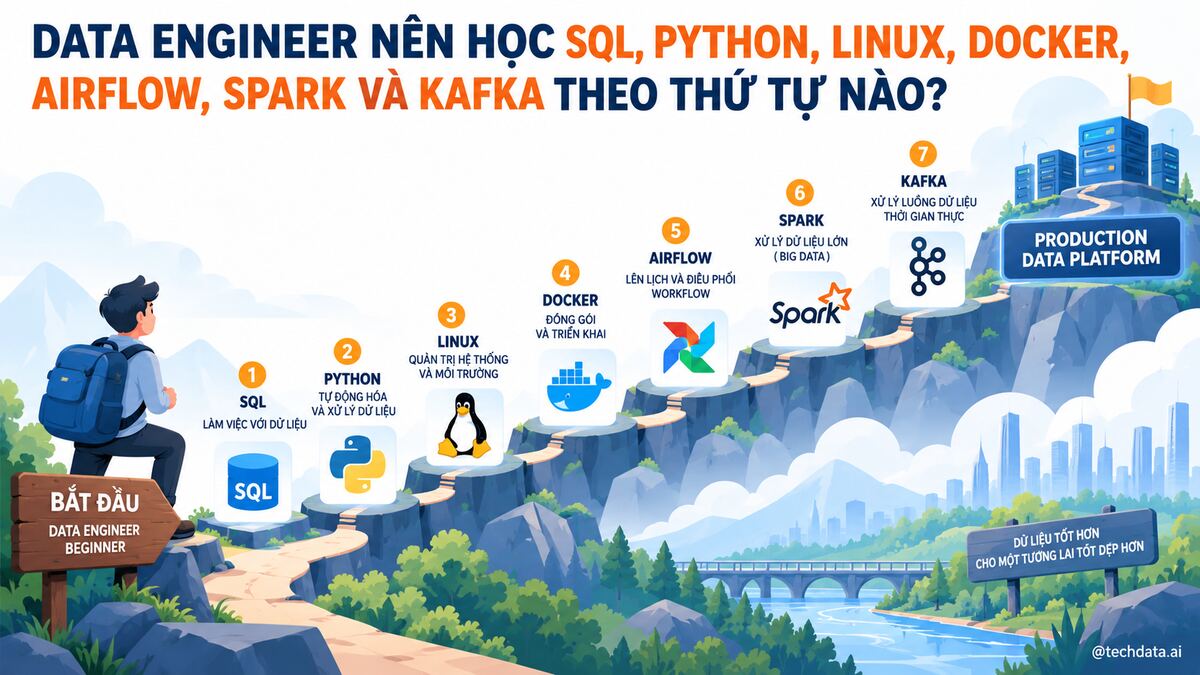

Data Engineer nên học SQL, Python, Linux, Docker, Airflow, Spark và Kafka theo thứ tự nào?
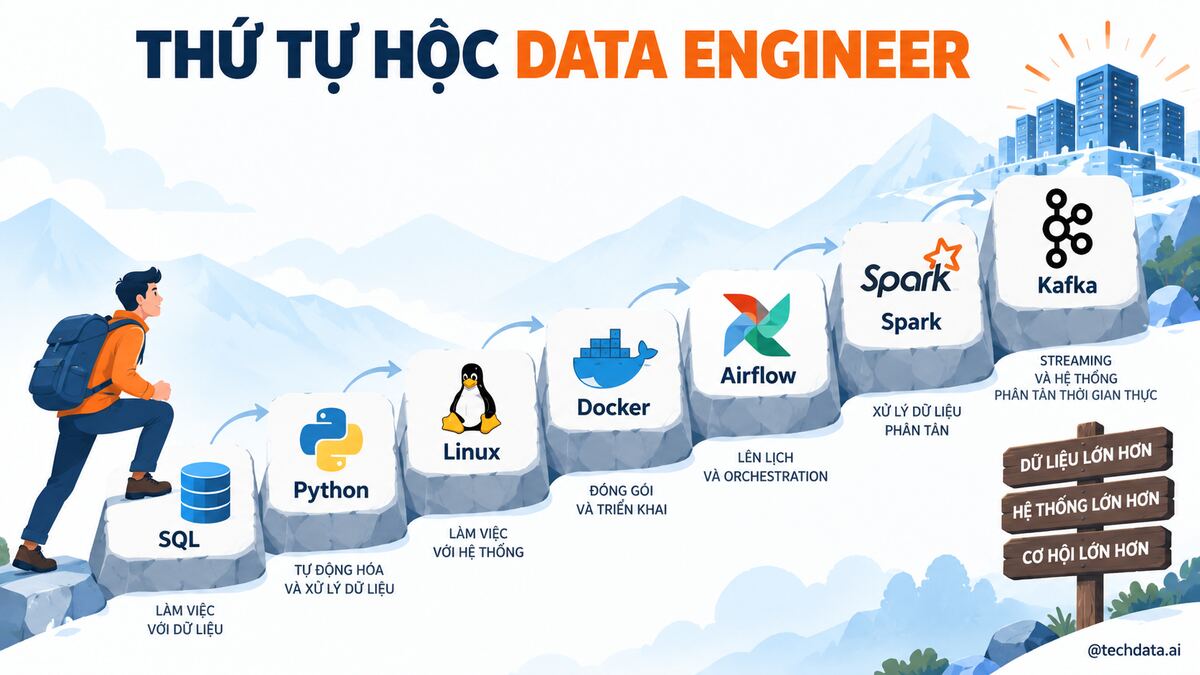
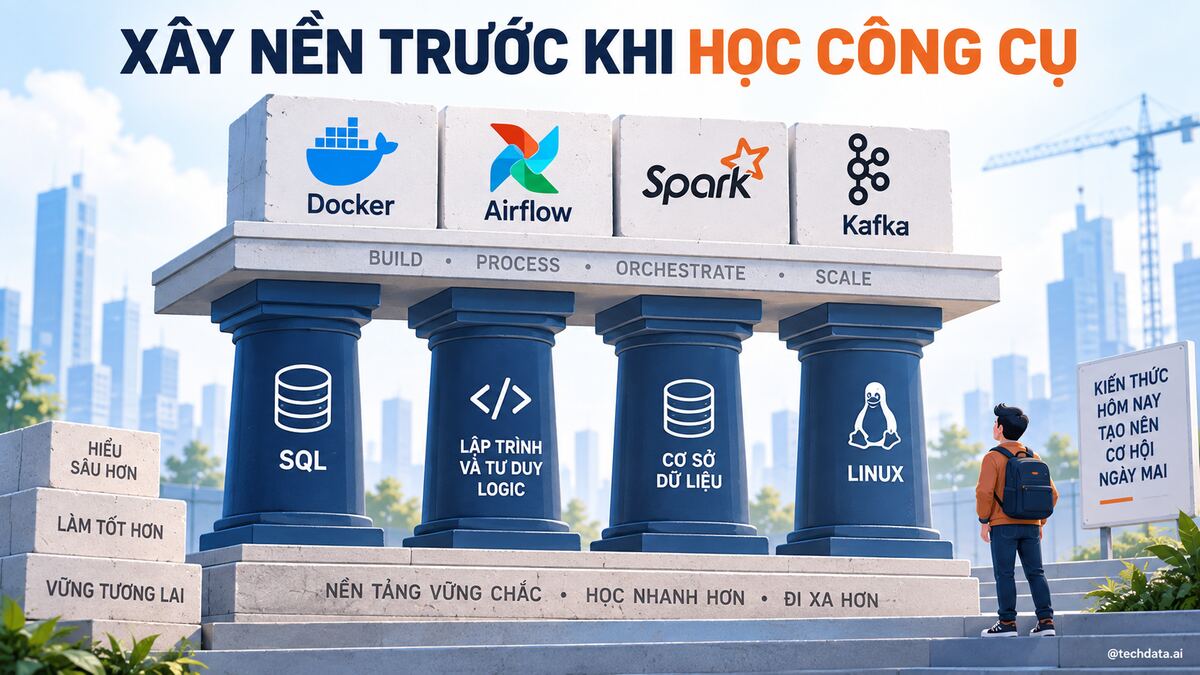
Thứ tự thực dụng cho đa số người mới là SQL, nền tảng dữ liệu và cơ sở dữ liệu; tiếp theo Python, Git và Linux; sau đó Data Warehouse, Docker và Airflow; cuối cùng mới học Spark, Kafka cùng một nền tảng Cloud theo nhu cầu. Đây không phải chuỗi cứng cho mọi người, nhưng nó giúp mỗi công nghệ dựa trên kiến thức đã có thay vì trở thành một môn rời rạc.
SQL được đặt trước vì Data Engineer làm việc trực tiếp với bảng, khóa và phép biến đổi. Python giúp tự động hóa và kết nối hệ thống. Linux là môi trường vận hành phổ biến; Docker đóng gói môi trường; Airflow điều phối pipeline. Spark xử lý dữ liệu phân tán, còn Kafka truyền sự kiện liên tục. Nếu học Spark và Kafka quá sớm, người mới dễ thuộc lệnh nhưng không hiểu vấn đề chúng giải quyết.
Cloud nên được học song song từ giai đoạn giữa, sau khi đã có một pipeline nhỏ trên máy cá nhân. Đưa một hệ thống chưa hiểu lên Cloud chỉ làm tăng số màn hình, quyền và chi phí phải xử lý. Nền tảng tốt giúp người học nhìn dịch vụ Cloud như phiên bản được quản lý của các khái niệm quen thuộc.
Bài viết giải thích vai trò, mức cần đạt và sản phẩm đầu ra của từng công nghệ. Mục tiêu không phải biết càng nhiều càng tốt, mà xây được một hệ thống dữ liệu hoàn chỉnh và có khả năng học công cụ mới khi công việc yêu cầu.
Mục lục
- PHẦN I — Vì sao thứ tự học quan trọng?
- PHẦN II — Giai đoạn 1: SQL và cơ sở dữ liệu
- PHẦN III — Giai đoạn 2: Python, Git và Linux
- PHẦN IV — Giai đoạn 3: Data Warehouse và mô hình dữ liệu
- PHẦN V — Giai đoạn 4: Docker và Airflow
- PHẦN VI — Giai đoạn 5: Cloud
- PHẦN VII — Giai đoạn 6: Spark và Kafka
- PHẦN VIII — Ba thứ tự theo nền tảng xuất phát
- PHẦN IX — Dự án xuyên suốt
- PHẦN X — AI hỗ trợ học công nghệ
- Câu hỏi thường gặp
- Kết luận
PHẦN I — VÌ SAO THỨ TỰ HỌC QUAN TRỌNG?
1. Công nghệ trong Data Engineering phụ thuộc nhau
Airflow điều phối chương trình Python và truy vấn SQL; Docker đóng gói chúng; Cloud cung cấp nơi lưu, chạy và giám sát. Spark vẫn dùng tư duy biến đổi bảng; Kafka vẫn cần chương trình đọc, ghi và xử lý. Học phần sau khi phần trước chưa chắc làm lỗi khó chẩn đoán.
Ví dụ, một DAG Airflow thất bại có thể do Python, đường dẫn Linux, quyền file, kết nối cơ sở dữ liệu hoặc SQL. DAG là sơ đồ các công việc và quan hệ phụ thuộc. Nếu không hiểu các lớp dưới, người học chỉ thử cấu hình ngẫu nhiên.
2. Thứ tự tốt giảm tải nhận thức
Người mới chỉ nên xử lý một vài khái niệm mới cùng lúc. SQL với PostgreSQL đã đủ để học bảng, khóa và truy vấn. Thêm Docker, Cloud và Kafka ngay tuần đầu làm cùng một lỗi xuất hiện qua quá nhiều lớp.
Giảm tải không có nghĩa học từng công nghệ tới mức chuyên gia. Cần đạt ngưỡng sử dụng rồi kết nối sang phần tiếp. Kiến thức sẽ sâu dần qua dự án.
3. Học theo vấn đề thay vì theo logo
Mỗi công nghệ phải trả lời một câu hỏi: SQL biến đổi dữ liệu nào, Python tự động hóa bước gì, Docker giải quyết khác biệt môi trường ra sao, Airflow quản lý lịch nào, Spark cần vì quy mô gì, Kafka cần vì độ trễ nào. Không có vấn đề thì chưa cần thêm công cụ.
Danh sách công nghệ trên CV không tạo giá trị nếu ứng viên không giải thích được lựa chọn. Một hệ thống nhỏ có lý do rõ tốt hơn kiến trúc lớn được sao chép.
4. Một số phần cần học song song
Git nên bắt đầu cùng Python; Linux được dùng dần từ khi chạy chương trình; Data Quality xuất hiện từ SQL; Cloud được thử sau pipeline đầu tiên. Thứ tự là trọng tâm theo giai đoạn, không phải cấm chạm vào phần sau.
Người học có thể xem tổng quan Spark và Kafka sớm để hiểu bản đồ. Việc đi sâu, xây dự án và đưa vào CV nên đến sau nền tảng.
PHẦN II — GIAI ĐOẠN 1: SQL VÀ CƠ SỞ DỮ LIỆU
5. Vì sao SQL đứng đầu?
SQL là ngôn ngữ truy vấn dữ liệu trong cơ sở dữ liệu. Data Engineer dùng SQL để kiểm tra nguồn, biến đổi, đối soát và xây bảng phục vụ phân tích. Ngay cả khi dùng Spark, tư duy thao tác trên bảng vẫn rất gần SQL.
SQL cũng buộc người học hiểu một dòng đại diện cho điều gì. Đây là nền tảng cho mọi pipeline. Mã Python tốt không cứu được phép nối sai mức chi tiết.
6. SQL cơ bản cần đạt mức nào?
Cần SELECT, WHERE, ORDER BY, GROUP BY, HAVING, CASE và JOIN. JOIN nối các bảng theo trường liên quan. Người học phải phân biệt quan hệ một–một, một–nhiều và nhiều–nhiều.
Không chỉ giải câu đố cú pháp. Hãy dùng dữ liệu đơn hàng, sản phẩm và hoàn trả, rồi kiểm tra tổng trước–sau. Cố tình tạo khóa trùng để thấy doanh thu bị nhân.
7. SQL trung cấp
Học Common Table Expression, truy vấn con, hàm ngày và window function. Common Table Expression đặt tên cho kết quả trung gian; window function tính trên một vùng dòng nhưng vẫn giữ chi tiết. Chúng hữu ích cho lũy kế, xếp hạng và lịch sử.
Học đọc kế hoạch thực thi ở mức cơ bản. Biết truy vấn quét dữ liệu nào, dùng chỉ mục hay không và bước nào tốn thời gian. Chưa cần tối ưu hệ thống cực lớn.
8. Cơ sở dữ liệu cần học cùng SQL
PostgreSQL là lựa chọn phù hợp. Học kiểu dữ liệu, khóa, ràng buộc, chỉ mục, view và transaction. Transaction giúp một nhóm thay đổi hoàn thành toàn bộ hoặc được hủy khi lỗi.
Thực hành tạo người dùng, quyền đọc–ghi và sao lưu đơn giản. Data Engineer không chỉ đọc bảng có sẵn. Hiểu lưu trữ giúp thiết kế nạp dữ liệu an toàn.
9. Mốc hoàn thành giai đoạn 1
Tự thiết kế cơ sở dữ liệu bán lẻ sáu bảng, nạp dữ liệu và viết 25 truy vấn. Mỗi truy vấn có câu hỏi, kết quả và kiểm tra. Có tài liệu mô tả mức chi tiết cùng khóa.
Nếu thay bộ dữ liệu mà vẫn giải quyết được, người học đã sẵn sàng đi tiếp. Nếu chỉ nhớ đáp án, cần thêm bài tập.
PHẦN III — GIAI ĐOẠN 2: PYTHON, GIT VÀ LINUX
10. Python đứng sau SQL vì sao?
Python tự động hóa việc lấy, kiểm tra và chuyển dữ liệu giữa hệ thống. Khi đã hiểu bảng, người học biết chương trình cần tạo đầu ra gì. Họ tránh biến mọi xử lý thành vòng lặp không cần thiết.
Cần biến, điều kiện, vòng lặp, hàm, module, cấu trúc dữ liệu và ngoại lệ. Sau đó tập trung file, API, cơ sở dữ liệu, log và test. API là giao diện giúp hệ thống trao đổi dữ liệu.
11. Python đủ dùng cho Data Engineer
Một chương trình tốt đọc cấu hình, gọi API có phân trang, thử lại khi lỗi tạm thời, lưu bản gốc và nạp cơ sở dữ liệu. Nó ghi log về thời gian, số dòng và lỗi. Mật khẩu không nằm trong mã.
Không cần học Machine Learning trước. Machine Learning là phương pháp để máy học quy luật từ dữ liệu; nó không phải nền tảng bắt buộc cho pipeline đầu tiên.
12. Git nên học ngay khi viết mã
Git lưu lịch sử thay đổi. Học repository, commit, branch và pull request. Pull request là đề nghị đưa một nhóm thay đổi vào nhánh chính để được kiểm tra.
Commit nhỏ và có mô tả giúp quay lại khi lỗi. Tách mã, cấu hình, test và tài liệu. Không chờ dự án hoàn thành mới tải một lần lên GitHub.
13. Linux học theo nhu cầu vận hành
Linux phổ biến trên máy chủ. Cần quản lý file, quyền, tiến trình, biến môi trường, đường dẫn, dung lượng và lịch chạy. Học đọc log và mã thoát.
Chạy chương trình Python bằng dòng lệnh và cấu hình qua biến môi trường. Khi lỗi, phân biệt đường dẫn, quyền và thư viện. Đây là kỹ năng thực tế hơn học thuộc nhiều lệnh hiếm dùng.
14. Mốc hoàn thành giai đoạn 2
Xây chương trình lấy dữ liệu từ API, lưu JSON theo ngày và nạp PostgreSQL. Chương trình chạy lại không trùng, có log và ít nhất năm test. Viết hướng dẫn chạy trên Linux.
Một người khác phải có thể tải repository và chạy theo README. README là trang giới thiệu cùng hướng dẫn của dự án. Nếu chỉ tác giả chạy được, sản phẩm chưa hoàn chỉnh.
PHẦN IV — GIAI ĐOẠN 3: DATA WAREHOUSE VÀ MÔ HÌNH DỮ LIỆU
15. Vì sao học Data Warehouse trước Airflow?
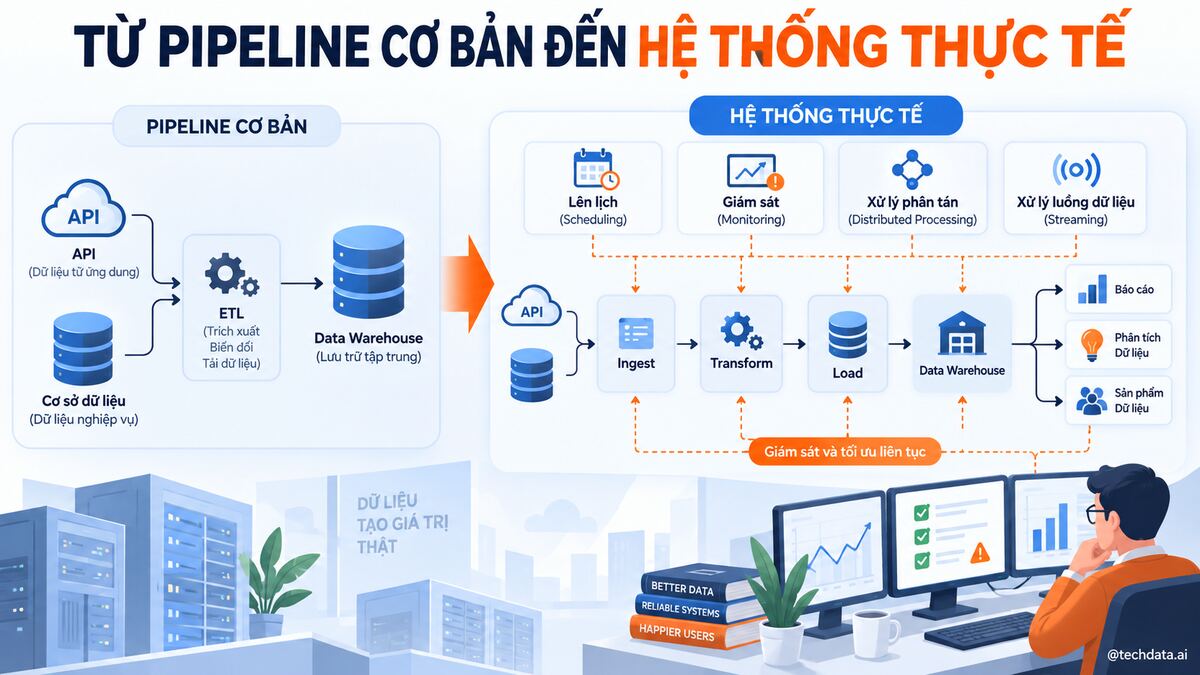
Airflow chỉ điều phối công việc; nó không xác định bảng đích nên được thiết kế thế nào. Data Warehouse là kho dữ liệu cho báo cáo và phân tích. Người học cần biết pipeline đang tạo sản phẩm gì trước khi tự động hóa lịch.
Học ETL và ELT. ETL biến đổi trước khi tải; ELT tải trước rồi biến đổi ở đích. Hai cách có thể cùng dùng tùy độ nhạy, độ tươi và khả năng tái xử lý.
16. Mô hình sao
Mô hình sao gồm fact và dimension. Fact chứa sự kiện đo lường như một sản phẩm trong đơn; dimension chứa mô tả như khách hàng, sản phẩm, cửa hàng và ngày. Mức chi tiết phải được ghi rõ.
Học xử lý dimension thay đổi theo thời gian. Khách đổi vùng có thể ghi đè hoặc tạo phiên bản mới tùy nhu cầu lịch sử. Không có một cách đúng cho mọi báo cáo.
17. Data Quality và dbt
Data Quality là mức dữ liệu đúng, đủ, nhất quán, cập nhật và phù hợp. Test kiểm tra cấu trúc, khóa, giá trị rỗng, phạm vi, số dòng và tổng nghiệp vụ. Đối soát cần nguồn chuẩn.
dbt giúp quản lý biến đổi SQL, test và tài liệu. Nó không bắt buộc, nhưng là cách tốt để học mô hình như một dự án phần mềm. Logic được chia lớp staging, intermediate và mart.
18. Mốc hoàn thành giai đoạn 3
Xây Data Warehouse từ API và file. Tạo vùng bản gốc, lớp chuẩn hóa, fact, dimension và mart. Mart là nhóm bảng cho một nhu cầu như bán hàng.
Thêm test, tài liệu và đối soát. Dashboard đơn giản chứng minh dữ liệu dùng được, nhưng không chiếm phần lớn thời gian. Sản phẩm chính là nền tảng.
PHẦN V — GIAI ĐOẠN 4: DOCKER VÀ AIRFLOW
19. Docker học trước Airflow
Docker đóng gói ứng dụng và thư viện vào container để chạy nhất quán. Học image, container, volume, network, Dockerfile và Docker Compose. Khi môi trường ổn định, việc chạy Airflow cùng cơ sở dữ liệu dễ kiểm soát hơn.
Container không phải máy ảo đầy đủ. Dữ liệu cần giữ phải nằm ở volume hoặc dịch vụ ngoài. Người học phải biết xem log và dừng tài nguyên.
20. Airflow điều phối, không xử lý thay
Airflow quản lý lịch và quan hệ phụ thuộc giữa task. Nó gọi chương trình Python hoặc SQL đã được thiết kế tốt. Không nên viết toàn bộ logic trong một task khổng lồ.
Cần DAG, task, retry, timeout, backfill và tham số ngày. Retry là thử lại có giới hạn; backfill là chạy cho khoảng lịch sử. Pipeline không nên luôn dùng “hôm nay”.
21. Xử lý dữ liệu đến muộn và chạy lại
Đơn hàng có thể được sửa sau ba ngày; hoàn trả xuất hiện sau giao dịch gốc. Pipeline chỉ đọc phần mới theo thời điểm tạo sẽ bỏ thay đổi. Cần khoảng nhìn lại, checkpoint hoặc Change Data Capture.
Change Data Capture ghi nhận phần dữ liệu thay đổi. Dù dùng cách nào, chạy lại phải không tạo trùng. Đây là tính idempotency, tức cùng đầu vào chạy lại vẫn cho kết quả đúng.
22. Quan sát và xử lý sự cố
Theo dõi thời gian chạy, số dòng, độ tươi, lỗi và chi phí. Job màu xanh vẫn có thể tạo dữ liệu thiếu. Cảnh báo cần tên pipeline, bước lỗi, thời gian và liên kết log.
Viết runbook, tức hướng dẫn xử lý sự cố lặp lại. Mô phỏng nguồn không phản hồi, cột đổi và task dừng. Dự án mạnh khi phục hồi được, không chỉ chạy lần đầu.
23. Mốc hoàn thành giai đoạn 4
Docker Compose dựng PostgreSQL, Airflow và dự án. DAG chạy lấy dữ liệu, kiểm tra, nạp, biến đổi và đối soát. Mỗi bước có log và cách chạy lại.
Tài liệu nêu cấu trúc, lệnh, lỗi thường gặp và cách xóa môi trường. Người khác có thể thử mà không cần cài từng phần thủ công.
PHẦN VI — GIAI ĐOẠN 5: CLOUD
24. Cloud nên học ở thời điểm nào?
Sau khi pipeline nhỏ chạy trên máy cá nhân, chuyển một phần lên AWS, Google Cloud hoặc Azure. Người học đã có khái niệm để so dịch vụ. Không cần đợi biết Docker và Airflow hoàn hảo.
Chọn một Cloud theo thị trường, công ty hoặc chương trình. Đừng học ba Cloud cùng lúc. Nguyên tắc có thể chuyển đổi.
25. Những phần Cloud cốt lõi
Cần lưu trữ file, tính toán, Data Warehouse, IAM, log và chi phí. IAM quản lý danh tính cùng quyền. Nguyên tắc quyền tối thiểu chỉ cấp đủ cho nhiệm vụ.
Học mã hóa, quản lý bí mật, vùng tài nguyên và trách nhiệm chia sẻ. Nhà cung cấp bảo vệ hạ tầng; người dùng vẫn chịu trách nhiệm cấu hình và dữ liệu.
26. Mốc hoàn thành Cloud
Lưu dữ liệu thô trên dịch vụ lưu trữ file, tạo mart trong Data Warehouse Cloud và chạy pipeline theo lịch. Cấu hình tài khoản riêng cho pipeline, không dùng quyền quản trị. Đặt cảnh báo ngân sách.
Tài liệu nêu chi phí ước tính và cách xóa tài nguyên. Dự án Cloud không hoàn chỉnh nếu người học không biết dịch vụ nào đang tính phí.
PHẦN VII — GIAI ĐOẠN 6: SPARK VÀ KAFKA
27. Spark học sau SQL và Python
Apache Spark xử lý dữ liệu phân tán trên nhiều tài nguyên. Tư duy bảng và biến đổi từ SQL giúp học DataFrame, tức cấu trúc dữ liệu dạng bảng. Python giúp viết và kiểm tra chương trình.
Cần hiểu thực thi lười, cách chia dữ liệu, phân phối lại và lỗi lệch tải. Dùng Spark khi quy mô hoặc nền tảng yêu cầu, không chỉ để thêm vào CV.
28. Kafka học sau pipeline theo lô
Apache Kafka truyền và lưu sự kiện liên tục. Producer gửi, consumer đọc, topic là luồng được đặt tên và partition chia tải. Người học cần hiểu vị trí đã đọc, nhóm consumer, sự kiện trùng và sai thứ tự.
Pipeline theo lô giúp hiểu nguồn, đích, chạy lại và chất lượng trước. Streaming thêm thời gian và trạng thái nên khó hơn. Streaming là xử lý dữ liệu liên tục hoặc gần liên tục.
29. Nên học Spark hay Kafka trước?
Nếu mục tiêu xử lý file lớn và Data Lakehouse, Spark có thể trước. Nếu công ty dùng sự kiện và tích hợp thời gian gần thực, Kafka có thể trước. Không có thứ tự chung sau nền tảng.
Nhiều vị trí Junior không yêu cầu sâu cả hai. Học nguyên tắc và một demo, sau đó đi sâu theo tin tuyển dụng. Không trì hoãn ứng tuyển vì danh sách vô tận.
30. Mốc hoàn thành giai đoạn 6
Với Spark, xử lý một bộ dữ liệu đủ lớn, đo tác động của chia dữ liệu và phân phối lại. So với SQL hoặc Python để giải thích lý do. Với Kafka, mô phỏng đơn hàng, consumer dừng và đọc lại.
Tài liệu phải nêu điều gì chưa giống vận hành thật. Không phóng đại bản mô phỏng cá nhân thành hệ thống Big Data đang phục vụ người dùng thật.
PHẦN VIII — BA THỨ TỰ THEO NỀN TẢNG XUẤT PHÁT
31. Người hoàn toàn mới
SQL và cơ sở dữ liệu; Python, Git, Linux; Data Warehouse; Docker, Airflow; Cloud; cuối cùng Spark hoặc Kafka. Mỗi giai đoạn khoảng hai đến ba tháng tùy thời gian. Tổng khung thường 12–18 tháng.
Không cắt nền tảng để chạy theo công nghệ. Một dự án xuyên suốt giúp kiến thức kết nối. Học chậm hơn kế hoạch nhưng tự giải thích được vẫn tốt.
32. Data Analyst chuyển hướng
Ôn SQL nâng cao và cơ sở dữ liệu; học Python, Linux, Git; tập trung pipeline, Docker, Airflow và Cloud. Data Warehouse có thể học nhanh hơn nhờ mô hình phân tích. Spark hoặc Kafka theo vị trí.
Dự án cần nhấn vận hành, không làm thêm dashboard. Thêm log, test, quyền, chạy lại và chi phí. Khung có thể 6–12 tháng.
33. Software Engineer chuyển hướng
Học SQL phân tích, mô hình dữ liệu và Data Warehouse trước; sau đó pipeline, Airflow, Cloud và chất lượng. Python, Git, Linux hoặc Docker có thể đã vững. Spark/Kafka được học theo hệ thống mục tiêu.
Khoảng trống thường là dữ liệu lịch sử và nghiệp vụ. Mã tốt nhưng fact sai mức chi tiết vẫn gây lỗi. Khung có thể 4–9 tháng.
PHẦN IX — DỰ ÁN XUYÊN SUỐT
34. Tháng đầu: cơ sở dữ liệu bán lẻ
Tạo khách hàng, sản phẩm, đơn hàng, chi tiết và hoàn trả. SQL trả lời doanh thu, khách quay lại và hàng hoàn. Test khóa cùng tổng.
Git lưu lịch sử. README mô tả mức chi tiết. Đây là nền móng cho mọi bước sau.
35. Thêm Python và Linux
Python lấy đơn từ API, đọc file sàn và nạp PostgreSQL. Log ghi số dòng; chạy lại không trùng. Linux chạy chương trình theo cấu hình.
Mô phỏng API lỗi và trường thiếu. Viết test. Không chuyển lên Cloud khi bước này chưa ổn.
36. Thêm Data Warehouse, Docker và Airflow
Tạo vùng bản gốc, staging, fact, dimension và mart. Docker đóng gói; Airflow điều phối. Mô phỏng dữ liệu đến muộn và backfill.
Đối soát doanh thu với nguồn. Viết runbook. Dự án trở thành hệ thống nhỏ có thể vận hành.
37. Thêm Cloud và phần mở rộng
Đưa bản gốc lên lưu trữ Cloud, mart vào Data Warehouse và cấu hình IAM. Chọn Spark cho xử lý lớn hoặc Kafka cho sự kiện, không bắt buộc cả hai.
Theo dõi chi phí và quyền. Tài liệu giải thích tại sao thêm dịch vụ. Đây là mạch Portfolio có logic.
PHẦN X — AI HỖ TRỢ HỌC CÔNG NGHỆ
38. AI Assistant giúp giải thích và rà lỗi
AI có thể giải thích cú pháp, tạo ví dụ, rà SQL và đề xuất test. Người học phải chạy lại, đọc tài liệu và kiểm tra dữ liệu. Không sao chép dự án hoàn chỉnh.
Hãy yêu cầu AI chỉ ra giả định và trường hợp biên. Câu trả lời trôi chảy chưa chắc đúng. Kỹ năng kiểm chứng quan trọng hơn tốc độ tạo mã.
39. AI Agent có thể chạy nhiều bước
AI Agent có thể chạy test, đọc log và nhóm lỗi nếu được cấp công cụ. Khác chatbot, Agent có thể tạo thay đổi. Quyền phải giới hạn.
Xóa dữ liệu, thay hạ tầng hoặc phát sinh chi phí cần Human Approval, tức phê duyệt của con người. Nhật ký phải lưu hành động.
40. AI không thay thứ tự nền tảng
AI làm Airflow hay Kafka dễ demo, nhưng người học vẫn cần SQL, Python và hệ thống để hiểu lỗi. Bỏ qua nền tảng chỉ chuyển sự phụ thuộc từ video sang chatbot.
Mục tiêu là dùng AI để tăng vòng phản hồi. Người học vẫn tự thiết kế, kiểm tra và giải thích.
CÂU HỎI THƯỜNG GẶP
41. Có nên học Python trước SQL?
Nếu hoàn toàn mới, SQL trước thường tạo bối cảnh dữ liệu nhanh. Có thể học Python song song sau vài tuần. Lập trình viên đã biết Python nên tập trung SQL trước.
42. Có cần học Linux trước Docker?
Cần Linux cơ bản trước hoặc song song. Docker dùng nhiều khái niệm file, quyền, tiến trình và mạng. Không cần thành quản trị viên hệ thống.
43. Có cần Kubernetes trước Airflow?
Không cho lộ trình đầu vào. Có thể chạy Airflow bằng Docker Compose. Kubernetes chỉ cần khi hệ thống và vị trí mục tiêu yêu cầu.
44. Spark và Kafka có bắt buộc không?
Không phải mọi vị trí Junior đều yêu cầu sâu. Nền tảng SQL, Python, pipeline, Data Warehouse và Cloud quan trọng hơn. Học theo thị trường mục tiêu.
45. Học theo chương trình nào?
Khóa học Data Engineer tại TechData.AI kết nối SQL, Python, Data Warehouse, Cloud và Big Data theo dự án. Người học nên xem đầu vào, lịch và chính sách hiện hành.
KẾT LUẬN
Thứ tự phù hợp cho đa số người mới là SQL và cơ sở dữ liệu; Python, Git và Linux; Data Warehouse; Docker và Airflow; Cloud; rồi Spark hoặc Kafka. Mỗi bước tạo đầu ra cho bước sau, không phải danh sách môn độc lập.
Người có nền tảng khác nhau có thể rút ngắn hoặc đổi trọng tâm, nhưng không nên bỏ qua tư duy dữ liệu, kiểm thử và vận hành. AI giúp học nhanh hơn, không thay nền móng.
Câu hỏi trước mỗi công nghệ mới là: vấn đề nào trong dự án hiện tại chưa giải quyết được bằng công cụ đang có? Khi câu trả lời rõ, thứ tự học sẽ dựa trên nhu cầu thay vì xu hướng.
Tài liệu tham khảo
- PostgreSQL Tutorial
- Python Tutorial
- The Linux Foundation — Introduction to Linux
- Docker Get Started
- Apache Airflow Documentation
- Apache Spark Documentation
- Apache Kafka Documentation
- Google Cloud — Professional Data Engineer
- AWS Certified Data Engineer – Associate
- Microsoft Fabric Data Engineer Associate
TechData.AI - Leading the Future.
Tham khảo khoá học theo link: https://techdata.ai/data-engineer/
Hoàng Minh.