



Chuỗi MongoDB · Bài 5/6. Ở bài 4 về Aggregation Pipeline, chúng ta đã tổng hợp đúng số đơn và tiền hàng. Bài này giải quyết câu hỏi tiếp theo: khi dữ liệu tăng, làm sao biết một truy vấn đang làm quá nhiều việc?
Màn hình lịch sử mua hàng chỉ cần 20 đơn mới nhất của một khách. Khi collection còn vài trăm đơn, mọi thứ có vẻ nhanh. Sau nhiều tháng, cùng màn hình ấy bắt đầu chậm. Một người đề nghị thêm index cho tất cả trường; người khác nhìn thấy IXSCAN trong explain và kết luận truy vấn đã được tối ưu.
Cả hai cách đều thiếu bước kiểm chứng. Một truy vấn có thể dùng index nhưng vẫn xét rất nhiều khóa, đọc nhiều document rồi sắp xếp thêm. Mục tiêu của bài là giúp bạn chọn index từ câu truy vấn, đọc được việc MongoDB đã làm và so sánh trước sau mà không nhầm kết quả đúng với kết quả nhanh.
1. Mục tiêu, điều kiện đầu vào và phạm vi bài lab
Bạn cần biết find(), điều kiện lọc, sort và projection. Nếu mới bắt đầu, đọc MongoDB và CRUD cho người mới. Sau bài này, bạn sẽ phân biệt COLLSCAN, IXSCAN, FETCH và SORT; hiểu thứ tự trường trong compound index; dùng executionStats để đánh giá; nhận biết chi phí khi thêm index.
Các lệnh dùng mongosh với cú pháp tương thích MongoDB 7.0/8.0. Kiểm tra phiên bản bằng db.version(). Lab giả định collection thông thường, không sharding, collation mặc định, các trường lọc và sort là scalar, không có query settings hoặc index filter tùy chỉnh. Tên stage và cấu trúc explain có thể khác giữa phiên bản và execution engine [1][2].
Chúng ta tạo database riêng techdata_mongo5_lab gồm 20.000 document giả lập. Đây là dữ liệu mới để luyện index, không sửa collection ở bài 4. Các số lượng và mã đơn được suy ra từ bộ sinh dữ liệu; thời gian chạy và số khóa thực tế phải lấy từ môi trường của bạn. Bài không đưa con số mili giây giả làm benchmark.
2. Index là một cấu trúc dữ liệu phụ, không phải nút tăng tốc mọi truy vấn
Hãy hình dung collection là kho chứa các phiếu đơn hàng. Nếu không có đường tìm phù hợp, nhân viên phải xem lần lượt từng phiếu để tìm một khách. Index giống một danh mục đã sắp xếp, chứa giá trị khóa và đường dẫn tới document. MongoDB có thể tìm vùng liên quan trong danh mục trước rồi đọc những document cần thiết [3].
Index không phải bản sao đầy đủ của collection. Index trên customerId giúp tìm đơn theo khách; nó không tự chứa mọi sản phẩm trong đơn để trả về. Với projection hoặc điều kiện chưa được index đáp ứng, MongoDB có thể phải đọc document gốc. Bạn sẽ thấy sự khác biệt giữa quét khóa index và đọc document trong explain.
MongoDB thường tạo sẵn index _id_ cho collection thông thường. Index này hữu ích khi tìm theo _id, nhưng không tự đáp ứng câu hỏi “20 đơn paid mới nhất của C042”. Trước khi thử nghiệm, luôn xem getIndexes() để biết mình đang có gì [4].
db = db.getSiblingDB("techdata_mongo5_lab");
db.version();
Sau khi nạp dữ liệu ở phần tiếp theo, chạy db.orders.getIndexes() để xem index hiện có. Không cần xóa index của một hệ thống đang hoạt động để làm bài lab này.
3. Tạo dữ liệu có quy luật để tự kiểm tra kết quả
Chạy đoạn sau một lần trong database lab mới. Mỗi lô chỉ có 1.000 document để đoạn sinh dữ liệu dễ theo dõi. Với mỗi 500 đơn, có một cụm 100 đơn paid; nhờ đó trạng thái không bị gắn cố định vào một mã khách. Mỗi khách có cả đơn paid và pending.
db = db.getSiblingDB("techdata_mongo5_lab");
const baseTime = Date.parse("2026-11-01T00:00:00Z");
for (let batchStart = 0; batchStart < 20000; batchStart += 1000) {
  const batch = [];
  for (let i = batchStart; i < batchStart + 1000; i++) {
    batch.push({
      _id: i,
      customerId: "C" + String(i % 100).padStart(3, "0"),
      status: Math.floor(i / 100) % 5 === 0 ? "paid" : "pending",
      createdAt: new Date(baseTime + i * 60000),
      total: 100000 + (i % 20) * 10000,
      note: "Dữ liệu giả lập cho bài học index"
    });
  }
  db.orders.insertMany(batch);
}
db.orders.countDocuments({}); // 20000
Nếu chạy lại trên collection đã nạp, _id sẽ bị trùng. Hãy dùng database lab mới hoặc chủ động làm lại dữ liệu mẫu trong môi trường học; không sao chép thao tác dọn dữ liệu sang production. createdAt là Date; total là số nguyên đồng, không phải chuỗi.
3.1. Viết yêu cầu nghiệp vụ trước khi thiết kế index
Màn hình cần toàn bộ document của 20 đơn paid mới nhất của C042 trong khoảng UTC từ 01/11 đến trước 15/11/2026. Khi hai đơn trùng createdAt, _id lớn hơn đứng trước. Khoảng thời gian trong bài cố ý dùng UTC; nếu báo cáo theo giờ Việt Nam, đổi cận thời gian như đã học ở bài 4.
const q = {
  customerId: "C042",
  status: "paid",
  createdAt: {
    $gte: ISODate("2026-11-01T00:00:00Z"),
    $lt: ISODate("2026-11-15T00:00:00Z")
  }
};
const orderBy = { createdAt: -1, _id: -1 };
db.orders.countDocuments(q); // 40

db.orders.find(q).sort(orderBy).limit(20);
Giữ cùng phiên mongosh để dùng lại q và orderBy ở các bước sau. Nếu mở phiên mới, chọn lại database và khai báo lại hai biến. Một query cursor sẽ được tạo mới ở mỗi phép đo; không dùng lại cursor đã được đọc hết.
| Mốc đối chiếu | Giá trị của bộ mẫu |
|---|---|
| Toàn collection | 20.000 document |
| Đơn của C042, mọi trạng thái | 200 document |
| Đơn khớp toàn bộ q | 40 document |
| Kết quả sau sort và limit | 20 document |
| Mã đơn đầu tiên | 19542 |
| Mã đơn thứ 20 | 10042 |
Index chỉ được phép đổi cách tìm dữ liệu, không được đổi yêu cầu nghiệp vụ. Khi so sánh hai phương án, q, sort, limit và projection phải giống nhau. Nếu thêm projection ở một bên nhưng không thêm ở bên còn lại, bạn đang so sánh hai công việc khác nhau.
4. Lấy mốc ban đầu bằng explain("executionStats")
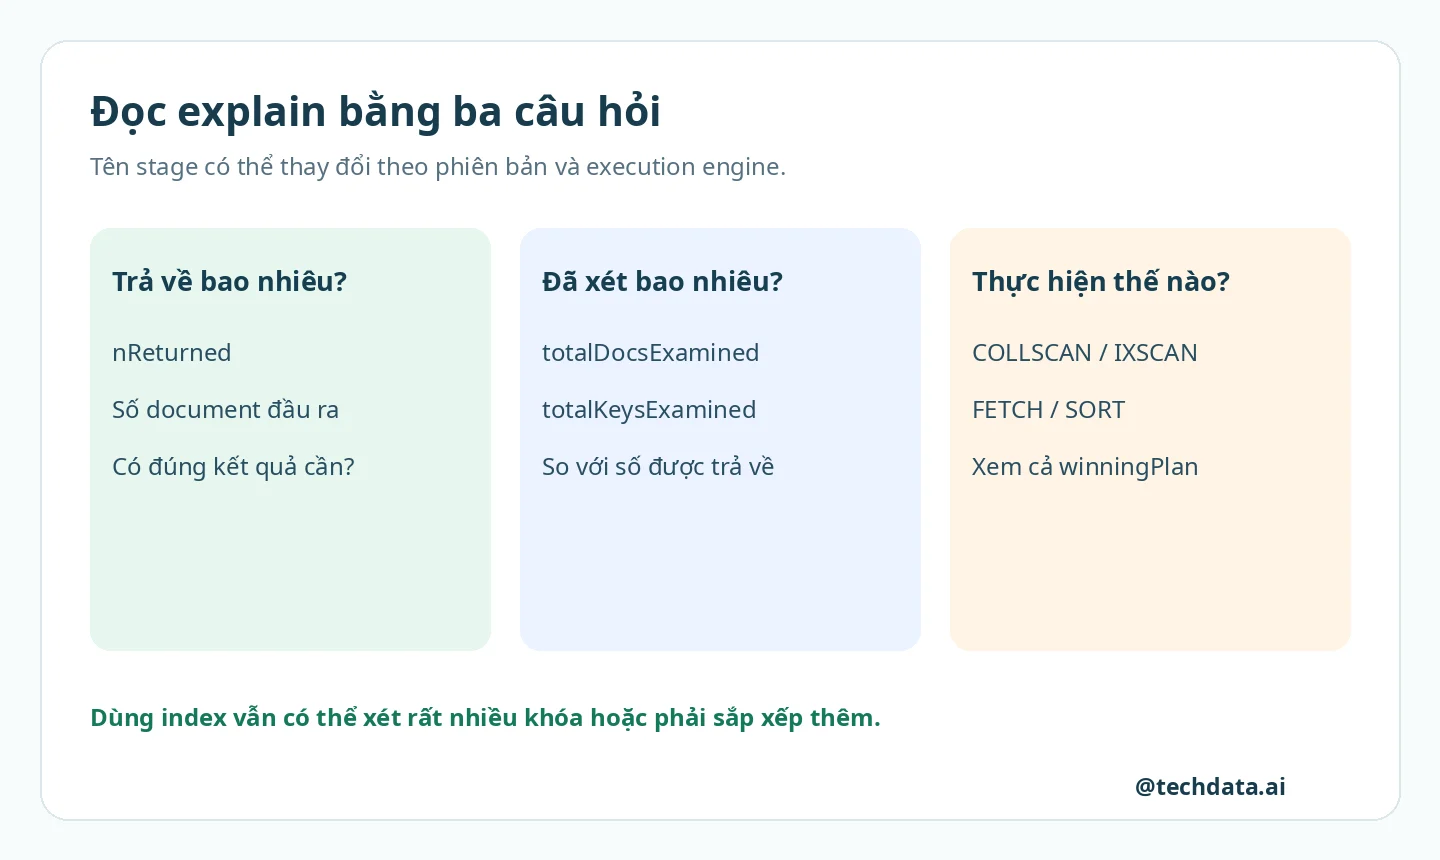
queryPlanner mô tả kế hoạch; executionStats còn chạy truy vấn để lấy thống kê thực thi. Vì vậy, không coi explain là thao tác luôn miễn phí trên dữ liệu lớn. Trong lab nhỏ, ta dùng executionStats để thấy lượng công việc thay vì chỉ nhìn tên index [5].
const before = db.orders.find(q)
  .sort(orderBy)
  .limit(20)
  .hint({ $natural: 1 })
  .explain("executionStats");

printjson(before.queryPlanner.winningPlan);
printjson(before.executionStats);
Ở đây hint({ $natural: 1 }) chủ động yêu cầu quét collection theo chiều tiến, giúp giữ mốc so sánh ngay cả khi bạn đã thêm index ở bước sau. Đây là lựa chọn phục vụ thí nghiệm, không phải đề nghị gắn hint này vào ứng dụng [6].
Với dữ liệu lab, truy vấn cần xét collection để tìm các đơn phù hợp rồi lấy top 20 theo sort. Hãy tìm COLLSCAN và bước SORT trong kế hoạch hoặc phần kế hoạch con tương ứng. Sort kết hợp limit có thể dùng tối ưu top-k; điều đó không có nghĩa nó bỏ qua được việc tìm các ứng viên từ nguồn không có thứ tự cần thiết.
5. Thử single-field index: thu hẹp tìm kiếm nhưng chưa giải quyết hết
db.orders.createIndex(
  { customerId: 1 },
  { name: "customer_only" }
);

const single = db.orders.find(q)
  .sort(orderBy)
  .limit(20)
  .hint("customer_only")
  .explain("executionStats");

printjson(single.queryPlanner.winningPlan);
printjson(single.executionStats);
Index này giúp đi tới những đơn của C042 thay vì tìm trên toàn collection. Nhưng trong vùng khách đó vẫn có nhiều trạng thái; createdAt cũng chưa được sắp theo nhu cầu màn hình. Với dữ liệu mẫu có 200 đơn của C042, ta dự kiến còn phải đọc các ứng viên để lọc rồi sắp 40 đơn phù hợp, trước khi trả 20 đơn.
Bạn có thể thấy IXSCAN đi cùng FETCH và SORT. Đây không phải lỗi của MongoDB: index chỉ được thiết kế cho một phần yêu cầu. Bước tiếp theo là xem có thể đưa cả bộ lọc và thứ tự mong muốn vào cùng cấu trúc tìm kiếm hay không.
6. Chọn compound index từ Equality, Sort và Range
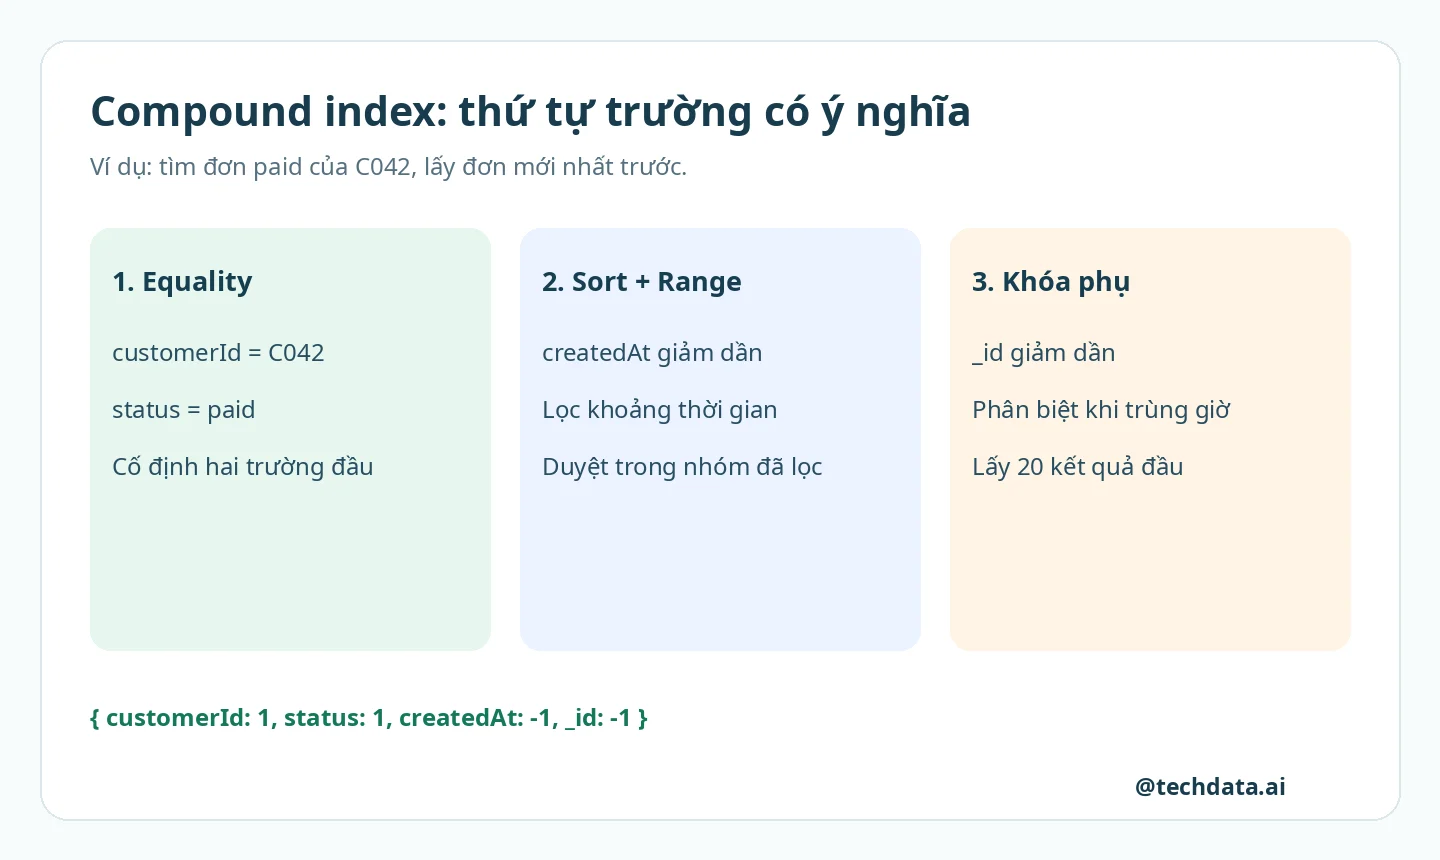
Compound index chứa nhiều trường theo một thứ tự xác định. Với q, customerId và status đều là điều kiện bằng. createdAt vừa có khoảng thời gian vừa đứng đầu yêu cầu sắp xếp; _id là khóa sắp xếp phụ. Một ứng viên phù hợp là:
db.orders.createIndex(
  { customerId: 1, status: 1, createdAt: -1, _id: -1 },
  { name: "customer_status_newest" }
);

const compound = db.orders.find(q)
  .sort(orderBy)
  .limit(20)
  .hint("customer_status_newest")
  .explain("executionStats");

printjson(compound.queryPlanner.winningPlan);
printjson(compound.executionStats);
Hình dung index chia theo khách, trong mỗi khách chia theo trạng thái, rồi sắp các đơn theo createdAt giảm dần và _id giảm dần. Khi hai trường đầu đã cố định bằng C042 và paid, MongoDB có thể duyệt vùng thời gian theo thứ tự cần dùng. Index không phải đọc mọi khách để trả lịch sử của một khách [7].
6.1. ESR là hướng dẫn lựa chọn, không phải công thức cứng
ESR viết tắt của Equality, Sort, Range: thường đặt điều kiện bằng trước, sau đó ưu tiên trường sắp xếp và trường khoảng. Các trường equality không bắt buộc có một thứ tự duy nhất giữa chúng; lựa chọn còn phụ thuộc các truy vấn khác cần dùng prefix. Nếu range rất chọn lọc, thứ tự Equality, Range, Sort có thể đáng thử dù cần sort thêm [8].
Ví dụ chính có một trường createdAt đóng cả vai trò sort lẫn range. Nếu bổ sung điều kiện total: { $gte: 250000 }, total là một trường range khác. Đặt total sau các khóa sort có thể giữ khả năng trả theo thứ tự; đặt total sớm hơn có thể giảm số ứng viên phải xét. Hãy đo trên phân bố tiền và thời gian đại diện, không mặc định một phương án luôn thắng.
6.2. Bỏ hint để xem lựa chọn tự nhiên của optimizer
const automatic = db.orders.find(q)
  .sort(orderBy)
  .limit(20)
  .explain("executionStats");

printjson(automatic.queryPlanner.winningPlan);
Các hint trước đó giúp so sánh từng phương án có kiểm soát. Khi không hint, optimizer được quyền chọn kế hoạch. Nếu nó không chọn index bạn mong đợi, xem lại độ chọn lọc, sort, projection và các index hiện có. Không gắn hint vĩnh viễn chỉ vì nó tốt trong một bộ mẫu; dữ liệu và workload sẽ thay đổi [6].
7. Đọc executionStats: hiểu công việc trước khi nhìn mili giây
| Thông tin | Cách đọc trong bài lab |
|---|---|
nReturned | Số document trả về; cả ba cách phải trả 20 |
totalDocsExamined | Số lượt document được xét; không phải số document trả về |
totalKeysExamined | Số entry index được xét; thấp không tự chứng minh nhanh |
executionTimeMillis | Thời gian server của lần explain; không phải độ trễ end-to-end |
winningPlan | Kế hoạch được chọn; xem cả cây và kế hoạch con |
COLLSCAN là quét collection; IXSCAN là duyệt khóa index; FETCH là đọc document; SORT là một bước sắp xếp. FETCH là bình thường khi màn hình cần các trường không nằm trong index. Một số truy vấn hoặc phiên bản có stage khác, nên đừng viết công cụ kiểm tra bằng giả định mọi kế hoạch đều có đúng một đường inputStage.inputStage [2].
Có thể in bảng tóm tắt từ ba kết quả vừa đo:
function summary(label, plan) {
  const s = plan.executionStats;
  return {
    label,
    nReturned: s.nReturned,
    totalDocsExamined: s.totalDocsExamined,
    totalKeysExamined: s.totalKeysExamined,
    executionTimeMillis: s.executionTimeMillis
  };
}
printjson([
  summary("collection scan", before),
  summary("customer_only", single),
  summary("compound", compound)
]);| Phương án | Điều cần quan sát, không phải benchmark đo sẵn |
|---|---|
| Quét collection | Xét toàn bộ 20.000 document; trả 20; có bước sort |
| Index customer_only | Thu hẹp về khách C042; vẫn cần lọc và sort |
| Index compound | Duyệt vùng khách + trạng thái theo thứ tự; lượng đọc có thể gần số cần trả |
Ở phương án compound của bộ mẫu, kỳ vọng không cần một bước SORT riêng và số document xét giảm mạnh. Số khóa xét có thể khác số trả về vì kiểm tra biên hoặc chi tiết thực thi. Đừng viết assertion cứng rằng keysExamined luôn bằng 20 trên mọi phiên bản [1].
7.1. Kiểm tra hai phương án có trả đúng cùng 20 đơn không
const expectedIds = Array.from({ length: 20 }, (_, k) => 19542 - k * 500);
const idsByScan = db.orders.find(q)
  .sort(orderBy).limit(20).hint({ $natural: 1 })
  .toArray().map(doc => doc._id);
const idsByIndex = db.orders.find(q)
  .sort(orderBy).limit(20).hint("customer_status_newest")
  .toArray().map(doc => doc._id);

printjson({ expectedIds, idsByScan, idsByIndex });
if (JSON.stringify(idsByScan) !== JSON.stringify(expectedIds) ||
    JSON.stringify(idsByIndex) !== JSON.stringify(expectedIds)) {
  throw new Error("Kết quả không khớp bộ dữ liệu mẫu");
}
Điều kiện đúng trước, hiệu năng sau. Khóa phụ _id giúp hai lần đọc có thứ tự xác định ngay cả khi createdAt trùng nhau; trong bộ sinh hiện tại mỗi thời điểm là duy nhất. Mã kiểm tra này cố định cho dữ liệu lab, không áp dụng nguyên xi nếu bạn đã thêm hoặc thay đổi đơn.
7.2. Vì sao không kết luận bằng một lần chạy 0 ms?
Dữ liệu nhỏ, cache đã nóng, tải máy và độ phân giải mili giây có thể làm nhiều phương án cùng hiện 0 ms. Hơn nữa, explain không sử dụng và không tạo entry plan cache như một truy vấn thông thường [5]. Hãy xem lượng dữ liệu xét trước; sau đó đo nhiều lần bằng ứng dụng với tải và dữ liệu đại diện. Thời gian server không bao gồm mọi chi phí mạng, giải mã và render màn hình.
8. Prefix và hướng sort: những chỗ dễ hiểu nhầm
Prefix là đoạn trường liên tiếp bắt đầu từ đầu index. Với index hiện tại, các prefix là customerId; customerId + status; customerId + status + createdAt; và toàn bộ bốn trường. Một bộ lọc chỉ có status không bắt đầu bằng prefix đầu tiên. MongoDB vẫn có thể cân nhắc quét index, nhưng đó không phải đường tìm thu hẹp tương đương truy vấn bắt đầu bằng customerId [7].
| Truy vấn | Index hiện tại đáp ứng thế nào? |
|---|---|
| customerId = C042 | Có prefix; chưa tự bảo đảm sort toàn khách theo createdAt khi thiếu status |
| customerId = C042 và status = paid | Cố định hai trường đầu; phù hợp sort createdAt, _id |
| Chỉ status = paid | Thiếu trường đầu; nên đánh giá index khác theo workload |
| Cố định customerId, status; sort createdAt tăng, _id tăng | Có thể duyệt ngược index để đáp ứng thứ tự đảo toàn bộ |
| Cố định customerId, status; sort createdAt giảm, _id tăng | Không cùng hướng hoặc đảo toàn bộ hai khóa sort của index |
Một index có thể hỗ trợ sort theo hướng khai báo hoặc hướng đảo ngược toàn bộ các khóa sort liên quan. Với nhiều trường, đảo một trường nhưng giữ trường kia không tương đương đảo toàn bộ. Đồng thời, nếu muốn sort bằng phần sau của index, điều kiện trên các trường đứng trước phải đáp ứng yêu cầu thích hợp, như equality trong ví dụ này [9].
9. Covered query: lúc nào không cần đọc document gốc?
Giả sử màn hình danh sách chỉ cần _id, customerId, status và createdAt. Tất cả các trường đó đã có trong compound index. Với lab scalar, không sharding và không điều kiện null, truy vấn dưới là một ứng viên covered query: MongoDB có thể trả kết quả từ index mà không đọc document gốc [3].
const covered = db.orders.find(q, {
  _id: 1, customerId: 1, status: 1, createdAt: 1
})
  .sort(orderBy)
  .limit(20)
  .hint("customer_status_newest")
  .explain("executionStats");

printjson(covered.queryPlanner.winningPlan);
printjson(covered.executionStats);
Kiểm tra totalDocsExamined bằng 0 cùng kế hoạch không cần FETCH cho truy vấn có kết quả. Nếu thêm total: 1 vào projection, index này thiếu total nên thường cần đọc document. Đừng lẫn chỉ tiêu này với trường hợp truy vấn không tìm thấy document nào.
Trong ví dụ này _id đã được đưa rõ vào compound index. Nếu dùng index khác không có _id và muốn cover, nhớ projection mặc định vẫn trả _id, nên có thể cần _id: 0. Không phải cứ dùng projection là được cover, và cũng không nên thêm mọi trường vào index chỉ để cố đạt con số 0 document đọc [3].
Covered query làm thay đổi dữ liệu trả về so với ví dụ lấy toàn document. Vì vậy hãy đo và so sánh nó như một thiết kế màn hình riêng, không lấy nó làm minh chứng trực tiếp rằng index ban đầu tăng tốc cùng một truy vấn bao nhiêu lần.
10. Mở rộng vừa đủ: multikey, unique và partial index
10.1. Multikey cho mảng: index không sửa ý nghĩa điều kiện
Nếu tạo index trên một trường chứa mảng, MongoDB tự xử lý nó như multikey; một document có thể tạo nhiều entry index. Ví dụ collection đơn ở bài 3 có thể cân nhắc index { "items.sku": 1 } cho việc tìm đơn chứa một SKU [10].
Tuy nhiên, index không thay thế $elemMatch khi nhiều điều kiện phải đúng trên cùng một phần tử mảng. Trước tiên viết điều kiện đúng như bài 3 về truy vấn mảng, sau đó mới kiểm tra index bounds. Đừng suy luận số khóa xét phải bằng số đơn khi index chứa nhiều phần tử trên một đơn.
10.2. Unique bảo vệ tính duy nhất của khóa
Với ứng dụng nhiều cửa hàng, mã đơn chỉ cần duy nhất trong từng cửa hàng, có thể dùng unique compound index trên shopId và orderCode. Đây là quy tắc toàn vẹn dữ liệu, không chỉ tối ưu đọc. Index bảo vệ cặp giá trị, không bắt từng orderCode duy nhất trên tất cả cửa hàng [4].
db.order_registry.createIndex(
  { shopId: 1, orderCode: 1 },
  { name: "unique_shop_order", unique: true }
);
Ví dụ này tạo collection registry riêng trong lab nếu chưa có. Với dữ liệu có sẵn, kiểm tra trùng trước khi tạo; unique index không tự dọn dữ liệu trùng. Ứng dụng cần xử lý lỗi duplicate key, thay vì chỉ kiểm tra “đã có chưa” rồi insert trong hai bước độc lập.
10.3. Partial index chỉ chứa một phần document
Nếu màn hình chỉ phục vụ đơn paid, một phương án khác là index một phần dữ liệu với partialFilterExpression. Đoạn dưới là bài thử thêm sau khi bạn đã hoàn thành so sánh chính:
db.orders.createIndex(
  { customerId: 1, createdAt: -1, _id: -1 },
  {
    name: "paid_customer_newest",
    partialFilterExpression: { status: "paid" }
  }
);
Index chỉ chứa document paid. Truy vấn phải có điều kiện khiến MongoDB xác định kết quả nằm trọn trong phạm vi index; q có status paid nên phù hợp để thử. Một truy vấn lấy cả paid lẫn pending không được dùng partial index này để thay thế toàn bộ tập kết quả. Đừng ép hint chỉ để nhìn thấy tên index [11].
Trong bộ mẫu, chỉ 4.000 trên 20.000 đơn là paid, nên đây là ví dụ dễ nhìn về phạm vi index. Lợi ích dung lượng thực tế còn phụ thuộc độ dài khóa và overhead. Nếu trả cả status trong projection, không tự khẳng định truy vấn sẽ cover vì status không nằm trong key pattern partial này; hãy kiểm tra explain riêng.
11. Chi phí vận hành và lỗi thường gặp
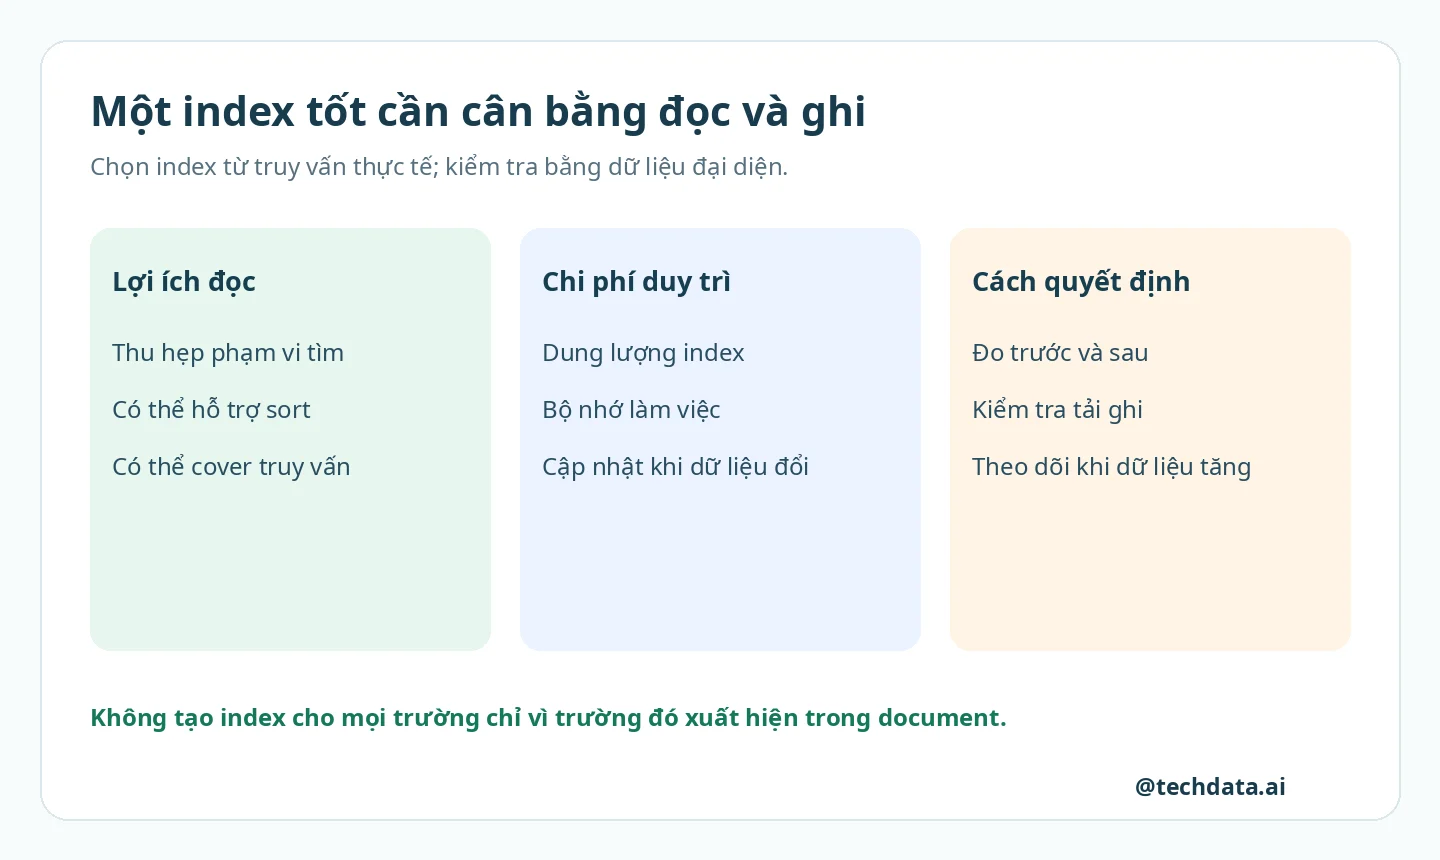
Mỗi index dùng thêm dung lượng và góp vào working set. Khi insert hoặc xóa document, MongoDB phải duy trì các index liên quan; update làm thay đổi trường được index cũng cần cập nhật khóa. Vì vậy nhiều index có thể giúp đọc nhưng làm ghi tốn công hơn. Hãy đo cả đường đọc lẫn đường ghi quan trọng [12].
Các index được tạo trong bài là ứng viên học tập, không phải danh sách phải giữ nguyên trong mọi hệ thống. Trong production, xem truy vấn phổ biến, tần suất, p95 độ trễ và tốc độ ghi trước khi quyết định. Việc build index trên collection lớn cần được lên kế hoạch theo tài nguyên, topology và phiên bản; không suy ra nó nhẹ chỉ vì lab chạy nhanh.
| Dấu hiệu | Kiểm tra và hướng xử lý |
|---|---|
| Thấy IXSCAN nhưng vẫn chậm | Đọc keys/docs examined, FETCH, SORT và số kết quả; kiểm tra độ chọn lọc |
| Có compound index nhưng vẫn SORT | Đối chiếu prefix equality, thứ tự và hướng sort; kiểm tra collation |
| Số liệu trước sau không cùng kết quả | Giữ nguyên filter, sort, limit, projection; kiểm tra dữ liệu có đổi giữa hai lần |
| Hai lần đều 0 ms | Tăng dữ liệu đại diện, xem lượng việc và đo nhiều lần trong ứng dụng |
| Ghi chậm hơn sau khi thêm nhiều index | Đánh giá chi phí duy trì và nhu cầu từng index |
| hint báo lỗi | Kiểm tra tên, tồn tại và khả năng sử dụng của index; không đoán tên |
Đừng xóa index chỉ dựa trên một câu truy vấn hoặc một khoảng quan sát ngắn. Một index có thể phục vụ báo cáo ít chạy nhưng quan trọng, hoặc thực thi unique constraint. Đánh giá toàn workload trước khi thay đổi; bài lab không yêu cầu bạn xóa bất kỳ index production nào.
12. Bài tập tự luyện và đáp án định hướng
Bài 1: đổi yêu cầu thành “đơn paid mới nhất của toàn cửa hàng”
Bỏ customerId khỏi q và giữ sort createdAt giảm, _id giảm. Hãy đề xuất một index mới. Gợi ý: câu hỏi không còn cố định trường đầu của index hiện tại. Ứng viên là { status: 1, createdAt: -1, _id: -1 }. Kiểm tra bằng explain với truy vấn mới và số lượng kết quả cần trả; không chỉ nhìn việc index cũ có được chọn hay không.
Bài 2: sort một chiều khác và kiểm chứng
Với customerId và status cố định, thử sort { createdAt: 1, _id: 1 }, sau đó thử { createdAt: -1, _id: 1 }. Gợi ý: trường hợp đầu đảo toàn bộ phần sort nên có thể duyệt ngược index; trường hợp sau đổi quan hệ hướng giữa hai khóa nên không được index hiện tại bảo đảm trực tiếp. Dù bộ mẫu không có ngày trùng, hãy xem kế hoạch theo cấu trúc sort, không chỉ thấy dữ liệu tình cờ đúng thứ tự.
Bài 3: thêm total vào projection covered
Sao chép truy vấn covered rồi thêm total. Dự đoán trước khi chạy: thường cần FETCH vì total không có trong index. Đáp án cần nêu totalDocsExamined, các stage và kết quả có còn đúng 20 đơn không. Nếu muốn thử index có total, ghi lại chi phí kích thước và nhu cầu màn hình; không mặc định nên giữ index rộng hơn.
Bài 4: đánh giá partial index
Dùng q với hint paid_customer_newest rồi chạy lại cùng q không hint. Ghi kế hoạch, số khóa và document xét. Sau đó giải thích bằng lời vì sao partial index không đại diện cho truy vấn lấy tất cả trạng thái. Không ép truy vấn ngoài phạm vi chỉ để tạo một kết quả có vẻ nhanh.
13. Tổng kết: chọn index bằng truy vấn và chứng minh bằng số liệu
Quy trình có thể lặp lại là: chốt filter, sort, limit và projection; lấy mốc; tạo một ứng viên; so sánh lượng việc và kế hoạch; kiểm tra kết quả vẫn đúng; cuối cùng đánh giá tải ghi và dung lượng. Một index hợp lý phục vụ nhu cầu cụ thể, không phải mọi trường trong document.
Trong bài này, single-field index mới thu hẹp theo khách; compound index còn đưa trạng thái và thứ tự thời gian vào đường tìm. Bạn cũng đã thấy covered query là một thiết kế projection riêng, partial index có phạm vi riêng và hint là công cụ thí nghiệm cần dùng có lý do.
Bài 6 tiếp theo: Atomicity và Transaction trong MongoDB: xử lý tồn kho, đơn hàng và retry an toàn. Khi truy vấn đã đúng và được đo, chúng ta sẽ chuyển sang bảo vệ tính đúng đắn khi nhiều thao tác ghi diễn ra đồng thời.
14. Tài liệu tham khảo
Đối chiếu tài liệu chính thức ngày 12/11/2026. Các trang manual có thể cập nhật; chọn nhánh tài liệu khớp server khi triển khai. Dữ liệu và yêu cầu cửa hàng trong bài là ví dụ giảng dạy tự xây dựng, không phải benchmark của MongoDB.
- Interpret Explain Plan Results
- Explain Results
- Query Optimization và covered queries
- Unique Indexes
- cursor.explain()
- cursor.hint()
- Compound Indexes
- Equality, Sort, Range Guideline
- Sort Results with Indexes
- Multikey Indexes
- Partial Indexes
- Write Operation Performance
Học cùng TechData.AI: Muốn luyện truy vấn, index và kiểm tra hiệu năng trong project Data Engineering có hướng dẫn? Xem các chương trình đào tạo Data & AI để chọn lộ trình phù hợp với nền tảng hiện tại.
Comments are closed!