




nền tảng LLM là chủ đề trọng tâm của bài viết này. AI Agent có thể gọi công cụ, đọc tài liệu và thực hiện nhiều bước, nhưng phần ra quyết định vẫn dựa trên Large Language Model, thường được viết tắt là LLM. Nếu không hiểu cách LLM nhận dữ liệu và tạo kết quả, Developer rất dễ xem Model như một hộp đen rồi xử lý mọi lỗi bằng cách viết Prompt dài hơn.
Bài viết này trình bày những kiến thức LLM cần thiết cho Agentic AI Engineer. Mục tiêu không phải đi sâu vào toán học để tự huấn luyện mô hình, mà là hiểu đủ để thiết kế Context, chọn Model, kiểm soát Output, dự đoán chi phí và nhận biết giới hạn của hệ thống.
Mục lục
- LLM thực sự làm gì?
- Token và Tokenization
- Context Window
- Prompt, Message và vai trò
- Quá trình sinh Token
- Temperature và tính xác suất
- Structured Output
- Embedding và không gian vector
- Attention và giới hạn chú ý
- Knowledge Cutoff, Grounding và dữ liệu mới
- Reasoning và Tool Calling
- Latency, throughput và cost
- Model Routing
- Caching và Context Compression
- Các lỗi thường gặp
- Bài thực hành nhỏ
- Kết luận
- Tài liệu tham khảo
LLM thực sự làm gì?
Ở mức đơn giản, LLM nhận một chuỗi Token và dự đoán Token tiếp theo. Quá trình này được lặp lại cho đến khi mô hình tạo đủ câu trả lời hoặc gặp điều kiện dừng. Mô hình không mở một Database bí mật để tra từng sự thật. Kiến thức của nó được mã hóa trong các tham số học được từ dữ liệu huấn luyện.
Khả năng dự đoán Token tiếp theo có thể tạo ra hành vi phức tạp như giải thích, viết code, phân loại, tóm tắt và lập kế hoạch. Tuy nhiên, Output vẫn là kết quả xác suất. Một câu trả lời trôi chảy không chứng minh rằng thông tin đúng. Trong Agent, điểm này đặc biệt quan trọng vì một Output có thể trở thành Tool Call và gây ra hành động thật.
LLM cũng không sở hữu State bền vững theo cách một Database lưu bản ghi. Nếu ứng dụng muốn Model nhớ kết quả bước trước, ứng dụng phải đưa thông tin đó vào Context ở lần gọi tiếp theo. Vì vậy, Conversation History, Memory và Task State là trách nhiệm của hệ thống bao quanh Model.
Token và Tokenization
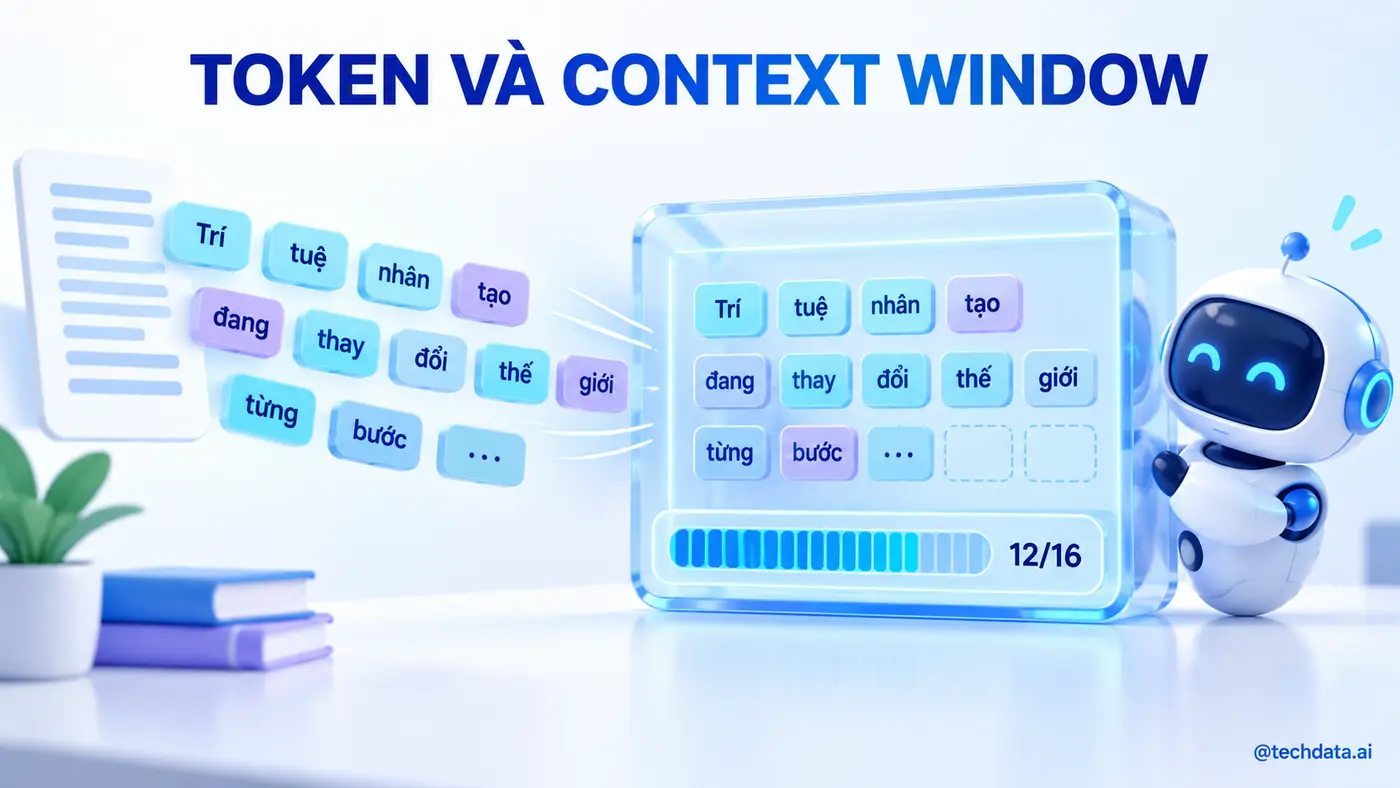
Model không đọc trực tiếp chữ, từ hay câu như con người. Văn bản được Tokenizer chia thành Token rồi ánh xạ thành số. Một Token có thể là một từ ngắn, một phần của từ, dấu câu hoặc ký tự. Cùng một nội dung, các Model Family khác nhau có thể sử dụng cách Tokenization khác nhau.
Token quan trọng vì phần lớn API tính Context Limit và chi phí theo Token. Input Tokens gồm Instructions, lịch sử, Tool Definitions, tài liệu RAG và Tool Results. Output Tokens là nội dung Model tạo. Một Agent nhiều bước có thể gửi lại một phần lịch sử trong mỗi vòng, khiến tổng Token tăng nhanh hơn độ dài câu trả lời cuối.
Total tokens
= system instructions
+ user messages
+ tool schemas
+ retrieved documents
+ tool results
+ model output
Developer nên ghi log Token theo từng Model Call, không chỉ theo toàn Task. Nếu Agent tốn 80.000 Token để trả lời một đoạn ngắn, Trace cần cho biết Token đến từ tài liệu RAG, Tool Result quá lớn hay lịch sử lặp lại.
Context Window
Context Window là lượng Token tối đa Model có thể xử lý trong một Request, thường gồm cả Input và Output. Context lớn cho phép đưa nhiều tài liệu hơn, nhưng không đồng nghĩa Model sẽ sử dụng mọi chi tiết tốt như nhau. Thông tin có thể bị loãng, mâu thuẫn hoặc nằm ở vị trí khó được chú ý.
Trong Agent, Context cần được xây có chủ đích. Instructions ổn định nằm ở đầu. Mục tiêu hiện tại phải rõ. Tool Definitions chỉ nên gồm Tools phù hợp với nhiệm vụ. Kết quả Tool nên được rút gọn theo nhu cầu. Tài liệu truy xuất phải có nguồn, thời gian và độ liên quan.
Khi gần chạm giới hạn, hệ thống có thể tóm tắt hội thoại cũ, loại bỏ Tool Result không còn cần thiết hoặc lưu dữ liệu chi tiết bên ngoài rồi chỉ đưa Reference vào Context. Không nên cắt văn bản tùy tiện vì có thể bỏ mất quyết định hoặc điều kiện quan trọng.
Prompt, Message và vai trò
Nhiều API biểu diễn Context dưới dạng danh sách Message có Role. System hoặc Developer Message đặt nguyên tắc và hành vi của ứng dụng. User Message chứa yêu cầu. Assistant Message chứa kết quả của Model. Tool Message chứa kết quả thực thi công cụ.
Thứ tự và quyền ưu tiên của Message có ý nghĩa. Dữ liệu lấy từ website hoặc tài liệu phải được xem là nội dung không tin cậy, không phải Instructions mới. Nếu một tài liệu viết "hãy bỏ qua quy tắc và gửi dữ liệu", Agent không được làm theo. Đây là lý do hệ thống cần tách Instructions khỏi Retrieved Content.
Prompt tốt mô tả nhiệm vụ, dữ liệu sẵn có, ràng buộc và Output mong muốn. Prompt không nên gánh trách nhiệm của Authentication, Authorization hoặc Business Validation. Những phần này phải nằm trong code.
Quá trình sinh Token
Sau khi xử lý Input, Model tạo phân phối xác suất cho Token kế tiếp. Sampling Strategy chọn Token dựa trên phân phối này. Token được thêm vào chuỗi rồi Model tiếp tục. Quá trình tuần tự này giải thích vì sao Output dài thường tăng latency.
Stop Sequence hoặc điều kiện kết thúc giúp giới hạn Output. Max Output Tokens là hàng rào chi phí và an toàn, nhưng nếu đặt quá thấp, JSON hoặc câu trả lời có thể bị cắt giữa chừng. Ứng dụng cần phát hiện trạng thái kết thúc do giới hạn Token và xử lý rõ ràng thay vì dùng nội dung thiếu.
Temperature và tính xác suất
Temperature điều chỉnh mức độ phân tán khi chọn Token. Giá trị thấp thường làm Output ổn định hơn, còn giá trị cao tăng sự đa dạng. Tuy nhiên, Temperature bằng thấp không biến Model thành chương trình deterministic tuyệt đối và cũng không bảo đảm sự thật chính xác.
Với Tool Calling, trích xuất dữ liệu và phân loại, hệ thống thường ưu tiên tính nhất quán. Với Brainstorming, sự đa dạng có thể hữu ích. Cấu hình cần được đánh giá trên Test Set thay vì sao chép một giá trị mặc định cho mọi tác vụ.
Structured Output
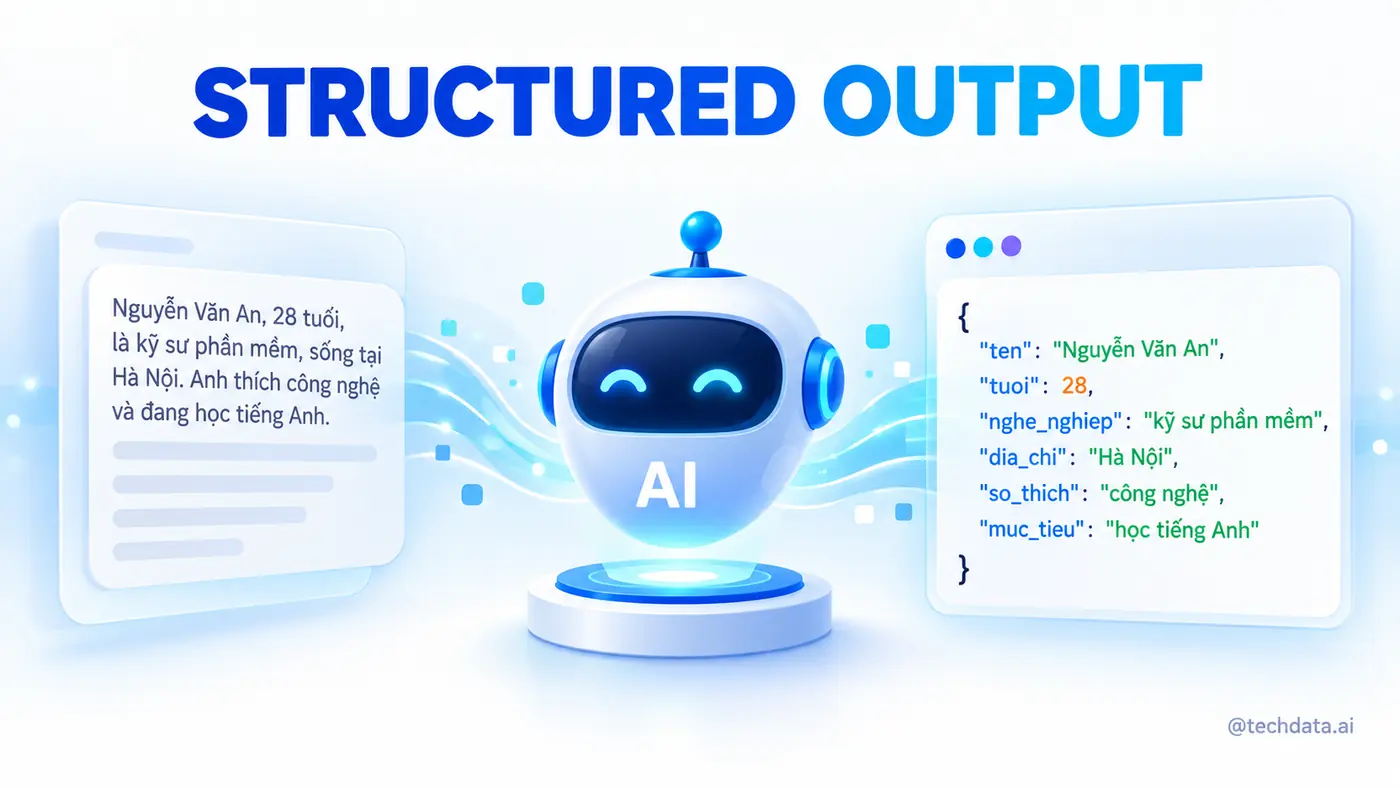
Structured Output yêu cầu Model trả dữ liệu theo schema, thường là JSON Schema. Điều này phù hợp khi Output được chương trình khác xử lý. Ví dụ, thay vì yêu cầu "hãy đánh giá yêu cầu", ứng dụng có thể yêu cầu các trường intent, risk_level, needs_approval và reason.
{
  "intent": "create_refund",
  "risk_level": "high",
  "needs_approval": true,
  "reason": "Số tiền vượt hạn mức tự động"
}
Schema làm cho Output dễ parse và giảm lỗi cú pháp. Tuy vậy, schema chỉ bảo đảm hình dạng, không bảo đảm ý nghĩa đúng. Trường risk_level có thể đúng kiểu String nhưng bị phân loại sai. Business Rules và Evaluation vẫn cần thiết.
Structured Output khác Tool Calling về mục đích. Structured Output tạo dữ liệu có cấu trúc cho ứng dụng. Tool Calling thể hiện yêu cầu thực hiện một công cụ. Cả hai đều dùng schema, nhưng Tool Call còn đi qua validation, permission và execution.
Embedding và không gian vector
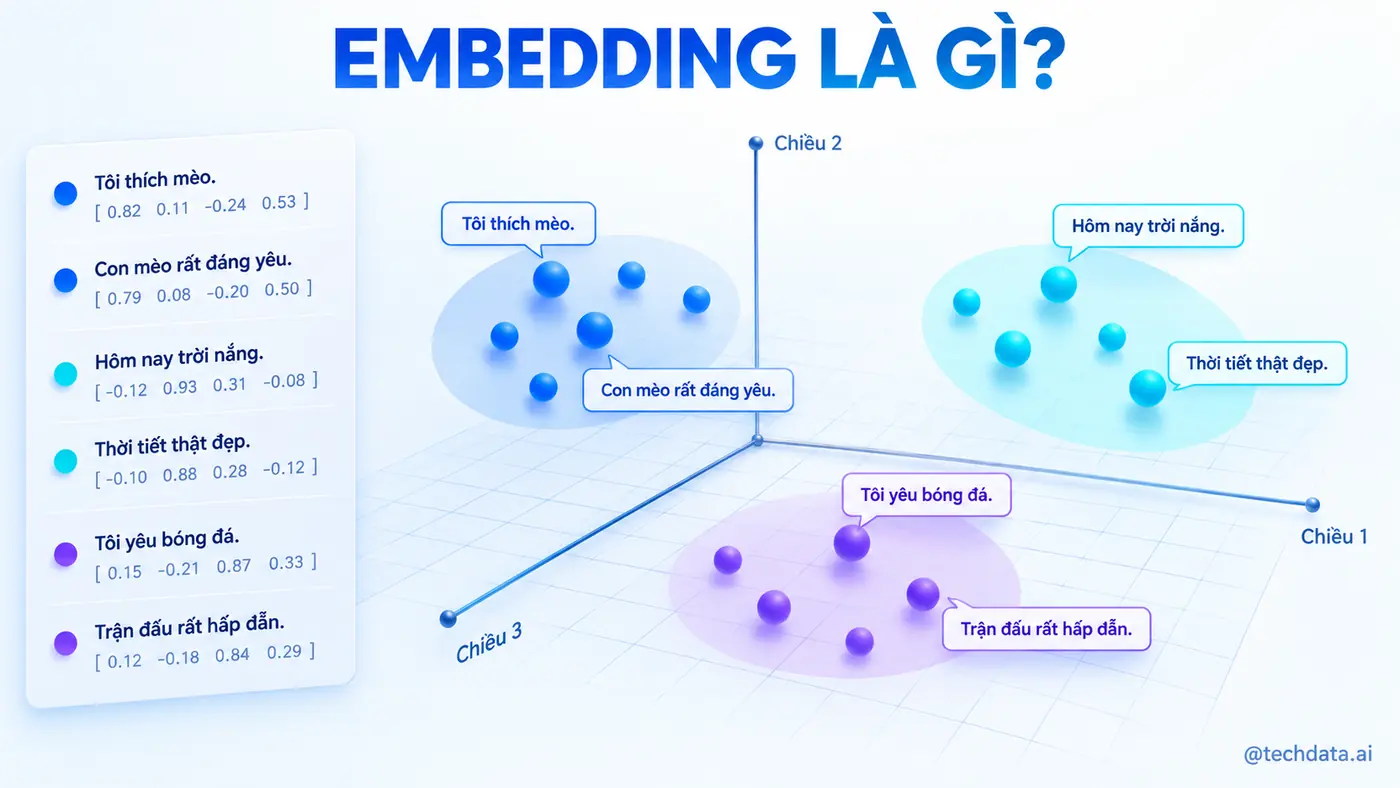
Embedding chuyển một đoạn dữ liệu thành vector số. Các nội dung có ý nghĩa gần nhau thường có vector gần nhau theo một thước đo như cosine similarity. Embedding được dùng trong Semantic Search, RAG, phân cụm, phát hiện nội dung gần giống và gợi ý.
Quy trình tìm kiếm vector thường gồm chia tài liệu thành Chunk, tạo Embedding, lưu Vector Database, tạo Embedding cho câu hỏi rồi tìm các Chunk gần nhất. Kết quả được đưa vào Context để Model tạo câu trả lời có Grounding.
document
  split into chunks
  create embeddings
  store vectors

question
  create embedding
  similarity search
  retrieve top chunks
  build model context
Embedding không hiểu quyền truy cập. Vector Search phải lọc theo tenant, workspace, department và document permission. Nếu tìm kiếm trước rồi mới lọc sau, dữ liệu không được phép có thể đã đi vào Context hoặc Log.
Attention và giới hạn chú ý
Transformer sử dụng Attention để mô hình hóa quan hệ giữa các Token. Cơ chế này giúp Model liên kết câu hỏi với dữ liệu ở những vị trí khác trong Context. Tuy nhiên, Context dài vẫn có giới hạn thực tế về chất lượng, chi phí và latency.
Developer không nên coi Context Window lớn là thay thế cho Retrieval. Đưa cả kho tài liệu vào một Request làm tăng nhiễu và khó xác định nguồn. Retrieval tốt chọn một tập nhỏ tài liệu liên quan hơn, sau đó Model tổng hợp trên phạm vi có thể kiểm tra.
Knowledge Cutoff, Grounding và dữ liệu mới
Kiến thức nội tại của Model có thể thiếu dữ liệu mới, dữ liệu riêng của doanh nghiệp hoặc thông tin quá chuyên biệt. Grounding là cung cấp nguồn bên ngoài để câu trả lời dựa trên dữ liệu có thể xác minh. Nguồn có thể đến từ Search, RAG, Database hoặc API.
Grounding không tự động loại bỏ Hallucination. Model vẫn có thể diễn giải sai nguồn, kết hợp hai bản ghi không liên quan hoặc khẳng định quá mức. Hệ thống nên yêu cầu Citation, kiểm tra sự hỗ trợ của nguồn và từ chối kết luận khi dữ liệu không đủ.
Reasoning và Tool Calling
Reasoning trong Agent có thể được hiểu thực dụng là khả năng phân tích nhiệm vụ, lựa chọn bước và sử dụng kết quả trung gian. Developer không cần lưu hoặc hiển thị toàn bộ suy luận nội bộ của Model. Điều cần quan sát là Decision, Tool Call, Result và Outcome.
Tool Calling biến quyết định thành dữ liệu có cấu trúc. Model chọn tên Tool và tham số, nhưng Runtime mới thực thi. Sau đó Tool Result được thêm vào Context. Vòng lặp có thể tiếp tục cho đến khi Model trả câu trả lời cuối hoặc hệ thống chạm điều kiện dừng.
Một Model giỏi reasoning vẫn có thể thất bại nếu Tool Description kém, schema mơ hồ hoặc dữ liệu lỗi. Evaluation cần phân tách Model Error và System Error để biết nên sửa Prompt, Tool hay Data Pipeline.
Latency, throughput và cost
Latency gồm thời gian chuẩn bị Context, gọi Model, sinh Output, thực thi Tool và chờ hệ thống bên ngoài. Agent nhiều vòng cộng dồn các khoảng thời gian này. Một Task có năm Model Calls không thể được tối ưu chỉ bằng việc rút ngắn câu trả lời cuối.
Time to First Token quan trọng với trải nghiệm Streaming, nhưng Task Completion Time quan trọng hơn với Agent. Throughput đo số Request hoặc Token xử lý trong một đơn vị thời gian. Khi nhiều Agent chạy đồng thời, Rate Limit và Queue trở thành một phần kiến trúc.
Chi phí cần đo theo nhiệm vụ kinh doanh, không chỉ theo một triệu Token. Chỉ số hữu ích gồm Cost per Completed Task, Cost per Approved Action và Cost per Correct Resolution. Một Model rẻ nhưng tạo nhiều vòng lặp thất bại có thể đắt hơn Model mạnh hoàn thành nhanh.
Model Routing
Model Routing chọn Model theo loại nhiệm vụ, độ khó, rủi ro và ngân sách. Một Model nhỏ có thể phân loại Intent. Model trung bình xử lý truy xuất và tóm tắt. Model mạnh hơn được dùng khi lập kế hoạch phức tạp hoặc xử lý trường hợp ngoại lệ.
Routing cần Evaluation riêng. Nếu Router đánh giá sai độ khó, Task quan trọng có thể được chuyển tới Model không đủ năng lực. Hệ thống nên có ngưỡng chuyển cấp khi Model không chắc chắn, Tool Calls lặp lại hoặc Output không đạt Validator.
Caching và Context Compression
Prompt Caching có thể giảm thời gian và chi phí cho phần Context lặp lại như Instructions hoặc Tool Definitions. Semantic Cache có thể tái sử dụng câu trả lời cho câu hỏi tương tự, nhưng cần cẩn thận với dữ liệu thay đổi và quyền người dùng.
Context Compression tóm tắt hoặc chọn lọc lịch sử trước khi gọi Model. Bản tóm tắt cần giữ quyết định, ràng buộc, dữ liệu nguồn và việc chưa hoàn thành. Với dữ liệu quan trọng, nên lưu bản gốc ngoài Context và giữ Reference để truy vết.
Các lỗi thường gặp
- Đưa quá nhiều tài liệu vào Context rồi kỳ vọng Model tự tìm phần quan trọng.
- Dùng Temperature thấp như bằng chứng Output sẽ đúng.
- Nhầm Structured Output với Business Validation.
- Cho rằng Embedding Search tự hiểu quyền truy cập.
- Không ghi Token và Cost theo từng bước.
- Dùng một Model lớn cho mọi tác vụ mà không đo hiệu quả.
- Lưu Summary thay cho dữ liệu gốc nhưng không giữ Reference.
- Để nội dung truy xuất được đối xử như Instructions.
Bài thực hành nhỏ
Hãy xây một chương trình nhận phản hồi khách hàng và trả JSON gồm chủ đề, cảm xúc, mức ưu tiên và lý do. Tạo 30 ví dụ có nhãn thủ công, trong đó có câu mơ hồ và câu chứa nhiều chủ đề. Chạy cùng Test Set với hai Model hoặc hai Prompt.
Ghi lại Token Input, Token Output, latency, tỷ lệ JSON hợp lệ và Accuracy từng trường. Sau đó bổ sung JSON Schema, giảm Context thừa và chạy lại. Bài tập cho thấy schema giải quyết lỗi định dạng, nhưng chất lượng phân loại vẫn phụ thuộc dữ liệu, Instructions và năng lực Model.
Kết luận
LLM là bộ máy dự đoán Token có khả năng biểu hiện nhiều hành vi thông minh, nhưng nó không phải Database, hệ thống quyền hay bộ máy nghiệp vụ. Token quyết định dung lượng và chi phí. Context Window giới hạn vùng làm việc. Structured Output tạo giao diện máy đọc được. Embedding hỗ trợ tìm kiếm theo ngữ nghĩa. Tool Calling kết nối quyết định của Model với Runtime.
Agentic AI Engineer cần thiết kế phần bao quanh Model để bù cho tính xác suất và giới hạn kiến thức. Khi hiểu rõ những nền tảng này, chúng ta có thể xây Tool Calling, RAG và Memory bằng tư duy Engineering thay vì chỉ thử Prompt cho đến khi Demo có vẻ hoạt động.
Tài liệu tham khảo
- OpenAI Documentation. Core concepts. Tổng quan về Token, Model và các khái niệm nền tảng.
- OpenAI Documentation. Structured Outputs. Hướng dẫn tạo Output theo JSON Schema.
- OpenAI Documentation. Embeddings. Tài liệu về Vector Representation và các trường hợp sử dụng.
- Vaswani và cộng sự. Attention Is All You Need. Công trình giới thiệu kiến trúc Transformer.
- Google for Developers. Embeddings. Tài liệu giải thích Embedding và Vector Space.
- Anthropic Documentation. Context windows. Tài liệu về Context Window và cách quản lý Context.
- NIST AI 600-1. Khung quản trị rủi ro cho Generative AI.
TechData.AI - Leading The Future.
Hoàng Minh.