




RAG và Memory cho AI Agent là chủ đề trọng tâm của bài viết này. LLM có kiến thức rộng nhưng không tự biết tài liệu nội bộ, dữ liệu mới nhất hay quyết định riêng của doanh nghiệp. Retrieval-Augmented Generation, thường gọi là RAG, giúp hệ thống tìm nguồn liên quan rồi đưa nguồn đó vào Context. Memory giúp Agent lưu và lấy lại thông tin qua nhiều bước hoặc nhiều phiên.
RAG và Memory thường bị nhầm vì cả hai đều đưa thông tin bên ngoài vào Model. RAG chủ yếu truy xuất tri thức từ một kho nguồn. Memory lưu thông tin liên quan đến quá trình tương tác và trạng thái lâu dài. Cả hai chỉ hữu ích khi Retrieval đúng, Permission đúng và thông tin có thể truy vết.
Mục lục
- Vì sao Agent cần RAG?
- Pipeline RAG cơ bản
- Ingestion và Parsing
- Chunking
- Embedding và Vector Index
- Hybrid Search
- Metadata Filtering và Permissions
- Reranking
- Context Construction
- Citation và Groundedness
- Agentic RAG
- Memory là gì?
- Các loại Memory
- Memory Write và Memory Retrieval
- Freshness, Privacy và Retention
- Evaluation RAG và Memory
- Kiến trúc tham khảo
- Kết luận
- Tài liệu tham khảo
Vì sao Agent cần RAG?
Nếu hỏi Model về chính sách nghỉ phép của một công ty, nó có thể trả lời theo hiểu biết chung nhưng không biết quy định nội bộ. Fine-tuning có thể điều chỉnh hành vi, nhưng không phải cách phù hợp để cập nhật tài liệu thay đổi thường xuyên. RAG giữ kiến thức trong hệ thống nguồn và truy xuất khi cần.
RAG tạo ba lợi ích. Thứ nhất, dữ liệu có thể cập nhật mà không huấn luyện lại Model. Thứ hai, câu trả lời có thể kèm nguồn. Thứ ba, quyền truy cập có thể được áp dụng tại Retrieval Layer. Tuy vậy, RAG không bảo đảm đúng nếu tài liệu sai, Chunk kém hoặc truy xuất nhầm.
Pipeline RAG cơ bản
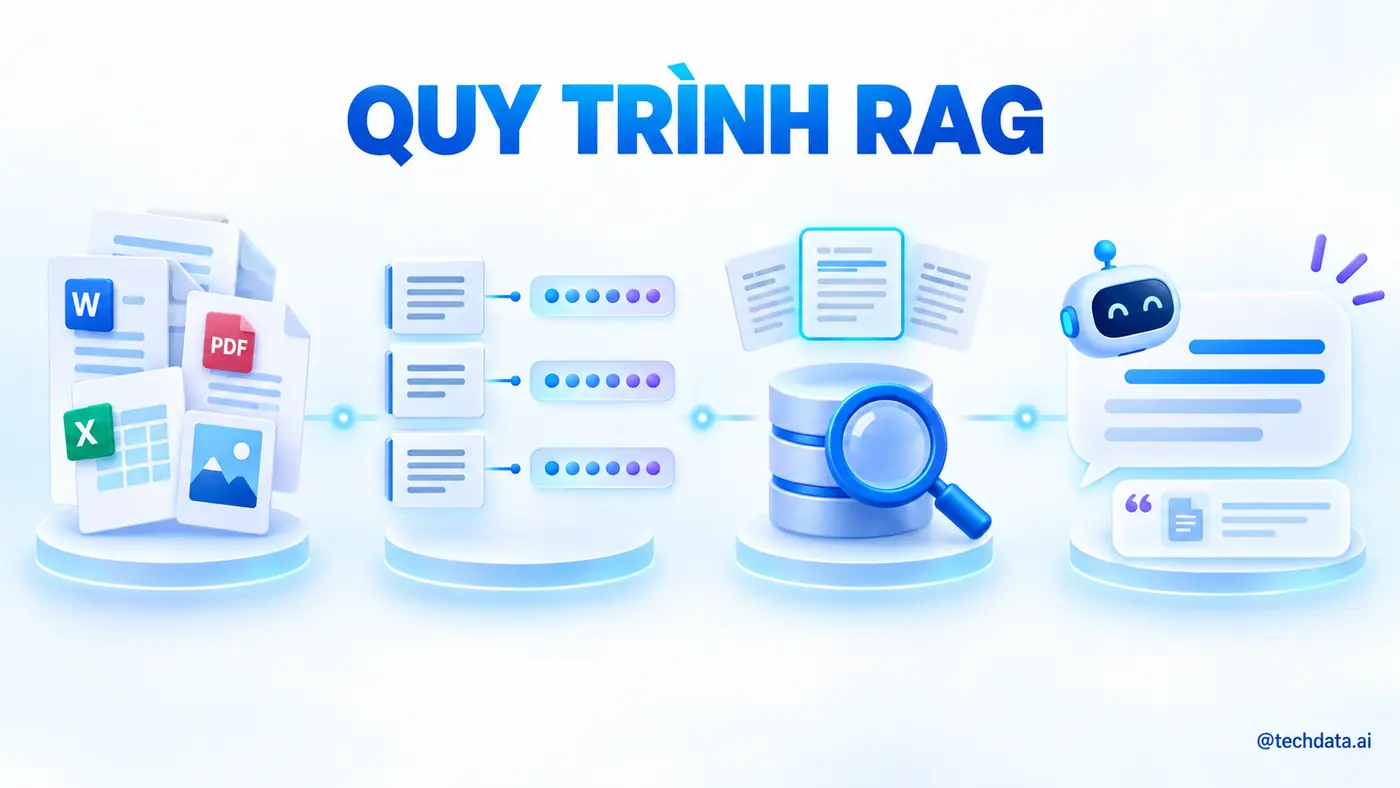
Documents
  parse and clean
  split into chunks
  create embeddings
  store index

Question
  rewrite query
  retrieve candidates
  filter permissions
  rerank
  build context
  generate answer with citations
Pipeline có hai pha. Offline Ingestion chuẩn bị tài liệu và Index. Online Retrieval xử lý câu hỏi, tìm nguồn và tạo Context. Production cần thêm Versioning, Monitoring, Access Control, Deduplication và cơ chế xóa dữ liệu.
Ingestion và Parsing
Ingestion nhận tài liệu từ Google Drive, SharePoint, Website, Database hoặc Object Storage. Parser trích xuất văn bản, tiêu đề, bảng và metadata. Chất lượng Parser ảnh hưởng trực tiếp đến Retrieval. Một bảng bị chuyển thành chuỗi lộn xộn có thể làm mất quan hệ giữa cột và giá trị.
Mỗi tài liệu cần Document ID ổn định, Source URL, Owner, Version, Effective Date, Updated Time, Language và ACL. Hệ thống nên tạo Content Hash để phát hiện thay đổi. Khi bản mới xuất hiện, Chunk cũ phải được vô hiệu hóa hoặc xóa khỏi Index.
Chunking
Chunking chia tài liệu thành đơn vị có thể truy xuất. Chunk quá nhỏ mất Context. Chunk quá lớn chứa nhiều chủ đề và làm tăng Token. Kích thước phù hợp phụ thuộc loại tài liệu, Embedding Model và câu hỏi.
Fixed-size Chunking đơn giản nhưng có thể cắt giữa câu. Semantic Chunking dựa trên cấu trúc hoặc ý nghĩa. Với hợp đồng, nên giữ điều khoản và tiêu đề. Với tài liệu kỹ thuật, nên giữ code cùng phần giải thích. Với bảng, cần giữ header và khóa liên kết.
Chunk Overlap giúp bảo toàn ngữ cảnh ở biên nhưng tạo trùng lặp. Hệ thống cần đo Retrieval Quality thay vì chọn một con số theo thói quen. Parent-child Retrieval có thể tìm Chunk nhỏ rồi đưa phần cha lớn hơn vào Context.
Embedding và Vector Index
Embedding biểu diễn Chunk thành Vector. Query cũng được Embedding bằng Model tương thích. Vector Database tìm các Chunk có độ gần cao. Similarity không đồng nghĩa với đúng câu trả lời, nên Top K chỉ là tập Candidate.
Khi thay Embedding Model, thường cần tạo lại Index vì Vector Space thay đổi. Embedding Version phải được lưu cùng bản ghi. Index cũng cần tách Tenant hoặc Filter bằng ACL để tránh Retrieval dữ liệu ngoài phạm vi.
Hybrid Search
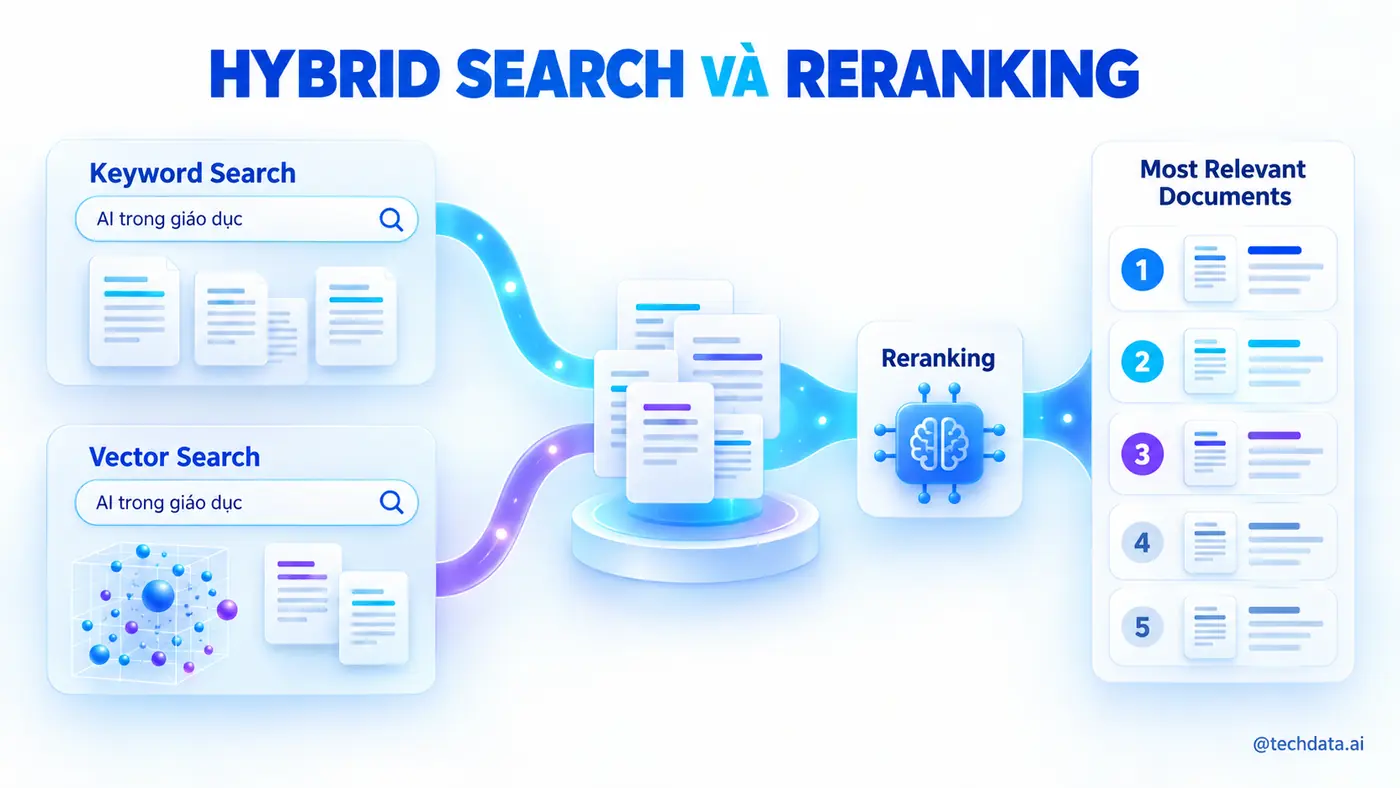
Vector Search mạnh với ý nghĩa gần nhau nhưng có thể yếu với mã sản phẩm, số hợp đồng và từ khóa chính xác. Keyword Search như BM25 xử lý Exact Term tốt. Hybrid Search kết hợp cả hai rồi hợp nhất điểm.
Ví dụ, câu hỏi về "Hợp đồng HD-2026-018" cần Keyword Search tìm đúng mã. Câu hỏi "quy định chấm dứt sớm" phù hợp với Semantic Search. Production RAG thường cần Hybrid Retrieval thay vì chỉ dùng Vector.
Metadata Filtering và Permissions
Metadata Filter thu hẹp theo Tenant, phòng ban, loại tài liệu, ngày hiệu lực và ngôn ngữ. Permission Filter phải được áp dụng trước khi Chunk vào Context. Không thể dựa vào Prompt để yêu cầu Model bỏ qua dữ liệu không có quyền.
ACL có thể thay đổi sau khi Index được tạo. Retrieval Service cần đồng bộ quyền hoặc kiểm tra với Authorization Service tại Query Time. Trace nên ghi Identity, Filter và Document IDs đã trả về mà không ghi lộ nội dung nhạy cảm không cần thiết.
Reranking
Retriever ưu tiên tốc độ và lấy một tập Candidate rộng. Reranker đánh giá sâu hơn mối liên quan giữa Query và từng Chunk rồi sắp xếp lại. Cách này thường tăng chất lượng khi kho tài liệu lớn hoặc câu hỏi có nhiều nghĩa.
Reranking tăng latency và cost, nên cần đo lợi ích. Có thể lấy 30 Candidates bằng Retrieval nhanh, Rerank rồi chọn 5 Chunk tốt nhất. Số lượng không nên được quyết định mà không có Evaluation.
Context Construction
Context Builder đóng gói Chunk, Source, Title, Updated Time và Citation ID. Các nguồn nên được phân tách rõ để Model không trộn nội dung. Nếu tài liệu mâu thuẫn, Context cần ưu tiên bản còn hiệu lực hoặc yêu cầu Model nêu mâu thuẫn.
Query Transformation có thể chuyển câu hỏi hội thoại thành câu độc lập, tách câu hỏi nhiều ý hoặc tạo nhiều truy vấn. Tuy nhiên, câu truy vấn viết lại phải giữ nguyên ràng buộc quan trọng như ngày, khu vực và mã khách hàng.
Citation và Groundedness
Citation cho biết câu trả lời dựa trên Chunk nào. Groundedness đo mức độ các Claim được nguồn hỗ trợ. Một câu trả lời có Link chưa chắc Grounded nếu Link không chứa nội dung được khẳng định.
Hệ thống có thể tách Answer thành Claims rồi kiểm tra từng Claim với nguồn. Claim không có bằng chứng phải bị loại, hạ mức chắc chắn hoặc yêu cầu Retrieval bổ sung. Với nghiệp vụ rủi ro cao, Answer nên trích đúng điều khoản và phiên bản.
Agentic RAG
RAG thông thường chạy một Retrieval cố định. Agentic RAG cho phép Model quyết định khi nào tìm, dùng nguồn nào, viết lại Query và có cần tìm tiếp hay không. Điều này hữu ích với câu hỏi nhiều bước nhưng tăng tính không xác định.
Ví dụ, Agent kiểm tra hợp đồng có thể tìm điều khoản thanh toán, nhận thấy có phụ lục rồi truy xuất phụ lục, sau đó kiểm tra chính sách phê duyệt nội bộ. Orchestrator cần Max Searches, Source Allowlist và điều kiện dừng.
Memory là gì?
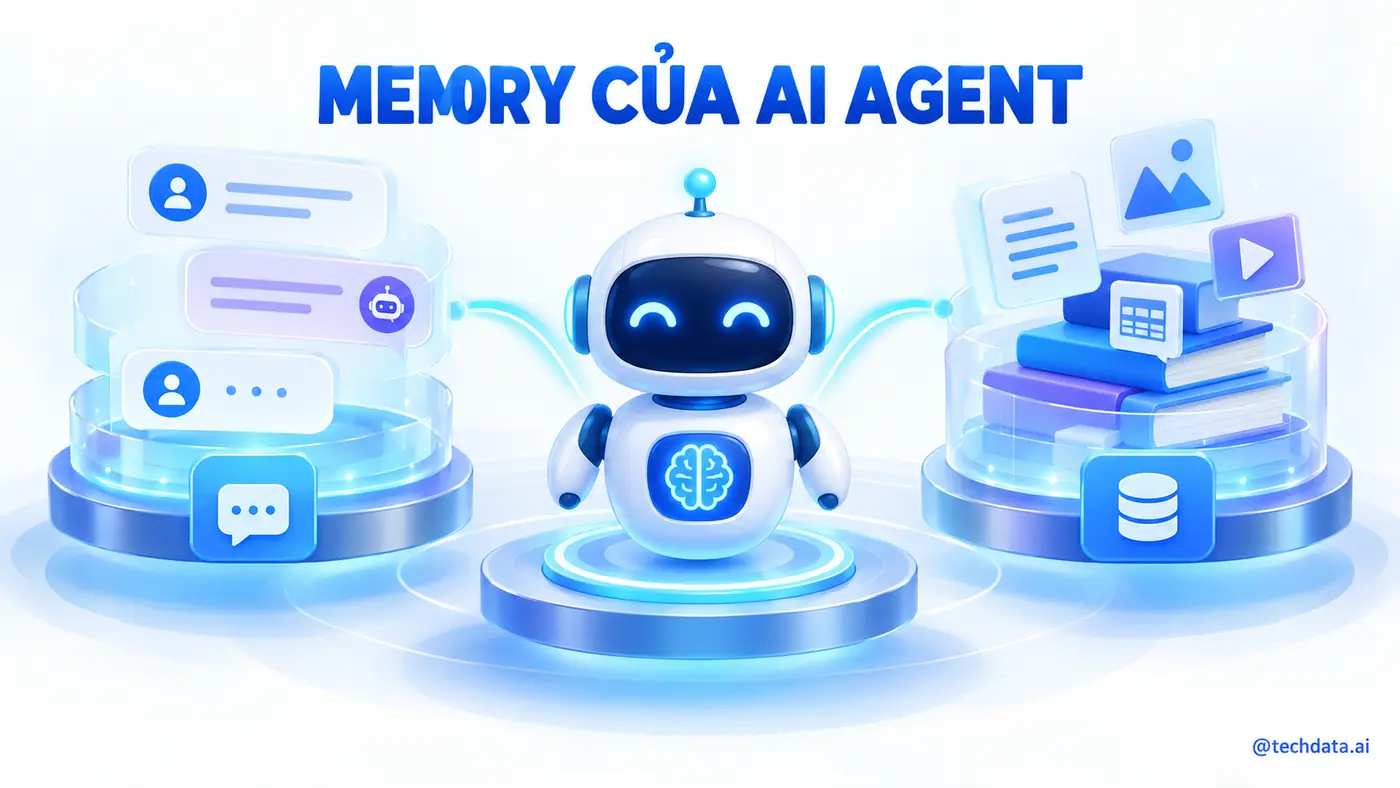
Memory là cơ chế lưu, chọn và đưa thông tin quá khứ trở lại Context. Memory không phải chỉ là lưu toàn bộ Chat History. Một hệ thống Memory phải quyết định thông tin nào đáng lưu, ai được sử dụng, khi nào hết hạn và cách sửa khi sai.
Task State như bước hiện tại và Tool Result thường thuộc State Store. User Preference lâu dài có thể thuộc Memory. Tài liệu chính sách thuộc Knowledge Base. Tách các loại này giúp áp dụng Retention và quyền chính xác.
Các loại Memory
- Working Memory chứa thông tin của Task hiện tại.
- Episodic Memory lưu sự kiện hoặc lần tương tác cụ thể.
- Semantic Memory lưu sự thật hoặc preference đã được xác nhận.
- Procedural Memory biểu diễn quy trình hoặc cách thực hiện công việc.
Cách phân loại mang tính thiết kế. Điều quan trọng là mỗi Record có Source, Timestamp, Owner, Scope, Confidence và Expiry. Một suy luận của Model không nên có độ tin cậy ngang với thông tin người dùng xác nhận.
Memory Write và Memory Retrieval
Memory Write cần Policy. Không lưu mọi câu người dùng nói. Hệ thống có thể chỉ lưu preference rõ ràng, quyết định quan trọng hoặc kết quả đã được xác nhận. Dữ liệu nhạy cảm cần consent và mục đích sử dụng cụ thể.
{
  "memory_id": "mem_1032",
  "type": "user_preference",
  "content": "Ưu tiên báo cáo ngắn theo tuần",
  "source": "user_confirmed",
  "scope": "sales_reporting",
  "created_at": "2026-09-15T09:00:00+07:00",
  "expires_at": null,
  "confidence": 1.0
}
Memory Retrieval có thể dựa trên Semantic Similarity, thời gian, loại nhiệm vụ và mức quan trọng. Sau Retrieval, hệ thống vẫn cần kiểm tra Scope và Permission. Memory lỗi thời phải được đánh dấu thay vì âm thầm dùng lại.
Freshness, Privacy và Retention
Knowledge và Memory đều có vòng đời. Chính sách mới phải thay thế bản cũ. Preference có thể thay đổi. Dữ liệu cá nhân có thể cần xóa theo yêu cầu hoặc hết mục đích. Vì vậy mỗi Record cần Version và Retention Rule.
Không lưu bí mật, Token truy cập hoặc dữ liệu nhạy cảm chỉ vì nó có thể hữu ích. Encryption, access logging và tenant isolation là yêu cầu nền tảng. Memory UI nên cho người dùng xem, sửa và xóa thông tin khi phù hợp.
Evaluation RAG và Memory
RAG Evaluation nên tách Retrieval và Generation. Retrieval đo Recall, Precision, Hit Rate, MRR hoặc nDCG. Generation đo Faithfulness, Answer Relevance, Citation Correctness và Completeness. Nếu nguồn đúng không được Retrieval, sửa Prompt không giải quyết được.
Memory Evaluation đo Write Precision, Retrieval Relevance, Freshness, Contradiction Rate, Privacy Violation và tác động lên Task Success. Một Memory System nhớ nhiều nhưng đưa sai thông tin vào Context có thể làm chất lượng giảm.
Kiến trúc tham khảo
Source systems
  ingestion pipeline
  parser and chunker
  embedding service
  vector and keyword indexes

User request
  identity and permission
  query transformation
  hybrid retrieval
  reranking
  context builder
  model
  answer with citations

Memory service
  write policy
  memory store
  retrieval policy
  retention and deletion
Knowledge Retrieval và Memory Retrieval có thể chạy qua hai Services riêng rồi Context Builder hợp nhất kết quả. Mỗi phần giữ Citation ID và Source Type. Điều này giúp Model phân biệt chính sách chính thức với preference cá nhân.
Kết luận
RAG cung cấp tri thức có nguồn. Memory cung cấp sự liên tục. Cả hai đều không chỉ là Vector Database. Chất lượng phụ thuộc Ingestion, Chunking, Retrieval, Metadata, Permission, Freshness, Context Construction và Evaluation.
Người mới nên bắt đầu với một bộ tài liệu nhỏ có câu hỏi chuẩn. Đo Retrieval trước, thêm Citation, sau đó mới thử Agentic RAG. Với Memory, hãy bắt đầu bằng thông tin được người dùng xác nhận và có schema rõ, không lưu toàn bộ hội thoại một cách thiếu kiểm soát.
Tài liệu tham khảo
- Lewis và cộng sự. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Công trình nền tảng về RAG.
- Google Cloud Architecture Center. RAG-capable generative AI application. Kiến trúc RAG trên môi trường production.
- Microsoft Learn. Retrieval-augmented generation overview. Các thành phần Retrieval, Index và Grounding.
- Pinecone Documentation. Vector database overview. Tài liệu về Vector Search, Metadata và Index.
- Anthropic. Contextual Retrieval. Kỹ thuật bổ sung Context cho Chunk để cải thiện Retrieval.
- NIST AI 600-1. Quản trị rủi ro dữ liệu và Generative AI.
TechData.AI - Leading The Future.
Hoàng Minh.