




Đơn vị biên soạn: TechData.AI
Chủ đề: Kafka Architecture và Capacity Planning
Đối tượng: Data Engineer, Platform Engineer và Backend Developer
Phiên bản tham chiếu: Apache Kafka 4.x
MỤC LỤC
- Mục tiêu bài học
- Topic không chỉ là một thư mục dữ liệu
- Cấu trúc vật lý của Partition
- Offset và thứ tự dữ liệu
- Cách Producer chọn Partition
- Tính số lượng Partition
- Leader, Follower và Replica
- In-Sync Replica và High Watermark
- Replication Factor và min.insync.replicas
- Leader Election và Unclean Election
- Retention và Log Segment
- Log Compaction
- Topic Naming Convention
- Thay đổi số Partition và rủi ro
- Capacity Planning thực tế
- Bài thực hành
- Lỗi thiết kế thường gặp
- Tổng kết
- Câu hỏi ôn tập
- Tài liệu tham khảo
1. Mục tiêu bài học
Topic, Partition và Replication là ba khái niệm quyết định khả năng mở rộng, thứ tự dữ liệu và mức chịu lỗi của Kafka. Một Cluster có thể hoạt động tốt trong giai đoạn thử nghiệm nhưng nhanh chóng gặp Hot Partition, thiếu dung lượng hoặc mất khả năng ghi khi tải tăng nếu ba yếu tố này được thiết kế tùy ý.
Bài này giải thích Kafka lưu record trên ổ đĩa như thế nào, vì sao thứ tự chỉ tồn tại trong một Partition, Replica nào được phép trở thành Leader và cách ước lượng số Partition dựa trên throughput thay vì chọn một con số theo cảm tính.
2. Topic không chỉ là một thư mục dữ liệu
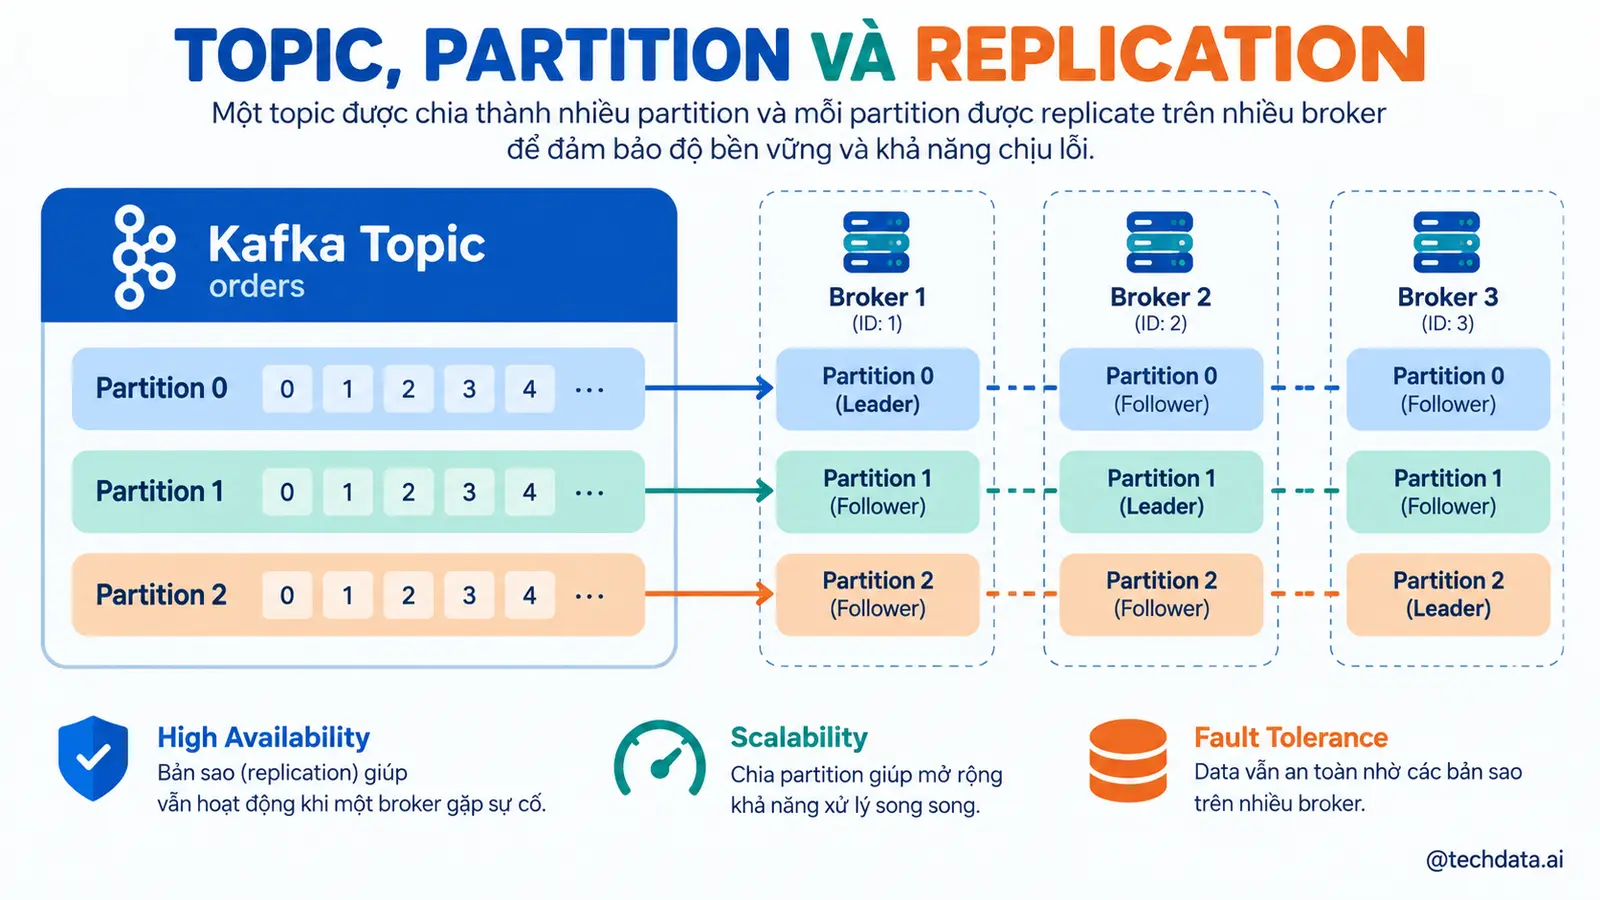
Topic là luồng Event có tên và là ranh giới quản trị quan trọng. Mỗi Topic có cấu hình riêng về Partition, Replication, retention, compaction và kích thước message.
Thiết kế Topic thường bám theo loại sự kiện hoặc miền nghiệp vụ. Ví dụ order-created mô tả sự kiện đơn hàng đã được tạo, trong khi order-events có thể chứa nhiều loại sự kiện của vòng đời đơn hàng.
Topic quá rộng khiến Consumer phải lọc nhiều dữ liệu và schema trở nên phức tạp. Topic quá nhỏ làm số lượng Topic và Partition tăng mạnh, gây áp lực metadata và vận hành. Cần tìm ranh giới dựa trên quyền truy cập, retention, schema, throughput và nhóm Consumer.
Kafka không xem Topic như bảng trong cơ sở dữ liệu. Không nên tạo một Topic cho mỗi khách hàng hoặc mỗi ngày nếu số lượng có thể tăng không kiểm soát.
3. Cấu trúc vật lý của Partition
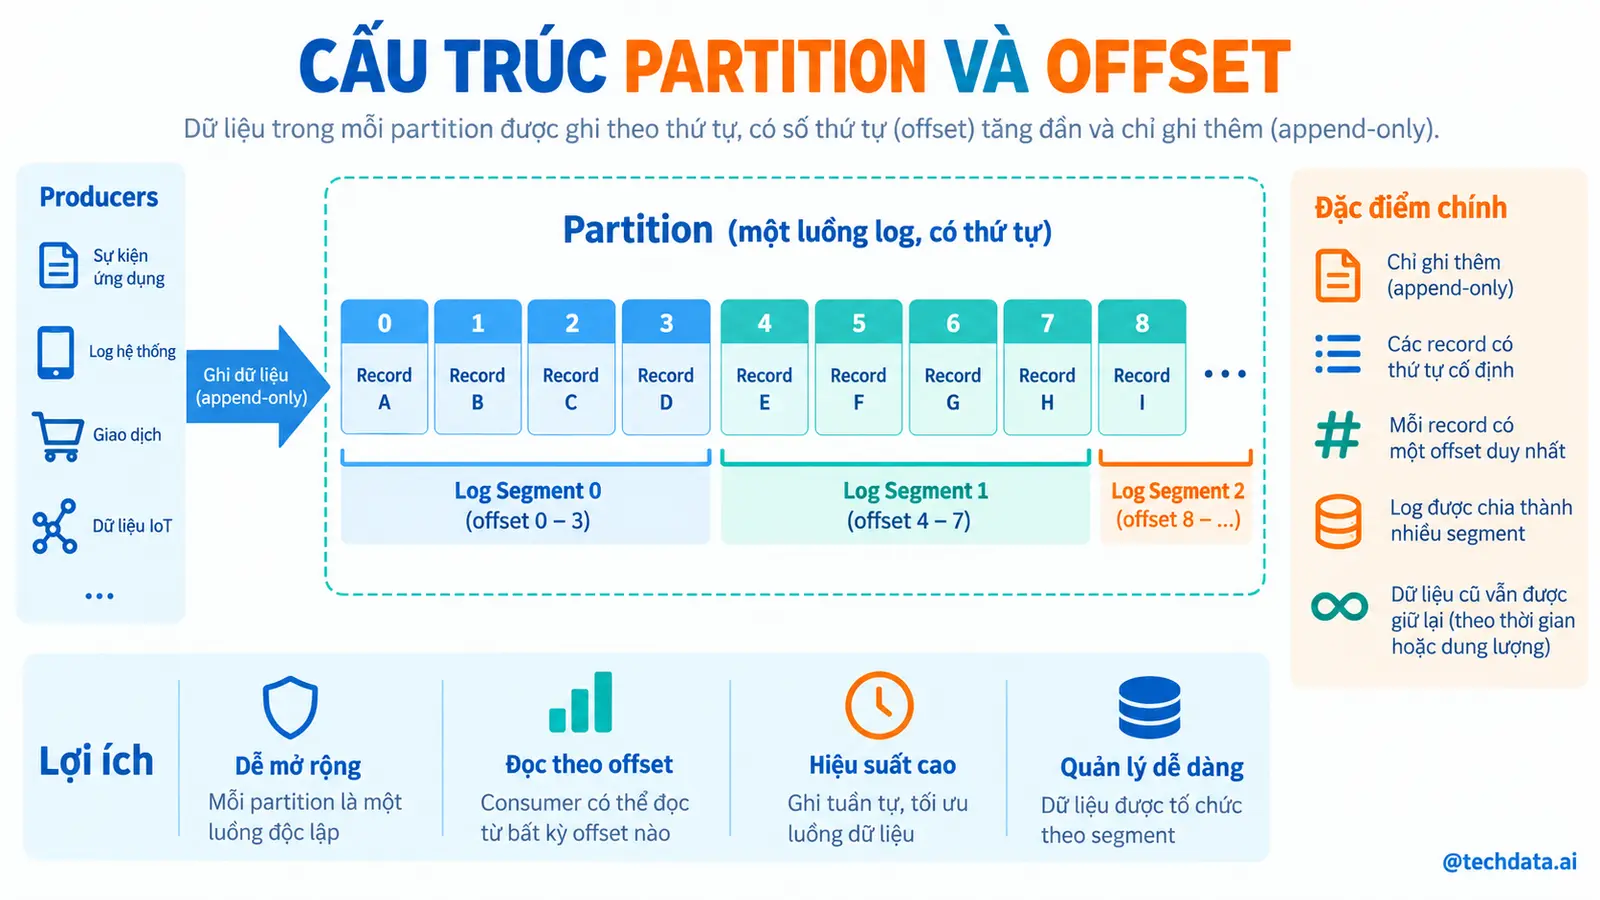
Mỗi Partition là một append-only log. Record mới được ghi vào cuối log và không cập nhật tại chỗ như một hàng trong database.
Trên ổ đĩa, Partition được chia thành nhiều Log Segment. Mỗi Segment có file dữ liệu và các index hỗ trợ tìm record theo Offset hoặc Timestamp. Kafka đóng Segment cũ và tạo Segment mới theo kích thước hoặc thời gian cấu hình.
Cách ghi nối tiếp giúp Kafka sử dụng ổ đĩa hiệu quả. Hệ điều hành tận dụng Page Cache và Kafka có thể truyền dữ liệu từ file ra network với ít lần sao chép bộ nhớ.
Partition cũng là đơn vị:
- Replication.
- Leader Election.
- Phân công cho Consumer.
- Duy trì thứ tự.
- Di chuyển dữ liệu giữa Broker.
Vì vậy, tăng số Partition làm tăng song song nhưng cũng tăng số Replica, file, request và công việc quản lý metadata.
4. Offset và thứ tự dữ liệu
Offset là số thứ tự của record trong một Partition. Offset tăng dần nhưng không mang ý nghĩa nghiệp vụ. Nếu record bị xóa theo retention, Offset không được đánh số lại.
Kafka bảo đảm thứ tự record trong một Partition theo thứ tự được ghi thành công. Kafka không đưa ra một thứ tự tổng thể giữa nhiều Partition.
Giả sử sự kiện order_paid nằm ở Partition 0 và order_cancelled nằm ở Partition 2. Không thể dùng Offset để kết luận sự kiện nào xảy ra trước vì hai Partition có dãy Offset độc lập.
Nếu thứ tự của cùng một đơn hàng quan trọng, mọi sự kiện của đơn hàng phải sử dụng cùng Key và chiến lược partitioning nhất quán.
Timestamp vẫn cần được lưu trong Event để xử lý Event Time, nhưng Timestamp không thay thế thứ tự ghi của Partition. Đồng hồ giữa các hệ thống có thể lệch và Event có thể đến muộn.
5. Cách Producer chọn Partition
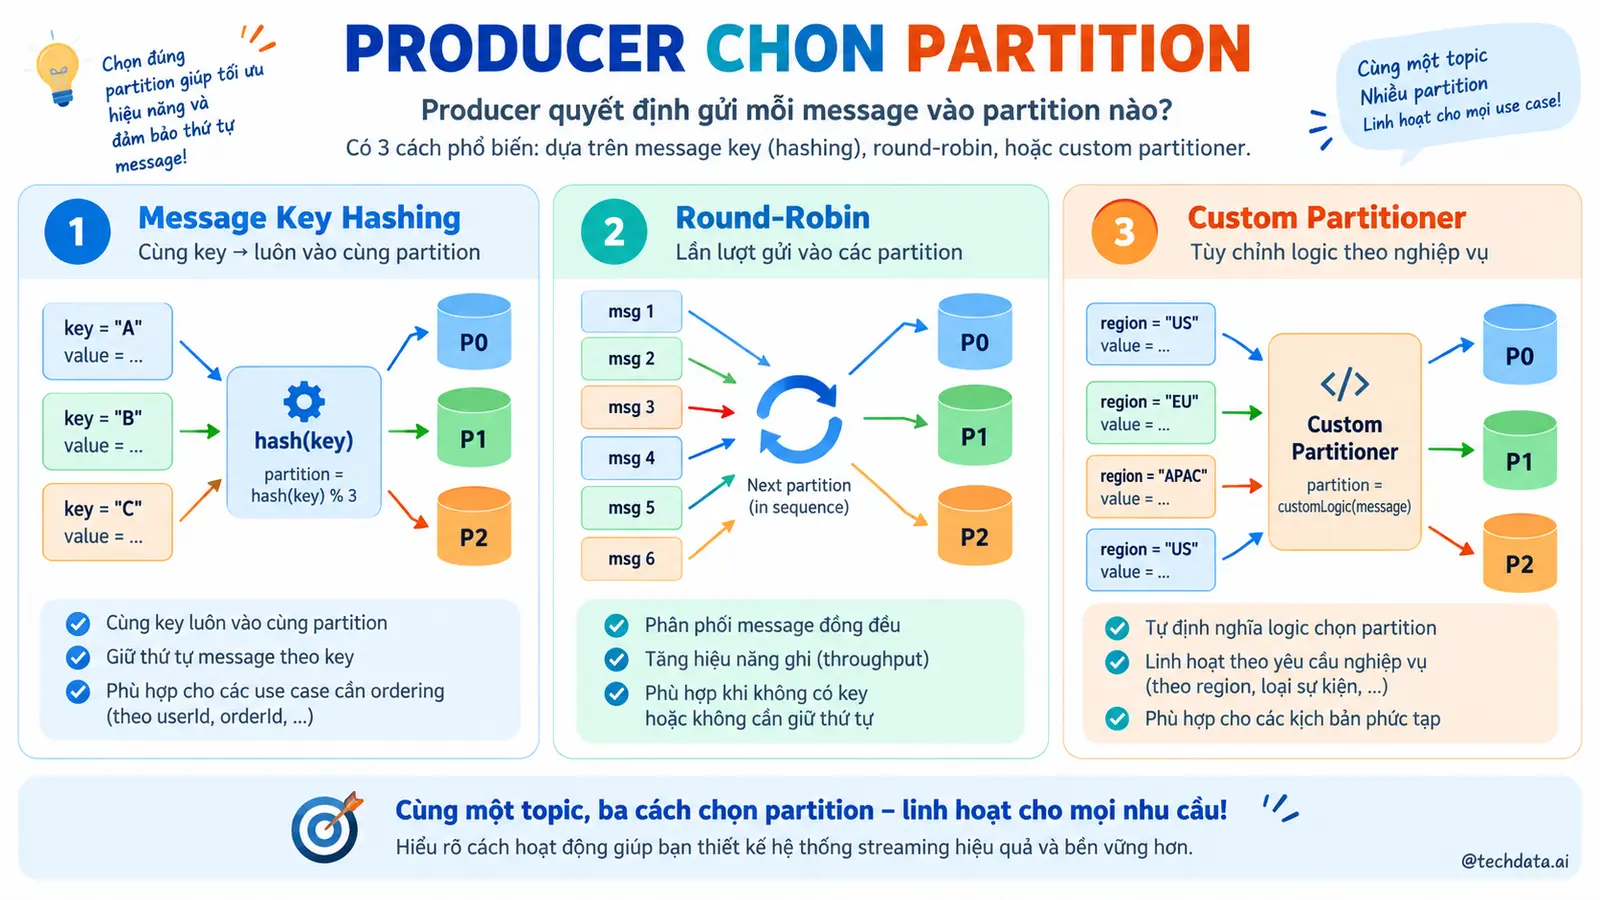
Producer có thể chọn Partition theo ba cách chính:
- Chỉ định trực tiếp Partition.
- Dùng Key và Partitioner.
- Không có Key và để Client phân phối record.
Chỉ định Partition trực tiếp làm ứng dụng phụ thuộc chặt vào số Partition và thường không nên dùng trừ trường hợp đặc biệt.
Với Key, Client tính hash rồi ánh xạ sang số Partition. Cùng Key và cùng số Partition thường cho cùng kết quả. Đây là cơ chế phổ biến để giữ thứ tự theo Business Key.
Không có Key, Producer hiện đại có thể giữ record trong một Partition đủ lâu để tạo batch lớn, sau đó chuyển sang Partition khác. Cách này cải thiện batching tốt hơn Round Robin từng record.
Custom Partitioner chỉ nên dùng khi có yêu cầu rõ, chẳng hạn định tuyến theo vùng dữ liệu. Logic tùy chỉnh cần tránh tạo phân phối lệch và phải được quản lý nhất quán giữa các Producer.
6. Tính số lượng Partition
Không có công thức duy nhất, nhưng có thể ước lượng từ throughput.
Giả sử Topic cần nhận 120 MB mỗi giây. Qua benchmark, một Partition trên hạ tầng hiện tại ghi ổn định 15 MB mỗi giây. Số Partition tối thiểu theo Producer throughput là:
120 / 15 = 8 PartitionNếu một Consumer xử lý được 10 MB mỗi giây và tổng tốc độ đọc yêu cầu là 120 MB mỗi giây, nhu cầu theo Consumer là 12 Partition.
Ta chọn giá trị lớn hơn, sau đó bổ sung biên an toàn cho tăng trưởng và sự cố.
Cần benchmark vì throughput mỗi Partition phụ thuộc kích thước record, compression, acks, Replication Factor, ổ đĩa, CPU, network và hành vi Consumer.
Các câu hỏi cần trả lời:
- Peak throughput là bao nhiêu?
- Một Partition xử lý được bao nhiêu trên hạ tầng thật?
- Cần bao nhiêu Consumer song song?
- Có bao nhiêu Group đọc Topic?
- Key có phân phối đều không?
- Dự báo tăng trưởng trong bao lâu?
- Thời gian khôi phục khi Broker hỏng là bao nhiêu?
Không nên tạo hàng nghìn Partition chỉ để phòng xa nếu chưa đánh giá chi phí metadata, file handle, Rebalance và Recovery.
7. Leader, Follower và Replica
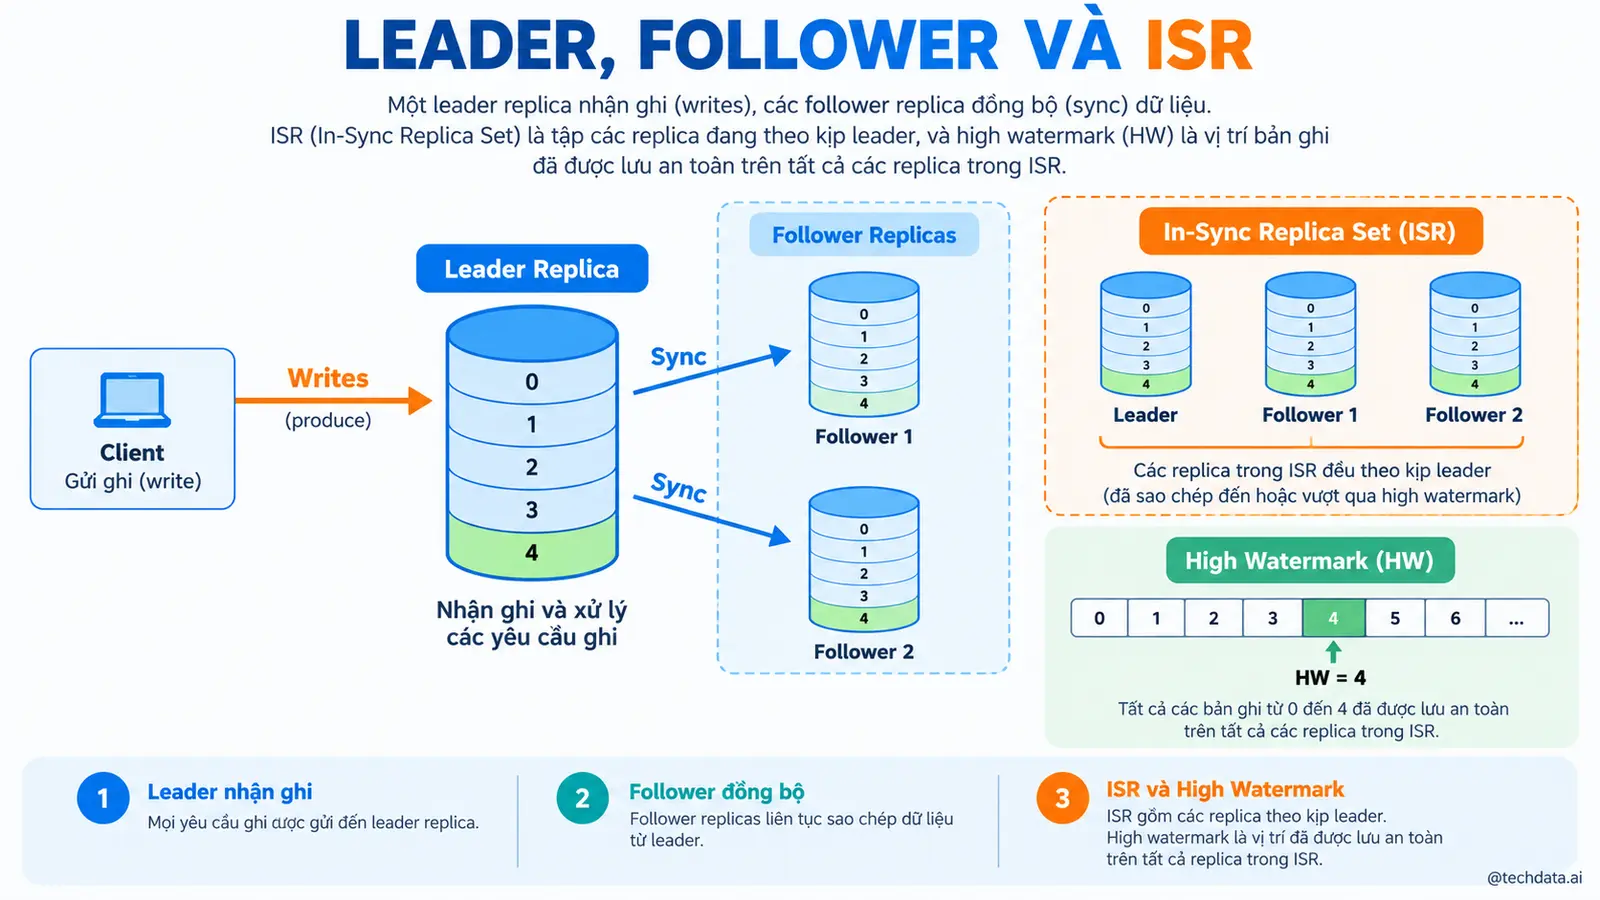
Mỗi Partition có một Leader Replica và có thể có nhiều Follower Replica. Producer và Consumer giao tiếp với Replica phù hợp theo giao thức và cấu hình, trong đó Leader giữ vai trò trung tâm cho việc ghi.
Follower lấy dữ liệu từ Leader và duy trì bản sao. Replica của cùng Partition phải nằm trên các Broker khác nhau để sự cố một Broker không xóa toàn bộ bản sao.
Replication Factor bằng 3 nghĩa mỗi Partition có ba Replica. Nếu Topic có 12 Partition, tổng cộng có 36 Replica được phân phối trên Cluster.
Replication tăng khả năng chịu lỗi nhưng làm tăng:
- Dung lượng lưu trữ.
- Network giữa Broker.
- I/O ghi.
- Thời gian di chuyển và phục hồi dữ liệu.
Replication Factor cần dựa trên mức quan trọng của dữ liệu và số Broker. Không thể tạo ba Replica trên Cluster chỉ có hai Broker.
8. In-Sync Replica và High Watermark
In-Sync Replica là tập Replica đang theo kịp Leader trong giới hạn Kafka cho phép. Tập này được gọi là ISR.
Follower quá chậm hoặc mất kết nối sẽ bị loại khỏi ISR. Khi phục hồi và bắt kịp Leader, nó có thể được thêm lại.
High Watermark thể hiện ranh giới dữ liệu đã được replicate đủ để Consumer đọc an toàn theo cơ chế của Kafka. Record phía sau ranh giới này có thể chưa xuất hiện cho Consumer dù Leader đã nhận.
Theo dõi số Under Replicated Partition và ISR Shrink rất quan trọng. Nếu Replica thường xuyên rời ISR, Cluster có thể đang thiếu I/O, network không ổn định hoặc Broker quá tải.
9. Replication Factor và min.insync.replicas
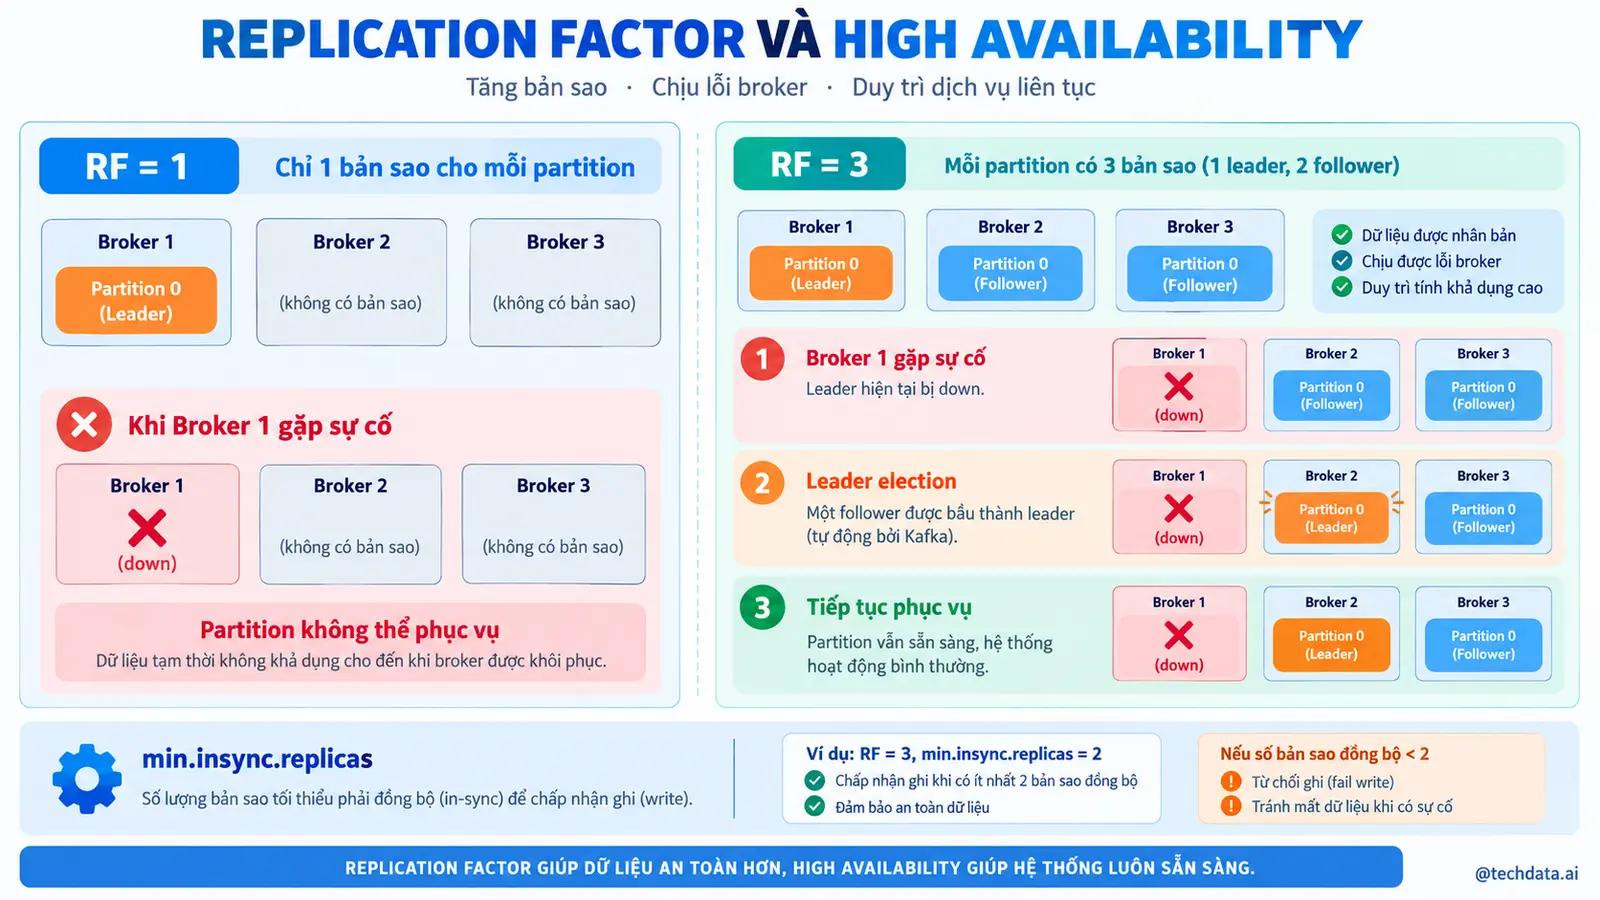
Replication Factor xác định tổng số bản sao. min.insync.replicas xác định số Replica tối thiểu phải còn trong ISR để yêu cầu ghi với acks=all được chấp nhận.
Một cấu hình phổ biến cho dữ liệu quan trọng:
replication.factor=3
min.insync.replicas=2
producer acks=all
Nếu còn ít nhất hai Replica đồng bộ, ghi tiếp tục. Nếu chỉ còn một, Kafka từ chối ghi để tránh xác nhận dữ liệu với mức bảo vệ không đủ.
Đây là đánh đổi giữa Availability và Durability. Giảm min.insync.replicas có thể giữ hệ thống ghi được khi nhiều Broker hỏng nhưng tăng nguy cơ mất dữ liệu. Tăng giá trị bảo vệ dữ liệu tốt hơn nhưng hệ thống có thể ngừng ghi sớm hơn.
Ba cấu hình phải được xem cùng nhau. Replication Factor bằng 3 không có nhiều ý nghĩa nếu Producer dùng acks=1 và doanh nghiệp chấp nhận Leader xác nhận trước khi Follower bắt kịp.
10. Leader Election và Unclean Election
Khi Leader không còn hoạt động, Controller chọn Leader mới. Lựa chọn an toàn là một Replica trong ISR vì nó có dữ liệu đã được xác nhận đầy đủ.
Unclean Leader Election cho phép một Replica ngoài ISR trở thành Leader trong tình huống không còn Replica đồng bộ. Hệ thống có thể hoạt động trở lại nhưng một phần dữ liệu đã xác nhận có nguy cơ bị mất.
Với dữ liệu tài chính, thanh toán hoặc đơn hàng, thường ưu tiên tính đúng và không cho Replica cũ làm Leader. Với dữ liệu có thể tái tạo và yêu cầu Availability cao, tổ chức có thể đưa ra quyết định khác.
Đây phải là quyết định quản trị rủi ro, không phải thay đổi cấu hình trong lúc sự cố mà không hiểu hậu quả.
11. Retention và Log Segment
Kafka xóa dữ liệu theo chính sách retention, không dựa vào việc Consumer đã đọc xong.
Time-based Retention xóa Segment cũ sau một khoảng thời gian. Size-based Retention giới hạn tổng dung lượng Partition. Kafka đánh giá Segment, không xóa từng record ngay khi vượt thời gian.
Ví dụ:
retention.ms=604800000
retention.bytes=-1
Topic giữ dữ liệu khoảng bảy ngày và không đặt giới hạn riêng theo dung lượng.
Retention cần tính theo nhu cầu replay, thời gian tối đa Consumer có thể ngừng, yêu cầu kiểm toán và chi phí ổ đĩa. Nếu Consumer ngừng lâu hơn retention, Offset của nó có thể trỏ vào dữ liệu đã bị xóa.
Không nên dùng Kafka làm kho lưu trữ duy nhất cho mọi dữ liệu lịch sử. Dữ liệu dài hạn thường được đưa vào Object Storage, Data Lake hoặc Data Warehouse.
12. Log Compaction
Log Compaction giữ lại giá trị mới nhất của mỗi Key thay vì chỉ dựa trên tuổi record. Nó phù hợp với Topic biểu diễn trạng thái hiện tại, chẳng hạn cấu hình khách hàng hoặc trạng thái tài khoản.
Ví dụ:
customer_id=CUS-001, tier=gold
customer_id=CUS-001, tier=platinum
Sau compaction, Kafka có thể loại bản cũ và giữ trạng thái mới nhất của CUS-001.
Tombstone là record có Key nhưng Value bằng null, dùng để biểu thị xóa Key. Tombstone cũng được giữ một thời gian trước khi compaction loại bỏ.
Compaction không xảy ra ngay lập tức và không bảo đảm Topic chỉ còn đúng một record cho mỗi Key tại mọi thời điểm. Consumer vẫn phải chịu được bản ghi cũ và cập nhật lặp.
Topic có thể cấu hình cleanup.policy=delete, compact hoặc kết hợp cả hai tùy use case.
13. Topic Naming Convention
Tên Topic nên nhất quán và có khả năng mở rộng. Một quy ước có thể gồm:
environment.domain.entity.event.versionVí dụ:
prod.ecommerce.order.created.v1
prod.payment.transaction.completed.v1
dev.ecommerce.order.created.v1
Không phải tổ chức nào cũng cần đưa environment vào tên nếu Cluster đã tách biệt. Điều quan trọng là quy ước phản ánh:
- Chủ sở hữu Domain.
- Ý nghĩa Event.
- Phiên bản khi cần.
- Môi trường hoặc mức dữ liệu nếu cần.
- Quy tắc quyền truy cập và retention.
Nên có Topic Catalog ghi owner, schema, SLA, retention, classification, Producer và Consumer chính.
14. Thay đổi số Partition và rủi ro
Kafka cho phép tăng số Partition nhưng không hỗ trợ giảm trực tiếp. Tăng Partition có thể thay đổi kết quả ánh xạ Key sang Partition.
Nếu trước đây Key ORD-10001 vào Partition 1, sau khi tăng số Partition, record mới của Key đó có thể vào Partition khác. Thứ tự toàn vòng đời của Key không còn được giữ trên một Partition.
Khi Ordering quan trọng, có thể:
- Chọn số Partition có dư địa ngay từ đầu.
- Tạo Topic phiên bản mới và migrate có kiểm soát.
- Dùng custom mapping ổn định nếu thực sự cần.
- Thiết kế Consumer xử lý version và Event Time.
Việc tăng Partition cũng gây Rebalance và làm thay đổi assignment Consumer.
15. Capacity Planning thực tế
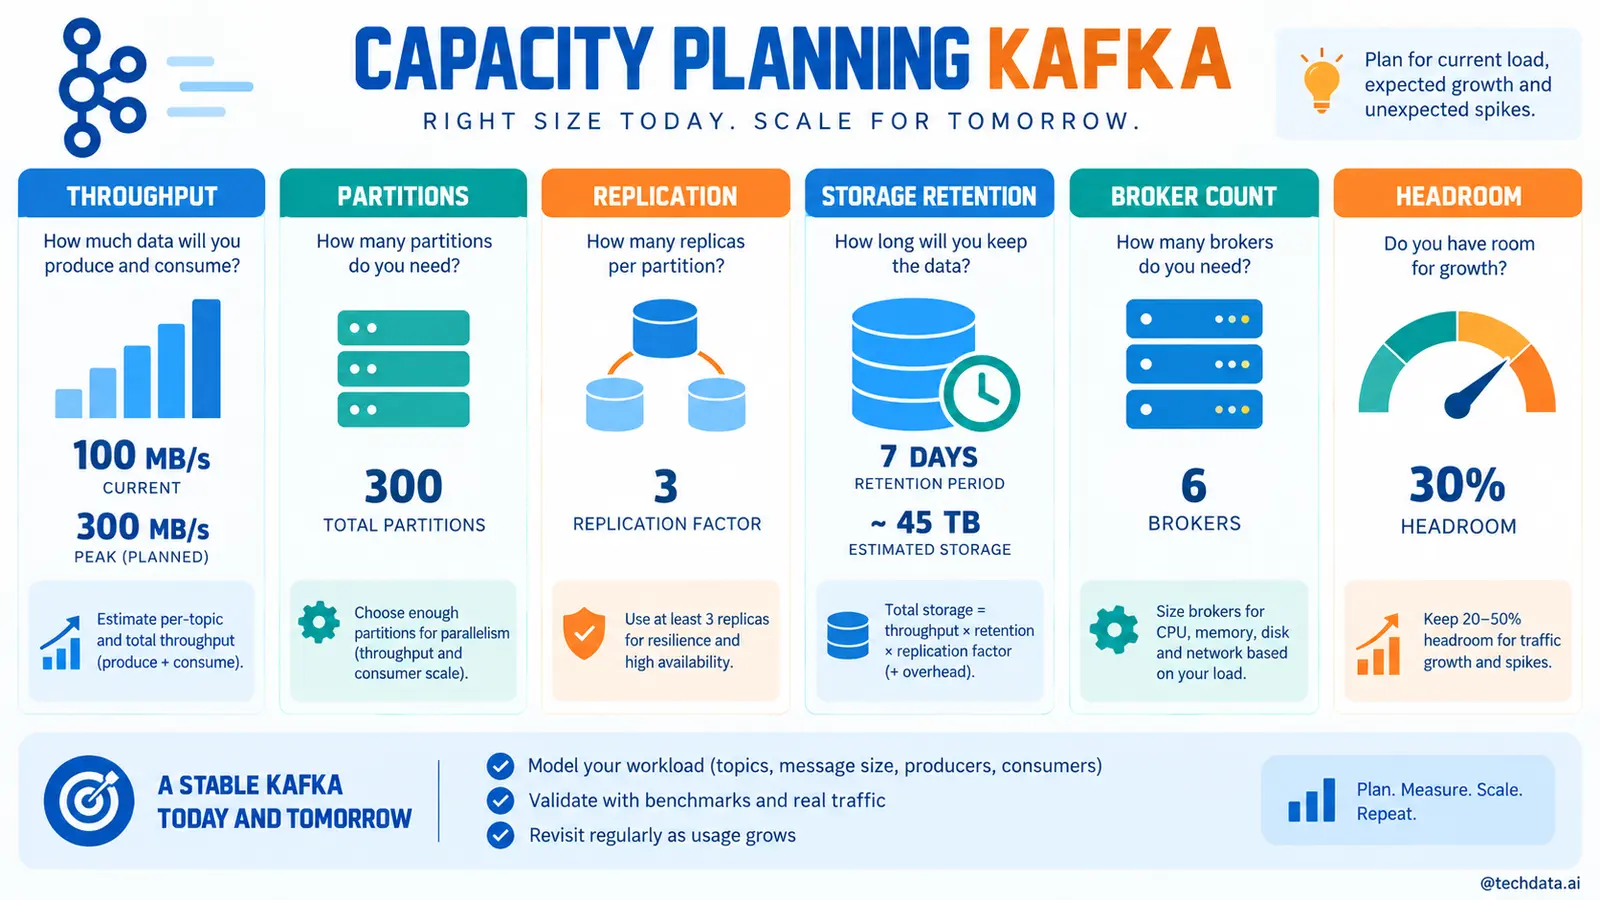
Dung lượng thô có thể ước lượng:
storage = ingest_per_day x retention_days x replication_factorNếu hệ thống nhận 500 GB mỗi ngày, giữ 7 ngày và Replication Factor bằng 3:
500 GB x 7 x 3 = 10.5 TBCần cộng thêm biên an toàn, index, tăng trưởng, dữ liệu chưa compact và khoảng trống để Broker phục hồi. Không nên vận hành ổ đĩa gần 100 phần trăm vì khi một Broker hỏng, Cluster cần chỗ để tái phân phối Replica.
Compression có thể giảm dung lượng đáng kể nhưng tỷ lệ phụ thuộc payload. Hãy benchmark dữ liệu thật.
Network phải chịu cả lưu lượng Producer, Consumer và Replication. Một Event được nhiều Consumer Group đọc sẽ tạo lưu lượng đọc nhiều lần dù chỉ lưu một lần cho mỗi Replica.
16. Bài thực hành
Tạo ba Topic:
order-events
customer-state
application-logs
Yêu cầu:
order-eventscó sáu Partition và retention bảy ngày.customer-statesử dụng Log Compaction.application-logsgiữ dữ liệu hai ngày.- Gửi Event có Key và không có Key.
- Quan sát phân phối Partition bằng Console Consumer.
- Mô tả Topic và giải thích Leader, Replica, ISR.
- Tính dung lượng cho lưu lượng 100 GB mỗi ngày, retention 14 ngày và Replication Factor bằng 3.
17. Lỗi thiết kế thường gặp
- Chọn một Partition rồi kỳ vọng scale nhiều Consumer.
- Tạo quá nhiều Partition từ ngày đầu mà không benchmark.
- Dùng Key có độ lệch lớn và tạo Hot Partition.
- Nghĩ Replication Factor bằng 3 tự động ngăn mọi mất dữ liệu.
- Đặt retention ngắn hơn thời gian phục hồi Consumer.
- Tăng Partition mà không đánh giá ảnh hưởng đến Key Ordering.
- Dùng Kafka làm nơi lưu file lớn hoặc lịch sử vô hạn.
- Không có owner và catalog cho Topic.
18. Tổng kết
Topic tổ chức luồng Event, Partition tạo khả năng song song và Replica tạo khả năng chịu lỗi. Ba thành phần này phải được thiết kế cùng Producer, Consumer và hạ tầng.
Các điểm cần nhớ:
- Kafka chỉ bảo đảm thứ tự trong một Partition.
- Key quyết định phân phối và ranh giới Ordering.
- Số Partition giới hạn mức song song của Consumer Group.
- ISR gồm những Replica đang theo kịp Leader.
- Replication Factor,
min.insync.replicasvàackscần được cấu hình đồng bộ. - Retention xóa Segment theo thời gian hoặc dung lượng.
- Compaction giữ trạng thái mới nhất theo Key.
- Tăng số Partition có thể thay đổi ánh xạ Key.
Bài tiếp theo sẽ phân tích Delivery Semantics, Idempotence, Transaction và thiết kế Exactly Once trong phạm vi phù hợp.
19. Câu hỏi ôn tập
- Vì sao Kafka chỉ bảo đảm thứ tự trong một Partition?
- Một Topic 12 Partition và Replication Factor 3 có bao nhiêu Replica?
- ISR khác tổng số Replica như thế nào?
min.insync.replicasảnh hưởng khả năng ghi ra sao?- Log Compaction khác Time-based Retention như thế nào?
- Vì sao tăng Partition có thể phá vỡ thứ tự theo Key?
- Những yếu tố nào quyết định số Partition?
- Vì sao cần chừa dung lượng trống khi capacity planning?
20. Tài liệu tham khảo
- Apache Kafka Design: https://kafka.apache.org/documentation/#design
- Apache Kafka Topic Configurations: https://kafka.apache.org/documentation/#topicconfigs
- Apache Kafka Replication: https://kafka.apache.org/documentation/#replication
- Apache Kafka Log Compaction: https://kafka.apache.org/documentation/#compaction
- Apache Kafka Operations: https://kafka.apache.org/documentation/#operations