



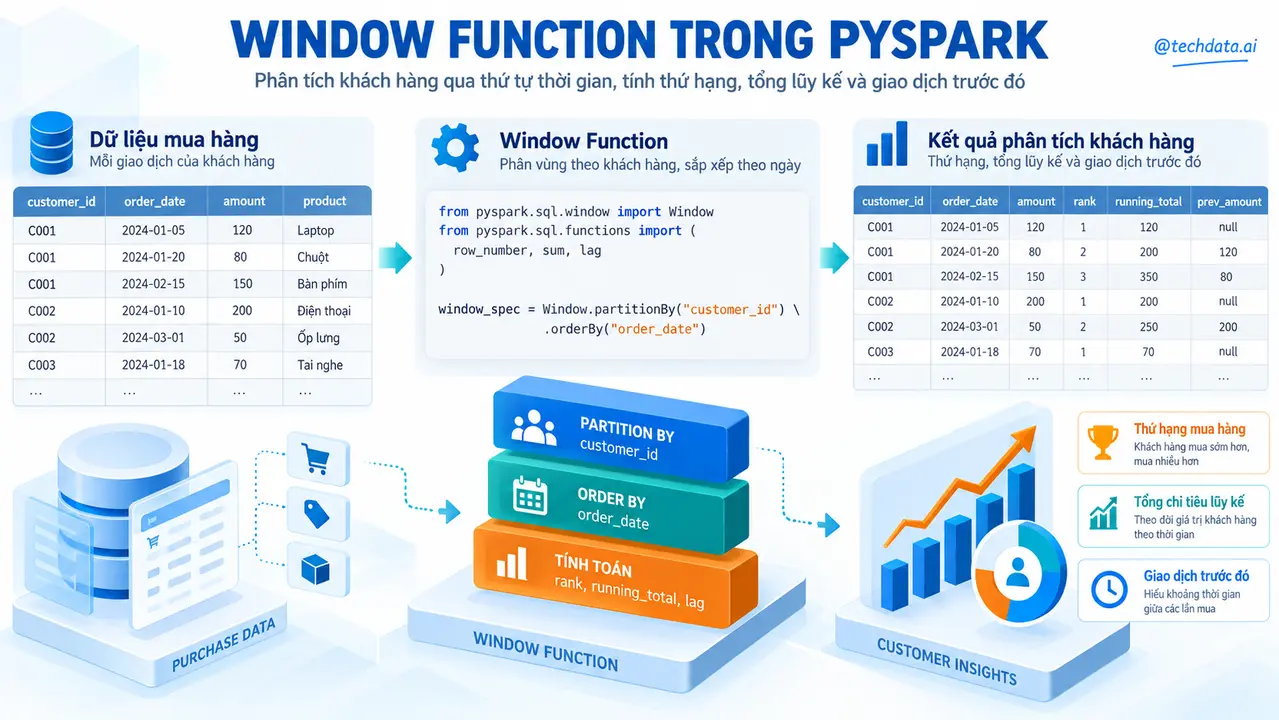

Window Function trong PySpark cho phép tính toán theo nhóm mà vẫn giữ lại từng dòng dữ liệu, phù hợp với xếp hạng, giá trị tích lũy và phân tích chuỗi hành vi. Project trong bài tính lần mua gần nhất, khoảng cách giữa hai đơn, doanh thu tích lũy và thứ hạng khách hàng theo từng khu vực từ dữ liệu giao dịch mẫu.
Mục lục
- Bài toán thực tế
- Sau bài này bạn sẽ làm được gì?
- Kiến thức Spark cần dùng
- Chuẩn bị môi trường
- Hiểu dữ liệu đầu vào
- Xây dựng ứng dụng từng bước
- Ghép thành chương trình hoàn chỉnh
- Kiểm tra kết quả
- Những lỗi thường gặp
- Nâng cấp từ demo thành pipeline thực tế
- Bài tập thực hành
- Project mở rộng
- Tổng kết
- Tài liệu tham khảo
1. Bài toán thực tế
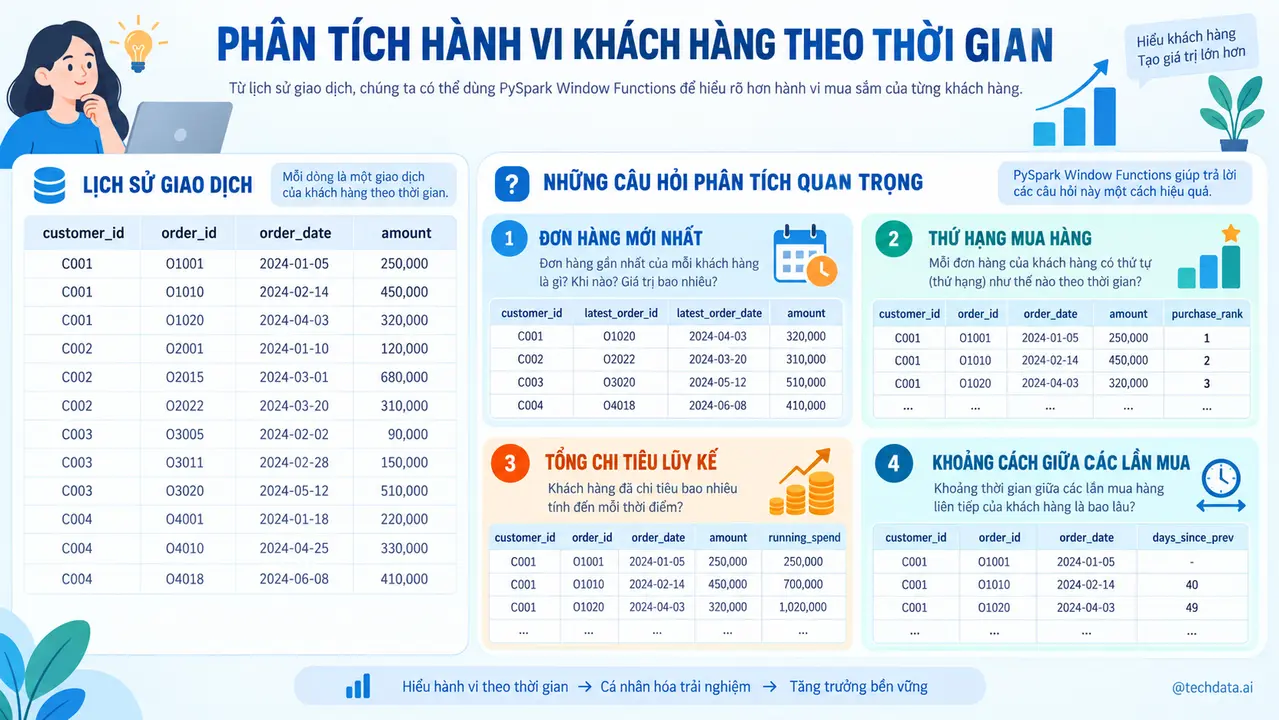
Một doanh nghiệp bán lẻ nhận dữ liệu Parquet từ nhiều hệ thống vận hành. Mỗi ngày có thể phát sinh từ vài trăm nghìn đến hàng chục triệu bản ghi. Nhóm dữ liệu cần tính lần mua gần nhất, tổng chi tiêu, thứ hạng và nhóm khách hàng, nhưng quy trình cũ chạy trên một máy đơn, phụ thuộc bộ nhớ và thường thất bại khi lượng dữ liệu tăng hoặc khi một file có schema khác dự kiến.
Vấn đề không chỉ nằm ở tốc độ. Pipeline phải giữ được grain của dữ liệu, không tính trùng giao dịch, tách bản ghi lỗi, ghi kết quả có thể chạy lại và cung cấp số liệu kiểm soát. Spark phù hợp khi dữ liệu vượt khả năng xử lý ổn định của một tiến trình đơn, khi cần chia việc trên nhiều partition hoặc khi cùng một logic phải mở rộng lên cluster. Với vài trăm MB và một job chạy không thường xuyên, DuckDB, Polars hoặc một câu SQL trong database có thể đơn giản hơn.
Project chọn DataFrame API và Spark SQL vì Catalyst có thể tối ưu logical plan và Spark có thể phân phối scan, join, aggregation trên nhiều task. Quyết định dùng Spark vẫn phải dựa trên thời gian chạy, chi phí vận hành, kỹ năng đội ngũ và khả năng quan sát job, không dựa trên nhãn Big Data.
2. Sau bài này bạn sẽ làm được gì?
Sản phẩm cuối cùng là một project chạy local nhận dữ liệu Parquet, áp dụng schema tường minh, làm sạch và tính lần mua gần nhất, tổng chi tiêu, thứ hạng và nhóm khách hàng. Dữ liệu hợp lệ được ghi ở định dạng Parquet; dữ liệu lỗi được ghi vào vùng quarantine cùng nguyên nhân. Chương trình xuất audit gồm số dòng đầu vào, hợp lệ, lỗi, trùng lặp và số partition.
- Tạo SparkSession với cấu hình local có thể thay bằng cấu hình cluster.
- Đọc dữ liệu bằng schema tường minh và kiểm tra cột bắt buộc.
- Chuẩn hóa timestamp, số tiền, mã định danh và trạng thái nghiệp vụ.
- Không dùng collect hoặc toPandas cho dữ liệu chi tiết.
- Ghi đầu ra theo partition hợp lý và kiểm tra bằng Spark SQL.
- Đọc execution plan, nhận diện shuffle và xác nhận kết quả trên Spark UI.
Phiên bản áp dụng là Apache Spark 3.5.3, PySpark 3.5.3, Python 3.11 và Java 17. Dataset mẫu có 100.000 dòng khi chạy local; phần production giả định từ 100 triệu dòng mỗi ngày để phân tích partition, shuffle và chiến lược ghi.
3. Kiến thức Spark cần dùng
SparkSession là điểm vào của ứng dụng. DataFrame biểu diễn dữ liệu có schema và các phép biến đổi. Transformation như select, filter, join và groupBy chỉ xây dựng kế hoạch; Spark bắt đầu thực thi khi gặp action như count, write hoặc show. Cơ chế này gọi là lazy evaluation và cho phép Catalyst tối ưu toàn bộ kế hoạch trước khi chạy.
Partition là đơn vị dữ liệu được một task xử lý. Narrow transformation như filter thường không chuyển dữ liệu giữa các partition. Wide transformation như groupBy, distinct, orderBy và phần lớn join có thể tạo shuffle, nghĩa là dữ liệu phải trao đổi qua mạng và ghi file trung gian. Shuffle không phải lỗi, nhưng cần được quan sát vì thường là phần tốn thời gian và tài nguyên nhất.
Project ưu tiên hàm tích hợp của Spark SQL. Python UDF làm giảm khả năng tối ưu và tạo chi phí chuyển dữ liệu giữa JVM với Python, vì vậy chỉ nên dùng khi không có biểu thức DataFrame tương đương. Broadcast join phù hợp khi một phía đủ nhỏ để gửi đến từng executor; quyết định phải dựa trên kích thước thực tế và plan.
4. Chuẩn bị môi trường
Môi trường tham chiếu sử dụng Apache Spark 3.5.3, PySpark 3.5.3, Python 3.11 và Java 17 trên macOS, Linux hoặc Windows qua WSL2. Java và Python phải nằm trong dải tương thích của bản Spark đang dùng. Với project có Kafka hoặc Delta, package bổ sung phải cùng nhánh Spark và Scala; không sao chép ngẫu nhiên tọa độ Maven từ một phiên bản khác.
python -m venv .venv
source .venv/bin/activate
python -m pip install pyspark==3.5.3 pytest==8.3.3
window_customer/
data/input/
data/output/
data/quarantine/
src/main.py
tests/test_transformations.py
requirements.txt
README.mdspark-submit --master local[*] --conf spark.sql.adaptive.enabled=true src/main.py --input data/input --output data/outputChế độ local[*] dùng các core của máy phát triển và không phải cấu hình production. Kiểm tra cài đặt bằng cách in spark.version, tạo DataFrame ba dòng và gọi show. Nếu SparkSession không khởi tạo, kiểm tra java -version, JAVA_HOME và phiên bản pyspark trước khi sửa logic nghiệp vụ.
5. Hiểu dữ liệu đầu vào
Dataset mẫu có các cột event_id, order_id, customer_id, product_id, store_id, event_time, status, quantity, unit_price và discount_amount. Grain là một dòng sản phẩm trong một đơn hàng tại một thời điểm sự kiện. Khóa kỹ thuật event_id phải duy nhất; order_id không duy nhất vì một đơn có nhiều sản phẩm.
Các lỗi chủ động được đưa vào dữ liệu mẫu gồm event_id trùng, customer_id rỗng, timestamp sai định dạng, quantity bằng không, giá âm, giảm giá lớn hơn thành tiền và trạng thái ngoài miền cho phép. Nếu để Spark tự inferSchema từ một phần file, cùng một cột có thể bị suy luận khác giữa các đợt dữ liệu. Production nên định nghĩa StructType, quản lý thay đổi schema và dừng job khi thiếu cột bắt buộc.
Phân bố khóa cũng quan trọng như schema. Một store_id chiếm tỷ trọng lớn có thể tạo partition lệch sau groupBy. File cực nhỏ làm tăng chi phí liệt kê và lập lịch. Trước khi tối ưu, cần đo số file, dung lượng, số partition, phân bố theo khóa và tỷ lệ null thay vì chỉ nhìn tổng số dòng.
6. Xây dựng ứng dụng từng bước
Trọng tâm project: thiết kế WindowSpec đúng partition và thứ tự
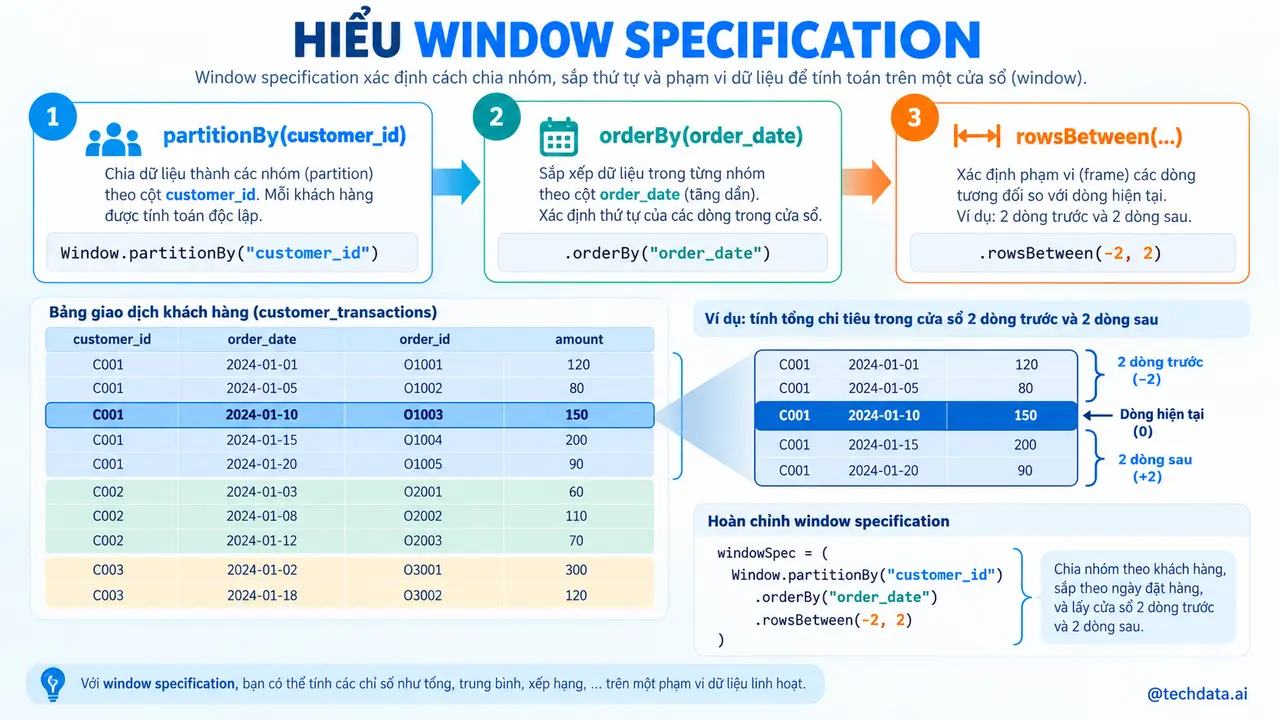
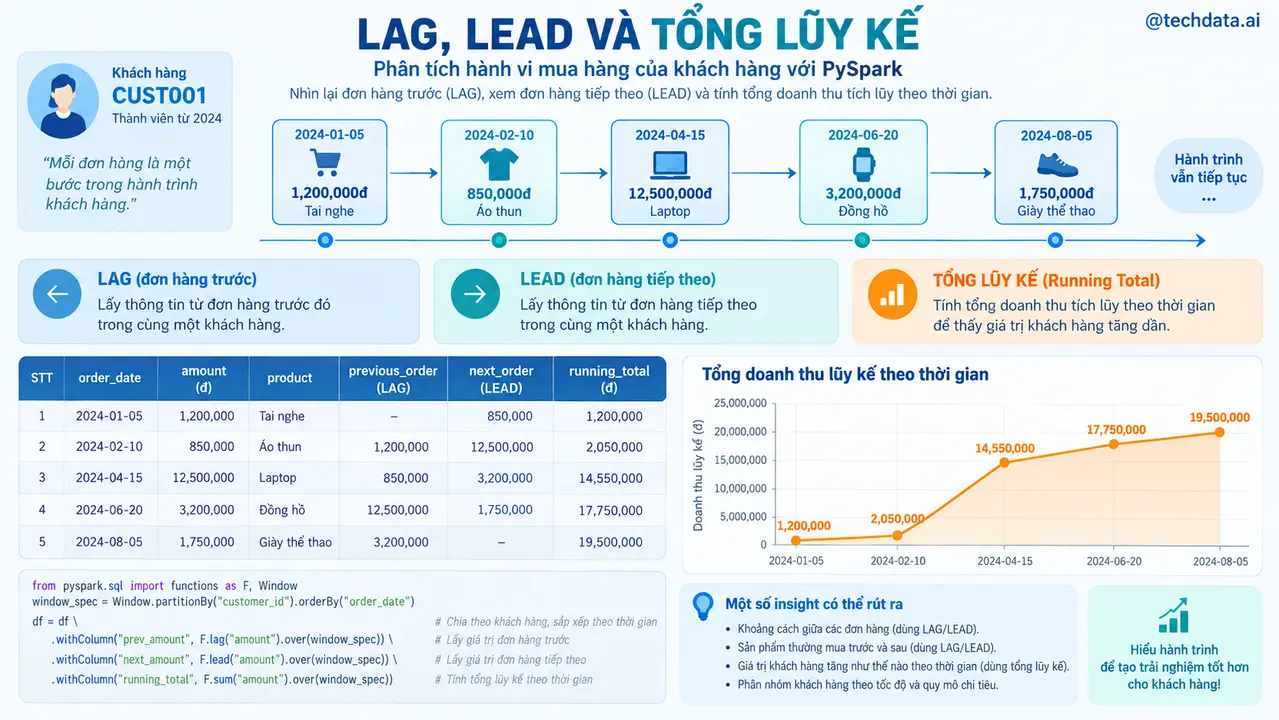
Window partitionBy(customer_id) gom lịch sử của cùng khách hàng vào một nhóm logic; orderBy(order_ts) xác định thứ tự thời gian. lag lấy giá trị của giao dịch trước, trong khi rowsBetween cho phép tính tổng tích lũy. Xếp hạng theo khu vực cần một WindowSpec khác vì grain và mục tiêu tính toán đã thay đổi.
from pyspark.sql import Window, functions as F

customer_time = Window.partitionBy("customer_id").orderBy("order_ts")
cumulative = customer_time.rowsBetween(Window.unboundedPreceding, Window.currentRow)
region_rank = Window.partitionBy("region").orderBy(F.desc("lifetime_value"))

order_history = (orders
    .withColumn("previous_order_ts", F.lag("order_ts").over(customer_time))
    .withColumn("days_since_previous",
                F.datediff(F.to_date("order_ts"), F.to_date("previous_order_ts")))
    .withColumn("cumulative_revenue", F.sum("net_amount").over(cumulative)))

customer_metrics = (order_history.groupBy("customer_id", "region")
    .agg(F.max("order_ts").alias("last_order_ts"),
         F.countDistinct("order_id").alias("frequency"),
         F.sum("net_amount").alias("lifetime_value"))
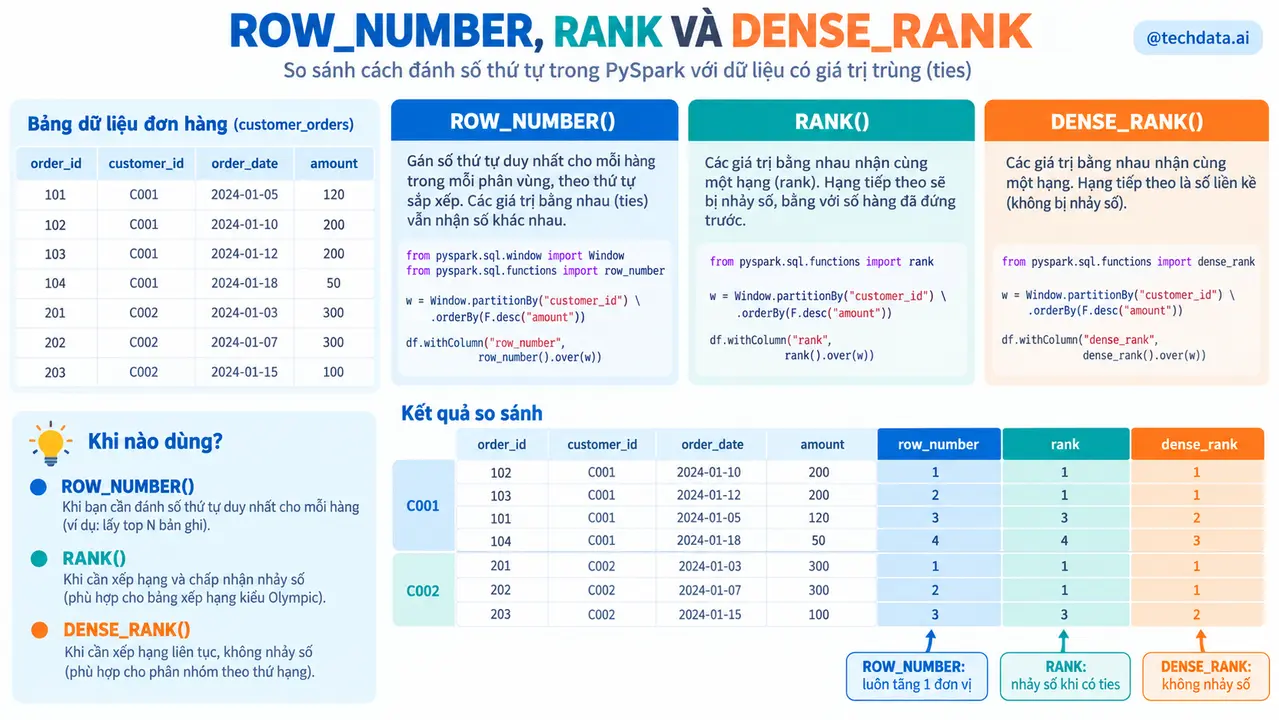
    .withColumn("rank_in_region", F.dense_rank().over(region_rank)))
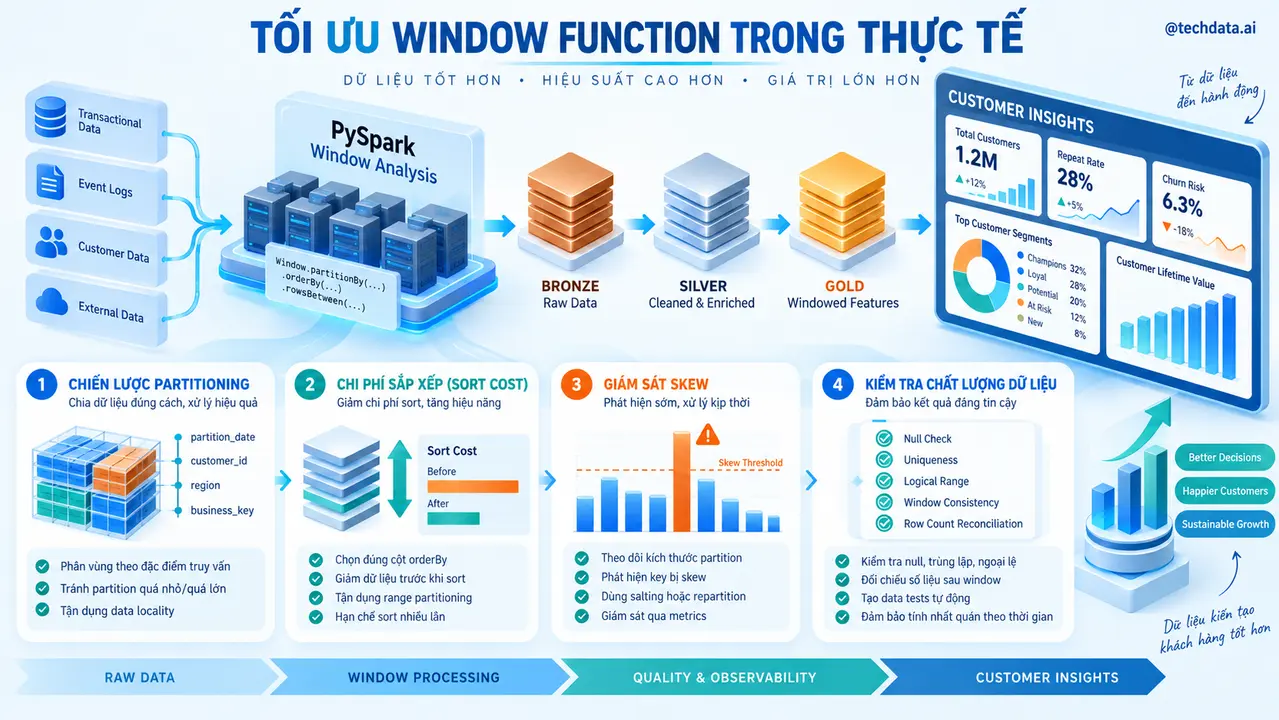
Window thường yêu cầu shuffle theo partition key và sort trong từng partition. Nếu một customer_id có lịch sử cực lớn, task có thể bị skew. Không dùng Window.partitionBy() rỗng trên dữ liệu lớn vì toàn bộ dữ liệu có thể bị gom vào một partition logic.
Bước 1: Khởi tạo SparkSession và cấu hình có chủ đích
from pyspark.sql import SparkSession

def create_spark_session():
    return (SparkSession.builder
        .appName("techdata-spark-project")
        .master("local[*]")
        .config("spark.sql.adaptive.enabled", "true")
        .config("spark.sql.session.timeZone", "UTC")
        .getOrCreate())
Timezone được đặt rõ để kết quả timestamp không phụ thuộc máy chạy. AQE được bật để Spark có thể điều chỉnh một số quyết định khi đã biết thống kê runtime. Không đặt số shuffle partition bằng một con số cố định cho mọi môi trường; production cần đo dung lượng từng partition và thời gian task.
Bước 2: Định nghĩa schema và đọc dữ liệu
from pyspark.sql.types import *

INPUT_SCHEMA = StructType([
    StructField("event_id", StringType(), False),
    StructField("order_id", StringType(), False),
    StructField("customer_id", StringType(), True),
    StructField("product_id", StringType(), True),
    StructField("store_id", StringType(), True),
    StructField("event_time", StringType(), True),
    StructField("status", StringType(), True),
    StructField("quantity", IntegerType(), True),
    StructField("unit_price", DoubleType(), True),
    StructField("discount_amount", DoubleType(), True),
])
raw = (spark.read.schema(INPUT_SCHEMA)
       .option("header", True)
       .csv(input_path))
Schema tường minh làm hành vi đọc ổn định và phát hiện sớm dữ liệu không đúng kiểu. Việc đọc vẫn là transformation; file chỉ được scan khi một action phía sau cần dữ liệu. Với JSON lồng nhau hoặc JDBC, hàm đọc thay đổi nhưng nguyên tắc kiểm soát schema và projection vẫn giữ nguyên.
Bước 3: Chuẩn hóa và gắn lý do lỗi
from pyspark.sql import functions as F

checked = (raw
    .withColumn("event_ts", F.to_timestamp("event_time"))
    .withColumn("gross_amount", F.col("quantity") * F.col("unit_price"))
    .withColumn("net_amount", F.col("gross_amount") - F.coalesce(F.col("discount_amount"), F.lit(0.0)))
    .withColumn("error_reason",
        F.when(F.col("event_id").isNull(), "missing_event_id")
         .when(F.col("event_ts").isNull(), "invalid_timestamp")
         .when(F.col("quantity") <= 0, "invalid_quantity")
         .when(F.col("unit_price") < 0, "invalid_price")
         .when(F.col("net_amount") < 0, "discount_exceeds_gross")
         .when(~F.col("status").isin("completed", "cancelled", "returned"), "invalid_status")))
Mọi điều kiện sử dụng biểu thức Spark tích hợp nên Catalyst vẫn nhìn thấy logic. Chuỗi when có thứ tự ưu tiên; nếu cần lưu tất cả lỗi của một dòng, có thể tạo array các mã lỗi thay vì một cột duy nhất. Việc tính cột không kích hoạt job ngay vì vẫn thuộc logical plan.
Bước 4: Tách dữ liệu hợp lệ, loại trùng và tính KPI
invalid = checked.filter(F.col("error_reason").isNotNull())
valid = (checked.filter(F.col("error_reason").isNull())
         .dropDuplicates(["event_id"]))

daily = (valid.filter(F.col("status") == "completed")
    .withColumn("event_date", F.to_date("event_ts"))
    .groupBy("event_date", "store_id")
    .agg(F.countDistinct("order_id").alias("order_count"),
         F.sum("quantity").alias("units"),
         F.sum("net_amount").alias("net_revenue")))
dropDuplicates và groupBy có thể gây shuffle vì các dòng cùng khóa phải về cùng partition. countDistinct thường đắt hơn count. Không thay thế bằng phép đếm khác nếu yêu cầu nghiệp vụ là số đơn duy nhất. Khi bảng dimension nhỏ được join vào pipeline, kiểm tra plan để xác nhận Spark có broadcast thay vì buộc broadcast theo thói quen.
Bước 5: Ghi đầu ra và audit
(daily.write.mode("overwrite")
    .partitionBy("event_date")
    .parquet(output_path))

(invalid.write.mode("overwrite")
    .parquet(quarantine_path))
Đầu ra chính dùng Parquet. Demo dùng overwrite để chạy lại thuận tiện, nhưng production không nên ghi đè toàn bộ dataset. Hãy giới hạn partition cần thay, dùng bảng hỗ trợ transaction hoặc chiến lược staging và commit. partitionBy chỉ nên dùng cột có số lượng giá trị vừa phải và thường xuất hiện trong bộ lọc.
Với chủ đề cụ thể của bài, phần transformation trung tâm được điều chỉnh để tính lần mua gần nhất, tổng chi tiêu, thứ hạng và nhóm khách hàng. Sau mỗi thay đổi, dùng explain('formatted') để kiểm tra scan, exchange, sort và join; dùng Spark UI để so sánh số task, shuffle read/write, thời gian và độ lệch giữa task.
Phân tích hiệu năng trước khi ghép chương trình
Trước lần chạy đầu tiên, tạo một baseline gồm tổng thời gian, thời gian của từng stage, dung lượng input, shuffle read, shuffle write, số task, median task time và task chậm nhất. Nếu không có baseline, việc thay đổi cấu hình chỉ tạo cảm giác nhanh hơn mà không chứng minh được cải thiện. Cùng một phép biến đổi có thể cho kết quả khác khi kích thước dữ liệu, số khóa và kích thước cluster thay đổi.
Một partition quá nhỏ làm scheduler phải quản lý quá nhiều task và thường tạo nhiều file nhỏ. Một partition quá lớn kéo dài thời gian task, tăng spill và rủi ro mất toàn bộ công việc của task khi executor lỗi. repartition thực hiện shuffle để phân phối lại dữ liệu và phù hợp khi cần tăng partition hoặc phân bố lại theo khóa. coalesce thường giảm partition với ít trao đổi hơn nhưng có thể tạo task mất cân bằng. Cả hai đều phải được chọn dựa trên kích thước dữ liệu và phép xử lý phía sau.
Khi groupBy theo store_id, Spark cần đưa các dòng cùng cửa hàng về cùng partition. Nếu một cửa hàng chiếm 40% giao dịch, một task có thể chạy lâu hơn phần còn lại. Hãy đo phân bố khóa, tỷ lệ task chậm và dung lượng shuffle. Các lựa chọn gồm tiền tổng hợp, tách khóa nóng, salting có kiểm soát hoặc để AQE xử lý một số trường hợp. Mỗi lựa chọn làm logic phức tạp hơn nên phải kèm test đối soát.
Với join, bắt đầu bằng việc xác định grain và quan hệ một-một, một-nhiều hay nhiều-nhiều. Một join đúng kỹ thuật nhưng sai quan hệ có thể nhân bản dòng và thổi phồng KPI. Kiểm tra số dòng, số khóa duy nhất và khóa không khớp trước với sau join. Broadcast chỉ phù hợp khi phía nhỏ thực sự vừa bộ nhớ của từng executor; việc ép broadcast một bảng lớn có thể làm executor hết bộ nhớ.
Execution plan cần được đọc từ dưới lên: scan cho biết cột và partition được đọc; Filter và Project cho biết predicate pushdown cùng column pruning; Exchange thường đánh dấu shuffle; SortMergeJoin, BroadcastHashJoin hoặc HashAggregate cho biết thuật toán vật lý. Plan không thay thế Spark UI vì thống kê runtime mới cho thấy spill, skew, thời gian task và tác động của storage thực tế.
Định dạng cột như Parquet giúp chỉ đọc cột cần thiết và có thể đẩy một số điều kiện lọc xuống lớp đọc. Compression giảm I/O nhưng dùng CPU. Partition pruning chỉ hoạt động khi bộ lọc dùng đúng cột partition và biểu thức cho phép Spark suy luận. Không partition theo khóa có cardinality rất cao như event_id vì có thể tạo số lượng thư mục và file khó quản lý.
Nếu valid và invalid cùng được ghi từ checked, Spark có thể tính lại phần chuẩn hóa cho hai action. Đây là tình huống có thể cân nhắc persist sau khi đo chi phí lineage và dung lượng bộ nhớ. Persist không miễn phí: dữ liệu chiếm bộ nhớ hoặc đĩa, có chi phí materialize và cần unpersist. Nếu mỗi nhánh chỉ dùng một lần hoặc phép tính rẻ, không cache thường đơn giản và hiệu quả hơn.
Cuối cùng, phép tối ưu chỉ được chấp nhận khi kết quả nghiệp vụ không đổi. Lưu một bộ dữ liệu kiểm thử cố định, tổng số dòng, tổng doanh thu, số đơn duy nhất và phân bố theo ngày. So sánh trước và sau tối ưu bằng cùng input, cùng cluster và cùng điều kiện cache. Một job nhanh hơn nhưng làm thay đổi grain, bỏ sót dữ liệu đến muộn hoặc nhân đôi bản ghi không phải là cải thiện.
7. Ghép thành chương trình hoàn chỉnh
import argparse
import logging
from pyspark.sql import SparkSession, functions as F

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger(__name__)

def transform(raw):
    return (raw.withColumn("event_ts", F.to_timestamp("event_time"))
        .withColumn("gross_amount", F.col("quantity") * F.col("unit_price"))
        .withColumn("net_amount", F.col("gross_amount") - F.coalesce(F.col("discount_amount"), F.lit(0.0))))

def main(args):
    spark = (SparkSession.builder.appName("spark-production-project")
             .config("spark.sql.adaptive.enabled", "true")
             .getOrCreate())
    try:
        raw = spark.read.schema(INPUT_SCHEMA).option("header", True).csv(args.input)
        checked = transform(raw)
        valid = checked.filter((F.col("event_ts").isNotNull()) & (F.col("quantity") > 0) & (F.col("net_amount") >= 0)).dropDuplicates(["event_id"])
        result = (valid.filter(F.col("status") == "completed")
                  .withColumn("event_date", F.to_date("event_ts"))
                  .groupBy("event_date", "store_id")
                  .agg(F.countDistinct("order_id").alias("order_count"), F.sum("net_amount").alias("net_revenue")))
        result.write.mode("overwrite").partitionBy("event_date").parquet(args.output)
        logger.info("Pipeline completed")
    finally:
        spark.stop()

if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("--input", required=True)
    parser.add_argument("--output", required=True)
    main(parser.parse_args())
Chương trình tách phần tạo session, đọc, kiểm tra, biến đổi và ghi để có thể kiểm thử độc lập. INPUT_SCHEMA dùng đúng định nghĩa ở phần trước. Trong repository thật, schema và transformation nên đặt ở module riêng; logging cần gắn run_id và không ghi dữ liệu nhạy cảm.
8. Kiểm tra kết quả
Không dùng một thông báo thành công làm bằng chứng dữ liệu đúng. Hãy đối soát input_count bằng valid_count cộng invalid_count và duplicate_count. Kiểm tra schema đầu ra, số partition, tổng số đơn, tổng doanh thu và số cửa hàng. Một tập dữ liệu mẫu 100.000 dòng có thể cho 99.420 dòng hợp lệ, 430 dòng lỗi và 150 bản ghi trùng; đây chỉ là output minh họa của dữ liệu giả lập.
result.printSchema()
result.orderBy("event_date", "store_id").show(20, truncate=False)
result.explain("formatted")
print("output partitions:", result.rdd.getNumPartitions())
Nhiều lệnh count liên tiếp có thể chạy lại cùng lineage. Chỉ persist khi DataFrame đắt tiền được dùng cho nhiều action kiểm soát, chọn storage level phù hợp và unpersist sau khi hoàn tất. Trên Spark UI, kiểm tra stage có task bất thường, shuffle spill, input size, số record và executor memory.
9. Những lỗi thường gặp
Lỗi Java hoặc JAVA_HOME thường xuất hiện trước khi SparkSession được tạo. Xác nhận phiên bản Java, đường dẫn và pyspark. AnalysisException về cột thường do tên cột sai hoặc ambiguous sau join; chọn cột rõ ràng và đặt alias cho từng DataFrame.
Driver out of memory thường liên quan collect, toPandas hoặc broadcast quá lớn. Executor out of memory có thể đến từ partition quá lớn, skew hoặc cache không phù hợp. Không tăng memory ngay lập tức; trước hết xem plan, kích thước partition, spill, phân bố khóa và lineage.
Quá nhiều file nhỏ làm chậm việc liệt kê và đọc metadata. coalesce(1) không phải giải pháp production vì dồn toàn bộ output vào một task. Hãy xác định kích thước file mục tiêu, repartition theo khóa cần thiết hoặc chạy compaction có đo lường. Nếu job JDBC chậm, kiểm tra partitionColumn, lowerBound, upperBound, numPartitions, index và giới hạn connection của database.
10. Nâng cấp từ demo thành pipeline thực tế
Production cần cấu hình theo môi trường, secret manager, logging có cấu trúc, retry có giới hạn, checkpoint hoặc bảng audit và cơ chế chạy lại không tạo dữ liệu trùng. Input nên bất biến; output được commit theo partition hoặc transaction. Data quality rule cần có ngưỡng cảnh báo và ownership, không chỉ ghi bản ghi lỗi rồi bỏ quên.
Cluster sizing dựa trên dung lượng sau giải nén, số partition, shuffle và SLA. Theo dõi event log, Spark UI, executor loss, garbage collection, skew và chi phí. Airflow có thể lập lịch spark-submit nhưng không nên chứa logic biến đổi chi tiết. Với dữ liệu đến muộn, định nghĩa cửa sổ cập nhật và backfill. Với schema evolution, phân loại thay đổi tương thích và breaking change.
Cấu hình local[*], đường dẫn local và overwrite toàn bộ chỉ phục vụ demo. Trên Kubernetes, Dataproc, EMR hoặc Databricks, tách driver/executor resources, dependency, credential và storage path theo môi trường. Mọi tối ưu như broadcast threshold, shuffle partition và cache chỉ thay đổi sau khi có baseline và phép đo sau thay đổi.
11. Bài tập thực hành
Level 1
Thay dataset bằng 1 triệu dòng Parquet, bổ sung hai ngày dữ liệu và chạy lại pipeline. Đầu ra phải là Parquet, có partition theo ngày; kiểm tra input bằng tổng valid, invalid và duplicate, đồng thời ghi lại thời gian chạy.
Level 2
Join thêm bảng sản phẩm gồm category và brand, sau đó tính doanh thu theo ngày và category. Kiểm tra số dòng trước và sau join, phát hiện khóa không khớp và dùng explain để xác định chiến lược join.
Level 3
Chuyển pipeline sang incremental, chỉ cập nhật partition bị ảnh hưởng và lưu audit theo run_id. Thêm data quality test, cơ chế retry và một báo cáo so sánh shuffle read/write trước với sau tối ưu.
12. Project mở rộng
Xây dựng portfolio project Retail Spark Lakehouse thực hiện tính lần mua gần nhất, tổng chi tiêu, thứ hạng và nhóm khách hàng. Nguồn gồm đơn hàng, khách hàng, sản phẩm và cửa hàng với quy mô giả định 500 triệu dòng giao dịch. Pipeline có tầng raw bất biến, tầng clean chuẩn hóa và data mart phục vụ BI. Mỗi run lưu input count, output count, duplicate, invalid, thời gian và phiên bản code.
Tiêu chí hoàn thành gồm chạy lại không nhân đôi dữ liệu, xử lý được dữ liệu đến muộn, test cho business rule chính, file output có kích thước hợp lý và không có task lệch nghiêm trọng. README cần mô tả grain, schema, cách chạy, cách tạo dữ liệu mẫu, execution plan, ảnh Spark UI, kết quả test và quyết định thiết kế cùng đánh đổi.
Để đặt project này trong lộ trình nghề nghiệp hoàn chỉnh, có thể tham khảo bản đồ Data Engineering 2027 và danh sách khóa học Data & AI của TechData.AI.
13. Tổng kết
Project đã đọc Parquet, áp dụng schema tường minh, kiểm tra dữ liệu, tính lần mua gần nhất, tổng chi tiêu, thứ hạng và nhóm khách hàng và ghi Parquet. Người học đã sử dụng lazy evaluation, partition, shuffle, DataFrame API, Spark SQL, execution plan và Spark UI. Khi tăng quy mô, hai nguyên tắc quan trọng là giữ đúng tính chất nghiệp vụ của dữ liệu và chỉ tối ưu sau khi đo.
TechData.AI - Leading the Future.
Tham khảo các khoá học theo link: https://techdata.ai/techdata-ai-course/
Hoàng Minh.
14. Tài liệu tham khảo
- Apache Spark Documentation: https://spark.apache.org/docs/3.5.3/
- PySpark API Reference: https://spark.apache.org/docs/3.5.3/api/python/
- Spark SQL Performance Tuning: https://spark.apache.org/docs/3.5.3/sql-performance-tuning.html
- Spark Structured Streaming Guide: https://spark.apache.org/docs/3.5.3/structured-streaming-programming-guide.html
- Spark Configuration: https://spark.apache.org/docs/3.5.3/configuration.html