



100 câu hỏi và câu trả lời về Pandas dành cho người mới bước vào Data. Bài đi từ cách đọc một giá trị, một cột, một bảng đến làm sạch và tóm tắt dữ liệu. Hãy chạy ví dụ, đoán kết quả trước khi đọc đáp án và đối chiếu với giải thích.
Mục lục
- Phần 1: Hiểu Pandas và Series
- Phần 2: Thao tác với Series
- Phần 3: Giá trị thiếu
- Phần 4: DataFrame cơ bản
- Phần 5: Chọn và đổi kiểu dữ liệu
- Phần 6: Làm sạch và chia dữ liệu
- Phần 7: GroupBy, Split, Pivot và Cut
- Phần 8: Trực quan hóa và bài tổng hợp
Phần 1: Hiểu Pandas và Series (1–20)
1. Pandas là gì?
Pandas là một thư viện Python chuyên dùng để làm việc với dữ liệu dạng bảng. Có thể hình dung Pandas giúp Python làm nhiều công việc giống Excel.
Một bảng điểm có cột tên và điểm. Pandas giúp đọc bảng đó, lọc học sinh đạt điểm cao và tính điểm trung bình mà không phải thao tác thủ công từng ô.
2. Muốn sử dụng Pandas thường viết câu lệnh nào?
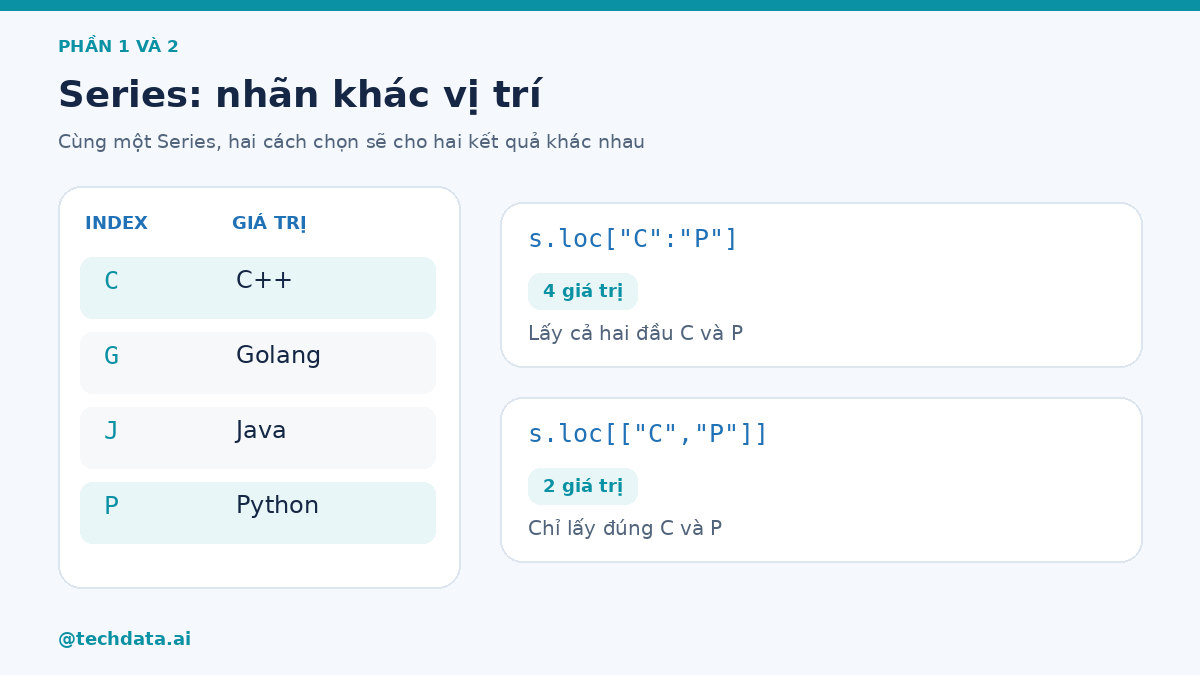
import pandas as pdpd là tên viết tắt mà lập trình viên thường dùng cho
Pandas.
Chạy dòng này trước các ví dụ phía sau. Nếu máy báo chưa tìm thấy pandas, cần cài thư viện vào đúng môi trường Python đang chạy.
3. Pandas có phải là một ngôn ngữ lập trình không?
Không. Python là ngôn ngữ lập trình, còn Pandas là thư viện được sử dụng trong Python.
Thư viện là bộ công cụ viết sẵn. Python vẫn là ngôn ngữ điều khiển chương trình; Pandas cung cấp các đối tượng và hàm xử lý bảng.
4. Hai cấu trúc dữ liệu quan trọng trong bài là gì?
Series và DataFrame.
Series biểu diễn dữ liệu một chiều; DataFrame biểu diễn bảng hai chiều. Khi lấy một cột bằng df[“Score”], ta thường nhận được Series.
5. Series là gì?
Có thể hình dung Series giống một cột dữ liệu có các giá trị và index.
Series không nhất thiết là cột lấy từ bảng: ta cũng có thể tạo nó độc lập. Mỗi giá trị gắn với một nhãn gọi là index.
6. DataFrame là gì?
DataFrame giống một bảng Excel, có nhiều hàng và nhiều cột.
Hàng thường là một bản ghi, cột thường là một thuộc tính. Ví dụ mỗi hàng là một học sinh, mỗi cột là tên hoặc điểm.
7. Lệnh nào tạo Series?
pd.Series()Gọi pd.Series() không truyền dữ liệu sẽ tạo Series rỗng. Muốn có dữ liệu, truyền một danh sách như pd.Series([9, 8]).
8. Kết quả của đoạn code sau có những giá trị nào?
s = pd.Series([5, 7, 5, 1, 6])Các giá trị là 5, 7, 5, 1, 6.
Đây là năm giá trị, không phải năm index. In s sẽ thấy bên trái là index 0 đến 4 và bên phải là các giá trị này.
9. Index mặc định của Series trên là gì?
0, 1, 2, 3, 4.
Pandas tự đánh nhãn từ 0 khi ta không cung cấp index. Vì vậy giá trị 5 đầu tiên có nhãn 0, còn 6 có nhãn 4.
10. Index là gì?
Index là nhãn giúp xác định từng phần tử hoặc từng hàng dữ liệu.
Index là nhãn, không phải lúc nào cũng là số thứ tự. Khi index là tên học sinh, ta có thể tìm điểm theo tên.
11. s.values dùng để làm gì?
Lấy các giá trị chứa trong Series.
Ví dụ với s ở câu 8, s.values cho mảng chứa 5, 7, 5, 1, 6. Kết quả là mảng NumPy, không còn nhãn index đi kèm.
12. s.index dùng để làm gì?
Xem index của Series.
s.index cho đối tượng index; ví dụ RangeIndex(start=0, stop=5, step=1). Stop=5 nghĩa là dừng trước 5.
13. Series có thể có tên không?
Có.
pd.Series([5, 7, 5], name="score")Tên score là tên của cả Series, không phải tên từng giá trị. Nó hữu ích khi hiển thị và chuyển Series thành cột.
14. Có bắt buộc index phải là 0, 1, 2, 3 không?
Không. Ta có thể tự đặt index.
Ví dụ index=[“An”, “Bình”] giúp gắn tên với điểm. Số nhãn phải khớp số giá trị khi tạo Series.
15. Ví dụ tạo Series có index là chữ?
s = pd.Series(
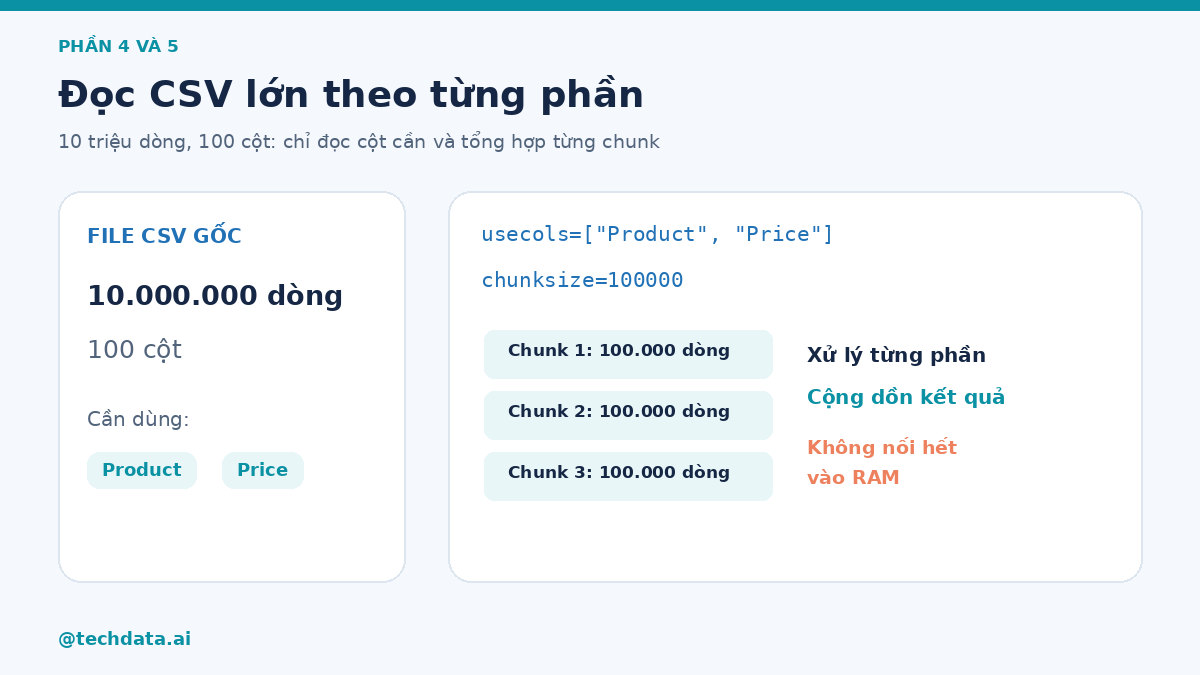
    ["C++", "Golang", "Java", "Python"],
    index=["C", "G", "J", "P"]
)
Ở ví dụ này C, G, J, P là nhãn; C++, Golang, Java, Python là giá trị. Đừng nhầm chữ P với vị trí thứ tư.
16. Với Series trên, s["P"] trả về
gì?
Python.
s[“P”] lấy theo nhãn P, không lấy vị trí P. Muốn diễn đạt rõ, dùng s.loc[“P”].
17. Tại sao?
Vì "P" là index và giá trị nằm tại index
"P" là "Python".
Nếu thay giá trị tại nhãn P thành Ruby, cùng câu lệnh sẽ trả Ruby. Index là cách định vị, không phải nội dung.
18. s["C":"P"] có ý nghĩa gì?
Lấy một đoạn dữ liệu từ nhãn "C" đến
"P".
Với thứ tự nhãn C, G, J, P, kết quả gồm cả C++, Golang, Java và Python. Lát cắt theo nhãn trong ví dụ này lấy cả điểm cuối P; khác lát cắt vị trí thường loại điểm cuối.
19. s[["C", "P"]] có giống câu trên
không?
Không. Nó yêu cầu lấy chính xác hai nhãn "C" và
"P".
Kết quả chỉ gồm C++ và Python; hai giá trị ở G, J không được chọn. Dùng s.loc[[“C”, “P”]] để chỉ rõ chọn theo nhãn.
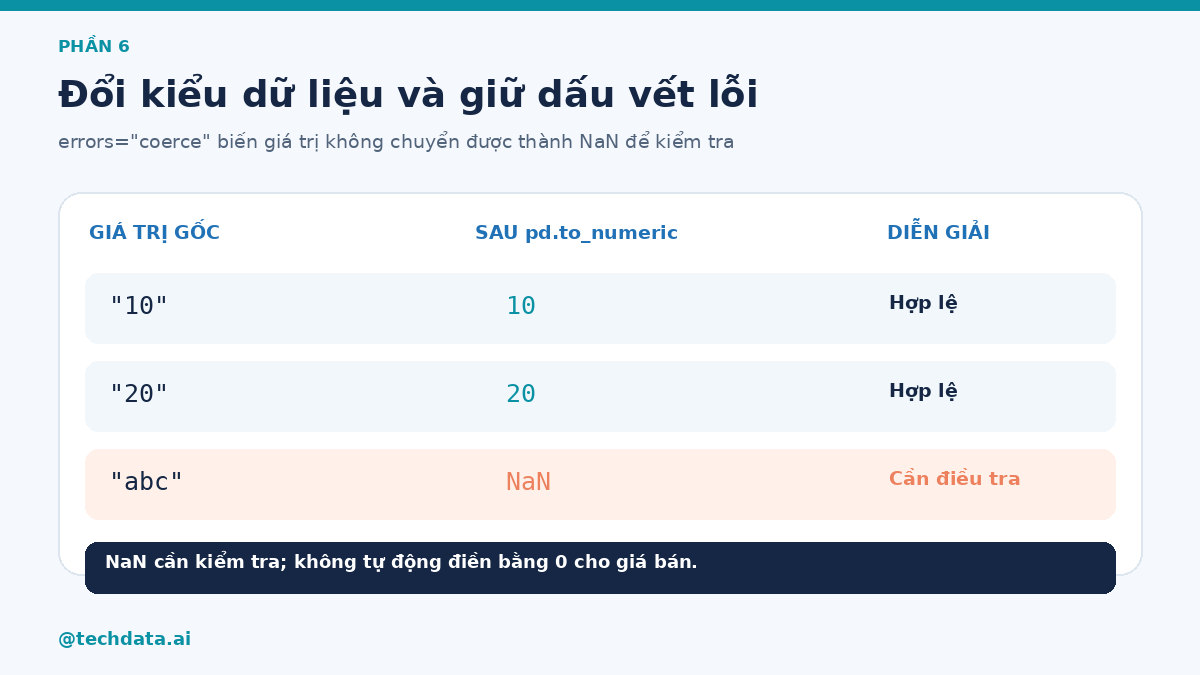
20. Cách dễ nhất để phân biệt Series và DataFrame?
Series ≈ một cột.
DataFrame ≈ một bảng.
Một Series có một trục nhãn; DataFrame có nhãn hàng và nhãn cột. Phép so sánh với Excel chỉ là cách hình dung ban đầu.
Phần 2: Thao tác với Series (21–35)
21. drop() dùng để làm gì?
Dùng để loại bỏ dữ liệu theo index.
s.drop("C")s.drop(“C”) trả về Series mới không có nhãn C. Biến s ban đầu vẫn giữ C nếu ta không gán lại: s = s.drop(“C”).
22. Muốn xóa cả "C" và "P" thì
sao?
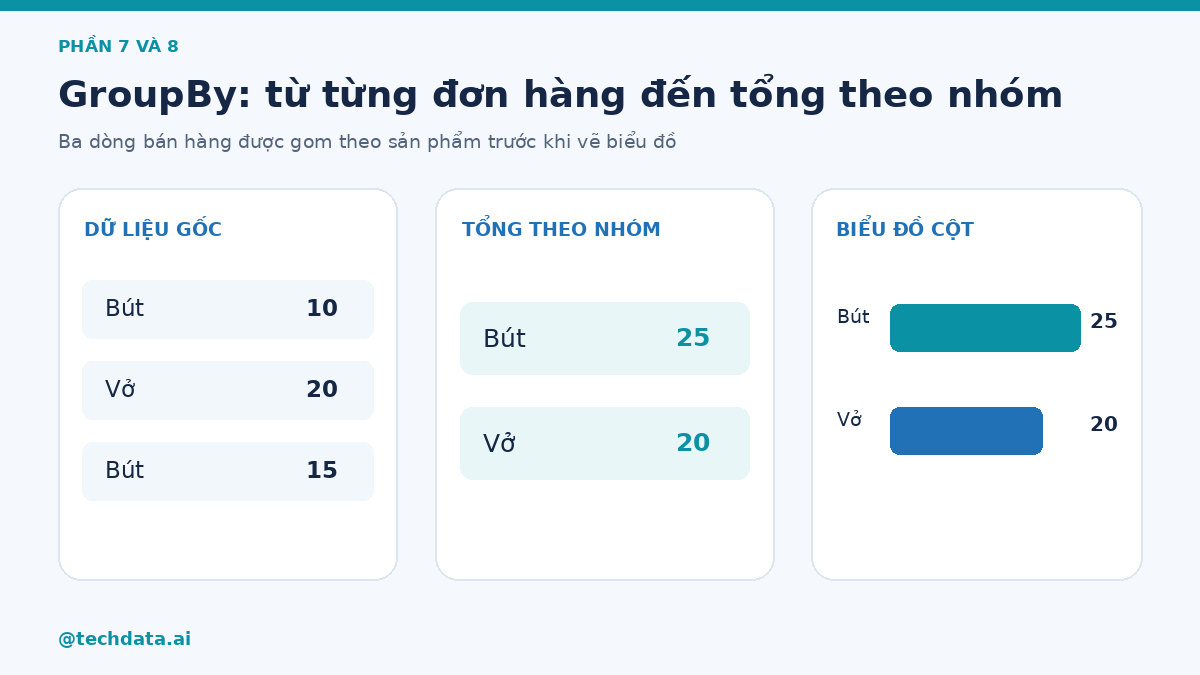
s.drop(["C", "P"])Danh sách bên trong là hai nhãn cần bỏ. Nếu nhãn không tồn tại, Pandas thường báo KeyError; cần kiểm tra nhãn trước.
23. Muốn thêm Kotlin với index "K" thì
sao?
s["K"] = "Kotlin"Phép gán thay đổi s trực tiếp. Nếu nhãn K chưa tồn tại, một phần tử mới được thêm; nếu đã tồn tại, giá trị cũ bị thay.
24. sort_index() làm gì?
Sắp xếp dữ liệu theo index.
Hàm trả về Series được sắp theo nhãn. Muốn sắp theo giá trị, dùng sort_values(); hai tiêu chí khác nhau.
25. min() làm gì?
Tìm giá trị nhỏ nhất.
Với Series số, min() trả giá trị bé nhất, không trả index của nó. Để tìm nhãn của giá trị bé nhất, dùng idxmin().
26. Cho Series [5,7,5,1,6], min()
bằng bao nhiêu?
1.
Số 1 xuất hiện ở vị trí thứ tư, có index mặc định là 3. Giá trị nhỏ nhất và nhãn của nó là hai câu hỏi khác nhau.
27. max() bằng bao nhiêu?
7.
Số 7 là giá trị lớn nhất, có index mặc định là 1 trong ví dụ ở câu 8.
28. sum() bằng bao nhiêu?
5 + 7 + 5 + 1 + 6 = 24sum() cộng các giá trị số; nó không đếm số phần tử. Muốn đếm số giá trị không thiếu, dùng count().
29. mean() là gì?
Giá trị trung bình.
Trung bình cộng bằng tổng các giá trị chia cho số giá trị hợp lệ. Pandas thường bỏ qua NaN theo mặc định.
30. Mean của [5,7,5,1,6] là bao
nhiêu?
24 / 5 = 4.8Tổng 24 chia 5 bằng 4.8. Kiểm tra lại bằng s.mean() sau khi tạo s như câu 8.
31. Median là gì?
Trung vị, tức giá trị nằm giữa sau khi sắp xếp dữ liệu.
Để tìm trung vị, sắp dữ liệu từ bé đến lớn rồi nhìn chính giữa. Nếu có số phần tử chẵn, lấy trung bình của hai giá trị giữa.
32. Median của [5,7,5,1,6] bằng bao
nhiêu?
Sắp xếp:
1, 5, 5, 6, 7Giá trị giữa là 5.
Dãy ban đầu chưa được sắp xếp. Sau khi sắp thành 1, 5, 5, 6, 7 thì số ở giữa là 5.
33. std() là gì?
Độ lệch chuẩn. Nó giúp đo mức độ các giá trị phân tán xa hay gần nhau.
std() đo độ phân tán của Series số. Theo mặc định Pandas tính độ lệch chuẩn mẫu (ddof=1); một giá trị hợp lệ thì kết quả là NaN.
34. Dãy nào có độ phân tán lớn hơn: [9,10,11]
hay [1,10,19]?
[1,10,19] vì các giá trị nằm xa nhau hơn.
Cả hai dãy đều có trung bình 10. Dãy thứ hai xa 10 hơn nhiều nên độ lệch chuẩn lớn hơn.
35. str.upper() làm gì?
Python thành PYTHON
Java thành JAVA
Với Series chuỗi s, dùng s.str.upper(); phép này tạo Series chữ hoa mới và không sửa s nếu không gán lại.
Phần 3: Giá trị thiếu (36–45)
Phần này sử dụng NaN, dropna(),
fillna() và interpolate() để minh họa cách
Pandas xử lý dữ liệu thiếu.
36. NaN là gì?
Trong ngữ cảnh bài học, có thể hiểu NaN là một giá trị
đang bị thiếu.
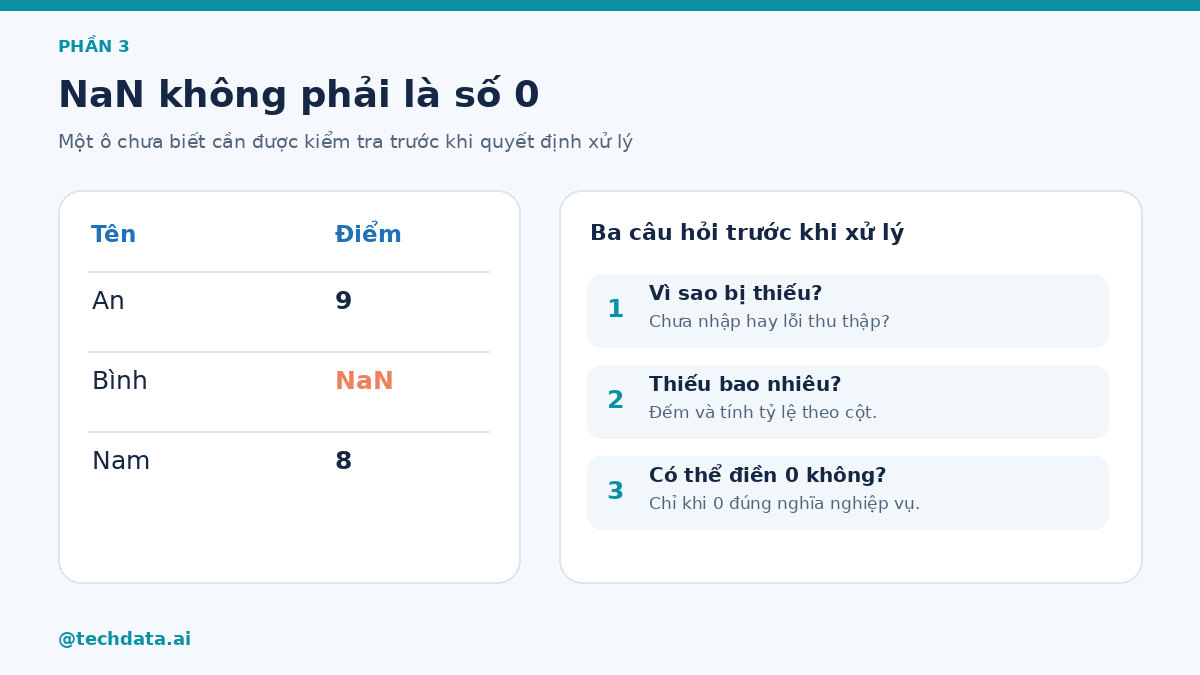
NaN thường biểu thị ô thiếu trong cột số, nhưng không phải mọi dữ liệu thiếu đều hiện thành NaN: Pandas còn có pd.NA và NaT tùy kiểu dữ liệu.
37. Ví dụ dữ liệu thiếu?
| Tên | Điểm |
|---|---|
| An | 9 |
| Bình | NaN |
| Nam | 8 |
Điểm của Bình đang thiếu.
Không biết điểm của Bình khác với điểm bằng 0. Điền 0 khi chưa có bằng chứng sẽ làm sai trung bình lớp.
38. dropna() làm gì?
Loại bỏ dữ liệu thiếu.
Với DataFrame, df.dropna() mặc định bỏ các hàng chứa ít nhất một giá trị thiếu. Hãy xem số hàng trước và sau khi bỏ.
39. fillna(0) làm gì?
Thay các giá trị thiếu bằng 0.
Điền 0 chỉ hợp lý nếu 0 thực sự mang ý nghĩa nghiệp vụ, chẳng hạn số lượng bán bằng 0 được xác nhận. Giá chưa biết không đồng nghĩa giá bằng 0.
40. fillna("Unknown") có ý nghĩa
gì?
Thay dữ liệu thiếu bằng chuỗi "Unknown".
Phù hợp hơn với một số cột dạng nhãn hay văn bản, nhưng cần đảm bảo Unknown không bị hiểu như một danh mục thật.
41. interpolate() có ý tưởng gì?
Ước lượng giá trị bị thiếu dựa trên các giá trị xung quanh.
Nội suy tuyến tính thường phù hợp với chuỗi số có thứ tự. Không nên nội suy mã sản phẩm, tên người hoặc dữ liệu mà khoảng cách giữa hai hàng không có ý nghĩa.
42. Nếu dữ liệu là 4, NaN, 6, interpolation đơn
giản có thể điền gì?
5.
5 nằm chính giữa 4 và 6 khi hai giá trị ở hai vị trí cách đều. Nếu khoảng thời gian không đều, cần xem lại cách nội suy.
43. Khi tính mean(), Pandas thường xử lý NaN như
thế nào?
Các phép tổng hợp như mean() thường bỏ qua NaN.
Ví dụ [8, NaN, 6] cho trung bình 7, vì chỉ có hai số hợp lệ. Nếu toàn bộ đều thiếu, kết quả trung bình là NaN.
44. [8, 10, NaN, 6] có mean là bao
nhiêu?
(8 + 10 + 6) / 3 = 8Không chia cho 4.
Mẫu số là 3 vì có ba điểm đã biết. Đừng âm thầm coi người thiếu điểm là 0 điểm.
45. Có nên cứ thấy NaN là xóa không?
Không. Xóa quá nhiều có thể làm mất dữ liệu quan trọng.
Trước hết hỏi tại sao thiếu, thiếu bao nhiêu, có tập trung ở nhóm nào không. Có thể giữ nguyên, loại bỏ hoặc điền giá trị theo quy tắc đã giải thích.
Phần 4: DataFrame cơ bản (46–60)
46. Cách tạo DataFrame đơn giản?
df = pd.DataFrame({
    "Name": ["An", "Bình"],
    "Score": [9, 8]
})
Bảng có hàng An 9 và Bình 8. Hai danh sách Name và Score phải có cùng số phần tử.
47. DataFrame trên có bao nhiêu cột?
2 cột: Name và Score.
Tên cột là Name và Score; df.shape trả (2, 2), lần lượt là số hàng và số cột.
48. Có bao nhiêu dòng?
2 dòng.
Mỗi học sinh chiếm một dòng. Dùng len(df) hoặc df.shape[0] để kiểm tra.
49. df.head() dùng để làm gì?
Xem một số dòng đầu tiên của DataFrame.
Mặc định hiển thị năm dòng đầu; df.head(2) xem hai dòng. Hàm này chỉ giúp quan sát, không xác nhận toàn bộ dữ liệu đều sạch.
50. Tại sao không phải lúc nào cũng in toàn bộ DataFrame?
Vì dữ liệu thực tế có thể có hàng triệu dòng.
In cả bảng lớn làm kết quả khó đọc và tốn thời gian. Kết hợp head(), info() và các phép thống kê để kiểm tra có chủ đích.
51. df.info() giúp biết những gì?
Giúp xem cấu trúc DataFrame như số dòng, cột, kiểu dữ liệu và số lượng giá trị không bị thiếu.
info() in tóm tắt chứ không trả về bảng dữ liệu mới; nó cho biết non-null count và dtype để phát hiện cột thiếu hoặc sai kiểu.
52. Dataset là gì?
Một tập hợp dữ liệu.
Một tập dữ liệu có thể gồm một hay nhiều bảng, tệp hoặc bản ghi. Trong bài này ta chủ yếu làm việc với bảng.
53. CSV là gì trong bối cảnh Pandas?
Một dạng file dữ liệu dạng bảng rất phổ biến mà Pandas có thể đọc.
CSV là tệp văn bản, mỗi dòng là một bản ghi và các trường thường phân cách bằng dấu phẩy. Tệp CSV không lưu công thức hay nhiều sheet như Excel.
54. Hàm thường dùng để đọc CSV?
pd.read_csv("data.csv")Hàm trả về DataFrame. Nếu lỗi mã hóa hoặc dấu phân cách, có thể cần chỉ rõ encoding hoặc sep tùy tệp thực tế.
55. Dataset quá lớn thì vấn đề gì có thể xảy ra?
Tốn nhiều RAM và thời gian xử lý.
Không chỉ số dòng: số cột, độ dài văn bản và kiểu dữ liệu cũng ảnh hưởng RAM. Mười triệu dòng cần kiểm tra dung lượng trước khi đọc toàn bộ.
56. Chunk là gì?
Một phần nhỏ của dataset lớn.
Chunk là một DataFrame nhỏ lấy từ một lượt đọc. Hết chunk này mới xử lý chunk tiếp theo.
57. Tại sao chia dataset thành chunk?
Để không phải đưa toàn bộ dataset khổng lồ vào bộ nhớ cùng lúc.
Nếu nối tất cả chunk lại bằng concat, ta có thể lại dùng nhiều RAM như đọc cả tệp. Nên tổng hợp hoặc ghi kết quả theo từng chunk khi dữ liệu quá lớn.
58. Ví dụ chunksize=100 nghĩa là
gì?
Đọc dữ liệu thành từng phần khoảng 100 dòng.
Mỗi lượt lặp nhận tối đa 100 hàng; chunk cuối có thể ít hơn 100. read_csv(…, chunksize=100) trả về đối tượng để lặp, chưa phải một DataFrame hoàn chỉnh.
59. pd.concat() dùng để làm gì?
Nối nhiều DataFrame lại với nhau.
Có thể nối theo chiều dọc (thêm hàng) hoặc chiều ngang (thêm cột). Kiểm tra tên cột và index để tránh dữ liệu lệch.
60. Vì sao ignore_index=True hữu ích khi
concat?
Nó tạo lại index liên tục cho bảng sau khi nối, thay vì giữ index cũ của từng bảng.
Khi nối dọc hai bảng đều có index 0, 1, kết quả sẽ trùng index nếu giữ nguyên. ignore_index=True đánh lại index 0, 1, 2, 3.
Phần 5: Chọn và đổi kiểu dữ liệu (61–75)
61. usecols dùng để làm gì khi đọc
CSV?
Chỉ đọc những cột cần thiết.
Đọc hai cột cần dùng ngay từ đầu thường tiết kiệm bộ nhớ hơn đọc đủ 100 cột rồi mới bỏ 98 cột.
62. Dataset có 100 cột nhưng chỉ cần Name và Score thì nên làm gì?
pd.read_csv(
    "data.csv",
    usecols=["Name", "Score"]
)
Tên trong usecols phải khớp tên cột thật của CSV; nếu không Pandas sẽ báo lỗi thay vì tự đoán.
63. Lợi ích là gì?
Giảm dữ liệu cần đọc và thường tiết kiệm bộ nhớ.
Tiết kiệm RAM và I/O, nhưng số dòng vẫn giữ nguyên. Nếu file vẫn quá lớn, cân nhắc thêm chunksize.
64. [::-1] nghĩa là gì?
Duyệt theo chiều ngược lại.
Đây là cú pháp lát cắt Python: bắt đầu và kết thúc để trống, bước là -1 nên lấy từ cuối về đầu.
65. [1,2,3,4][::-1] cho kết quả gì?
[4,3,2,1]Các giá trị lần lượt từ cuối là 4, 3, 2, 1. Danh sách gốc vẫn giữ thứ tự cũ nếu ta không gán kết quả.
66. Trong DataFrame, [::-1] có thể được dùng để
làm gì?
Đảo thứ tự hàng.
Dùng df.iloc[::-1] để diễn đạt rõ đảo hàng theo vị trí. Index của hàng đi theo dữ liệu nên có thể không còn tăng dần.
67. [:, ::-1] có ý tưởng gì?
Giữ tất cả hàng nhưng đảo thứ tự cột bằng df.iloc[:, ::-1].
Dùng df.iloc[:, ::-1]: trước dấu phẩy là tất cả hàng, sau dấu phẩy là các cột theo thứ tự ngược. Viết df[:, ::-1] trực tiếp thường không đúng cú pháp chọn của DataFrame.
68. reset_index(drop=True) dùng để làm
gì?
Đánh lại index từ đầu và bỏ index cũ.
Sau khi đảo hàng hoặc lọc, index có thể là 4, 3, 2… Hàm tạo index mới 0, 1, 2…; drop=True không giữ index cũ thành cột.
69. select_dtypes() dùng để làm gì?
Chọn các cột dựa trên kiểu dữ liệu.
Ví dụ bảng có cột tên và điểm, select_dtypes(include=“number”) chỉ lấy các cột đang có kiểu số; chuỗi “9” vẫn là văn bản.
70. Muốn chọn các cột số có thể dùng gì?
df.select_dtypes(include="number")Kết quả là DataFrame con. Kiểm tra df.dtypes nếu một cột tưởng là số lại không xuất hiện.
71. include có thể hiểu là gì?
Những kiểu dữ liệu muốn lấy.
include=“number” là chọn kiểu số, không có nghĩa là chọn cột chứa bất kỳ chữ số nào trong chuỗi.
72. exclude là gì?
Những kiểu dữ liệu muốn loại ra.
Ví dụ exclude=“number” chọn các cột không có kiểu số. Có thể phối hợp include và exclude khi cần.
73. "123" và 123 có giống nhau
không?
Không. "123" là chuỗi, còn 123 là số.
“123” có thể ghép với văn bản, còn 123 có thể cộng số học. Nhìn giống nhau khi in ra nhưng kiểu khác.
74. Tại sao khác biệt này quan trọng?
Vì muốn thực hiện các phép toán số học thì dữ liệu phải có kiểu phù hợp.
Một cột giá chứa chuỗi sẽ không tính tổng đúng như cột số. Cần kiểm tra ký tự tiền tệ, dấu phẩy, khoảng trắng trước khi chuyển.
75. Có thể chuyển dữ liệu sang kiểu số bằng công cụ nào?
pd.to_numeric()pd.to_numeric(df[“Price”]) chuyển một Series sang số. Nếu có giá trị lạ, mặc định hàm báo lỗi để ta phát hiện.
Phần 6: Làm sạch dữ liệu và chia dữ liệu (76–85)
76. pd.to_numeric(..., errors="coerce") có tác
dụng gì?
Các giá trị có thể chuyển thành số sẽ được chuyển; giá trị không
chuyển được sẽ trở thành dữ liệu thiếu NaN.
Coerce không sửa giá trị sai: nó biến chúng thành missing để ta điều tra tiếp. Nên đếm số lượng chuyển lỗi trước khi điền hoặc loại bỏ.
77. Ví dụ cột chứa ["10", "20", "abc"] thì
"abc" xử lý thế nào với
errors="coerce"?
Nó trở thành NaN.
Hai chuỗi đầu trở thành 10 và 20. “abc” thành NaN; đây là dấu hiệu dữ liệu cần kiểm tra, không tự động đồng nghĩa giá 0.
78. Sau đó muốn đổi NaN thành 0 thì sao?
pd.to_numeric(
    df["col"],
    errors="coerce"
).fillna(0)
Đoạn code cho ra số 0 ở vị trí không chuyển được. Chỉ áp dụng khi quy tắc nghiệp vụ cho phép; với giá bán, nên kiểm tra bản ghi gốc trước.
79. sample() dùng để làm gì?
Lấy ngẫu nhiên một phần dữ liệu.
Mỗi lần lấy mẫu có thể ra các dòng khác nhau. Đặt random_state=42 khi muốn tái lập cùng kết quả.
80. df.sample(frac=0.75) nghĩa là
gì?
Lấy ngẫu nhiên 75% số dòng của DataFrame.
frac là tỷ lệ hàng, không phải tỷ lệ cột. 0.75 tương ứng 75% số hàng.
81. Dataset có 800 dòng thì 75% khoảng bao nhiêu dòng?
600 dòng.
800 nhân 0.75 đúng 600. Với số hàng không chia hết, Pandas làm tròn số hàng được chọn.
82. Tại sao phải chia dữ liệu?
Một ứng dụng là tạo các tập dữ liệu khác nhau phục vụ những mục đích xử lý hoặc phân tích khác nhau.
Khi tạo tập huấn luyện và kiểm tra, phải tránh cùng một bản ghi xuất hiện ở cả hai tập. Lấy 75% trước rồi lấy phần còn lại theo index.
83. df.isna().sum() trả lời câu hỏi
gì?
“Mỗi cột có bao nhiêu giá trị bị thiếu?”
Kết quả là số ô thiếu trên từng cột, không phải tổng số hàng thiếu. Một hàng có thể thiếu nhiều cột.
84. df.isna().mean() trả lời câu hỏi
gì?
“Mỗi cột có tỷ lệ dữ liệu bị thiếu bao nhiêu?”
True được tính như 1, False như 0; trung bình của chúng chính là tỷ lệ thiếu từng cột, từ 0 đến 1.
85. Một cột 100 dòng có 20 NaN thì tỷ lệ thiếu là bao nhiêu?
20%.
20 chia 100 bằng 0.20. Nhân 100 để viết 20%; cần tính trên số hàng thực có của cột.
Phần 7: GroupBy, Split, Pivot và Cut (86–94)
86. GroupBy là gì?
Gom các dòng có cùng đặc điểm thành nhóm rồi thực hiện phép tính trên từng nhóm.
Ví dụ gom đơn theo tên sản phẩm rồi cộng doanh thu từng sản phẩm. Nhóm không làm thay đổi ý nghĩa của đơn vị đo.
87. Ví dụ doanh thu:
Bút: 10
Vở: 20
Bút: 15
Nếu groupby sản phẩm rồi sum thì Bút bằng bao nhiêu?
Đáp án: 25.
Bút có hai dòng 10 và 15 nên tổng là 25; Vở có một dòng 20. Có thể kiểm tra bằng df.groupby(“Sản phẩm”)[“Doanh thu”].sum().
88. Tại sao GroupBy quan trọng trong phân tích dữ liệu?
Vì rất nhiều câu hỏi kinh doanh có dạng: “tổng/trung bình/số lượng theo từng nhóm là bao nhiêu?”
Ví dụ doanh thu theo cửa hàng, đơn hàng theo tỉnh, điểm trung bình theo lớp.
Nếu hỏi doanh thu theo cửa hàng, nhóm theo cửa hàng; nếu hỏi điểm trung bình theo lớp, nhóm theo lớp rồi dùng mean().
89. str.split() dùng để làm gì?
Tách một chuỗi thành nhiều phần.
Ví dụ “An Bình”.split() cho hai phần An và Bình. Với Series, dùng s.str.split(); lưu ý tên thật không phải lúc nào cũng tách được thành ba phần.
90. "Arthur Conan Doyle" có thể tách thành
gì?
First  = Arthur
Middle = Conan
Last   = Doyle
Slide minh họa việc split đặc biệt hữu ích với Name, Address và Date.
Đây chỉ là một ví dụ có ba từ. Tên nhiều thành phần, dấu cách thừa và quy ước tên các nước khác nhau cần xử lý riêng.
91. Pivot Table là gì?
Một cách tóm tắt và sắp xếp lại dữ liệu thành bảng dễ phân tích.
Ví dụ hàng là cửa hàng, cột là tháng, ô là tổng doanh thu. Dữ liệu gốc không mất; ta tạo một góc nhìn tổng hợp.
92. margins=True trong Pivot Table có thể tạo
thêm gì?
Phần tổng hợp All.
All thường là tổng hoặc phép tổng hợp theo cả hàng/cột, tùy aggfunc. Không nên hiểu mọi trường hợp là phép cộng.
93. pd.cut() dùng để làm gì?
Chia dữ liệu số thành các khoảng rồi gán nhãn nhóm. Cần định nghĩa rõ điểm nằm đúng ranh giới.
Ta đặt ranh giới các khoảng và nhãn tương ứng. Cần chỉ rõ điểm đúng ở ranh giới thuộc nhóm nào để tránh phân loại sai.
94. Cho quy tắc Attack <50 = weak,
50–100 = normal, 100–150 = strong, vậy Attack
= 82 thuộc nhóm nào?
normal.
82 nằm trong khoảng giữa 50 và 100 nên là normal. Quy tắc ghi 50–100 và 100–150 bị chồng ở 100; hãy định nghĩa rõ, ví dụ [50,100) và [100,150).
Phần 8: Trực quan hóa và bài tổng hợp (95–100)
95. Data Visualization là gì?
Biến dữ liệu thành các hình trực quan như biểu đồ để con người dễ quan sát và phân tích.
Biểu đồ giúp nhìn mẫu hình nhanh, nhưng không thay thế kiểm tra dữ liệu. Trục và đơn vị sai có thể khiến người đọc hiểu sai.
96. Bar Chart phù hợp với việc gì?
So sánh giá trị giữa các nhóm.
Ví dụ doanh thu:
HCM      100
Hà Nội    80
Đà Nẵng   50
Biểu đồ cột giúp nhìn nhanh nhóm nào lớn hơn.
Mỗi cột biểu diễn một nhóm với cùng đơn vị doanh thu. Nếu nhóm quá nhiều, có thể sắp xếp và chỉ hiển thị nhóm quan trọng.
97. Line Chart phù hợp nhất với dạng câu hỏi nào?
“Giá trị thay đổi theo thời gian như thế nào?”
Ví dụ doanh thu từ tháng 1 đến tháng 12.
Cần cột thời gian theo đúng thứ tự và trục Y có đơn vị rõ. Nối các điểm bằng đường khi thứ tự thời gian có ý nghĩa.
98. Pie Chart phù hợp với ý tưởng nào?
Biểu diễn các phần trong một tổng thể, ví dụ tỷ trọng từng nhóm.
Các phần cần cộng thành một tổng thể. Khi quá nhiều lát nhỏ, biểu đồ cột thường dễ so sánh hơn.
99. Scatter Plot giúp chúng ta quan sát điều gì?
Mối quan hệ giữa hai biến số. Ví dụ trục X là chiều dài, trục Y là chiều rộng; mỗi điểm đại diện cho một quan sát.
Mỗi chấm là một bản ghi. Hai biến có xu hướng tăng cùng nhau không chứng minh biến này gây ra biến kia.
100. Câu tổng hợp: Một file CSV có 10 triệu dòng, 100 cột,
nhiều giá trị thiếu và cột Price đang được lưu dưới dạng
text. Em sẽ suy nghĩ xử lý nó theo thứ tự nào?
Một hướng xử lý dựa trên các kỹ thuật của bài:
# 1. Chỉ đọc những cột cần thiết
chunks = pd.read_csv(
    "data.csv",
    usecols=["Product", "Price"],
    chunksize=100000
)

missing_total = 0
for chunk in chunks:
    chunk["Price"] = pd.to_numeric(chunk["Price"], errors="coerce")
    missing_total += chunk["Price"].isna().sum()
    # Xử lý hoặc ghi kết quả của từng chunk tại đây

print("Số dòng Price thiếu hoặc không chuyển được:", missing_total)
Điểm quan trọng của câu 100 không phải học thuộc code mà phải hiểu tư duy:
Với dữ liệu lớn, hãy đọc đúng các cột cần thiết, kiểm tra
kiểu dữ liệu và giá trị thiếu, quyết định cách xử lý phù hợp rồi mới
phân tích và trực quan hóa.
Đây cũng là bước chuyển từ “biết câu lệnh Pandas” sang “biết dùng Pandas để giải quyết bài toán dữ liệu”.
Ví dụ trên cộng dồn số dòng thiếu hoặc chuyển kiểu lỗi, chưa tự điền 0. Muốn tách riêng hai nguyên nhân, hãy đếm dữ liệu thiếu trước khi chuyển kiểu. Cần giữ riêng số bản ghi chuyển kiểu lỗi và tỷ lệ giá thiếu, rồi xác nhận quy tắc xử lý với người phụ trách dữ liệu. Với mười triệu dòng, không nối hết các chunk vào RAM chỉ để tính tổng.