


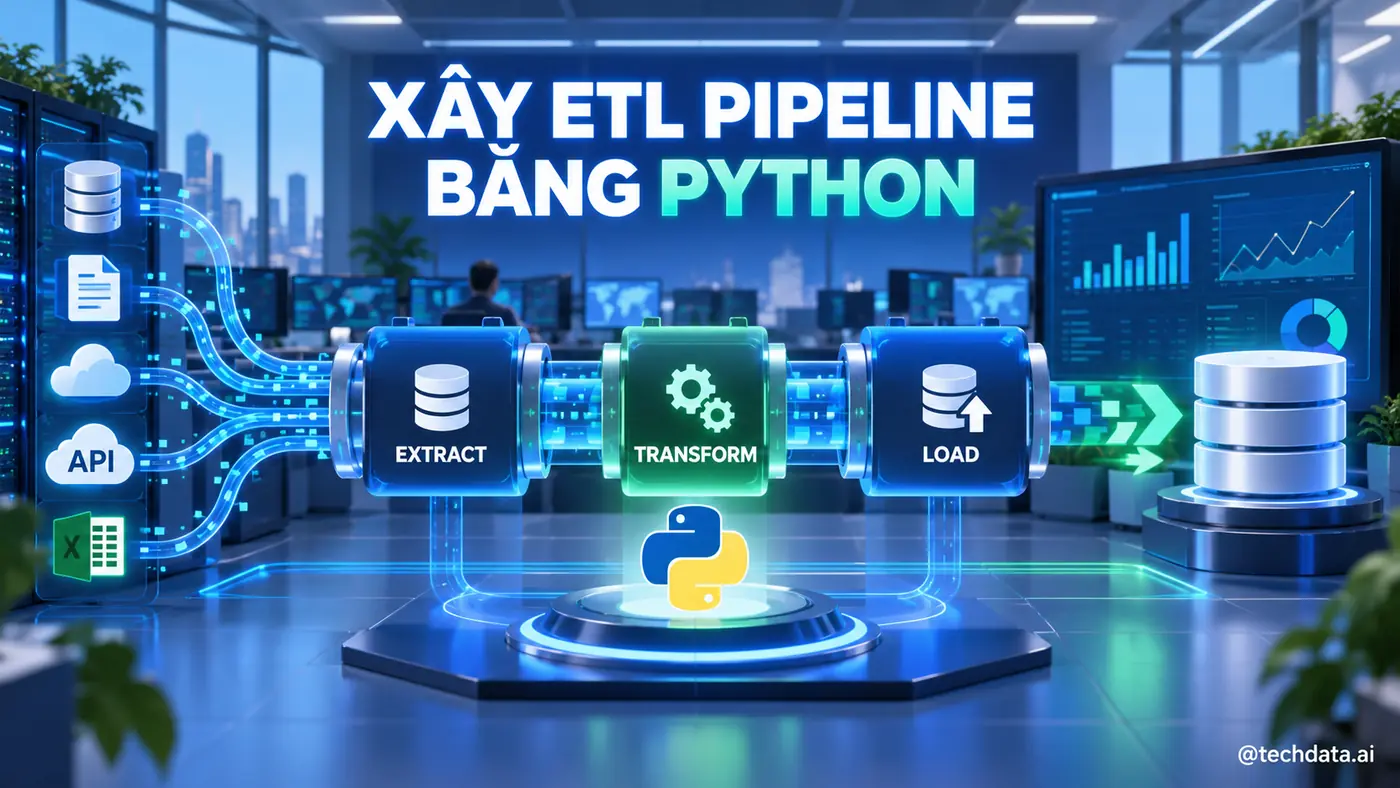

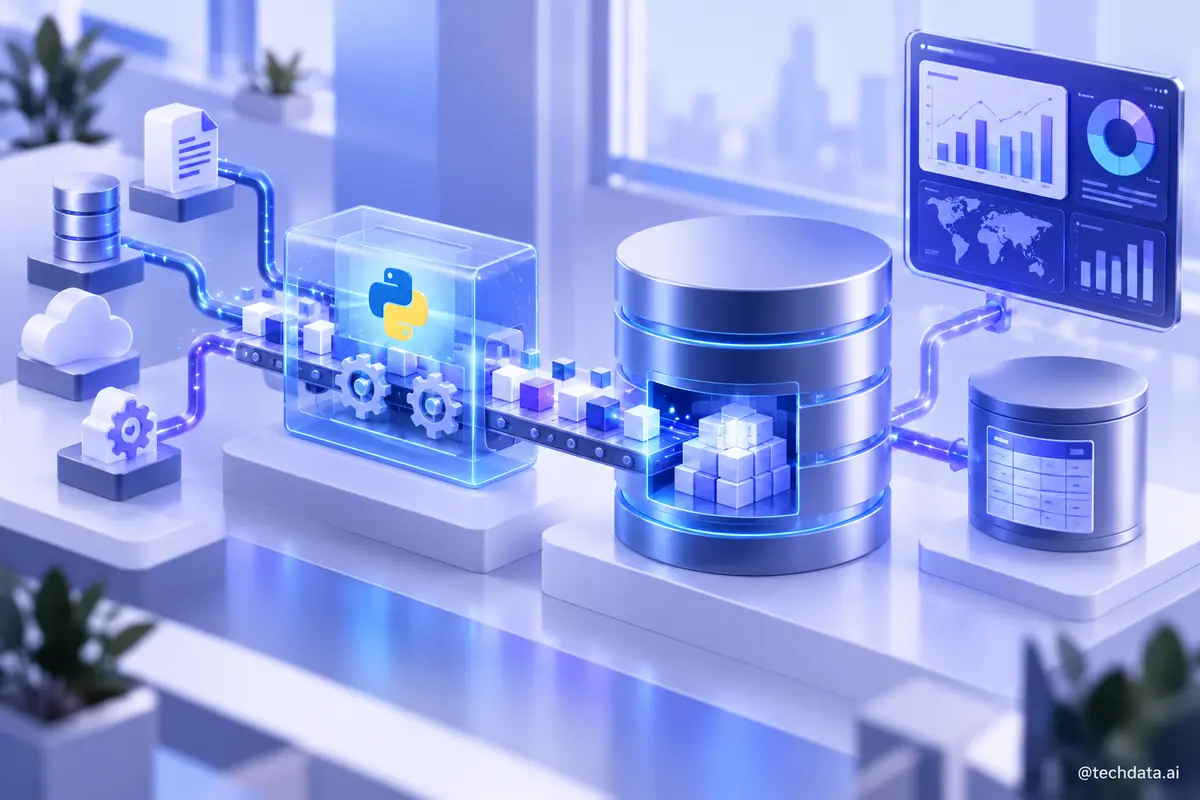
Xây ETL Pipeline bằng Python là chủ đề trọng tâm của bài viết. ETL thường được giới thiệu bằng ba từ Extract, Transform và Load, nhưng một pipeline dùng trong doanh nghiệp cần nhiều hơn ba function nối tiếp nhau. Nó phải biết dữ liệu nào đã xử lý, phát hiện schema thay đổi, tách bản ghi lỗi, chạy lại an toàn, ghi log và chứng minh số liệu đầu ra không bị mất hoặc nhân đôi. Bài viết này xây dựng một ETL Pipeline bằng Python lấy đơn hàng từ CSV, chuẩn hóa dữ liệu và nạp vào PostgreSQL theo mô hình incremental load.
Mục lục
- Bài toán thực tế
- Sau bài này bạn sẽ làm được gì?
- Kiến thức Python cần dùng
- Chuẩn bị môi trường
- Hiểu dữ liệu đầu vào
- Xây dựng ứng dụng từng bước
- Ghép thành chương trình hoàn chỉnh
- Kiểm tra kết quả
- Những lỗi thường gặp
- Nâng cấp thành ETL production
- Bài tập thực hành
- Project mở rộng
- Tổng kết
- Tài liệu tham khảo
1. Bài toán thực tế
Một doanh nghiệp bán lẻ nhận file đơn hàng hằng ngày từ hệ thống POS. Mỗi file chứa giao dịch của một ngày và được đặt trong thư mục dùng chung. Bộ phận Data cần nạp dữ liệu vào PostgreSQL để Power BI đọc bảng báo cáo. Trong giai đoạn đầu, nhân viên chạy script đọc toàn bộ file, nối dữ liệu và dùng to_sql() với chế độ append. Sau vài tuần, bảng đích xuất hiện duplicate vì một số file được gửi lại, một lần chạy thất bại giữa chừng và script được chạy lại mà không biết phần nào đã hoàn tất.
Ngoài duplicate, dữ liệu nguồn còn có ngày sai định dạng, số lượng âm, mã cửa hàng mới chưa xuất hiện trong danh mục và tên cột thay đổi. Nếu pipeline chỉ cố gắng nạp mọi thứ, lỗi sẽ đi thẳng vào báo cáo. Nếu pipeline dừng ở bản ghi lỗi đầu tiên, toàn bộ dữ liệu hợp lệ của ngày đó bị chậm. Bài toán thực tế vì vậy không chỉ là di chuyển dữ liệu mà là quản lý trạng thái, chất lượng và khả năng phục hồi.
Project trong bài xây một pipeline theo batch. Mỗi lần chạy nhận một file CSV, tạo run ID, tính checksum, kiểm tra file đã được xử lý hay chưa, đọc dữ liệu, chuẩn hóa, tách bản ghi không hợp lệ và nạp dữ liệu tốt vào bảng staging. Trong cùng transaction, pipeline upsert vào bảng đích và ghi audit. Nếu load thất bại, transaction được rollback để không tạo trạng thái nửa hoàn tất.
2. Sau bài này bạn sẽ làm được gì?
Sau bài viết, bạn có project nhận đường dẫn file đơn hàng và nạp dữ liệu vào ba bảng PostgreSQL. Bảng fact_order_items chứa dữ liệu hợp lệ. Bảng etl_rejected_rows giữ bản ghi không đạt business rule cùng nguyên nhân. Bảng etl_runs lưu run ID, checksum file, số dòng, thời gian bắt đầu, thời gian kết thúc và trạng thái.
Pipeline có thể chạy lại cùng một file mà không tạo duplicate. Khi file có cùng tên nhưng nội dung thay đổi, checksum giúp nhận biết đây là phiên bản khác. Người vận hành có thể đối soát số dòng đầu vào với số dòng hợp lệ và không hợp lệ, tra cứu nguồn của một bản ghi và biết chính xác lần chạy nào đã ghi dữ liệu.
3. Kiến thức Python cần dùng
Project sử dụng Pandas để đọc và biến đổi CSV, SQLAlchemy để quản lý kết nối và transaction, Psycopg làm PostgreSQL driver, hashlib để tính checksum, uuid để tạo run ID và logging để ghi log. Các function được chia theo trách nhiệm extract, validate, transform, load và audit.
Upsert được thực hiện bằng câu lệnh PostgreSQL có ON CONFLICT. Cơ chế này cần unique constraint phù hợp trên business key. Nếu khóa không phản ánh đúng grain, upsert có thể ghi đè dữ liệu hợp lệ hoặc vẫn tạo duplicate. Vì vậy thiết kế bảng và hiểu nghiệp vụ quan trọng ngang với code Python.
4. Chuẩn bị môi trường
python -m venv .venv
source .venv/bin/activate
python -m pip install pandas sqlalchemy "psycopg[binary]" python-dotenv
python-etl-pipeline/
data/
incoming/
processed/
rejected/
logs/
sql/
schema.sql
.env
.gitignore
main.py
requirements.txtFile .env chứa DATABASE_URL cho môi trường phát triển và không được commit. Tài khoản ETL nên có quyền tối thiểu trên các bảng cần đọc và ghi. Database cần tạo constraint trước khi pipeline chạy.
CREATE TABLE fact_order_items (
    order_id TEXT NOT NULL,
    product_id TEXT NOT NULL,
    order_date DATE NOT NULL,
    store_id TEXT NOT NULL,
    quantity INTEGER NOT NULL,
    unit_price NUMERIC(18, 2) NOT NULL,
    revenue NUMERIC(18, 2) NOT NULL,
    source_file TEXT NOT NULL,
    etl_run_id UUID NOT NULL,
    updated_at TIMESTAMPTZ NOT NULL DEFAULT NOW(),
    PRIMARY KEY (order_id, product_id)
);

CREATE TABLE etl_runs (
    run_id UUID PRIMARY KEY,
    source_file TEXT NOT NULL,
    file_checksum TEXT NOT NULL,
    started_at TIMESTAMPTZ NOT NULL,
    finished_at TIMESTAMPTZ,
    input_count INTEGER,
    valid_count INTEGER,
    invalid_count INTEGER,
    status TEXT NOT NULL,
    error_message TEXT,
    UNIQUE (file_checksum)
);
5. Hiểu dữ liệu đầu vào
| Cột | Kiểu mong đợi | Ý nghĩa | Quy tắc |
|---|---|---|---|
| order_id | String | Mã đơn | Không trống |
| product_id | String | Mã sản phẩm | Không trống |
| order_date | Date | Ngày bán | Ngày hợp lệ |
| store_id | String | Mã cửa hàng | Không trống |
| quantity | Integer | Số lượng | Lớn hơn 0 |
| unit_price | Decimal | Đơn giá | Không âm |
Grain của bảng là một sản phẩm trong một đơn hàng. Business key gồm order_id và product_id. Trong hệ thống có thể bán cùng sản phẩm trên hai dòng với chương trình giá khác nhau, khóa cần bổ sung line_number. Không nên chọn khóa chỉ vì dữ liệu mẫu chưa xuất hiện duplicate.
Schema contract cần mô tả cột bắt buộc, kiểu dữ liệu và business rule. Khi nguồn thêm cột không ảnh hưởng, pipeline có thể tiếp tục. Khi nguồn xóa hoặc đổi tên cột bắt buộc, pipeline phải fail rõ ràng. Việc âm thầm tạo cột trống có thể làm sai báo cáo mà không tạo lỗi kỹ thuật.
6. Xây dựng ứng dụng từng bước
Bước 1: Tạo checksum và run ID
import hashlib
from pathlib import Path
from uuid import uuid4


def calculate_checksum(
    file_path: Path,
) -> str:
    digest = hashlib.sha256()

    with file_path.open("rb") as file:
        for chunk in iter(
            lambda: file.read(1024 * 1024),
            b"",
        ):
            digest.update(chunk)

    return digest.hexdigest()


def create_run_context(
    file_path: Path,
) -> dict:
    return {
        "run_id": str(uuid4()),
        "source_file": file_path.name,
        "file_checksum": calculate_checksum(
            file_path
        ),
    }
Checksum dựa trên nội dung thay vì tên file. Đọc theo chunk giúp tính hash mà không nạp toàn bộ file lớn vào bộ nhớ. Run ID định danh một lần chạy, còn checksum định danh nội dung nguồn. Hai khái niệm không nên dùng thay thế cho nhau.
Bước 2: Kiểm tra file đã xử lý
from sqlalchemy import text


CHECK_FILE_SQL = text("""
    SELECT 1
    FROM etl_runs
    WHERE file_checksum = :checksum
      AND status = 'success'
    LIMIT 1
""")


def was_processed(
    connection,
    checksum: str,
) -> bool:
    result = connection.execute(
        CHECK_FILE_SQL,
        {"checksum": checksum},
    )
    return result.scalar() is not None
Chỉ lần chạy thành công mới ngăn việc xử lý lại. Nếu lần trước failed, pipeline được phép retry. Một số doanh nghiệp muốn hỗ trợ force reprocess; tùy chọn đó cần được kiểm soát và ghi audit thay vì xóa lịch sử cũ.
Bước 3: Extract và kiểm tra schema
import pandas as pd


REQUIRED_COLUMNS = [
    "order_id",
    "product_id",
    "order_date",
    "store_id",
    "quantity",
    "unit_price",
]


def extract(
    file_path: Path,
) -> pd.DataFrame:
    frame = pd.read_csv(
        file_path,
        dtype={
            "order_id": "string",
            "product_id": "string",
            "store_id": "string",
        },
        encoding="utf-8",
    )

    frame.columns = [
        str(column)
        .strip()
        .lower()
        .replace(" ", "_")
        for column in frame.columns
    ]

    missing = sorted(
        set(REQUIRED_COLUMNS)
        - set(frame.columns)
    )
    if missing:
        raise ValueError(
            f"Thiếu cột bắt buộc: {missing}"
        )

    return frame[
        REQUIRED_COLUMNS
    ].copy()
Pipeline chỉ lấy cột cần thiết để hợp đồng dữ liệu rõ ràng. Nếu cần lưu toàn bộ payload gốc phục vụ điều tra, nên lưu file raw trong object storage thay vì thêm mọi cột không kiểm soát vào bảng báo cáo.
Bước 4: Transform và tạo error reason
def transform(
    frame: pd.DataFrame,
    source_file: str,
    run_id: str,
) -> pd.DataFrame:
    transformed = frame.copy()

    for column in [
        "order_id",
        "product_id",
        "store_id",
    ]:
        transformed[column] = (
            transformed[column]
            .astype("string")
            .str.strip()
            .replace("", pd.NA)
        )

    transformed["order_date"] = (
        pd.to_datetime(
            transformed["order_date"],
            errors="coerce",
            dayfirst=True,
        ).dt.date
    )

    transformed["quantity"] = pd.to_numeric(
        transformed["quantity"],
        errors="coerce",
    )
    transformed["unit_price"] = pd.to_numeric(
        transformed["unit_price"],
        errors="coerce",
    )

    transformed["revenue"] = (
        transformed["quantity"]
        * transformed["unit_price"]
    )
    transformed["source_file"] = source_file
    transformed["etl_run_id"] = run_id

    return transformed


def validate(
    frame: pd.DataFrame,
) -> tuple[pd.DataFrame, pd.DataFrame]:
    checked = frame.copy()

    conditions = {
        "missing_order_id": (
            checked["order_id"].isna()
        ),
        "missing_product_id": (
            checked["product_id"].isna()
        ),
        "missing_store_id": (
            checked["store_id"].isna()
        ),
        "invalid_order_date": (
            checked["order_date"].isna()
        ),
        "invalid_quantity": (
            checked["quantity"].isna()
            | (checked["quantity"] <= 0)
            | (checked["quantity"] % 1 != 0)
        ),
        "invalid_unit_price": (
            checked["unit_price"].isna()
            | (checked["unit_price"] < 0)
        ),
    }

    checked["error_reason"] = ""
    for name, mask in conditions.items():
        checked.loc[
            mask,
            "error_reason",
        ] += name + ";"

    valid_mask = checked[
        "error_reason"
    ].eq("")

    valid_rows = checked.loc[
        valid_mask
    ].drop(
        columns="error_reason"
    ).copy()

    invalid_rows = checked.loc[
        ~valid_mask
    ].copy()

    valid_rows["quantity"] = (
        valid_rows["quantity"]
        .astype("int64")
    )

    return valid_rows, invalid_rows
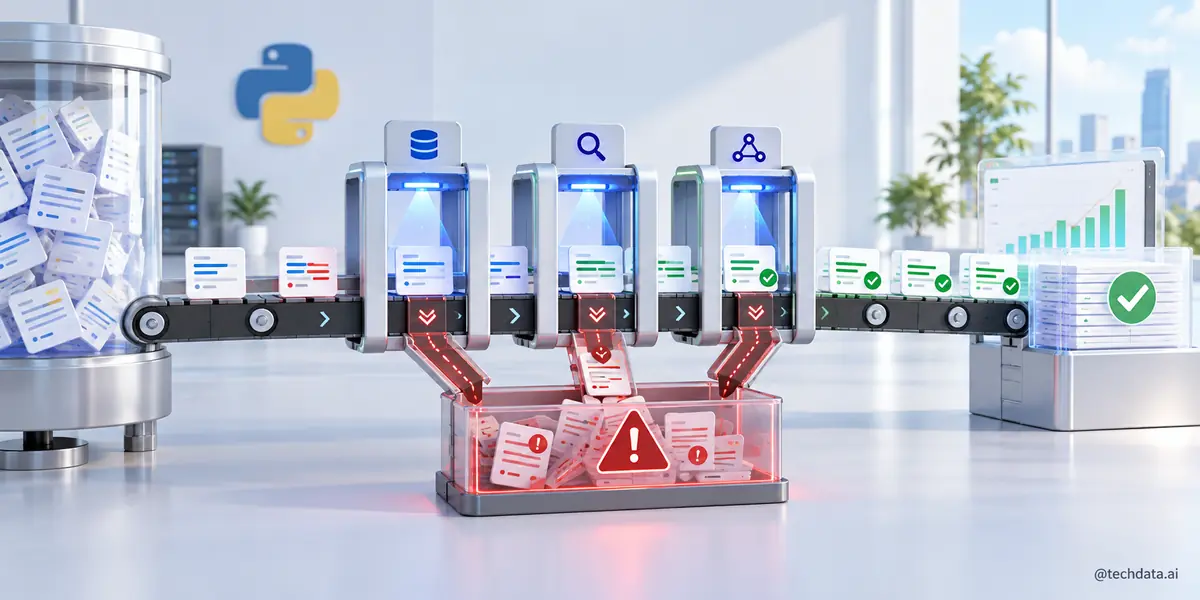
Dữ liệu lỗi không bị xóa. Nó được tách ra cùng source file, run ID và error reason. Cách này cho phép nhóm nguồn sửa vấn đề có hệ thống. Nếu 80% lỗi cùng là invalid_order_date, giải pháp tốt hơn là sửa định dạng tại POS thay vì mở rộng parser vô hạn.
Bước 5: Loại duplicate trong batch
def deduplicate(
    frame: pd.DataFrame,
) -> tuple[pd.DataFrame, int]:
    duplicate_mask = frame.duplicated(
        subset=[
            "order_id",
            "product_id",
        ],
        keep="last",
    )

    duplicate_count = int(
        duplicate_mask.sum()
    )

    return (
        frame.loc[~duplicate_mask].copy(),
        duplicate_count,
    )
Đây là deduplication trong một file. Duplicate giữa các ngày được kiểm soát bằng primary key và upsert tại database. Nếu nguồn có cột updated_at, cần sắp xếp theo thời điểm cập nhật trước khi giữ bản ghi cuối.
Bước 6: Upsert trong transaction
UPSERT_SQL = text("""
    INSERT INTO fact_order_items (
        order_id,
        product_id,
        order_date,
        store_id,
        quantity,
        unit_price,
        revenue,
        source_file,
        etl_run_id
    )
    VALUES (
        :order_id,
        :product_id,
        :order_date,
        :store_id,
        :quantity,
        :unit_price,
        :revenue,
        :source_file,
        CAST(:etl_run_id AS UUID)
    )
    ON CONFLICT (order_id, product_id)
    DO UPDATE SET
        order_date = EXCLUDED.order_date,
        store_id = EXCLUDED.store_id,
        quantity = EXCLUDED.quantity,
        unit_price = EXCLUDED.unit_price,
        revenue = EXCLUDED.revenue,
        source_file = EXCLUDED.source_file,
        etl_run_id = EXCLUDED.etl_run_id,
        updated_at = NOW()
""")


def load_valid_rows(
    connection,
    valid_rows: pd.DataFrame,
) -> None:
    records = valid_rows.to_dict(
        orient="records"
    )

    if records:
        connection.execute(
            UPSERT_SQL,
            records,
        )
SQLAlchemy thực hiện executemany khi nhận danh sách dictionary. Với batch rất lớn, PostgreSQL COPY hoặc staging table có thể nhanh hơn. Dù chọn phương thức nào, constraint vẫn là lớp bảo vệ cuối cùng chống duplicate.
Bước 7: Ghi rejected rows và audit
FINISH_RUN_SQL = text("""
    UPDATE etl_runs
    SET
        finished_at = NOW(),
        input_count = :input_count,
        valid_count = :valid_count,
        invalid_count = :invalid_count,
        status = :status,
        error_message = :error_message
    WHERE run_id = CAST(:run_id AS UUID)
""")


def finish_run(
    connection,
    context: dict,
    input_count: int,
    valid_count: int,
    invalid_count: int,
    status: str,
    error_message: str | None = None,
) -> None:
    connection.execute(
        FINISH_RUN_SQL,
        {
            "run_id": context["run_id"],
            "input_count": input_count,
            "valid_count": valid_count,
            "invalid_count": invalid_count,
            "status": status,
            "error_message": error_message,
        },
    )
Audit phải được thiết kế để vẫn ghi nhận được lần chạy failed. Một transaction duy nhất cho dữ liệu và audit success giúp tránh trạng thái báo thành công khi dữ liệu chưa commit. Với audit failure, có thể dùng transaction riêng sau khi transaction chính rollback.
7. Ghép thành chương trình hoàn chỉnh
import logging
import os
from pathlib import Path
from uuid import uuid4

import pandas as pd
from dotenv import load_dotenv
from sqlalchemy import create_engine, text


logging.basicConfig(
    level=logging.INFO,
    format=(
        "%(asctime)s %(levelname)s "
        "%(message)s"
    ),
)
logger = logging.getLogger(__name__)


def create_engine_from_env():
    database_url = os.getenv("DATABASE_URL")
    if not database_url:
        raise RuntimeError(
            "Chưa cấu hình DATABASE_URL"
        )
    return create_engine(
        database_url,
        pool_pre_ping=True,
    )


def run_pipeline(
    file_path: Path,
) -> None:
    context = create_run_context(file_path)
    engine = create_engine_from_env()

    with engine.connect() as connection:
        if was_processed(
            connection,
            context["file_checksum"],
        ):
            logger.info(
                "File đã được xử lý thành công"
            )
            return

    raw = extract(file_path)
    transformed = transform(
        raw,
        context["source_file"],
        context["run_id"],
    )

    deduplicated, duplicate_count = (
        deduplicate(transformed)
    )
    valid_rows, invalid_rows = validate(
        deduplicated
    )

    input_count = len(raw)
    valid_count = len(valid_rows)
    invalid_count = (
        len(invalid_rows)
        + duplicate_count
    )

    if input_count != (
        valid_count + invalid_count
    ):
        raise ValueError(
            "Reconciliation không cân bằng"
        )

    with engine.begin() as connection:
        connection.execute(
            text("""
                INSERT INTO etl_runs (
                    run_id,
                    source_file,
                    file_checksum,
                    started_at,
                    status
                )
                VALUES (
                    CAST(:run_id AS UUID),
                    :source_file,
                    :file_checksum,
                    NOW(),
                    'running'
                )
            """),
            context,
        )

        load_valid_rows(
            connection,
            valid_rows,
        )

        if not invalid_rows.empty:
            invalid_rows.to_sql(
                "etl_rejected_rows",
                connection,
                if_exists="append",
                index=False,
                method="multi",
            )

        finish_run(
            connection,
            context,
            input_count,
            valid_count,
            invalid_count,
            "success",
        )

    logger.info(
        "ETL thành công, input=%s valid=%s "
        "invalid=%s",
        input_count,
        valid_count,
        invalid_count,
    )


def main() -> None:
    load_dotenv()
    file_path = Path(
        "data/incoming/orders_20260919.csv"
    )
    run_pipeline(file_path)


if __name__ == "__main__":
    main()
Phiên bản hoàn chỉnh tập trung vào luồng chính. Trong code production, phần tạo audit failure nên nằm trong except, sau đó ghi bằng transaction riêng rồi phát sinh lại exception để scheduler nhận trạng thái thất bại. Không nên bắt mọi exception và chỉ in thông báo vì hệ thống điều phối sẽ tưởng tác vụ thành công.
8. Kiểm tra kết quả
run_id: 8f08b29e-9b36-4e19-bbe1-1abfe60f8485
input_records: 125430
duplicates_in_batch: 318
invalid_records: 300
valid_records: 124812
rows_upserted: 124812
status: success
Phép kiểm tra đầu tiên là 125.430 bằng 318 cộng 300 cộng 124.812. Sau đó truy vấn bảng đích theo run ID để xác nhận số dòng được ghi. Chạy lại cùng file phải trả thông báo đã xử lý và không thay đổi số dòng bảng đích. Thay một dòng trong file rồi chạy lại sẽ tạo checksum mới và thực hiện upsert.
Kiểm tra thêm tổng doanh thu trước load và sau load, số business key duy nhất, tỷ lệ null theo cột và top error reason. Đối với dữ liệu quan trọng, reconciliation nên được lưu vào bảng audit thay vì chỉ in trên terminal.
9. Những lỗi thường gặp
Dùng append mà không có constraint. Retry sẽ tạo duplicate. Cần business key, unique constraint và chiến lược upsert rõ ràng.
Đánh dấu file thành công trước khi commit. Nếu load thất bại sau đó, lần chạy tiếp theo có thể bỏ qua file. Audit success phải nằm cùng transaction hoặc chỉ được ghi sau commit.
Bắt exception nhưng không phát sinh lại. Scheduler nhận exit code thành công dù pipeline lỗi. Hãy log đủ context, ghi audit failure và raise exception.
Giữ transaction quá lâu. Không nên đọc file và transform bên trong transaction database. Chỉ mở transaction khi chuẩn bị ghi.
Không kiểm soát schema drift. Thêm cột có thể chấp nhận, nhưng thiếu cột bắt buộc phải tạo lỗi rõ ràng. Kiểu dữ liệu thay đổi cần được theo dõi theo phiên bản contract.
Dùng float cho tiền. Production nên giữ Decimal hoặc số nguyên theo đơn vị nhỏ nhất để tránh sai số nhị phân.
10. Nâng cấp thành ETL production
Pipeline production cần tách raw, staging và curated. Raw giữ nguyên dữ liệu nguồn để chạy lại. Staging phản ánh batch đã chuẩn hóa và thường có thời gian lưu ngắn. Curated chứa bảng đã áp dụng business rule phục vụ báo cáo. Không chỉnh sửa file raw để che lỗi.
Incremental load có thể dựa trên file checksum, timestamp, sequence ID hoặc Change Data Capture. Watermark phải được cập nhật chỉ sau khi load thành công. Với dữ liệu late-arriving, pipeline cần cửa sổ đọc chồng lấn và upsert để vừa không bỏ sót vừa không nhân đôi.
Observability bao gồm số dòng, thời gian chạy, freshness, duplicate rate, invalid rate, schema drift và phân bố dữ liệu. Alert nên gắn với hành động rõ ràng. Lỗi network có thể retry, lỗi schema cần data owner xử lý, còn doanh thu giảm bất thường cần xác minh nghiệp vụ.
Security yêu cầu secret manager, tài khoản quyền tối thiểu, mã hóa kết nối, masking dữ liệu nhạy cảm và log không chứa payload cá nhân. Mỗi bảng cần owner, SLA, retention và lineage. Pipeline nhanh nhưng không có ownership vẫn khó vận hành khi xảy ra sai số.
Orchestration bằng Airflow phù hợp khi có dependency, backfill và nhiều pipeline. Tuy nhiên, đưa một script chưa idempotent vào Airflow không làm nó đáng tin cậy hơn. Trước tiên phải hoàn thiện transaction, audit, retry policy và data quality.
Thiết kế incremental load và xử lý dữ liệu đến muộn
Khi dữ liệu tăng lên, đọc lại toàn bộ nguồn ở mỗi lần chạy sẽ tốn thời gian và làm tăng rủi ro khóa bảng đích. Pipeline thực tế nên lưu một watermark, thường là thời điểm cập nhật lớn nhất hoặc khóa tăng dần lớn nhất đã xử lý thành công. Lần chạy kế tiếp chỉ lấy những bản ghi mới hơn watermark đó. Watermark chỉ được cập nhật sau khi transaction tải dữ liệu hoàn tất; nếu cập nhật sớm, một lần chạy lỗi có thể khiến dữ liệu bị bỏ sót vĩnh viễn.
Dữ liệu đến muộn cần một khoảng nhìn lại. Ví dụ, nếu đơn hàng có thể được sửa trong ba ngày, pipeline nên lấy lại dữ liệu từ watermark trừ ba ngày, sau đó dùng khóa nghiệp vụ để upsert. Cách này cố ý đọc trùng một phần dữ liệu nhưng giữ kết quả đúng. Điều kiện quan trọng là bước load phải idempotent: chạy lại cùng một batch không được tạo thêm bản ghi hoặc cộng doanh thu hai lần.
from datetime import timedelta

lookback_start = last_watermark - timedelta(days=3)
query = """
SELECT order_id, customer_id, order_date, quantity, unit_price, updated_at
FROM source_orders
WHERE updated_at >= :lookback_start
  AND updated_at < :window_end
"""
Trong hệ thống có nhiều nguồn, mỗi nguồn nên có watermark riêng. Bảng metadata có thể lưu tên pipeline, tên nguồn, cửa sổ bắt đầu, cửa sổ kết thúc, trạng thái, số bản ghi và checksum. Nhờ đó đội vận hành biết chính xác batch nào đã thành công, batch nào cần chạy lại và phạm vi dữ liệu nào bị ảnh hưởng.
Staging table và tải dữ liệu nguyên tử
Không nên ghi trực tiếp từng dòng vào bảng báo cáo. Pipeline nên nạp batch vào staging table, chạy các kiểm tra số lượng, khóa duy nhất và tổng kiểm soát, rồi mới merge vào bảng đích trong một transaction. Nếu bất kỳ bước kiểm tra nào thất bại, transaction được rollback và bảng phục vụ báo cáo vẫn giữ trạng thái nhất quán. Với bảng cần thay thế toàn bộ, có thể tạo bảng phiên bản mới, kiểm tra xong rồi đổi tên trong một thao tác được database hỗ trợ.
Staging table cũng tạo ranh giới rõ giữa dữ liệu vừa trích xuất và dữ liệu đã được chấp nhận. Các bản ghi lỗi nên được ghi sang bảng quarantine cùng mã lỗi, tên cột, giá trị gốc và run_id. Không nên im lặng loại bỏ chúng vì đội nghiệp vụ cần biết doanh thu bị thiếu do lỗi nguồn hay do quy tắc làm sạch.
Chiến lược kiểm thử cho ETL
Unit test phù hợp với các hàm chuyển đổi thuần như chuẩn hóa mã cửa hàng, tính doanh thu và kiểm tra ngày. Integration test cần một database tạm để xác nhận transaction, upsert và ràng buộc khóa hoạt động đúng. Contract test kiểm tra schema nguồn, chẳng hạn cột bắt buộc, kiểu dữ liệu và tập giá trị hợp lệ. Cuối cùng, một bài kiểm thử end-to-end chạy dataset nhỏ đã biết trước kết quả để so sánh số dòng, doanh thu và số bản ghi bị từ chối.
def test_calculate_revenue():
    source = pd.DataFrame({
        "quantity": [2, 3],
        "unit_price": [100_000, 50_000],
    })

    result = calculate_revenue(source)

    assert result["revenue"].tolist() == [200_000, 150_000]
    assert result["revenue"].sum() == 350_000
Kiểm thử không thay thế reconciliation sau khi chạy. Test chứng minh logic hoạt động với các tình huống đã thiết kế, còn reconciliation chứng minh batch hiện tại không làm thất thoát hoặc nhân đôi dữ liệu. Hai lớp bảo vệ này nên được triển khai cùng nhau.
Tối ưu hiệu năng mà không làm mất khả năng kiểm soát
Với file lớn, hãy đọc theo chunk và ghi theo batch thay vì giữ toàn bộ DataFrame trong bộ nhớ. Kích thước batch cần được đo thực tế vì batch quá nhỏ tạo nhiều lần giao tiếp với database, còn batch quá lớn kéo dài transaction và tiêu thụ nhiều RAM. Trước khi tối ưu, hãy ghi thời gian của từng pha extract, transform, validate và load. Số liệu này giúp tập trung vào nút thắt thực sự thay vì tối ưu theo cảm giác.
Khi chạy song song, mỗi worker phải xử lý phạm vi không giao nhau hoặc cùng tuân thủ cơ chế upsert. Giới hạn kết nối cũng phải phù hợp với connection pool của database. Nhanh hơn không có ý nghĩa nếu pipeline tạo tải đột biến, làm chậm hệ thống giao dịch hoặc khiến việc chạy lại khó dự đoán.
11. Bài tập thực hành
- Thêm cột
updated_at, giữ phiên bản mới nhất khi duplicate xuất hiện trong cùng batch. - Ghi audit failure bằng transaction riêng và bảo đảm chương trình trả exit code khác 0.
- Thay executemany bằng staging table và PostgreSQL COPY, sau đó merge vào bảng đích.
12. Project mở rộng
Xây Retail ETL Platform nhận đơn hàng, sản phẩm và tồn kho từ nhiều cửa hàng. Hệ thống cần raw storage, schema contract, staging, upsert, rejected zone, audit, backfill theo ngày và dashboard quan sát pipeline. Portfolio nên có Docker Compose, migration, unit test, integration test, dữ liệu giả lập và tài liệu giải thích grain của từng bảng.
Tiêu chí hoàn thành gồm chạy lại không tạo duplicate, file lỗi không làm mất batch khác, reconciliation cân bằng, retry không làm sai trạng thái và có thể truy một dòng bảng đích về source file cùng run ID. Đây là những bằng chứng có giá trị hơn một sơ đồ kiến trúc đẹp nhưng không có code vận hành.
13. Tổng kết
Bạn vừa xây ETL Pipeline bằng Python có checksum, run ID, schema validation, business rule, rejected rows, reconciliation, transaction và upsert. Đầu vào là file đơn hàng, đầu ra là bảng PostgreSQL có thể phục vụ báo cáo cùng audit giải thích toàn bộ lần chạy.
Giá trị cốt lõi của ETL không phải di chuyển dữ liệu nhanh nhất mà là tạo dữ liệu đúng, có thể chạy lại và có thể điều tra. Khi ba yêu cầu này được giải quyết, việc bổ sung scheduler, cloud storage hoặc công cụ orchestration mới thực sự tạo giá trị.
14. Tài liệu tham khảo
- Python hashlib: https://docs.python.org/3/library/hashlib.html
- Python logging: https://docs.python.org/3/library/logging.html
- Pandas read_csv: https://pandas.pydata.org/docs/reference/api/pandas.read_csv.html
- Pandas DataFrame.to_sql: https://pandas.pydata.org/docs/reference/api/pandas.DataFrame.to_sql.html
- SQLAlchemy Transactions: https://docs.sqlalchemy.org/en/20/core/connections.html
- PostgreSQL INSERT ON CONFLICT: https://www.postgresql.org/docs/current/sql-insert.html
- PostgreSQL Constraints: https://www.postgresql.org/docs/current/ddl-constraints.html
TechData.AI - Leading the Future.
Tham khảo các khoá học theo link: https://techdata.ai/techdata-ai-course/
Hoàng Minh.