



Tự động hóa báo cáo bằng Python là chủ đề trọng tâm của bài viết. Nhiều doanh nghiệp đã có database và dashboard nhưng vẫn duy trì các báo cáo Excel định kỳ cho ban điều hành, đối tác hoặc bộ phận vận hành. Vấn đề không nằm ở việc tạo một workbook, mà ở chuỗi công việc lặp lại: lấy dữ liệu đúng kỳ, kiểm tra số liệu, tính KPI, định dạng bảng, tạo biểu đồ, lưu đúng tên file và ghi lại bằng chứng đối soát. Bài viết này xây dựng một ứng dụng Python hoàn chỉnh để tự động hóa quy trình đó theo cách có thể kiểm tra và vận hành lâu dài.
Mục lục
- Bài toán thực tế
- Sau bài này bạn sẽ làm được gì?
- Kiến thức Python cần dùng
- Chuẩn bị môi trường
- Hiểu dữ liệu đầu vào
- Xây dựng ứng dụng từng bước
- Ghép thành chương trình hoàn chỉnh
- Kiểm tra kết quả
- Những lỗi thường gặp
- Nâng cấp từ demo thành ứng dụng thực tế
- Bài tập thực hành
- Project mở rộng
- Tổng kết
- Tài liệu tham khảo
1. Bài toán thực tế
Giả sử một doanh nghiệp bán lẻ có 40 cửa hàng. Trước 8 giờ sáng mỗi ngày, bộ phận vận hành phải gửi báo cáo doanh thu ngày hôm trước cho ban giám đốc. Báo cáo gồm doanh thu theo cửa hàng, số đơn hoàn tất, giá trị đơn trung bình, tỷ lệ đơn hủy và danh sách cửa hàng chưa đạt mục tiêu. Dữ liệu đơn hàng nằm trong PostgreSQL, còn chỉ tiêu doanh thu được quản lý trong một file Excel do phòng kế hoạch cập nhật mỗi tháng.
Quy trình thủ công thường bắt đầu bằng việc chạy một câu SQL, xuất CSV, mở file chỉ tiêu, dùng hàm tra cứu, tạo PivotTable, định dạng số tiền và sao chép vài con số vào email. Nếu truy vấn sai khoảng ngày, một cửa hàng bị thiếu trong file chỉ tiêu hoặc nhân viên quên loại đơn hủy, báo cáo vẫn có thể được gửi mà không có dấu hiệu cảnh báo. Khi số liệu bị chất vấn, việc truy lại chính xác dữ liệu và công thức đã dùng rất khó.
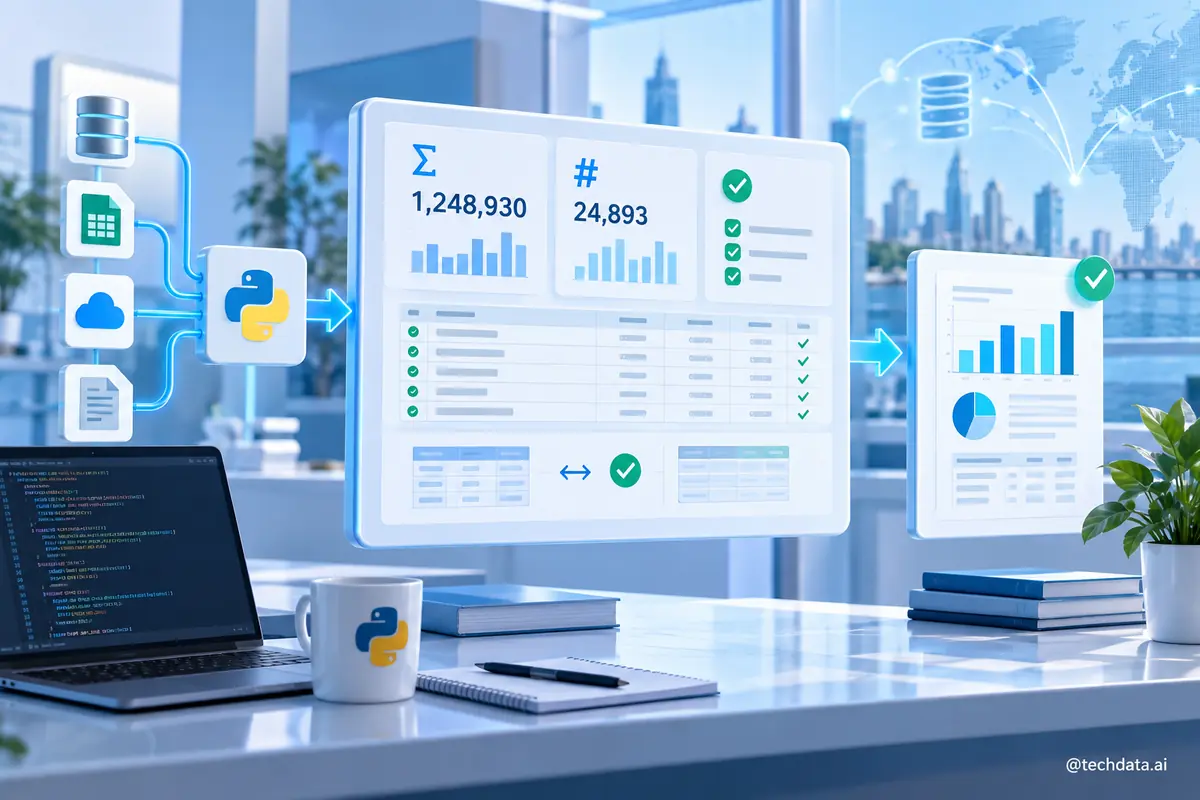
Ứng dụng trong bài tự động thực hiện toàn bộ phần xử lý dữ liệu và tạo workbook. Chương trình nhận ngày báo cáo, đọc dữ liệu đơn hàng từ SQL, đọc chỉ tiêu từ Excel, kiểm tra schema, xác thực business rule, tính KPI, đối chiếu tổng số dòng và xuất file có nhiều sheet. File chỉ được xem là thành công khi các kiểm tra chất lượng đều đạt.
2. Sau bài này bạn sẽ làm được gì?
Sau bài viết, bạn sẽ có project tạo file daily_sales_report_YYYYMMDD.xlsx. Workbook gồm sheet executive_summary cho lãnh đạo, store_performance cho bộ phận vận hành, invalid_rows cho dữ liệu cần kiểm tra và data_quality ghi lại các chỉ số đối soát.
Chương trình có thể chạy lại cho một ngày bất kỳ, không ghi đè nhầm báo cáo khác và trả về exit status lỗi nếu dữ liệu không đạt điều kiện. Người đọc sẽ thực hành cách tách cấu hình, extract, transform, validate, calculate KPI và export thành các function độc lập. Đây là cấu trúc đủ rõ để sau này đưa vào cron, Airflow, n8n hoặc một nền tảng orchestration khác.
3. Kiến thức Python cần dùng
Project sử dụng SQLAlchemy và Pandas để truy vấn PostgreSQL, Pandas để xử lý dữ liệu, OpenPyXL để định dạng workbook và pathlib để quản lý đường dẫn. datetime xác định khoảng thời gian báo cáo. Function và exception giúp tổ chức quy trình thành các bước có trách nhiệm rõ ràng.
Phần SQL dùng bind parameter để dữ liệu đầu vào không bị ghép trực tiếp vào câu truy vấn. Phần Excel dùng ExcelWriter tạo nhiều sheet trong một lần ghi, sau đó OpenPyXL điều chỉnh chiều rộng cột, định dạng tiền và cố định dòng tiêu đề. Code không dùng macro Excel nên có thể chạy trên server không cài Microsoft Office.
4. Chuẩn bị môi trường
Project dùng Python 3.11 trở lên. Tạo virtual environment và cài thư viện:
python -m venv .venv
source .venv/bin/activate
python -m pip install pandas sqlalchemy "psycopg[binary]" openpyxl python-dotenv
Trên Windows, dùng command .venvScriptsactivate để kích hoạt môi trường. Cấu trúc thư mục đề xuất:
python-automated-report/
    data/
        targets.xlsx
    output/
    .env
    .gitignore
    main.py
    requirements.txt
File .env chứa biến DATABASE_URL trong môi trường phát triển. Không commit file này lên Git. Trong production, thông tin xác thực nên được cấp từ secret manager hoặc biến môi trường của nền tảng triển khai.
5. Hiểu dữ liệu đầu vào
Bảng order_items có grain là một sản phẩm trong một đơn hàng. Một đơn có nhiều sản phẩm nên order_id có thể lặp lại. Khóa dòng phù hợp là tổ hợp order_id và product_id, hoặc một order_item_id duy nhất nếu hệ thống nguồn cung cấp.
| Cột | Ý nghĩa | Quy tắc kiểm tra |
|---|---|---|
| order_id | Mã đơn hàng | Không được trống |
| product_id | Mã sản phẩm | Không được trống |
| store_id | Mã cửa hàng | Phải tồn tại trong danh mục cửa hàng |
| order_time | Thời điểm đặt hàng | Nằm trong kỳ báo cáo |
| status | Trạng thái đơn | Thuộc miền giá trị cho phép |
| quantity | Số lượng | Số nguyên dương |
| unit_price | Đơn giá | Không âm |
| discount_amount | Giảm giá theo dòng | Không âm và không vượt thành tiền |
File targets.xlsx có một dòng cho mỗi cửa hàng và tháng, gồm month, store_id và revenue_target. Nếu một cửa hàng xuất hiện trong đơn hàng nhưng không có chỉ tiêu, chương trình không nên tự gán chỉ tiêu bằng 0 vì điều đó khiến tỷ lệ hoàn thành mất ý nghĩa. Trường hợp này phải được ghi nhận trong kiểm tra chất lượng.
6. Xây dựng ứng dụng từng bước
Bước 1: Tạo cấu hình và khoảng thời gian báo cáo
Vấn đề. Báo cáo hằng ngày phải lấy đủ dữ liệu trong ngày nhưng không đếm trùng bản ghi ở ranh giới giữa hai ngày. Chúng ta dùng khoảng thời gian đóng ở đầu và mở ở cuối.
from datetime import date, datetime, time, timedelta
from pathlib import Path


OUTPUT_DIR = Path("output")
TARGET_FILE = Path("data/targets.xlsx")


def build_report_window(
    report_date: date,
) -> tuple[datetime, datetime]:
    start_time = datetime.combine(
        report_date,
        time.min,
    )
    end_time = start_time + timedelta(days=1)
    return start_time, end_time
Giải thích code. Query sẽ lấy bản ghi có thời gian lớn hơn hoặc bằng start_time và nhỏ hơn end_time. Cách này ổn định hơn việc tìm thời điểm 23 giờ 59 phút 59 giây vì database có thể lưu độ chính xác đến microsecond.
Bước 2: Truy vấn dữ liệu đơn hàng
import os

import pandas as pd
from sqlalchemy import create_engine, text


ORDER_QUERY = text("""
    SELECT
        order_id,
        product_id,
        store_id,
        order_time,
        status,
        quantity,
        unit_price,
        COALESCE(discount_amount, 0)
            AS discount_amount
    FROM order_items
    WHERE order_time >= :start_time
      AND order_time < :end_time
""")


def create_database_engine():
    database_url = os.getenv("DATABASE_URL")
    if not database_url:
        raise RuntimeError(
            "Chưa cấu hình DATABASE_URL"
        )

    return create_engine(
        database_url,
        pool_pre_ping=True,
    )


def extract_orders(
    engine,
    start_time: datetime,
    end_time: datetime,
) -> pd.DataFrame:
    with engine.connect() as connection:
        return pd.read_sql_query(
            ORDER_QUERY,
            connection,
            params={
                "start_time": start_time,
                "end_time": end_time,
            },
        )
Giải thích code. Bind parameter tách giá trị ngày khỏi cấu trúc SQL. Connection được đóng tự động khi ra khỏi context manager. Tài khoản báo cáo chỉ cần quyền đọc những bảng nguồn thực sự cần thiết.
Bước 3: Đọc và kiểm tra file chỉ tiêu
def extract_targets(
    file_path: Path,
    report_date: date,
) -> pd.DataFrame:
    targets = pd.read_excel(
        file_path,
        dtype={"store_id": "string"},
    )

    required_columns = {
        "month",
        "store_id",
        "revenue_target",
    }

    missing = sorted(
        required_columns - set(targets.columns)
    )
    if missing:
        raise ValueError(
            f"File chỉ tiêu thiếu cột: {missing}"
        )

    targets["month"] = pd.to_datetime(
        targets["month"],
        errors="coerce",
    ).dt.to_period("M")

    targets["revenue_target"] = pd.to_numeric(
        targets["revenue_target"],
        errors="coerce",
    )

    selected_month = pd.Period(
        report_date,
        freq="M",
    )

    return targets.loc[
        targets["month"].eq(selected_month)
    ].copy()
Chương trình lọc chỉ tiêu theo tháng của ngày báo cáo. Các dòng có tháng hoặc chỉ tiêu không chuyển đổi được cần được kiểm tra trước khi merge. Production nên quản lý target trong database có lịch sử phiên bản thay vì phụ thuộc vào một workbook được sửa trực tiếp.
Bước 4: Làm sạch và xác thực đơn hàng
VALID_STATUSES = {
    "completed",
    "cancelled",
    "refunded",
}


def validate_orders(
    frame: pd.DataFrame,
) -> tuple[pd.DataFrame, pd.DataFrame]:
    checked = frame.copy()

    for column in [
        "order_id",
        "product_id",
        "store_id",
        "status",
    ]:
        checked[column] = (
            checked[column]
            .astype("string")
            .str.strip()
        )

    checked["status"] = checked[
        "status"
    ].str.lower()

    for column in [
        "quantity",
        "unit_price",
        "discount_amount",
    ]:
        checked[column] = pd.to_numeric(
            checked[column],
            errors="coerce",
        )

    checked["gross_revenue"] = (
        checked["quantity"]
        * checked["unit_price"]
    )
    checked["net_revenue"] = (
        checked["gross_revenue"]
        - checked["discount_amount"]
    )

    conditions = {
        "missing_order_id": (
            checked["order_id"].isna()
        ),
        "missing_product_id": (
            checked["product_id"].isna()
        ),
        "missing_store_id": (
            checked["store_id"].isna()
        ),
        "invalid_status": (
            ~checked["status"].isin(
                VALID_STATUSES
            )
        ),
        "invalid_quantity": (
            checked["quantity"].isna()
            | (checked["quantity"] <= 0)
            | (checked["quantity"] % 1 != 0)
        ),
        "invalid_unit_price": (
            checked["unit_price"].isna()
            | (checked["unit_price"] < 0)
        ),
        "invalid_discount": (
            checked["discount_amount"].isna()
            | (checked["discount_amount"] < 0)
            | (checked["net_revenue"] < 0)
        ),
    }

    checked["validation_errors"] = ""
    for name, mask in conditions.items():
        checked.loc[
            mask,
            "validation_errors",
        ] += name + ";"

    valid_mask = checked[
        "validation_errors"
    ].eq("")

    return (
        checked.loc[valid_mask].copy(),
        checked.loc[~valid_mask].copy(),
    )
Một dòng có thể vi phạm nhiều quy tắc nên cột lỗi giữ tất cả nguyên nhân. Chương trình không tự sửa số lượng âm hoặc giảm giá vượt thành tiền vì không có đủ bằng chứng để xác định giá trị đúng. Các dòng này được đưa vào sheet riêng để xử lý tại nguồn.
Bước 5: Tính KPI theo cửa hàng
def build_store_performance(
    valid_rows: pd.DataFrame,
    targets: pd.DataFrame,
) -> pd.DataFrame:
    order_summary = (
        valid_rows
        .groupby(
            ["store_id", "status"],
            as_index=False,
        )
        .agg(
            order_count=("order_id", "nunique"),
            net_revenue=("net_revenue", "sum"),
        )
    )

    orders = (
        order_summary
        .pivot(
            index="store_id",
            columns="status",
            values="order_count",
        )
        .fillna(0)
        .reset_index()
    )

    completed_rows = valid_rows.loc[
        valid_rows["status"].eq("completed")
    ]

    revenue = (
        completed_rows
        .groupby("store_id", as_index=False)
        .agg(
            completed_orders=(
                "order_id",
                "nunique",
            ),
            total_quantity=(
                "quantity",
                "sum",
            ),
            net_revenue=(
                "net_revenue",
                "sum",
            ),
        )
    )

    performance = revenue.merge(
        orders,
        on="store_id",
        how="outer",
    ).merge(
        targets[
            ["store_id", "revenue_target"]
        ],
        on="store_id",
        how="left",
        validate="one_to_one",
    )

    performance["average_order_value"] = (
        performance["net_revenue"]
        / performance["completed_orders"]
    )

    total_orders = (
        performance.get("completed", 0)
        + performance.get("cancelled", 0)
        + performance.get("refunded", 0)
    )

    performance["cancellation_rate"] = (
        performance.get("cancelled", 0)
        / total_orders.where(
            total_orders.ne(0)
        )
    )

    performance["target_achievement"] = (
        performance["net_revenue"]
        / performance["revenue_target"]
    )

    return performance.sort_values(
        "net_revenue",
        ascending=False,
    )
validate="one_to_one" khiến merge báo lỗi nếu file chỉ tiêu có hai dòng cho cùng một cửa hàng. Đây là lựa chọn an toàn hơn việc để duplicate âm thầm nhân đôi doanh thu. Khi chia, mẫu số bằng 0 được chuyển thành missing để tránh tạo giá trị vô hạn.
Bước 6: Tạo executive summary
def build_executive_summary(
    performance: pd.DataFrame,
    report_date: date,
) -> pd.DataFrame:
    summary = [
        ("report_date", str(report_date)),
        (
            "store_count",
            int(performance["store_id"].nunique()),
        ),
        (
            "completed_orders",
            int(
                performance[
                    "completed_orders"
                ].sum()
            ),
        ),
        (
            "net_revenue",
            float(
                performance[
                    "net_revenue"
                ].sum()
            ),
        ),
        (
            "stores_below_target",
            int(
                performance[
                    "target_achievement"
                ].lt(1).sum()
            ),
        ),
    ]

    return pd.DataFrame(
        summary,
        columns=["metric", "value"],
    )
Bước 7: Xuất và định dạng workbook
from openpyxl.styles import Font, PatternFill


def export_report(
    output_file: Path,
    summary: pd.DataFrame,
    performance: pd.DataFrame,
    invalid_rows: pd.DataFrame,
    quality_report: pd.DataFrame,
) -> None:
    output_file.parent.mkdir(
        parents=True,
        exist_ok=True,
    )

    with pd.ExcelWriter(
        output_file,
        engine="openpyxl",
    ) as writer:
        summary.to_excel(
            writer,
            sheet_name="executive_summary",
            index=False,
        )
        performance.to_excel(
            writer,
            sheet_name="store_performance",
            index=False,
        )
        invalid_rows.to_excel(
            writer,
            sheet_name="invalid_rows",
            index=False,
        )
        quality_report.to_excel(
            writer,
            sheet_name="data_quality",
            index=False,
        )

        for worksheet in writer.book.worksheets:
            worksheet.freeze_panes = "A2"
            worksheet.auto_filter.ref = (
                worksheet.dimensions
            )

            for cell in worksheet[1]:
                cell.font = Font(
                    bold=True,
                    color="FFFFFF",
                )
                cell.fill = PatternFill(
                    "solid",
                    fgColor="1F4E78",
                )

            for column_cells in worksheet.columns:
                max_length = max(
                    len(str(cell.value or ""))
                    for cell in column_cells
                )
                width = min(max_length + 2, 40)
                worksheet.column_dimensions[
                    column_cells[0].column_letter
                ].width = width
Giới hạn chiều rộng cột ở mức 40 giúp workbook không bị kéo quá rộng khi một ô chứa thông báo lỗi dài. Có thể bổ sung định dạng tiền và phần trăm theo tên cột, nhưng không nên dành quá nhiều logic trình bày cho file nếu dashboard mới là kênh sử dụng chính.
7. Ghép thành chương trình hoàn chỉnh
from datetime import date, datetime, time, timedelta
import os
from pathlib import Path

import pandas as pd
from dotenv import load_dotenv
from openpyxl.styles import Font, PatternFill
from sqlalchemy import create_engine, text


OUTPUT_DIR = Path("output")
TARGET_FILE = Path("data/targets.xlsx")

ORDER_QUERY = text("""
    SELECT
        order_id,
        product_id,
        store_id,
        order_time,
        status,
        quantity,
        unit_price,
        COALESCE(discount_amount, 0)
            AS discount_amount
    FROM order_items
    WHERE order_time >= :start_time
      AND order_time < :end_time
""")


def main() -> None:
    load_dotenv()

    report_date = (
        date.today() - timedelta(days=1)
    )
    start_time, end_time = (
        build_report_window(report_date)
    )

    engine = create_database_engine()

    raw_orders = extract_orders(
        engine,
        start_time,
        end_time,
    )

    targets = extract_targets(
        TARGET_FILE,
        report_date,
    )

    valid_rows, invalid_rows = (
        validate_orders(raw_orders)
    )

    performance = build_store_performance(
        valid_rows,
        targets,
    )

    missing_targets = int(
        performance[
            "revenue_target"
        ].isna().sum()
    )

    if missing_targets:
        raise ValueError(
            f"Có {missing_targets} cửa hàng "
            "chưa được cấu hình chỉ tiêu"
        )

    summary = build_executive_summary(
        performance,
        report_date,
    )

    quality_report = pd.DataFrame(
        [
            ("input_records", len(raw_orders)),
            ("valid_records", len(valid_rows)),
            ("invalid_records", len(invalid_rows)),
            (
                "valid_rate",
                round(
                    len(valid_rows)
                    / max(len(raw_orders), 1),
                    4,
                ),
            ),
            (
                "net_revenue",
                performance[
                    "net_revenue"
                ].sum(),
            ),
        ],
        columns=["metric", "value"],
    )

    output_file = OUTPUT_DIR / (
        "daily_sales_report_"
        f"{report_date:%Y%m%d}.xlsx"
    )

    export_report(
        output_file,
        summary,
        performance,
        invalid_rows,
        quality_report,
    )

    print(
        quality_report.to_string(
            index=False
        )
    )
    print(
        f"Report: {output_file.resolve()}"
    )


if __name__ == "__main__":
    main()
Chương trình hoàn chỉnh sử dụng các function đã xây dựng ở phần trước. Khi triển khai project thực tế, đặt mỗi nhóm function vào module riêng như extract.py, transform.py, validate.py và export.py. Bài viết giữ trong một file để người mới có thể sao chép và chạy dễ dàng.
8. Kiểm tra kết quả
Giả sử database trả về 182.450 dòng đơn hàng. Pipeline phát hiện 245 dòng lỗi và tạo báo cáo cho 40 cửa hàng. Output trên terminal có thể giống như sau:
              metric          value
       input_records      182450.00
       valid_records      182205.00
     invalid_records         245.00
          valid_rate           1.00
          net_revenue  9326815000.00

Report: /project/output/daily_sales_report_20260919.xlsx
Không dừng ở việc file đã được tạo. Trước tiên, xác nhận input bằng valid cộng invalid. Tiếp theo, chạy một câu SQL độc lập để đối chiếu số đơn hoàn tất và doanh thu thuần. Tổng doanh thu trong executive summary phải bằng tổng cột net_revenue của sheet cửa hàng. Danh sách cửa hàng trong báo cáo phải khớp với danh mục hoạt động trong ngày.
Mở workbook và kiểm tra tên sheet, số dòng, định dạng header, filter và freeze pane. Chọn ngẫu nhiên ba cửa hàng để đối chiếu chi tiết với dữ liệu nguồn. Với báo cáo tài chính quan trọng, lưu kết quả kiểm tra cùng run ID thay vì chỉ quan sát thủ công.
9. Những lỗi thường gặp
Báo cáo lấy sai ngày
Server có thể chạy theo UTC trong khi nghiệp vụ sử dụng múi giờ Việt Nam. Production cần dùng timezone-aware datetime và thống nhất timezone của cột nguồn. Không sửa sai lệch bằng cách cộng giờ tùy ý trong nhiều nơi của code.
Merge làm tăng số dòng
Nguyên nhân thường là bảng chỉ tiêu hoặc dimension có duplicate key. Dùng tham số validate khi merge và kiểm tra uniqueness trước khi ghép. Không loại duplicate ngẫu nhiên nếu chưa xác định bản ghi nào có hiệu lực.
PermissionError khi ghi Excel
File đầu ra có thể đang mở trong Excel. Quy trình tự động nên ghi vào file tạm, kiểm tra thành công rồi đổi tên cuối cùng. Tên file chứa ngày hoặc run ID giúp tránh ghi đè báo cáo đang được sử dụng.
Workbook có số nhưng kiểu hiển thị không đúng
Excel lưu giá trị và định dạng hiển thị riêng. Sau khi ghi dữ liệu, có thể gán number_format cho cột tiền và phần trăm. Không chuyển số thành chuỗi chỉ để thêm dấu phân cách vì điều đó làm người dùng không thể tính toán tiếp.
Email được gửi dù dữ liệu lỗi
Bước phân phối phải chạy sau quality gate. Nếu schema sai, thiếu chỉ tiêu hoặc tỷ lệ lỗi vượt ngưỡng, pipeline phải dừng và gửi cảnh báo vận hành thay vì phát tán một báo cáo có vẻ hoàn chỉnh.
10. Nâng cấp từ demo thành ứng dụng thực tế
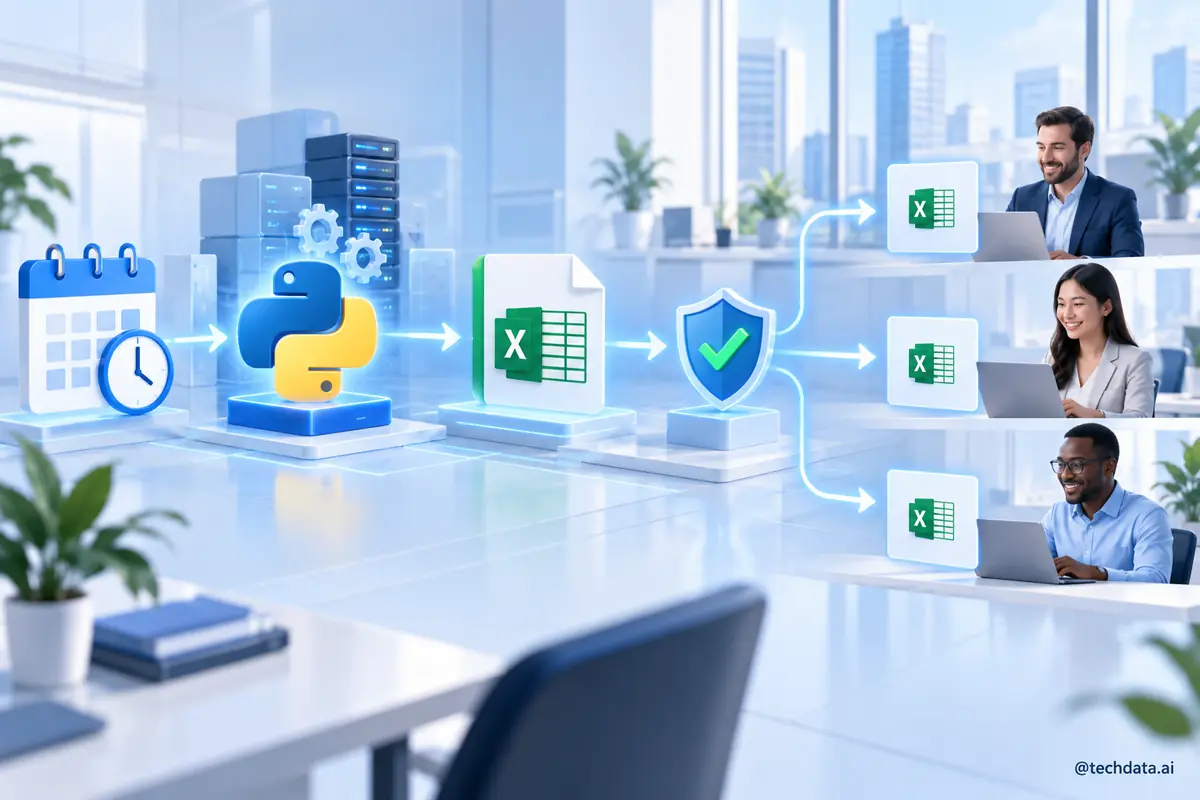
Production cần tách quá trình tạo báo cáo và quá trình phân phối. Bước tạo báo cáo sinh artifact cùng metadata gồm run ID, ngày báo cáo, thời điểm hoàn tất, checksum, số dòng và phiên bản code. Bước phân phối chỉ nhận artifact đã vượt quality gate. Cách tách này giúp retry việc gửi mà không phải chạy lại toàn bộ truy vấn.
Logging cần ghi trạng thái từng bước, thời gian xử lý và thông tin đối soát nhưng không ghi mật khẩu hoặc dữ liệu khách hàng chi tiết. Chương trình cần exit code khác 0 khi thất bại để scheduler nhận biết. Retry chỉ áp dụng cho lỗi tạm thời như network timeout; lỗi schema và business rule cần được xử lý bởi con người hoặc hệ thống nguồn.
Khi số người nhận tăng, gửi file đính kèm không còn là phương án tốt. Có thể lưu báo cáo trong kho tài liệu có kiểm soát quyền và gửi liên kết, hoặc chuyển nhu cầu tra cứu sang dashboard. Mỗi người chỉ nên thấy phạm vi dữ liệu phù hợp với vai trò. File chứa dữ liệu nhạy cảm phải có chính sách lưu giữ và xóa rõ ràng.
Lập lịch có thể bắt đầu bằng cron đối với một server đơn giản. Khi có nhiều dependency, backfill, retry và theo dõi trạng thái, Airflow hoặc orchestrator tương đương phù hợp hơn. Dù dùng công cụ nào, tính đúng và khả năng đối soát vẫn quan trọng hơn việc pipeline chạy nhanh.
11. Bài tập thực hành
Level 1: Thêm báo cáo theo khu vực
Bổ sung file danh mục cửa hàng có cột khu vực. Merge danh mục vào dữ liệu và tạo thêm sheet tổng hợp theo khu vực. Dùng validate để bảo đảm mỗi cửa hàng chỉ thuộc một khu vực.
Level 2: Thêm quality gate
Đặt ngưỡng valid rate tối thiểu là 99,5%. Nếu không đạt, chương trình vẫn xuất sheet dữ liệu lỗi nhưng đánh dấu báo cáo là failed và không chuyển sang bước phân phối. Ghi lý do thất bại vào file audit.
Level 3: Lập lịch và gửi thông báo
Đóng gói project thành command nhận tham số ngày. Lập lịch chạy mỗi sáng, lưu báo cáo theo thư mục năm và tháng, gửi thông báo thành công hoặc thất bại. Thông tin xác thực phải lấy từ biến môi trường hoặc secret manager.
12. Project mở rộng
Xây Reporting Platform nhỏ cho doanh nghiệp có nhiều loại báo cáo. Hệ thống cần đọc cấu hình báo cáo, chạy query có tham số, áp dụng quality rule, xuất Excel, lưu artifact, ghi audit vào database và phân phối theo nhóm người nhận. Mỗi báo cáo có owner, SLA, lịch chạy, phiên bản schema và chính sách lưu giữ.
Portfolio nên có Docker Compose cho PostgreSQL, dữ liệu mẫu, migration tạo bảng, unit test cho KPI, integration test cho query, ảnh workbook kết quả và tài liệu giải thích cách chạy lại một kỳ cũ. Đây là sản phẩm thể hiện đồng thời Python, SQL, Data Engineering, kiểm soát chất lượng và tư duy vận hành.
13. Tổng kết
Bạn vừa dùng Python để tự động hóa một báo cáo từ lúc đọc dữ liệu SQL và file chỉ tiêu đến khi tạo workbook có executive summary, chi tiết theo cửa hàng, dữ liệu lỗi và báo cáo chất lượng. Project không chỉ thay thao tác Excel thủ công mà còn bổ sung schema validation, business rule, reconciliation và khả năng chạy lại.
Điểm quan trọng nhất của tự động hóa báo cáo là tạo ra kết quả đáng tin cậy đúng thời điểm. Một file được sinh tự động nhưng không có kiểm tra dữ liệu chỉ giúp tạo sai số nhanh hơn. Vì vậy, quality gate và audit phải được xem là một phần của sản phẩm, không phải phần bổ sung sau cùng.
14. Tài liệu tham khảo
- Pandas documentation, read_sql_query: https://pandas.pydata.org/docs/reference/api/pandas.read_sql_query.html
- Pandas documentation, read_excel: https://pandas.pydata.org/docs/reference/api/pandas.read_excel.html
- Pandas documentation, merge: https://pandas.pydata.org/docs/reference/api/pandas.DataFrame.merge.html
- Pandas documentation, ExcelWriter: https://pandas.pydata.org/docs/reference/api/pandas.ExcelWriter.html
- OpenPyXL documentation: https://openpyxl.readthedocs.io/en/stable/
- SQLAlchemy Engine Configuration: https://docs.sqlalchemy.org/en/20/core/engines.html
- Python documentation, datetime: https://docs.python.org/3/library/datetime.html
- Python documentation, pathlib: https://docs.python.org/3/library/pathlib.html
TechData.AI - Leading the Future.
Tham khảo các khoá học theo link: https://techdata.ai/techdata-ai-course/
Hoàng Minh.