




BigQuery Cost Optimization: Giảm chi phí truy vấn mà không làm chậm phân tích
BigQuery Cost Optimization: Reducing Query Costs Without Slowing Down Analytics
BigQuery giúp doanh nghiệp phân tích lượng dữ liệu lớn mà không phải tự quản lý máy chủ. Sự tiện lợi này cũng tạo ra một rủi ro: người dùng có thể chạy truy vấn trên hàng terabyte dữ liệu chỉ bằng vài dòng SQL, rồi đến cuối tháng mới nhận ra hóa đơn tăng mạnh. Chi phí không nhất thiết đến từ một truy vấn sai; nó thường là tổng của hàng nghìn thao tác nhỏ thiếu kiểm soát.
Tối ưu chi phí BigQuery không có nghĩa là cắt giảm bằng mọi giá. Một dashboard mất mười phút để mở có thể tiết kiệm tiền hạ tầng nhưng làm hàng trăm nhân viên mất thời gian. Mục tiêu đúng là giảm lượng tài nguyên lãng phí trong khi giữ, hoặc cải thiện, tốc độ và độ tin cậy của phân tích.
BigQuery có nhiều mô hình tính phí. Với mô hình theo lượng dữ liệu xử lý, chi phí truy vấn gắn với số byte được quét. Với mô hình dung lượng, doanh nghiệp mua năng lực xử lý thông qua slot, tức đơn vị tài nguyên tính toán mà BigQuery dùng để thực thi truy vấn. Hai mô hình cần cách quản trị khác nhau.
Tài liệu chính thức của Google Cloud cho biết giá và lựa chọn thanh toán có thể thay đổi theo khu vực, loại dịch vụ và mô hình sử dụng. Vì vậy, bài toán không nên bắt đầu bằng một con số giá cố định. Doanh nghiệp cần xem dữ liệu hóa đơn của chính mình, quy đổi chi phí về nhóm công việc và giá trị tạo ra.
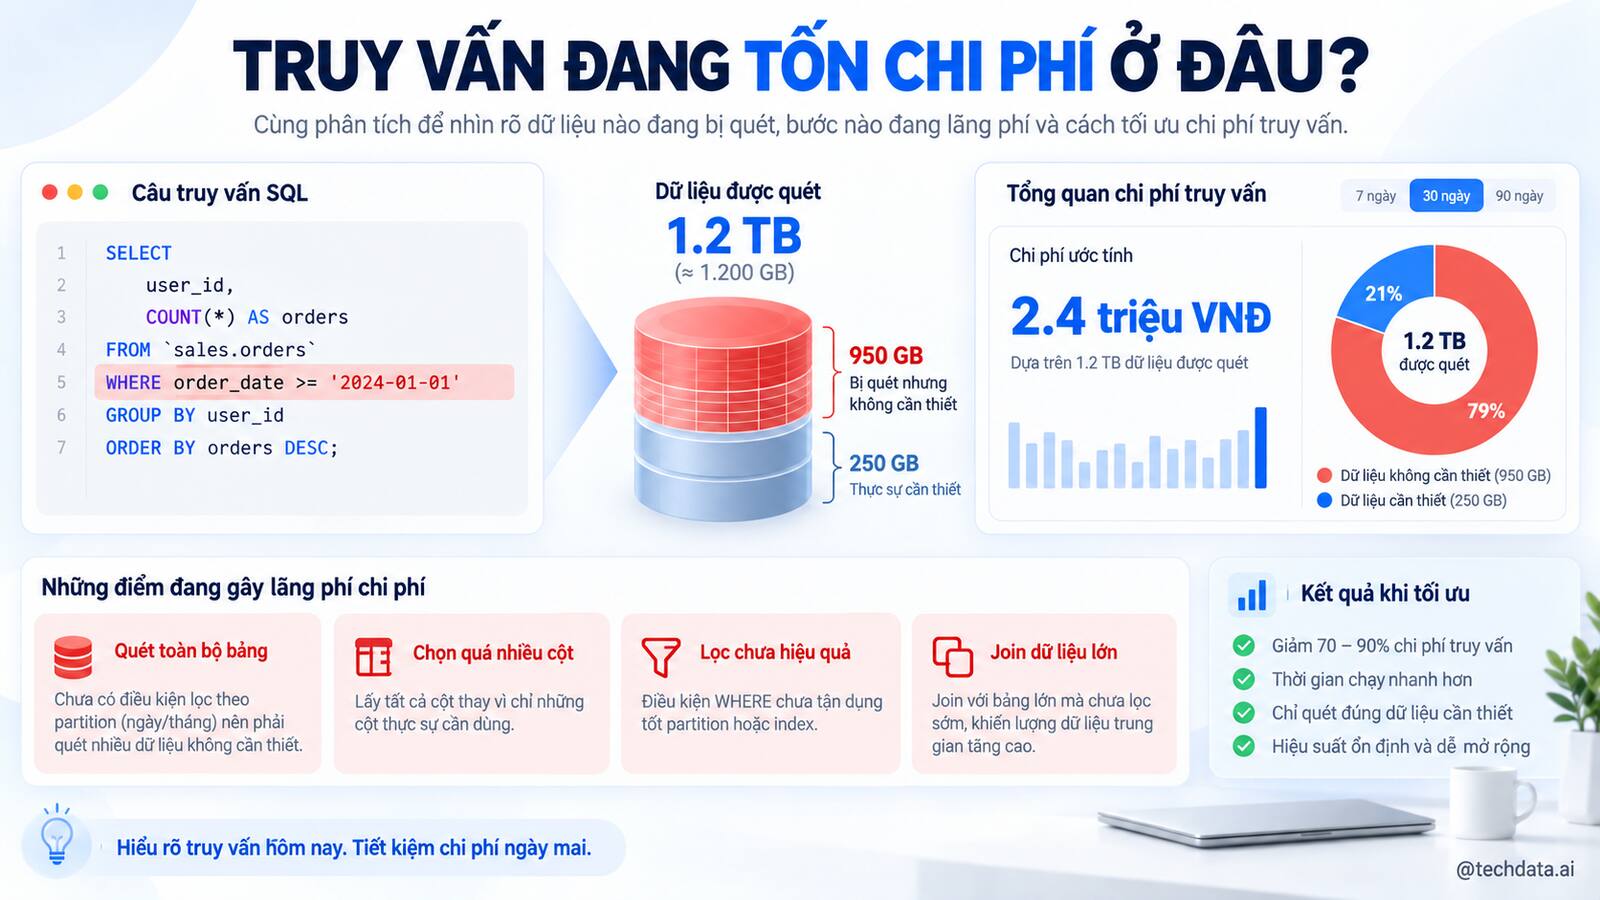
Nhiều truy vấn đắt không hề phức tạp. Câu lệnh chọn tất cả cột từ một bảng lớn có thể đọc dữ liệu mà báo cáo không dùng. Dashboard tự làm mới quá thường xuyên có thể chạy lại cùng một logic hàng trăm lần. Bảng không được phân vùng khiến truy vấn một ngày vẫn quét nhiều năm lịch sử.
Phân vùng là cách chia bảng thành các phần theo ngày, giờ hoặc một trường phù hợp để BigQuery chỉ đọc phần cần thiết. Clustering là sắp xếp dữ liệu theo một số cột thường được lọc để giảm lượng khối phải quét. Hai kỹ thuật này không phải nút “bật là rẻ”; hiệu quả phụ thuộc vào mẫu truy vấn thật.
AI có thể hỗ trợ phân tích lịch sử truy vấn, nhóm các mẫu SQL giống nhau, phát hiện truy vấn tăng chi phí và đề xuất thay đổi. Nhưng AI không nên tự sửa truy vấn sản xuất hoặc xóa bảng. Một gợi ý nhìn đúng cú pháp vẫn có thể làm thay đổi logic kinh doanh và khiến dashboard đưa ra số sai.
Data Platform, tức nền tảng dữ liệu, giúp nối lịch sử truy vấn, hóa đơn, quyền truy cập và chất lượng để chi phí được nhìn theo từng workload, nghĩa là nhóm công việc có mục đích chung. Một truy vấn đắt phục vụ quyết định quan trọng có thể hợp lý; hàng nghìn truy vấn rẻ nhưng không ai dùng lại vẫn là lãng phí.
BigQuery Cost Optimization không phải cuộc cắt giảm máy móc. Doanh nghiệp cần biết tiền đang đi đâu, hành vi nào gây lãng phí và thay đổi nào không làm sai dữ liệu. Kết quả bền vững đến từ kiến trúc đúng, thói quen sử dụng tốt và cơ chế đo giá trị, không chỉ từ vài mẹo sửa SQL.
MỤC LỤC
- PHẦN I — HIỂU ĐÚNG CHI PHÍ BIGQUERY
- PHẦN II — NHỮNG CÁCH TỐI ƯU THỰC TẾ
- PHẦN III — DỮ LIỆU, AI AGENT VÀ CƠ CHẾ KIỂM SOÁT
- PHẦN IV — LỘ TRÌNH TỐI ƯU TRONG 90 NGÀY
- PHẦN V — CASE TỔNG THỂ, TƯƠNG LAI VÀ KẾT LUẬN
PHẦN I — HIỂU ĐÚNG CHI PHÍ BIGQUERY
1. BigQuery thực chất làm những công việc gì?
BigQuery là kho dữ liệu phân tích trên Cloud của Google. Doanh nghiệp đưa dữ liệu từ ERP, CRM, website, ứng dụng và nhiều nguồn khác vào để tổng hợp, tạo báo cáo, phân tích hành vi và huấn luyện mô hình. Người dùng truy vấn bằng SQL, ngôn ngữ phổ biến để chọn và biến đổi dữ liệu.
Khác với cơ sở dữ liệu phục vụ giao dịch từng đơn hàng, BigQuery được thiết kế cho phân tích trên khối lượng lớn. Nó tự quản lý nhiều phần hạ tầng, nhưng doanh nghiệp vẫn phải quyết định cách tổ chức bảng, giữ dữ liệu bao lâu, ai được chạy truy vấn và workload nào xứng đáng với chi phí.
2. Chi phí phát sinh ở những lớp nào?
Chi phí chính thường gồm lưu trữ, xử lý truy vấn, truyền dữ liệu, nạp hoặc xuất dữ liệu và một số dịch vụ liên quan. Một pipeline có thể rẻ ở bước nạp nhưng đắt ở bước biến đổi vì quét lại lịch sử mỗi giờ. Dashboard có thể dùng ít dữ liệu trên màn hình nhưng kích hoạt truy vấn rất lớn phía sau.
Cần tách chi phí trực tiếp của BigQuery khỏi chi phí toàn nền tảng như công cụ BI, điều phối, lưu trữ khác và nhân sự vận hành. Nếu chỉ nhìn một dòng hóa đơn, doanh nghiệp dễ “tối ưu” sang dịch vụ khác mà tổng chi phí không giảm.
3. AI có thể giúp tối ưu ở đâu?
AI phù hợp với việc đọc hàng triệu bản ghi truy vấn, nhóm truy vấn giống nhau và tìm thay đổi bất thường theo người dùng, dự án hoặc dashboard. Nó cũng có thể giải thích query plan, tức kế hoạch thực thi, bằng ngôn ngữ đơn giản và đề xuất điểm cần kiểm tra.
AI không thể biết một bảng hay báo cáo có giá trị kinh doanh hay không nếu không có metadata và chủ sở hữu. Nó cũng có thể đề xuất câu SQL nhanh hơn nhưng sai định nghĩa. Vì thế mọi sửa đổi ảnh hưởng dữ liệu sản xuất phải qua kiểm thử và review của con người.
4. Phân biệt AI Assistant và AI Agent trong FinOps dữ liệu
AI Assistant trả lời khi kỹ sư hỏi vì sao truy vấn này đắt hoặc cách viết lại một đoạn SQL. Người dùng chủ động cung cấp bối cảnh, đánh giá gợi ý và tự thực hiện thay đổi.
AI Agent có thể theo lịch đọc bảng INFORMATION_SCHEMA, phát hiện workload vượt ngưỡng, mở ticket kèm bằng chứng, chạy kiểm thử trên bản sao và đề nghị chủ sở hữu duyệt. Agent chỉ tự động hành động trong giới hạn đã định, chẳng hạn gắn nhãn hoặc tạm dừng một truy vấn thử nghiệm, không tự ngắt báo cáo điều hành.
5. Vì sao dữ liệu quản trị quan trọng?
Để tối ưu, doanh nghiệp cần dữ liệu truy vấn, hóa đơn, reservation, slot, bảng, phân vùng, lịch làm mới, chủ sở hữu và mức sử dụng báo cáo. Đây là metadata, tức dữ liệu mô tả hệ thống dữ liệu. Nếu không biết truy vấn thuộc phòng ban nào và phục vụ mục đích gì, chi phí không thể quy trách nhiệm hợp lý.
Nhãn dự án, mã cost center và tên workload phải nhất quán. Data Catalog giúp tra cứu tài sản, Data Lineage cho biết dữ liệu đi qua những bước nào, còn Data Quality giúp bảo đảm thay đổi tối ưu không làm sai số. Tất cả cần đi cùng quyền truy cập và thời gian lưu log phù hợp.
PHẦN II — NHỮNG CÁCH TỐI ƯU THỰC TẾ
6. Lập bản đồ chi phí theo workload và phòng ban
Bài toán hiện tại. Hóa đơn Cloud thường cho biết dịch vụ và dự án kỹ thuật nhưng không nói rõ chi phí phục vụ dashboard nào, chiến dịch nào hoặc đơn vị kinh doanh nào. Các nhóm vì thế tranh luận mà không có cùng dữ liệu.
AI xử lý như thế nào. Hệ thống kết hợp billing export, nhãn, lịch sử truy vấn và quan hệ giữa bảng với dashboard. AI hỗ trợ phân loại các truy vấn chưa gắn nhãn dựa trên mẫu SQL, tài khoản dịch vụ và thời gian chạy, nhưng đánh dấu độ tin cậy.
Ví dụ và giá trị. Doanh nghiệp phát hiện 28% chi phí phân tích đến từ dashboard marketing tự làm mới mỗi 15 phút, dù người dùng chủ yếu xem vào đầu ngày. Marketing và Data cùng đổi lịch thay vì cắt ngân sách chung.
Giới hạn và trách nhiệm. Phân bổ sai có thể tạo xung đột nội bộ. Quy tắc chargeback hoặc showback phải minh bạch, cho phép chủ sở hữu phản hồi và không dùng suy đoán của AI như bằng chứng tài chính cuối cùng.
7. Loại bỏ SELECT * và cột không cần thiết
Bài toán hiện tại. Người viết SQL thường chọn toàn bộ cột cho nhanh, trong khi báo cáo chỉ dùng vài trường. Với bảng rộng, cách này làm quét thêm dữ liệu, tăng thời gian truyền và khiến logic khó kiểm soát.
AI xử lý như thế nào. Công cụ phân tích truy vấn đối chiếu các cột được chọn với cột thật sự dùng ở bước sau. AI có thể đề xuất danh sách cột cụ thể và giải thích lượng dữ liệu ước tính giảm trước khi thực thi.
Ví dụ và giá trị. Một báo cáo đơn hàng chỉ cần ngày, cửa hàng và doanh thu nhưng đang đọc 120 cột. Sau khi chọn đúng trường, lượng dữ liệu quét giảm rõ rệt mà kết quả kinh doanh không đổi.
Giới hạn và trách nhiệm. Một số quy trình downstream có thể phụ thuộc vào cột tưởng như không dùng. Thay đổi cần qua kiểm thử schema, đối chiếu kết quả và review; không tự động sửa truy vấn sản xuất chỉ vì công cụ báo lãng phí.
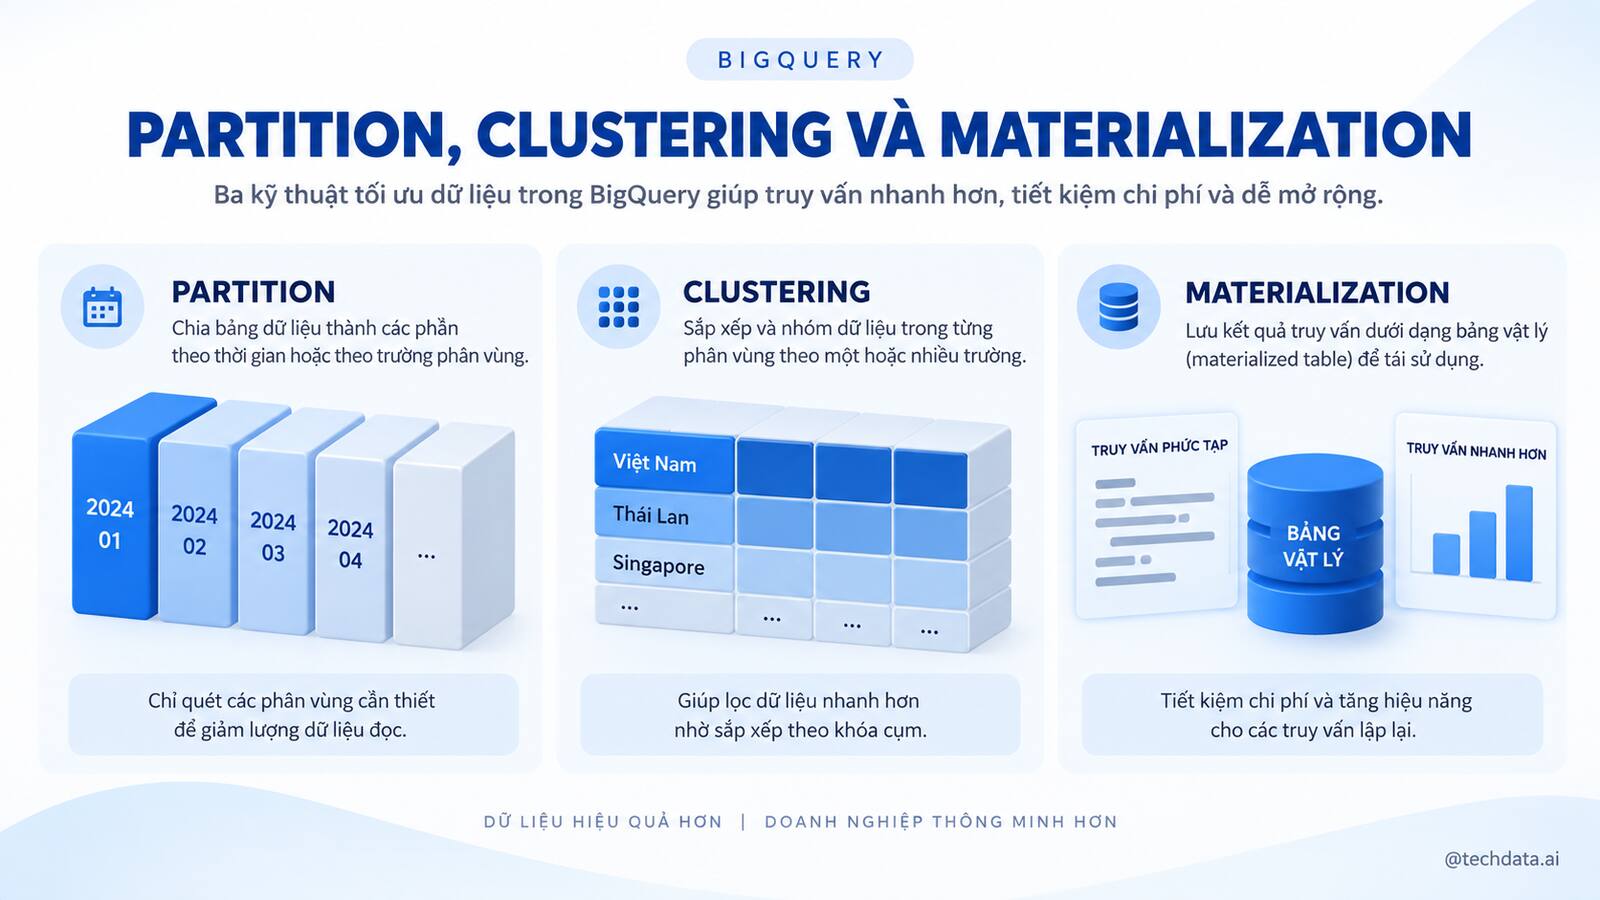
8. Dùng phân vùng để chỉ đọc thời gian cần thiết
Bài toán hiện tại. Bảng sự kiện nhiều năm thường được truy vấn theo ngày nhưng không phân vùng, hoặc truy vấn không lọc đúng cột phân vùng. BigQuery vì vậy phải đọc nhiều dữ liệu hơn phạm vi người dùng cần.
AI xử lý như thế nào. AI đọc lịch sử bộ lọc để nhận diện bảng có mẫu truy vấn thời gian rõ ràng, kiểm tra tỷ lệ truy vấn bỏ qua partition filter và đề xuất khóa phân vùng phù hợp. Hệ thống có thể ước lượng lợi ích từ dữ liệu thực tế.
Ví dụ và giá trị. Dashboard vận hành chỉ xem 30 ngày gần nhất nhưng quét toàn bộ ba năm. Bảng được phân vùng theo ngày giao dịch và quy tắc bắt buộc bộ lọc được bật, giúp giảm quét mà truy vấn nhanh hơn.
Giới hạn và trách nhiệm. Chọn sai trường phân vùng có thể tạo nhiều phần nhỏ, khó quản lý hoặc không phù hợp câu hỏi thực tế. Cần đánh giá mẫu truy vấn, độ trễ dữ liệu và cách cập nhật trước khi thay cấu trúc.
9. Clustering theo cột lọc thường xuyên
Bài toán hiện tại. Ngay cả trong một phân vùng, dữ liệu có thể rất lớn. Các truy vấn thường lọc theo khách hàng, cửa hàng hoặc sản phẩm nhưng vẫn đọc nhiều khối không liên quan.
AI xử lý như thế nào. Hệ thống phân tích tần suất bộ lọc và độ phân biệt của cột để đề xuất thứ tự clustering. AI so sánh các phương án trên workload mẫu thay vì chọn theo cảm tính.
Ví dụ và giá trị. Bảng giao dịch được phân vùng theo ngày và cluster theo cửa hàng, nhóm sản phẩm. Báo cáo cửa hàng trong một tuần đọc ít khối hơn, đồng thời không tạo thêm hàng nghìn bảng con.
Giới hạn và trách nhiệm. Clustering không bảo đảm mức giảm cố định và hiệu quả thay đổi theo dữ liệu. Quá nhiều cột hoặc thứ tự không phù hợp có thể ít giá trị; cần đo trên truy vấn thật và theo dõi sau thay đổi.
10. Dùng bảng tổng hợp và materialized view
Bài toán hiện tại. Dashboard thường tính lại cùng phép tổng hợp trên dữ liệu chi tiết, chẳng hạn doanh thu theo ngày và cửa hàng. Hàng trăm lượt xem lặp lại công việc giống nhau.
AI xử lý như thế nào. AI phát hiện đoạn truy vấn lặp, xác định tập kết quả có thể tái sử dụng và đề xuất bảng tổng hợp hoặc materialized view, tức kết quả được duy trì để truy vấn nhanh hơn. Nó cũng đánh giá độ mới cần thiết.
Ví dụ và giá trị. Thay vì cộng hàng tỷ dòng mỗi lần mở dashboard, doanh nghiệp duy trì bảng doanh thu ngày theo cửa hàng. Người dùng vẫn drill down vào dữ liệu chi tiết khi cần, còn màn hình tổng quan tải nhanh hơn.
Giới hạn và trách nhiệm. Bảng tổng hợp có thể làm số liệu chậm cập nhật hoặc nhân bản định nghĩa. Cần ghi rõ độ trễ, chủ sở hữu, logic tính và cơ chế đối chiếu với nguồn chi tiết.
11. Kiểm soát lịch làm mới dashboard
Bài toán hiện tại. Nhiều dashboard đặt lịch theo mặc định, kể cả ngoài giờ hoặc khi không có người xem. Các tab ẩn và bộ lọc riêng có thể kích hoạt nhiều truy vấn hơn người quản trị tưởng.
AI xử lý như thế nào. AI kết hợp log truy vấn với log sử dụng BI để tìm báo cáo ít xem, lịch làm mới trùng lặp và khoảng thời gian không có nhu cầu. Hệ thống đề xuất cache, giảm tần suất hoặc chuyển sang làm mới theo sự kiện.
Ví dụ và giá trị. Một dashboard tồn kho chạy mỗi 10 phút suốt đêm trong khi dữ liệu nguồn chỉ cập nhật mỗi giờ. Điều chỉnh lịch theo nguồn vừa giảm chi phí vừa không làm thông tin kém mới hơn.
Giới hạn và trách nhiệm. Giảm lịch có thể ảnh hưởng tình huống khẩn cấp. Chủ sở hữu nghiệp vụ cần xác định SLA về độ mới và cơ chế làm mới thủ công khi cần; AI không tự tắt dashboard quan trọng.
12. Tận dụng cache và kết quả đã tính
Bài toán hiện tại. Người dùng và công cụ BI có thể chạy lại truy vấn giống nhau với thay đổi rất nhỏ. Nếu cấu hình hoặc câu SQL làm mất khả năng dùng cache, BigQuery phải xử lý lại.
AI xử lý như thế nào. Phân tích truy vấn nhận diện fingerprint, tức dấu hiệu đại diện cho câu SQL tương đương, và chỉ ra tham số hoặc cách sinh SQL khiến cache không được dùng. AI đề xuất chuẩn hóa truy vấn hoặc lớp dữ liệu dùng chung.
Ví dụ và giá trị. Ba dashboard phòng ban dùng logic doanh thu giống nhau nhưng viết khác tên bí danh và thứ tự cột. Nhóm tạo mô hình dùng chung, giảm truy vấn lặp và chấm dứt chênh lệch số.
Giới hạn và trách nhiệm. Cache có thể trả dữ liệu không đủ mới cho nhu cầu thời gian thực. Phải hiểu chính sách cache, thời điểm dữ liệu nguồn thay đổi và không đánh đổi tính đúng chỉ để giảm chi phí.
13. Tối ưu JOIN và xử lý dữ liệu trung gian
Bài toán hiện tại. JOIN nối các bảng lớn có thể tạo lượng dữ liệu trung gian rất lớn, đặc biệt khi khóa không duy nhất hoặc lọc được áp dụng quá muộn. Truy vấn vừa chậm vừa có nguy cơ nhân bản dòng.
AI xử lý như thế nào. AI đọc query plan và thống kê để phát hiện bước shuffle lớn, khóa có độ lặp cao và điều kiện lọc bị đặt sau JOIN. Nó đề xuất lọc sớm, tổng hợp trước hoặc thay đổi thứ tự, kèm kiểm thử số dòng.
Ví dụ và giá trị. Một truy vấn nối giao dịch với lịch sử khách hàng theo mã không duy nhất làm số dòng tăng gấp nhiều lần. Sau khi chuẩn hóa khóa và lấy bản ghi hiệu lực, chi phí giảm đồng thời sửa được sai số doanh thu.
Giới hạn và trách nhiệm. Tối ưu JOIN có thể thay đổi ý nghĩa nếu không hiểu grain, tức mức chi tiết của mỗi dòng. Kỹ sư phải xác nhận khóa và nghiệp vụ; kiểm thử tổng, số dòng và trường hợp biên là bắt buộc.
14. Quản lý bảng tạm, bản sao và dữ liệu hết giá trị
Bài toán hiện tại. Nhóm phân tích tạo nhiều bảng thử nghiệm rồi quên xóa. Bản sao dữ liệu và bảng staging không có ngày hết hạn khiến chi phí lưu trữ tăng dần và làm catalog khó tìm.
AI xử lý như thế nào. Hệ thống tìm bảng không có truy vấn đọc trong thời gian dài, không có chủ sở hữu hoặc tên mang dấu hiệu tạm. AI gợi ý chính sách hết hạn theo loại dữ liệu và gửi danh sách cho chủ sở hữu xác nhận.
Ví dụ và giá trị. Một dự án thử nghiệm để lại hàng trăm bảng cá nhân sau sáu tháng. Doanh nghiệp gắn ngày hết hạn mặc định cho sandbox, lưu trữ những bảng cần kiểm toán và xóa phần đã được xác nhận.
Giới hạn và trách nhiệm. Không được xóa chỉ vì bảng ít dùng; dữ liệu có thể cần cho pháp lý hoặc khôi phục. Retention, legal hold và quy trình phê duyệt phải được kiểm tra trước mọi hành động xóa.
15. Ước lượng chi phí trước khi chạy truy vấn
Bài toán hiện tại. Người dùng chỉ biết truy vấn đắt sau khi đã chạy. Trong môi trường tự phục vụ, một thao tác khám phá vô tình có thể quét khối lượng rất lớn.
AI xử lý như thế nào. Dry run của BigQuery ước lượng byte xử lý mà không chạy đầy đủ. Trợ lý có thể đọc con số, so với ngưỡng của nhóm và đề xuất thêm bộ lọc hoặc dùng bảng mẫu trước khi cho phép thực thi.
Ví dụ và giá trị. Nhà phân tích chuẩn bị chạy truy vấn trên toàn bộ lịch sử. Hệ thống báo vượt ngân sách cá nhân, đề xuất thử trên bảy ngày và hiển thị dự kiến chi phí để người dùng quyết định.
Giới hạn và trách nhiệm. Ước lượng không phản ánh mọi thành phần chi phí và có thể thay đổi theo tối ưu của hệ thống. Ngưỡng quá cứng cũng cản trở phân tích cần thiết; phải có cơ chế xin ngoại lệ nhanh và có lý do.
16. Đặt maximum bytes billed và quota
Bài toán hiện tại. Không có giới hạn kỹ thuật khiến một lỗi SQL có thể tiêu thụ nhiều hơn dự kiến. Hướng dẫn bằng văn bản không đủ khi người dùng mới hoặc công cụ tự động tạo truy vấn.
AI xử lý như thế nào. Chính sách đặt maximum bytes billed chặn truy vấn vượt mức dữ liệu cho phép; custom quota giới hạn theo dự án hoặc người dùng. AI phân tích lịch sử để đề xuất ngưỡng hợp lý theo workload và phát hiện ai thường chạm ngưỡng.
Ví dụ và giá trị. Môi trường khám phá có giới hạn thấp hơn báo cáo sản xuất. Khi cần phân tích lớn, người dùng gửi mục đích, ước lượng và thời gian; chủ sở hữu dữ liệu duyệt ngoại lệ thay vì mở quyền vô hạn.
Giới hạn và trách nhiệm. Quota có thể làm hỏng pipeline quan trọng nếu áp dụng đồng loạt. Cần phân tách workload, cảnh báo trước khi chặn và có runbook xử lý; Agent không tự giảm quota của hệ thống sản xuất.
17. Tối ưu slot và reservation
Bài toán hiện tại. Trong mô hình dung lượng, doanh nghiệp có thể mua quá nhiều slot không dùng hoặc để workload quan trọng tranh tài nguyên với truy vấn thử nghiệm. Chi phí và hiệu năng cùng khó dự đoán.
AI xử lý như thế nào. AI phân tích mức sử dụng, thời gian chờ và mùa vụ để đề xuất reservation, autoscaling và assignment giữa các nhóm. Mô phỏng cho thấy thay đổi ảnh hưởng thế nào đến thời gian chạy và chi phí cam kết.
Ví dụ và giá trị. Pipeline sáng sớm cần năng lực cao trong hai giờ, còn truy vấn khám phá tập trung giờ hành chính. Việc tách reservation và dùng co giãn giúp báo cáo đúng giờ mà không giữ năng lực đỉnh cả ngày.
Giới hạn và trách nhiệm. Tối ưu slot cần hiểu edition, cam kết và ưu tiên thực tế. Dự báo sai mùa vụ có thể gây thiếu năng lực; quyết định mua cam kết dài hạn phải do FinOps, Data và tài chính cùng phê duyệt.
18. Phát hiện chi phí bất thường gần thời gian thực
Bài toán hiện tại. Báo cáo hóa đơn cuối tháng quá muộn để ngăn một pipeline lỗi chạy lặp. Cảnh báo tổng theo ngày cũng khó chỉ ra truy vấn hoặc thay đổi nào là nguyên nhân.
AI xử lý như thế nào. Agent theo dõi log truy vấn, so với nhịp lịch sử theo workload và phát hiện biến động về byte quét, slot-time hoặc số lần chạy. Nó liên kết bất thường với lần triển khai, dashboard và chủ sở hữu.
Ví dụ và giá trị. Sau một thay đổi, pipeline bắt đầu xử lý lại toàn bộ lịch sử mỗi giờ thay vì phân vùng mới. Agent mở ticket sau hai lần lặp, đính kèm truy vấn và ước lượng tác động để kỹ sư sửa sớm.
Giới hạn và trách nhiệm. Mùa vụ và chiến dịch thật có thể tạo biến động hợp lý. Cảnh báo cần ngữ cảnh kinh doanh, ngưỡng thích nghi và đường dẫn xác nhận; tự động dừng chỉ dành cho tình huống đã định nghĩa rất rõ.
19. Đo chi phí trên mỗi sản phẩm dữ liệu
Bài toán hiện tại. Tổng chi phí phòng ban không cho biết bảng, dashboard hoặc mô hình nào tạo giá trị. Tài sản ít dùng vẫn tiếp tục tiêu tốn vì không ai chịu trách nhiệm vòng đời.
AI xử lý như thế nào. Hệ thống gom chi phí nạp, lưu trữ, biến đổi và phục vụ theo Data Product, rồi đối chiếu số người dùng, SLA và quyết định được hỗ trợ. AI giúp phân bổ phần dùng chung theo quy tắc minh bạch.
Ví dụ và giá trị. Sản phẩm dữ liệu Customer 360 có chi phí cao nhưng phục vụ chăm sóc, marketing và chống gian lận; một dashboard cũ có chi phí thấp hơn nhưng không còn người xem. Ưu tiên tối ưu dựa trên giá trị, không chỉ số tiền tuyệt đối.
Giới hạn và trách nhiệm. Giá trị khó đo và không nên quy đổi mọi thứ thành số lượt xem. Báo cáo pháp lý ít dùng vẫn bắt buộc; chủ sở hữu nghiệp vụ phải giải thích mục đích và cùng tài chính thống nhất cách đo.
PHẦN III — DỮ LIỆU, AI AGENT VÀ CƠ CHẾ KIỂM SOÁT
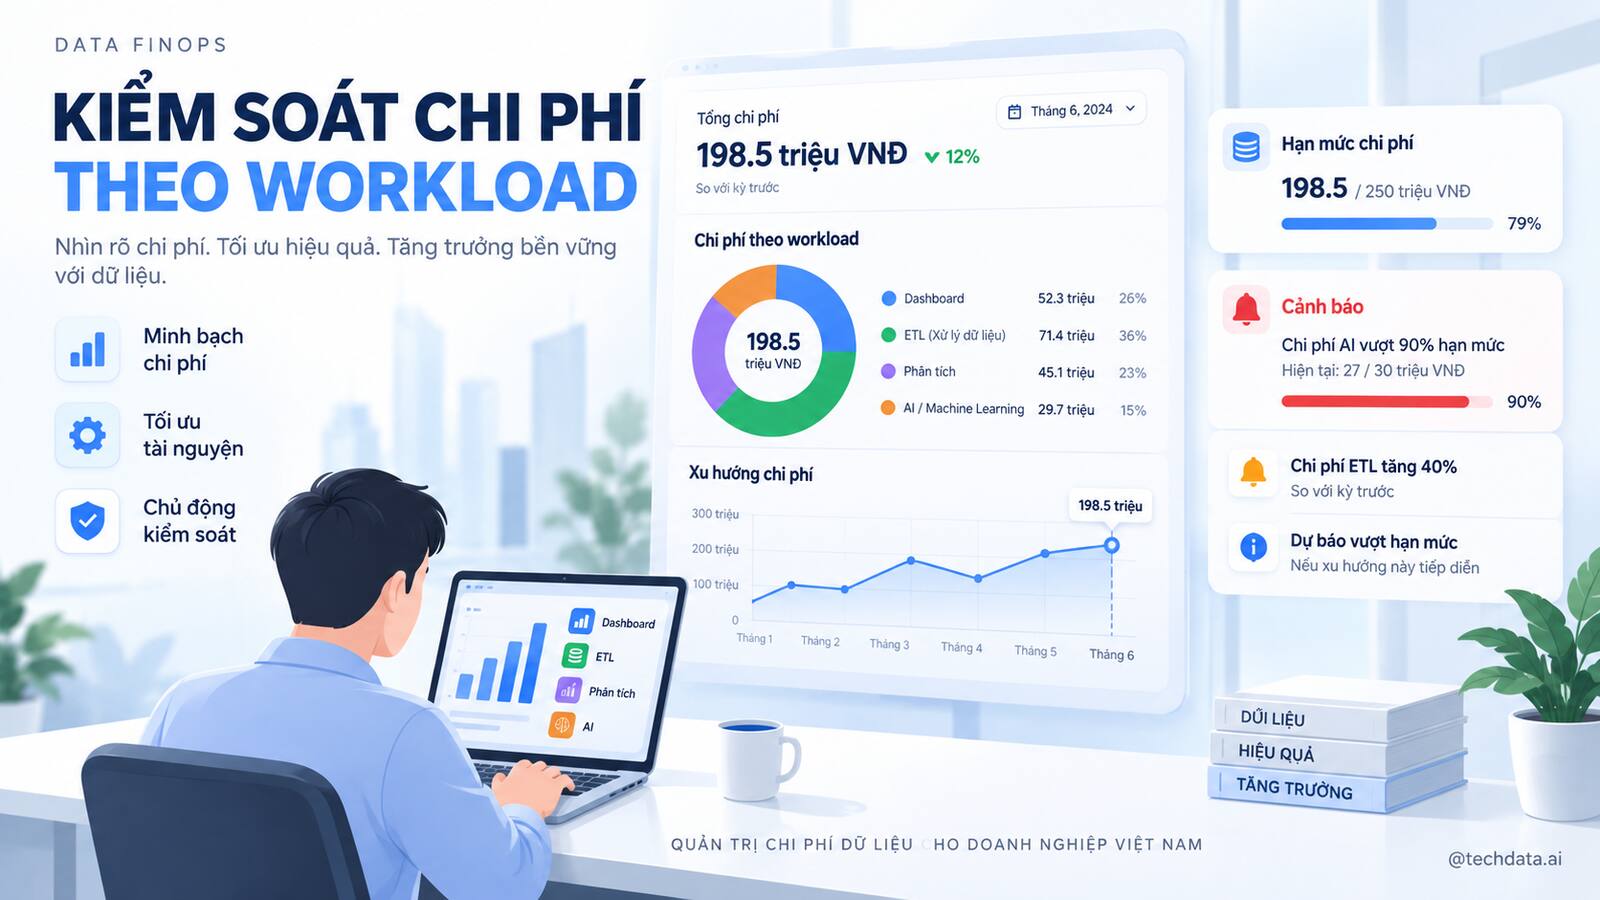
20. AI Agent tối ưu chi phí hoạt động theo vòng kiểm soát
Agent có thể quan sát log, phát hiện ngoại lệ, chẩn đoán nguyên nhân, đề xuất thay đổi, chạy thử và đo kết quả. Quy trình này giống một kỹ sư hỗ trợ liên tục, nhưng mỗi hành động phải có quyền và ngưỡng rõ.
Agent được phép gắn nhãn, tạo ticket, gửi cảnh báo và chạy dry run. Việc sửa SQL sản xuất, thay reservation, xóa bảng hoặc chặn người dùng cần Human Approval. Sau thay đổi, Agent phải so sánh chi phí, tốc độ và kết quả dữ liệu để tránh tối ưu một chiều.
21. Data Platform và lớp quan sát chi phí
Billing export đưa dữ liệu hóa đơn vào BigQuery; INFORMATION_SCHEMA cung cấp lịch sử job, bảng và mức sử dụng; catalog và lineage bổ sung chủ sở hữu, mục đích và quan hệ downstream. Khi ghép các lớp này, doanh nghiệp mới đi từ “dịch vụ nào tốn tiền” đến “quyết định và sản phẩm nào tạo chi phí”.
Lớp dữ liệu quản trị nên có định nghĩa chung cho workload, môi trường, cost center và Data Product. Nếu nhãn được nhập tự do, báo cáo chi phí sẽ phân mảnh. Quy tắc bắt buộc nhãn ở pipeline và mẫu dự án giúp dữ liệu quản trị hình thành ngay từ đầu.
22. Data Quality và kiểm thử sau tối ưu
Tối ưu thành công phải giữ đúng số liệu. Bộ kiểm thử cần so tổng, số dòng, khóa duy nhất, dữ liệu trễ, trường hợp null và các lát cắt quan trọng trước–sau. Với dashboard, nên kiểm tra cả thời gian tải và độ mới.
Sai khác nhỏ có thể là hợp lý nếu logic mới sửa lỗi cũ, nhưng phải được giải thích và phê duyệt. Không dùng “truy vấn chạy nhanh hơn” làm tiêu chí duy nhất; một câu SQL rẻ nhưng trả số sai gây thiệt hại lớn hơn nhiều.
23. Permission và tách biệt môi trường
Người dùng nên có quyền đúng với vai trò và môi trường. Sandbox cho phép khám phá trong quota phù hợp; production giới hạn thay đổi và dùng tài khoản dịch vụ; dữ liệu nhạy cảm được bảo vệ theo cột hoặc hàng khi cần.
Agent cũng cần danh tính riêng, không dùng quyền quản trị chung. Mỗi truy vấn và hành động phải truy về Agent, phiên bản chính sách và người duyệt. Khóa, thông tin nhạy cảm và kết quả truy vấn không nên bị ghi vào log không kiểm soát.
24. Semantic Layer có cần thiết không?
Semantic Layer là lớp định nghĩa thống nhất các chỉ số như doanh thu thuần, khách hàng hoạt động hay tồn kho khả dụng. Khi dashboard dùng cùng định nghĩa, hệ thống có thể tái sử dụng mô hình, cache và bảng tổng hợp thay vì mỗi nhóm tính lại.
Lớp này chỉ hữu ích khi được quản trị như sản phẩm: có chủ sở hữu, phiên bản, kiểm thử và tài liệu. Nếu biến thành một tầng phức tạp không ai hiểu, nó có thể làm chậm thay đổi và chỉ chuyển lãng phí sang nơi khác.
PHẦN IV — LỘ TRÌNH TỐI ƯU TRONG 90 NGÀY
25. Chọn phạm vi đầu tiên
Nên bắt đầu với một dự án BigQuery có hóa đơn đáng kể, 10–20 workload chính và chủ sở hữu sẵn sàng hợp tác. Không nên tối ưu toàn bộ tổ chức ngay, vì nhãn và định nghĩa chưa đủ sẽ làm báo cáo phân bổ thiếu tin cậy.
Ba use case đầu tiên là bản đồ chi phí theo workload, cảnh báo truy vấn bất thường và tối ưu các dashboard tốn kém nhất. Chúng tạo kết quả đo được mà ít đụng đến logic lõi.
26. Ngày 1–30: đo đường cơ sở
Xuất dữ liệu billing, job, bảng và mức sử dụng dashboard; chuẩn hóa nhãn; xác định top workload theo chi phí và thời gian. Nhóm ghi nhận SLA, độ mới, người dùng và mục đích để không cắt nhầm tài sản quan trọng.
Đường cơ sở nên bao gồm chi phí, byte quét, slot-time, thời gian chạy, tỷ lệ lỗi và số người dùng. Danh sách 20 cơ hội đầu tiên phải kèm chủ sở hữu và giả thuyết thay đổi.
27. Ngày 31–60: sửa các lãng phí ít rủi ro
Nhóm loại cột thừa, chỉnh partition filter, đồng bộ lịch dashboard với nguồn và đặt hết hạn cho bảng thử nghiệm mới. Mọi thay đổi đi qua kiểm thử dữ liệu và so sánh hiệu năng.
Dashboard quan trọng được chạy song song trước–sau. Phần tiết kiệm được ghi nhận theo cùng cửa sổ thời gian và điều chỉnh cho mùa vụ để tránh báo cáo thành tích không thật.
28. Ngày 61–90: tự động hóa kiểm soát
Doanh nghiệp triển khai budget, quota phù hợp, cảnh báo bất thường và quy trình ngoại lệ. Agent bắt đầu tạo ticket có dẫn nguồn, nhưng chưa tự thực hiện thay đổi có tác động lớn.
Sau bốn tuần, nhóm xem tỷ lệ cảnh báo đúng, thời gian xử lý và số lỗi dữ liệu. Chỉ những hành động lặp lại, dễ đảo ngược và đã có runbook mới được cân nhắc tự động hóa.
29. KPI cần theo dõi
KPI gồm chi phí mỗi workload, byte quét trên mỗi truy vấn, slot utilization, thời gian chờ, thời gian tải dashboard, tỷ lệ truy vấn dùng partition filter, số bảng không chủ và chi phí tài sản không sử dụng.
Cần đo giá trị: số người dùng, quyết định hỗ trợ, SLA đạt được và thời gian kỹ sư tiết kiệm. Chỉ số đơn thuần “giảm hóa đơn” có thể che việc phân tích bị chậm hoặc người dùng chuyển sang công cụ khác.
30. Mô hình showback và chargeback
Showback cho phòng ban thấy phần chi phí của mình mà chưa phân bổ vào ngân sách; chargeback thực sự tính chi phí về đơn vị. Nhiều doanh nghiệp nên bắt đầu bằng showback để sửa dữ liệu nhãn và tạo thói quen trước.
Quy tắc phân bổ phải công khai, đặc biệt với hạ tầng dùng chung. Ngoại lệ cho báo cáo pháp lý, nền tảng chung và R&D cần được thống nhất thay vì ép mọi workload theo cùng một chuẩn ROI.
31. Sai lầm phổ biến
Sai lầm là chỉ săn truy vấn đắt nhất mà bỏ qua truy vấn nhỏ chạy quá nhiều, cắt lịch dashboard không hỏi nghiệp vụ, áp quota đồng loạt và không kiểm thử kết quả SQL sau sửa. Một lỗi khác là mua reservation dựa trên đỉnh ngắn hạn.
Tối ưu một lần rồi dừng cũng không bền. Workload, giá và kiến trúc thay đổi liên tục; chi phí cần trở thành chỉ số vận hành có chủ sở hữu, không phải chiến dịch chữa cháy cuối quý.
32. Cơ chế cải tiến liên tục
Mỗi tháng, nhóm Data, FinOps và đại diện nghiệp vụ xem top biến động, hiệu quả thay đổi và tài sản không còn giá trị. Quyết định được lưu cùng giả định để có thể đánh giá lại khi nhu cầu thay đổi.
Các mẫu SQL tốt, bảng dùng chung và hướng dẫn tự phục vụ giúp giảm chi phí từ thiết kế. Khi người dùng thấy ước lượng trước khi chạy và hiểu tác động, tối ưu trở thành hành vi hằng ngày thay vì lệnh cấm từ trung tâm.
PHẦN V — CASE TỔNG THỂ, TƯƠNG LAI VÀ KẾT LUẬN
33. Case tổng thể: chuỗi bán lẻ phân tích đa kênh
Giả sử chuỗi bán lẻ có 100 cửa hàng, website và ứng dụng. BigQuery nhận dữ liệu bán hàng, tồn kho, marketing và hành vi khách hàng. Hóa đơn tăng ba tháng liên tiếp, dashboard chậm vào buổi sáng, nhưng nhóm chưa biết nguyên nhân vì dự án Cloud chỉ gắn tên kỹ thuật.
Doanh nghiệp xuất billing và job metadata, gắn workload với chủ sở hữu và phát hiện ba vấn đề: dashboard marketing làm mới quá thường, bảng giao dịch không được lọc phân vùng đúng, pipeline tồn kho xử lý lại 24 tháng mỗi giờ. Nhóm sửa từng điểm, kiểm thử số liệu và giữ SLA theo nhu cầu nghiệp vụ.
34. Hệ thống hoạt động sau khi tối ưu
Mỗi workload có ngân sách, chủ sở hữu và chỉ số giá trị. Trước khi chạy truy vấn lớn, người dùng thấy lượng dữ liệu ước tính; truy vấn bất thường tạo ticket có dẫn nguồn; dashboard dùng bảng tổng hợp nhưng vẫn cho phép đi xuống chi tiết.
Ban điều hành theo dõi chi phí trên mỗi sản phẩm dữ liệu cùng tốc độ và độ mới. Khi chiến dịch lớn làm nhu cầu tăng, đội marketing yêu cầu ngoại lệ có thời hạn thay vì bị chặn. Tối ưu trở thành cơ chế hợp tác, không phải cuộc chiến giữa Cloud và người dùng.
35. Tương lai của tối ưu chi phí dữ liệu
AI sẽ tự động giải thích query plan, dự báo nhu cầu slot và tạo bản sửa SQL ngày càng tốt. Công việc thủ công tìm log và ghép hóa đơn sẽ giảm, còn kỹ sư tập trung vào kiến trúc, định nghĩa giá trị và kiểm soát thay đổi.
Con người vẫn quyết định SLA, quyền truy cập, thời gian lưu dữ liệu và đánh đổi giữa chi phí với tốc độ. Những quyết định này gắn với chiến lược và rủi ro doanh nghiệp, không thể giao trọn cho một mô hình tối ưu số học.
36. Kết luận
BigQuery Cost Optimization không phải cắt bớt truy vấn bằng mọi giá. Đó là quá trình nối dữ liệu chi phí với workload, tối ưu cấu trúc và SQL, kiểm thử chất lượng, rồi đưa kiểm soát vào quy trình vận hành. Data + Workflow + AI giúp doanh nghiệp quan sát đúng, hành động có kiểm soát và học từ kết quả.
Câu hỏi chiến lược nên bắt đầu là: workload nào đang tiêu tốn nhiều nhất so với giá trị và SLA mà nó phục vụ? Khi trả lời được bằng dữ liệu, doanh nghiệp có thể giảm lãng phí mà vẫn làm phân tích nhanh hơn. Chi phí tốt không phải chi phí thấp nhất; đó là chi phí được hiểu, được sở hữu và tạo ra giá trị.
Bài viết liên quan
Để mở rộng chủ đề, có thể đọc thêm Data FinOps, dbt cho doanh nghiệp và ETL hay ELT.
TÀI LIỆU THAM KHẢO
- Google Cloud — BigQuery pricing
- Google Cloud — Control costs in BigQuery
- Google Cloud — Optimize query computation
- Google Cloud — Optimize storage
- Google Cloud — Introduction to clustered tables
- Google Cloud — Introduction to partitioned tables
- Google Cloud — Create custom query quotas
- Google Cloud — INFORMATION_SCHEMA jobs views
- Google Cloud — Export Cloud Billing data to BigQuery
TechData.AI - Leading the Future.
Tham khảo các khoá học theo link: https://techdata.ai/techdata-ai-course/
Hoàng Minh.