



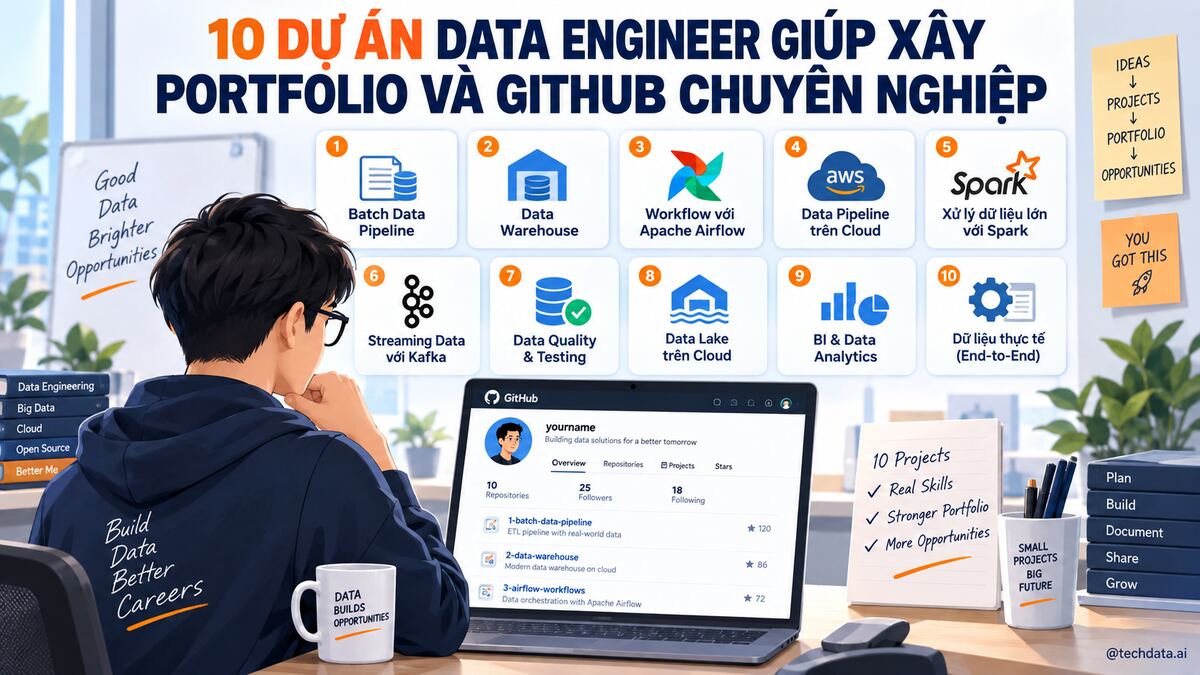

10 dự án Data Engineer giúp xây Portfolio và GitHub chuyên nghiệp
Portfolio Data Engineer không phải bộ sưu tập sơ đồ kiến trúc hoặc ảnh chụp pipeline chạy thành công. Một dự án tốt phải cho thấy người học hiểu dữ liệu đến từ đâu, đi qua những bước nào, được kiểm tra ra sao và có thể phục hồi thế nào khi gặp lỗi. Nhà tuyển dụng cần nhìn thấy cách ứng viên suy nghĩ, không chỉ danh sách công nghệ.
Người mới thường rơi vào hai cực. Một là làm dự án quá nhỏ, chẳng hạn đọc một file CSV rồi tải vào cơ sở dữ liệu. Hai là cố đưa Docker, Airflow, Spark, Kafka, Kubernetes và ba nền tảng Cloud vào cùng một sơ đồ dù không có nhu cầu. Cả hai đều làm Portfolio thiếu sức thuyết phục.
Mười dự án trong bài được sắp xếp từ nền tảng tới nâng cao. Không cần hoàn thành đủ mười. Hai hoặc ba dự án sâu, khác nhau về loại dữ liệu và do chính ứng viên giải thích được thường có giá trị hơn nhiều bản demo giống hướng dẫn.
Mỗi dự án được trình bày theo năm câu hỏi: bài toán là gì, dữ liệu nào cần dùng, hệ thống xử lý ra sao, đầu ra nào cần công khai và rủi ro nào phải kiểm soát. Cách tiếp cận này giúp người mới hiểu Data Engineering là một chuỗi trách nhiệm, không phải cuộc thi dùng nhiều công cụ.
Mục lục
- PHẦN I — Portfolio Data Engineer cần chứng minh điều gì?
- PHẦN II — Cấu trúc một dự án hoàn chỉnh
- PHẦN III — 10 dự án Data Engineer thực tế
- PHẦN IV — Cách xây GitHub chuyên nghiệp
- PHẦN V — Kiểm thử, bảo mật và chi phí
- PHẦN VI — Dùng AI đúng cách trong dự án
- PHẦN VII — Kế hoạch hoàn thành Portfolio trong 16 tuần
- PHẦN VIII — Ví dụ tổng thể
- Câu hỏi thường gặp
- Kết luận
PHẦN I — PORTFOLIO DATA ENGINEER CẦN CHỨNG MINH ĐIỀU GÌ?
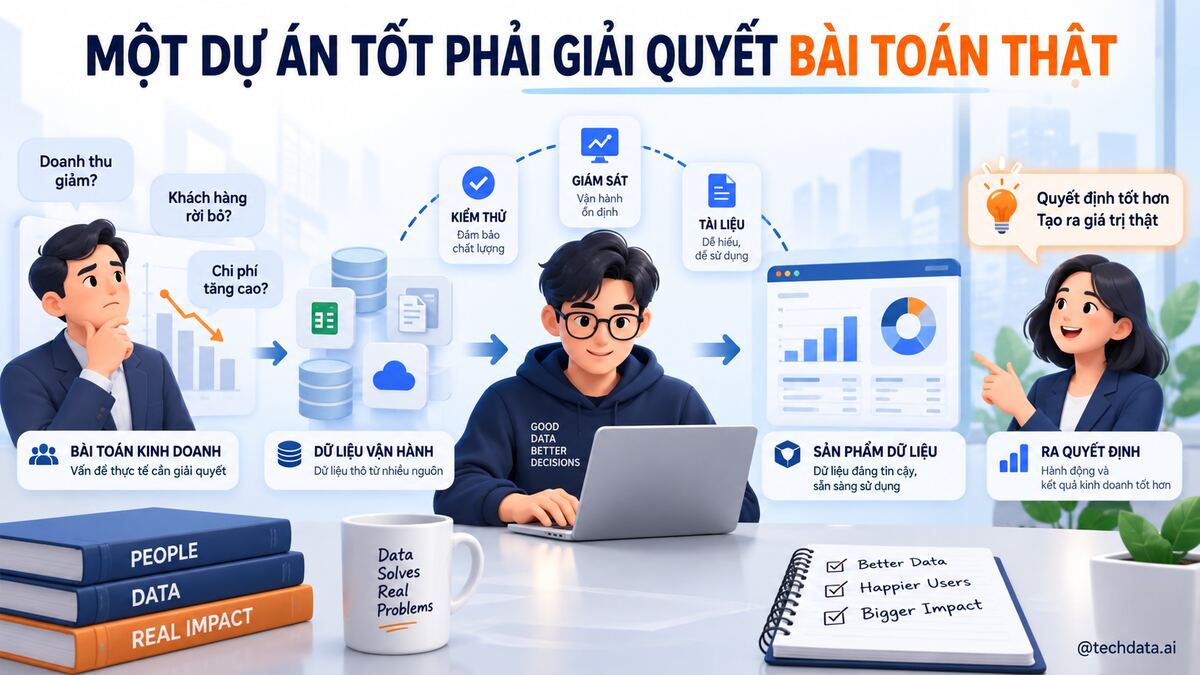
1. Hiểu bài toán kinh doanh
Dự án cần nói rõ ai sử dụng dữ liệu và quyết định nào được hỗ trợ. “Xây pipeline bán hàng” vẫn quá chung. “Hợp nhất doanh thu từ cửa hàng, website và sàn để bộ phận tài chính đối soát theo ngày hạch toán” cho thấy mục tiêu rõ hơn.
Data Engineer không quyết định mọi quy tắc nghiệp vụ, nhưng phải biết hỏi. Doanh thu đã trừ hoàn trả chưa, thời gian cập nhật cần bao lâu và nguồn nào là chuẩn? Những câu hỏi này ảnh hưởng thiết kế.
2. Hiểu cấu trúc và chất lượng dữ liệu
Ứng viên cần xác định một dòng đại diện cho điều gì, khóa nào nối bảng và dữ liệu có thể thiếu ở đâu. Mức chi tiết sai làm tổng bị nhân dù chương trình vẫn chạy. Đây là lỗi phổ biến trong dự án người mới.
Data Quality là mức dữ liệu đúng, đủ, nhất quán, cập nhật và phù hợp mục đích. Portfolio nên có test cấu trúc, khóa, giá trị rỗng, phạm vi, số dòng và tổng nghiệp vụ.
3. Biết thiết kế pipeline có thể chạy lại
Pipeline là chuỗi bước tự động đưa và xử lý dữ liệu. Dự án cần nạp tăng dần, lưu mốc đã xử lý và chạy lại không tạo trùng. Nếu tác vụ dừng giữa chừng, người vận hành phải biết tiếp tục từ đâu.
Backfill là chạy lại dữ liệu cho một khoảng lịch sử. Mã không nên luôn dùng “hôm nay”, vì cách đó làm phục hồi và kiểm thử khó khăn. Ngày xử lý phải là tham số.
4. Biết vận hành, không chỉ phát triển
Nhật ký vận hành cần cho biết thời gian, bước, số dòng và lỗi. Cảnh báo phải dẫn tới hành động. Một tác vụ báo thành công vẫn có thể tạo dữ liệu sai nếu nguồn giảm 50%.
Portfolio nên mô tả ít nhất ba sự cố đã thử: nguồn không phản hồi, cấu trúc thay đổi và dữ liệu trùng. Runbook, tức hướng dẫn xử lý sự cố, cho thấy ứng viên đã nghĩ tới vận hành.
5. Biết giải thích lựa chọn và giới hạn
Mỗi công nghệ cần một lý do. Spark chỉ hợp lý khi quy mô hoặc môi trường yêu cầu; Kafka phù hợp dữ liệu sự kiện liên tục; Airflow phù hợp điều phối theo lịch. Không thêm công nghệ để trang trí CV.
Ứng viên cũng phải nói điều gì dự án chưa mô phỏng: tải lớn, nhiều người dùng, yêu cầu sẵn sàng cao hoặc dữ liệu nhạy cảm thật. Trung thực về giới hạn tạo niềm tin.
PHẦN II — CẤU TRÚC MỘT DỰ ÁN HOÀN CHỈNH
6. Bối cảnh, người dùng và yêu cầu
Mở đầu bằng doanh nghiệp giả định, vấn đề, người sử dụng và tần suất. Nêu dữ liệu nào nằm ngoài phạm vi. Một đoạn 150–250 từ thường đủ để người đọc hiểu trước khi xem sơ đồ.
Yêu cầu nên đo được: dữ liệu cập nhật trước 8 giờ, tổng doanh thu lệch dưới ngưỡng được bộ phận tài chính chấp nhận, hoặc pipeline có thể chạy lại theo ngày. Tránh từ “nhanh”, “ổn định” mà không có tiêu chí.
7. Kiến trúc và dòng dữ liệu
Sơ đồ cần thể hiện nguồn, nơi lưu bản gốc, xử lý, Data Warehouse và người dùng. Mỗi mũi tên phải có ý nghĩa như batch, sự kiện hoặc API. Không cần logo của mọi dịch vụ.
Batch là xử lý dữ liệu theo lô vào một thời điểm; API là giao diện giúp hệ thống trao đổi dữ liệu. Nếu có nhiều phương án, ghi lý do chọn và điều kiện xem xét lại.
8. Mã, cấu hình và môi trường
Tách mã nguồn, cấu hình, test, tài liệu và dữ liệu mẫu. Không ghi mật khẩu vào repository. Dùng biến môi trường hoặc công cụ quản lý bí mật.
Docker có thể đóng gói môi trường để người khác chạy nhất quán. README phải có yêu cầu, lệnh khởi động và cách dừng. README là trang giới thiệu cùng hướng dẫn dự án.
9. Kiểm thử và đối soát
Unit test kiểm tra một phần logic nhỏ; integration test kiểm tra nhiều thành phần làm việc cùng nhau. Với dữ liệu, cần thêm kiểm tra số dòng, khóa, độ tươi và tổng nghiệp vụ. Không một loại test nào đủ cho mọi rủi ro.
Đối soát kết quả với nguồn hoặc phép tính độc lập. Ví dụ, tổng doanh thu theo ngày trong mart phải khớp với bảng chuẩn sau khi áp dụng cùng quy tắc hoàn trả.
10. Tài liệu và bản trình bày
Trang chính tóm tắt vấn đề, kiến trúc, cách chạy, chất lượng, vận hành, bảo mật, chi phí và giới hạn. Mã chi tiết nằm trong thư mục. Ảnh và video chỉ bổ trợ.
Chuẩn bị bản trình bày hai phút và mười phút. Bản ngắn giúp người tuyển dụng hiểu giá trị; bản dài dùng khi phỏng vấn kỹ thuật. Không học thuộc câu chữ mà phải hiểu quyết định.
PHẦN III — 10 DỰ ÁN DATA ENGINEER THỰC TẾ
11. Dự án 1: Pipeline bán hàng từ API vào PostgreSQL
Bài toán. Website cung cấp đơn hàng qua API, nhưng đội báo cáo đang tải file thủ công. Hệ thống cần lấy dữ liệu hằng ngày, giữ bản gốc và nạp vào PostgreSQL. Đây là dự án nhập môn phù hợp để chứng minh Python, SQL và Linux.
Cách làm. Chương trình Python xử lý phân trang, giới hạn lượt gọi, lỗi tạm thời và cấu hình. Dữ liệu JSON được lưu theo ngày trước khi nạp. Khóa đơn hàng dùng để cập nhật thay vì chèn trùng.
Đầu ra và giới hạn. GitHub có mã, test, log mẫu, hướng dẫn và sơ đồ đơn giản. Mô phỏng API trả rỗng, trường bị thiếu và lần chạy lặp. Dự án chưa cần Cloud hoặc Airflow; trọng tâm là luồng cơ bản đúng.
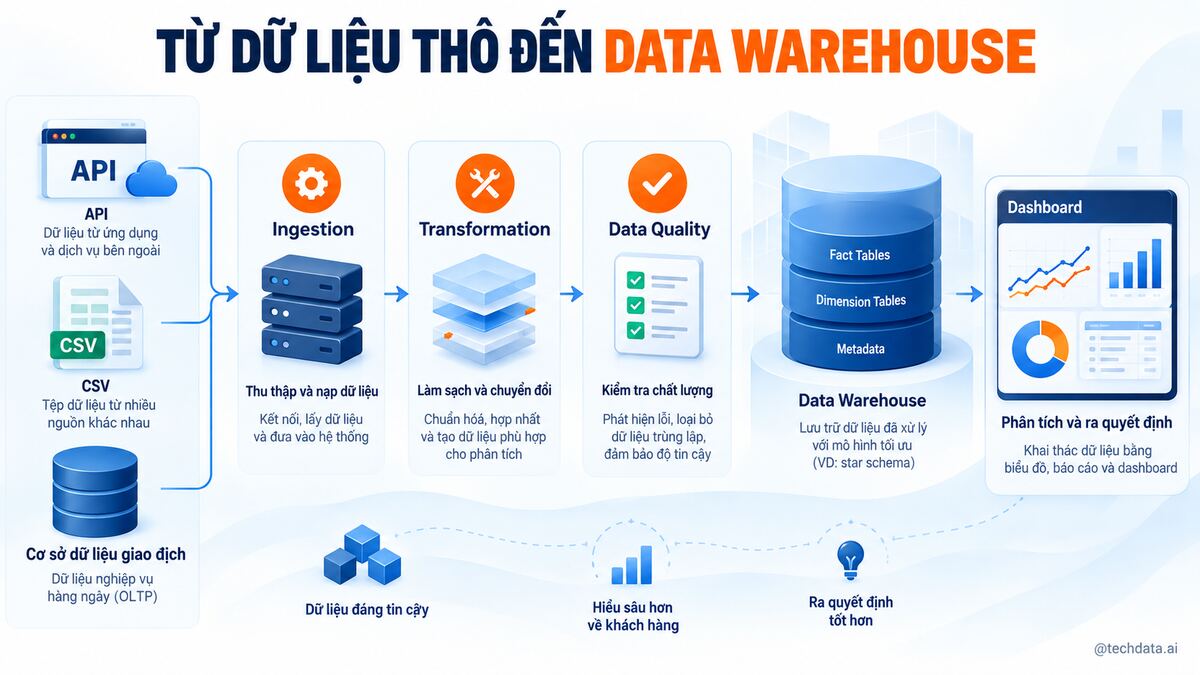
12. Dự án 2: Data Warehouse bán lẻ đa nguồn
Bài toán. Cửa hàng, website và sàn dùng mã sản phẩm, trạng thái cùng ngày ghi nhận khác nhau. Bộ phận tài chính cần doanh thu thống nhất. Dữ liệu gồm đơn, chi tiết, hoàn trả, sản phẩm và cửa hàng.
Cách làm. Lưu dữ liệu thô, tạo lớp staging để chuẩn hóa và mart bán hàng. Mô hình sao gồm fact bán hàng cùng dimension ngày, sản phẩm, khách hàng và kênh. dbt hoặc SQL có cấu trúc quản lý biến đổi và test.
Đầu ra và giới hạn. Tài liệu định nghĩa doanh thu, mức chi tiết, khóa và lịch cập nhật. Đối soát tổng theo nguồn. Nếu chi phí vận hành không có, không gọi measure là lợi nhuận đầy đủ.
13. Dự án 3: Pipeline Airflow có backfill và cảnh báo
Bài toán. Các chương trình nhỏ chạy thủ công, thất bại không ai biết và khó xử lý lại lịch sử. Cần điều phối theo ngày, kiểm tra phụ thuộc và cảnh báo. Dự án nâng cấp luồng đã có, không tạo dữ liệu mới chỉ để dùng Airflow.
Cách làm. DAG gồm lấy dữ liệu, kiểm tra, nạp, biến đổi và đối soát. DAG là sơ đồ công việc có hướng và không tạo vòng lặp. Mỗi task có retry, timeout, tham số ngày và log.
Đầu ra và giới hạn. Mô phỏng nguồn lỗi, task dừng cùng backfill bảy ngày. Runbook giải thích phục hồi. Không đặt toàn bộ logic vào một task vì sẽ khó chạy lại từng phần.
14. Dự án 4: CDC từ PostgreSQL tới Data Warehouse
Bài toán. Đọc lại toàn bộ bảng giao dịch mỗi giờ làm chậm nguồn. Doanh nghiệp cần lấy phần thay đổi gần thời gian thực. CDC, hay Change Data Capture, ghi nhận dữ liệu được thêm, sửa hoặc xóa.
Cách làm. Dùng công cụ CDC hoặc mô phỏng nhật ký thay đổi, truyền sự kiện tới vùng đệm rồi cập nhật bảng đích. Thiết kế khóa, thứ tự và cách xử lý cùng sự kiện nhiều lần. Không đọc trực tiếp nguồn bằng truy vấn nặng vào giờ cao điểm.
Đầu ra và giới hạn. Đo độ trễ, số sự kiện và đối soát snapshot. Mô phỏng mất kết nối và đọc lại. Dự án cần nói rõ xóa mềm, xóa cứng được phản ánh thế nào.
15. Dự án 5: Dữ liệu clickstream bằng Kafka
Bài toán. Website phát sự kiện xem trang, thêm giỏ và mua hàng. Hệ thống cần nhận liên tục để theo dõi phễu. Clickstream là dòng sự kiện hành vi người dùng trên website hoặc ứng dụng.
Cách làm. Thành phần gửi dữ liệu đưa sự kiện vào một luồng Kafka; thành phần đọc kiểm tra cấu trúc rồi ghi xuống nơi lưu. Luồng được đặt tên để phân biệt loại sự kiện, còn các phân vùng giúp chia tải. Mỗi sự kiện cần một mã riêng để chống trùng và thời điểm phát sinh để xử lý dữ liệu đến muộn.
Đầu ra và giới hạn. Mô phỏng thành phần đọc bị dừng, phải đọc lại hoặc nhận sự kiện sai thứ tự. Dashboard gần thời gian thực phải đánh dấu dữ liệu tạm. Không dùng dữ liệu cá nhân thật trong bản trình diễn.
16. Dự án 6: Xử lý log lớn bằng Spark
Bài toán. File log theo ngày vượt khả năng xử lý thuận tiện của một máy. Cần tổng hợp lỗi và hành vi theo nhiều phân vùng. Dự án phải giải thích vì sao Spark phù hợp hơn Python đơn lẻ.
Cách làm. Spark đọc file theo partition, biến đổi DataFrame và ghi kết quả theo ngày. DataFrame là cấu trúc dữ liệu dạng bảng. Theo dõi bước phân phối lại dữ liệu, lệch tải và số file nhỏ.
Đầu ra và giới hạn. So thời gian, lượng dữ liệu và cấu hình giữa hai cách. Mô phỏng dữ liệu lệch vào một khóa lớn. Không gọi vài nghìn dòng là Big Data chỉ để tạo câu chuyện.
17. Dự án 7: Nền tảng tồn kho trên Cloud
Bài toán. Chuỗi bán lẻ cần hợp nhất bán hàng, nhập hàng và tồn theo cửa hàng. Dữ liệu phải cập nhật mỗi giờ, có phân quyền và giới hạn chi phí. Người quản lý vùng chỉ được xem phạm vi của mình.
Cách làm. Lưu bản gốc trên dịch vụ lưu trữ file; biến đổi trong Data Warehouse Cloud; điều phối bằng dịch vụ quản lý hoặc Airflow. IAM quản lý danh tính cùng quyền. Thiết kế incremental load, tức chỉ xử lý phần mới hoặc thay đổi.
Đầu ra và giới hạn. Tài liệu quyền, chi phí dự kiến, cảnh báo ngân sách và cách xóa tài nguyên. Dashboard tồn chỉ dùng dữ liệu giả lập. Độ trễ nguồn phải hiển thị để người dùng không hiểu nhầm.
18. Dự án 8: Data Lakehouse với dữ liệu có cấu trúc và bán cấu trúc
Bài toán. Doanh nghiệp có bảng giao dịch, JSON ứng dụng và file lớn, cần lưu linh hoạt nhưng vẫn quản trị. Lakehouse kết hợp khả năng lưu dữ liệu đa dạng của Data Lake với quản lý bảng và truy vấn gần Data Warehouse.
Cách làm. Lưu dữ liệu ở định dạng cột như Parquet, quản lý bảng bằng định dạng hỗ trợ giao dịch và dùng Spark hoặc công cụ tương đương để biến đổi. Phân vùng theo trường thường lọc, không theo trường có quá nhiều giá trị.
Đầu ra và giới hạn. Mô tả cách cấu trúc bảng thay đổi theo thời gian, khả năng quay lại phiên bản và dọn tệp. So với Data Warehouse, tức kho dữ liệu phục vụ phân tích, để nêu lý do lựa chọn. Lakehouse không phải phương án mặc định cho mọi dự án.
19. Dự án 9: Data Observability cho nhiều pipeline
Bài toán. Các tác vụ đều báo thành công nhưng dashboard đôi khi thiếu dữ liệu. Cần theo dõi độ tươi, khối lượng, phân phối, cấu trúc bảng và quan hệ phụ thuộc. Observability là khả năng hiểu trạng thái hệ thống qua tín hiệu vận hành.
Cách làm. Thu thập metadata của mỗi lần chạy, tạo ngưỡng và lịch sử. Lineage cho biết dữ liệu từ nguồn nào qua bảng nào tới sản phẩm nào. Cảnh báo nối tới người chịu trách nhiệm và tài sản bị ảnh hưởng.
Đầu ra và giới hạn. Mô phỏng nguồn giảm 40%, cột đổi kiểu và phân phối giá trị bất thường. Đo thời gian phát hiện cùng khôi phục. Ngưỡng cố định có thể tạo cảnh báo nhiễu nên cần được xem xét định kỳ.
20. Dự án 10: Pipeline tạo biến đầu vào cho mô hình dự đoán
Bài toán. Mô hình dự đoán rời bỏ cần các đặc trưng như số ngày từ lần mua cuối và tần suất 30 ngày. Giai đoạn huấn luyện và giai đoạn vận hành phải dùng cùng logic. Feature là biến đầu vào; Machine Learning là phương pháp để máy học quy luật từ dữ liệu quá khứ và áp dụng vào dữ liệu mới.
Cách làm. Tạo bảng biến đầu vào theo từng thời điểm, lưu phiên bản và kiểm tra để không dùng dữ liệu tương lai. Sai lệch giữa huấn luyện và vận hành xảy ra khi hai giai đoạn tính biến theo hai cách khác nhau. Dự án phải chứng minh đã ngăn việc vô tình dùng thông tin tương lai để dự đoán quá khứ.
Đầu ra và giới hạn. Tài liệu định nghĩa, thời gian có hiệu lực, chất lượng và lineage. Mô hình đơn giản chỉ để sử dụng feature; trọng tâm vẫn là pipeline. Không tuyên bố độ chính xác nếu không có đánh giá phù hợp.
PHẦN IV — CÁCH XÂY GITHUB CHUYÊN NGHIỆP
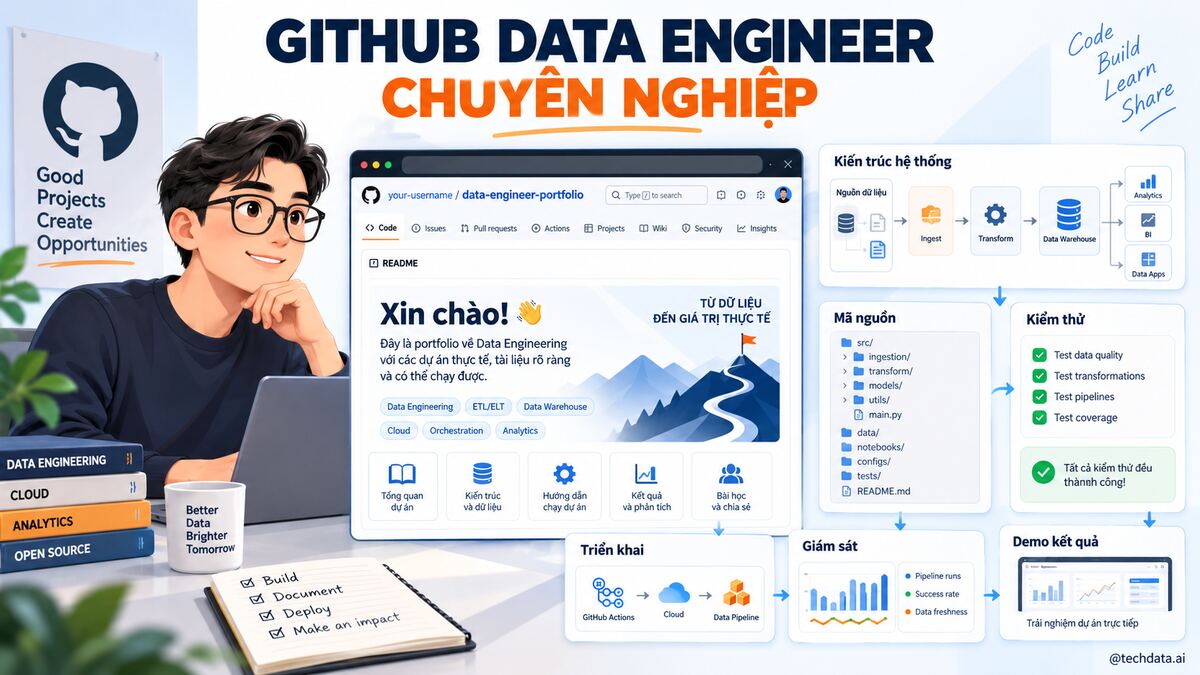
21. Cấu trúc repository rõ ràng
Thư mục thường gồm mã nguồn, test, cấu hình mẫu, hạ tầng, tài liệu, dữ liệu mẫu và ảnh. Tên phải nói được vai trò. Không để hàng chục notebook và file tạm ở thư mục gốc.
Tệp .gitignore loại môi trường, dữ liệu lớn và bí mật khỏi Git. Tệp cấu hình mẫu cho biết biến cần có nhưng không chứa giá trị thật. Một người ngoài phải hiểu dự án trong vài phút.
22. README là trang bán năng lực
README mở bằng vấn đề và kết quả, sau đó mới tới công nghệ. Có mục kiến trúc, cách chạy, dữ liệu, test, vận hành, bảo mật, chi phí và giới hạn. Liên kết nội bộ giúp tài liệu dài vẫn dễ đọc.
Không sao chép nguyên hướng dẫn cài đặt công cụ. Hãy giải thích quyết định riêng của dự án. Ảnh kiến trúc cần chữ đủ lớn và không có chi tiết bí mật.
23. Lịch sử commit và nhánh
Commit nên nhỏ, có thông điệp rõ và phản ánh thay đổi. Branch dùng cho tính năng hoặc sửa lỗi. Pull request có thể tự review bằng checklist trước khi hợp nhất.
Không cần tạo commit giả để làm lịch sử đẹp. Một lịch sử tự nhiên với lỗi và sửa có giá trị hơn tải một lần. Không chỉnh sửa lịch sử để che việc sao chép.
24. Tài liệu quyết định kiến trúc
Architecture Decision Record là biên bản ngắn ghi vấn đề, lựa chọn, lý do và hệ quả. Ví dụ, chọn batch mỗi giờ thay Kafka vì quyết định tồn kho chỉ cần độ trễ 60 phút. Tài liệu cho thấy khả năng đánh đổi.
Không cần ghi mọi chi tiết. Tập trung quyết định có phương án thay thế. Khi yêu cầu đổi, người xem hiểu điều kiện ban đầu.
25. Giấy phép và dữ liệu
Chỉ công khai mã, dữ liệu và tài sản có quyền sử dụng. Ghi nguồn dữ liệu cùng giấy phép. Nếu dự án không muốn người khác dùng lại, vẫn cần nêu điều kiện rõ.
Không đưa dữ liệu khách hàng, công ty, mật khẩu hoặc khóa Cloud lên GitHub. Quét lịch sử nếu từng commit bí mật; xóa file ở phiên bản mới chưa loại khỏi lịch sử cũ.
PHẦN V — KIỂM THỬ, BẢO MẬT VÀ CHI PHÍ
26. Bộ test tối thiểu
Test mã gồm hàm biến đổi, xử lý lỗi và kết nối giả lập. Test dữ liệu gồm schema, khóa, null, phạm vi, số dòng và đối soát. Test pipeline gồm chạy lại, backfill và task thất bại.
Không chạy mọi test nặng ở mỗi commit. Chia kiểm tra nhanh và kiểm tra đầy đủ. Tài liệu nói thời điểm chạy.
27. Quyền tối thiểu
Tài khoản pipeline chỉ được đọc nguồn cần thiết và ghi vùng đích. Người xem dashboard không cần quyền bảng thô. Tách tài khoản người dùng và tài khoản máy.
Portfolio có thể mô phỏng vai trò. Ảnh quyền không được lộ ID hoặc khóa. Giải thích đường thu hồi quyền.
28. Quản lý chi phí Cloud
Đặt ngân sách, cảnh báo, thời gian tự tắt và giới hạn truy vấn. Theo dõi chi phí theo dịch vụ. Dọn tài nguyên sau demo.
Tài liệu ước tính dữ liệu, tần suất và chi phí. Con số không cần chính xác tuyệt đối nhưng giả định phải rõ. Một dự án rẻ nhờ giới hạn thông minh là điểm cộng.
29. Kiểm tra trước khi công khai
Quét bí mật, thử hướng dẫn từ môi trường sạch, mở mọi liên kết và đọc tài liệu như người mới. Kiểm tra dữ liệu có thể tái nhận diện không. Xóa file tạm.
Nhờ ba người review: người nghiệp vụ, người dữ liệu và người tuyển dụng. Họ nhìn thấy lỗi khác nhau. Tác giả tự sửa và hiểu từng thay đổi.
PHẦN VI — DÙNG AI ĐÚNG CÁCH TRONG DỰ ÁN
30. AI Assistant hỗ trợ giải thích và review
AI có thể gợi ý test, rà SQL, giải thích log và tạo dữ liệu mẫu. Người học phải chạy và kiểm chứng. Mã trôi chảy vẫn có thể sai mức chi tiết hoặc quyền.
Ghi phần AI hỗ trợ nếu cần. Không đưa dữ liệu nhạy cảm vào dịch vụ không được phép. Portfolio vẫn do ứng viên chịu trách nhiệm.
31. AI Agent có thể chạy nhiều bước
AI Agent dùng công cụ để chạy test, kiểm tra log và tạo báo cáo. Khác chatbot, Agent có thể hành động. Quyền phải giới hạn ở môi trường thử nghiệm.
Xóa dữ liệu, thay hạ tầng hoặc phát sinh phí cần Human Approval, tức phê duyệt của con người. Nhật ký ghi mọi hành động.
32. Thiết kế bài kiểm tra chống sao chép
Sau khi AI hỗ trợ, tự thay nguồn, cột hoặc tần suất và sửa hệ thống. Giải thích từng quyết định mà không nhìn mã. Mô phỏng một sự cố mới.
Nếu không làm được, dự án chưa thuộc về người học. Hãy thu nhỏ phạm vi và xây lại phần lõi. Năng lực quan trọng hơn tốc độ hoàn thành.
PHẦN VII — KẾ HOẠCH HOÀN THÀNH PORTFOLIO TRONG 16 TUẦN
33. Tuần 1–4: dự án nền tảng
Xây API tới PostgreSQL với Python, SQL, Git và Linux. Tập trung chạy lại, log và test. Nhờ review cuối tuần bốn.
Không thêm Cloud hoặc Airflow nếu luồng chưa đúng. README phiên bản đầu phải đủ chạy.
34. Tuần 5–8: Data Warehouse và Airflow
Mở rộng thành mô hình sao, lớp staging và mart. Dùng Airflow điều phối, Docker đóng gói. Thêm backfill và Data Quality.
Mô phỏng ba lỗi và viết runbook. Review kiến trúc cùng dữ liệu. Đây là dự án chủ lực.
35. Tuần 9–12: Cloud
Đưa bản gốc và mart lên một Cloud, cấu hình IAM, log và ngân sách. Chỉ dùng dịch vụ cần thiết. Ghi chi phí.
Tách cấu hình phát triển và mô phỏng vận hành. Quét bí mật trước commit. Hoàn thiện tài liệu.
36. Tuần 13–16: dự án bổ sung và trình bày
Chọn Spark, Kafka, CDC hoặc Observability theo vị trí. Dự án thứ hai nhỏ hơn nhưng chứng minh năng lực khác. Không lặp case bán hàng y hệt.
Chuẩn bị CV, trang Portfolio và bài trình bày. Nhờ review cuối từ ba góc nhìn. Chỉ công khai khi dữ liệu, liên kết và hướng dẫn an toàn.
PHẦN VIII — VÍ DỤ TỔNG THỂ
37. Giả sử một ứng viên chọn ba dự án
An chọn dự án API–PostgreSQL để chứng minh nền tảng, Data Warehouse bán lẻ trên Cloud làm dự án chủ lực và Kafka clickstream làm phần mở rộng. Ba dự án dùng chung một doanh nghiệp giả định nhưng có yêu cầu khác.
Dự án đầu cho thấy Python, SQL, chạy lại và test. Dự án hai thêm mô hình, Airflow, Docker, IAM, chi phí và vận hành. Dự án ba chứng minh sự kiện, nhưng ghi rõ dữ liệu mô phỏng và giới hạn quy mô.
GitHub của An có trang tổng quan liên kết ba repository. Mỗi README mở bằng bài toán, không phải logo. Architecture Decision Record giải thích vì sao pipeline doanh thu chạy theo giờ trong khi clickstream dùng Kafka.
Trong buổi phản biện, người hướng dẫn phát hiện Data Warehouse bỏ hoàn trả đến muộn và thành phần đọc Kafka chưa chống trùng. An tự sửa, thêm test và cập nhật runbook. Hai lỗi trở thành nội dung phỏng vấn.
An không tuyên bố đã vận hành hệ thống doanh nghiệp thật. Portfolio cho thấy nền tảng, lựa chọn và khả năng học. Đây là bằng chứng đáng tin hơn một sơ đồ có quá nhiều dịch vụ nhưng không thể chạy.
CÂU HỎI THƯỜNG GẶP
38. Cần bao nhiêu dự án?
Hai hoặc ba dự án sâu là đủ để bắt đầu. Một dự án trọn vòng đời, một dự án bổ sung Cloud và một phần chuyên sâu tùy chọn tạo phạm vi tốt.
39. Có cần deploy dự án không?
Nên có ít nhất một dự án chạy trên Cloud hoặc môi trường có thể tái tạo. Deploy nghĩa là đưa hệ thống vào môi trường chạy. Không cần để tài nguyên hoạt động liên tục và tốn phí.
40. Có nên dùng dữ liệu công ty?
Chỉ khi có quyền rõ ràng, nhưng phần lớn trường hợp không nên công khai. Dùng dữ liệu mở hoặc giả lập. Bảo mật quan trọng hơn tính “thật”.
41. Có nên dùng dự án khóa học?
Có nếu tự làm, hiểu và mở rộng. Ghi bối cảnh học tập, phần đã thay đổi và phản hồi đã xử lý. Không trình bày như dự án khách hàng.
42. Học theo chương trình nào?
Khóa học Data Engineer tại TechData.AI kết nối SQL, Python, Data Warehouse, Cloud, Big Data cùng dự án. Người học nên xem đầu vào, lịch và chính sách hiện hành.
KẾT LUẬN
Portfolio Data Engineer chuyên nghiệp chứng minh toàn bộ vòng đời dữ liệu: vấn đề, nguồn, pipeline, mô hình, chất lượng, vận hành, bảo mật, chi phí và giới hạn. Nó không được đo bằng số logo hoặc số dòng dữ liệu.
Mười dự án là bản đồ lựa chọn, không phải danh sách bắt buộc. Hãy làm hai hoặc ba sản phẩm sâu, có review và do chính ứng viên bảo vệ được. AI giúp tăng tốc nhưng không thay kiểm chứng.
Câu hỏi cuối trước khi công khai là: nếu nguồn đổi, pipeline dừng hoặc con số lệch, ứng viên có thể phát hiện, giải thích và phục hồi không? Khi câu trả lời được chứng minh bằng mã, test và tài liệu, dự án đã trở thành bằng chứng năng lực.
Tài liệu tham khảo
- GitHub Docs — About READMEs
- PostgreSQL Tutorial
- Python Tutorial
- Docker Get Started
- Apache Airflow Documentation
- Apache Kafka Documentation
- Apache Spark Documentation
- dbt Documentation
- Google Cloud Architecture Framework
- AWS Well-Architected Framework
TechData.AI - Leading the Future.
Tham khảo khoá học theo link: https://techdata.ai/data-engineer/
Hoàng Minh.