



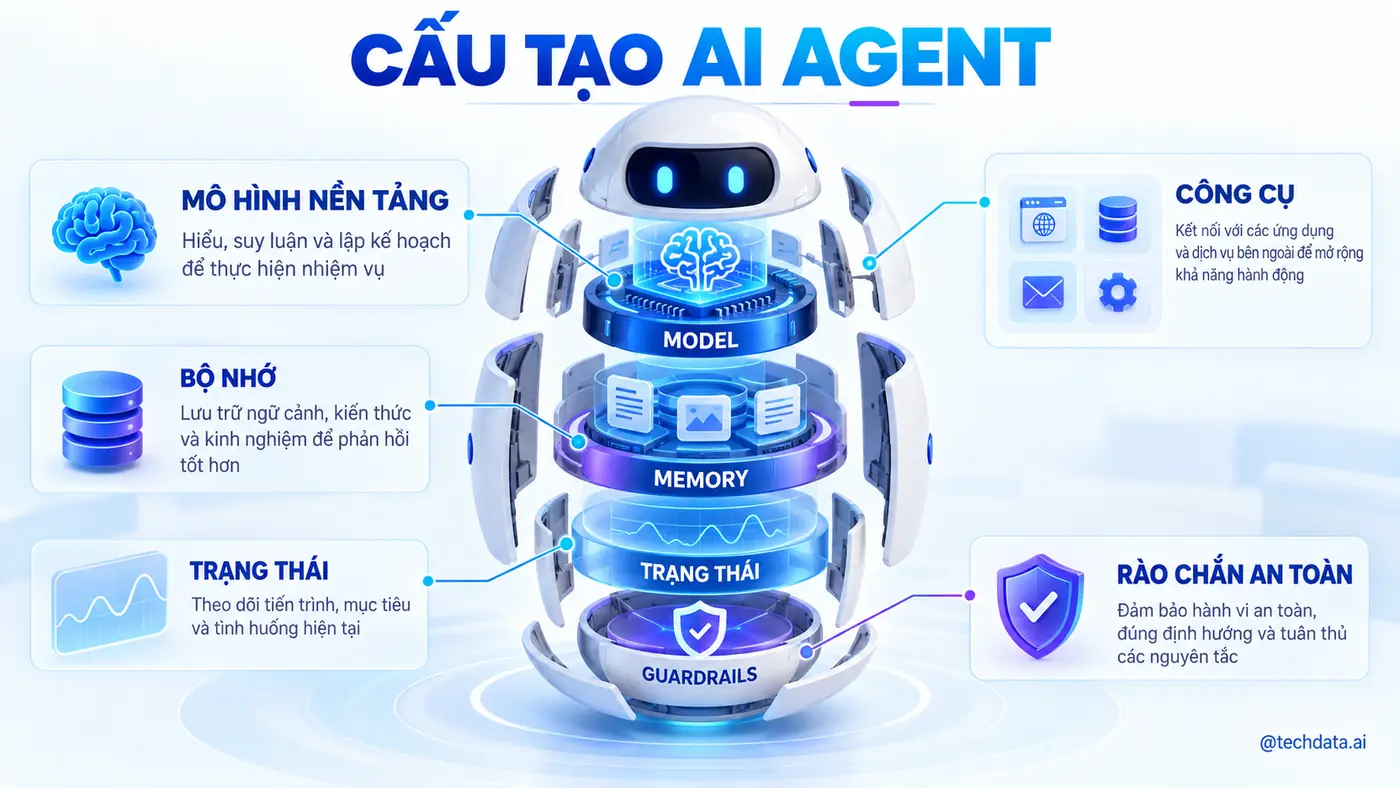

cấu tạo AI Agent là chủ đề trọng tâm của bài viết này. Ở Bài 1, chúng ta đã phân biệt Chatbot, Workflow và Agent, đồng thời thấy rằng Agentic AI không chỉ tạo câu trả lời mà còn có thể lựa chọn hành động để hoàn thành mục tiêu. Tuy nhiên, nếu chỉ nhìn một AI Agent như một mô hình ngôn ngữ được gắn thêm vài công cụ, người mới rất dễ bỏ qua những phần quan trọng nhất của hệ thống.
Một AI Agent hoạt động trong thực tế là sự kết hợp của Model, Instructions, Context, Tools, State, Memory, Orchestration, Guardrails và Observability. Mỗi thành phần giải quyết một nhóm vấn đề riêng. Model cung cấp khả năng hiểu và suy luận. Tools cho phép hệ thống tác động ra bên ngoài. State giúp chương trình biết mình đang ở bước nào. Guardrails giới hạn những việc Agent được phép làm. Observability giúp Developer biết chuyện gì đã xảy ra khi kết quả sai.
Bài viết này đi sâu vào cấu tạo đó bằng một ví dụ xuyên suốt: Agent hỗ trợ kiểm tra tình hình bán hàng của doanh nghiệp. Mục tiêu không phải ghi nhớ tên gọi của các thành phần, mà là hiểu dữ liệu đi qua hệ thống như thế nào, quyết định được hình thành ở đâu và vì sao một Agent cần nhiều kỹ thuật Software Engineering hơn một bản Demo Chatbot.
Mục lục
- Nhìn AI Agent như một hệ thống phần mềm
- Model là bộ máy suy luận, không phải toàn bộ Agent
- Instructions xác định vai trò và quy tắc
- Context là vùng thông tin làm việc hiện tại
- Tools kết nối suy luận với hành động
- Tool schema và hợp đồng dữ liệu
- State giúp Agent biết mình đang ở đâu
- Memory khác Context như thế nào
- Planning và Task Decomposition
- Vòng lặp Observe, Decide, Act
- Orchestration điều phối toàn bộ quá trình
- Guardrails, Permissions và Human Approval
- Observability và Evaluation
- Kiến trúc Agent phân tích doanh thu
- Các Failure Mode thường gặp
- Checklist thiết kế AI Agent đầu tiên
- Kết luận
- Tài liệu tham khảo
Nhìn AI Agent như một hệ thống phần mềm
Trong một ứng dụng LLM đơn giản, chương trình nhận Prompt, gửi Prompt đến Model rồi hiển thị câu trả lời. Nếu yêu cầu là tóm tắt một đoạn văn, luồng xử lý có thể kết thúc tại đó. Một Agent phức tạp hơn vì kết quả từ Model chưa chắc là câu trả lời cuối cùng. Model có thể quyết định gọi Tool, chương trình thực thi Tool, kết quả được đưa trở lại Context và Model tiếp tục quyết định bước kế tiếp.
Vì vậy, Agent cần được nhìn như một vòng lặp có trạng thái. Vòng lặp bắt đầu từ mục tiêu của người dùng, nhưng có thể đi qua nhiều lần suy luận và hành động trước khi kết thúc. Trong mỗi vòng, hệ thống phải trả lời ít nhất bốn câu hỏi: Agent đã biết gì, còn thiếu gì, được phép làm gì và điều kiện nào cho biết nhiệm vụ đã hoàn thành.
Ví dụ, yêu cầu "Kiểm tra vì sao doanh thu hôm qua giảm" chưa cung cấp đủ dữ liệu để kết luận. Agent có thể cần lấy doanh thu theo ngày, so sánh với đường cơ sở, phân rã theo chi nhánh, kiểm tra tồn kho và đọc lịch sử chương trình khuyến mãi. Mỗi lần gọi dữ liệu đều tạo ra một quan sát mới. Quan sát này có thể thay đổi kế hoạch ban đầu.
Kiến trúc của Agent vì thế không chỉ trả lời câu hỏi "dùng Model nào". Nó còn phải xác định cách quản lý Tool, dữ liệu, quyền, lỗi, chi phí, số vòng lặp và bằng chứng cho kết luận. Đây là ranh giới giữa một thử nghiệm thú vị và một hệ thống có thể được doanh nghiệp tin cậy.
Model là bộ máy suy luận, không phải toàn bộ Agent
Model thường là LLM có khả năng tiếp nhận Instructions và Context để sinh ra nội dung hoặc yêu cầu gọi Tool. Trong Agent, Model đảm nhiệm các công việc như hiểu ý định, chọn công cụ, tạo tham số, tổng hợp quan sát và quyết định khi nào nên dừng. Model mạnh hơn thường xử lý nhiệm vụ mơ hồ và nhiều bước tốt hơn, nhưng năng lực cao không tự động làm cho toàn hệ thống đáng tin cậy.
Model không trực tiếp truy cập Database chỉ vì Prompt nói rằng nó có quyền. Model cũng không tự biết dữ liệu nội bộ mới nhất nếu dữ liệu đó không được cung cấp. Khả năng gọi Tool chỉ tạo ra một yêu cầu có cấu trúc. Application Runtime mới là phần kiểm tra yêu cầu, xác thực quyền, gọi API thật và trả kết quả về cho Model.
Khi chọn Model, Developer cần cân bằng ít nhất năm yếu tố: chất lượng reasoning, khả năng Tool Calling, Context Window, latency và cost. Một Model lớn có thể phù hợp cho bước lập kế hoạch khó, còn một Model nhỏ hơn có thể đủ cho bước phân loại yêu cầu hoặc trích xuất trường dữ liệu. Kiến trúc tốt không nhất thiết dùng một Model duy nhất cho mọi bước.
Cần nhớ rằng Model có tính xác suất. Cùng một Input, hệ thống có thể tạo ra các Output hơi khác nhau. Vì vậy, logic quan trọng như giới hạn tiền, kiểm tra quyền truy cập hoặc xác nhận giao dịch không nên chỉ tồn tại trong Prompt. Những quy tắc này phải được thực thi bằng code và policy ở lớp Application.
Instructions xác định vai trò và quy tắc
Instructions là tập chỉ dẫn giúp Model hiểu vai trò, mục tiêu, cách sử dụng Tools, giới hạn hành vi và định dạng đầu ra. Một Instruction tốt không chỉ nói "Bạn là trợ lý phân tích dữ liệu". Nó phải làm rõ nguồn dữ liệu nào được phép sử dụng, tiêu chuẩn nào được dùng để kết luận, khi nào phải hỏi lại và hành động nào cần con người phê duyệt.
Có thể chia Instructions thành nhiều lớp. System Instructions mô tả quy tắc toàn cục và mức ưu tiên cao nhất. Developer Instructions mô tả quy trình của ứng dụng. User Input chứa mục tiêu cụ thể của người dùng. Tool Description giải thích khả năng và giới hạn của từng công cụ. Việc tách lớp giúp hệ thống dễ bảo trì hơn so với đặt mọi thứ vào một Prompt dài.
Instructions cũng cần nêu rõ tiêu chí dừng. Nếu chỉ yêu cầu Agent "hãy phân tích thật kỹ", Agent có thể gọi Tool quá nhiều lần hoặc tiếp tục tìm dữ liệu dù đã đủ bằng chứng. Một quy tắc tốt có thể giới hạn tối đa sáu Tool Calls, yêu cầu dừng khi không còn giả thuyết mới có thể kiểm tra hoặc chuyển cho con người khi dữ liệu thiếu.
Prompt không phải cơ chế bảo mật. Câu "không được đọc dữ liệu phòng Nhân sự" trong Instructions có ích để định hướng Model, nhưng quyền truy cập vẫn phải bị chặn tại Tool hoặc Data Layer. Nếu Tool nhận được truy vấn không hợp lệ, nó phải từ chối ngay cả khi Model cố gọi.
Context là vùng thông tin làm việc hiện tại
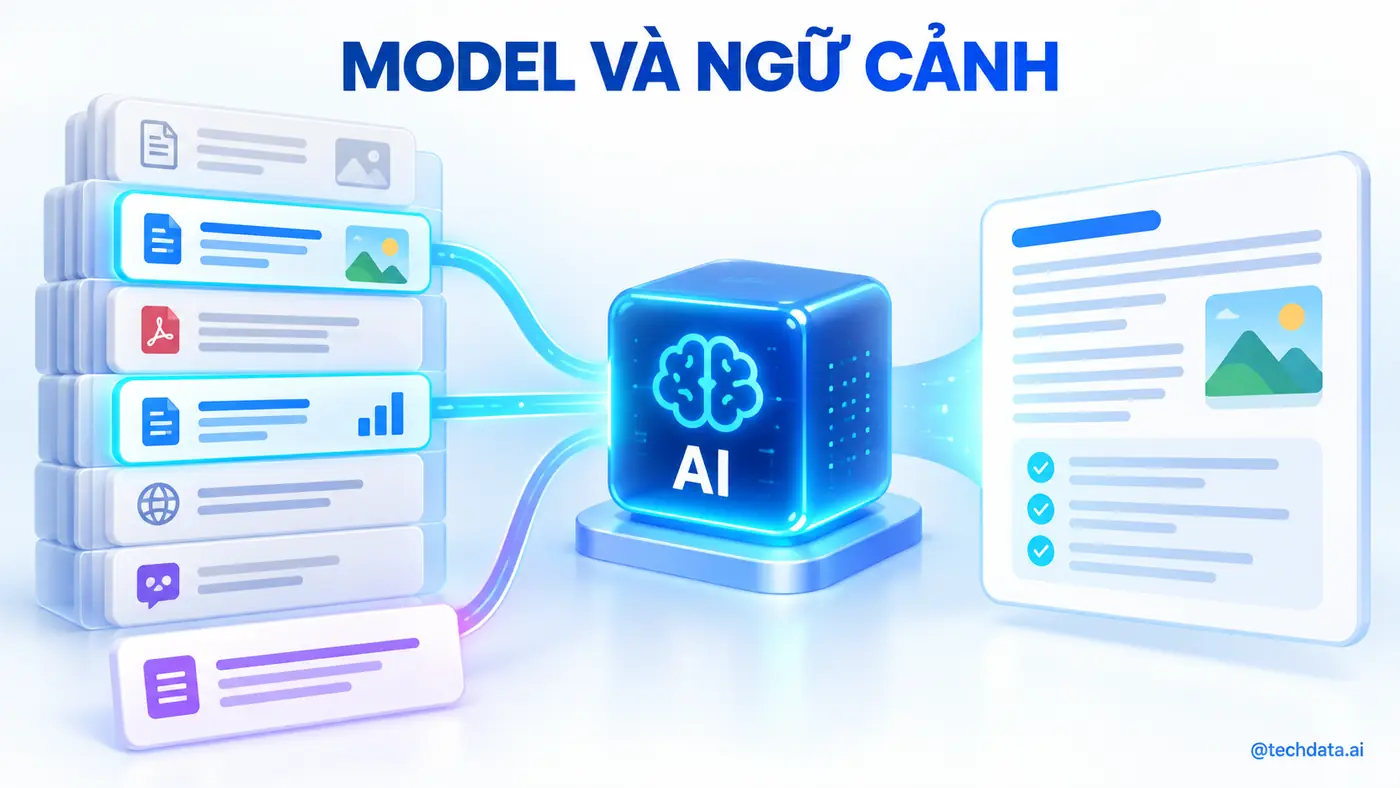
Context là toàn bộ thông tin Model nhận được tại một lần xử lý. Nó có thể gồm Instructions, câu hỏi của người dùng, lịch sử hội thoại, mô tả Tools, kết quả Tool Calls, tài liệu được truy xuất và dữ liệu trạng thái. Model chỉ có thể suy luận dựa trên những gì có trong Context hoặc những gì đã được học trong quá trình huấn luyện.
Context Window có giới hạn. Khi một Agent chạy nhiều bước, lịch sử có thể tăng nhanh vì mỗi Tool Call bổ sung cả yêu cầu lẫn kết quả. Nếu đưa toàn bộ bảng dữ liệu hàng trăm nghìn dòng vào Context, chi phí và latency tăng lên trong khi chất lượng có thể giảm. Context Engineering vì vậy là công việc chọn đúng thông tin, đúng mức chi tiết và đúng thời điểm.
Trong Agent phân tích doanh thu, Tool không nên trả toàn bộ bảng giao dịch nếu Model chỉ cần doanh thu theo chi nhánh. Data Layer nên thực hiện phép tổng hợp bằng SQL rồi trả một bảng nhỏ có schema rõ ràng. Khi Model cần điều tra một chi nhánh cụ thể, Agent mới gọi Tool chi tiết hơn.
Một Context tốt thường chứa cả dữ liệu và metadata. Ngoài giá trị doanh thu, Model cần biết đơn vị tiền tệ, múi giờ, ngày dữ liệu được cập nhật, định nghĩa KPI và phạm vi quyền của người dùng. Thiếu metadata có thể dẫn đến kết luận sai dù con số hoàn toàn chính xác.
Tools kết nối suy luận với hành động
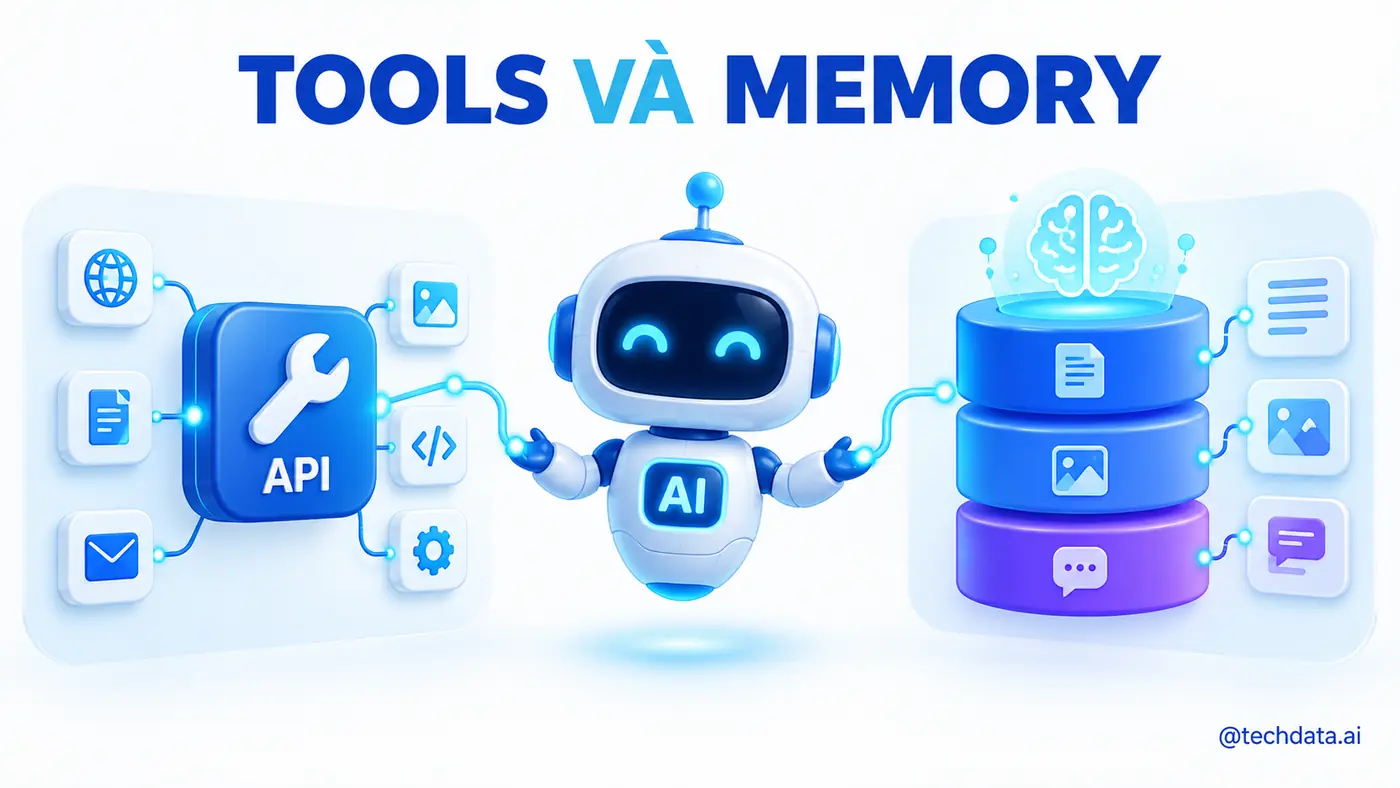
Tool là giao diện cho phép Agent tương tác với hệ thống bên ngoài. Tool có thể đọc dữ liệu từ Database, tìm tài liệu, gọi API, gửi thông báo, tạo Ticket hoặc kích hoạt Workflow. Không có Tools, Model chủ yếu tạo nội dung. Khi có Tools, Agent có thể quan sát trạng thái thật và thực hiện hành động thật.
Một Tool nên thực hiện một năng lực rõ ràng. Ví dụ, get_sales_summary trả doanh thu theo khoảng thời gian và chiều phân tích; get_inventory_status kiểm tra tồn kho; create_incident tạo yêu cầu xử lý. Nếu một Tool có quá nhiều chức năng, Model khó chọn đúng và Developer khó kiểm soát quyền.
Anthropic nhấn mạnh rằng Tool Description có ảnh hưởng lớn đến khả năng sử dụng công cụ của Agent. Tên Tool, mô tả, tham số, ví dụ và thông báo lỗi đều là một phần của giao diện dành cho Model. Thiết kế Tool cho Agent giống thiết kế API cho Developer, nhưng người tiêu thụ API là một mô hình xác suất.
Tools nên được phân loại theo mức rủi ro. Read-only Tools chỉ đọc dữ liệu thường có rủi ro thấp hơn Write Tools làm thay đổi hệ thống. Với Tool gửi email, hoàn tiền hoặc cập nhật hợp đồng, Application nên yêu cầu Human Approval trước khi thực thi. Quyền phải gắn với danh tính người dùng chứ không gắn chung cho toàn bộ Agent.
Tool schema và hợp đồng dữ liệu
Tool Calling thường dựa trên một schema mô tả tên hàm, ý nghĩa và kiểu dữ liệu của các tham số. Model không chạy hàm trực tiếp. Nó tạo một cấu trúc dữ liệu thể hiện ý định gọi hàm. Runtime kiểm tra cấu trúc này rồi mới thực thi.
{
  "name": "get_sales_summary",
  "description": "Lấy doanh thu đã ghi nhận theo khoảng ngày và chiều phân tích",
  "parameters": {
    "type": "object",
    "properties": {
      "start_date": {"type": "string", "format": "date"},
      "end_date": {"type": "string", "format": "date"},
      "group_by": {
        "type": "string",
        "enum": ["day", "branch", "product_category"]
      }
    },
    "required": ["start_date", "end_date", "group_by"]
  }
}
Schema giúp giảm sự mơ hồ nhưng không thay thế validation. Model vẫn có thể tạo ngày kết thúc trước ngày bắt đầu, yêu cầu khoảng thời gian quá lớn hoặc chọn một phạm vi mà người dùng không có quyền xem. Runtime cần kiểm tra cả kiểu dữ liệu, quy tắc nghiệp vụ và authorization.
Kết quả Tool cũng cần một hợp đồng ổn định. Thay vì trả một đoạn Text khó kiểm tra, Tool nên trả JSON với các trường như status, data, currency, timezone, freshness và error. Cấu trúc nhất quán giúp Model hiểu kết quả và giúp hệ thống ghi log, kiểm thử, đo lường.
{
  "status": "success",
  "currency": "VND",
  "timezone": "Asia/Ho_Chi_Minh",
  "freshness": "2026-09-15T08:00:00+07:00",
  "data": [
    {"branch": "Q7", "revenue": 520000000},
    {"branch": "Thu Duc", "revenue": 410000000}
  ]
}
State giúp Agent biết mình đang ở đâu
State là trạng thái có cấu trúc của một lần thực hiện nhiệm vụ. Nó có thể chứa Task ID, mục tiêu, bước hiện tại, Tools đã gọi, kết quả trung gian, số lần thử, lỗi, ngân sách và trạng thái phê duyệt. State thuộc về Application, không nên chỉ tồn tại trong phần hội thoại của Model.
Giả sử Agent đã phát hiện chi nhánh Q7 giảm 18 phần trăm và đang chờ người quản lý cho phép mở Incident. Nếu tiến trình bị dừng, State cho phép hệ thống tiếp tục từ điểm chờ thay vì phân tích lại từ đầu. State cũng giúp tránh thực thi trùng một hành động khi hệ thống retry sau timeout.
Một State Machine đơn giản có thể gồm các trạng thái received, planning, executing, waiting_approval, completed và failed. Mỗi chuyển trạng thái cần có điều kiện rõ ràng. Cách thiết kế này đưa một phần quan trọng của hệ thống trở lại logic deterministic và giảm phụ thuộc vào trí nhớ của Model.
State còn cần cơ chế idempotency. Nếu Tool create_incident được gọi lại do mạng chậm, hệ thống không nên tạo hai Ticket giống nhau. Một Idempotency Key gắn với Task ID và loại hành động giúp Tool nhận biết yêu cầu đã được xử lý.
Memory khác Context như thế nào
Context là thông tin được đưa vào lần xử lý hiện tại. Memory là cơ chế lưu giữ và lấy lại thông tin qua nhiều bước hoặc nhiều phiên làm việc. Nói cách khác, Memory chỉ có ích khi thông tin được truy xuất đúng lúc và được đưa trở lại Context.
Short-term Memory thường liên quan đến lịch sử của nhiệm vụ đang chạy, chẳng hạn các giả thuyết đã kiểm tra và kết quả Tool Calls gần nhất. Long-term Memory lưu thông tin qua nhiều phiên, chẳng hạn sở thích trình bày báo cáo của người dùng hoặc một quyết định đã được xác nhận. Semantic Memory lưu kiến thức, còn Episodic Memory lưu các sự kiện và trải nghiệm cụ thể.
Không phải mọi thứ đều nên được ghi nhớ. Memory có thể chứa thông tin lỗi thời, sai hoặc nhạy cảm. Hệ thống cần chính sách về loại dữ liệu được lưu, thời hạn lưu, quyền truy cập, nguồn gốc, cách sửa và cách xóa. Khi sử dụng Memory để ra quyết định, Agent nên phân biệt thông tin do người dùng xác nhận với suy luận trước đây của Model.
Một Memory Record tốt có thể gồm nội dung, loại thông tin, chủ sở hữu, thời điểm tạo, thời điểm hết hạn, nguồn, mức tin cậy và phạm vi được phép sử dụng. Không nên chỉ lưu một câu tự do rồi xem đó là sự thật lâu dài.
Planning và Task Decomposition
Planning là quá trình xác định các bước cần thực hiện để đạt mục tiêu. Task Decomposition là chia một nhiệm vụ lớn thành các nhiệm vụ nhỏ có thể xử lý và kiểm tra. Với yêu cầu đơn giản, một Tool Call có thể đủ. Với yêu cầu mơ hồ, Agent cần tạo giả thuyết và chọn thứ tự kiểm tra.
Ví dụ, để tìm nguyên nhân doanh thu giảm, kế hoạch ban đầu có thể gồm xác nhận khoảng thời gian, đo mức giảm, tìm chiều dữ liệu có biến động lớn, kiểm tra tồn kho và đối chiếu sự kiện kinh doanh. Tuy nhiên, kế hoạch không nhất thiết bất biến. Nếu dữ liệu cho thấy doanh thu chỉ giảm ở một chi nhánh, Agent có thể thu hẹp phạm vi sớm.
Có hai cách phổ biến. Plan-first tạo một kế hoạch tương đối đầy đủ trước khi thực thi. Incremental Planning quyết định từng bước dựa trên quan sát mới nhất. Plan-first dễ hiển thị và phê duyệt, còn Incremental Planning linh hoạt hơn. Nhiều hệ thống production kết hợp cả hai: tạo kế hoạch cấp cao, nhưng cho phép điều chỉnh bước chi tiết.
Planning cần giới hạn. Runtime nên đặt Max Steps, Timeout, Token Budget và Tool Budget. Nếu Agent không tiến gần mục tiêu sau nhiều vòng, hệ thống cần dừng hoặc chuyển sang con người. Khả năng tiếp tục suy luận không đồng nghĩa với việc tiếp tục sẽ tạo thêm giá trị.
Vòng lặp Observe, Decide, Act
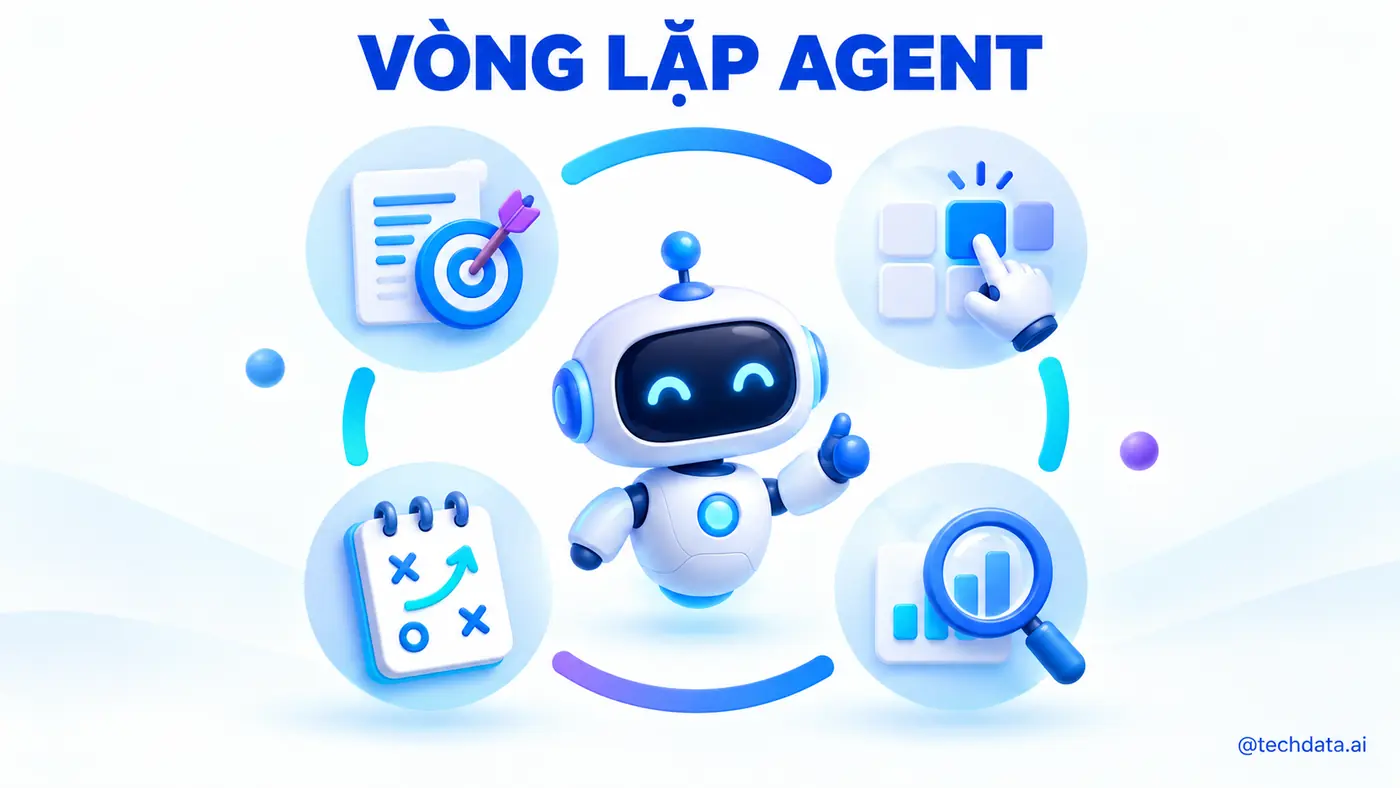
Một cách dễ hiểu để mô tả hoạt động của Agent là vòng lặp Observe, Decide, Act. Observe thu nhận yêu cầu, State và kết quả từ môi trường. Decide sử dụng Model cùng Instructions để chọn bước tiếp theo. Act thực thi Tool hoặc tạo câu trả lời. Kết quả hành động trở thành quan sát mới cho vòng tiếp theo.
while not task.finished:
    context = build_context(task.state)
    decision = model.decide(context, tools)

    if decision.type == "tool_call":
        validate(decision)
        result = execute_tool(decision)
        task.state.add_observation(result)
    else:
        task.finish(decision.answer)
Đoạn Pseudocode này che giấu nhiều chi tiết production. Hàm validate phải kiểm tra schema, quyền và policy. execute_tool cần timeout, retry có kiểm soát và idempotency. build_context phải chọn thông tin phù hợp. Điều kiện task.finished phải bao gồm cả giới hạn số bước và ngân sách.
Vòng lặp cũng cần phân biệt lỗi có thể retry và lỗi không nên retry. Timeout tạm thời có thể thử lại. Lỗi permission phải dừng ngay. Lỗi validation nên được trả cho Model bằng thông báo có cấu trúc để Model sửa tham số. Retry mù quáng có thể tăng chi phí hoặc lặp lại hành động nguy hiểm.
Orchestration điều phối toàn bộ quá trình
Orchestration là lớp điều phối Model, Tools, State, Memory, Guardrails và Workflow. Nó quyết định khi nào gọi Model, cách đưa Tool Result trở lại Context, cách lưu checkpoint, cách xử lý lỗi và khi nào yêu cầu Human Approval. Framework có thể hỗ trợ Orchestration, nhưng Developer vẫn phải thiết kế logic nghiệp vụ.
Đối với Agent nhỏ, Orchestrator có thể là một vòng lặp Python. Khi hệ thống lớn hơn, nó có thể cần Queue, Worker, Database trạng thái và Workflow Engine. Những nhiệm vụ kéo dài nhiều phút hoặc chờ phê duyệt hàng giờ không nên phụ thuộc vào một HTTP Request duy nhất.
Orchestrator nên tách Business State khỏi Message History. Message History phục vụ Model, còn Business State phục vụ tính đúng đắn của ứng dụng. Ví dụ, trạng thái "đã được phê duyệt bởi user_id 781 lúc 09:15" cần được lưu như dữ liệu có cấu trúc, không chỉ là một câu trong hội thoại.
Thiết kế Orchestration cũng ảnh hưởng khả năng thay Model. Nếu toàn bộ logic bị nhúng vào Prompt riêng của một nhà cung cấp, việc thay đổi trở nên khó khăn. Khi Tools, State và Policy có hợp đồng rõ ràng, Model trở thành một thành phần có thể được đánh giá và thay thế có kiểm soát.
Guardrails, Permissions và Human Approval
Guardrails là các cơ chế giới hạn đầu vào, đầu ra và hành động của Agent. Chúng có thể kiểm tra nội dung, định dạng, dữ liệu nhạy cảm, phạm vi Tool và chính sách nghiệp vụ. Guardrails không phải một lớp duy nhất mà là nhiều lớp phòng vệ đặt trước và sau Model.
Permissions trả lời câu hỏi Agent đang hành động thay mặt ai và người đó được phép làm gì. Tool đọc doanh thu cần áp dụng Row-level hoặc Column-level Security theo danh tính người dùng. Tool tạo yêu cầu thanh toán cần kiểm tra hạn mức. Agent không được sở hữu một tài khoản dịch vụ có quyền rộng rồi bỏ qua quyền của người yêu cầu.
Human Approval phù hợp với hành động có hậu quả đáng kể hoặc khó hoàn tác. Agent có thể chuẩn bị nội dung và bằng chứng, nhưng con người quyết định bước cuối. Một Approval Request tốt phải cho người duyệt biết Agent định làm gì, trên đối tượng nào, lý do, dữ liệu được dùng và tác động dự kiến.
Quy tắc Approval nên dựa trên rủi ro, không dựa trên cảm giác. Hành động đọc báo cáo tổng hợp có thể chạy tự động. Hành động gửi email nội bộ có thể cần phê duyệt trong giai đoạn đầu. Hành động thanh toán, xóa dữ liệu hoặc thay đổi quyền phải có kiểm soát chặt hơn và Audit Log đầy đủ.
Observability và Evaluation
Observability cho biết Agent đã thực hiện những bước nào. Một Trace nên liên kết User Request, Task ID, Model Call, Tool Call, latency, token usage, cost, lỗi, quyết định phê duyệt và kết quả cuối. Khi câu trả lời sai, đội ngũ cần biết sai do Model hiểu nhầm, Tool trả dữ liệu lỗi hay Context thiếu thông tin.
Evaluation đo xem Agent có hoàn thành nhiệm vụ theo tiêu chuẩn hay không. Chỉ đánh giá câu trả lời cuối là chưa đủ. Cần đo Tool Selection Accuracy, Parameter Accuracy, Task Completion, Groundedness, Policy Compliance, số bước, latency và cost. Một Agent có câu trả lời nghe hợp lý nhưng gọi nhầm dữ liệu vẫn là thất bại.
Evaluation Set nên được xây từ tình huống thật, gồm cả trường hợp bình thường, dữ liệu thiếu, câu hỏi mơ hồ, lỗi Tool và yêu cầu vượt quyền. Mỗi lần thay Prompt, Model, Tool Description hoặc Logic, hệ thống cần chạy Regression Evaluation để phát hiện chất lượng bị giảm.
Production Monitoring bổ sung tín hiệu từ người dùng và hệ thống thật. Các chỉ số như tỷ lệ hoàn thành, tỷ lệ cần con người sửa, số Tool Calls, chi phí mỗi nhiệm vụ và lỗi theo loại giúp đội ngũ hiểu Agent đang tạo giá trị hay chỉ tạo thêm công việc kiểm tra.
Kiến trúc Agent phân tích doanh thu
Hãy ghép các thành phần thành một kiến trúc cụ thể. Người quản lý gửi yêu cầu qua ứng dụng. API Gateway xác thực danh tính và tạo Task. Orchestrator nạp Instructions, User Context và Tool Catalog. Model quyết định cần lấy dữ liệu doanh thu. Tool Gateway kiểm tra schema và quyền rồi gọi Data Service. Data Service truy vấn Data Warehouse và trả kết quả có metadata.
Orchestrator lưu Tool Result vào State, tạo Context mới và gọi Model lần tiếp theo. Model nhận thấy chi nhánh Q7 giảm mạnh nên yêu cầu dữ liệu theo nhóm sản phẩm. Sau lần phân tích thứ hai, Model phát hiện nhóm đồ uống giảm đồng thời tồn kho bằng không. Agent tạo kết luận kèm bằng chứng và đề nghị mở Incident cho bộ phận vận hành.
Vì tạo Incident là Write Action, Policy Engine chuyển nhiệm vụ sang trạng thái waiting_approval. Người quản lý xem bản tóm tắt, dữ liệu hỗ trợ và nội dung Ticket dự kiến. Sau khi phê duyệt, Orchestrator gọi Tool tạo Ticket với Idempotency Key. Kết quả được lưu vào Audit Log và Agent trả đường dẫn Ticket.
User
  |
API Gateway
  |
Task Orchestrator
  |     Model
  |     Memory
  |     Policy Engine
  |
Tool Gateway
  |     Sales Service
  |     Inventory Service
  |     Incident Service
  |
Data Warehouse and Business Systems
Model là một phần quan trọng, nhưng phần lớn tính an toàn và tin cậy đến từ các lớp bao quanh Model. Nếu Data Service trả sai KPI, Permission không được áp dụng hoặc Write Tool thiếu idempotency, Model tốt đến đâu cũng không cứu được kiến trúc.
Các Failure Mode thường gặp
Failure Mode đầu tiên là Tool Selection sai. Agent chọn Tool tồn kho trong khi cần Tool doanh thu, hoặc chọn Tool tổng hợp khi câu hỏi cần dữ liệu chi tiết. Nguyên nhân có thể là tên Tool giống nhau, mô tả mơ hồ hoặc quá nhiều Tools được đưa vào cùng Context.
Failure Mode thứ hai là tham số hợp lệ về schema nhưng sai về nghiệp vụ. Ngày tháng đúng định dạng nhưng sai múi giờ; Branch ID tồn tại nhưng nằm ngoài quyền; số tiền là số dương nhưng vượt hạn mức. JSON Schema chỉ kiểm tra được một phần, Business Validation phải được thực hiện bằng code.
Failure Mode thứ ba là vòng lặp không tiến triển. Agent gọi lại cùng một Tool với tham số tương tự, nhận cùng kết quả rồi tiếp tục suy luận. Cần phát hiện hành động lặp, giới hạn số bước và đưa lịch sử quyết định phù hợp vào Context.
Failure Mode thứ tư là Context bị nhiễu hoặc quá dài. Dữ liệu quan trọng bị chôn trong lịch sử, Tool Result cũ bị hiểu như dữ liệu mới hoặc tài liệu không liên quan được Retrieval đưa vào. Context cần provenance, timestamp và chiến lược rút gọn.
Failure Mode thứ năm là hành động được thực hiện hai lần. Timeout xảy ra sau khi API đã nhận yêu cầu nhưng trước khi trả phản hồi. Agent retry và tạo bản ghi trùng. Idempotency, Transaction Log và cơ chế đối soát là yêu cầu bắt buộc cho Write Tools.
Failure Mode cuối cùng là kết luận không có bằng chứng. Agent tạo một câu chuyện hợp lý từ dữ liệu chưa đủ. Hệ thống nên yêu cầu mỗi Finding liên kết với Tool Result hoặc nguồn tài liệu, đồng thời nêu rõ mức độ chắc chắn và dữ liệu còn thiếu.
Checklist thiết kế AI Agent đầu tiên
- Mục tiêu của Agent có thể mô tả bằng một câu rõ ràng hay không?
- Điều kiện hoàn thành và điều kiện dừng đã được xác định chưa?
- Mỗi Tool có một chức năng, schema và mô tả dễ phân biệt hay không?
- Runtime có validation và authorization độc lập với Prompt hay không?
- Read Tools và Write Tools đã được phân loại theo rủi ro chưa?
- State có được lưu bằng cấu trúc thay vì chỉ nằm trong Message History không?
- Write Actions có idempotency và Audit Log hay không?
- Memory có nguồn, thời hạn và phạm vi truy cập hay không?
- Agent có Max Steps, Timeout, Token Budget và Tool Budget không?
- Hành động rủi ro có Human Approval tại đúng thời điểm không?
- Trace có đủ dữ liệu để tái hiện từng bước không?
- Evaluation Set có cả trường hợp bình thường và Failure Cases không?
Với người mới, cách học tốt nhất là xây một Agent chỉ có một mục tiêu và hai Read Tools. Hãy quan sát Model chọn Tool, tạo tham số, nhận kết quả và kết thúc nhiệm vụ. Sau đó mới thêm State Persistence, Write Tool, Approval, Memory và Evaluation. Mỗi lớp được thêm vào nên giải quyết một vấn đề đã quan sát được.
Kết luận
Một AI Agent không phải là một LLM biết gọi API. Nó là hệ thống phần mềm trong đó Model suy luận bên trong những giới hạn do Application kiểm soát. Instructions định hướng hành vi. Context cung cấp thông tin hiện tại. Tools tạo khả năng quan sát và hành động. State giữ tiến độ. Memory đưa thông tin quá khứ trở lại đúng lúc. Orchestration điều phối vòng lặp. Guardrails và Permissions giới hạn rủi ro. Observability cùng Evaluation giúp hệ thống có thể được cải tiến bằng dữ liệu.
Khi hiểu cấu tạo này, người học sẽ không còn đánh giá Agent chỉ bằng việc câu trả lời có thông minh hay không. Một Agent tốt phải chọn đúng hành động, dùng đúng dữ liệu, tuân thủ quyền, dừng đúng lúc, giải thích được kết quả và phục hồi an toàn khi một thành phần thất bại.
Ở bài tiếp theo, chúng ta sẽ đi sâu vào nền tảng LLM dành cho Agentic AI Engineer, gồm Token, Context Window, Embedding, Temperature, Structured Output và những giới hạn cần hiểu trước khi xây Tool Calling hay RAG.
Ghi nhớ khi triển khai cấu tạo AI Agent
Khi triển khai cấu tạo AI Agent, cần bắt đầu từ mục tiêu nghiệp vụ, dữ liệu được phép sử dụng và tiêu chí đánh giá. Kiến trúc chỉ nên tăng độ phức tạp khi kết quả kiểm thử chứng minh lợi ích rõ ràng.
Đọc thêm: nền tảng LLM cho Agentic AI Engineer và Tool Calling cho AI Agent.
Tài liệu tham khảo
- Anthropic. Building Effective Agents. Tài liệu phân biệt Workflow và Agent, đồng thời trình bày các pattern như prompt chaining, routing, parallelization, orchestrator-workers và evaluator-optimizer.
- Anthropic. Writing Effective Tools for AI Agents. Hướng dẫn thiết kế Tool, Tool Description, response format và phương pháp đánh giá khả năng sử dụng Tool.
- Google Cloud. What are AI agents?. Tổng quan về reasoning, planning, memory, tools và hoạt động của AI Agent.
- Google Cloud Architecture Center. Choose a design pattern for your agentic AI system. Tài liệu về kiến trúc Agent, Workflow, Multi-Agent và tiêu chí lựa chọn pattern.
- OpenAI Documentation. Function calling. Tài liệu kỹ thuật về Tool Calling, schema, vòng đời Tool Call và Structured Outputs.
- Model Context Protocol. Architecture overview. Tài liệu về kiến trúc Client, Host, Server và cách cung cấp Tools, Resources, Prompts cho ứng dụng AI.
- NIST. Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. Khung quản trị rủi ro dành cho hệ thống Generative AI.
TechData.AI - Leading The Future.
Hoàng Minh.
Comments are closed!