




Đơn vị biên soạn: TechData.AI
Chủ đề: Data Engineering và Event Streaming
Đối tượng: Data Engineer, Python Developer và Backend Developer
Phiên bản tham chiếu: Apache Kafka 4.x
MỤC LỤC
- Mục tiêu bài học
- Kafka Consumer hoạt động như thế nào
- Xây dựng Consumer đầu tiên bằng Python
- Consumer Group
- Partition Assignment và Rebalance
- Offset và vị trí đọc
- Auto Commit và Manual Commit
- At Most Once và At Least Once
- Thiết kế xử lý idempotent
- Consumer Lag
- Retry và Dead Letter Topic
- Graceful Shutdown
- Scale Consumer đúng cách
- Consumer hoàn chỉnh cho Order Service
- Kiểm thử và quan sát
- Lỗi thường gặp
- Tổng kết
- Câu hỏi ôn tập
- Tài liệu tham khảo
1. Mục tiêu bài học
Producer đưa Event vào Kafka, nhưng giá trị nghiệp vụ chỉ xuất hiện khi Consumer đọc và xử lý Event đúng cách. Consumer có thể cập nhật tồn kho, xác nhận thanh toán, ghi Data Warehouse hoặc kích hoạt một quy trình phía sau.
Một Consumer chạy được chưa chắc là Consumer đáng tin cậy. Nếu commit Offset quá sớm, hệ thống có thể mất dữ liệu. Nếu commit quá muộn hoặc xử lý không idempotent, dữ liệu có thể bị ghi trùng. Nếu xử lý một record quá lâu, Consumer có thể bị loại khỏi Group và gây Rebalance.
Bài này xây dựng Consumer Python cho Topic order-created, giải thích sâu Consumer Group, Offset, Rebalance, Consumer Lag, Retry và Dead Letter Topic.
2. Kafka Consumer hoạt động như thế nào
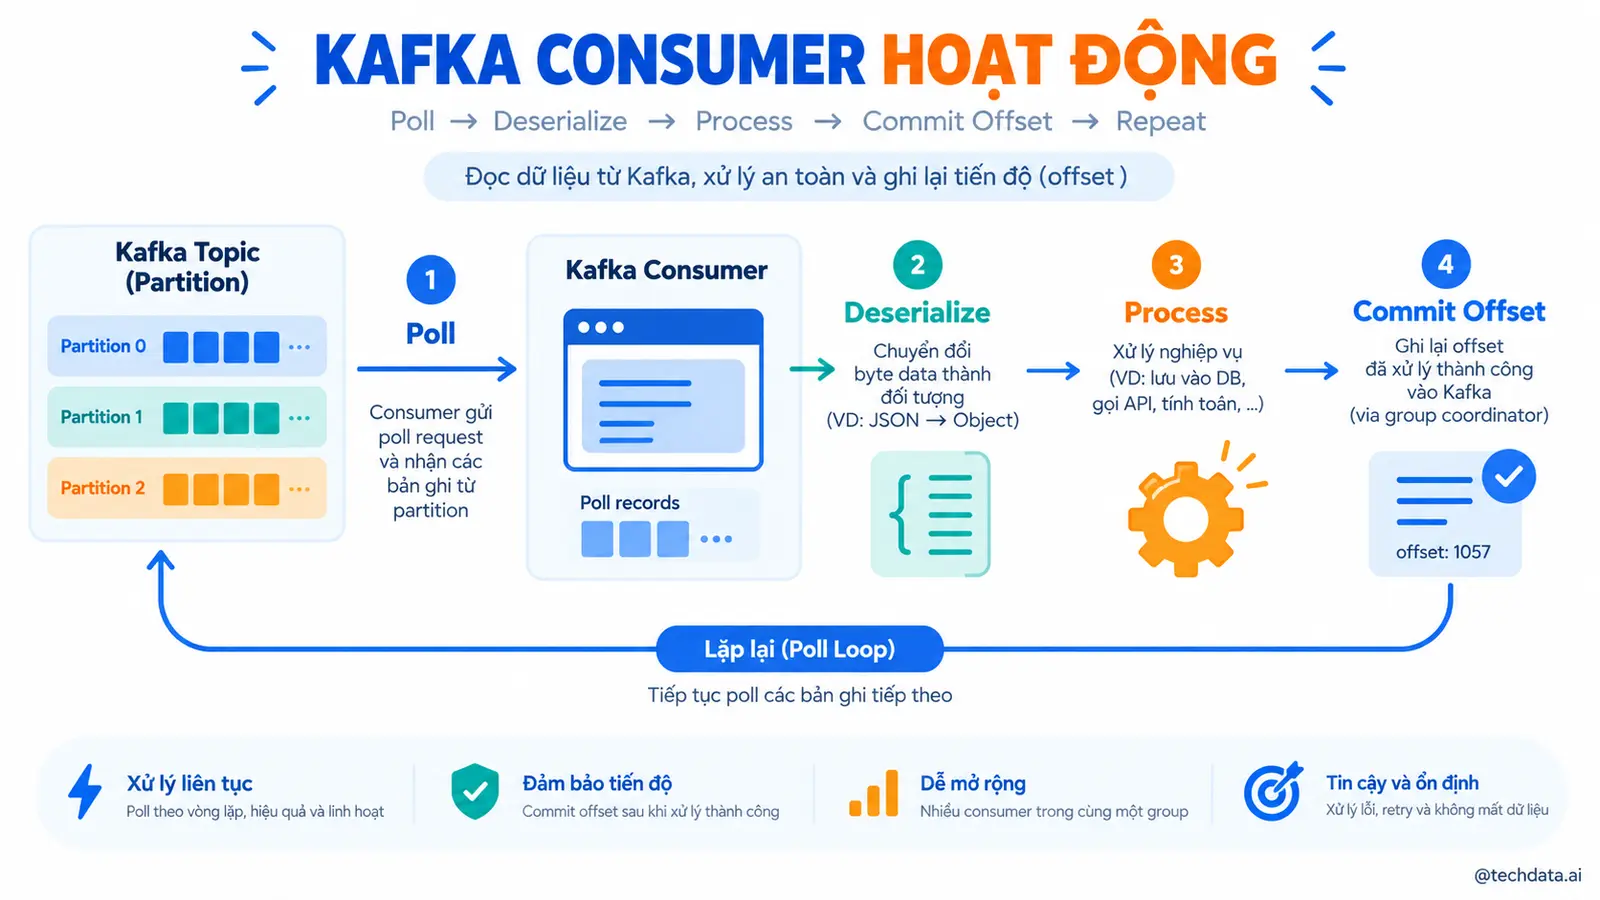
Consumer kết nối đến Kafka Cluster bằng danh sách bootstrap.servers. Sau khi lấy metadata, Consumer đăng ký Topic cần đọc và tham gia một Consumer Group.
Kafka phối hợp các thành viên trong Group và phân công Partition. Consumer gọi poll() để lấy record từ những Partition được giao. Sau khi xử lý, Consumer commit Offset để lưu vị trí đã hoàn thành.
Consumer chủ động kéo dữ liệu từ Broker. Cơ chế pull cho phép Consumer điều chỉnh tốc độ theo năng lực xử lý. Broker không cần đẩy record đến một Consumer đang quá tải.
Mỗi record Consumer nhận được có các thông tin:
- Topic.
- Partition.
- Offset.
- Timestamp.
- Key.
- Value.
- Headers.
Ba thông tin Topic, Partition và Offset tạo thành vị trí duy nhất của record trong Kafka.
3. Xây dựng Consumer đầu tiên bằng Python
Cài thư viện:
pip install confluent-kafkaTạo file consumer.py:
import json
from confluent_kafka import Consumer, KafkaError


config = {
    "bootstrap.servers": "localhost:9092",
    "group.id": "inventory-service",
    "auto.offset.reset": "earliest",
}

consumer = Consumer(config)
consumer.subscribe(["order-created"])

try:
    while True:
        message = consumer.poll(1.0)

        if message is None:
            continue

        if message.error():
            if message.error().code() == KafkaError._PARTITION_EOF:
                continue
            raise RuntimeError(message.error())

        event = json.loads(message.value().decode("utf-8"))
        print(
            event,
            message.topic(),
            message.partition(),
            message.offset(),
        )
finally:
    consumer.close()
group.id định danh Consumer Group. auto.offset.reset=earliest chỉ có tác dụng khi Group chưa có Offset hợp lệ. Nó không buộc Consumer đọc lại từ đầu mỗi khi khởi động.
poll() vừa nhận record vừa duy trì hoạt động của Consumer Group. Nếu ứng dụng không poll trong thời gian dài, Kafka có thể cho rằng Consumer không còn khỏe mạnh.
4. Consumer Group
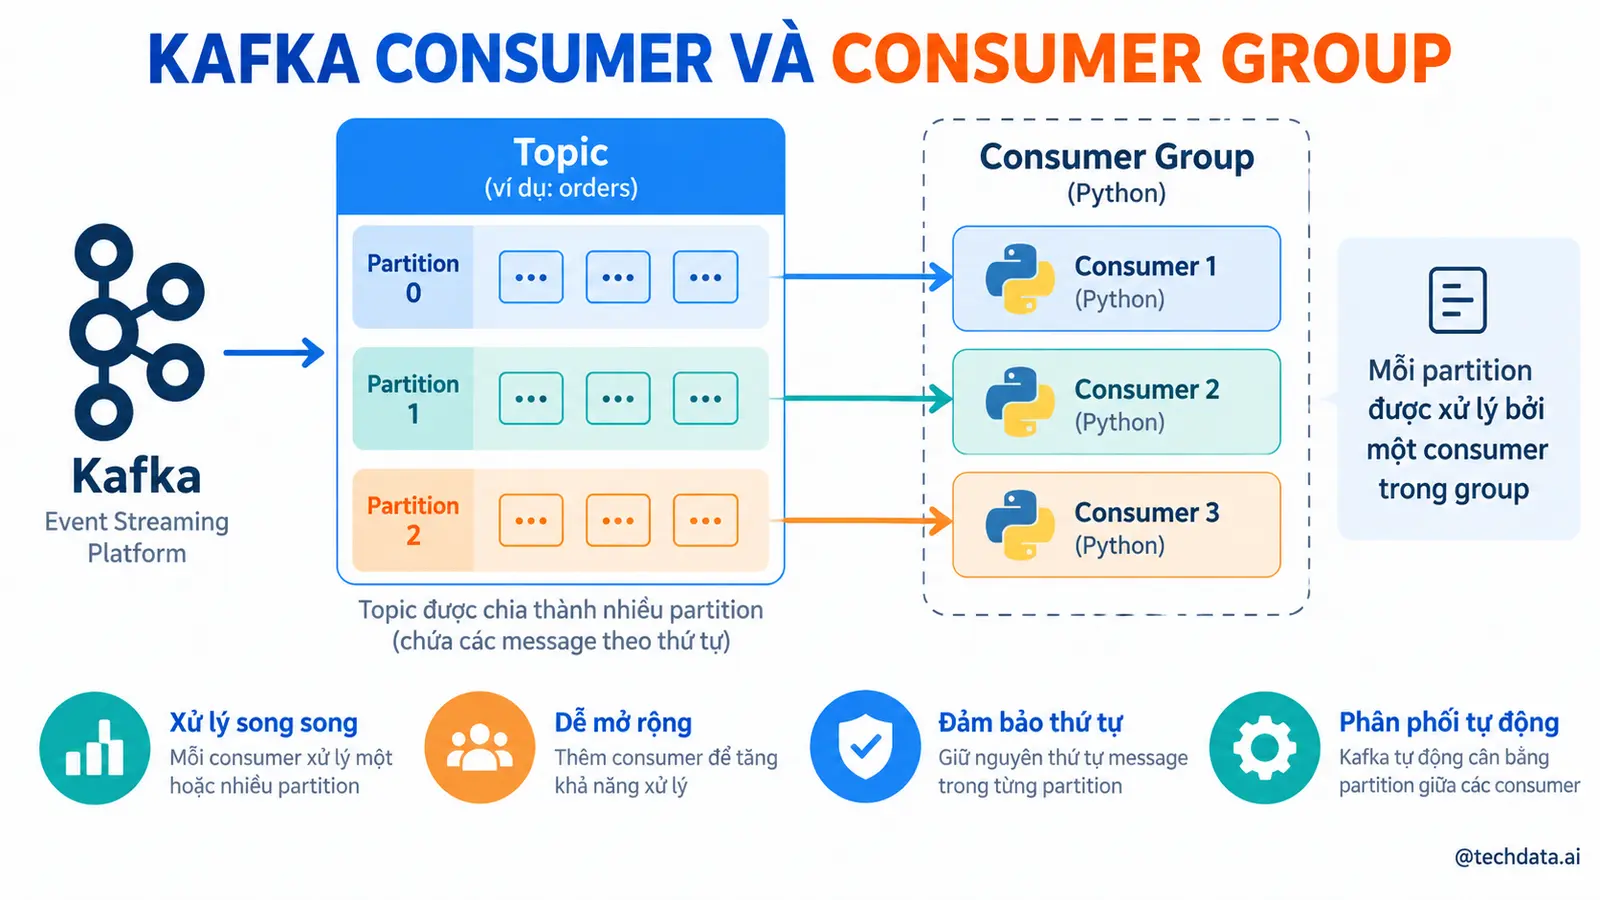
Consumer Group giúp nhiều Consumer phối hợp xử lý một Topic.
Giả sử Topic có bốn Partition và Group inventory-service có hai Consumer. Mỗi Consumer có thể được giao hai Partition. Khi thêm Consumer thứ ba, Kafka phân phối lại Partition để tải được chia giữa ba tiến trình.
Một Partition chỉ được giao cho một Consumer trong cùng Group tại một thời điểm. Quy tắc này giúp tránh hai Consumer cùng xử lý một record trong điều kiện bình thường.
Nếu Group có sáu Consumer nhưng Topic chỉ có bốn Partition, tối đa bốn Consumer nhận việc. Hai Consumer còn lại không có Partition.
Các Group khác nhau đọc Topic độc lập. inventory-service và shipping-service có thể cùng đọc order-created nhưng duy trì Offset riêng. Inventory đọc xong không làm Shipping mất dữ liệu.
Tên Group cần ổn định. Nếu mỗi lần deploy lại sinh một Group ID ngẫu nhiên, ứng dụng có thể đọc lại toàn bộ dữ liệu hoặc bỏ qua lịch sử tùy auto.offset.reset.
5. Partition Assignment và Rebalance
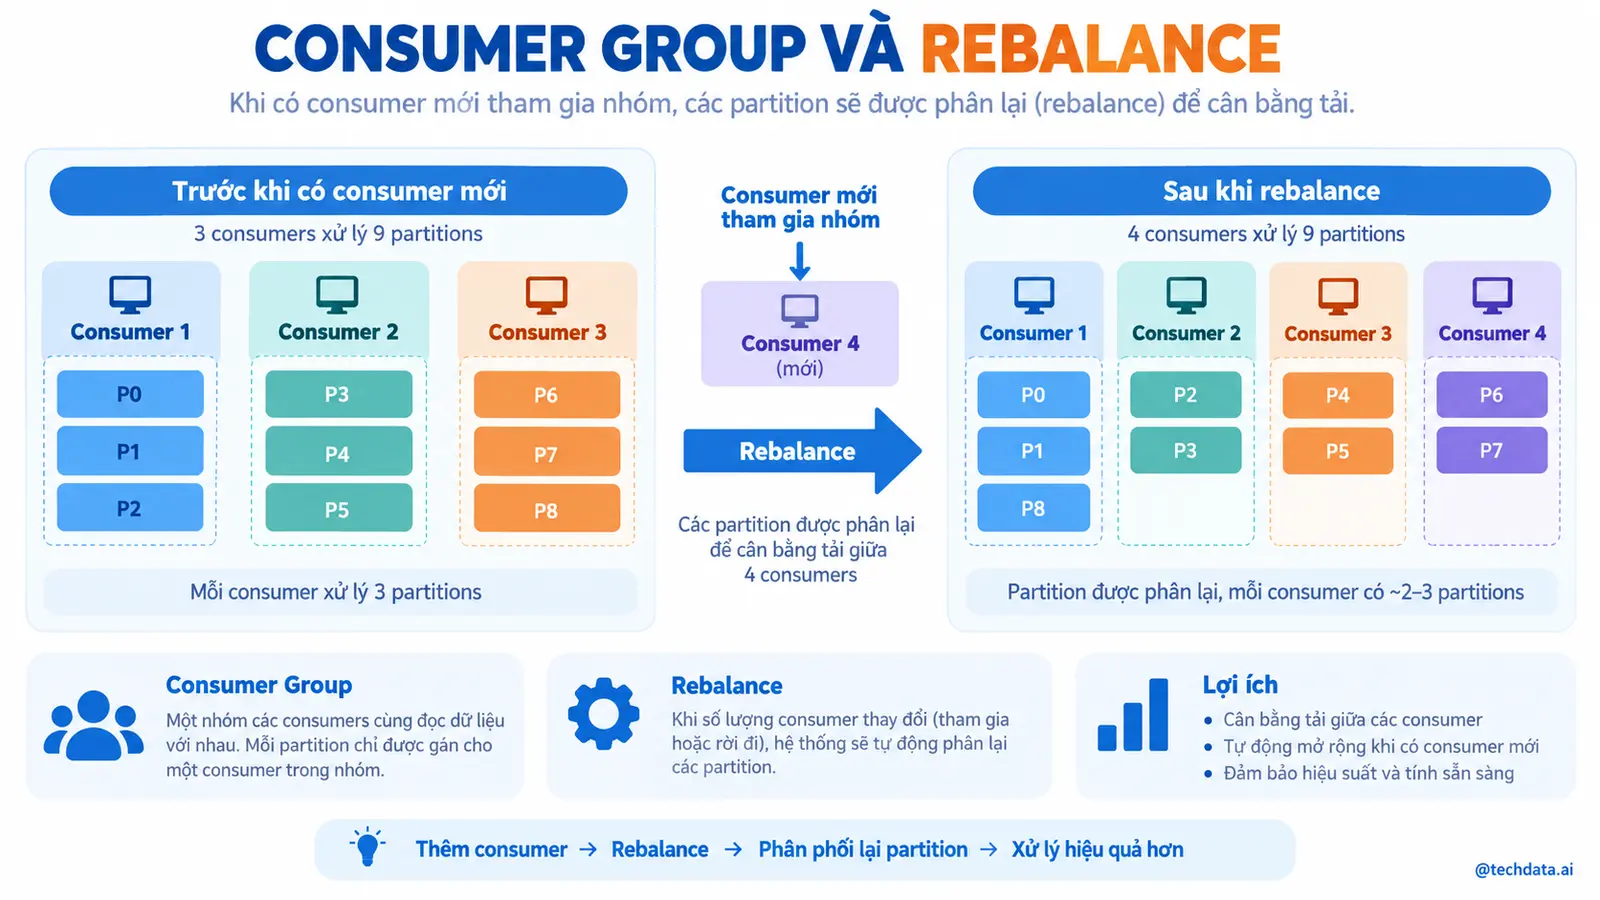
Rebalance xảy ra khi Kafka cần phân phối lại Partition trong Consumer Group. Một số nguyên nhân:
- Consumer mới tham gia.
- Consumer dừng hoặc mất kết nối.
- Số Partition của Topic thay đổi.
- Subscription của Group thay đổi.
- Consumer không poll trong giới hạn cho phép.
Trong Rebalance, Consumer có thể tạm dừng xử lý. Rebalance quá thường xuyên làm tăng độ trễ và giảm throughput.
Consumer cần xử lý sự kiện revoke Partition để hoàn tất công việc và commit Offset phù hợp. Nếu một record đang xử lý dở nhưng Partition chuyển cho Consumer khác, dữ liệu có thể được xử lý lại.
Các chiến lược assignment có cách phân phối khác nhau. Range Assignor phân chia theo từng Topic. Round Robin phân phối tuần tự giữa Consumer. Sticky Assignor cố gắng giữ assignment cũ để giảm lượng Partition bị di chuyển. Cooperative Sticky cho phép Rebalance tăng dần thay vì thu hồi toàn bộ assignment cùng lúc.
Không nên chọn Assignor chỉ theo tên gọi. Hãy quan sát số Topic, số Partition, thời gian Rebalance và mô hình deploy thực tế.
6. Offset và vị trí đọc
Offset là số thứ tự tăng dần của record trong một Partition. Consumer sử dụng Offset đã commit để biết vị trí tiếp tục sau khi khởi động lại.
Cần phân biệt ba khái niệm:
- Current Position là vị trí Consumer chuẩn bị đọc.
- Committed Offset là vị trí đã lưu cho Consumer Group.
- Log End Offset là Offset cuối của Partition tại Broker.
Nếu Consumer đã xử lý record Offset 100, giá trị commit thường biểu thị vị trí tiếp theo là 101.
Offset của Consumer Group được Kafka lưu trong Topic nội bộ __consumer_offsets. Data Engineer không nên sửa Topic này bằng cách thông thường.
Kafka cho phép reset Offset theo thời điểm, Offset cụ thể, vị trí sớm nhất hoặc mới nhất. Đây là thao tác mạnh. Trước khi reset Production, cần dừng Consumer Group, xác định phạm vi record bị đọc lại và bảo đảm hệ thống đích chịu được dữ liệu lặp.
7. Auto Commit và Manual Commit
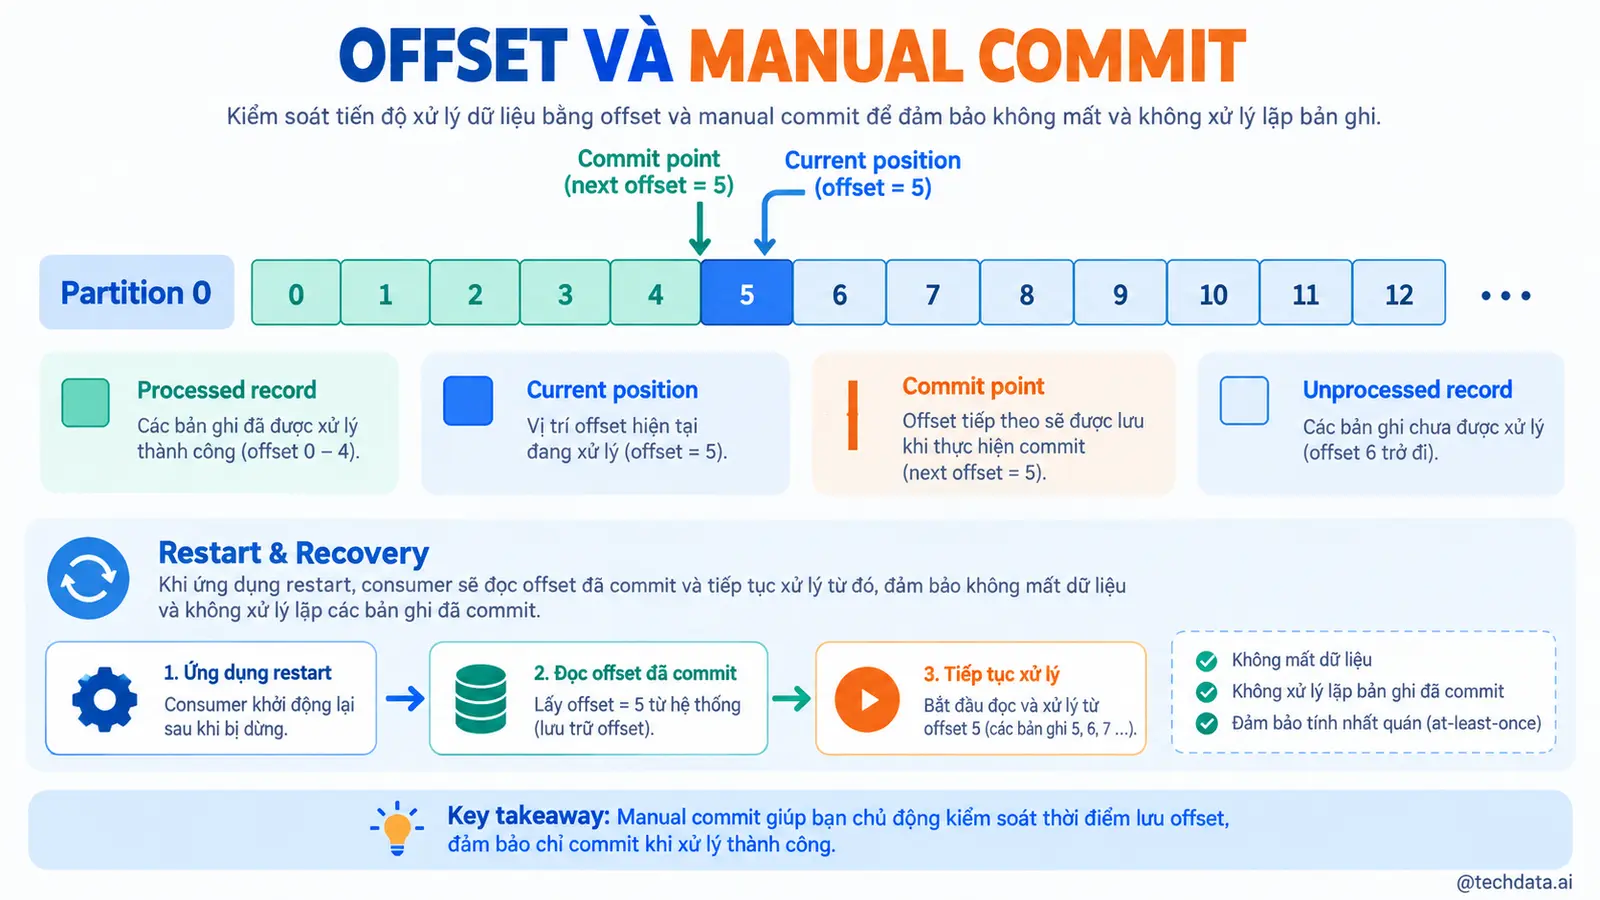
Auto Commit tiện lợi nhưng dễ tạo hiểu nhầm. Khi enable.auto.commit=true, Client commit vị trí định kỳ. Việc commit không chứng minh logic nghiệp vụ đã hoàn tất.
Nếu record được trả về từ poll(), Auto Commit có thể lưu Offset trong chu kỳ tiếp theo dù ứng dụng chưa cập nhật database thành công. Khi tiến trình hỏng, record có nguy cơ bị bỏ qua.
Manual Commit cho phép ứng dụng commit sau khi xử lý:
config = {
    "bootstrap.servers": "localhost:9092",
    "group.id": "inventory-service",
    "auto.offset.reset": "earliest",
    "enable.auto.commit": False,
}
Sau khi nghiệp vụ thành công:
process_order(event)
consumer.commit(message=message, asynchronous=False)
Synchronous Commit chờ Broker xác nhận, đơn giản nhưng tăng độ trễ. Asynchronous Commit nhanh hơn nhưng cần xử lý callback và thứ tự commit cẩn thận.
Commit từng record tạo nhiều request. Hệ thống throughput cao có thể commit theo batch, nhưng khi lỗi sẽ đọc lại một phần batch. Đây là đánh đổi giữa hiệu suất và lượng dữ liệu phải xử lý lại.
8. At Most Once và At Least Once
Thứ tự giữa xử lý và commit tạo nên Delivery Semantics.
At Most Once
Consumer commit trước rồi mới xử lý. Nếu ứng dụng hỏng sau commit nhưng trước khi hoàn tất nghiệp vụ, record không được đọc lại. Dữ liệu có thể mất nhưng không bị xử lý lặp do lỗi đó.
At Least Once
Consumer xử lý trước rồi commit. Nếu ứng dụng hoàn tất nghiệp vụ nhưng hỏng trước commit, record được đọc lại. Dữ liệu không dễ mất nhưng có thể bị xử lý trùng.
At Least Once thường được chọn cho dữ liệu nghiệp vụ, kết hợp với Consumer idempotent.
Exactly Once trên toàn hệ thống phức tạp hơn nhiều. Kafka Transaction có thể bảo đảm tính nguyên tử cho pipeline đọc từ Kafka, xử lý và ghi lại Kafka. Nếu Consumer ghi vào database bên ngoài, cần thêm cơ chế của hệ thống đích.
9. Thiết kế xử lý idempotent
Idempotent nghĩa là xử lý cùng một Event nhiều lần vẫn tạo ra kết quả cuối giống như xử lý một lần.
Ví dụ, Consumer nhận Event trừ tồn kho. Nếu chỉ chạy câu lệnh giảm số lượng, record lặp sẽ làm tồn kho giảm hai lần.
Có thể tạo bảng lưu Event đã xử lý:
CREATE TABLE processed_events (
    consumer_name VARCHAR(100) NOT NULL,
    event_id VARCHAR(100) NOT NULL,
    processed_at TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP,
    PRIMARY KEY (consumer_name, event_id)
);
Trong cùng transaction database:
- Kiểm tra hoặc chèn
event_id. - Cập nhật nghiệp vụ.
- Commit transaction.
Nếu event_id đã tồn tại, Consumer bỏ qua nghiệp vụ nhưng vẫn có thể commit Kafka Offset.
Một cách khác là dùng Upsert theo Business Key. Ví dụ, bảng trạng thái đơn hàng cập nhật theo order_id và event_version, chỉ nhận phiên bản mới hơn.
Không nên sử dụng riêng Topic, Partition và Offset làm Event ID nếu Event có thể được phát lại sang Topic khác. event_id thuộc Event Envelope linh hoạt hơn.
10. Consumer Lag
Consumer Lag là khoảng cách giữa Log End Offset và Committed Offset của Consumer Group.
Ví dụ, Partition có Log End Offset 10.000 và Group đã commit đến 9.200. Lag xấp xỉ 800 record.
Lag tăng có thể do:
- Producer tạo dữ liệu nhanh hơn Consumer xử lý.
- Hệ thống đích chậm.
- Consumer gặp lỗi hoặc đã dừng.
- Một Partition nhận quá nhiều dữ liệu.
- Số Consumer chưa đủ.
- Record có một nhóm xử lý đặc biệt lâu.
Lag bằng 0 không luôn đồng nghĩa hệ thống khỏe. Nếu Producer không gửi được Event vào Kafka, Consumer vẫn có Lag bằng 0. Cần giám sát cả Producer Rate, Error Rate, Lag, Processing Latency và kết quả nghiệp vụ.
Kiểm tra Group bằng CLI:
docker exec kafka /opt/kafka/bin/kafka-consumer-groups.sh \
  --bootstrap-server localhost:9092 \
  --describe \
  --group inventory-service
Không chỉ cảnh báo theo số record. Một Lag 10.000 record có thể xử lý trong vài giây hoặc vài giờ tùy tốc độ Consumer. Nên theo dõi cả tuổi của Event chưa xử lý.
11. Retry và Dead Letter Topic
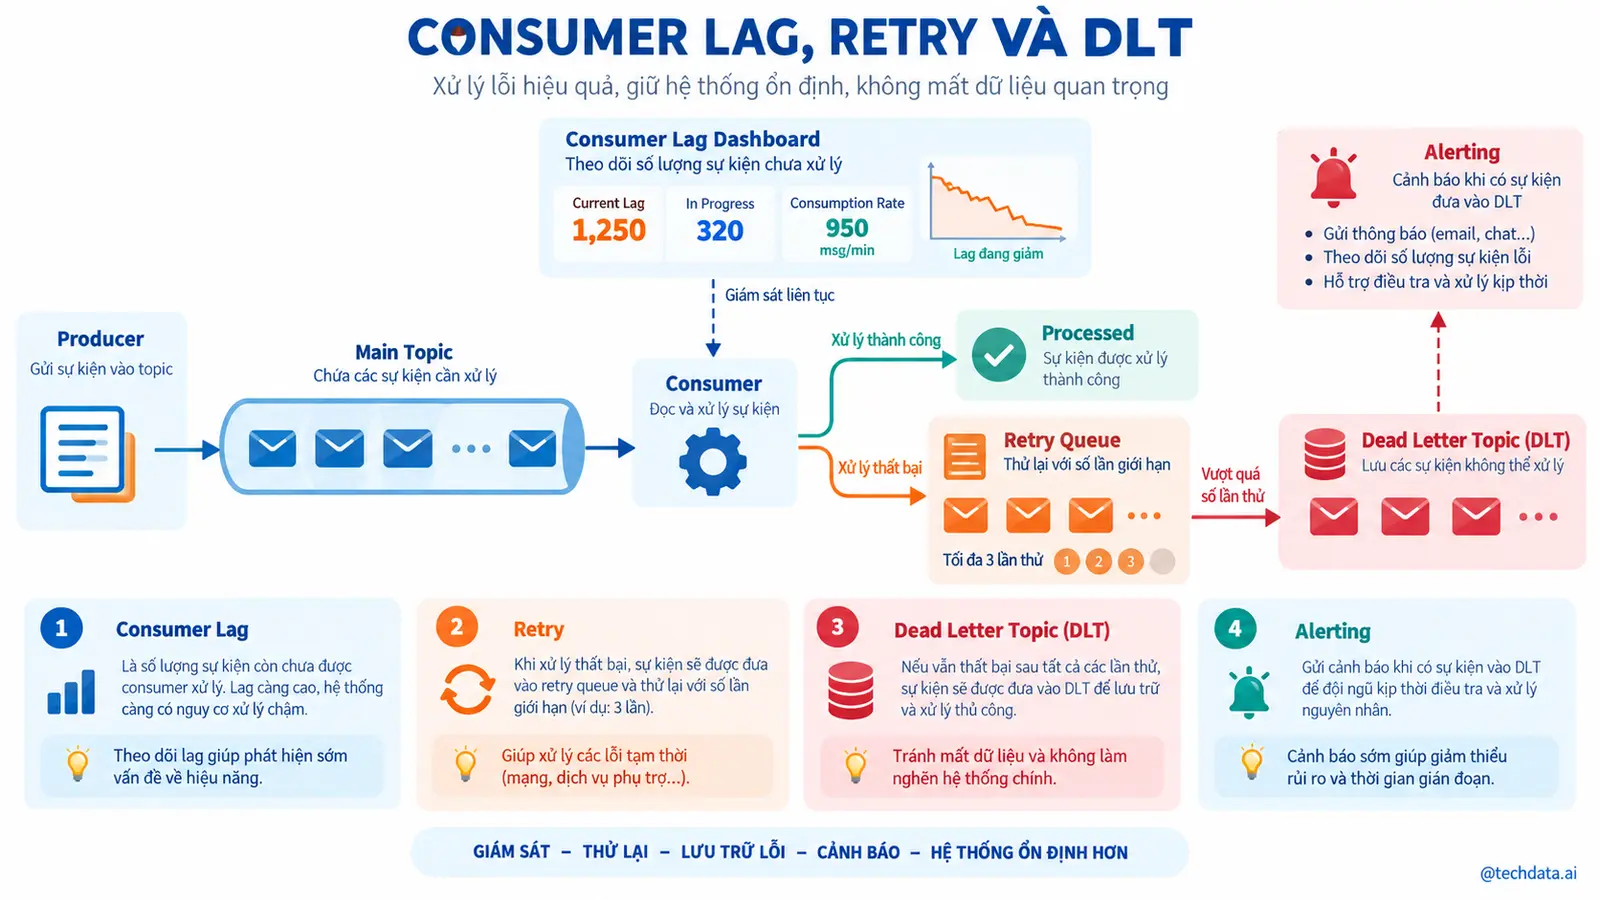
Không phải lỗi nào cũng nên retry giống nhau.
Lỗi tạm thời gồm timeout database, API tạm thời không phản hồi hoặc network gián đoạn. Những lỗi này có thể retry với Exponential Backoff và Jitter.
Lỗi vĩnh viễn gồm JSON sai, thiếu field bắt buộc, giá trị nghiệp vụ không hợp lệ hoặc schema không hỗ trợ. Retry liên tục không giải quyết được và có thể chặn cả Partition.
Dead Letter Topic lưu những Event không thể xử lý sau số lần retry cho phép. Ví dụ:
order-created.dltRecord trong DLT nên giữ:
- Payload gốc.
- Key gốc.
- Topic, Partition và Offset gốc.
- Event ID.
- Tên Consumer.
- Loại lỗi và thông báo lỗi.
- Số lần thử.
- Thời điểm thất bại.
DLT không phải thùng rác. Doanh nghiệp cần Dashboard, cảnh báo, người chịu trách nhiệm và quy trình sửa rồi replay dữ liệu.
Retry trực tiếp trong vòng lặp có thể chặn Partition. Với thời gian chờ dài, nên sử dụng Retry Topic theo cấp độ, chẳng hạn retry sau một phút, năm phút và ba mươi phút.
12. Graceful Shutdown
Khi deploy phiên bản mới, nền tảng gửi tín hiệu dừng tiến trình. Consumer nên ngừng nhận record mới, hoàn thành record đang xử lý, commit Offset cần thiết và rời Group sạch sẽ.
import signal


running = True


def stop_consumer(signum, frame):
    global running
    running = False


signal.signal(signal.SIGTERM, stop_consumer)
signal.signal(signal.SIGINT, stop_consumer)
Vòng lặp kiểm tra running và gọi consumer.close() trong finally. close() gửi Leave Group, giúp Kafka phân công lại Partition nhanh hơn thay vì chờ Session Timeout.
13. Scale Consumer đúng cách
Tăng số Consumer chỉ có tác dụng đến giới hạn số Partition. Trước khi scale, cần xác định bottleneck.
Nếu CPU xử lý cao, thêm Consumer và Partition có thể giúp. Nếu database đích đã quá tải, thêm Consumer chỉ làm database chậm hơn. Nếu một Key chiếm phần lớn dữ liệu, cần giải quyết Hot Partition thay vì tăng toàn bộ Group.
Cần đo:
- Record xử lý mỗi giây.
- Thời gian xử lý trung bình và phân vị cao.
- Lag theo từng Partition.
- Tỷ lệ lỗi và retry.
- Số lần Rebalance.
- Mức sử dụng CPU, RAM và connection pool.
Không tăng Partition một cách tùy tiện nếu Key Ordering quan trọng. Khi số Partition thay đổi, cùng một Key có thể được ánh xạ sang Partition khác đối với record mới.
14. Consumer hoàn chỉnh cho Order Service
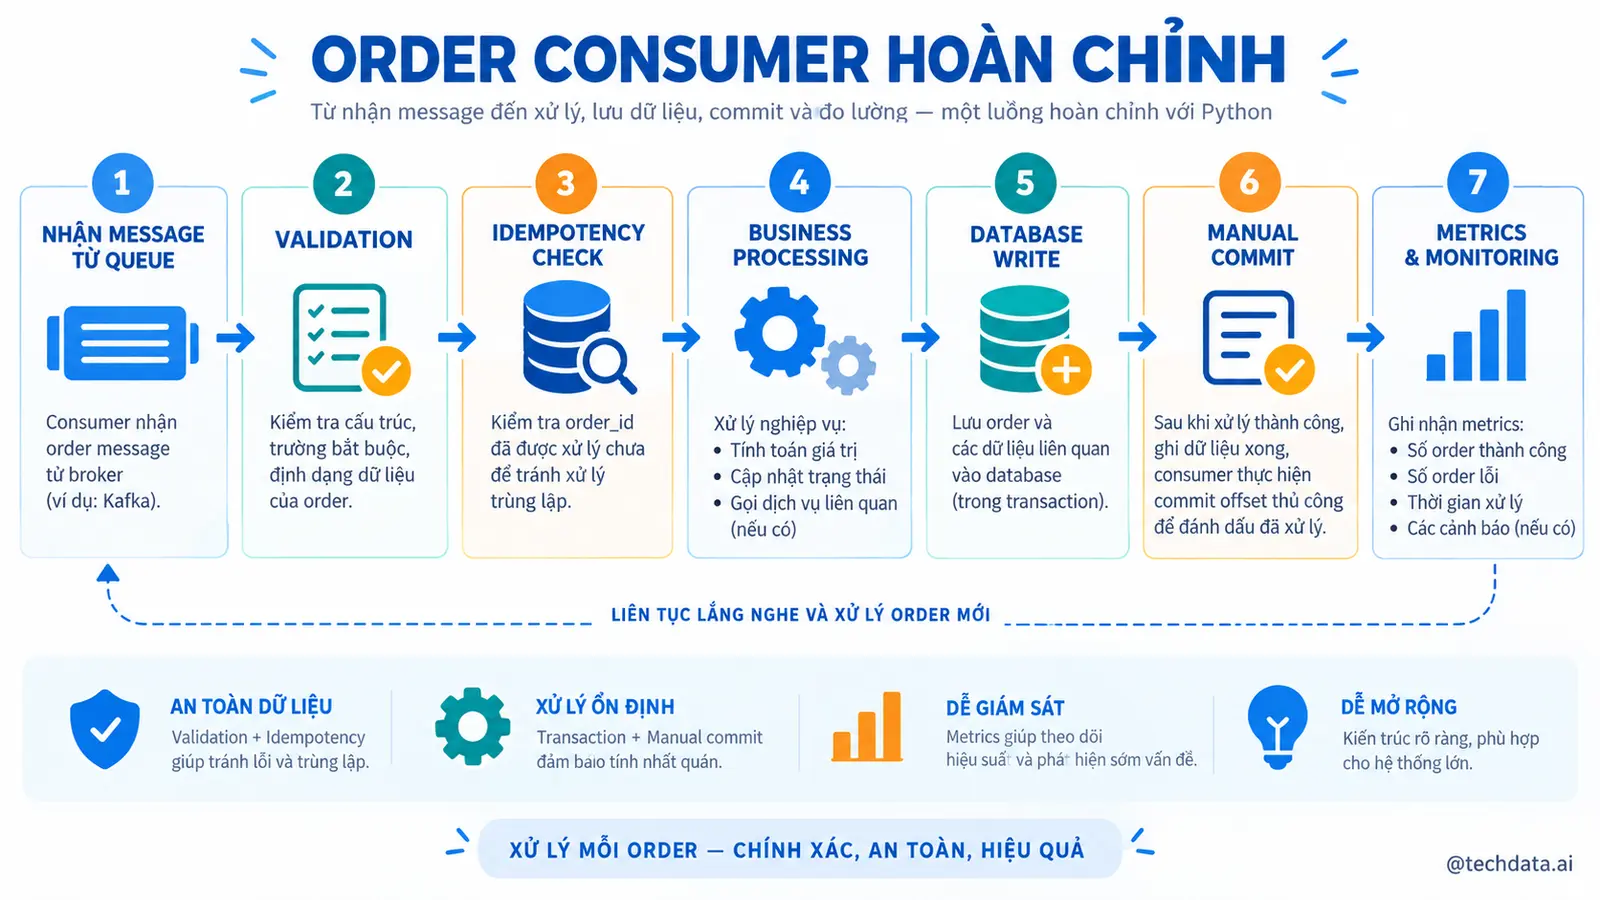
import json
import signal
from confluent_kafka import Consumer, KafkaException


class InventoryConsumer:
    def __init__(self, config: dict, topic: str):
        self.consumer = Consumer(config)
        self.consumer.subscribe([topic])
        self.running = True

    def stop(self, signum=None, frame=None):
        self.running = False

    def process(self, event: dict) -> None:
        event_id = event["event_id"]
        order_id = event["data"]["order_id"]

        if event_already_processed("inventory-service", event_id):
            return

        reserve_inventory_and_mark_processed(
            consumer_name="inventory-service",
            event_id=event_id,
            order_id=order_id,
        )

    def run(self) -> None:
        try:
            while self.running:
                message = self.consumer.poll(1.0)
                if message is None:
                    continue
                if message.error():
                    raise KafkaException(message.error())

                try:
                    event = json.loads(message.value())
                    self.process(event)
                    self.consumer.commit(
                        message=message,
                        asynchronous=False,
                    )
                except PermanentBusinessError as exc:
                    publish_to_dlt(message, exc)
                    self.consumer.commit(
                        message=message,
                        asynchronous=False,
                    )
        finally:
            self.consumer.close()
Các hàm database và DLT được tách riêng để code dễ kiểm thử. Production cần bổ sung retry có giới hạn, logging có cấu trúc, metrics và tracing.
15. Kiểm thử và quan sát
Unit test cần kiểm tra:
- Deserialization.
- Validation Event.
- Idempotency.
- Phân loại lỗi tạm thời và vĩnh viễn.
- Payload gửi vào DLT.
Integration test cần khởi động Kafka và database thật trong container, sau đó kiểm tra:
- Consumer xử lý Event thành công.
- Offset chỉ commit sau khi database commit.
- Event lặp không làm lặp nghiệp vụ.
- Consumer khởi động lại đúng vị trí.
- Poison Message được đưa vào DLT.
Log nên chứa Event ID, Topic, Partition, Offset, Group ID, thời gian xử lý và trạng thái. Đây là dữ liệu cần thiết khi truy vết một đơn hàng qua nhiều dịch vụ.
16. Lỗi thường gặp
Nhầm auto.offset.reset với vị trí đọc cố định
earliest chỉ dùng khi Group không có Offset hợp lệ. Nó không reset Group về đầu mỗi lần chạy.
Commit trước khi xử lý
Nếu ứng dụng hỏng sau commit, Event có thể bị bỏ qua.
Không thiết kế idempotent
At Least Once tạo khả năng xử lý lặp. Không có idempotency, tồn kho hoặc thanh toán có thể sai.
Xử lý quá lâu trong poll loop
Consumer có thể vượt max.poll.interval.ms và bị loại khỏi Group.
Retry vô hạn
Một Poison Message chặn toàn bộ record phía sau trong Partition.
Chỉ nhìn tổng Lag
Tổng Lag có thể che giấu một Partition bị nóng. Cần quan sát Lag theo Partition.
17. Tổng kết
Consumer là nơi Event được chuyển thành hành động nghiệp vụ. Thiết kế Consumer tốt cần quản lý đồng thời Group, Offset, Rebalance, lỗi và tính idempotent.
Các điểm cần ghi nhớ:
- Mỗi Partition chỉ được một Consumer trong cùng Group xử lý tại một thời điểm.
- Nhiều Group có thể đọc cùng một Topic độc lập.
- Offset thể hiện vị trí tiếp tục của Group.
- Commit sau xử lý tạo At Least Once và khả năng record bị xử lý lại.
- Consumer idempotent là yêu cầu thực tế, không phải tùy chọn trang trí.
- Consumer Lag cần được theo dõi theo Partition và thời gian.
- DLT cần quy trình xử lý và replay rõ ràng.
- Graceful Shutdown giúp giảm Rebalance và tránh bỏ dở công việc.
Bài tiếp theo sẽ đi sâu vào Topic, Partition, Replication, Leader, Follower, ISR và cách tính số Partition phù hợp.
18. Câu hỏi ôn tập
- Vì sao số Consumer hữu ích không vượt quá số Partition?
- Consumer Group khác nhau có dùng chung Offset không?
- Khi nào Rebalance xảy ra?
- Auto Commit có bảo đảm nghiệp vụ đã hoàn thành không?
- At Least Once tạo ra rủi ro gì?
- Làm thế nào để Consumer xử lý idempotent?
- Consumer Lag được tính như thế nào?
- Khi nào Event nên được đưa vào Dead Letter Topic?
19. Tài liệu tham khảo
- Apache Kafka Consumer Configurations: https://kafka.apache.org/documentation/#consumerconfigs
- Apache Kafka Consumer Group Protocol: https://kafka.apache.org/documentation/#consumerconfigs_group.protocol
- Apache Kafka Design: https://kafka.apache.org/documentation/#design
- Apache Kafka Consumer Group Operations: https://kafka.apache.org/documentation/#basic_ops_consumer_group
- Confluent Kafka Python Consumer: https://docs.confluent.io/kafka-clients/python/current/overview.html