




Đơn vị biên soạn: TechData.AI
Chủ đề: Kafka Connect, Debezium và Change Data Capture
Đối tượng: Data Engineer, Database Engineer và Platform Engineer
Phiên bản tham chiếu: Apache Kafka 4.x và Debezium Stable
MỤC LỤC
- Mục tiêu bài
- Vì sao cần Change Data Capture
- Kafka Connect là gì
- Source Connector, Sink Connector và Task
- Standalone và Distributed Mode
- Debezium đọc MySQL Binlog như thế nào
- Kiến trúc pipeline thực hành
- Chuẩn bị MySQL cho CDC
- Cài Kafka Connect và Debezium
- Đăng ký MySQL Source Connector
- Snapshot ban đầu
- Cấu trúc CDC Event
- Insert, Update và Delete
- Schema History và Offset
- Single Message Transform
- Đưa dữ liệu đến BigQuery hoặc Data Warehouse
- Monitoring và xử lý lỗi
- DDL, schema change và vận hành
- Những lỗi thường gặp
- Tổng kết
- Câu hỏi ôn tập
- Tài liệu tham khảo
1. Mục tiêu bài
Nhiều doanh nghiệp có dữ liệu vận hành nằm trong MySQL, PostgreSQL hoặc SQL Server. Data Engineer thường cần đồng bộ thay đổi từ các hệ thống này sang Kafka, Data Lake, Search Engine và Data Warehouse.
Cách đơn giản là chạy truy vấn định kỳ theo cột updated_at. Tuy nhiên, phương pháp này có thể bỏ sót bản ghi, khó nhận biết thao tác xóa, tạo tải truy vấn lớn và tăng độ trễ.
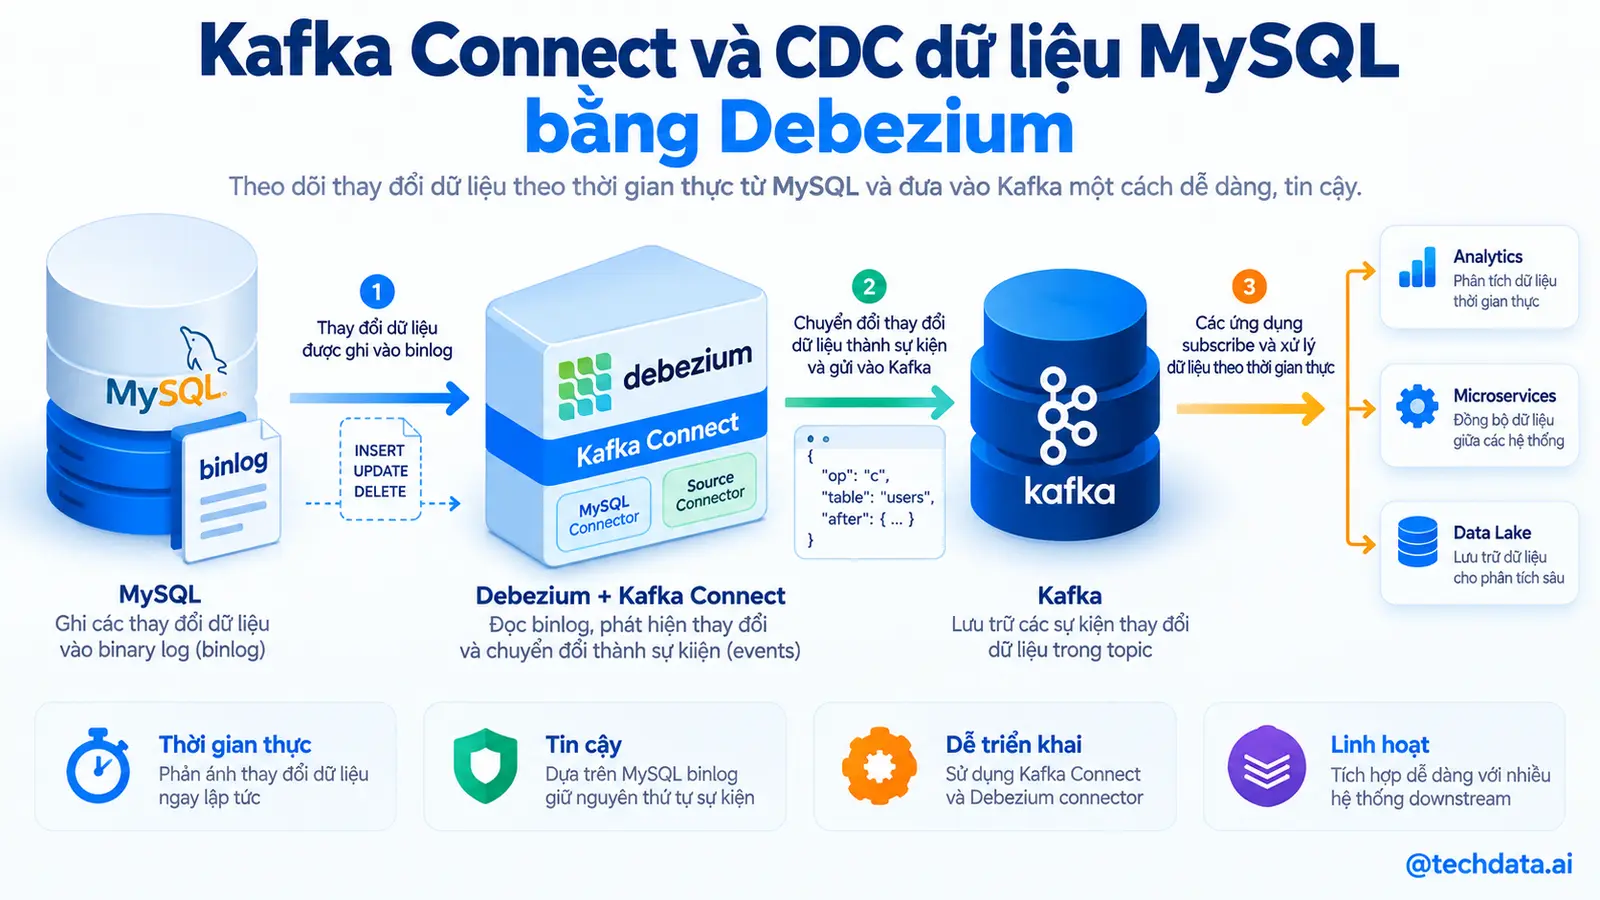
Change Data Capture, viết tắt là CDC, đọc thay đổi từ transaction log của database. Bài này sử dụng Debezium và Kafka Connect để đưa Insert, Update và Delete từ MySQL vào Kafka.
2. Vì sao cần Change Data Capture
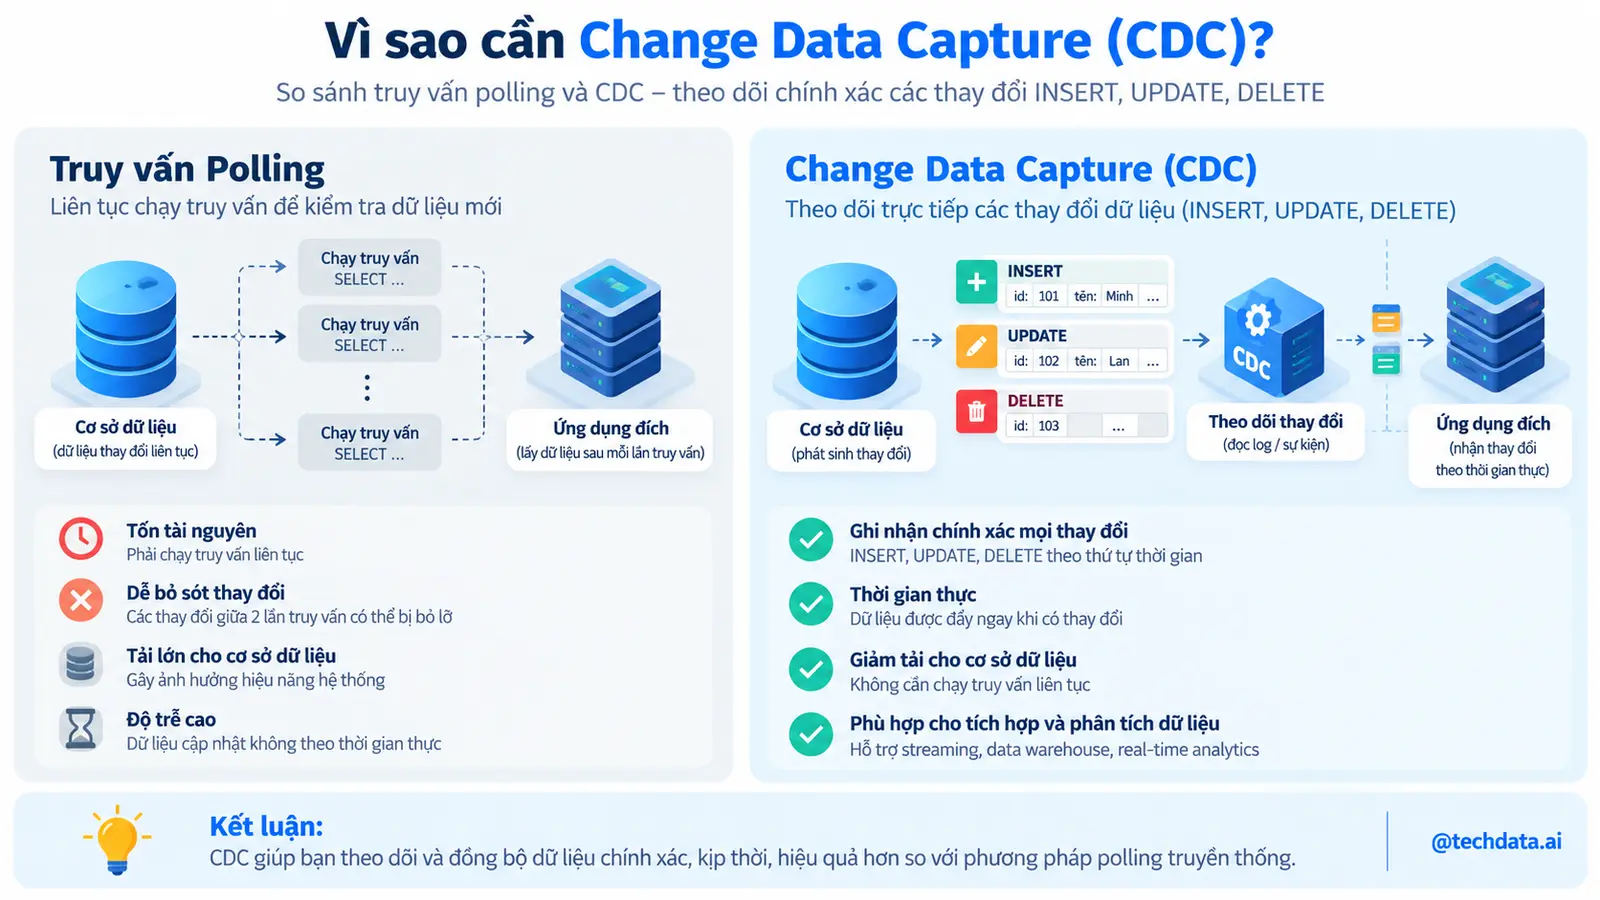
Giả sử bảng orders có hàng chục triệu bản ghi. Pipeline chạy mỗi phút để tìm dữ liệu mới:
SELECT *
FROM orders
WHERE updated_at > :last_watermark;
Cách này có nhiều vấn đề:
- Hai record có cùng timestamp có thể tạo ranh giới khó xử lý.
- Clock và timezone có thể không thống nhất.
- Hard Delete không còn record để truy vấn.
- Truy vấn lặp gây tải lên database nguồn.
- Schema change có thể làm pipeline lỗi.
- Watermark lưu sai dẫn đến mất hoặc lặp dữ liệu.
CDC đọc transaction log mà database vốn đã tạo cho replication và recovery. Mỗi thay đổi được chuyển thành Event gần thời gian thực mà không cần quét lại toàn bảng.
CDC không miễn phí. Doanh nghiệp phải quản lý quyền database, log retention, snapshot, schema evolution, offset và khả năng connector bị chậm.
3. Kafka Connect là gì
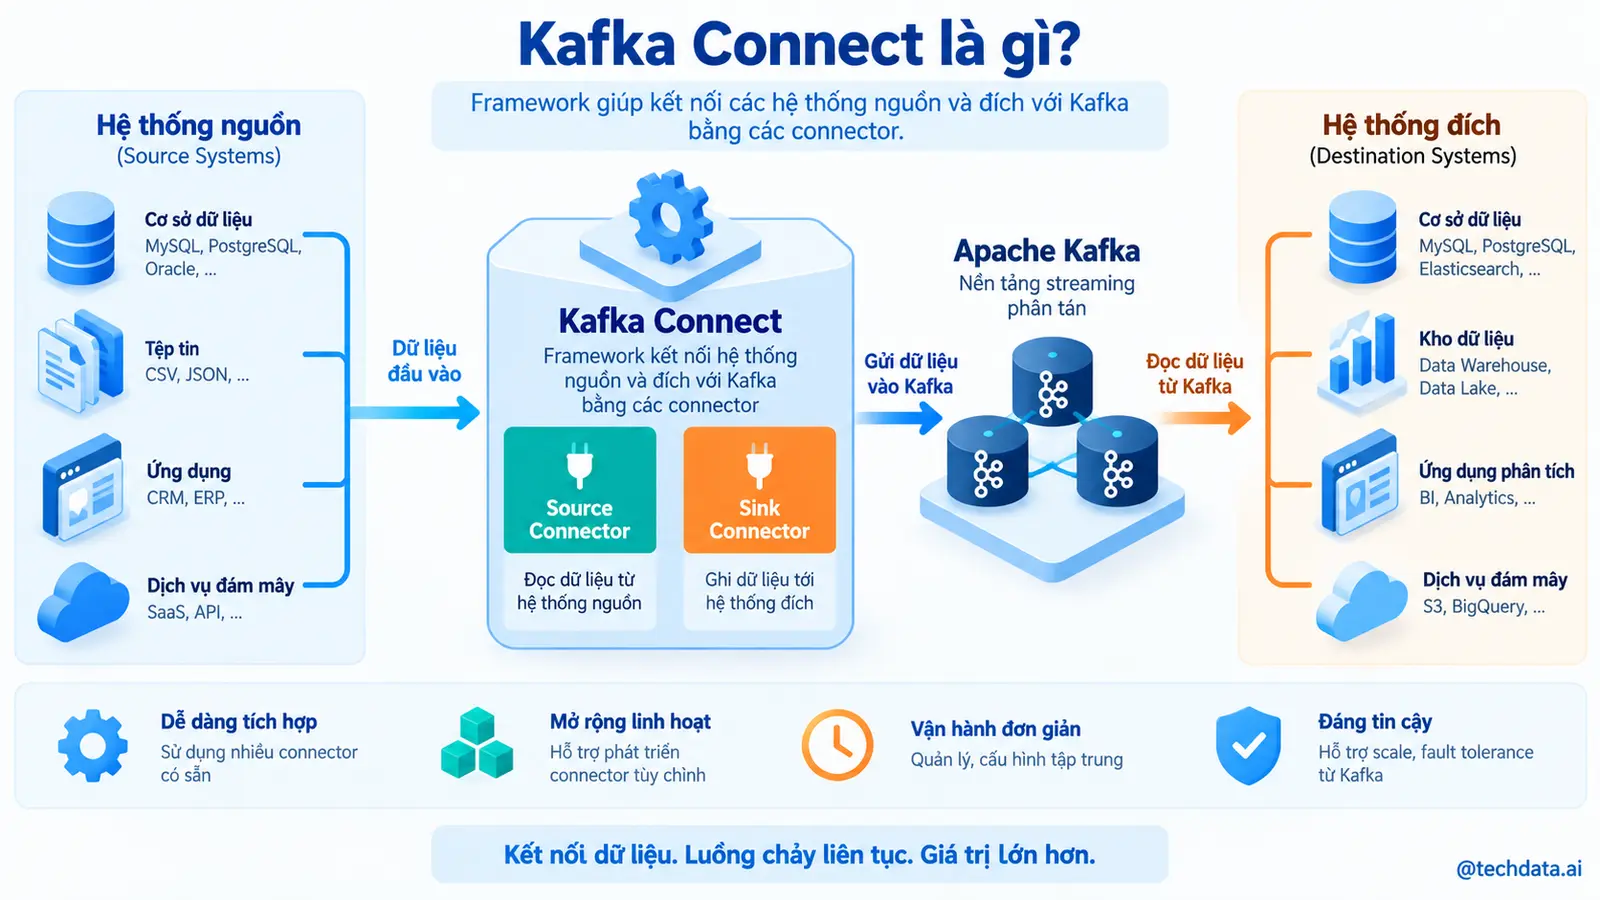
Kafka Connect là framework thuộc hệ sinh thái Apache Kafka, dùng để truyền dữ liệu giữa Kafka và hệ thống bên ngoài bằng Connector có thể cấu hình.
Thay vì tự viết chương trình đọc database, quản lý retry, Offset, scale worker và expose REST API, Data Engineer cài Connector phù hợp rồi cung cấp cấu hình.
Kafka Connect cung cấp:
- Worker Runtime.
- REST API quản trị Connector.
- Cơ chế lưu Offset.
- Quản lý cấu hình và trạng thái.
- Chia công việc thành Task.
- Converter cho Key và Value.
- Single Message Transform.
- Retry và Dead Letter Queue.
Connector vẫn cần vận hành như một hệ thống Production. Không nên xem Connect là công cụ tự chạy mà không cần monitoring.
4. Source Connector, Sink Connector và Task
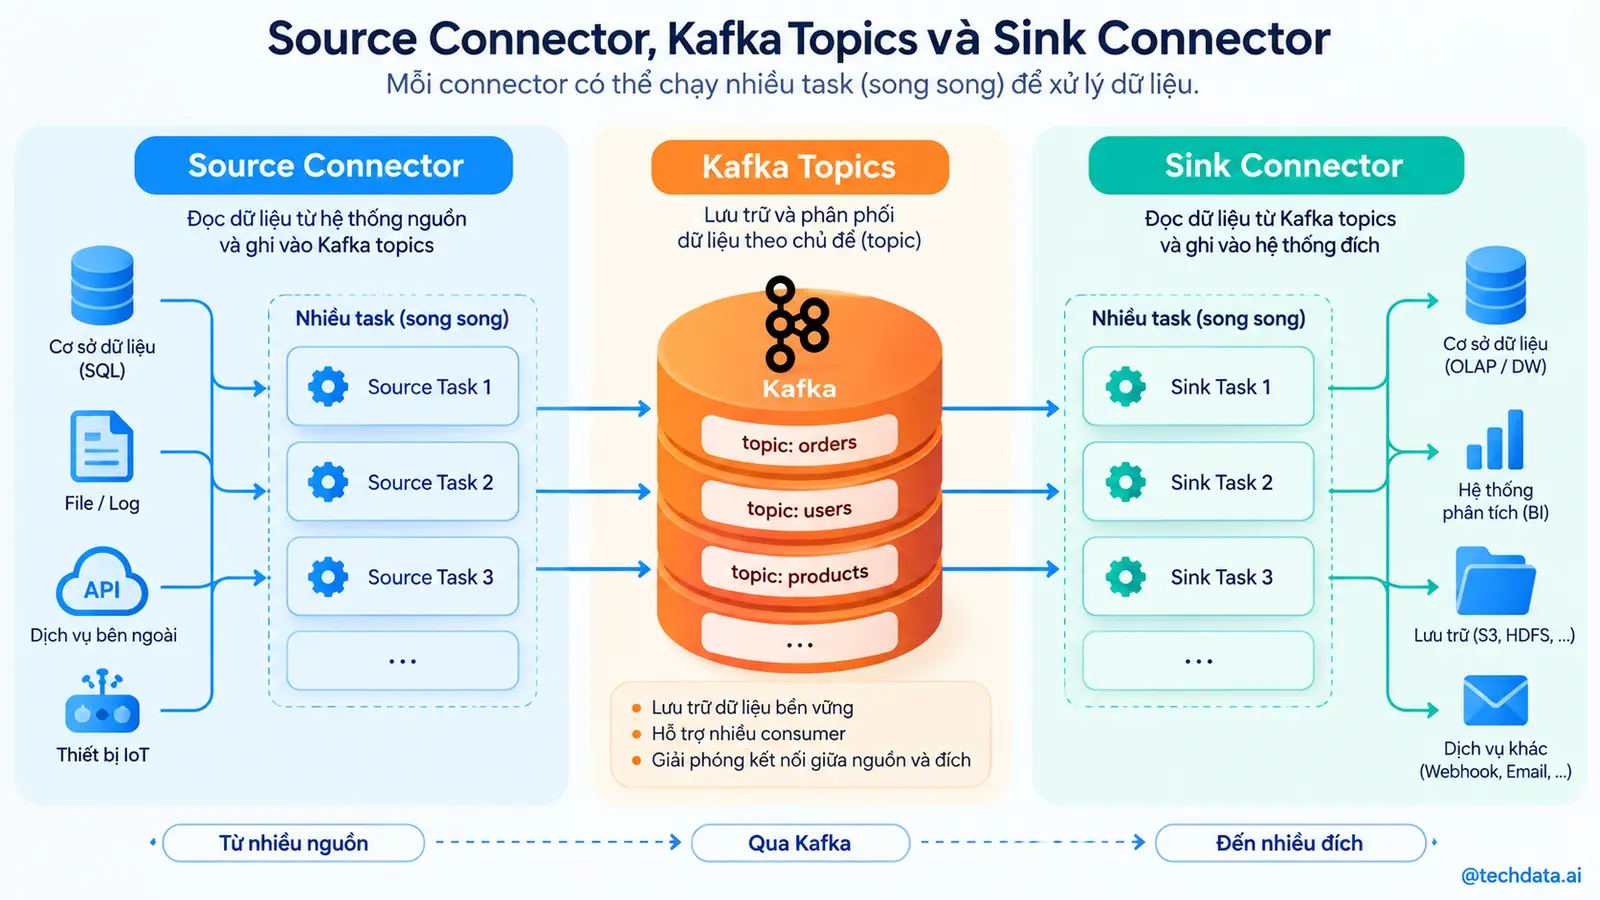
Source Connector đọc dữ liệu từ hệ thống ngoài và ghi vào Kafka. Debezium MySQL Connector là Source Connector.
Sink Connector đọc record từ Kafka rồi ghi vào hệ thống ngoài như Object Storage, Search Engine hoặc Data Warehouse.
Connector quản lý cấu hình cấp cao. Task thực hiện công việc thực tế. Một số Connector có thể chia tải thành nhiều Task. Với MySQL Debezium, một Connector theo dõi một logical server và khả năng song song bị giới hạn bởi thứ tự transaction log.
tasks.max là số Task tối đa, không phải cam kết Connector luôn tạo đúng số đó. Đặt giá trị rất lớn không tự động tăng throughput nếu Connector không hỗ trợ chia nguồn.
5. Standalone và Distributed Mode
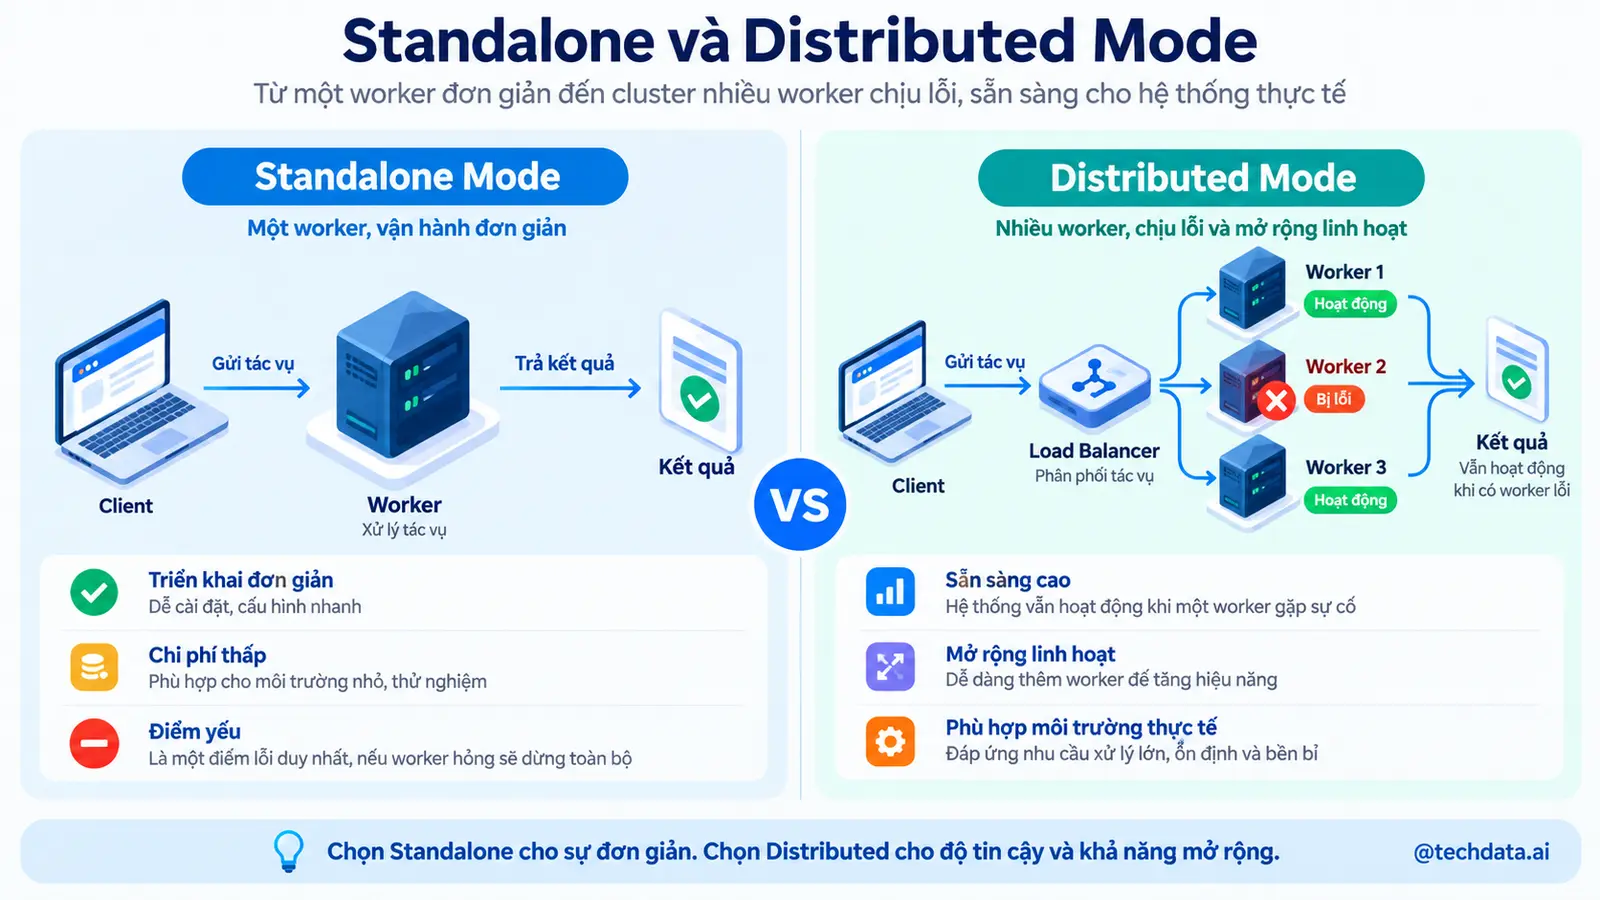
Standalone Mode chạy Worker và Connector trong một tiến trình, cấu hình bằng file. Nó phù hợp cho học tập, kiểm thử hoặc pipeline đơn giản trên một máy.
Distributed Mode chạy nhiều Worker chung một Connect Cluster. Cấu hình, Offset và trạng thái được lưu trong các Topic nội bộ. Connect tự phân phối Connector và Task giữa Worker, đồng thời phục hồi khi Worker hỏng.
Production thường dùng Distributed Mode vì:
- Có High Availability.
- Quản lý qua REST API.
- Cân bằng Task giữa nhiều Worker.
- Dễ rolling restart.
- Không phụ thuộc một tiến trình duy nhất.
Nhiều Worker chỉ tạo HA và khả năng phân phối Task. Nó không làm một Connector đơn luồng tự nhiên trở thành nhiều luồng.
6. Debezium đọc MySQL Binlog như thế nào
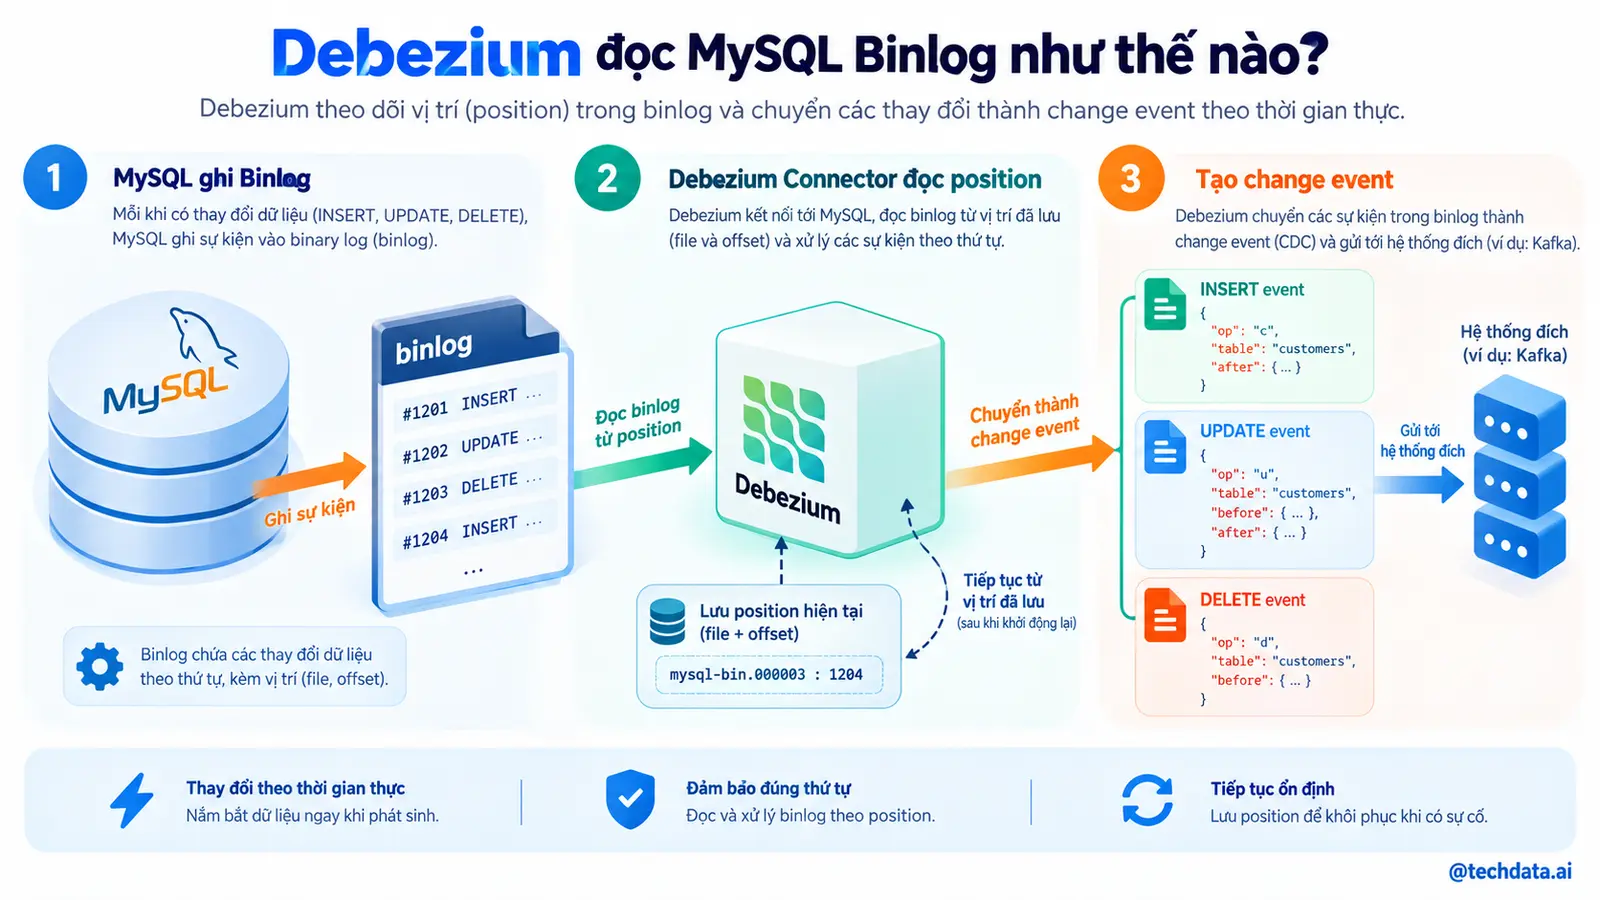
MySQL ghi thay đổi dữ liệu vào Binary Log, thường gọi là Binlog. Debezium kết nối như một replication client, đọc Binlog và chuyển mỗi thay đổi thành Kafka Event.
Để CDC chính xác, MySQL nên dùng Row-based Binlog. Mỗi Event chứa trạng thái trước, trạng thái sau, loại thao tác, metadata nguồn và timestamp.
Debezium duy trì vị trí Binlog đã đọc. Khi restart, Connector tiếp tục từ Offset đã lưu nếu Binlog cần thiết vẫn còn.
Nếu MySQL xóa Binlog trước khi Connector bắt kịp, Connector không thể tiếp tục từ vị trí cũ. Vì vậy, Binlog retention phải lớn hơn thời gian gián đoạn tối đa dự kiến, có thêm biên an toàn.
7. Kiến trúc pipeline thực hành
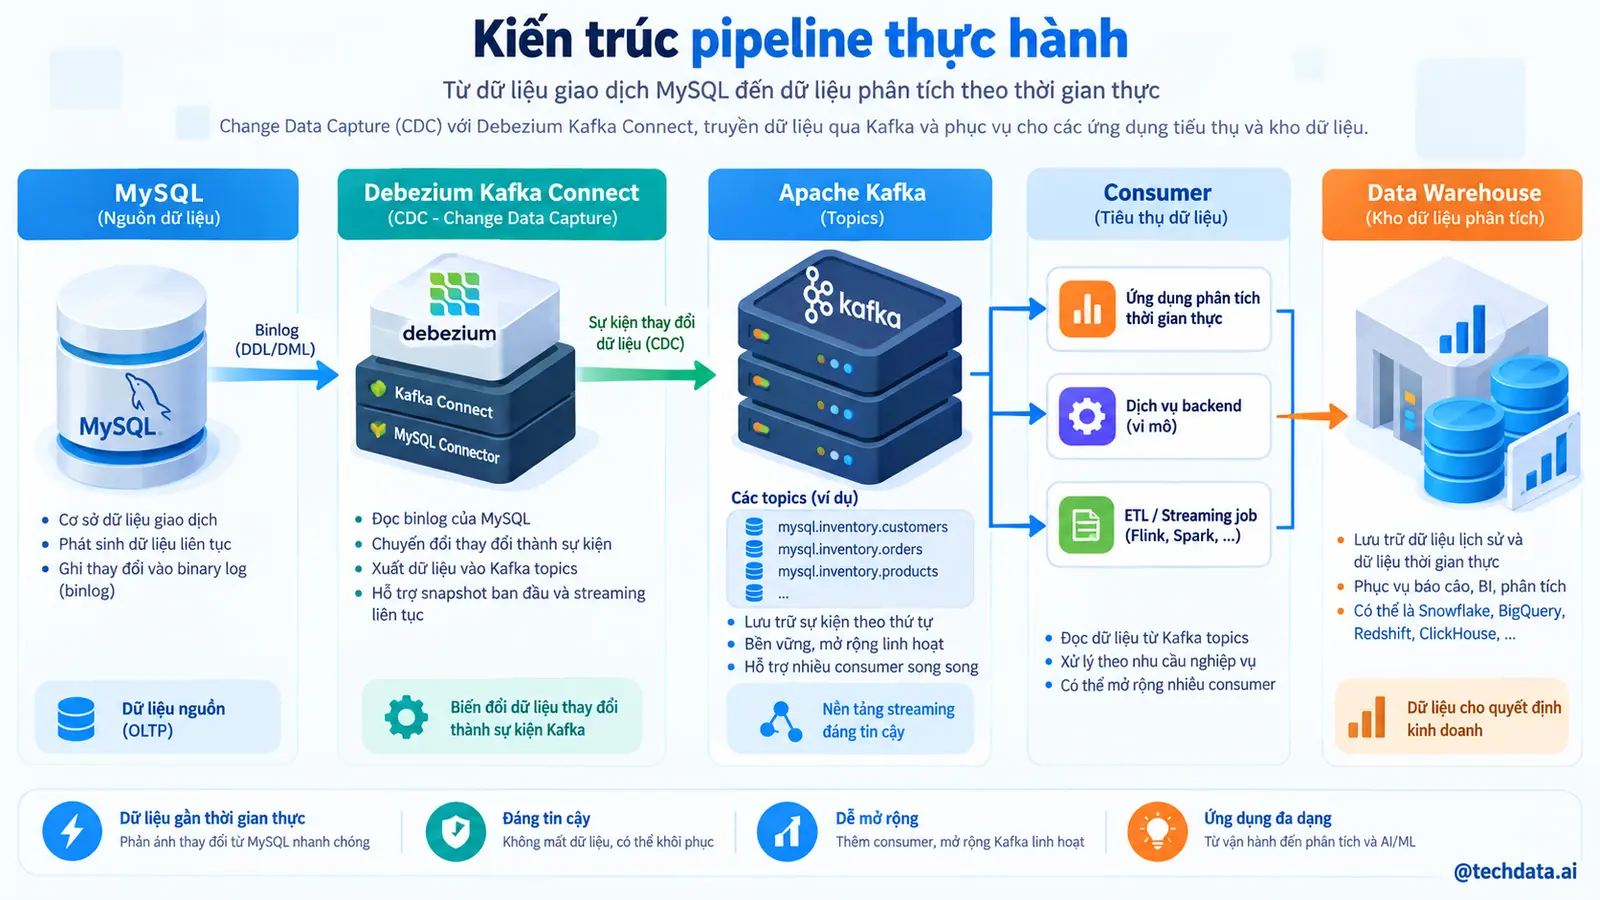
Project gồm:
MySQL
Kafka Broker
Kafka Connect Worker
Debezium MySQL Connector
Kafka UI
Consumer kiểm tra dữ liệu
MySQL chứa các bảng customers, orders và order_items. Debezium chụp Snapshot ban đầu, sau đó tiếp tục đọc Binlog.
Topic có thể được tạo theo quy ước:
mysql01.ecommerce.customers
mysql01.ecommerce.orders
mysql01.ecommerce.order_items
Tên thực tế phụ thuộc topic.prefix, database và table.
8. Chuẩn bị MySQL cho CDC
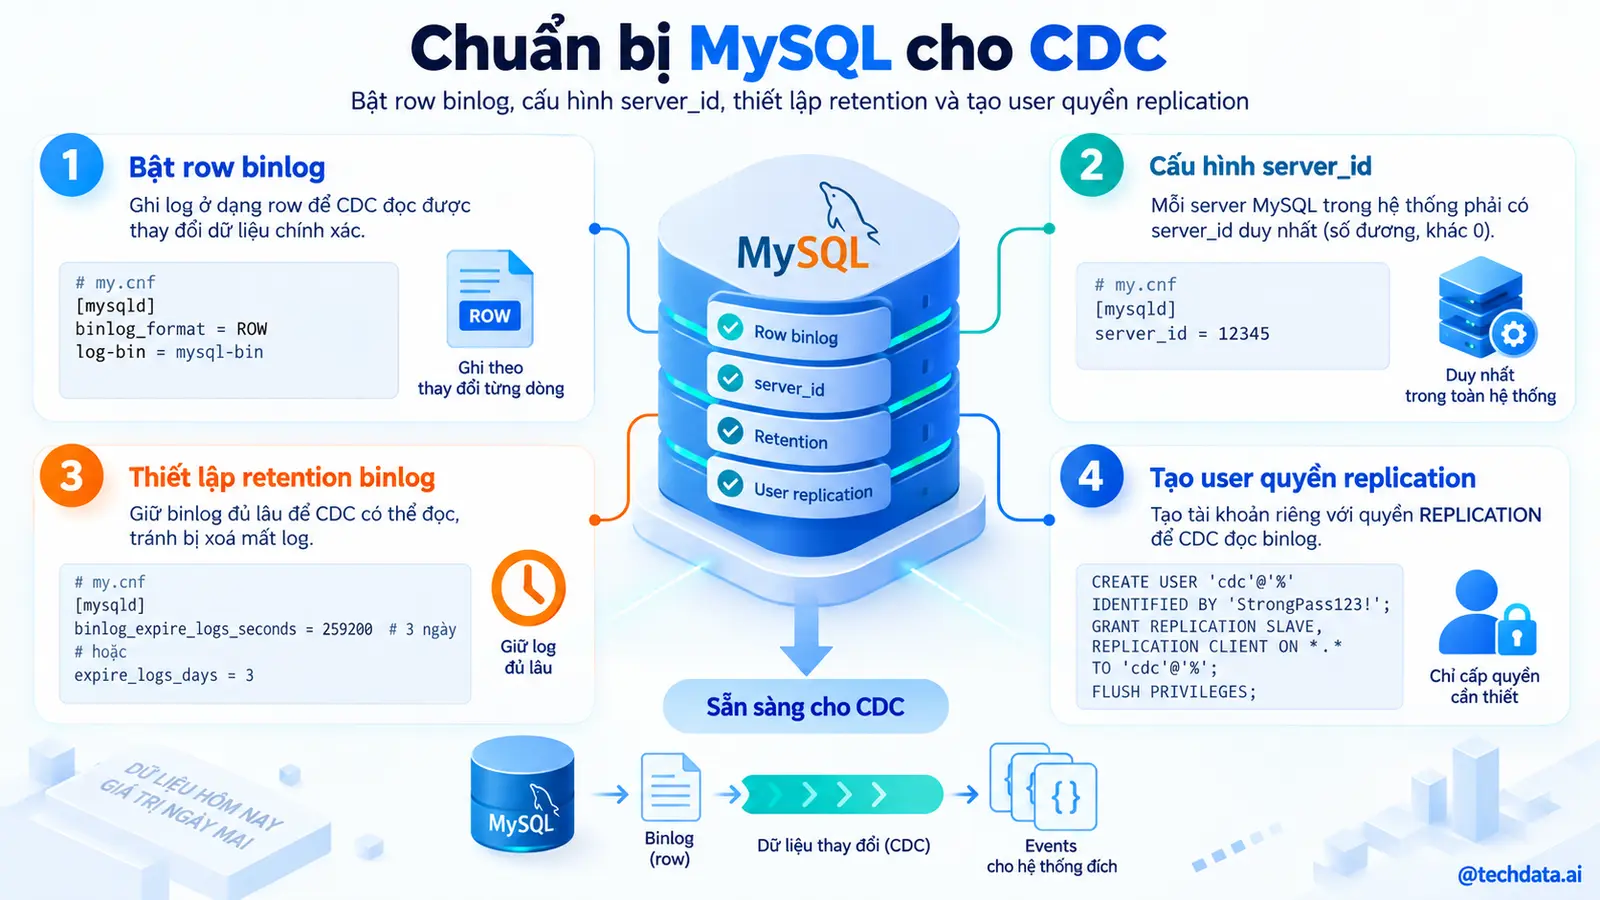
Các cấu hình quan trọng:
server-id=223344
log_bin=mysql-bin
binlog_format=ROW
binlog_row_image=FULL
expire_logs_days=7
Tạo user riêng cho Debezium với quyền tối thiểu cần thiết. Ví dụ quyền có thể gồm SELECT, RELOAD, SHOW DATABASES, REPLICATION SLAVE và REPLICATION CLIENT tùy phiên bản cùng chế độ snapshot.
Không sử dụng tài khoản root trong Production. Credential phải nằm trong Secret Manager hoặc cơ chế bảo mật của nền tảng, không ghi vào Git.
Kiểm tra:
SHOW VARIABLES LIKE 'log_bin';
SHOW VARIABLES LIKE 'binlog_format';
SHOW BINARY LOGS;
Mỗi bảng nên có Primary Key ổn định. Không có Primary Key, Key của Kafka record và hành vi update có thể kém hiệu quả hoặc khó dùng cho downstream.
9. Cài Kafka Connect và Debezium
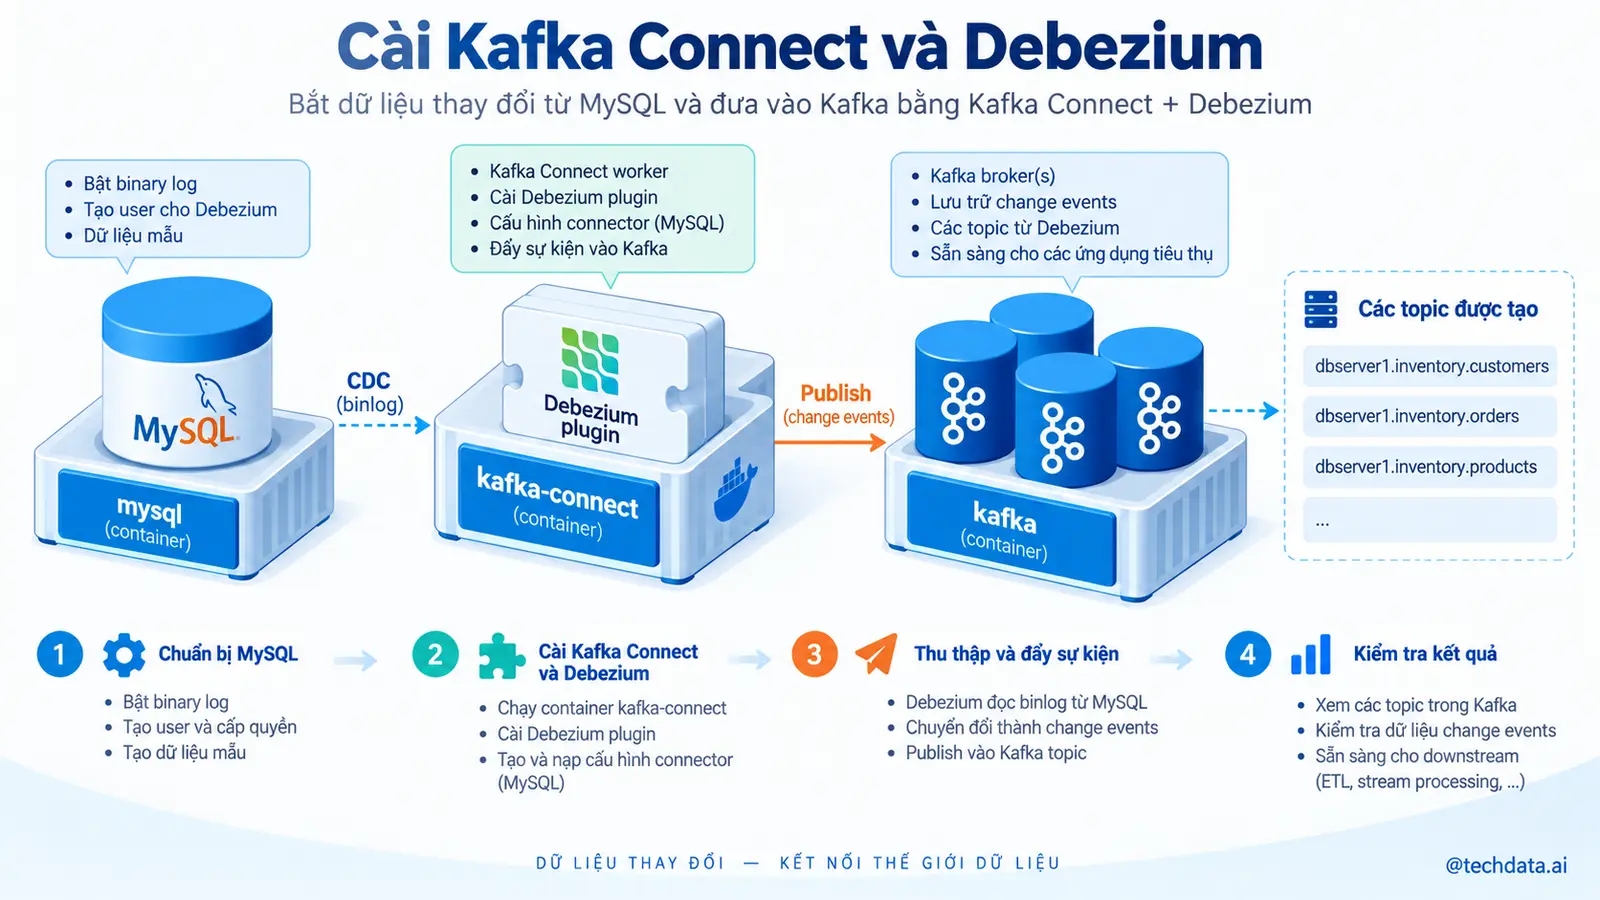
Trong môi trường Docker, có thể dùng Debezium Connect Image chứa sẵn Connector. Connect Worker cần kết nối đến Kafka bằng địa chỉ nội bộ trong Docker Network.
Cấu hình nền tảng:
connect:
  image: quay.io/debezium/connect:latest
  ports:
    - "8083:8083"
  environment:
    BOOTSTRAP_SERVERS: kafka:29092
    GROUP_ID: connect-cluster-01
    CONFIG_STORAGE_TOPIC: connect-configs
    OFFSET_STORAGE_TOPIC: connect-offsets
    STATUS_STORAGE_TOPIC: connect-status
  depends_on:
    - kafka
    - mysql
Production nên ghim phiên bản cụ thể thay vì dùng latest. Ba Topic nội bộ cần Replication Factor phù hợp và không nên để mặc định một Replica.
Kiểm tra Connect REST API:
curl http://localhost:8083/
curl http://localhost:8083/connector-plugins
10. Đăng ký MySQL Source Connector
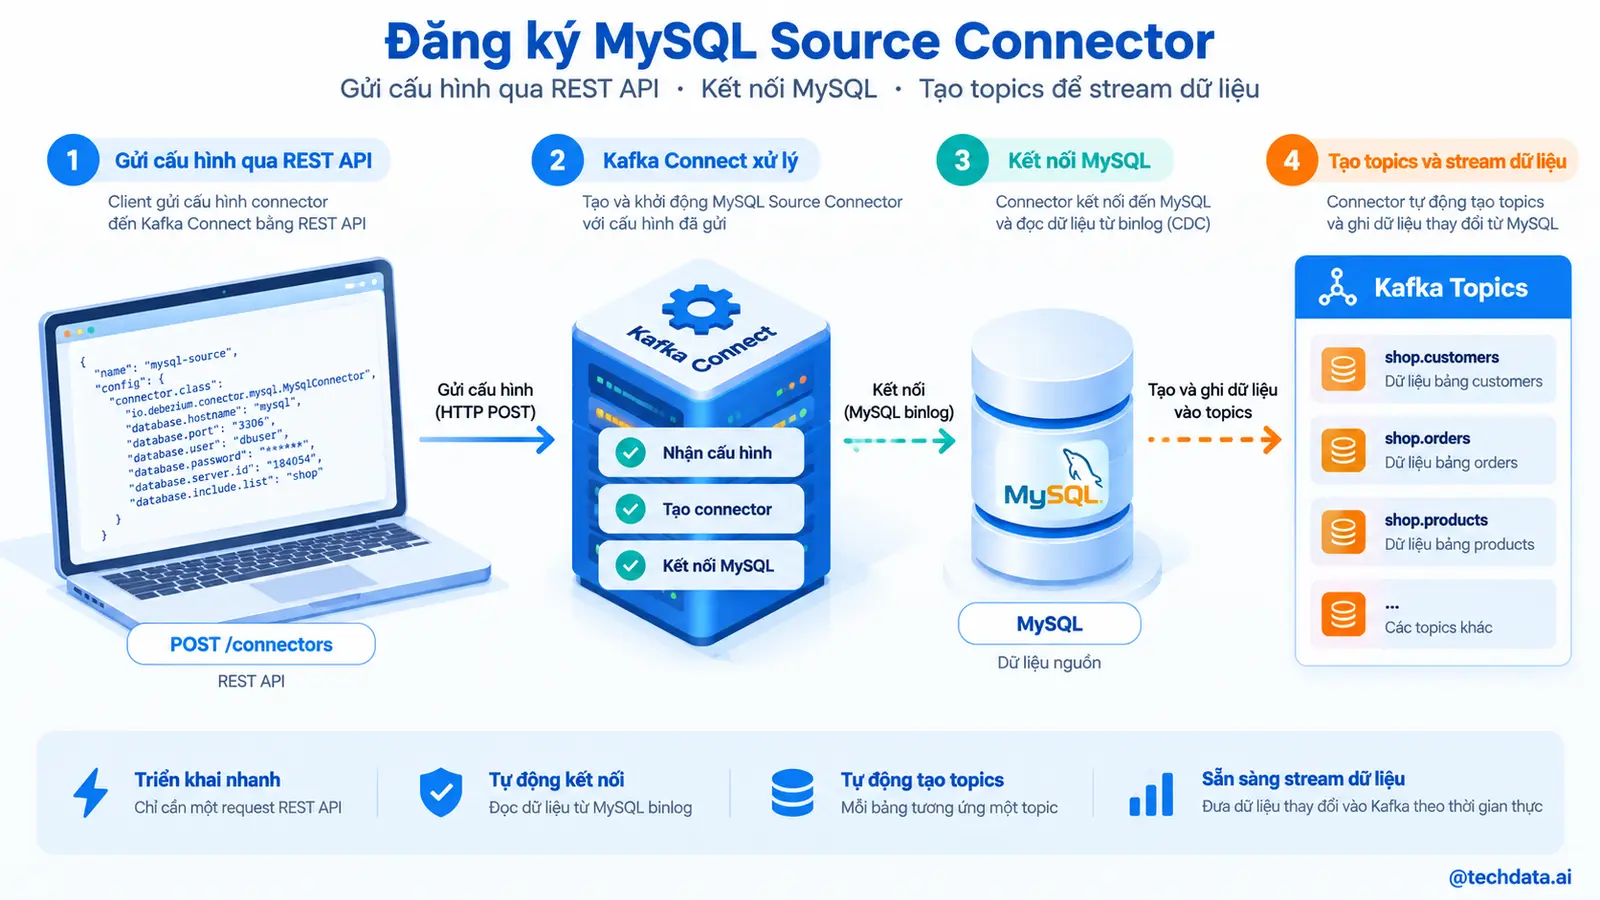
Tạo file mysql-connector.json:
{
  "name": "mysql-ecommerce-source",
  "config": {
    "connector.class": "io.debezium.connector.mysql.MySqlConnector",
    "database.hostname": "mysql",
    "database.port": "3306",
    "database.user": "debezium",
    "database.password": "debezium_password",
    "database.server.id": "5401",
    "topic.prefix": "mysql01",
    "database.include.list": "ecommerce",
    "table.include.list": "ecommerce.customers,ecommerce.orders,ecommerce.order_items",
    "schema.history.internal.kafka.bootstrap.servers": "kafka:29092",
    "schema.history.internal.kafka.topic": "schema-history.mysql01",
    "include.schema.changes": "true"
  }
}
Đăng ký:
curl -X POST http://localhost:8083/connectors \
  -H "Content-Type: application/json" \
  --data @mysql-connector.json
Kiểm tra trạng thái:
curl http://localhost:8083/connectors/mysql-ecommerce-source/statusKhông đưa password thật vào file được commit. Bài thực hành dùng giá trị đơn giản, Production phải dùng Config Provider hoặc Secret Management.
11. Snapshot ban đầu
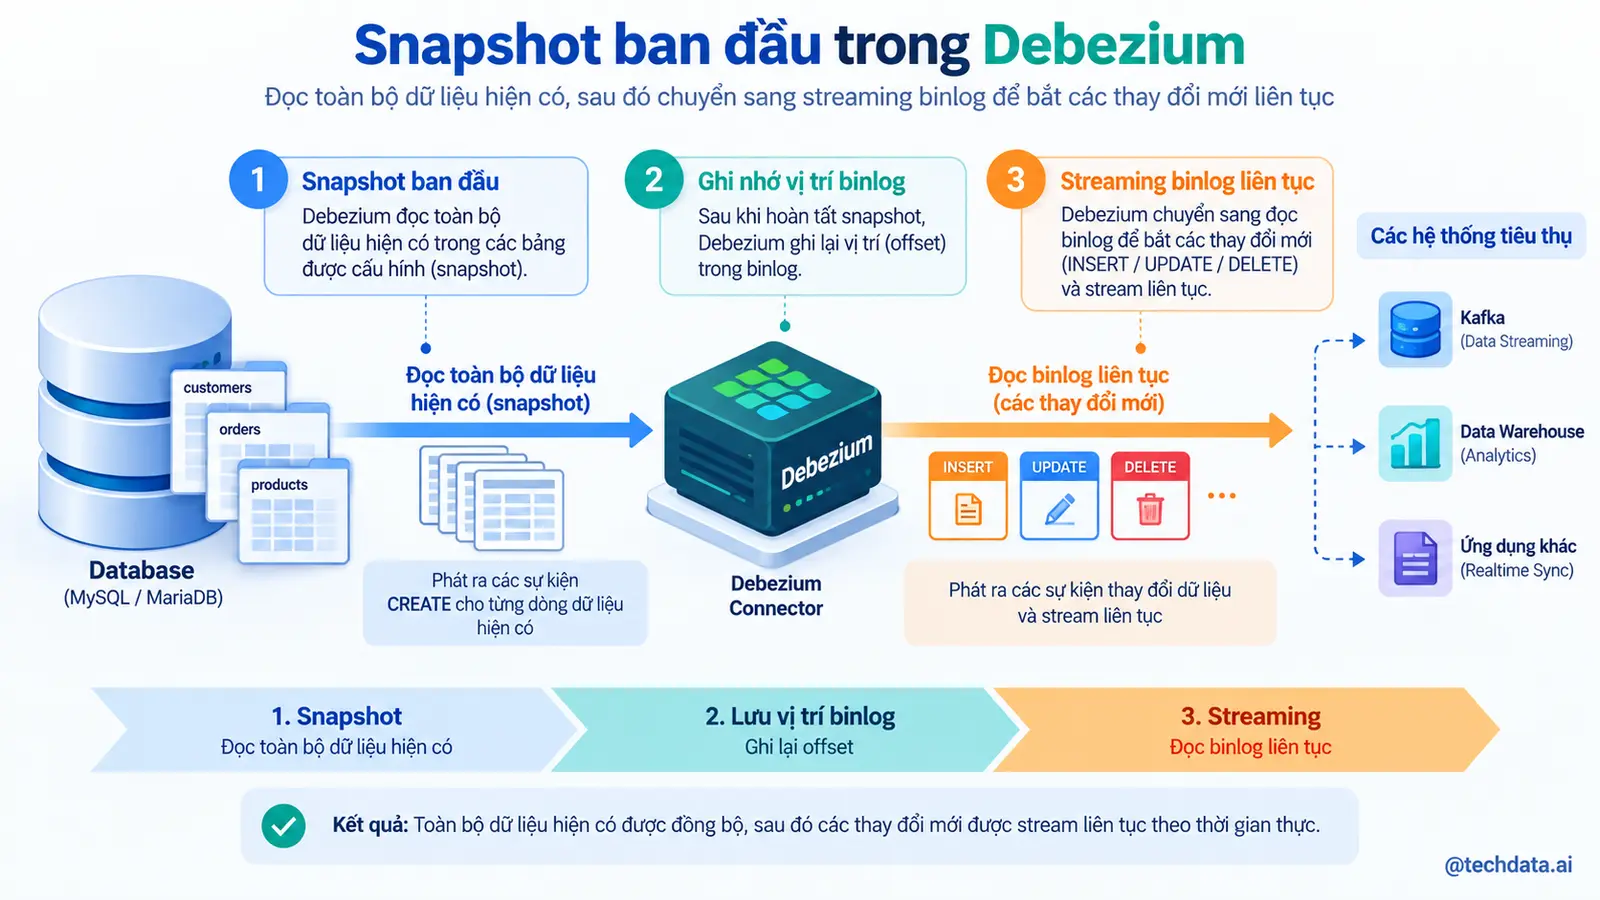
Binlog chỉ chứa thay đổi trong một khoảng retention. Khi bắt đầu CDC, Debezium thường cần Snapshot để lấy trạng thái hiện tại của bảng trước khi tiếp tục streaming.
Snapshot gồm:
- Đọc schema.
- Xác định vị trí Binlog nhất quán.
- Đọc dữ liệu hiện có.
- Phát Event Snapshot.
- Chuyển sang đọc thay đổi liên tục.
Với bảng lớn, Snapshot có thể kéo dài và tạo tải lên database. Cần đánh giá locking, fetch size, network, giờ chạy và khả năng downstream tiếp nhận lưu lượng lớn.
Các chế độ Snapshot khác nhau phục vụ Initial Load, Schema Only hoặc phục hồi. Không nên thay đổi snapshot.mode mà chưa hiểu trạng thái Offset và dữ liệu đã tồn tại ở downstream.
12. Cấu trúc CDC Event
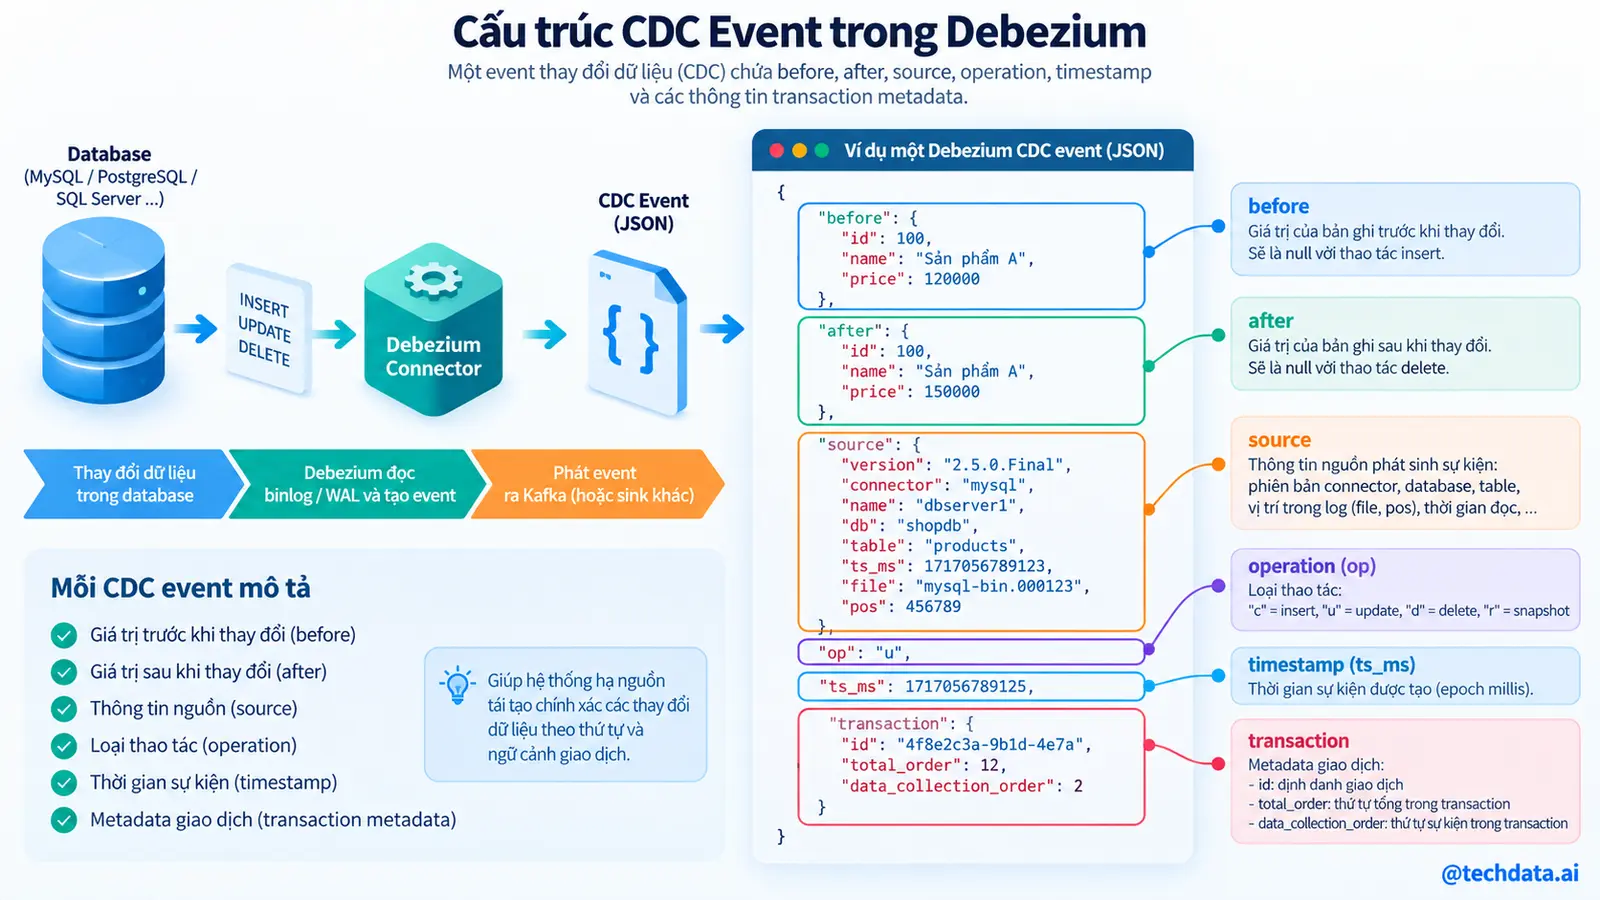
Debezium Event thường có Envelope:
{
  "before": {
    "id": 1001,
    "status": "pending"
  },
  "after": {
    "id": 1001,
    "status": "paid"
  },
  "source": {
    "db": "ecommerce",
    "table": "orders"
  },
  "op": "u",
  "ts_ms": 1789718400000
}
before là trạng thái cũ. after là trạng thái mới. op thể hiện thao tác. Metadata source giúp truy vết database, table và vị trí log.
Consumer không nên chỉ lấy after mà bỏ toàn bộ metadata nếu cần kiểm toán, chống trùng hoặc xử lý Delete.
13. Insert, Update và Delete
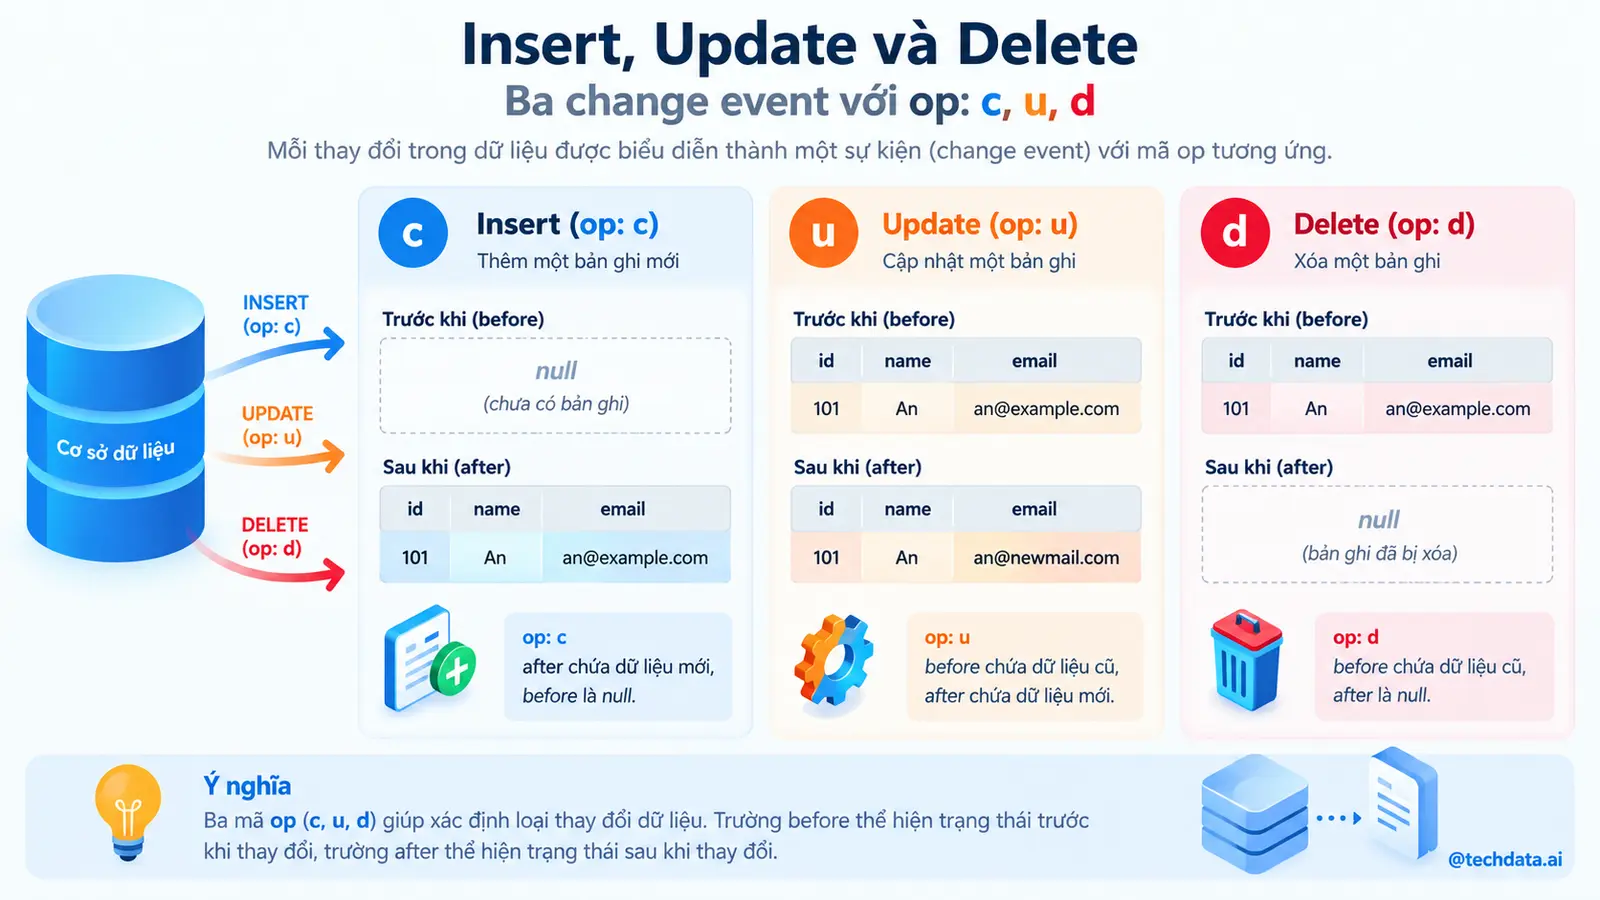
Các mã thao tác thường gặp:
ccho Create.ucho Update.dcho Delete.rcho Snapshot Read.
Với Delete, after thường bằng null và before chứa trạng thái trước khi xóa. Debezium có thể phát thêm Tombstone tùy cấu hình để hỗ trợ Log Compaction.
Downstream cần quyết định Hard Delete, Soft Delete hay lưu lịch sử. Data Warehouse thường ghi nhận is_deleted, valid_from và valid_to thay vì xóa ngay dữ liệu phân tích.
14. Schema History và Offset
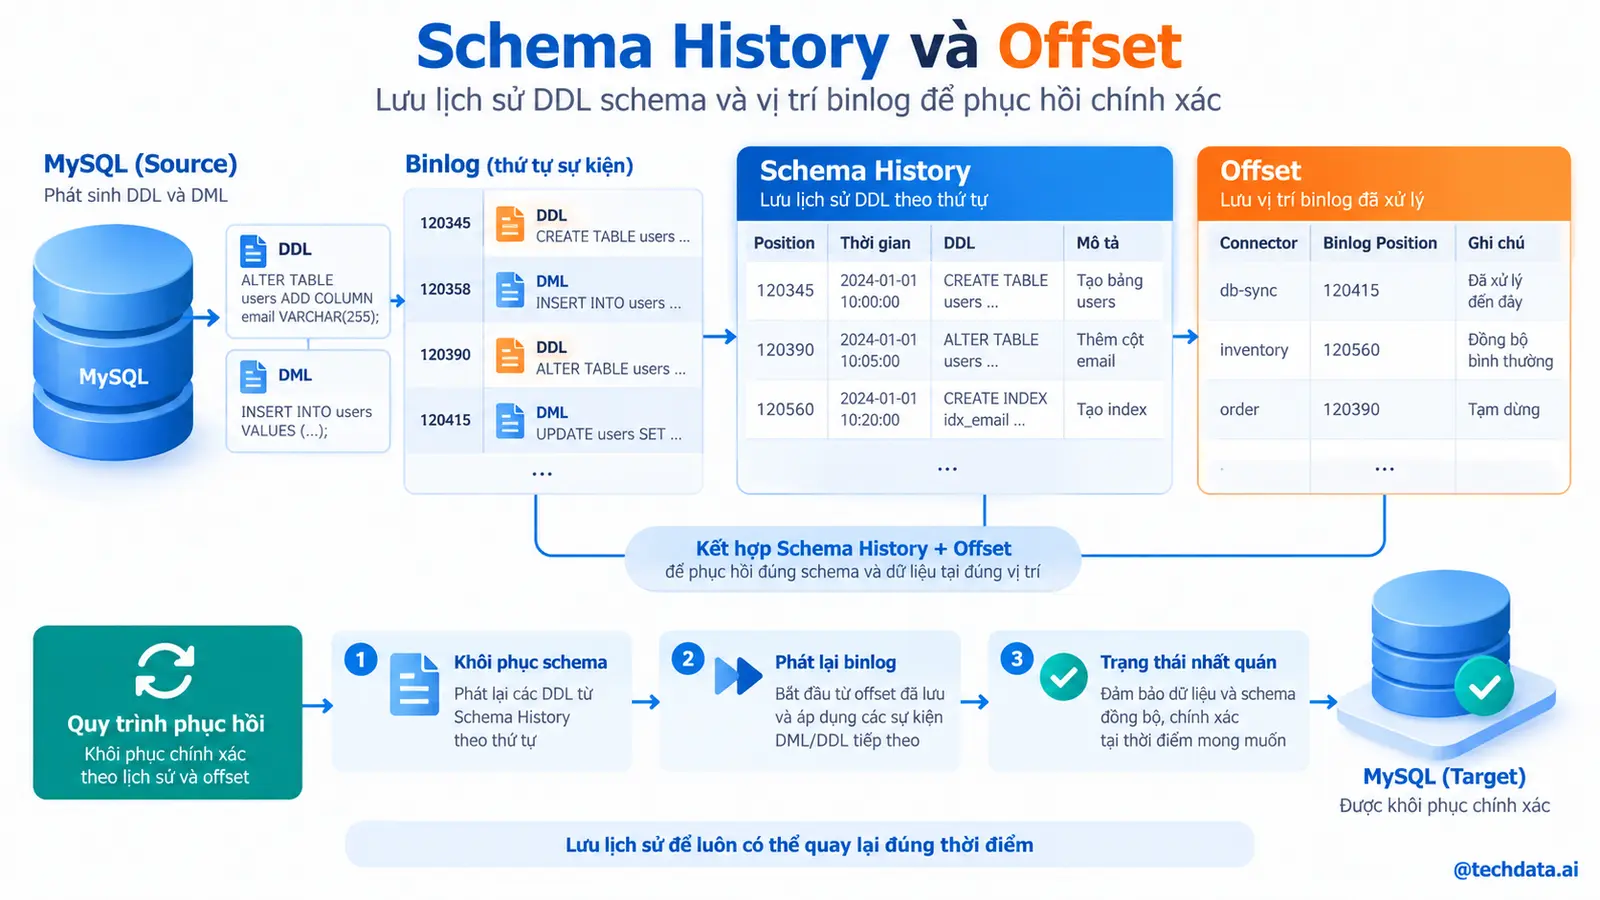
Debezium cần Schema History để diễn giải Binlog qua các lần DDL thay đổi. Topic Schema History là thành phần vận hành quan trọng, không phải Topic nghiệp vụ cho Consumer thông thường.
Kafka Connect Offset lưu vị trí nguồn đã xử lý. Nếu xóa Offset hoặc Schema History không đúng cách, Connector có thể Snapshot lại, đọc trùng hoặc không khởi động được.
Ba Topic nội bộ của Connect và Topic Schema History cần:
- Replication phù hợp.
- Quyền truy cập hạn chế.
- Monitoring.
- Backup hoặc chiến lược phục hồi.
- Không để retention tùy tiện làm mất dữ liệu cần thiết.
15. Single Message Transform
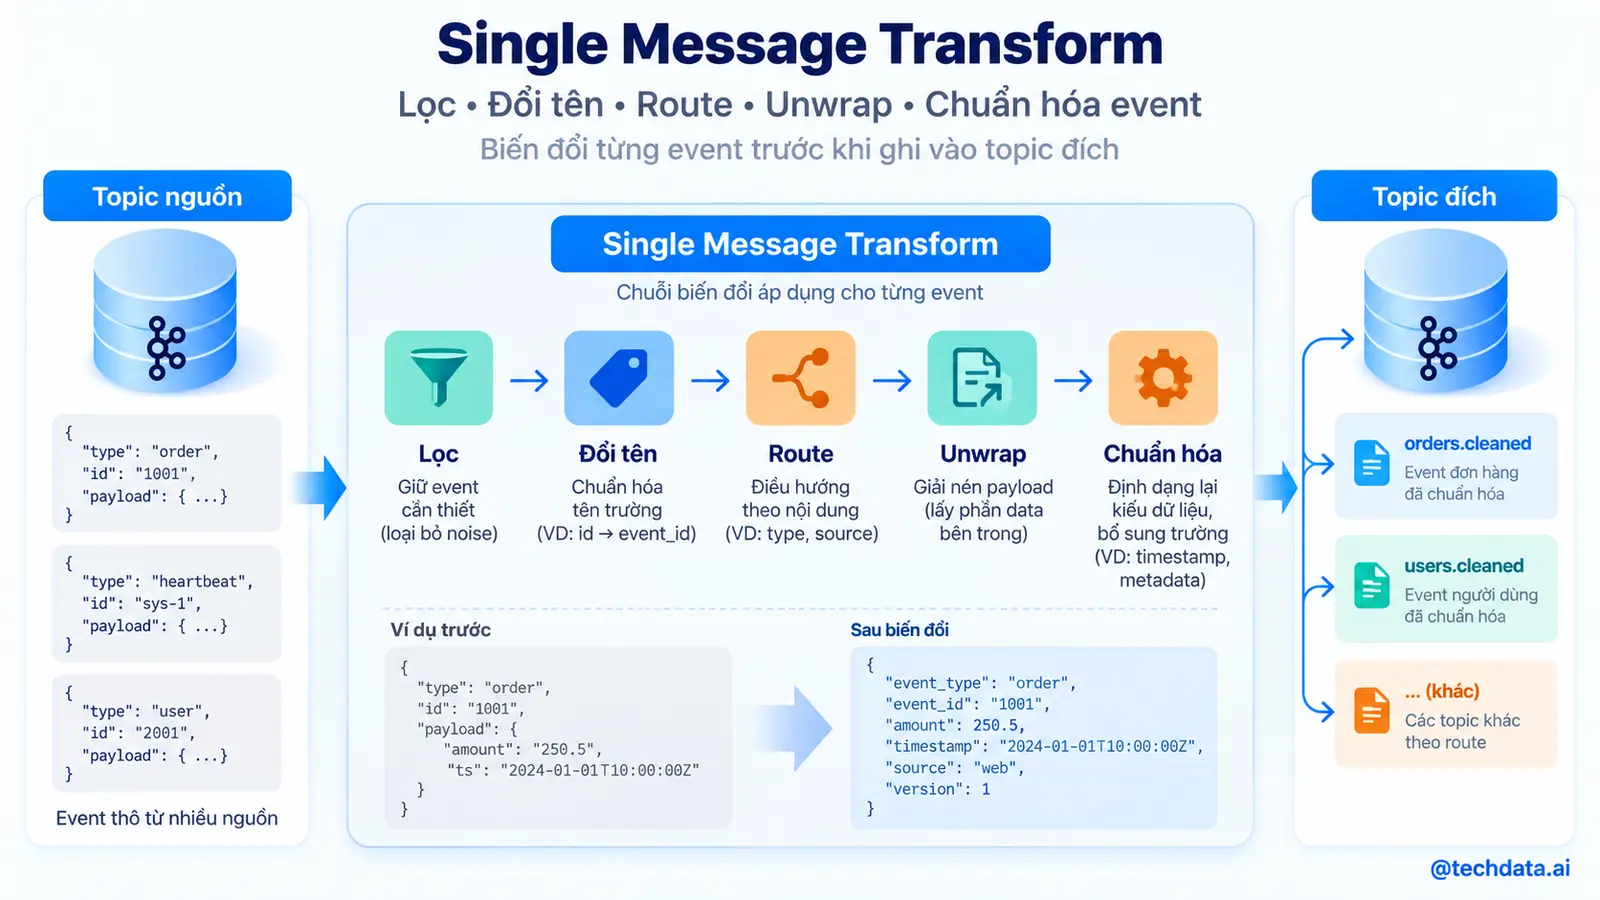
Single Message Transform, viết tắt SMT, thay đổi từng record khi đi qua Connect mà không cần viết ứng dụng riêng.
Debezium cung cấp Event Flattening để lấy after và bổ sung metadata:
"transforms": "unwrap",
"transforms.unwrap.type": "io.debezium.transforms.ExtractNewRecordState",
"transforms.unwrap.add.fields": "op,table,source.ts_ms",
"transforms.unwrap.delete.handling.mode": "rewrite"
SMT phù hợp với biến đổi nhẹ như rename Topic, thêm field hoặc unwrap Envelope. Không nên nhồi logic nghiệp vụ phức tạp vào SMT. Biến đổi lớn nên thuộc Stream Processor hoặc Data Transformation Layer.
16. Đưa dữ liệu đến BigQuery hoặc Data Warehouse
Sau khi CDC Event nằm trong Kafka, có thể dùng Sink Connector để ghi Data Warehouse. Pipeline cần xử lý:
- Mapping schema.
- Primary Key.
- Upsert và Delete.
- Batch size.
- Retry.
- Duplicate.
- Schema Evolution.
- Partitioning bảng đích.
Với BigQuery, một thiết kế có thể ghi raw CDC vào bảng staging trước. Sau đó, câu lệnh MERGE chuẩn hóa dữ liệu vào bảng đích. Cách này giữ lịch sử, dễ replay và tách ingestion khỏi business transformation.
Không nên giả định Sink Connector tạo Exactly Once cho mọi Data Warehouse. Hãy đọc rõ Delivery Semantics của Connector cụ thể và thiết kế deduplication theo Event ID hoặc source position.
17. Monitoring và xử lý lỗi
Metrics quan trọng:
- Connector và Task status.
- Source Record Poll Rate.
- Source Record Write Rate.
- Milliseconds Behind Source.
- Batch Size.
- Error Rate.
- Retry Count.
- Kafka Producer latency của Connect.
- Tuổi Binlog sớm nhất còn giữ.
Khi Connector Failed, REST API trả stack trace trong Task status. Không nên chỉ restart liên tục. Cần xác định lỗi credential, schema, network, Binlog đã mất hay record không hợp lệ.
Connect hỗ trợ error tolerance và Dead Letter Queue cho một số trường hợp chuyển đổi hoặc Sink. Cấu hình bỏ qua lỗi có thể giúp pipeline tiếp tục nhưng cũng có thể âm thầm làm mất dữ liệu. Mọi record bị bỏ qua phải có metric và cảnh báo.
18. DDL, schema change và vận hành
Thay đổi schema nguồn có thể ảnh hưởng toàn chuỗi. Thêm cột nullable thường ít rủi ro hơn rename, đổi kiểu hoặc xóa cột.
Quy trình nên có:
- Đánh giá compatibility với Connector và Consumer.
- Cập nhật schema downstream trước nếu cần.
- Triển khai DDL có kiểm soát.
- Theo dõi Schema History và lỗi deserialize.
- Xác nhận Sink tiếp nhận field mới.
- Có phương án rollback hoặc forward fix.
CDC không loại bỏ nhu cầu Data Contract. Nó khiến thay đổi database lan truyền nhanh hơn, vì vậy Governance càng quan trọng.
19. Những lỗi thường gặp
- Binlog không bật hoặc không dùng ROW format.
- Binlog retention ngắn hơn thời gian Connector gián đoạn.
- Dùng tài khoản root cho Debezium.
- Bảng không có Primary Key.
- Xóa Offset Topic để sửa lỗi mà không đánh giá replay.
- Dùng
latestcho Docker Image Production. - Snapshot bảng lớn vào giờ cao điểm.
- Bỏ qua Delete Event.
- Unwrap Event nhưng mất metadata cần cho audit.
- Không giám sát độ trễ so với database nguồn.
20. Tổng kết
Kafka Connect cung cấp Runtime chuẩn để tích hợp Kafka với hệ thống ngoài. Debezium sử dụng Runtime đó để đọc transaction log và biến thay đổi database thành Event.
Các điểm cần nhớ:
- CDC đọc thay đổi từ Binlog thay vì quét bảng định kỳ.
- Source Connector ghi dữ liệu vào Kafka, Sink Connector đưa dữ liệu ra ngoài.
- Distributed Mode phù hợp với Production.
- Snapshot lấy dữ liệu hiện có trước khi streaming.
- Offset và Schema History là trạng thái quan trọng.
- Delete cần được thiết kế rõ ở downstream.
- SMT chỉ nên dùng cho biến đổi nhẹ.
- Binlog retention phải đủ cho thời gian phục hồi.
- CDC cần Data Contract, monitoring và quy trình schema change.
Bài tiếp theo sẽ quản lý schema Event bằng Schema Registry, Avro, JSON Schema và Protobuf.
21. Câu hỏi ôn tập
- CDC giải quyết hạn chế nào của truy vấn theo
updated_at? - Source Connector và Sink Connector khác nhau thế nào?
- Vì sao nhiều Worker không luôn làm một Connector nhanh hơn?
- Snapshot có vai trò gì?
- Schema History và Offset lưu thông tin gì?
- Debezium biểu diễn Delete ra sao?
- SMT phù hợp với loại biến đổi nào?
- Điều gì xảy ra nếu Binlog cần đọc đã bị xóa?
22. Tài liệu tham khảo
- Apache Kafka Connect: https://kafka.apache.org/documentation/#connect
- Kafka Connect Configurations: https://kafka.apache.org/documentation/#connectconfigs
- Debezium MySQL Connector: https://debezium.io/documentation/reference/stable/connectors/mysql.html
- Debezium Architecture: https://debezium.io/documentation/reference/stable/architecture.html
- Debezium Event Flattening SMT: https://debezium.io/documentation/reference/stable/transformations/event-flattening.html