


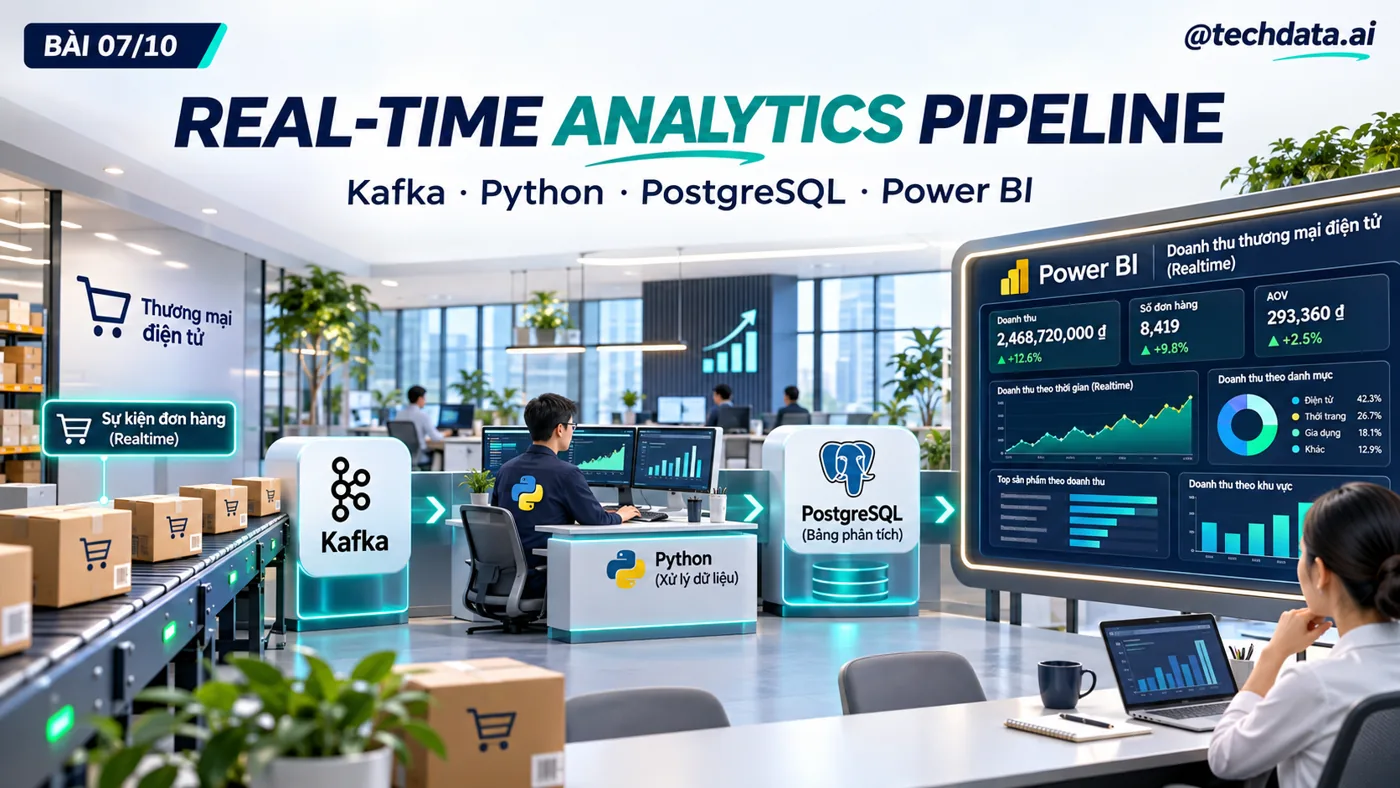

Series Apache Kafka · Bài 7/10. Website phát đơn liên tục, nhưng báo cáo vẫn chỉ cập nhật cuối ngày. Bài này xây luồng phân tích gần thời gian thực: producer phát sự kiện thanh toán, Kafka giữ luồng, Python lưu fact vào PostgreSQL, Power BI đọc view doanh thu. Ta kiểm tra tính đúng của tổng tiền trước khi tối ưu tốc độ hiển thị.
Lab dùng Kafka bài 2, Python bài 3 và PostgreSQL lab bài 5 ở localhost:5433. Nếu chưa có database, dựng lại container theo bài 5. Power BI Desktop chạy trên Windows và cần kết nối được PostgreSQL của bạn. Bài không yêu cầu tài khoản dịch vụ trả phí để thử phần Kafka, Python và SQL.
Mục lục
- Chốt định nghĩa doanh thu
- Tạo fact và view
- Sinh payment event
- Lưu dữ liệu chống trùng
- Đối soát số liệu
- Kết nối Power BI
- Đo độ trễ và dữ liệu đến muộn
- Bài tập và vận hành
- Tài liệu tham khảo
1. Doanh thu phải có định nghĩa trước khi có dashboard
Lab tính gross paid amount: tổng số tiền của các order.paid event hợp lệ, một event cho một lần thanh toán của một đơn. Đơn mới tạo nhưng chưa thanh toán không được cộng. Bài chưa trừ hoàn tiền, thuế, phí vận chuyển hoặc chiết khấu theo chính sách kế toán. Trong doanh nghiệp, tên measure phải phản ánh đúng phạm vi đó, không gộp mọi khái niệm vào một chữ “doanh thu”.
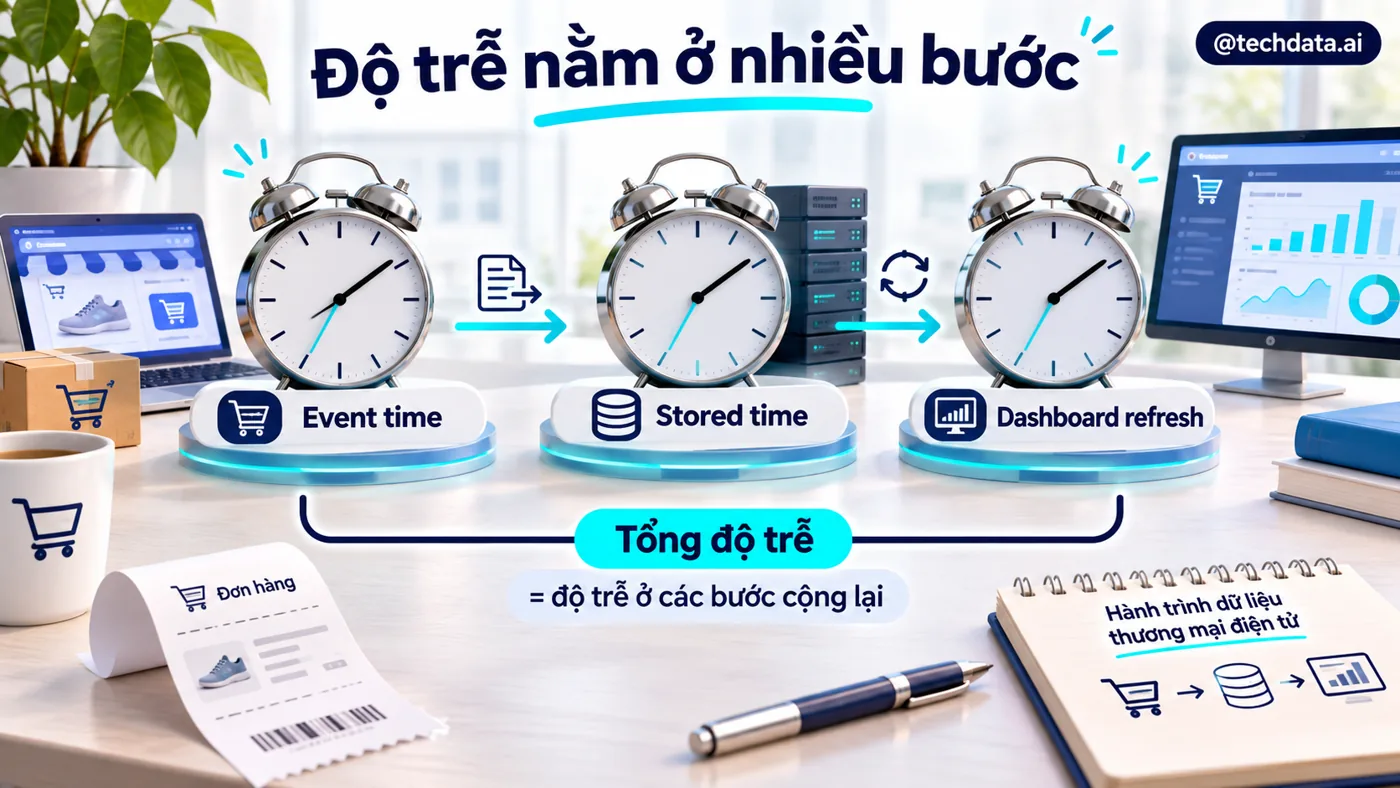
Event time là lúc thanh toán xảy ra; stored_at là lúc consumer ghi fact; thời điểm visual refresh là lúc người dùng nhìn dữ liệu mới. Một pipeline Kafka nhanh không làm Power BI Import tự đổi dữ liệu ngay. Độ mới đầu cuối còn phụ thuộc query, cache và refresh.
Chúng ta lưu fact từng event rồi SUM qua view. Nhờ vậy có thể đối soát theo event_id, replay mà không cộng lại và tính lại logic báo cáo từ dữ liệu chi tiết. Với dữ liệu lớn, có thể thêm bảng aggregate tăng dần nhưng phải cập nhật cùng transaction chống trùng hoặc xây từ fact theo quy trình có kiểm soát.
2. Tạo bảng fact và view theo giờ Việt Nam
Tạo analytics.sql, nhập bằng psql vào orderslab. Tên fact_paid riêng, không sửa bảng orders bài 5. Payload được lưu để phát hiện cùng event_id nhưng khác nội dung. amount_vnd là bigint, occurred_at là timestamptz.
CREATE TABLE IF NOT EXISTS fact_paid (
  event_id text PRIMARY KEY,
  order_id text NOT NULL UNIQUE,
  store_id text NOT NULL,
  amount_vnd bigint NOT NULL CHECK (amount_vnd > 0),
  occurred_at timestamptz NOT NULL,
  stored_at timestamptz NOT NULL DEFAULT clock_timestamp(),
  payload jsonb NOT NULL
);
CREATE INDEX IF NOT EXISTS fact_paid_time_store ON fact_paid(occurred_at,store_id);
CREATE OR REPLACE VIEW v_daily_sales AS
SELECT (occurred_at AT TIME ZONE 'Asia/Ho_Chi_Minh')::date AS sales_date,
       store_id, count(*) AS paid_orders, sum(amount_vnd) AS gross_paid_vnd,
       max(stored_at) AS last_stored_at
FROM fact_paid
GROUP BY 1,2;
docker exec -i kafka5-pg psql -U lab -d orderslab < analytics.sql
docker exec kafka-lab /opt/kafka/bin/kafka-topics.sh --bootstrap-server localhost:9092 --create --topic paid_orders_v1 --partitions 3 --replication-factor 1GROUP BY dùng ngày nghiệp vụ ở Asia/Ho_Chi_Minh, không mặc định theo timezone session của người chạy SQL. UNIQUE order_id phù hợp giả định một lần thanh toán trên một đơn của lab; hệ thống trả góp hoặc nhiều payment cần payment_id và mô hình fact khác. Không áp unique này nếu nghiệp vụ cho phép nhiều thanh toán hợp lệ cùng đơn.
3. Producer tạo 20 payment event có thể đối chiếu
Tạo paid_producer.py. Event ID cố định để chạy lại cùng bộ mẫu không tạo thêm fact; payload và timestamp cũng xác định để lần retry giống nhau. Có hai cửa hàng HCM và HN, mỗi cửa hàng 10 đơn.
import json
from datetime import datetime, timezone, timedelta
from confluent_kafka import Producer

p = Producer({"bootstrap.servers":"localhost:9092", "enable.idempotence":True, "acks":"all"})
errors = []
def done(err,msg):
    if err:
        errors.append(str(err))
base = datetime(2026,11,13,3,0,tzinfo=timezone.utc)
for i in range(1,21):
    event = {"event_id":f"paid-{i:03d}", "event_type":"order.paid",
             "order_id":f"SALE-{i:03d}", "store_id":"HCM" if i%2 else "HN",
             "amount_vnd":i*10000, "occurred_at":(base+timedelta(minutes=i)).isoformat()}
    p.produce("paid_orders_v1", key=event["order_id"].encode(),
              value=json.dumps(event).encode(), on_delivery=done)
    p.poll(0)
remaining = p.flush(30)
if remaining or errors:
    raise SystemExit(f"pending={remaining} errors={errors}")
print("20 events delivered")
Dữ liệu ngày 13/11/2026 được cố định cho bài học, không phải “hôm nay” động. Khi tạo biểu đồ, lọc đúng ngày mẫu. Tổng từ 1 đến 20 là 210, nhân 10.000 bằng 2.100.000 đồng. HCM nhận số lẻ nên tổng 1.000.000; HN nhận số chẵn nên tổng 1.100.000.
4. Consumer lưu fact rồi commit offset
Tạo analytics_consumer.py. Mỗi record được kiểm tra, insert bằng tham số SQL rồi commit database. Nếu event đã có, so payload để không che xung đột. Kafka offset chỉ commit khi bước database hoàn tất.
import json
import os
from datetime import datetime
import psycopg
from psycopg.types.json import Jsonb
from confluent_kafka import Consumer, KafkaException

DSN = os.getenv("PG_DSN","postgresql://lab:labpass@localhost:5433/orderslab")
c = Consumer({"bootstrap.servers":"localhost:9092", "group.id":os.getenv("GROUP_ID","analytics-v1"),
              "auto.offset.reset":"earliest", "enable.auto.commit":False})
c.subscribe(["paid_orders_v1"])
try:
    while True:
        msg = c.poll(1.0)
        if msg is None:
            continue
        if msg.error():
            raise KafkaException(msg.error())
        e = json.loads(msg.value().decode("utf-8"))
        if e.get("event_type") != "order.paid" or type(e.get("amount_vnd")) is not int or e["amount_vnd"] <= 0:
            raise ValueError("Invalid payment event")
        occurred = datetime.fromisoformat(e["occurred_at"])
        if occurred.tzinfo is None:
            raise ValueError("Timezone required")
        with psycopg.connect(DSN) as conn:
            with conn.cursor() as cur:
                cur.execute("INSERT INTO fact_paid(event_id,order_id,store_id,amount_vnd,occurred_at,payload) VALUES (%s,%s,%s,%s,%s,%s) ON CONFLICT(event_id) DO NOTHING RETURNING event_id",
                            (e["event_id"],e["order_id"],e["store_id"],e["amount_vnd"],occurred,Jsonb(e)))
                inserted = cur.fetchone()
                if not inserted:
                    cur.execute("SELECT payload FROM fact_paid WHERE event_id=%s",(e["event_id"],))
                    if cur.fetchone()[0] != e:
                        raise ValueError("Conflicting event_id")
        c.commit(message=msg,asynchronous=False)
        print("NEW" if inserted else "REPLAY",e["event_id"],flush=True)
except KeyboardInterrupt:
    pass
finally:
    c.close()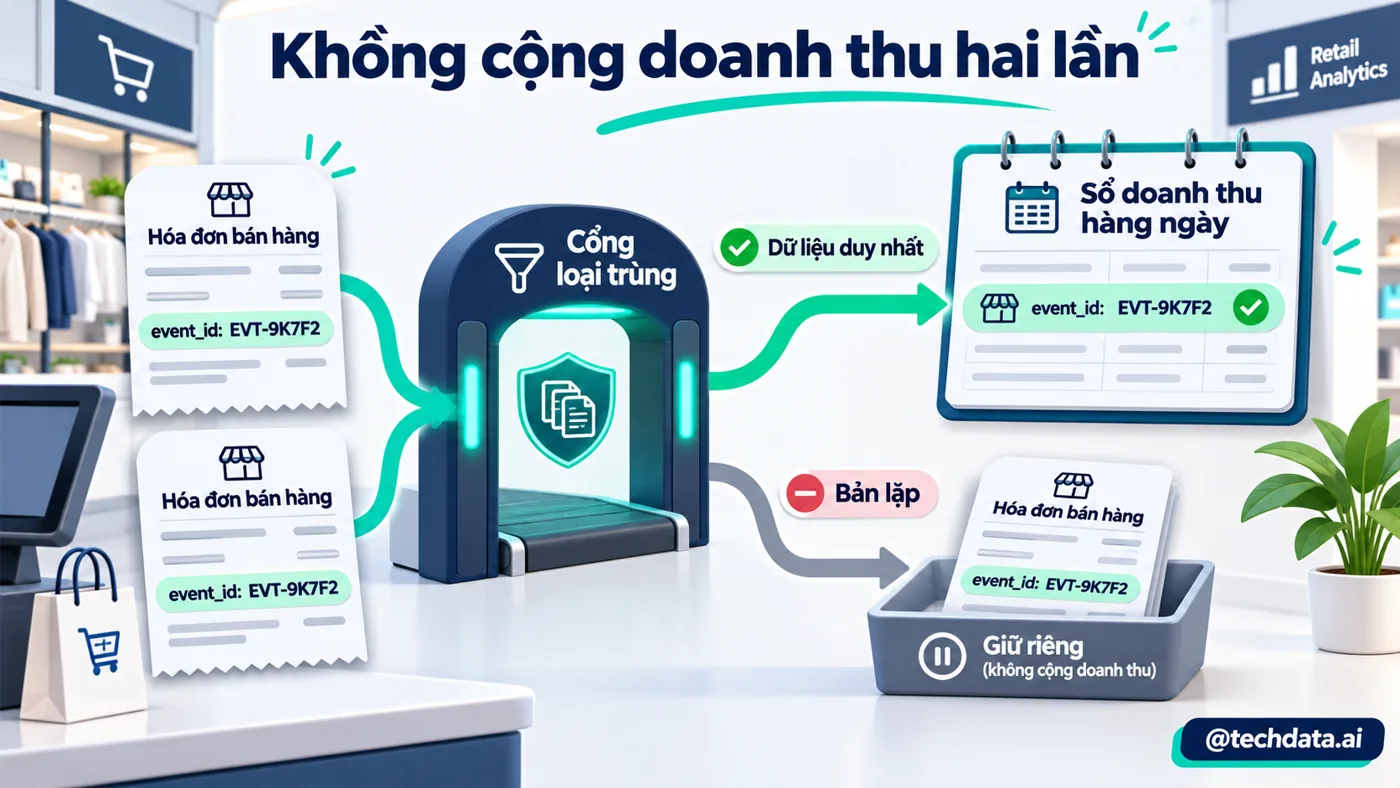
Nếu order_id trùng nhưng event_id khác, UNIQUE order_id báo lỗi thay vì tự cộng thêm. Đó là phát hiện vi phạm giả định một payment mỗi đơn. Nếu event_id trùng và payload giống nhau, consumer bỏ qua insert nên view không thay đổi. Không dùng SUM(DISTINCT amount_vnd) để chống trùng: hai đơn hợp lệ cùng số tiền vẫn phải được cộng hai lần.
Cách mở connection mỗi record thuận tiện cho lab, chưa tối ưu tải lớn. Production cân nhắc pool và batch, nhưng phải giữ transaction, kiểm tra duplicate và vị trí commit đúng. Không tăng tốc bằng cách commit offset trước khi database hoàn tất.
5. Chạy và đối soát trước khi vẽ biểu đồ
python analytics_consumer.py
# Terminal khác
python paid_producer.py
docker exec kafka5-pg psql -U lab -d orderslab -c "SELECT count(*),sum(amount_vnd) FROM fact_paid;"
docker exec kafka5-pg psql -U lab -d orderslab -c "SELECT * FROM v_daily_sales ORDER BY sales_date,store_id;"Trên database lab ban đầu rỗng, kỳ vọng 20 fact, tổng 2.100.000 đồng; hai dòng view cho HCM và HN như đã tính. Chạy lại producer: Kafka có thể có thêm record cùng ID nhưng fact vẫn 20 dòng. Sau đó chạy consumer bằng group mới để replay và đối chiếu count/sum không đổi.
GROUP_ID=analytics-replay-v1 python analytics_consumer.pyNếu số liệu sai ở SQL, chưa sửa bằng DAX để làm chart “đúng”. Hãy tìm lỗi từ event, duplicate, timezone và transaction. Dashboard nên thể hiện định nghĩa dữ liệu đã được kiểm tra, không che vấn đề ở pipeline.
6. Kết nối Power BI và tạo báo cáo
Trong Power BI Desktop chọn Get Data, PostgreSQL database. Server là localhost:5433 khi Power BI chạy trên cùng máy truy cập được port Docker; database là orderslab. Chọn chế độ DirectQuery cho bài quan sát độ mới, đăng nhập tài khoản lab rồi chọn v_daily_sales. Nếu Docker chạy trên máy khác, thay localhost bằng địa chỉ phù hợp và cấu hình mạng/bảo mật theo môi trường.
Tạo Card tổng gross_paid_vnd, Card tổng paid_orders, cột doanh thu theo store_id và biểu đồ theo sales_date. Có thể tạo measure dưới đây. Trong view, mỗi dòng là một ngày và một cửa hàng nên SUM paid_orders là số đơn trong phạm vi filter, không phải COUNTROWS(view).
Gross Paid VND = SUM(v_daily_sales[gross_paid_vnd])
Paid Orders = SUM(v_daily_sales[paid_orders])
Average Paid Order = DIVIDE([Gross Paid VND], [Paid Orders])
Với bộ mẫu không lọc cửa hàng, ba measure lần lượt là 2.100.000 đồng, 20 và 105.000 đồng/đơn. Định dạng tiền VND và đặt tên “Gross Paid” rõ phạm vi; chưa gọi là net revenue sau hoàn tiền.
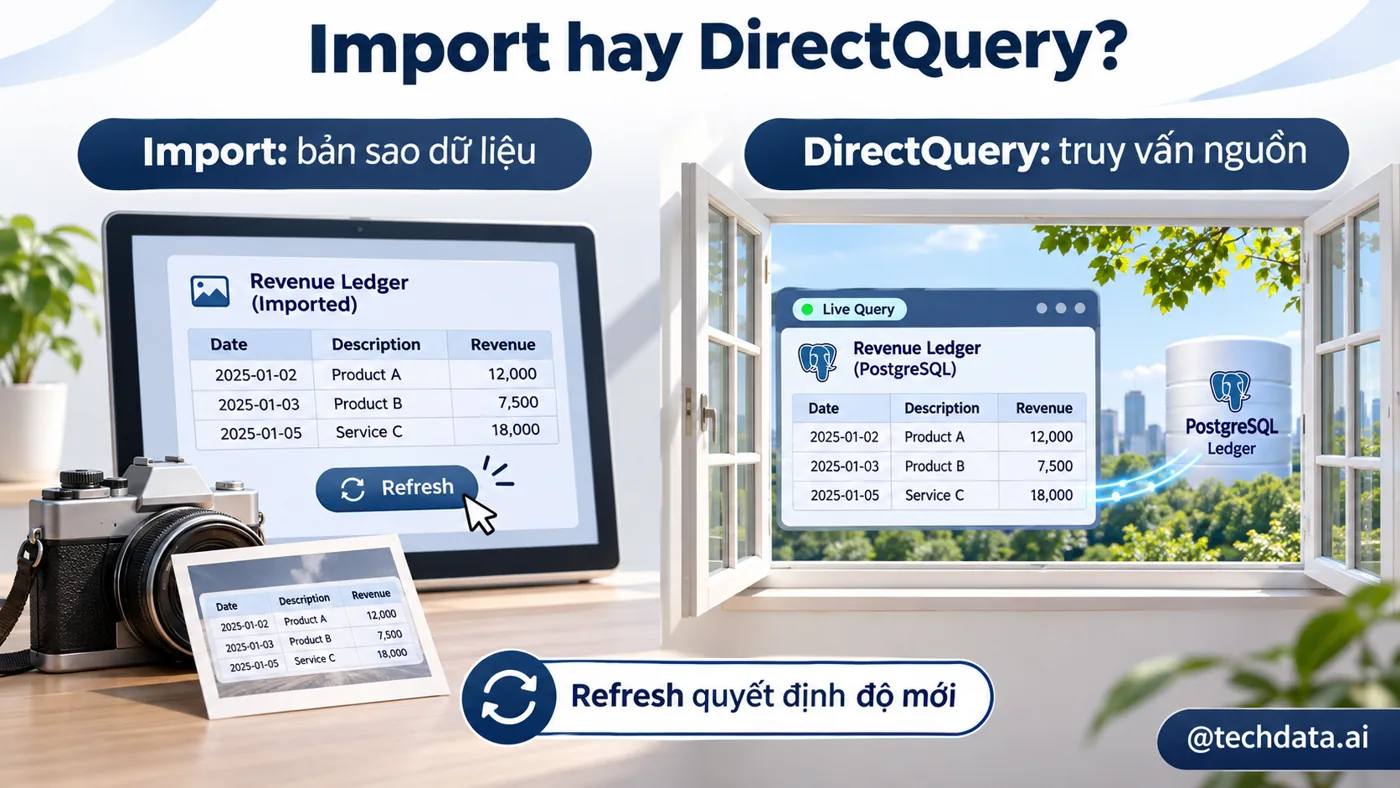
Import tải dữ liệu vào semantic model và cần refresh để thấy thay đổi. DirectQuery truy vấn nguồn khi visual cần dữ liệu nhưng vẫn chịu query/cache và refresh behavior. Automatic page refresh áp dụng cho DirectQuery; giới hạn khi publish phụ thuộc workspace/capacity và thiết lập quản trị. Không hứa dashboard service tự cập nhật mỗi giây chỉ vì Desktop cho chọn khoảng ngắn.
Để thử local, bật Page refresh trên trang DirectQuery và chọn khoảng hợp lý với thời gian query. Tạo một event mới bằng cách thêm ID 021 trong producer, chạy gửi và quan sát SQL trước, visual sau. Không chạy lại 20 event cũ rồi kỳ vọng doanh thu tăng vì consumer sẽ loại trùng. Khi publish lên Power BI service, database local thường cần gateway và cấu hình nguồn dữ liệu; service không truy cập localhost của laptop bạn.
7. Dữ liệu đến muộn và cách đo latency
Nếu payment xảy ra hôm qua nhưng consumer nhận hôm nay, view theo occurred_at cập nhật ngày hôm qua. Đây là hành vi đúng cho báo cáo event time của lab. Nếu GROUP BY stored_at, báo cáo sẽ chuyển giao dịch sang ngày xử lý, làm số liệu khác. Cần thống nhất với nghiệp vụ trước khi xây SLA và đối soát.
SELECT event_id, occurred_at, stored_at,
       extract(epoch FROM stored_at-occurred_at) AS event_to_store_seconds
FROM fact_paid ORDER BY stored_at DESC LIMIT 10;
Với dữ liệu mẫu có timestamp cố định, chênh lệch trên không phải benchmark pipeline. Muốn đo thật, tạo event mới tại thời điểm phát bằng đồng hồ UTC đồng bộ và ghi nhận các mốc. Theo dõi cả consumer lag, event-to-store latency, query duration và thời gian visual thấy dữ liệu. Một chỉ số riêng lẻ không mô tả toàn bộ trải nghiệm.
Nếu dữ liệu tăng lớn, view tổng hợp trực tiếp có thể quét nhiều fact. Cân nhắc index theo filter, partition bảng, aggregate mart hoặc warehouse phù hợp. Materialized view không tự cập nhật sau mỗi event; nó cần refresh. Tăng tần suất Power BI query quá cao có thể gây tải lên PostgreSQL mà không đem lại giá trị nghiệp vụ.
8. Bài tập và vận hành
Bài 1: thêm payment mới với amount_vnd 300.000 và event_id mới. Kỳ vọng tổng tăng đúng 300.000; gửi lại cùng payload không tăng nữa.
Bài 2: tạo event xảy ra 17:30 UTC của ngày trước và xem sales_date theo giờ Việt Nam. Gợi ý: UTC+7 có thể chuyển ngày; hãy tính bằng SQL AT TIME ZONE thay vì cắt chuỗi timestamp.
Bài 3: mô tả refund. Gợi ý: không sửa payment event cũ tùy tiện; thiết kế refund event và fact điều chỉnh, xác định gross, refund và net riêng. Với CDC snapshot, không coi mỗi dòng snapshot là một payment mới.
Bài tiếp theo xây retry và dead letter topic để một event lỗi không làm pipeline ngừng vô thời hạn, đồng thời giữ nguyên nguyên tắc không mất message và không tạo tác dụng phụ trùng.
Tài liệu tham khảo
- Microsoft: Automatic Page Refresh — DirectQuery và giới hạn capacity.
- Microsoft: Data Refresh — Import, DirectQuery và refresh.
- PostgreSQL Date/Time Functions — timezone và thời gian.
- Psycopg Transactions — transaction sink.
@techdata.ai · Series Apache Kafka