


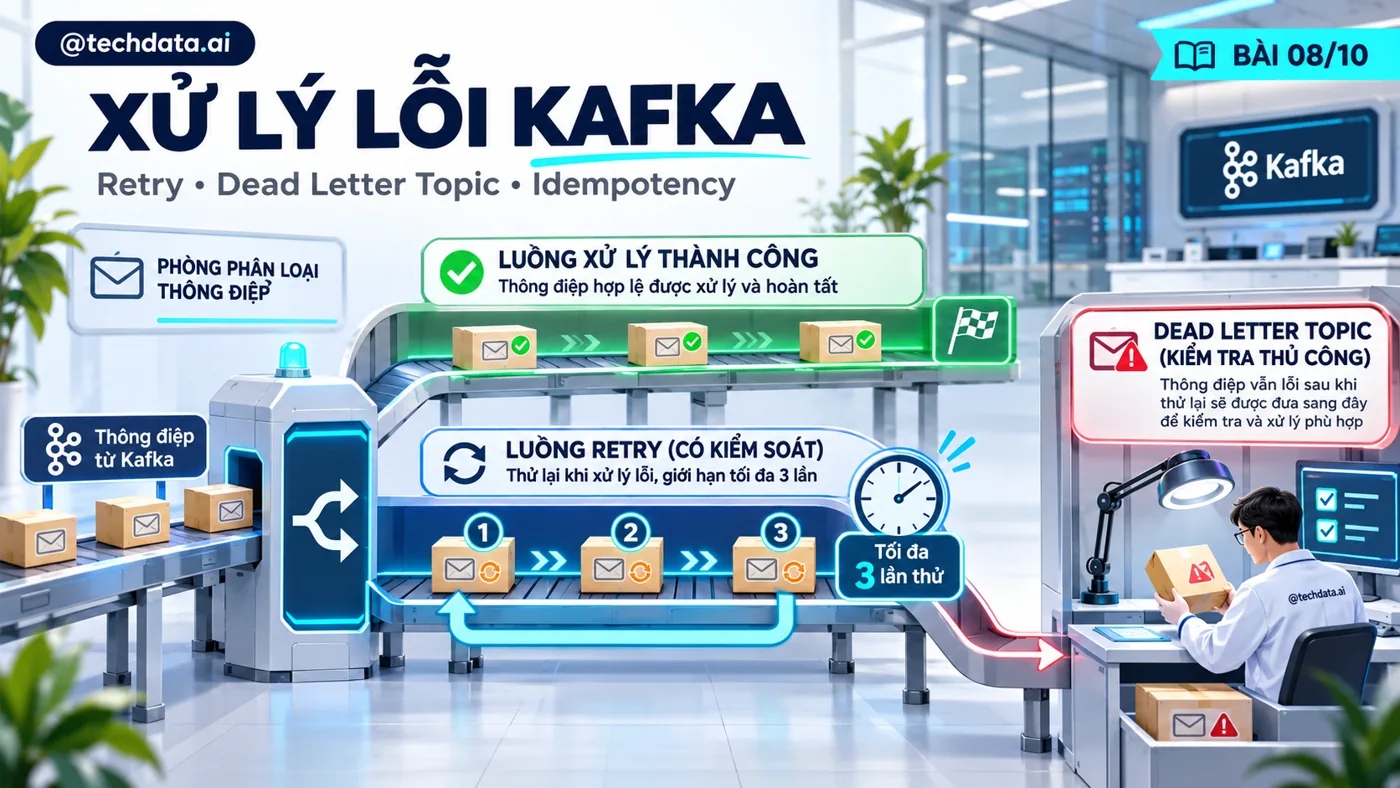

Series Apache Kafka · Bài 8/10. Consumer đang xử lý tốt thì gặp JSON sai hoặc database tạm thời gián đoạn. Nếu cứ retry vô hạn, pipeline có thể kẹt; nếu bỏ qua rồi commit, dữ liệu lỗi có thể biến mất khỏi quy trình xử lý. Bài này xây retry có giới hạn và Dead Letter Topic, giữ record gốc để điều tra và replay có kiểm soát.
Lab dùng Kafka bài 2, Python confluent-kafka và Psycopg 3 cùng PostgreSQL lab bài 5. Ta xử lý tuần tự từng record, retry ngắn tại chỗ và lưu tác dụng phụ vào bảng có event_id duy nhất. Đây là cách làm dễ quan sát để hiểu semantics; tải lớn cần chiến lược partition và retry phù hợp.
Mục lục
- Phân loại lỗi
- Quy tắc commit và chuyển DLT
- Chuẩn bị topic và bảng
- Tạo dữ liệu thành công và lỗi
- Consumer retry có giới hạn
- Chạy và đối soát
- Replay và thứ tự
- Vận hành
- Tài liệu tham khảo
1. Lỗi tạm thời và lỗi dữ liệu cần cách xử lý khác nhau
Database đang khởi động, kết nối bị reset hoặc dịch vụ phụ thuộc trả lỗi tạm thời có thể thành công ở lần sau. JSON sai cú pháp, thiếu trường bắt buộc hoặc số tiền âm thường không tự đúng lên chỉ vì chờ hai giây. Retry mọi lỗi bằng một vòng lặp duy nhất vừa tốn tài nguyên vừa che nguyên nhân.
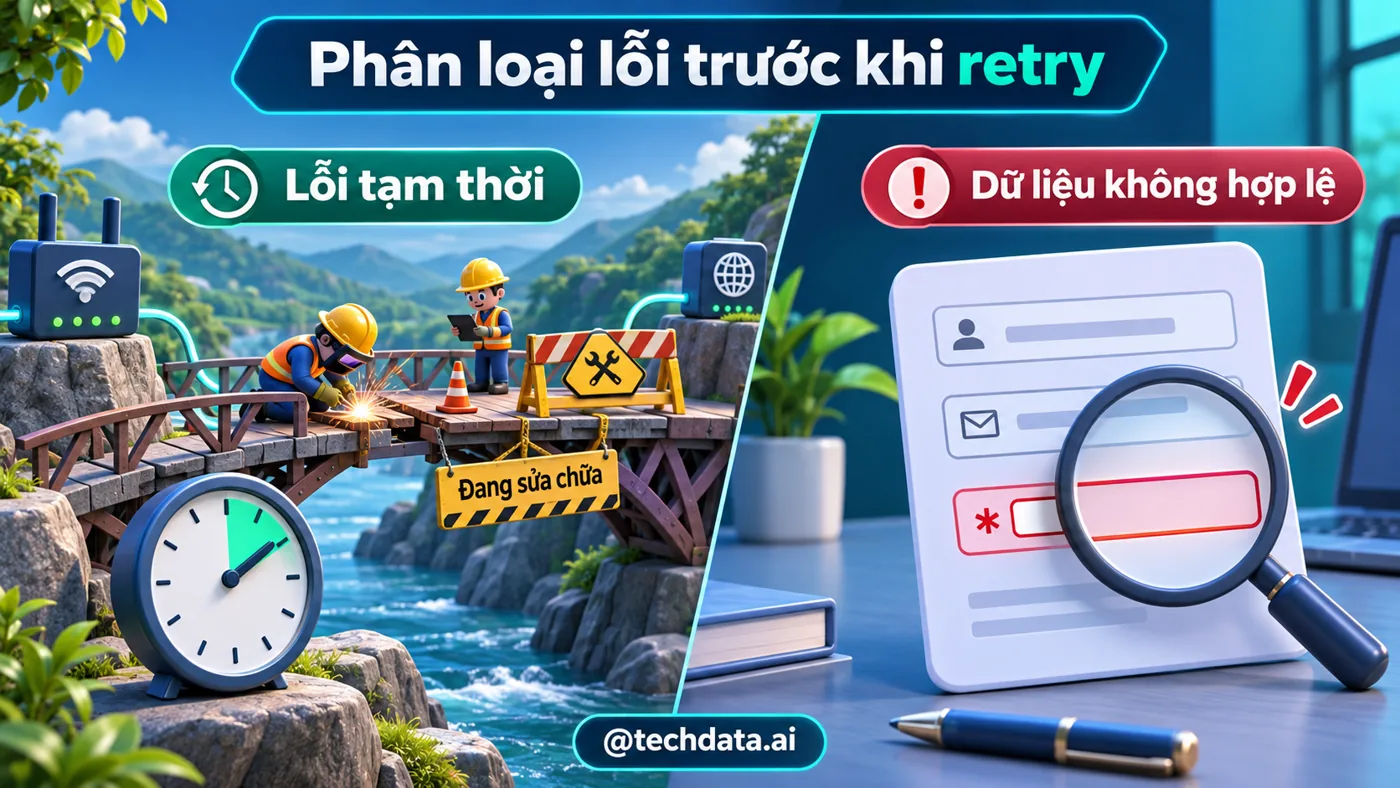
Một lỗi lập trình ngoài dự kiến, ví dụ KeyError do code thiếu kiểm tra, không nên tự động bị coi là record độc hại rồi chuyển hết vào DLT. Lab chỉ phân loại rõ các lỗi đã biết; lỗi bất ngờ làm tiến trình dừng và cảnh báo. DLT là nơi giữ thông tin để giải quyết, không phải thùng rác giúp dashboard lag về 0.
2. Hai đường hoàn tất một record
Đường thành công: xử lý nghiệp vụ và commit PostgreSQL trước, sau đó commit offset nguồn. Đường thất bại đã phân loại: publish bản ghi DLT và chờ delivery ACK trước, sau đó commit offset nguồn. Nếu DLT chưa được xác nhận, không commit nguồn. Nhờ vậy record lỗi chưa có nơi giữ không bị bỏ qua chỉ vì consumer tiến offset.
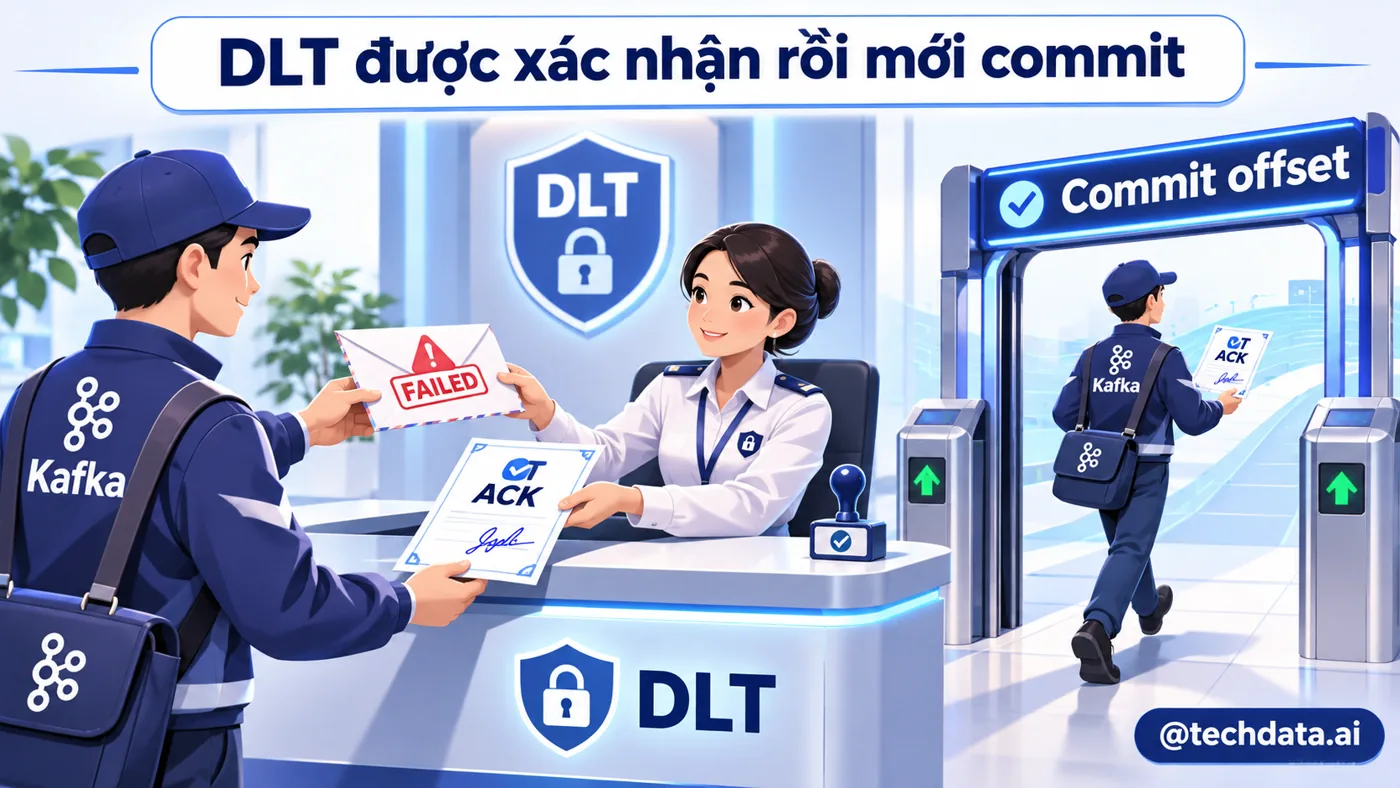
Vẫn có cửa sổ trùng: DLT đã ghi thành công nhưng consumer chết trước commit nguồn thì lần đọc lại có thể phát DLT lần nữa. Ta dùng địa chỉ topic:partition:offset làm source_id ổn định để công cụ DLT nhận diện lặp. Đây là at-least-once handoff, không phải transaction Kafka bao trùm mọi hệ thống.
3. Tạo topic riêng và bảng kết quả
docker exec kafka-lab /opt/kafka/bin/kafka-topics.sh --bootstrap-server localhost:9092 --create --topic retry_orders_v1 --partitions 1 --replication-factor 1
docker exec kafka-lab /opt/kafka/bin/kafka-topics.sh --bootstrap-server localhost:9092 --create --topic retry_orders_v1.dlt --partitions 1 --replication-factor 1
Một partition giúp quan sát thứ tự và kết quả dễ hơn. Dùng topic mới cho lần thử đầu; nếu làm lại nhiều lần, đổi hậu tố trong cả seed và worker. Tạo retry_schema.sql rồi nhập bằng lệnh như bài 5.
CREATE TABLE IF NOT EXISTS retry_results (
  event_id text PRIMARY KEY,
  payload jsonb NOT NULL,
  processed_at timestamptz NOT NULL DEFAULT now()
);
docker exec -i kafka5-pg psql -U lab -d orderslab < retry_schema.sql4. Seed bốn record có kết quả dự kiến
Tạo seed_retry.py. Hai event hợp lệ gồm một event thành công ngay và một event mô phỏng lỗi tạm thời hai lần. Một JSON hợp lệ nhưng amount âm và một payload không phải JSON phải sang DLT. Các scenario chỉ dùng để tạo lỗi có kiểm soát trong bài học.
import json
from confluent_kafka import Producer
p = Producer({"bootstrap.servers":"localhost:9092","enable.idempotence":True,"acks":"all"})
records = [
    {"event_id":"retry-ok-1","amount_vnd":100000,"scenario":"ok"},
    {"event_id":"retry-temp-1","amount_vnd":200000,"scenario":"transient"},
    {"event_id":"retry-invalid-1","amount_vnd":-1,"scenario":"ok"},
]
errors=[]
def done(err,msg):
    if err:
        errors.append(str(err))
for event in records:
    p.produce("retry_orders_v1",value=json.dumps(event).encode(),on_delivery=done)
p.produce("retry_orders_v1",value=b"this is not json",on_delivery=done)
if p.flush(30) or errors:
    raise SystemExit(errors)
print("4 records delivered")
5. Worker retry ngắn và publish DLT trước commit
Tạo retry_worker.py. Lỗi validation chuyển thẳng DLT. Lỗi mô phỏng TransientError và Psycopg OperationalError được thử tối đa ba lần tổng cộng, chờ một rồi hai giây. Lỗi database kéo dài trong ví dụ sẽ sang DLT sau giới hạn; production có thể chọn pause/circuit breaker thay vì đẩy hàng loạt dữ liệu tốt sang DLT.
import base64
import json
import os
import time
from datetime import datetime, timezone
import psycopg
from psycopg.types.json import Jsonb
from confluent_kafka import Consumer, Producer, KafkaException

DSN=os.getenv("PG_DSN","postgresql://lab:labpass@localhost:5433/orderslab")
TOPIC="retry_orders_v1"
class PermanentError(Exception): pass
class TransientError(Exception): pass
attempts={}
producer=Producer({"bootstrap.servers":"localhost:9092","enable.idempotence":True,
                   "acks":"all","delivery.timeout.ms":10000})
consumer=Consumer({"bootstrap.servers":"localhost:9092","group.id":"retry-worker-v1",
                   "auto.offset.reset":"earliest","enable.auto.commit":False,
                   "max.poll.interval.ms":300000})

def parse(raw):
    try:
        e=json.loads(raw.decode("utf-8"))
    except (UnicodeDecodeError,json.JSONDecodeError,AttributeError) as exc:
        raise PermanentError("Invalid UTF-8 JSON") from exc
    if not isinstance(e,dict) or not isinstance(e.get("event_id"),str) or not e["event_id"]:
        raise PermanentError("Missing event_id")
    if type(e.get("amount_vnd")) is not int or e["amount_vnd"]<=0:
        raise PermanentError("Invalid amount")
    return e

def process(e):
    eid=e["event_id"]
    attempts[eid]=attempts.get(eid,0)+1
    if e.get("scenario")=="transient" and attempts[eid]<=2:
        raise TransientError("Simulated temporary dependency failure")
    with psycopg.connect(DSN,connect_timeout=3) as conn:
        with conn.cursor() as cur:
            cur.execute("SET LOCAL statement_timeout='3s'")
            cur.execute("INSERT INTO retry_results(event_id,payload) VALUES (%s,%s) ON CONFLICT DO NOTHING RETURNING event_id",(eid,Jsonb(e)))
            if not cur.fetchone():
                cur.execute("SELECT payload FROM retry_results WHERE event_id=%s",(eid,))
                if cur.fetchone()[0]!=e:
                    raise PermanentError("Conflicting event_id")

def send_dlt(msg,error,total_attempts):
    source_id=f"{msg.topic()}:{msg.partition()}:{msg.offset()}"
    envelope={"source_id":source_id,"source_topic":msg.topic(),
              "source_partition":msg.partition(),"source_offset":msg.offset(),
              "key_base64":None if msg.key() is None else base64.b64encode(msg.key()).decode(),
              "value_base64":None if msg.value() is None else base64.b64encode(msg.value()).decode(),
              "error_type":type(error).__name__,"error_message":str(error),
              "attempts":total_attempts,"failed_at":datetime.now(timezone.utc).isoformat()}
    result=[]
    producer.produce(TOPIC+".dlt",key=source_id.encode(),value=json.dumps(envelope).encode(),
                     on_delivery=lambda err,m:result.append(err))
    pending=producer.flush(12)
    if pending or not result or result[0] is not None:
        raise RuntimeError("DLT not acknowledged; source offset not committed")
    print("DLT",source_id,flush=True)

consumer.subscribe([TOPIC])
try:
    while True:
        msg=consumer.poll(1.0)
        if msg is None: continue
        if msg.error(): raise KafkaException(msg.error())
        failure=None
        used=0
        for attempt in range(1,4):
            used=attempt
            try:
                event=parse(msg.value())
                process(event)
                failure=None
                print("SUCCESS",event["event_id"],"attempt",attempt,flush=True)
                break
            except PermanentError as exc:
                failure=exc
                break
            except (TransientError,psycopg.OperationalError) as exc:
                failure=exc
                print("RETRY",attempt,str(exc),flush=True)
                if attempt<3: time.sleep(attempt)
        if failure is not None:
            send_dlt(msg,failure,used)
        consumer.commit(message=msg,asynchronous=False)
except KeyboardInterrupt:
    print("Stopping")
finally:
    consumer.close()
Không có except Exception rồi commit để che lỗi. Nếu producer DLT lỗi, send_dlt ném exception và consumer đóng mà chưa commit record nguồn. Nếu commit Kafka lỗi sau database thành công, unique event_id giúp lần đọc lại không tạo tác dụng phụ thêm trong retry_results.
max.poll.interval phải lớn hơn tổng thời gian xử lý/retry tối đa dự kiến; đặt một số lớn không thay thế timeout thực của dependency. Lab có connect_timeout và statement_timeout ngắn, delay một/hai giây để tránh sleep dài. Hệ thống nhiều partition có thể pause partition lỗi và tiếp tục poll/heartbeat; retry topic là lựa chọn khác nhưng tạo thêm vấn đề thứ tự.
Bộ đếm attempts mô phỏng lỗi nằm trong RAM nên reset khi tiến trình restart. Giới hạn ba lần ở đây áp dụng cho một lượt xử lý sau poll, không phải ngân sách retry bền vững xuyên mọi lần restart. Nếu cần giới hạn toàn vòng đời event, lưu attempt/retry metadata ở topic hoặc database và có chính sách replay rõ ràng.
6. Chạy và đối soát kết quả
python retry_worker.py
# Terminal khác
python seed_retry.py
Trên topic mới và bảng lab rỗng, retry-ok-1 thành công ở lần một; retry-temp-1 thành công ở lần ba; amount âm và text không phải JSON sang DLT. retry_results có hai event_id duy nhất. DLT có hai source_id duy nhất; số record DLT vật lý có thể lớn hơn nếu bạn cố tình restart ở cửa sổ handoff.
docker exec kafka5-pg psql -U lab -d orderslab -c "SELECT event_id,payload FROM retry_results ORDER BY event_id;"
docker exec kafka-lab /opt/kafka/bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic retry_orders_v1.dlt --from-beginning
value_base64 giữ nguyên bytes gốc, kể cả payload không decode được UTF-8. Trong Python, base64.b64decode(envelope["value_base64"]) khôi phục bytes để điều tra. Không chỉ lưu thông báo lỗi rồi bỏ record gốc, vì sẽ khó sửa và phát lại đúng dữ liệu.
7. Replay và bảo toàn thứ tự
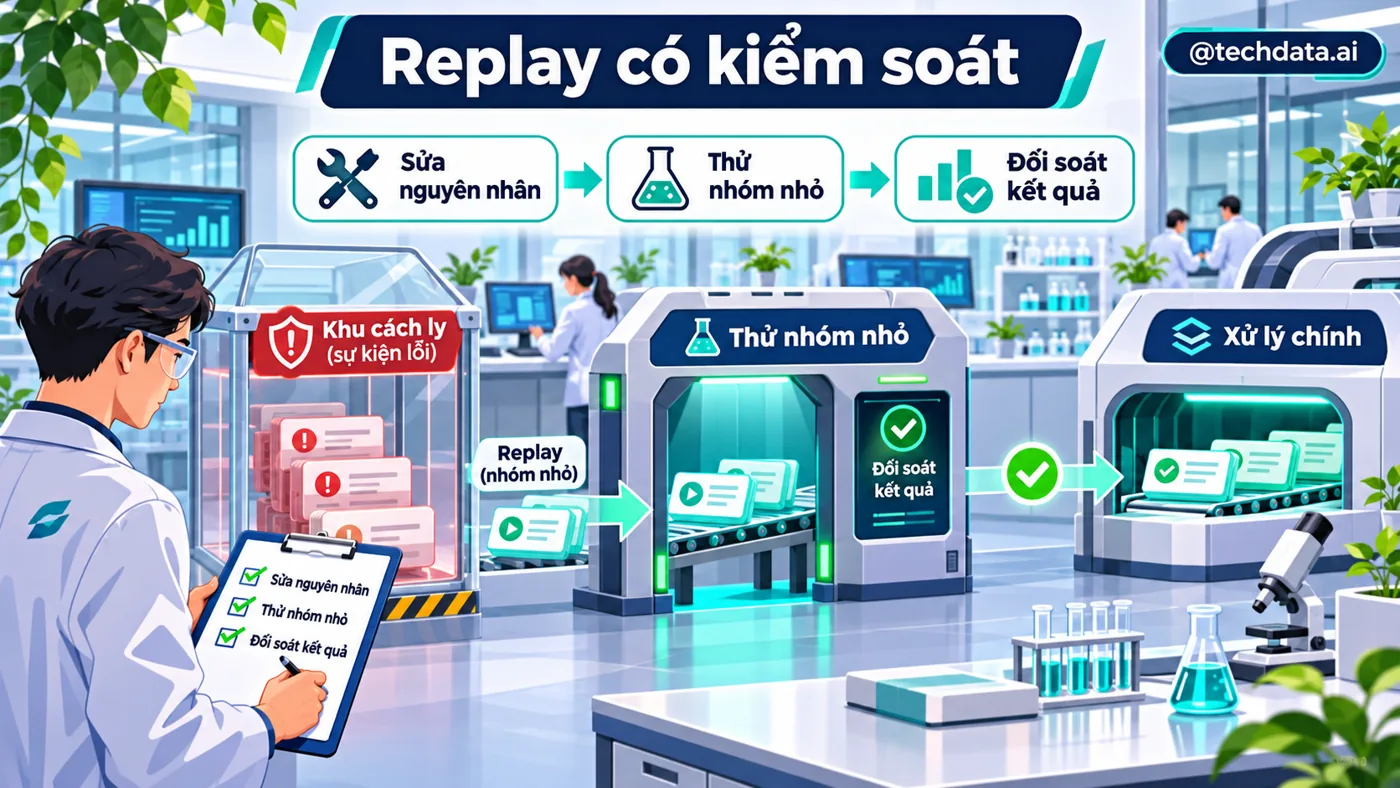
Quy trình replay cần xác định nguyên nhân đã được sửa, chọn source_id cần xử lý, thử một nhóm nhỏ, giữ event_id nghiệp vụ và ghi lại replay_run_id. Với lỗi JSON, cần sửa payload theo hợp đồng và lưu dấu bản sửa. Không tự động đẩy toàn bộ DLT về topic chính vô hạn vì có thể tạo vòng lặp lỗi và quá tải.
Khi chuyển record lỗi sang DLT rồi tiếp tục record sau, bạn đã cho phép luồng chính tiến qua một lỗ hổng nghiệp vụ. Nếu các event cùng key phụ thuộc thứ tự, chẳng hạn paid trước refund, bỏ event đầu có thể làm sai trạng thái sau. Có trường hợp phải block/pause key hoặc partition và xử lý sự cố thay vì ưu tiên lag thấp.
Retry topic tách xử lý lỗi ra khỏi luồng chính và cho phép delay dài hơn, nhưng không tự bảo toàn thứ tự với event mới ở topic gốc. Cần thiết kế idempotency, version, sequencing và quy tắc gộp lại. Không xem retry topic là cách thay thế mọi quyết định nghiệp vụ.
8. DLT cần người vận hành và số liệu
Theo dõi số record lỗi theo loại, tỷ lệ retry thành công, tuổi record DLT lâu nhất, số replay và số duplicate. Cảnh báo khi DLT không ghi được hoặc dependency ngừng hàng loạt. Phân quyền DLT vì payload lỗi có thể chứa thông tin cá nhân; retention và masking phải theo chính sách dữ liệu.
Bài tập: đổi scenario thành một loại lỗi luôn TransientError và dự đoán DLT sau ba lần; mô phỏng DLT broker không phản hồi và xác nhận worker không commit nguồn; chạy lại cùng event_id rồi kiểm tra retry_results không tăng dòng. Khi thử lỗi hạ tầng chỉ thao tác trong lab của bạn, không dừng broker production.
Bài tiếp theo dùng Spark Structured Streaming để đọc Kafka và tính doanh thu theo cửa sổ event time, với checkpoint và watermark để giải thích phục hồi cùng dữ liệu đến muộn.
Tài liệu tham khảo
- Confluent Python API — callback delivery và commit.
- Apache Kafka Design — delivery semantics và consumer offset.
- Psycopg Transactions — transaction và lỗi database.
@techdata.ai · Series Apache Kafka
Comments are closed!