


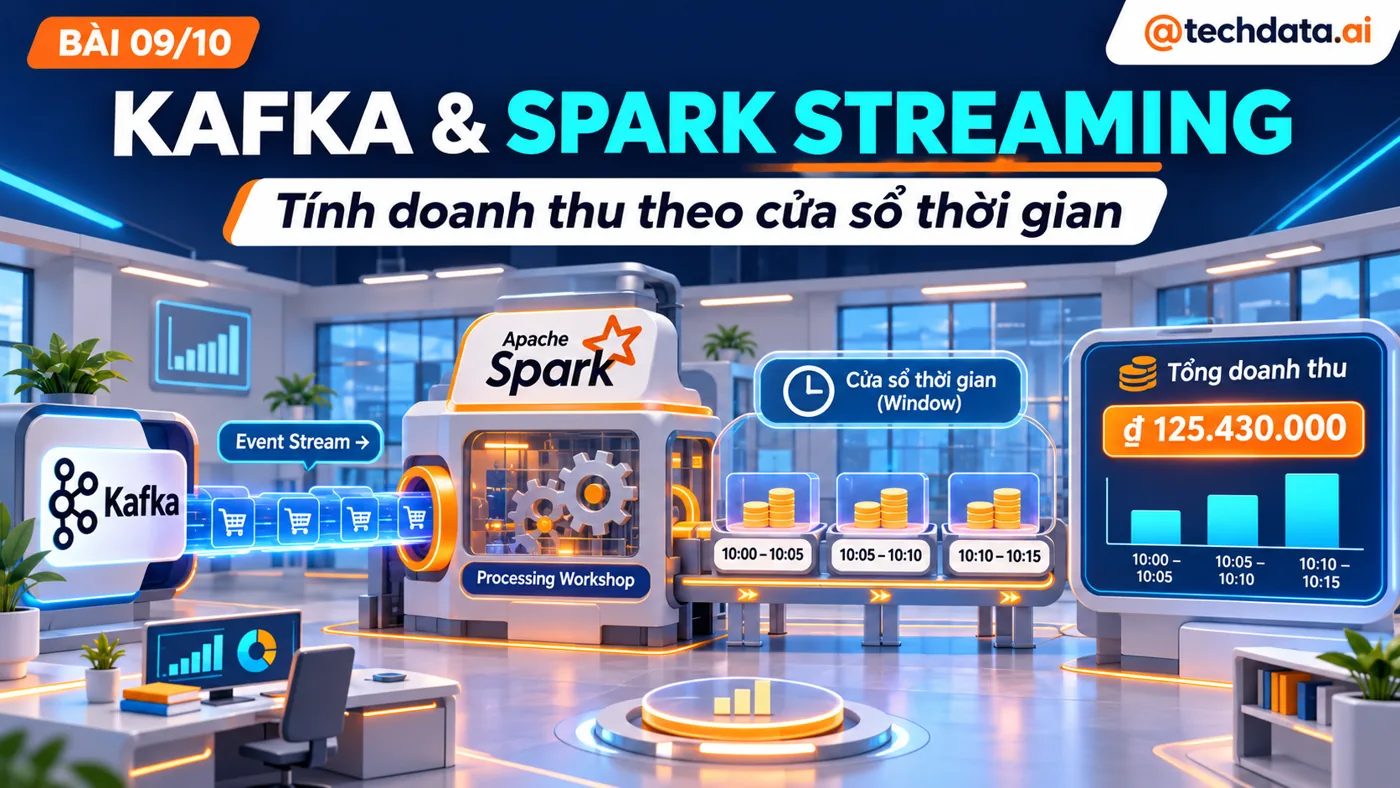

Series Apache Kafka · Bài 9/10. Python consumer phù hợp khi xử lý từng event và ghi database. Khi cần tổng hợp liên tục theo cửa sổ thời gian, quản lý state và phân phối tính toán, Spark Structured Streaming cung cấp mô hình DataFrame trên luồng dữ liệu. Bài này đọc Kafka, parse JSON và tính số đơn cùng tổng tiền theo window năm phút.
Lab pin PySpark 4.1.2 và Kafka connector cùng phiên bản, dùng Java 17 và Python 3.10 trở lên. Spark chạy local trên host, đọc Kafka localhost:9092 của bài 2. Kết quả cuối cửa sổ được ghi Parquet vào thư mục local, checkpoint giữ riêng để phục hồi. Đây là micro-batch lab, không phải cấu hình cluster production.
Mục lục
- Kafka và Spark làm phần việc nào
- Chuẩn bị môi trường
- Dữ liệu có event time
- Viết streaming query
- Window và watermark
- Chạy và đối soát
- Checkpoint và restart
- Duplicate, lỗi dữ liệu và sink
- Bài tập
- Tài liệu tham khảo
1. Kafka giữ luồng, Spark tính toán trên luồng
Kafka lưu và phân phối event theo partition. Spark đọc record, chuyển thành cột có schema, nhóm theo window rồi giữ state các nhóm đang mở. State chứa những tổng đang tính; khi đủ điều kiện đóng cửa sổ, Spark xuất kết quả và có thể giải phóng state theo watermark. Kafka retention và Spark state retention là hai cơ chế khác nhau.
Micro-batch gom dữ liệu đến thành các đợt xử lý nhỏ. Trigger năm giây là nhịp kiểm tra/xử lý, không phải window năm giây và không đảm bảo latency chính xác năm giây. Window năm phút là cách nhóm theo timestamp trong event, độc lập với thời gian một batch chạy.
2. Chuẩn bị Java, PySpark và Kafka connector
java -version
python -m pip install "pyspark==4.1.2" "confluent-kafka==2.16.1"
docker exec kafka-lab /opt/kafka/bin/kafka-topics.sh --bootstrap-server localhost:9092 --create --topic spark_sales_v1 --partitions 3 --replication-factor 1
Java phải được cài và JAVA_HOME trỏ đúng nếu hệ điều hành yêu cầu. spark-submit được cài cùng PySpark trong môi trường ảo. Lần đầu --packages cần truy cập Maven để tải Kafka connector và dependencies. Không trộn connector Spark 3.5 với runtime 4.1 hoặc suffix Scala 2.12 với 2.13 của bộ đã chọn.
Tạo thư mục kafka-spark-lab và chạy các file tại đây để đường dẫn checkpoint/output nhất quán. Với topic đã dùng, chọn tên mới và sửa cả producer/query. Giữ dữ liệu nguồn đủ lâu để Spark đọc bù; checkpoint không chứa bản sao toàn bộ Kafka message.
3. Tạo dữ liệu có thể tính tay
Tạo seed_spark.py. Chương trình có hai chế độ: initial gửi ba event ở các mốc 10:01, 10:03 và 10:06 UTC; advance gửi thêm event 10:20 và 10:21 để đẩy event time quan sát tiến lên. Đơn vị tiền là VND.
import json
import sys
from confluent_kafka import Producer

mode=sys.argv[1] if len(sys.argv)>1 else "initial"
sets={
 "initial":[("S1","2026-11-13T10:01:00Z",100000),
            ("S2","2026-11-13T10:03:00Z",200000),
            ("S3","2026-11-13T10:06:00Z",300000)],
 "advance":[("S4","2026-11-13T10:20:00Z",10000),
            ("S5","2026-11-13T10:21:00Z",10000)],
 "late":[("S6","2026-11-13T10:02:00Z",50000)]
}
p=Producer({"bootstrap.servers":"localhost:9092","enable.idempotence":True,"acks":"all"})
errors=[]
def done(err,msg):
    if err: errors.append(str(err))
for eid,ts,amount in sets[mode]:
    event={"event_id":eid,"store_id":"HCM","occurred_at":ts,"amount_vnd":amount}
    p.produce("spark_sales_v1",key=eid.encode(),value=json.dumps(event).encode(),on_delivery=done)
if p.flush(30) or errors: raise SystemExit(errors)
print("Delivered",mode)
Không chạy initial nhiều lần trong cùng thí nghiệm: Spark query dưới đây tổng hợp record đầu vào, chưa deduplicate theo event_id. Idempotent producer không loại việc bạn chủ động chạy lại một chương trình và gửi lại cùng payload. Phần cuối bài sẽ phân biệt việc replay do engine với duplicate có trong nguồn.
4. Viết streaming query với schema rõ ràng
Tạo sales_stream.py. Kafka source trả key/value dạng binary cùng metadata topic, partition và offset. Chúng ta cast value sang string, parse JSON theo StructType rồi chuyển occurred_at thành timestamp. Session timezone được đặt UTC để cửa sổ và kết quả lab có cùng cách diễn giải.
from pyspark.sql import SparkSession, functions as F, types as T

spark=(SparkSession.builder.appName("KafkaSalesWindows")
       .config("spark.sql.session.timeZone","UTC")
       .config("spark.sql.shuffle.partitions","3").getOrCreate())
spark.sparkContext.setLogLevel("WARN")
schema=T.StructType([
    T.StructField("event_id",T.StringType()),
    T.StructField("store_id",T.StringType()),
    T.StructField("occurred_at",T.StringType()),
    T.StructField("amount_vnd",T.LongType()),
])
raw=(spark.readStream.format("kafka")
     .option("kafka.bootstrap.servers","localhost:9092")
     .option("subscribe","spark_sales_v1")
     .option("startingOffsets","earliest")
     .option("maxOffsetsPerTrigger",1000)
     .load())
parsed=(raw.select(F.from_json(F.col("value").cast("string"),schema,{"mode":"FAILFAST"}).alias("e"))
        .select("e.*")
        .withColumn("event_time",F.to_timestamp("occurred_at")))
valid=parsed.filter(F.col("event_id").isNotNull() & F.col("store_id").isNotNull()
                    & F.col("event_time").isNotNull() & (F.col("amount_vnd")>0))
summary=(valid.withWatermark("event_time","2 minutes")
         .groupBy(F.window("event_time","5 minutes"),"store_id")
         .agg(F.count("*").alias("paid_orders"),F.sum("amount_vnd").alias("gross_paid_vnd"))
output=summary.select(F.col("window.start").alias("window_start"),
                      F.col("window.end").alias("window_end"),
                      "store_id","paid_orders","gross_paid_vnd")
query=(output.writeStream.format("parquet").outputMode("append")
       .option("path","output/sales_v1")
       .option("checkpointLocation","checkpoints/sales_v1")
       .trigger(processingTime="5 seconds").start())
query.awaitTermination()
startingOffsets=earliest xác định điểm bắt đầu của query mới. Khi restart với checkpoint có sẵn, Spark phục hồi tiến độ từ checkpoint thay vì tự đọc lại toàn topic theo earliest. maxOffsetsPerTrigger giới hạn số offset đọc mỗi trigger, không thay đổi retention hay biến thành giới hạn tốc độ chính xác mỗi giây.
Schema dùng LongType cho tiền nguyên đồng. FAILFAST giúp JSON malformed làm query lỗi thay vì âm thầm biến thành null. Bộ lọc valid loại record thiếu trường hoặc amount không hợp lệ trong lab có dữ liệu chuẩn; production phải ghi nhánh invalid/quarantine cùng metadata và đếm lỗi, không lọc mất dữ liệu mà không cảnh báo.
5. Hiểu window, watermark và output mode
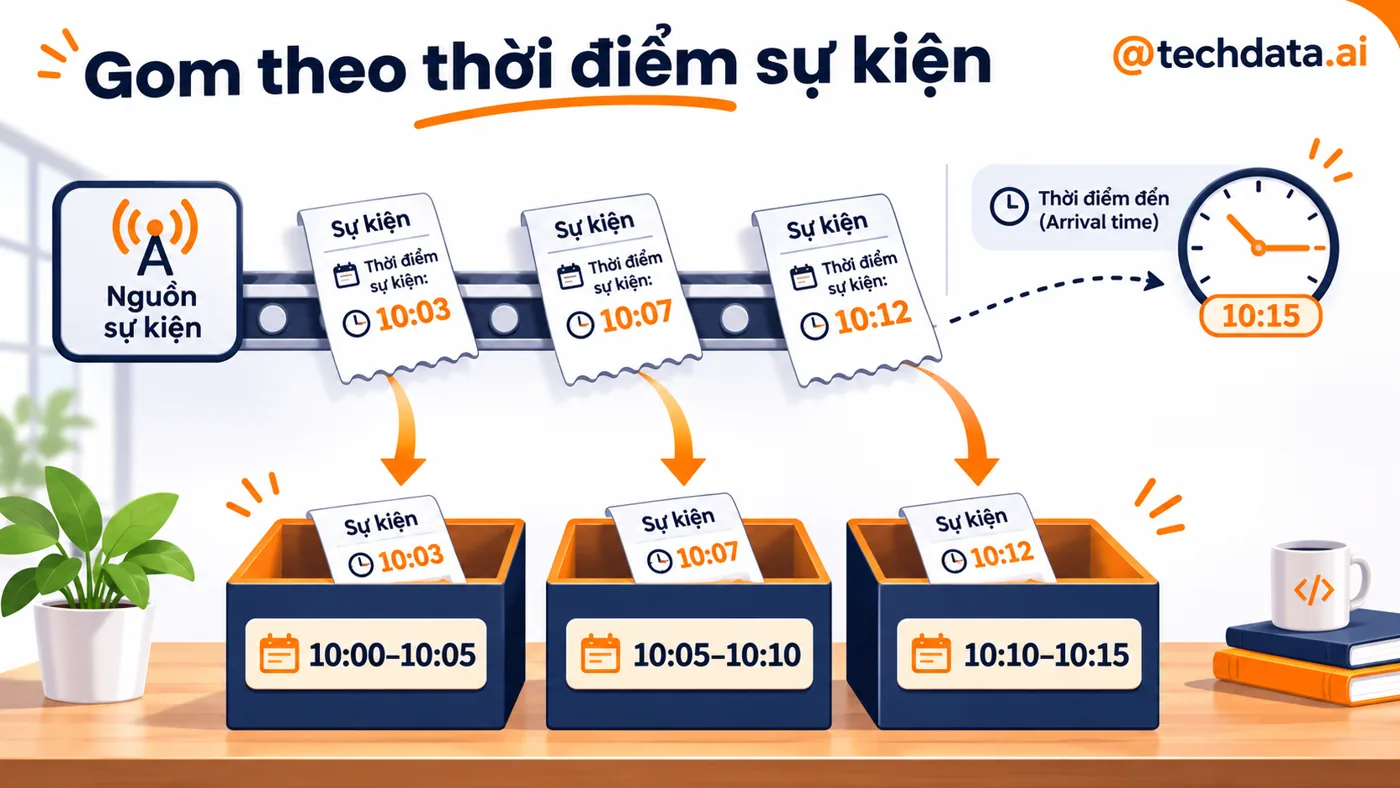
Window tumbling năm phút là các khoảng không chồng lấn như [10:00,10:05) và [10:05,10:10). Mốc đầu được tính vào, mốc cuối thuộc cửa sổ kế tiếp. Vì vậy S1 và S2 cùng nhóm 10:00–10:05, S3 thuộc 10:05–10:10. Store_id là chiều nhóm bổ sung.
withWatermark đặt ngưỡng chấp nhận trễ theo event time. Với độ trễ hai phút, watermark được xác định từ thời gian sự kiện lớn nhất đã quan sát, có độ trễ cập nhật theo engine/batch. Nó không bằng đồng hồ máy trừ hai phút trong mọi thời điểm. Không có event mới tiến thời gian thì cửa sổ cuối có thể chưa được đóng.
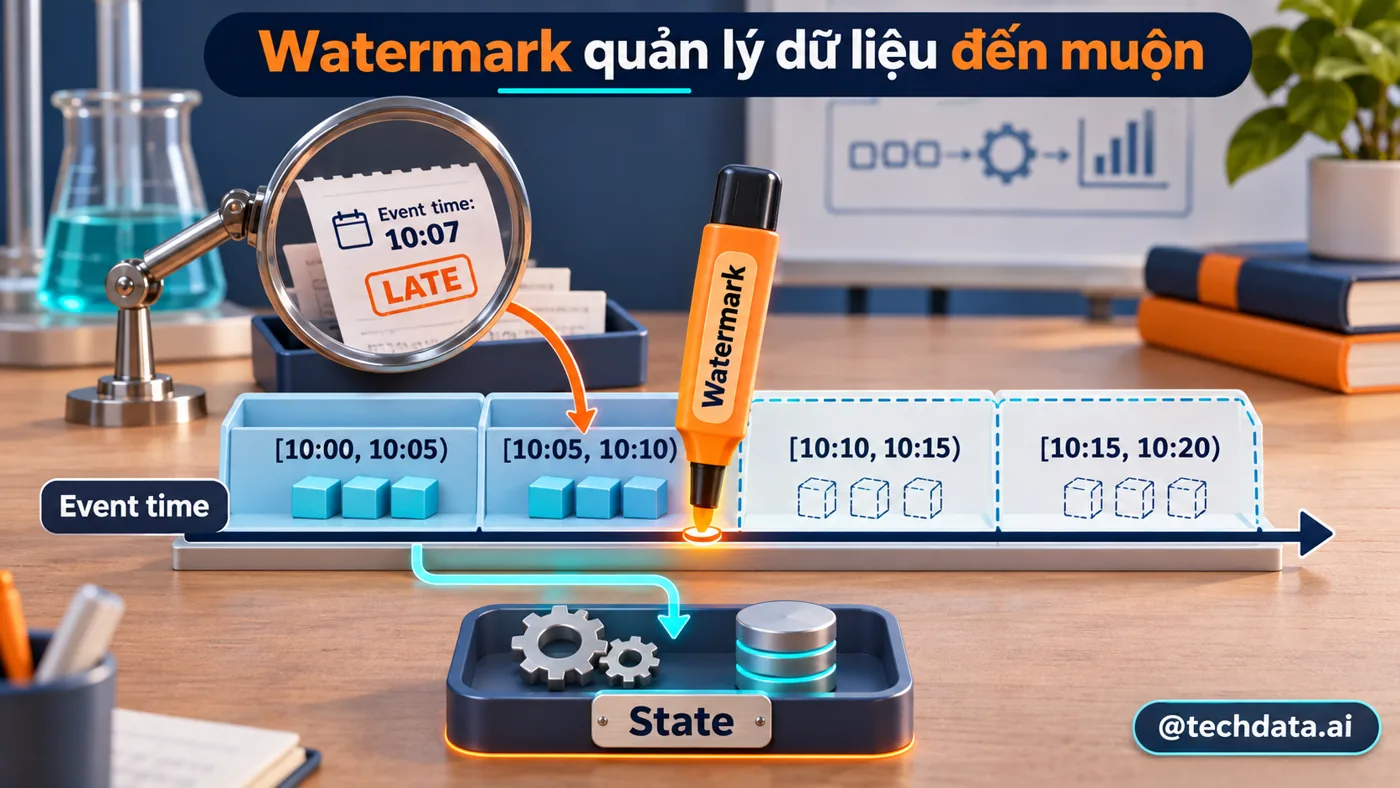
Append mode chỉ xuất kết quả window khi được xem là hoàn tất theo watermark. Vì vậy sau initial, chưa thấy file kết quả cho mọi window không nhất thiết là lỗi. Update mode có thể xuất các nhóm được cập nhật nhưng cần sink hiểu upsert; Complete xuất toàn bộ bảng kết quả và giữ state khác với Append. Không đổi outputMode mà bỏ qua yêu cầu của sink và state.
Ngưỡng hai phút không có nghĩa mọi event trễ hơn hai phút chắc chắn bị loại trong mọi tình huống. Guarantee watermark có tính một chiều; dữ liệu rất trễ có thể không được xử lý tùy state và tiến độ. Chọn ngưỡng cần phân bố độ trễ thật và yêu cầu đối soát, đồng thời có đường backfill cho dữ liệu ngoài ngưỡng.
6. Chạy query và quan sát kết quả cuối cửa sổ
spark-submit --master "local[2]" --packages org.apache.spark:spark-sql-kafka-0-10_2.13:4.1.2 sales_stream.pyGiữ query chạy. Terminal khác kích hoạt Python environment và gửi initial. Chờ vài trigger để xử lý, sau đó gửi advance. Event ở 10:21 giúp watermark tiến về khoảng 10:19, đủ điều kiện hoàn tất hai window đầu sau các batch tương ứng.
python seed_spark.py initial
# Sau khi query xử lý initial, chạy:
python seed_spark.py advance
Tạo read_output.py để đọc những file Parquet đã xuất. Nếu chưa có file dữ liệu, chờ query xử lý advance và kiểm tra log; không tạo schema giả để che việc chưa có output.
from pyspark.sql import SparkSession
spark=SparkSession.builder.appName("ReadSalesResult").config("spark.sql.session.timeZone","UTC").getOrCreate()
spark.read.parquet("output/sales_v1").orderBy("window_start","store_id").show(truncate=False)
spark.stop()
spark-submit --master "local[1]" read_output.pyTrên topic mới, kỳ vọng window 10:00–10:05 có paid_orders=2 và gross_paid_vnd=300000; window 10:05–10:10 có paid_orders=1 và gross_paid_vnd=300000. Các event advance thuộc window 10:20–10:25 vẫn có thể chưa xuất vì watermark chưa vượt cuối window. Đừng cộng file output rồi kết luận chỉ có ba event trong Kafka.
7. Checkpoint giữ tiến độ và state để phục hồi
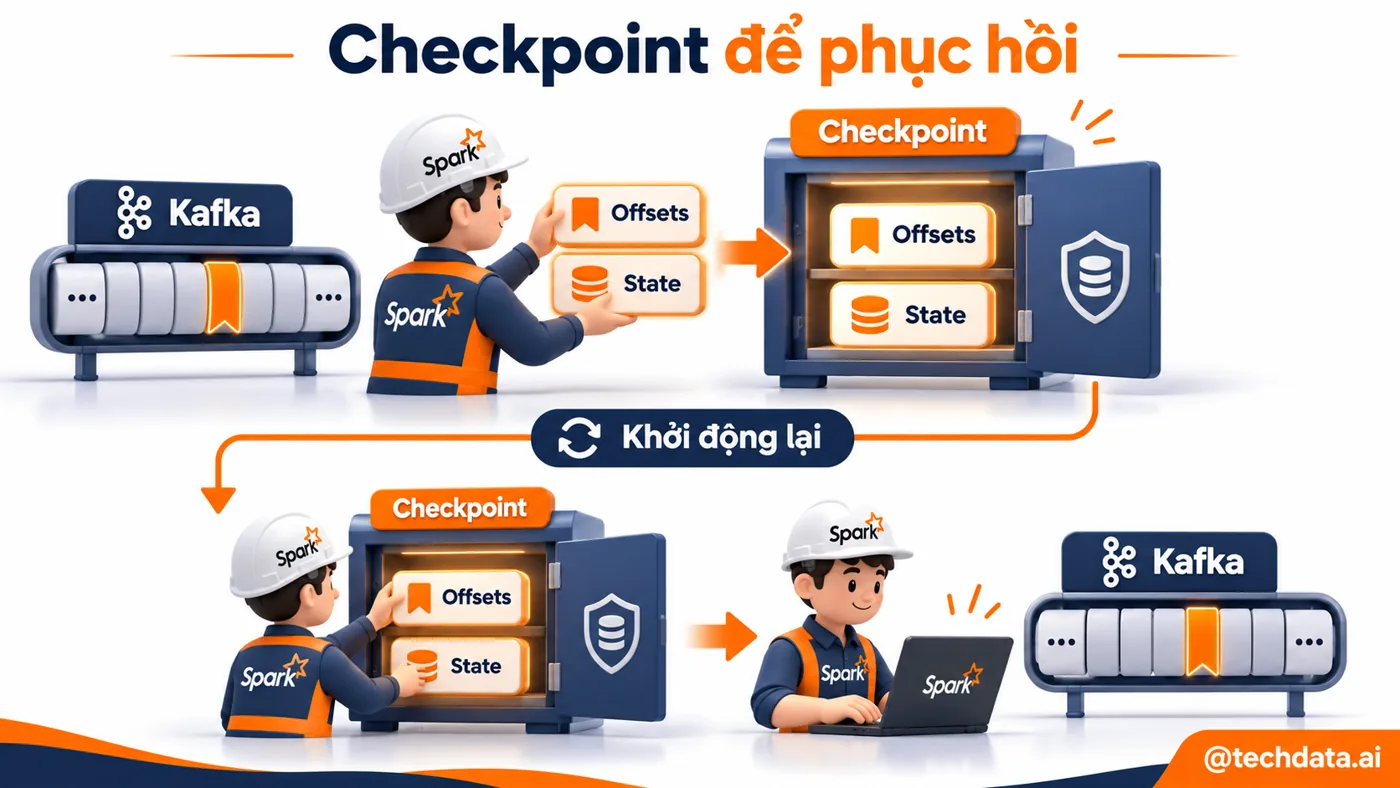
Dừng query bằng Ctrl+C rồi chạy lại cùng code, đường output và checkpoint. Spark dùng checkpoint phục hồi nguồn và state; không cần dựa vào committed offset của consumer group ứng dụng Python. Kafka source của Spark quản lý tiến độ qua checkpoint, nên đừng gắn enable.auto.commit hoặc auto.offset.reset theo cách của bài 3.
Checkpoint cần ổ lưu trữ bền vững và riêng cho từng query. Trong local lab là thư mục ổ đĩa; trên cluster phải dùng storage được mọi thành phần liên quan truy cập và có durability phù hợp. Không dùng thư mục tạm dễ bị xóa rồi coi đó là kế hoạch phục hồi.
Đổi schema state, nhóm aggregate hoặc nguồn topic có thể không tương thích checkpoint cũ. Khi muốn làm lại thí nghiệm, dùng topic, output path và checkpoint path mới cùng một phiên bản; không chỉ xóa checkpoint trong khi giữ output cũ vì có thể ghi lại kết quả trùng hoặc sai semantics.
8. Exactly-once, duplicate và sink phải được hiểu theo phạm vi
Checkpoint và file sink hỗ trợ phục hồi nhất quán trong phạm vi query/nguồn/sink được hỗ trợ. Điều đó không loại duplicate đã nằm trong Kafka với cùng event_id. Main query không deduplicate business event; nó đếm record. Nếu cần loại lặp, thiết kế dedup state với ngưỡng thời gian phù hợp hoặc upstream fact duy nhất, và xem giới hạn kết hợp nhiều stateful operator của phiên bản Spark.
foreachBatch ghi PostgreSQL có thể bị gọi lại cùng batch sau lỗi. Cần batch_id hoặc khóa kết quả window+store và upsert idempotent, không append lại mọi dòng một cách mù. Kafka sink cũng có semantics cần xét riêng; không tuyên bố toàn pipeline exactly-once chỉ từ tên Structured Streaming.
State tăng theo số group và số window còn mở. Key cardinality cao, watermark quá rộng hoặc event timestamp sai quá xa tương lai có thể làm memory/state và kết quả bị ảnh hưởng. Theo dõi numInputRows, inputRowsPerSecond, processedRowsPerSecond, eventTime watermark, batch duration và stateOperators trong progress/UI.
9. Bài tập với event đến muộn
Bài 1: trước khi advance, gửi thêm một event 10:02 với ID mới. Dự đoán window đầu tăng 50.000 nếu record được xử lý trước khi window hoàn tất. Làm trên topic/output/checkpoint mới để không trộn với lượt trước.
Bài 2: sau khi watermark đã tiến và window đầu xuất, chạy python seed_spark.py late. Quan sát progress và output. Không mặc định dữ liệu trễ luôn bị nhận hoặc luôn bị loại; đối chiếu watermark và state tại thời điểm xử lý.
Bài 3: đổi cửa sổ thành 10 phút trên một query mới. Tính tay S1/S2/S3 cùng window 10:00–10:10 với tổng 600.000. Giải thích vì sao trigger năm giây không làm thay đổi nhóm event time này.
Bài cuối series chuyển sang replication, security, monitoring và kế hoạch vận hành. Một streaming query chạy trên laptop là bước học; production còn cần thiết kế cluster, storage, quyền truy cập, cảnh báo và quy trình phục hồi.
Tài liệu tham khảo
- Spark 4.1.2 Kafka Integration — connector và quản lý offsets.
- Spark Structured Streaming APIs — windows, watermark, output mode và checkpoint.
- Spark Programming Guide — semantics watermark và điều kiện dọn state.
@techdata.ai · Series Apache Kafka
Comments are closed!