



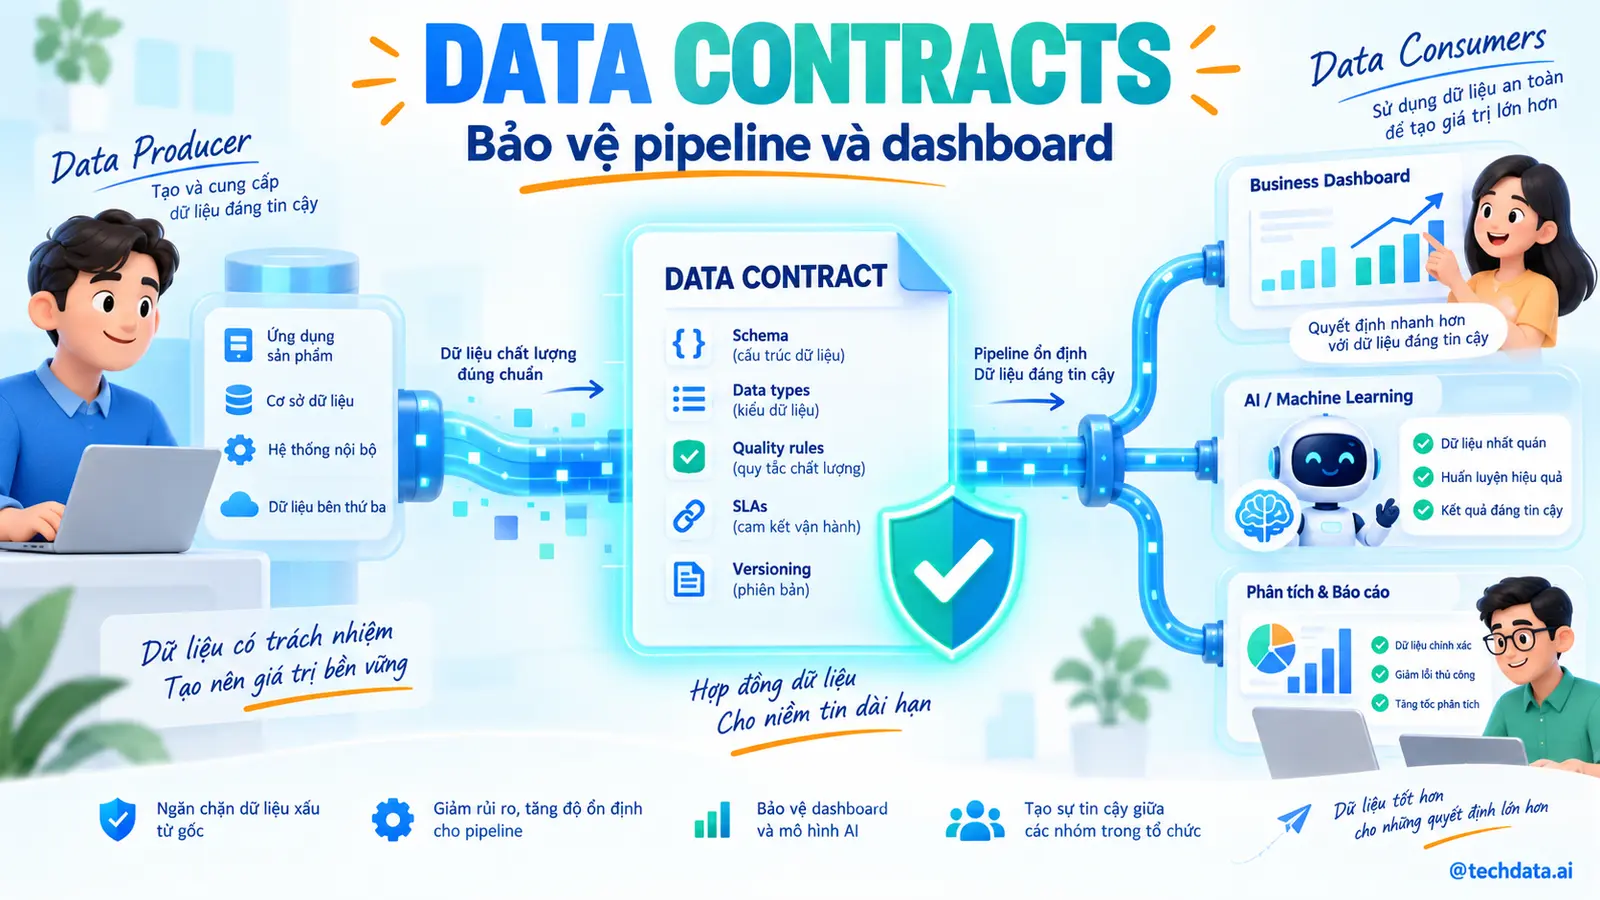

Data Contracts: Cách ngăn thay đổi dữ liệu làm hỏng pipeline và dashboard
Data Contracts: Cách ngăn thay đổi dữ liệu làm hỏng pipeline và dashboard xuất phát từ một nghịch lý quen thuộc: doanh nghiệp có nhiều dữ liệu hơn nhưng chưa chắc ra quyết định nhanh và chính xác hơn. Số liệu nằm trong nhiều hệ thống, được cập nhật theo lịch khác nhau và thường chỉ lộ ra vấn đề khi một báo cáo quan trọng đã đến tay lãnh đạo.
Data Contract biến kỳ vọng ngầm giữa bên tạo và bên sử dụng dữ liệu thành cam kết có thể kiểm thử, quản lý phiên bản và xử lý khi thay đổi. Vì vậy, điểm bắt đầu không phải danh sách sản phẩm cần mua mà là những quyết định doanh nghiệp muốn cải thiện trong 12 tháng tới.
Làn sóng AI làm yêu cầu này trở nên cấp thiết. AI Assistant có thể giải thích và tạo bản nháp; AI Agent còn có thể đọc dữ liệu, gọi công cụ và chuẩn bị hành động. Một nền dữ liệu sai hoặc quyền quá rộng vì thế không chỉ tạo báo cáo sai mà có thể đẩy sai lệch vào quy trình vận hành.
Bài viết sử dụng tình huống đội ERP đổi tên một cột và kiểu dữ liệu vào cuối tuần, khiến pipeline thất bại và dashboard doanh thu sáng thứ Hai không có số. Đây là ví dụ giả định nhưng đủ gần với thực tế để minh họa dữ liệu đi qua hệ thống như thế nào, AI tham gia ở bước nào và tại sao con người vẫn phải phê duyệt những quyết định quan trọng.
Mục tiêu cuối cùng là tạo một năng lực có thể vận hành và đo được. Data Contract biến kỳ vọng ngầm giữa bên tạo và bên sử dụng dữ liệu thành cam kết có thể kiểm thử, quản lý phiên bản và xử lý khi thay đổi.
MỤC LỤC
- hợp đồng dữ liệu thực chất là gì
- Doanh nghiệp đang giải quyết công việc gì
- Vì sao cách làm hiện tại thường thất bại
- AI có thể hỗ trợ ở đâu và không nên làm gì
- Vai trò của con người và trách nhiệm cuối cùng
PHẦN II — NHỮNG NĂNG LỰC VÀ ỨNG DỤNG THỰC TẾ
- Data Contract là gì
- Schema Contract
- Semantic Contract
- SLA về độ tươi
- Quy tắc chất lượng
- Quản lý phiên bản
- Phát hiện breaking change
- Kiểm thử trong CI/CD
- Phối hợp producer và consumer
- Contract trong Data Mesh
PHẦN III — DỮ LIỆU, AI AGENT VÀ KIỂM SOÁT
- AI Assistant và AI Agent khác nhau thế nào
- Dữ liệu nào cần được sử dụng
- ERP, CRM, Data Warehouse và Data Platform đóng vai trò gì
- Data Quality ảnh hưởng tới kết quả ra sao
- Permission và bảo mật dữ liệu
- Định nghĩa, metadata và khả năng truy vết
PHẦN IV — TRIỂN KHAI TRONG DOANH NGHIỆP
- Doanh nghiệp nên bắt đầu từ đâu
- Ba use case đầu tiên ít rủi ro
- Roadmap triển khai 90 ngày
- KPI nào cần đo
- Những sai lầm phổ biến
- Khi nào nên mở rộng phạm vi
PHẦN V — TÌNH HUỐNG TỔNG THỂ VÀ TƯƠNG LAI
- Một tình huống doanh nghiệp tổng thể
- Trước và sau khi triển khai
- Công việc sẽ thay đổi như thế nào
- Kết luận
PHẦN I — HIỂU ĐÚNG BÀI TOÁN
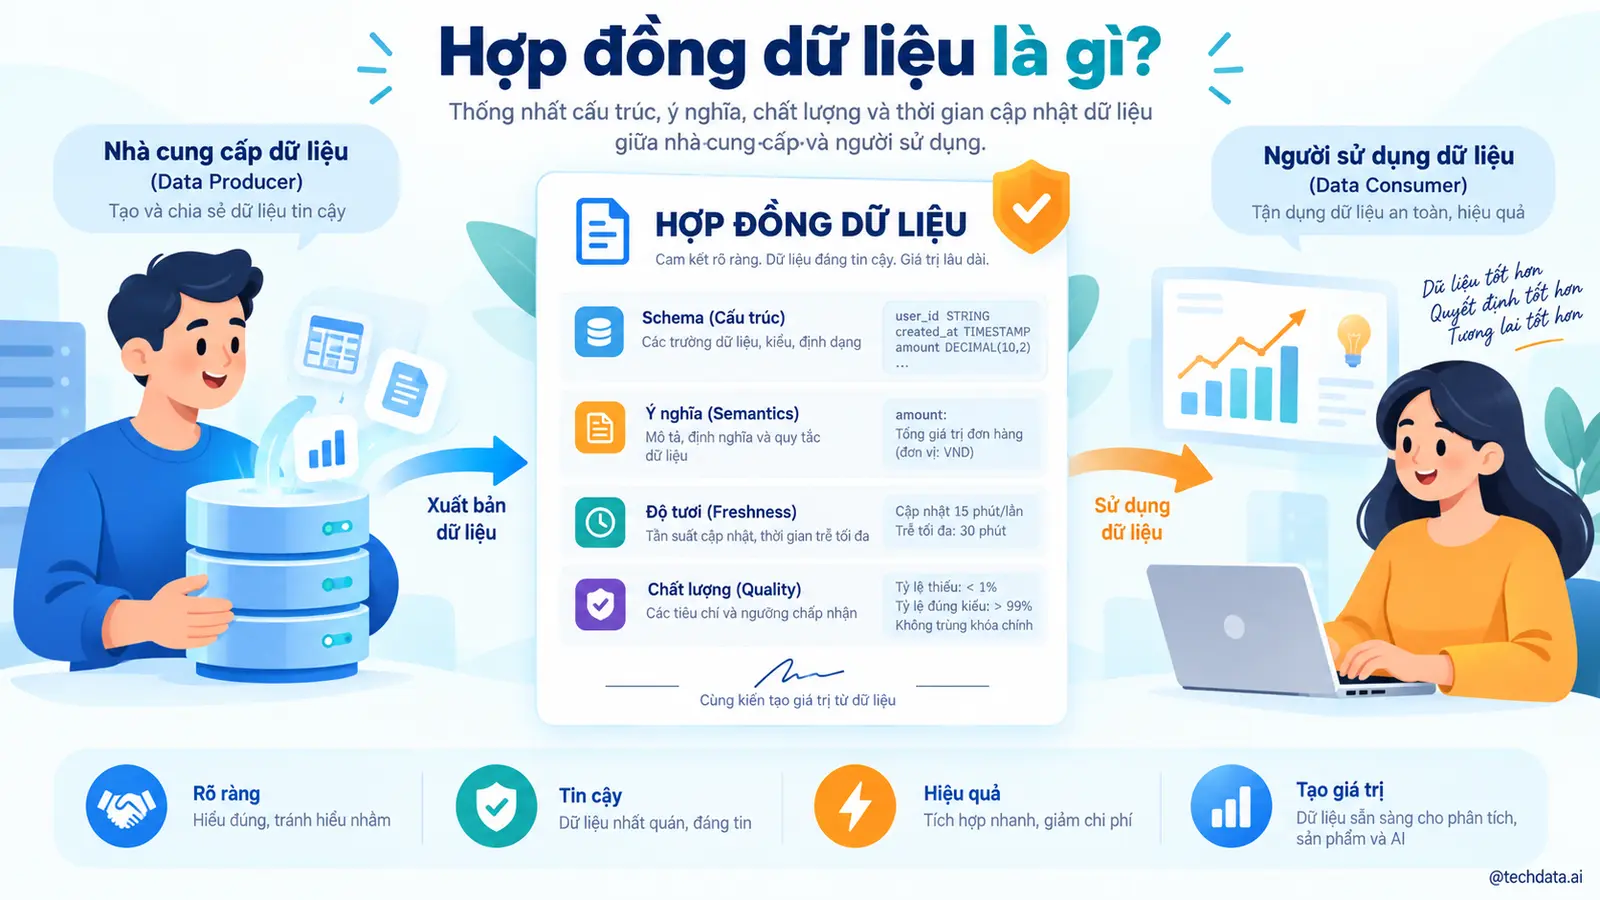
1. hợp đồng dữ liệu thực chất là gì?
hợp đồng dữ liệu thực chất là gì có thể hiểu đơn giản là cách doanh nghiệp biến hợp đồng dữ liệu thành một năng lực vận hành có mục tiêu, người chịu trách nhiệm và kết quả đo được. Nó không đồng nghĩa với việc mua một phần mềm hoặc lập thêm một nhóm dự án. Data Contract biến kỳ vọng ngầm giữa bên tạo và bên sử dụng dữ liệu thành cam kết có thể kiểm thử, quản lý phiên bản và xử lý khi thay đổi.
Điểm quan trọng là phạm vi phải đủ cụ thể để mọi người cùng hiểu. Với đội ERP đổi tên một cột và kiểu dữ liệu vào cuối tuần, khiến pipeline thất bại và dashboard doanh thu sáng thứ Hai không có số, khái niệm chỉ trở nên hữu ích khi được gắn với những quyết định như doanh thu nào được chốt, dữ liệu nào được tin cậy và ai xử lý khi kết quả không khớp.
2. Doanh nghiệp đang giải quyết công việc gì?
Công việc thực tế bắt đầu từ việc mô tả quyết định, quy trình và những điểm đang gây chậm trễ hoặc sai lệch. Nhóm dự án sau đó xác định schema, kiểu dữ liệu, ý nghĩa trường, độ tươi, quy tắc chất lượng, quyền sở hữu và chính sách phiên bản, cách dữ liệu di chuyển, những quy tắc nghiệp vụ đang được áp dụng và các ngoại lệ thường xảy ra.
data producer, data consumer, Data Engineer, Analytics Engineer và chủ sở hữu domain phải cùng tham gia vì không một bộ phận nào nhìn thấy toàn bộ bức tranh. Đội công nghệ hiểu hệ thống, nhưng người nghiệp vụ mới biết một con số có hợp lý hay không và quyết định nào có thể gây hậu quả nếu dữ liệu sai.
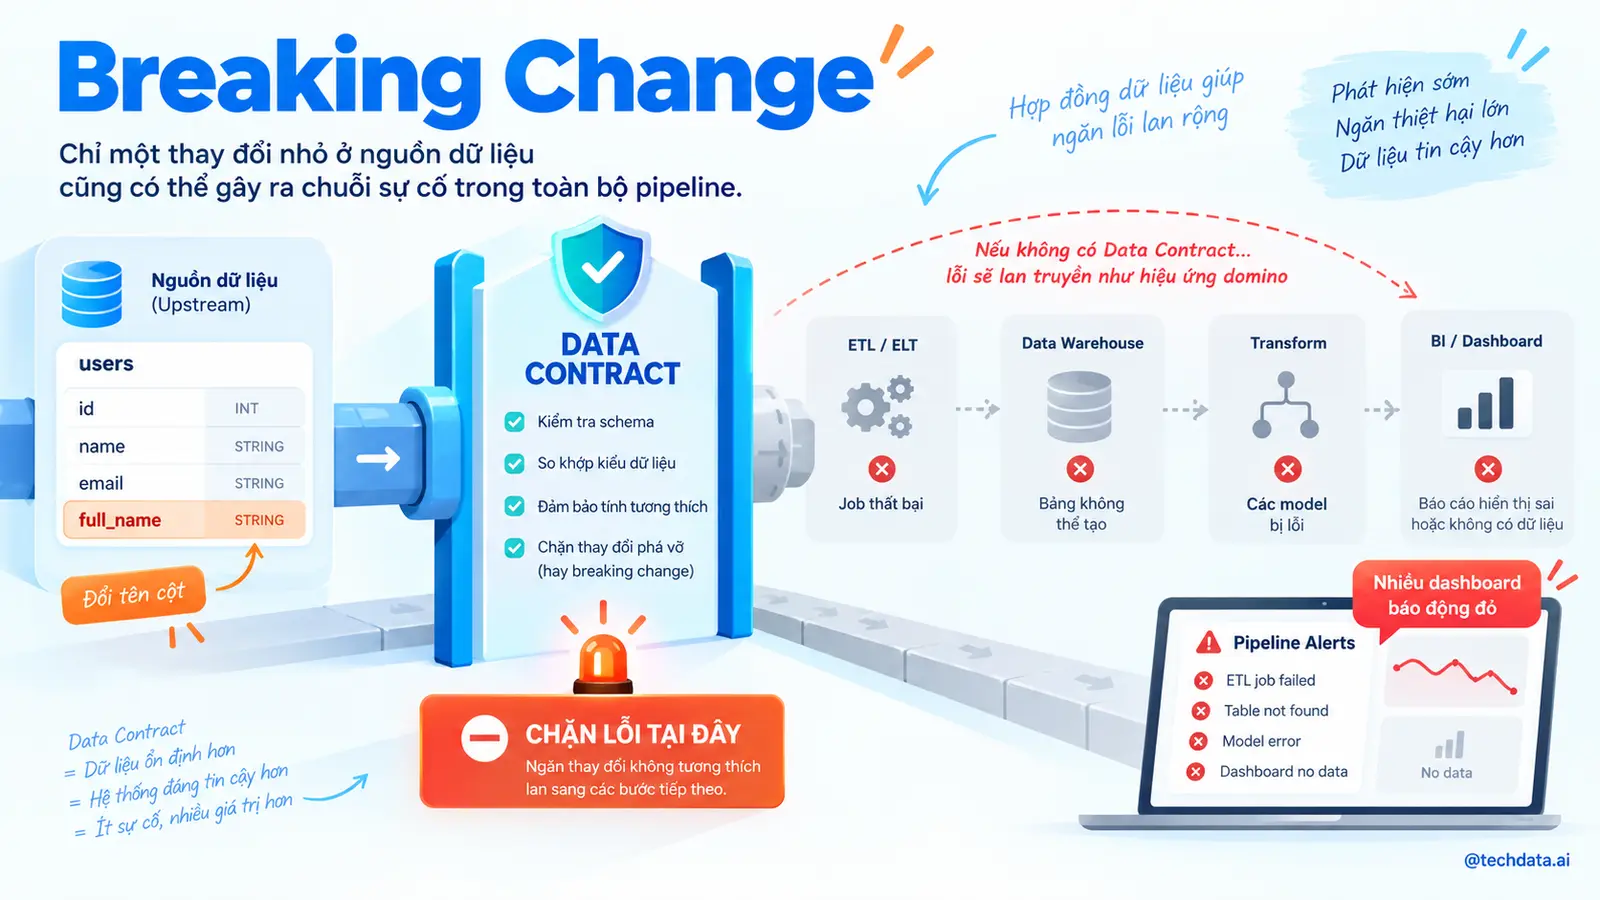
3. Vì sao cách làm hiện tại thường thất bại?
Cách làm hiện tại thường thất bại khi doanh nghiệp bắt đầu từ công cụ rồi mới tìm bài toán. Một nền tảng hiện đại không giải quyết được tình trạng mỗi bộ phận dùng một định nghĩa, dữ liệu cập nhật khác thời điểm hoặc không ai có quyền chốt phương án khi phát sinh tranh chấp.
Một nguyên nhân khác là pilot được tách khỏi công việc thật. Dữ liệu mẫu sạch, người dùng thử ít và không có tình huống xấu khiến kết quả ban đầu trông tốt hơn thực tế. Rủi ro cuối cùng là viết contract quá cứng làm chậm thay đổi hoặc quá lỏng nên không bảo vệ được hệ thống.
4. AI có thể hỗ trợ ở đâu và không nên làm gì?
AI có thể đọc khối lượng dữ liệu lớn, phát hiện mẫu, so sánh với lịch sử, chuẩn bị giải thích và đề xuất bước tiếp theo. Trong hợp đồng dữ liệu, AI đặc biệt hữu ích ở phần kiểm tra lặp lại và khoanh vùng ngoại lệ để con người không phải tìm thủ công trong hàng nghìn bản ghi.
AI không nên tự định nghĩa mục tiêu, mở rộng quyền truy cập hay thực hiện hành động khó đảo ngược. Khi dữ liệu thiếu hoặc mâu thuẫn, hệ thống phải nêu giới hạn và chuyển cho người có thẩm quyền thay vì tạo một câu trả lời chắc chắn.
5. Vai trò của con người và trách nhiệm cuối cùng
Con người giữ ba trách nhiệm không thể giao cho mô hình: xác định kết quả mong muốn, phê duyệt những hành động có hậu quả và chịu trách nhiệm khi hệ thống sai. data producer, data consumer, Data Engineer, Analytics Engineer và chủ sở hữu domain cũng phải thống nhất ai được điều chỉnh quy tắc, ai xử lý sự cố và ai có quyền dừng hệ thống.
Mục tiêu không phải giữ mọi bước thủ công. Doanh nghiệp có thể tăng mức tự động hóa sau khi hệ thống chứng minh được chất lượng qua dữ liệu vận hành. Quyền của AI nên tăng theo bằng chứng, không tăng theo sự tự tin của nhà cung cấp.
PHẦN II — NHỮNG NĂNG LỰC VÀ ỨNG DỤNG THỰC TẾ
6. Data Contract là gì
Data Contract là gì thường trở thành điểm nghẽn khi dữ liệu nằm ở nhiều nơi hoặc mỗi bộ phận áp dụng một quy tắc khác nhau. Để xử lý, doanh nghiệp cần tập trung vào producer, consumer, schema, semantics, SLA và version, xác định nguồn được coi là chuẩn và người có quyền giải quyết ngoại lệ. Cách triển khai phù hợp là biến kỳ vọng thành cam kết kiểm thử được. AI có thể hỗ trợ kiểm tra khối lượng lớn, phát hiện trường hợp bất thường và chuẩn bị phương án, nhưng kết quả phải kèm nguồn và quy tắc đã sử dụng.
Với đội ERP đổi tên một cột và kiểu dữ liệu vào cuối tuần, khiến pipeline thất bại và dashboard doanh thu sáng thứ Hai không có số, nhóm dự án có thể thử trên một đơn vị đại diện trong 30 ngày, chạy song song với cách hiện tại và ghi nhận từng ngoại lệ. Hiệu quả được đo bằng số vi phạm contract. Rủi ro quan trọng là xem contract là tài liệu pháp lý dài; quyền phê duyệt và trách nhiệm xử lý sai lệch phải được quy định rõ.
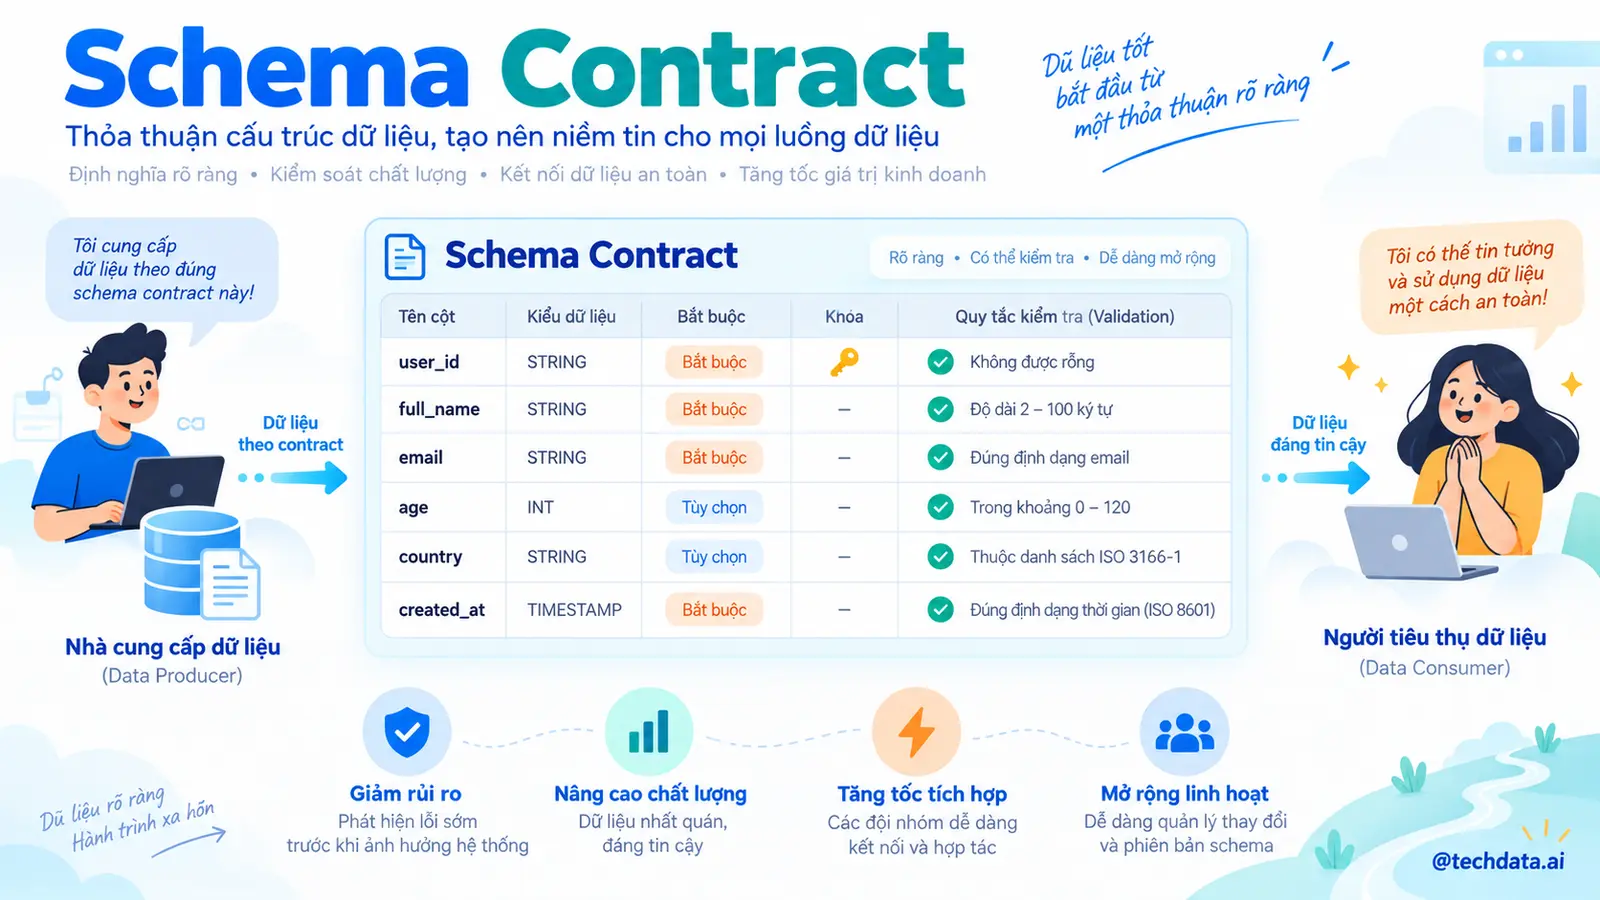
7. Schema Contract
Giá trị của Schema Contract không nằm ở một màn hình mới mà ở khả năng đưa ra kết quả nhất quán đúng thời điểm. Phạm vi dữ liệu cần làm rõ gồm column, type, nullability, constraint và order cần thiết; các trường bắt buộc, lịch cập nhật và quyền sử dụng phải được kiểm tra trước khi tự động hóa. Nhóm dự án nên enforce tại build hoặc trước publish. Quy trình cần chỉ ra bước nào chạy tự động, bước nào chuyển cho người nghiệp vụ và điều kiện nào buộc hệ thống dừng vì thiếu dữ liệu.
Trong tình huống đội ERP đổi tên một cột và kiểu dữ liệu vào cuối tuần, khiến pipeline thất bại và dashboard doanh thu sáng thứ Hai không có số, hai phương án nên được so sánh trên cùng dữ liệu và cùng thước đo, thay vì đánh giá bằng cảm nhận của từng bộ phận. Hiệu quả được đo bằng breaking change. Rủi ro quan trọng là chỉ phát hiện ở dashboard; quyền phê duyệt và trách nhiệm xử lý sai lệch phải được quy định rõ.
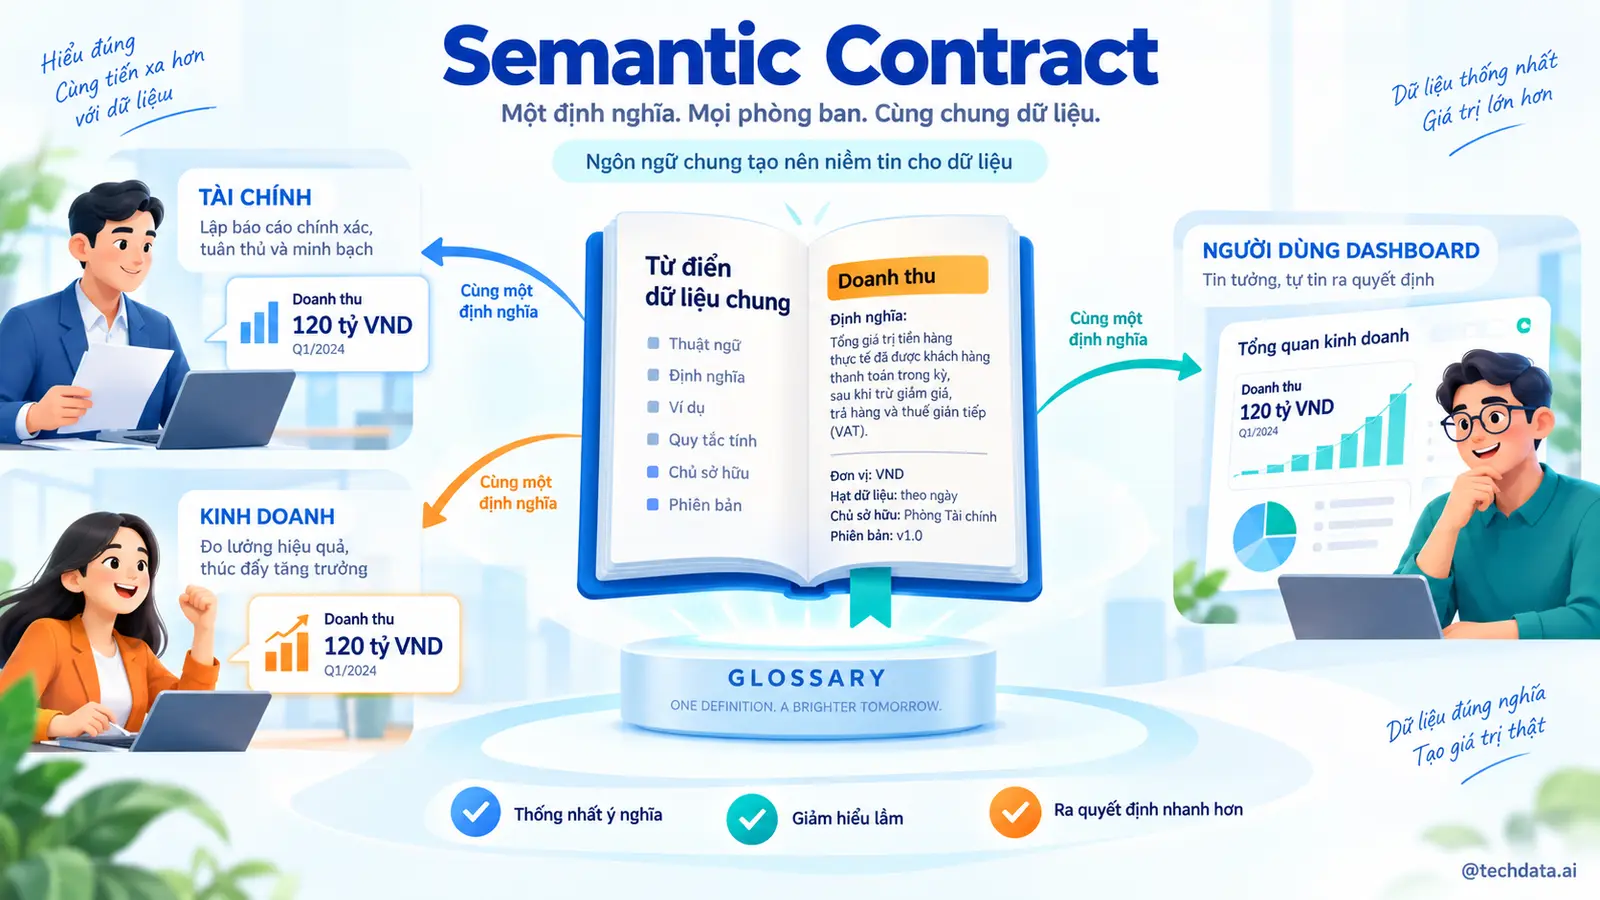
8. Semantic Contract
Trong vận hành thực tế, Semantic Contract liên quan trực tiếp tới ý nghĩa, đơn vị, grain, thời điểm và quy tắc tính. Nếu các yếu tố này chưa có định nghĩa chung, AI hoặc dashboard chỉ làm cho sự khác biệt xuất hiện nhanh hơn chứ không tự giải quyết được nó. Về kỹ thuật và quản trị, doanh nghiệp cần gắn business definition với field. Thay đổi phải được kiểm thử trên tình huống bình thường, dữ liệu thiếu và trường hợp có hậu quả lớn trước khi đưa vào quy trình thật.
Một bài kiểm tra hữu ích cho đội ERP đổi tên một cột và kiểu dữ liệu vào cuối tuần, khiến pipeline thất bại và dashboard doanh thu sáng thứ Hai không có số là cố ý đưa vào dữ liệu thiếu, cập nhật chậm và trường hợp mâu thuẫn để xem hệ thống có biết dừng hay không. Hiệu quả được đo bằng tranh chấp số liệu. Rủi ro quan trọng là schema đúng nhưng nghĩa đổi; quyền phê duyệt và trách nhiệm xử lý sai lệch phải được quy định rõ.
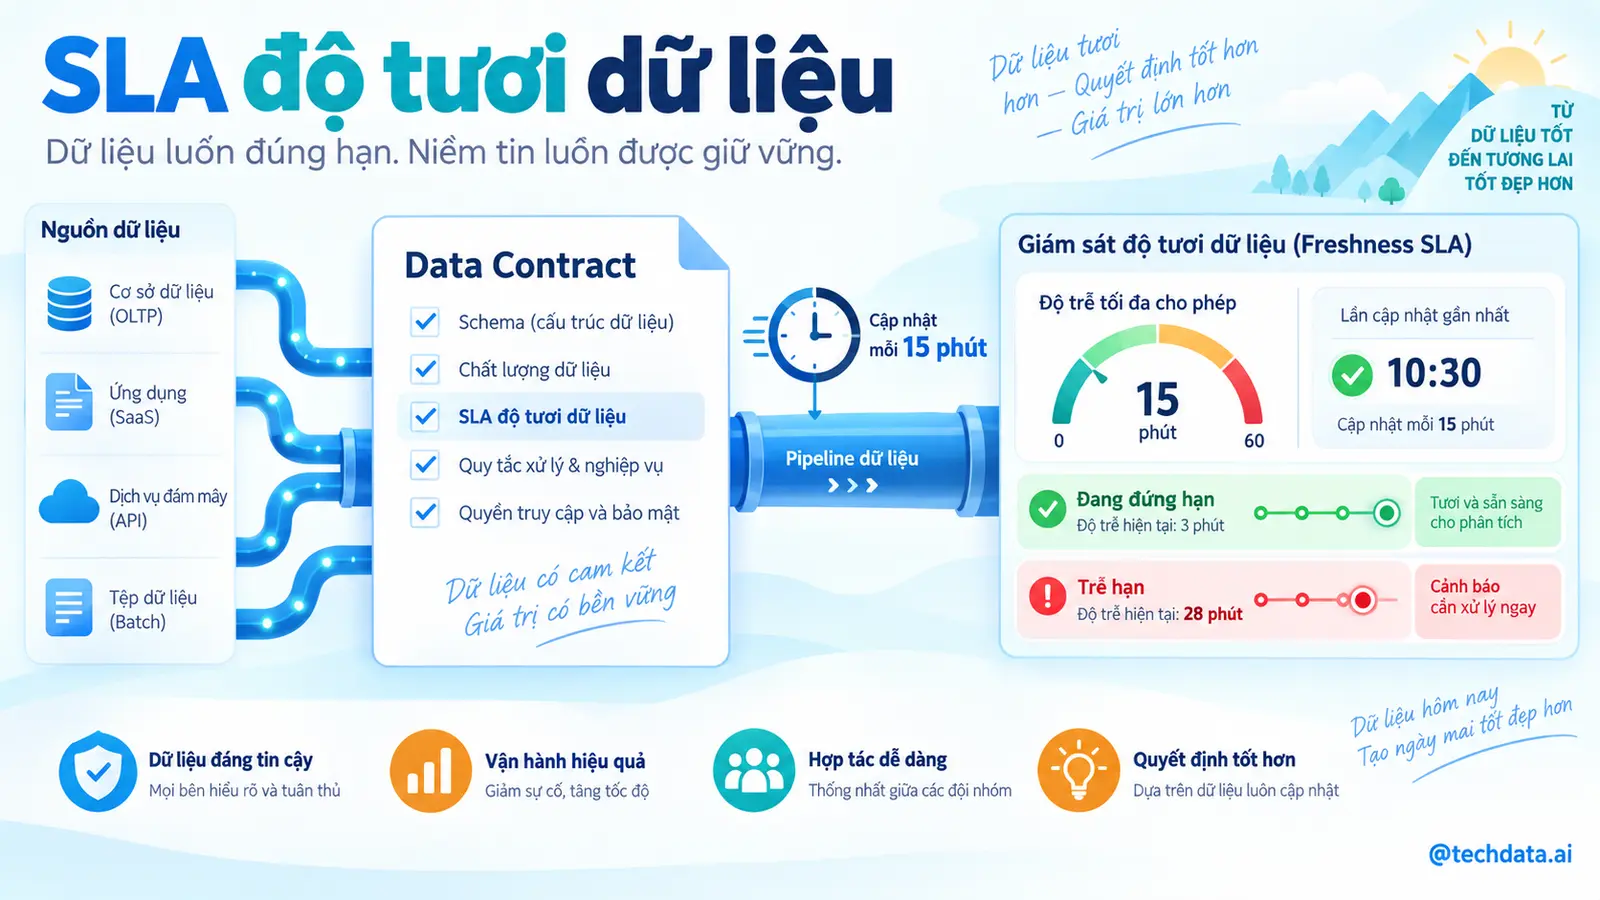
9. SLA về độ tươi
SLA về độ tươi thường trở thành điểm nghẽn khi dữ liệu nằm ở nhiều nơi hoặc mỗi bộ phận áp dụng một quy tắc khác nhau. Để xử lý, doanh nghiệp cần tập trung vào lịch cập nhật, deadline, latency và cửa sổ bảo trì, xác định nguồn được coi là chuẩn và người có quyền giải quyết ngoại lệ. Cách triển khai phù hợp là đặt SLO theo nhu cầu quyết định. AI có thể hỗ trợ kiểm tra khối lượng lớn, phát hiện trường hợp bất thường và chuẩn bị phương án, nhưng kết quả phải kèm nguồn và quy tắc đã sử dụng.
Nếu áp dụng cho đội ERP đổi tên một cột và kiểu dữ liệu vào cuối tuần, khiến pipeline thất bại và dashboard doanh thu sáng thứ Hai không có số, nhóm triển khai cần đo đường cơ sở trước, chọn một chu kỳ nghiệp vụ hoàn chỉnh rồi đối chiếu kết quả với người đang làm công việc hằng ngày. Hiệu quả được đo bằng tỷ lệ đạt freshness. Rủi ro quan trọng là hứa real-time không cần thiết; quyền phê duyệt và trách nhiệm xử lý sai lệch phải được quy định rõ.
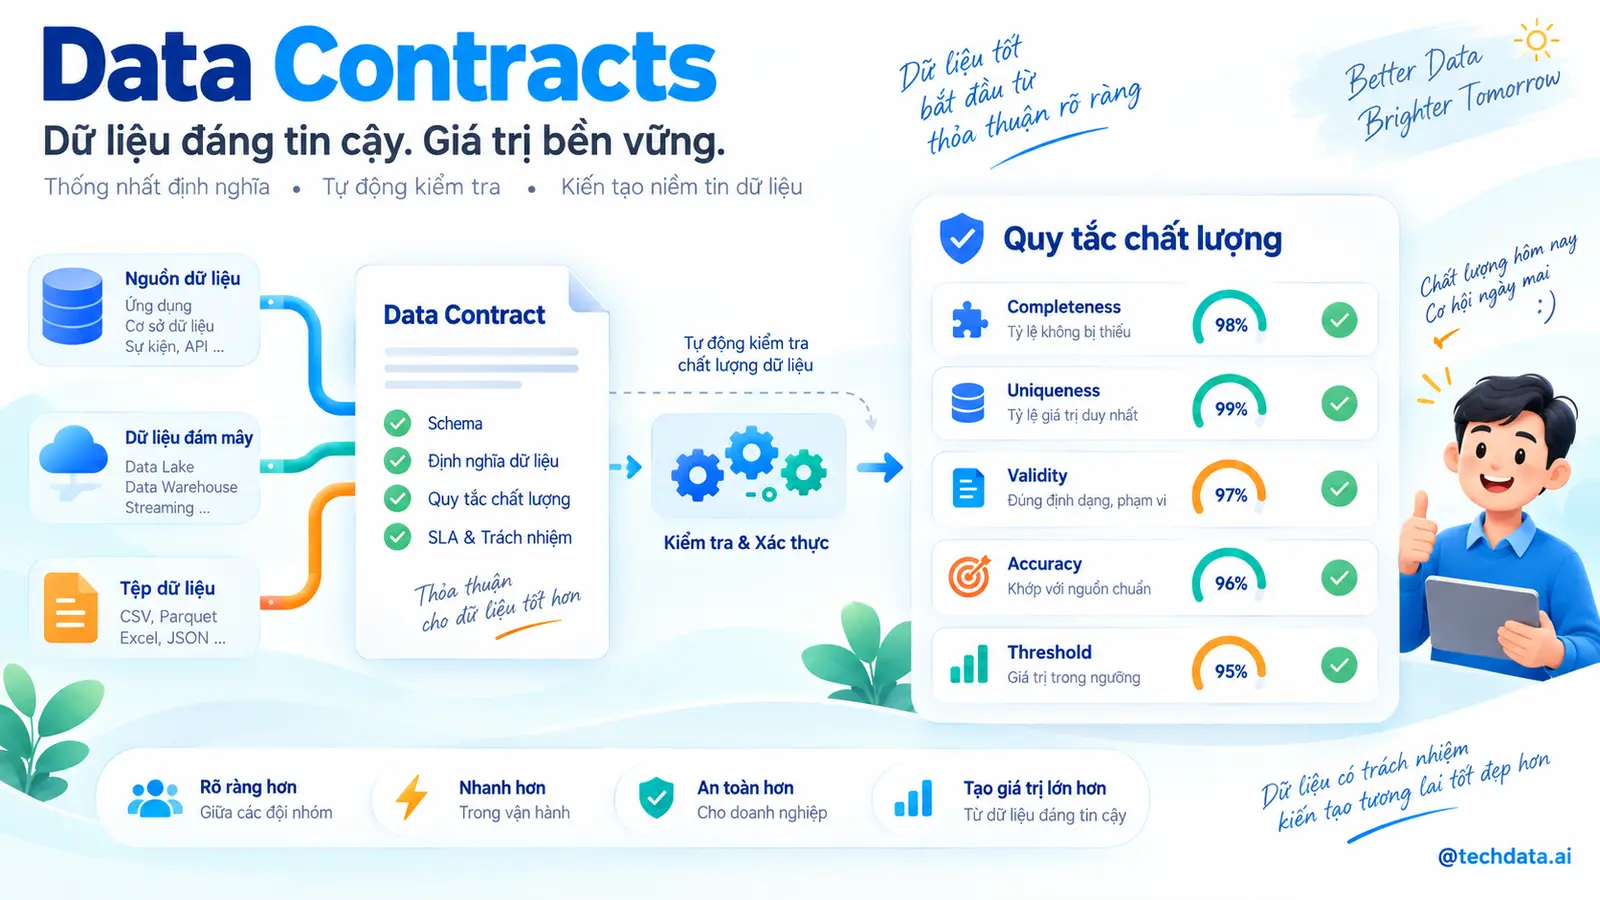
10. Quy tắc chất lượng
Giá trị của Quy tắc chất lượng không nằm ở một màn hình mới mà ở khả năng đưa ra kết quả nhất quán đúng thời điểm. Phạm vi dữ liệu cần làm rõ gồm completeness, uniqueness, validity và reconciliation; các trường bắt buộc, lịch cập nhật và quyền sử dụng phải được kiểm tra trước khi tự động hóa. Nhóm dự án nên chạy test tự động theo contract. Quy trình cần chỉ ra bước nào chạy tự động, bước nào chuyển cho người nghiệp vụ và điều kiện nào buộc hệ thống dừng vì thiếu dữ liệu.
Ở đội ERP đổi tên một cột và kiểu dữ liệu vào cuối tuần, khiến pipeline thất bại và dashboard doanh thu sáng thứ Hai không có số, kết quả nên được chuyển tới đúng người nghiệp vụ kèm dữ liệu nguồn, để họ có thể chấp nhận, sửa hoặc từ chối trước khi quy tắc được mở rộng. Hiệu quả được đo bằng tỷ lệ lỗi hữu ích. Rủi ro quan trọng là quá nhiều test không có owner; quyền phê duyệt và trách nhiệm xử lý sai lệch phải được quy định rõ.
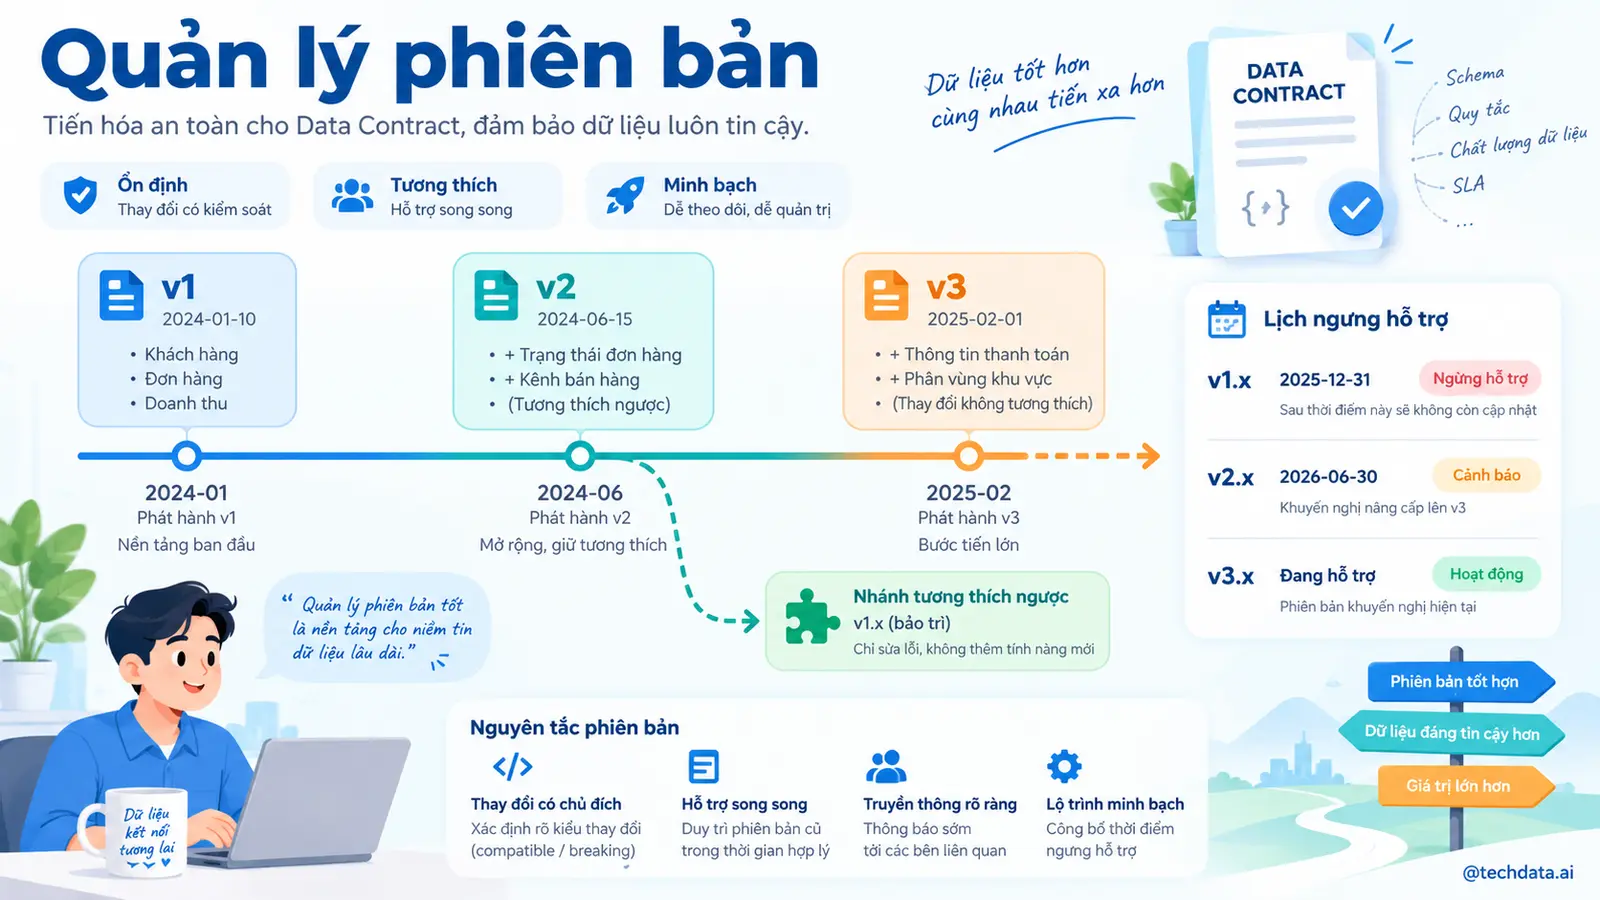
11. Quản lý phiên bản
Trong vận hành thực tế, Quản lý phiên bản liên quan trực tiếp tới major, minor, deprecation và migration window. Nếu các yếu tố này chưa có định nghĩa chung, AI hoặc dashboard chỉ làm cho sự khác biệt xuất hiện nhanh hơn chứ không tự giải quyết được nó. Về kỹ thuật và quản trị, doanh nghiệp cần phát hành version mới song song trước khi bỏ cũ. Thay đổi phải được kiểm thử trên tình huống bình thường, dữ liệu thiếu và trường hợp có hậu quả lớn trước khi đưa vào quy trình thật.
Với đội ERP đổi tên một cột và kiểu dữ liệu vào cuối tuần, khiến pipeline thất bại và dashboard doanh thu sáng thứ Hai không có số, nhóm dự án có thể thử trên một đơn vị đại diện trong 30 ngày, chạy song song với cách hiện tại và ghi nhận từng ngoại lệ. Hiệu quả được đo bằng số consumer di chuyển đúng hạn. Rủi ro quan trọng là đổi âm thầm; quyền phê duyệt và trách nhiệm xử lý sai lệch phải được quy định rõ.
12. Phát hiện breaking change
Phát hiện breaking change thường trở thành điểm nghẽn khi dữ liệu nằm ở nhiều nơi hoặc mỗi bộ phận áp dụng một quy tắc khác nhau. Để xử lý, doanh nghiệp cần tập trung vào rename, drop, type change, grain change và semantic change, xác định nguồn được coi là chuẩn và người có quyền giải quyết ngoại lệ. Cách triển khai phù hợp là so sánh contract trong pull request. AI có thể hỗ trợ kiểm tra khối lượng lớn, phát hiện trường hợp bất thường và chuẩn bị phương án, nhưng kết quả phải kèm nguồn và quy tắc đã sử dụng.
Trong tình huống đội ERP đổi tên một cột và kiểu dữ liệu vào cuối tuần, khiến pipeline thất bại và dashboard doanh thu sáng thứ Hai không có số, hai phương án nên được so sánh trên cùng dữ liệu và cùng thước đo, thay vì đánh giá bằng cảm nhận của từng bộ phận. Hiệu quả được đo bằng số lỗi chặn trước production. Rủi ro quan trọng là chỉ kiểm tra cú pháp; quyền phê duyệt và trách nhiệm xử lý sai lệch phải được quy định rõ.
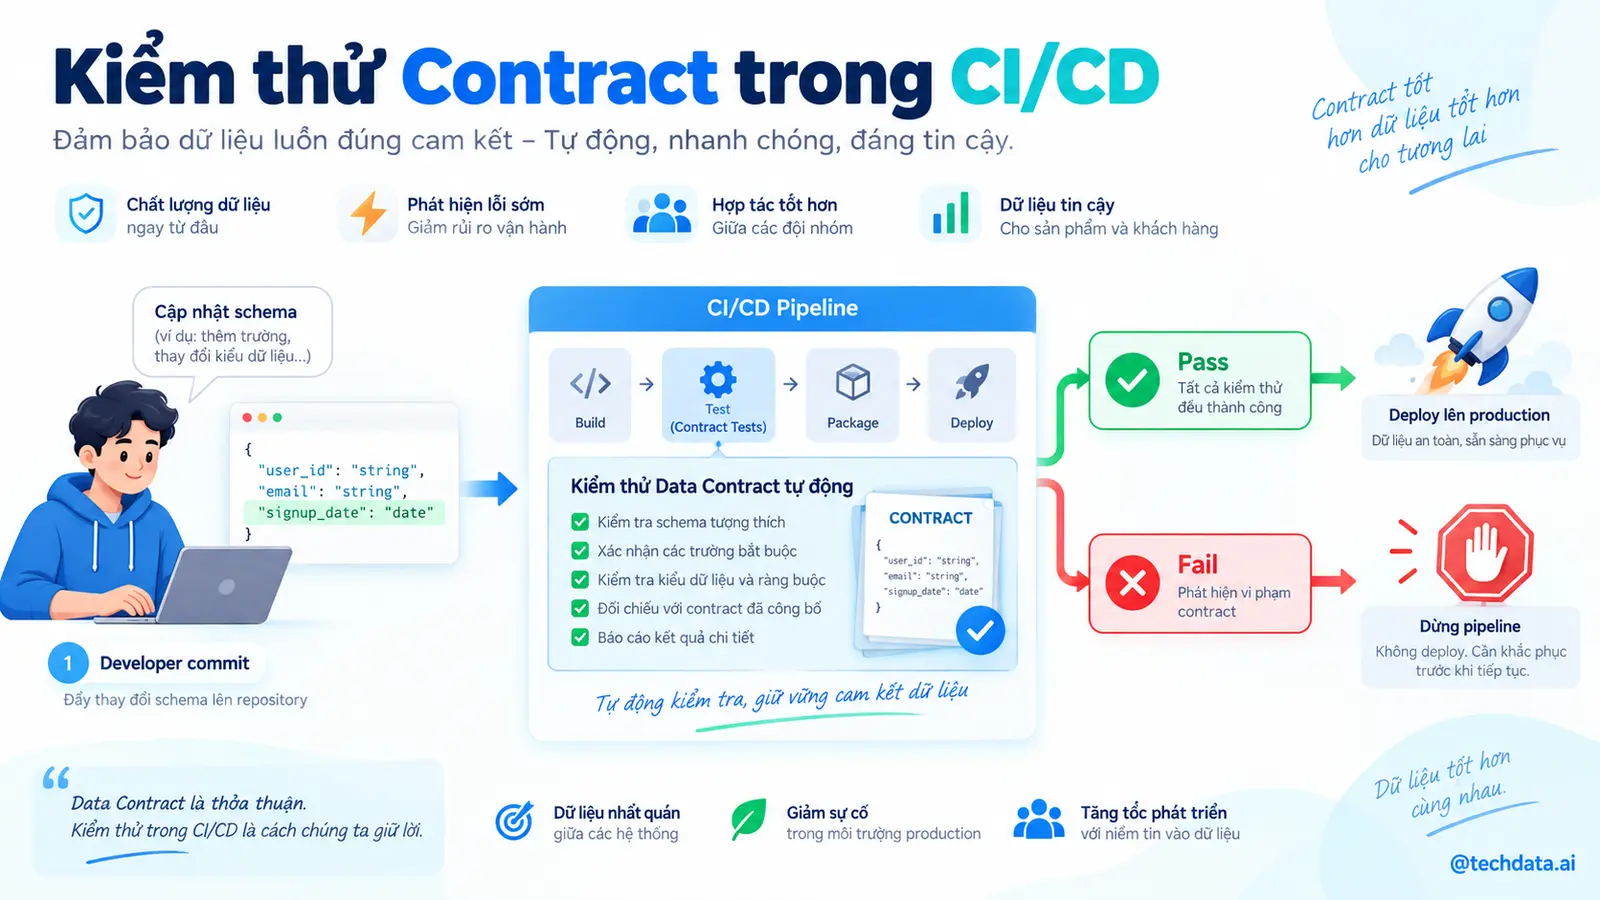
13. Kiểm thử trong CI/CD
Giá trị của Kiểm thử trong CI/CD không nằm ở một màn hình mới mà ở khả năng đưa ra kết quả nhất quán đúng thời điểm. Phạm vi dữ liệu cần làm rõ gồm test, sample data, compatibility và approval; các trường bắt buộc, lịch cập nhật và quyền sử dụng phải được kiểm tra trước khi tự động hóa. Nhóm dự án nên đưa contract vào pipeline CI/CD. Quy trình cần chỉ ra bước nào chạy tự động, bước nào chuyển cho người nghiệp vụ và điều kiện nào buộc hệ thống dừng vì thiếu dữ liệu.
Một bài kiểm tra hữu ích cho đội ERP đổi tên một cột và kiểu dữ liệu vào cuối tuần, khiến pipeline thất bại và dashboard doanh thu sáng thứ Hai không có số là cố ý đưa vào dữ liệu thiếu, cập nhật chậm và trường hợp mâu thuẫn để xem hệ thống có biết dừng hay không. Hiệu quả được đo bằng tỷ lệ build bị chặn đúng. Rủi ro quan trọng là test chạy sau deploy; quyền phê duyệt và trách nhiệm xử lý sai lệch phải được quy định rõ.
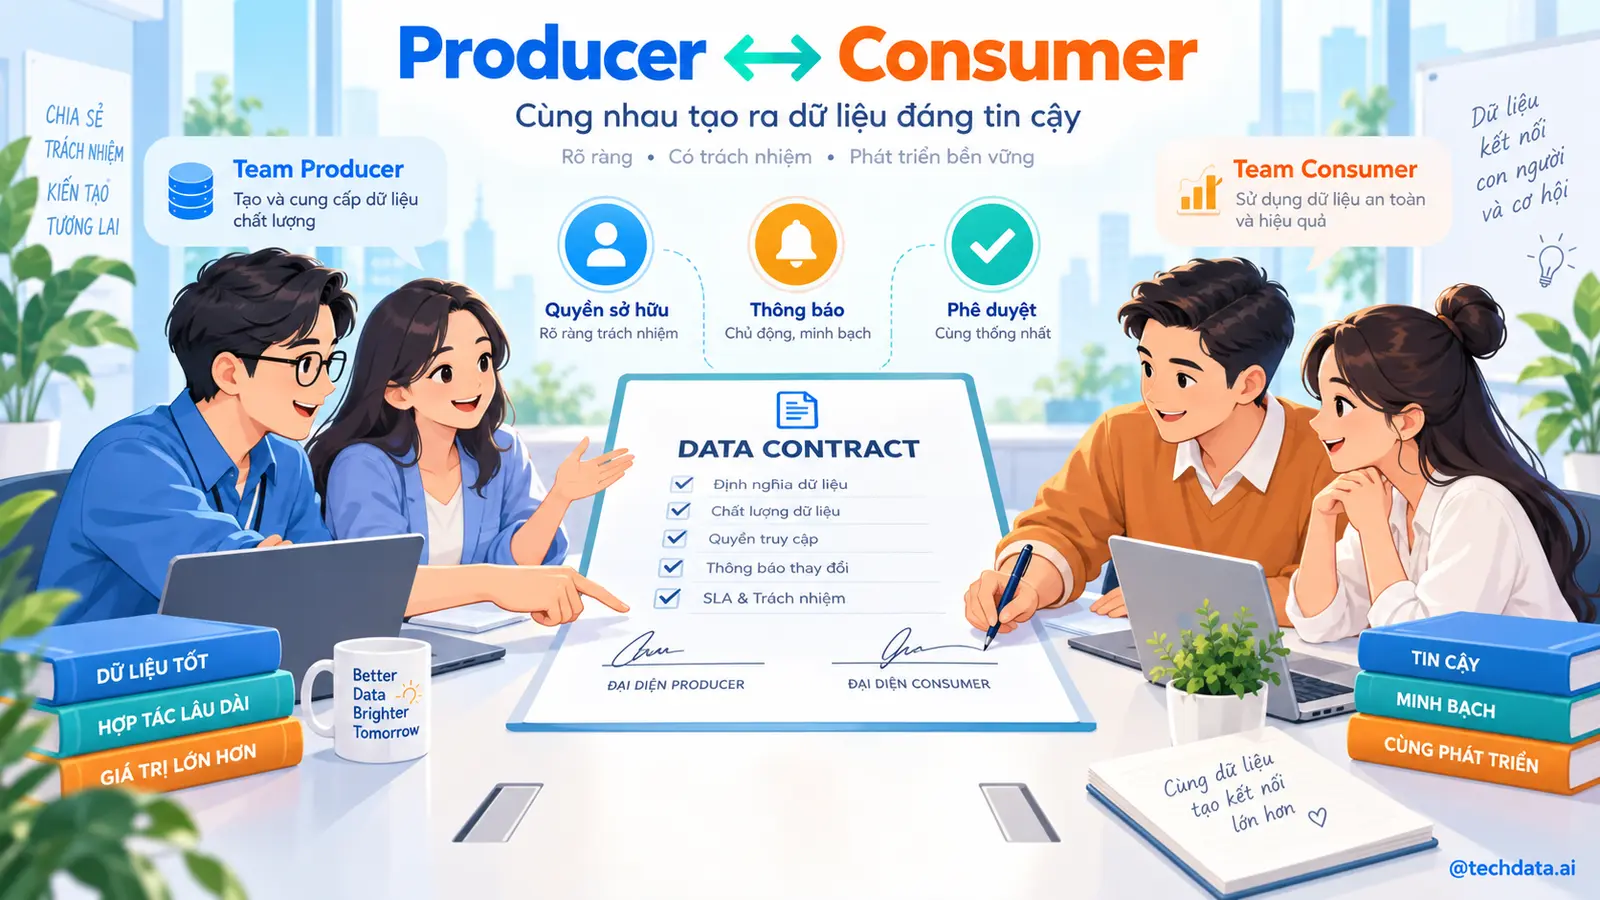
14. Phối hợp producer và consumer
Trong vận hành thực tế, Phối hợp producer và consumer liên quan trực tiếp tới ownership, change proposal, consumer list và SLA phản hồi. Nếu các yếu tố này chưa có định nghĩa chung, AI hoặc dashboard chỉ làm cho sự khác biệt xuất hiện nhanh hơn chứ không tự giải quyết được nó. Về kỹ thuật và quản trị, doanh nghiệp cần tạo quy trình thương lượng thay đổi ngắn gọn. Thay đổi phải được kiểm thử trên tình huống bình thường, dữ liệu thiếu và trường hợp có hậu quả lớn trước khi đưa vào quy trình thật.
Nếu áp dụng cho đội ERP đổi tên một cột và kiểu dữ liệu vào cuối tuần, khiến pipeline thất bại và dashboard doanh thu sáng thứ Hai không có số, nhóm triển khai cần đo đường cơ sở trước, chọn một chu kỳ nghiệp vụ hoàn chỉnh rồi đối chiếu kết quả với người đang làm công việc hằng ngày. Hiệu quả được đo bằng lead time thay đổi. Rủi ro quan trọng là producer quyết định một chiều; quyền phê duyệt và trách nhiệm xử lý sai lệch phải được quy định rõ.
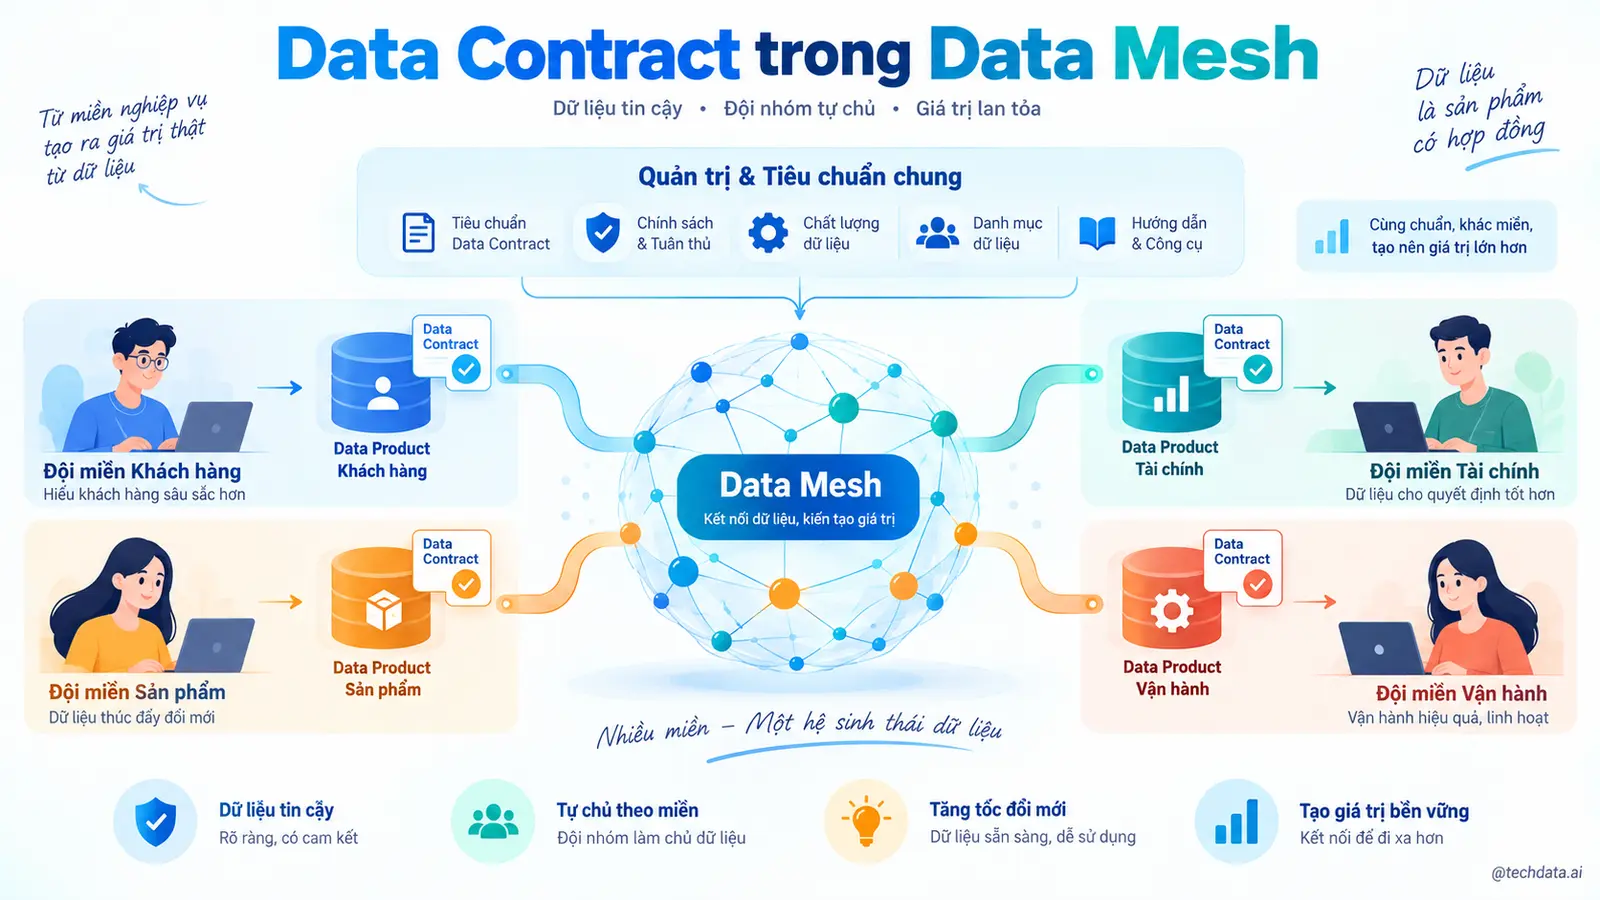
15. Contract trong Data Mesh
Contract trong Data Mesh thường trở thành điểm nghẽn khi dữ liệu nằm ở nhiều nơi hoặc mỗi bộ phận áp dụng một quy tắc khác nhau. Để xử lý, doanh nghiệp cần tập trung vào data product, domain owner và interface ổn định, xác định nguồn được coi là chuẩn và người có quyền giải quyết ngoại lệ. Cách triển khai phù hợp là dùng contract làm biên giữa domain. AI có thể hỗ trợ kiểm tra khối lượng lớn, phát hiện trường hợp bất thường và chuẩn bị phương án, nhưng kết quả phải kèm nguồn và quy tắc đã sử dụng.
Ở đội ERP đổi tên một cột và kiểu dữ liệu vào cuối tuần, khiến pipeline thất bại và dashboard doanh thu sáng thứ Hai không có số, kết quả nên được chuyển tới đúng người nghiệp vụ kèm dữ liệu nguồn, để họ có thể chấp nhận, sửa hoặc từ chối trước khi quy tắc được mở rộng. Hiệu quả được đo bằng khả năng tái sử dụng. Rủi ro quan trọng là mỗi đội định nghĩa khác nhau; quyền phê duyệt và trách nhiệm xử lý sai lệch phải được quy định rõ.
PHẦN III — DỮ LIỆU, AI AGENT VÀ KIỂM SOÁT
16. AI Assistant và AI Agent khác nhau thế nào?
AI Assistant chủ yếu trả lời hoặc tạo bản nháp sau khi người dùng đặt câu hỏi. AI Agent đi xa hơn: hệ thống có thể đọc dữ liệu được cấp quyền, gọi công cụ, thực hiện nhiều bước và theo dõi trạng thái của một nhiệm vụ.
Khác biệt quan trọng không nằm ở giao diện trò chuyện mà ở quyền hành động. Với đội ERP đổi tên một cột và kiểu dữ liệu vào cuối tuần, khiến pipeline thất bại và dashboard doanh thu sáng thứ Hai không có số, Assistant có thể giải thích vấn đề; Agent có thể chuẩn bị cập nhật hoặc gửi một nhiệm vụ. Những bước thay đổi dữ liệu, phát sinh chi phí hoặc ảnh hưởng con người vẫn cần điểm phê duyệt rõ.
17. Dữ liệu nào cần được sử dụng?
AI cần dữ liệu đúng với quyết định đang hỗ trợ, không cần toàn bộ dữ liệu doanh nghiệp ngay từ đầu. Nguồn chính gồm schema, kiểu dữ liệu, ý nghĩa trường, độ tươi, quy tắc chất lượng, quyền sở hữu và chính sách phiên bản. Mỗi nguồn phải có định nghĩa, chủ sở hữu, thời điểm cập nhật và mục đích sử dụng được phép.
Nhóm dự án nên bắt đầu bằng một bảng kiểm dữ liệu: trường nào bắt buộc, tỷ lệ thiếu, khóa liên kết, lịch sử đủ dài hay chưa và cách đối soát. Nếu chưa trả lời được, việc đổi mô hình hiếm khi cải thiện kết quả.
18. ERP, CRM, Data Warehouse và Data Platform đóng vai trò gì?
ERP và CRM ghi nhận giao dịch nghiệp vụ; Data Warehouse hợp nhất lịch sử để phân tích; Data Platform bổ sung pipeline, chất lượng, catalog, bảo mật và khả năng phục vụ nhiều ứng dụng. Các lớp này không thay thế nhau mà giải quyết những phần khác nhau của chuỗi giá trị dữ liệu.
AI nên truy cập dữ liệu qua những lớp đã được quản trị thay vì kết nối tùy ý vào từng hệ thống nguồn. Cách này giảm rủi ro làm chậm hệ thống vận hành, đồng thời giữ được định nghĩa và quyền truy cập nhất quán.
19. Data Quality ảnh hưởng tới kết quả ra sao?
Data Quality, tức chất lượng dữ liệu, thường được đánh giá qua độ đầy đủ, chính xác, nhất quán, hợp lệ và kịp thời. Một dataset có thể đạt bốn tiêu chí nhưng vẫn không dùng được nếu đến sau thời điểm ra quyết định.
Các kiểm tra quan trọng phải chạy tự động và có người nhận cảnh báo. Với hợp đồng dữ liệu, chất lượng không chỉ là tỷ lệ bản ghi lỗi; cần đo xem lỗi đó ảnh hưởng tới dashboard, AI Agent hoặc quyết định kinh doanh nào.
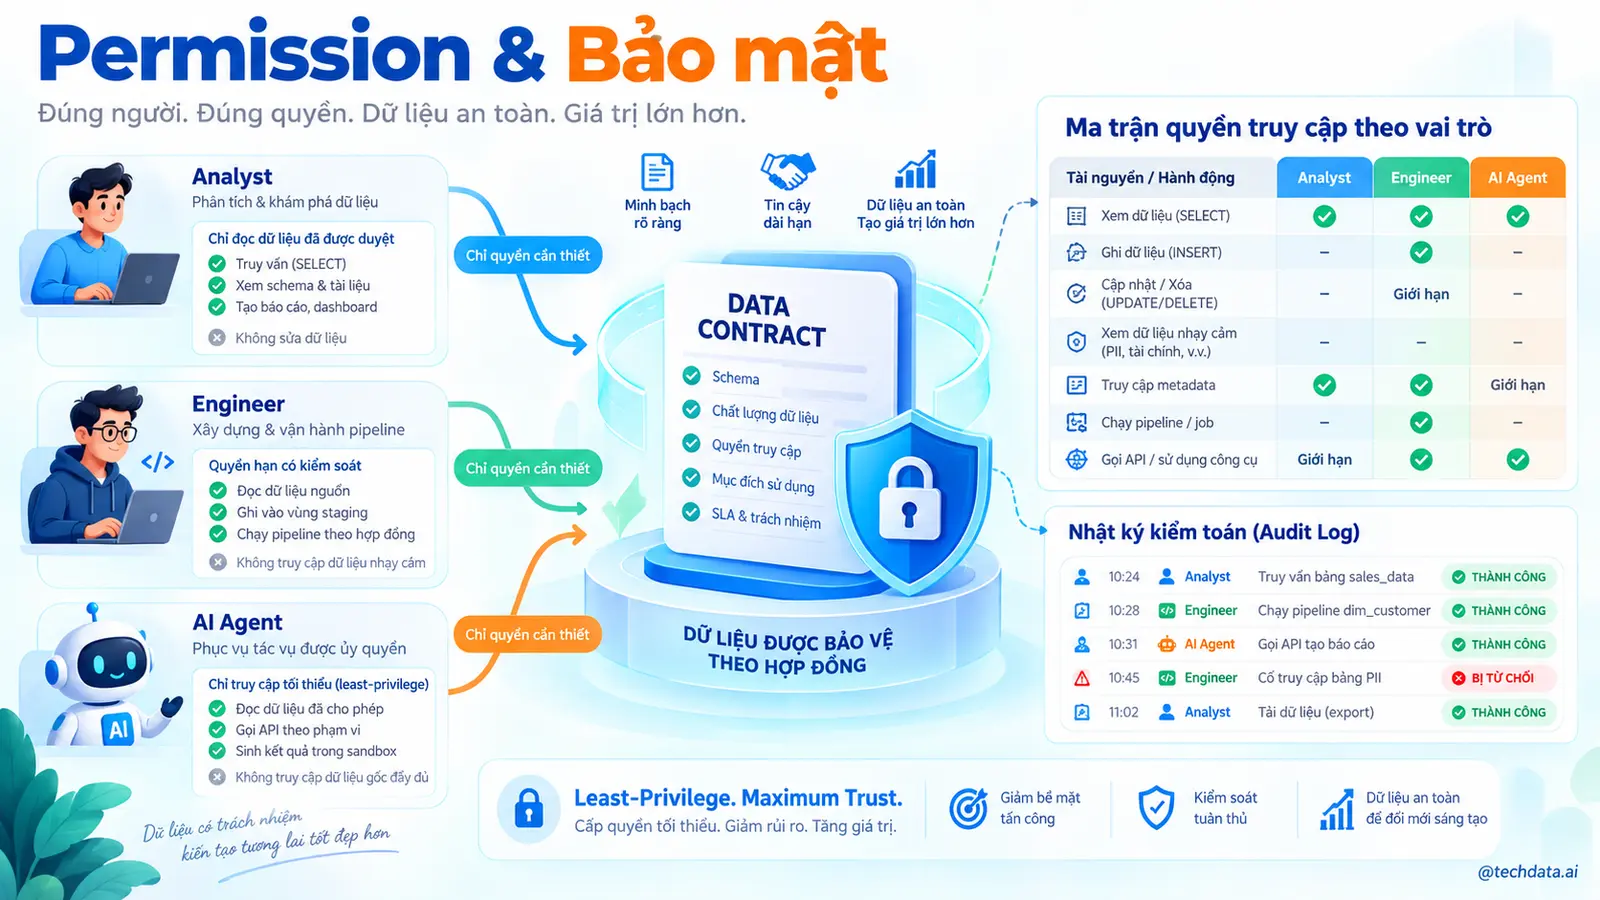
20. Permission và bảo mật dữ liệu
Permission là quyền truy cập và hành động. Người được xem báo cáo tổng hợp chưa chắc được xem dữ liệu chi tiết; AI được tạo đề xuất chưa chắc được ghi vào hệ thống. Quyền phải được kiểm tra ở từng lần truy cập, không chỉ ghi trong prompt.
Doanh nghiệp nên dùng tài khoản dịch vụ riêng, nguyên tắc quyền tối thiểu, giới hạn thời gian và nhật ký đầy đủ. Dữ liệu nhạy cảm cần được che hoặc loại bỏ khi không cần thiết cho nhiệm vụ.
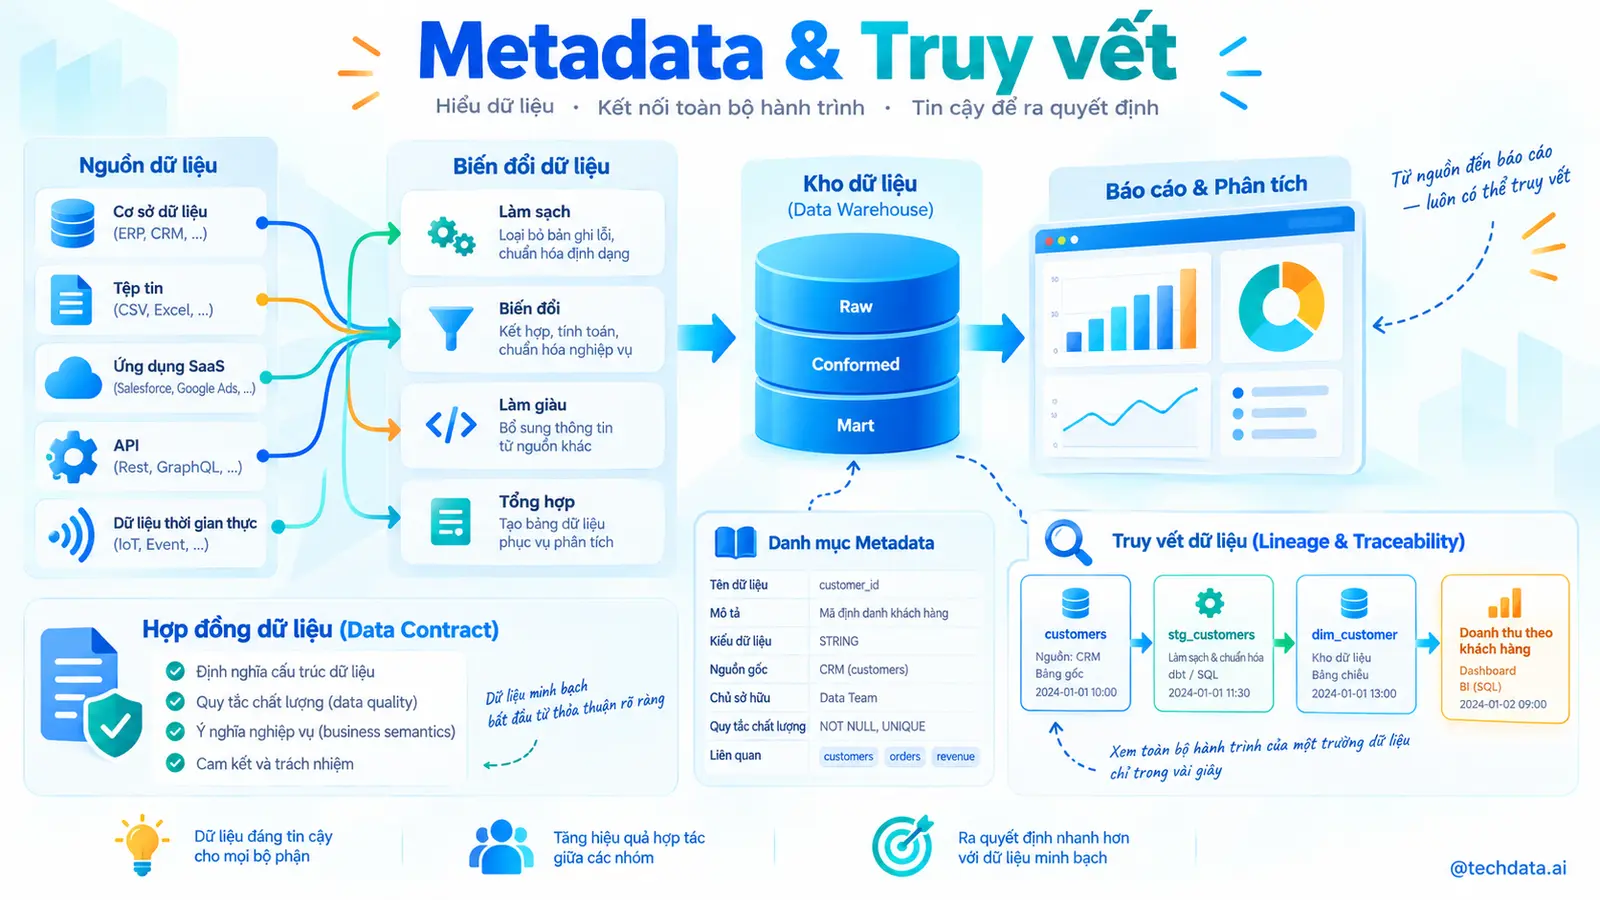
21. Định nghĩa, metadata và khả năng truy vết
Định nghĩa nghiệp vụ giải thích một trường hoặc KPI có nghĩa gì. Metadata mô tả cấu trúc, nguồn, chủ sở hữu và thời điểm cập nhật. Khả năng truy vết cho biết dữ liệu đã đi qua những bước nào trước khi xuất hiện trong báo cáo hoặc câu trả lời AI.
Ba lớp này giúp người dùng kiểm chứng thay vì tin mù quáng. Khi một số liệu sai, đội dữ liệu có thể khoanh vùng nguồn và bước biến đổi; khi một thay đổi sắp diễn ra, họ biết hệ thống nào sẽ bị ảnh hưởng.
PHẦN IV — TRIỂN KHAI TRONG DOANH NGHIỆP
22. Doanh nghiệp nên bắt đầu từ đâu?
Điểm bắt đầu phù hợp là một vấn đề có người sở hữu, dữ liệu tiếp cận được và kết quả đo trong 90 ngày. Doanh nghiệp nên viết đề bài trong một trang: hiện trạng, quyết định cần cải thiện, người dùng, dữ liệu, rủi ro và tiêu chuẩn thành công.
Không nên khởi động bằng mục tiêu chuyển đổi toàn doanh nghiệp. Phạm vi nhỏ giúp phát hiện vấn đề về định nghĩa, quyền và cách làm việc khi chi phí sửa còn thấp.
23. Ba use case đầu tiên ít rủi ro
Ba use case đầu tiên nên bao gồm một use case tra cứu hoặc giải thích có dẫn nguồn, một use case phát hiện ngoại lệ và một use case chuẩn bị hành động nhưng chưa tự thực hiện. Cấu trúc này kiểm tra lần lượt dữ liệu, khả năng phân tích và khả năng đưa kết quả vào quy trình.
Mỗi use case cần một baseline và người duyệt. Nếu không tốt hơn cách hiện tại về số breaking change, thời gian phát hiện, thời gian phục hồi, tỷ lệ contract được kiểm thử và số downstream bị ảnh hưởng, dự án chưa có lý do để mở rộng dù giao diện hấp dẫn.
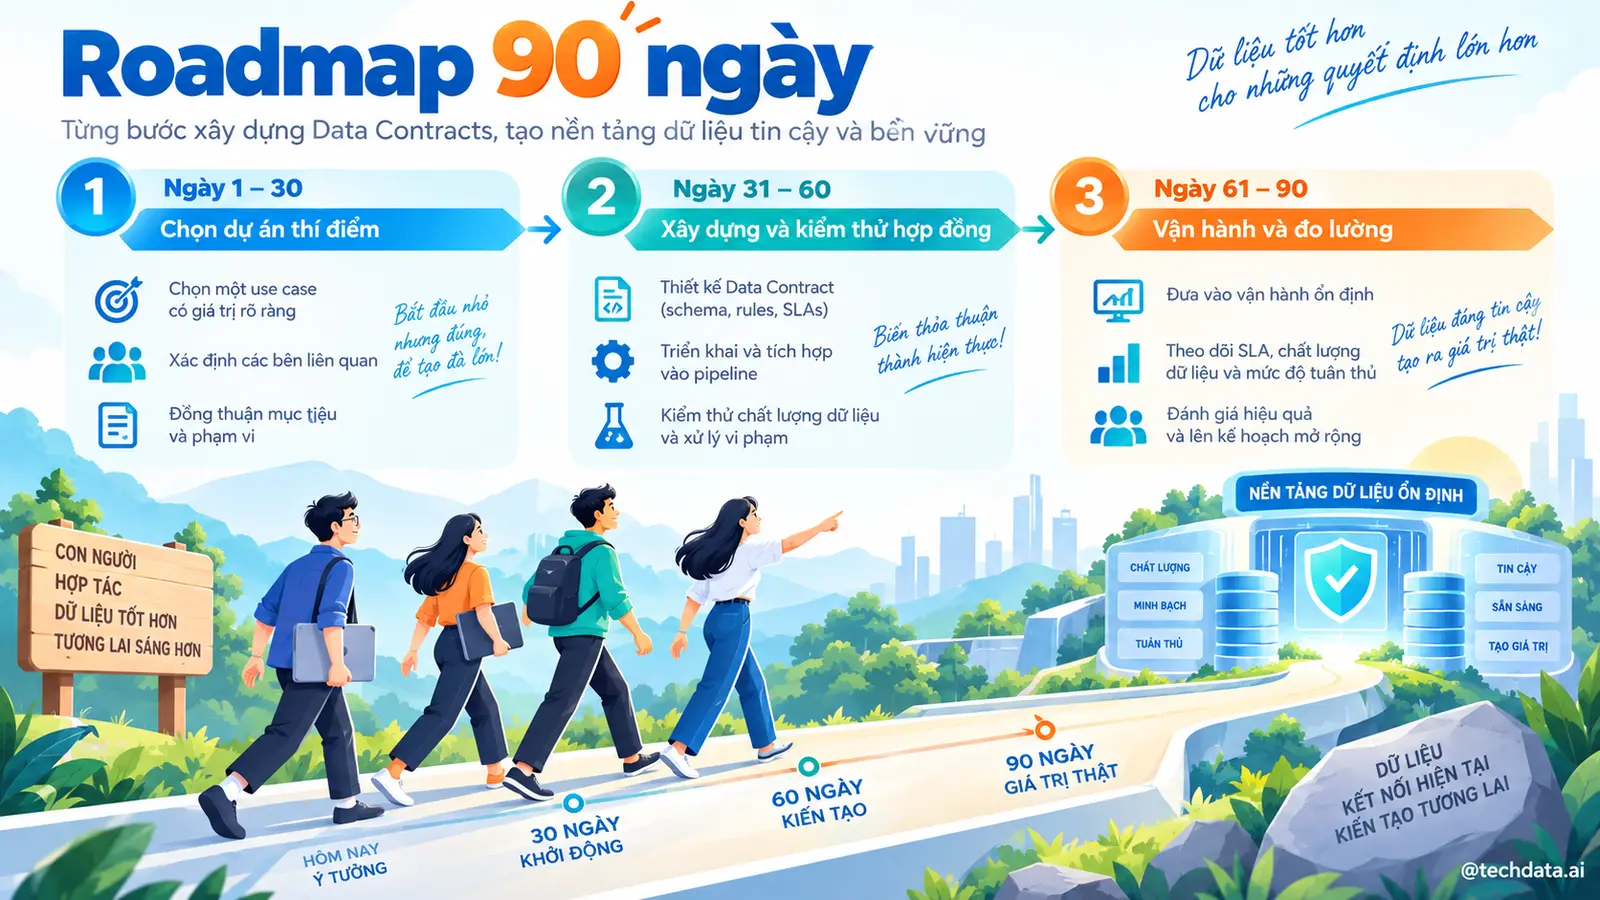
24. Roadmap triển khai 90 ngày
Trong 30 ngày đầu, doanh nghiệp chốt bài toán, đo baseline, kiểm tra dữ liệu và xác định quyền. Ngày 31–60 tập trung xây phiên bản tối thiểu, kiểm thử trên dữ liệu thật và chạy song song với quy trình cũ.
Ngày 61–90 mới đưa hệ thống vào một phạm vi vận hành có kiểm soát. Cuối giai đoạn phải có quyết định rõ: mở rộng, điều chỉnh hay dừng. Pilot không đạt không phải thất bại nếu giúp tránh một khoản đầu tư lớn sai hướng.
25. KPI nào cần đo?
KPI phải kết hợp kết quả kinh doanh, chất lượng, vận hành và rủi ro. Với bài toán này, nhóm chỉ số trọng tâm gồm số breaking change, thời gian phát hiện, thời gian phục hồi, tỷ lệ contract được kiểm thử và số downstream bị ảnh hưởng. Cần đo trước khi triển khai để tránh tình trạng chỉ có số sau nhưng không biết cải thiện bao nhiêu.
Số lượt dùng, số câu trả lời hoặc số tính năng không đại diện cho giá trị. Một hệ thống được dùng nhiều nhưng tạo cảnh báo nhiễu hoặc khiến nhân viên phải kiểm tra lại lâu hơn vẫn là một hệ thống kém hiệu quả.
26. Những sai lầm phổ biến
Sai lầm phổ biến gồm mua công cụ trước khi thống nhất định nghĩa, giao dự án hoàn toàn cho IT, dùng dữ liệu mẫu quá sạch và không có tiêu chí dừng. Doanh nghiệp cũng thường đánh giá thấp công việc quản lý thay đổi và hỗ trợ sau go-live.
Sai lầm nguy hiểm nhất là coi câu trả lời có vẻ hợp lý như bằng chứng hệ thống đúng. Mọi kết quả quan trọng cần có nguồn, ngữ cảnh, quyền và người chịu trách nhiệm.
27. Khi nào nên mở rộng phạm vi?
Phạm vi chỉ nên mở rộng khi chất lượng ổn định qua nhiều chu kỳ, người dùng thật chấp nhận kết quả và đội vận hành có thể xử lý sự cố. Mở rộng có thể theo số người dùng, domain dữ liệu hoặc mức quyền của Agent, nhưng không nên tăng cả ba cùng lúc.
Mỗi bước mở rộng cần kiểm tra lại chi phí, bảo mật và tác động downstream. Điều phù hợp với 20 người dùng chưa chắc giữ nguyên khi triển khai cho hàng nghìn người và nhiều đơn vị.
PHẦN V — TÌNH HUỐNG TỔNG THỂ VÀ TƯƠNG LAI
28. Một tình huống doanh nghiệp tổng thể
Giả sử đội ERP đổi tên một cột và kiểu dữ liệu vào cuối tuần, khiến pipeline thất bại và dashboard doanh thu sáng thứ Hai không có số. Ban đầu, mỗi bộ phận chuẩn bị một báo cáo riêng và mất nhiều ngày để tranh luận số nào đúng. Nhóm dự án chọn một quyết định quan trọng, xác định schema, kiểu dữ liệu, ý nghĩa trường, độ tươi, quy tắc chất lượng, quyền sở hữu và chính sách phiên bản và giao trách nhiệm rõ cho data producer, data consumer, Data Engineer, Analytics Engineer và chủ sở hữu domain.
Hệ thống đầu tiên chỉ chạy trong một phạm vi nhỏ, lưu lại dữ liệu nguồn và chuyển ngoại lệ cho người duyệt. Sau ba tháng, doanh nghiệp không hỏi công nghệ có hiện đại hay không mà so sánh số breaking change, thời gian phát hiện, thời gian phục hồi, tỷ lệ contract được kiểm thử và số downstream bị ảnh hưởng với đường cơ sở.
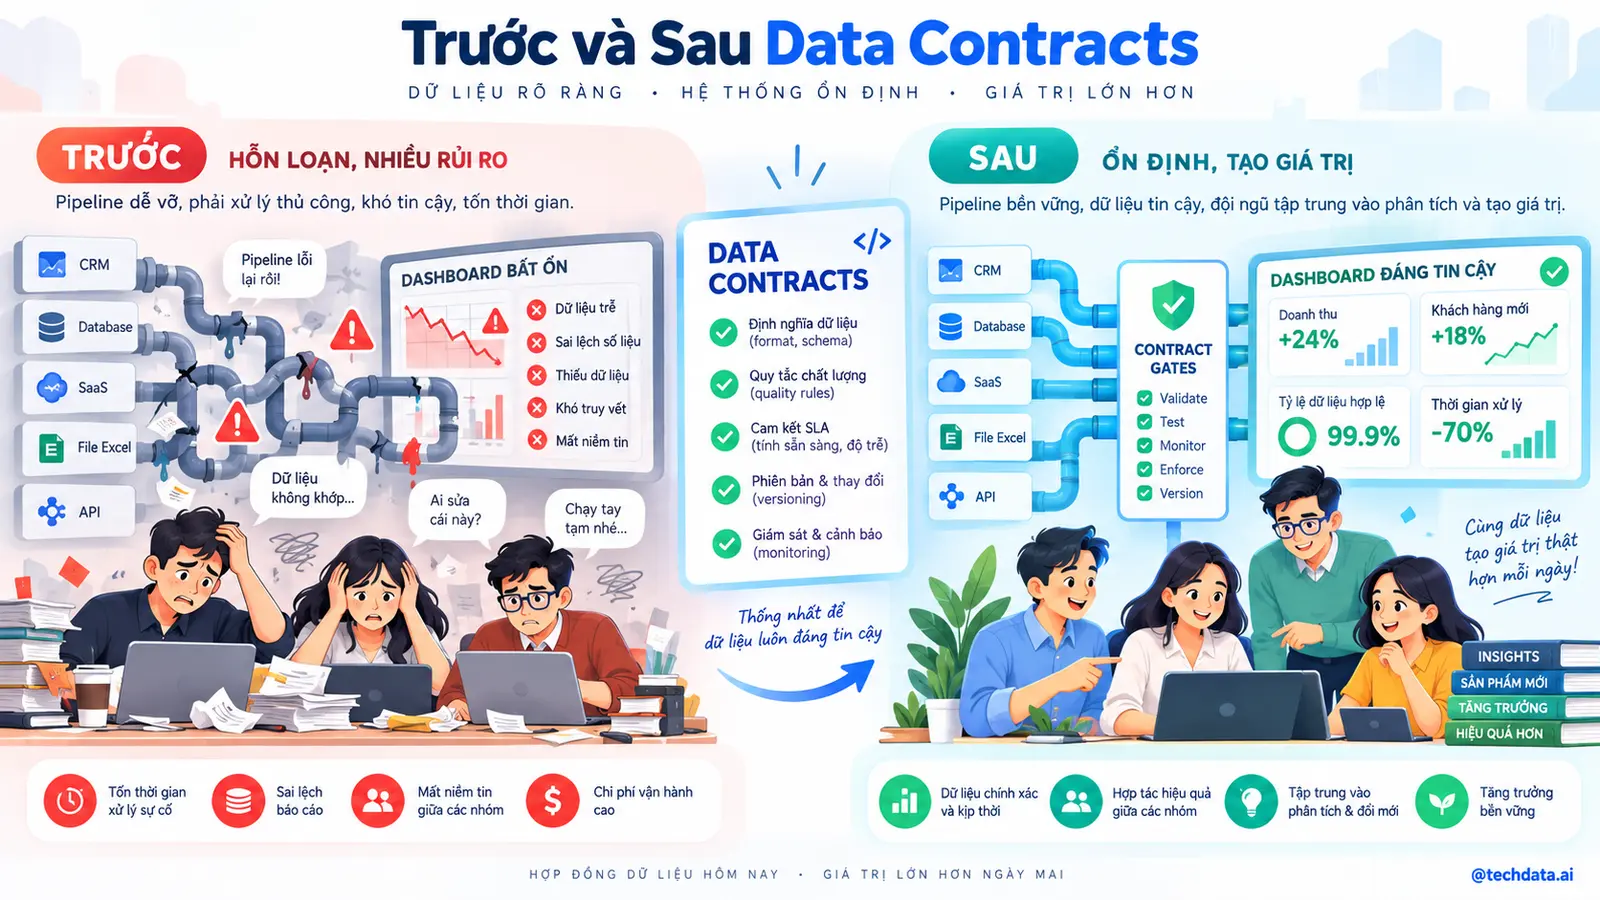
29. Trước và sau khi triển khai
Trước triển khai, phần lớn thời gian được dùng để thu thập, ghép và đối soát. Khi có vấn đề, người dùng phải hỏi nhiều bộ phận và thường chỉ phát hiện sau khi báo cáo đã được sử dụng.
Sau triển khai, các kiểm tra lặp lại được tự động hóa, ngoại lệ có chủ sở hữu và kết quả cho phép truy ngược. Con người dành nhiều thời gian hơn cho phân tích nguyên nhân, lựa chọn phương án và xử lý những trường hợp dữ liệu chưa phản ánh đủ bối cảnh.
30. Công việc sẽ thay đổi như thế nào?
Nhiều công việc thu thập metadata, kiểm tra quy tắc, tạo báo cáo ban đầu và phân loại sự cố sẽ được tự động hóa. Vai trò của nhân sự dữ liệu chuyển từ sản xuất đầu ra thủ công sang thiết kế tiêu chuẩn, đánh giá chất lượng và hỗ trợ quyết định.
Con người vẫn giữ vai trò chính ở việc định nghĩa đúng–sai, cân nhắc đánh đổi, xử lý ngoại lệ và chịu trách nhiệm. AI làm thay đổi cách làm việc nhiều hơn là xóa bỏ toàn bộ một nghề.
31. Kết luận
Data Contract biến kỳ vọng ngầm giữa bên tạo và bên sử dụng dữ liệu thành cam kết có thể kiểm thử, quản lý phiên bản và xử lý khi thay đổi. Công nghệ chỉ tạo giá trị khi được đặt trên dữ liệu đáng tin, quy trình có chủ sở hữu và quyền hạn được kiểm soát.
Câu hỏi chiến lược doanh nghiệp nên bắt đầu là: trong 90 ngày, quyết định nào có thể được cải thiện và bằng dữ liệu nào tổ chức sẽ chứng minh điều đó? Data cung cấp sự thật, quy trình đưa kết quả vào công việc, AI giúp xử lý ở quy mô lớn; con người vẫn chịu trách nhiệm cuối cùng.
Tài liệu tham khảo
- dbt — Model contracts
- dbt — Model versions
- Microsoft — Data governance with Microsoft Purview
- Microsoft — Data lineage in Purview
- Google Cloud — About data lineage
- Google Cloud — Scan for data quality issues
- Google Cloud — Data observability
- Google Cloud — BigQuery AI data platform
TechData.AI - Leading the Future.
Tham khảo các khoá học theo link: https://techdata.ai/techdata-ai-course/
Hoàng Minh.