



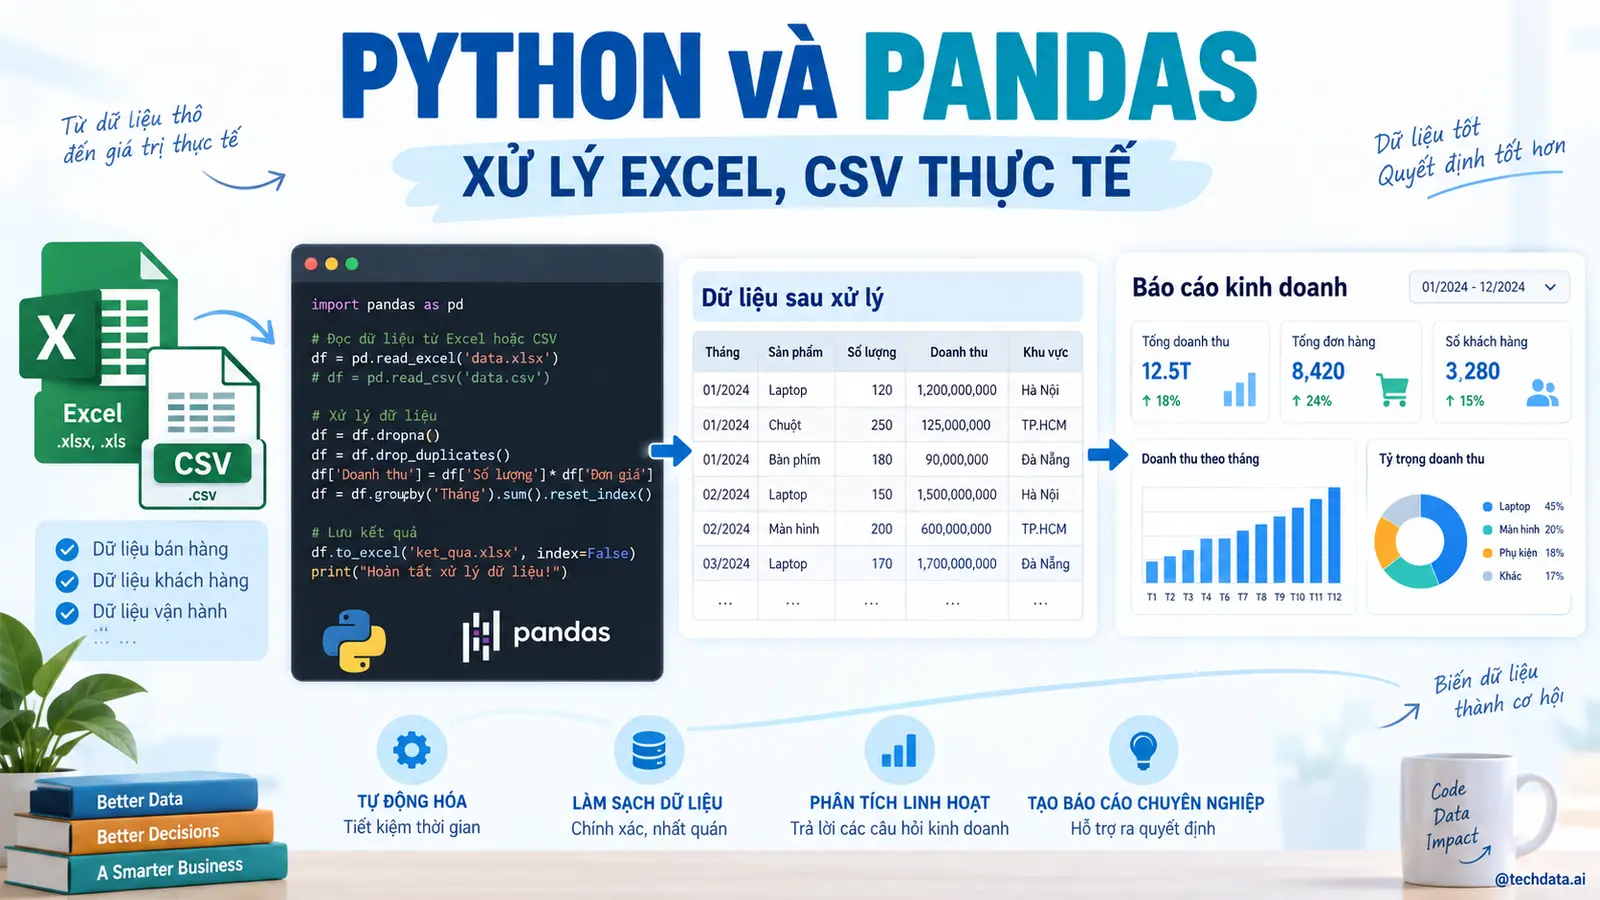

Trong nhiều doanh nghiệp, Excel và CSV vẫn là hai định dạng trao đổi dữ liệu phổ biến nhất. Vấn đề không nằm ở việc mở một file, mà xuất hiện khi người phụ trách phải nhận hàng chục file từ nhiều cửa hàng, kiểm tra cấu trúc, sửa lỗi dữ liệu, gộp kết quả và lập báo cáo lặp lại mỗi ngày. Bài viết này xây dựng một project Python hoàn chỉnh để tự động hóa công việc đó bằng Pandas.
Mục lục
- Bài toán thực tế
- Sau bài này bạn sẽ làm được gì?
- Kiến thức Python cần dùng
- Chuẩn bị môi trường
- Hiểu dữ liệu đầu vào
- Xây dựng ứng dụng từng bước
- Ghép thành chương trình hoàn chỉnh
- Kiểm tra kết quả
- Những lỗi thường gặp
- Nâng cấp từ demo thành ứng dụng thực tế
- Bài tập thực hành
- Project mở rộng
- Tổng kết
- Tài liệu tham khảo
1. Bài toán thực tế
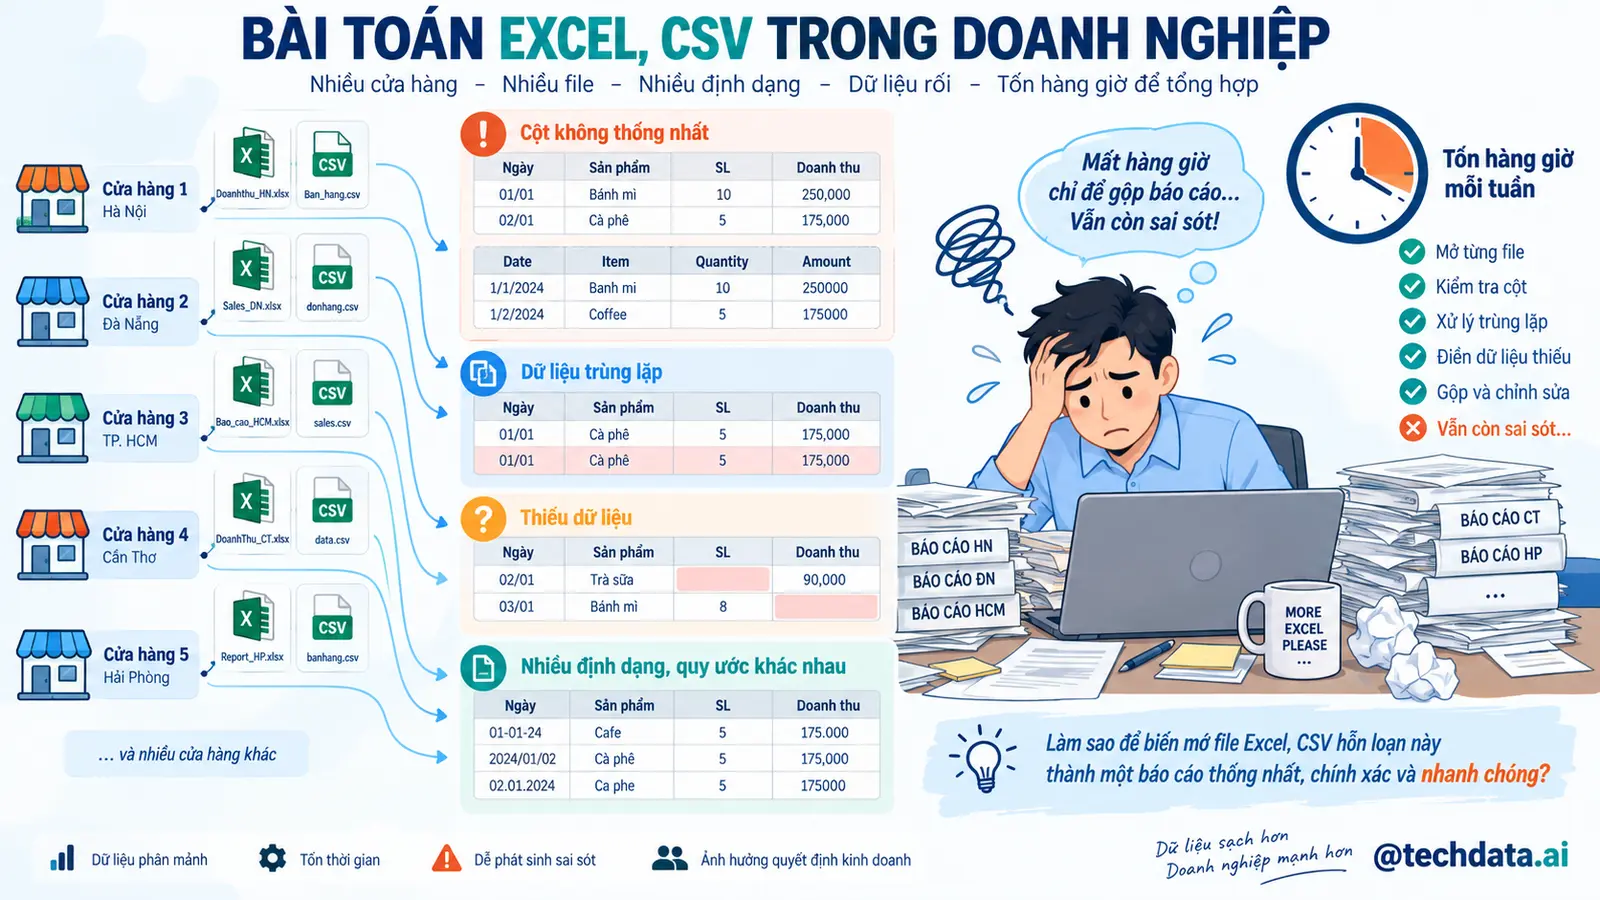
Giả sử một công ty bán lẻ có 30 cửa hàng. Cuối mỗi ngày, từng cửa hàng gửi một file doanh số về bộ phận vận hành. Một số cửa hàng dùng Excel, số khác xuất CSV từ phần mềm bán hàng. Nhân viên phụ trách phải tải các file về, sao chép dữ liệu vào một bảng tổng, sửa tên cột, định dạng ngày, loại dòng trùng, kiểm tra số lượng và tính doanh thu. Công việc nghe có vẻ đơn giản nhưng thường mất từ một đến hai giờ mỗi ngày.
Rủi ro lớn nhất không phải thời gian thao tác mà là chất lượng dữ liệu. Mã đơn hàng có thể bị Excel chuyển sang số. Ngày bán được nhập theo nhiều định dạng. Mã sản phẩm có khoảng trắng ở đầu hoặc cuối. Một đơn hàng có thể xuất hiện trong hai file vì cửa hàng gửi lại bản đã chỉnh sửa. Số lượng hoặc đơn giá có thể là số âm, trong khi một vài dòng không có mã đơn hàng. Nếu người xử lý chỉ gộp file rồi tính tổng, báo cáo vẫn được tạo nhưng doanh thu có thể sai.
Project trong bài sẽ thay công việc thủ công bằng một chương trình có quy trình rõ ràng. Chương trình tìm toàn bộ file Excel và CSV trong thư mục đầu vào, đọc từng file, chuẩn hóa tên cột, chuyển đổi kiểu dữ liệu, loại bản ghi trùng, tách dữ liệu không hợp lệ, tính doanh thu và xuất một workbook báo cáo. Quan trọng hơn, chương trình tạo số liệu đối soát để người vận hành biết dữ liệu đã thay đổi như thế nào trong quá trình xử lý.
2. Sau bài này bạn sẽ làm được gì?
Sau khi hoàn thành bài viết, bạn sẽ có một project nhận nhiều file doanh số từ thư mục data/raw, xử lý chúng bằng Pandas và tạo file output/sales_report.xlsx. Workbook kết quả gồm bốn sheet: dữ liệu hợp lệ đã làm sạch, dữ liệu không hợp lệ cần kiểm tra, báo cáo doanh thu theo cửa hàng và bảng kiểm soát chất lượng dữ liệu.
Sản phẩm không chỉ thực hiện thao tác gộp file. Nó còn trả lời được các câu hỏi quan trọng: chương trình đã đọc bao nhiêu file, nhận bao nhiêu dòng, loại bao nhiêu bản ghi trùng, phát hiện bao nhiêu dòng lỗi, còn bao nhiêu dòng hợp lệ và tổng doanh thu sau xử lý là bao nhiêu. Đây là điểm khác biệt giữa một đoạn script tiện ích và một quy trình dữ liệu có thể kiểm soát.
Project sử dụng dữ liệu mẫu nhưng cách tổ chức có thể áp dụng cho báo cáo bán hàng, tồn kho, công nợ, danh sách khách hàng hoặc dữ liệu vận hành từ nhiều chi nhánh.
3. Kiến thức Python cần dùng
Project sử dụng pathlib.Path để làm việc với đường dẫn và tìm file. So với việc ghép chuỗi đường dẫn thủ công, Path giúp code dễ đọc và hoạt động nhất quán hơn trên Windows, macOS và Linux.
Pandas là thư viện xử lý dữ liệu chính. Mỗi file sau khi đọc được biểu diễn dưới dạng DataFrame, một cấu trúc hai chiều gồm hàng và cột. Chúng ta dùng pd.read_csv() để đọc CSV, pd.read_excel() để đọc Excel, pd.concat() để gộp nhiều DataFrame, các phương thức chuyển đổi kiểu dữ liệu để làm sạch và ExcelWriter để ghi nhiều sheet vào cùng một workbook.
OpenPyXL là engine được Pandas sử dụng khi đọc và ghi file .xlsx. Trong project này, phần lớn thao tác được thực hiện qua Pandas; OpenPyXL chỉ cần được cài đặt để hỗ trợ định dạng Excel.
Code được chia thành các function nhỏ. Mỗi function đảm nhận một trách nhiệm như đọc file, chuẩn hóa dữ liệu, kiểm tra quy tắc nghiệp vụ hoặc xuất báo cáo. Cách tổ chức này giúp kiểm thử, sửa lỗi và tái sử dụng code dễ hơn so với đặt toàn bộ logic trong một đoạn chương trình dài.
4. Chuẩn bị môi trường
Project có thể chạy với Python 3.11 trở lên. Nên dùng virtual environment để thư viện của project không xung đột với những project khác.
Tạo thư mục project và môi trường ảo:
mkdir python-sales-report
cd python-sales-report
python -m venv .venv
Kích hoạt môi trường trên Windows:
.venv\Scripts\activate
Kích hoạt môi trường trên macOS hoặc Linux:
source .venv/bin/activate
Cài thư viện:
python -m pip install pandas openpyxl
Tạo file requirements.txt để cố định nhóm phụ thuộc chính của project:
pandas>=2.2,<4.0
openpyxl>=3.1,<4.0
Cấu trúc thư mục được sử dụng trong bài:
python-sales-report/
    data/
        raw/
            sales_hcm_01.xlsx
            sales_hcm_02.csv
            sales_hanoi_01.xlsx
    output/
    main.py
    requirements.txt
Mỗi file đầu vào chứa dữ liệu giao dịch với các cột order_id, order_date, store_id, product_id, quantity và unit_price. Bạn có thể tạo vài file mẫu từ Excel hoặc xuất CSV với encoding UTF-8. Để project thể hiện đúng giá trị thực tế, nên chủ động thêm một số dòng trùng, ngày sai định dạng, mã đơn hàng trống và số lượng âm.
5. Hiểu dữ liệu đầu vào
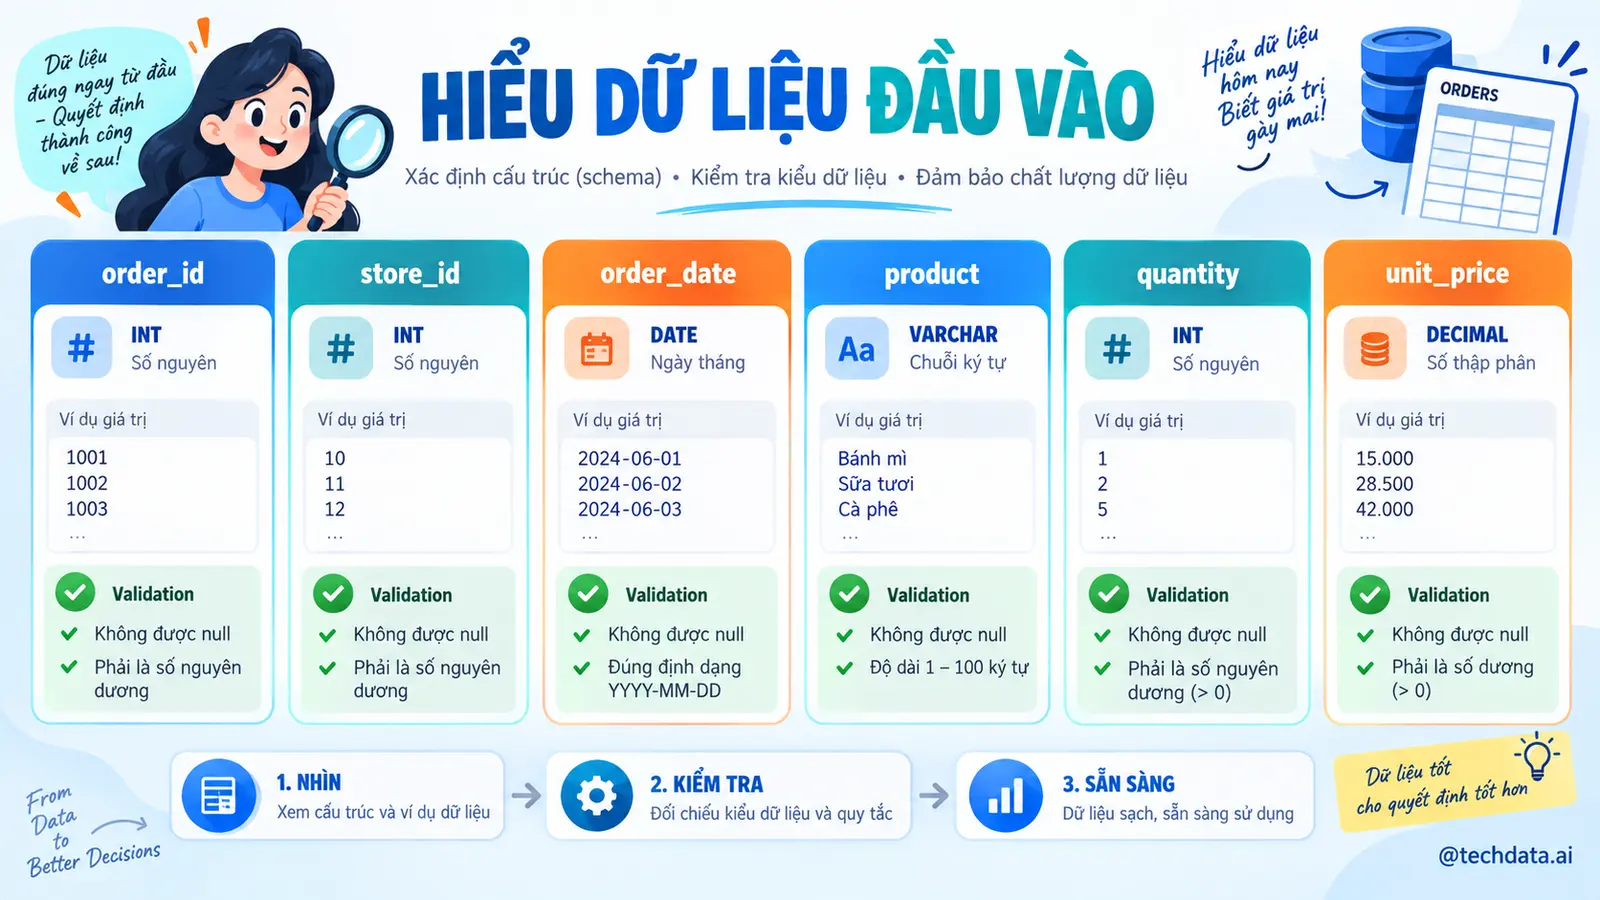
Trước khi viết code xử lý, cần xác định ý nghĩa nghiệp vụ của từng cột. Nếu không có bước này, chương trình có thể chuyển đổi dữ liệu đúng về mặt kỹ thuật nhưng sai về mặt kinh doanh.
| Cột | Kiểu dữ liệu mong đợi | Ý nghĩa nghiệp vụ | Quy tắc kiểm tra |
|---|---|---|---|
order_id | String | Mã duy nhất của đơn hàng | Không được trống |
order_date | Datetime | Ngày ghi nhận giao dịch | Phải chuyển được thành ngày hợp lệ |
store_id | String | Mã cửa hàng | Không được trống |
product_id | String | Mã sản phẩm | Không được trống |
quantity | Integer | Số lượng bán | Phải lớn hơn 0 |
unit_price | Decimal hoặc float | Đơn giá bán | Phải không âm |
Trong project mẫu, một giao dịch hợp lệ được nhận diện duy nhất bằng tổ hợp order_id và product_id. Lý do là một đơn hàng có thể chứa nhiều sản phẩm. Nếu chỉ dùng order_id để loại trùng, chương trình có thể vô tình xóa những dòng sản phẩm hợp lệ trong cùng đơn hàng. Trong hệ thống thật, khóa nhận diện nên được xác nhận với bộ phận nghiệp vụ và có thể cần thêm số dòng đơn hàng, mã cửa hàng hoặc thời điểm cập nhật.
Kiểu dữ liệu của mã định danh cần được xử lý cẩn thận. Mã 00125 không phải số dùng để tính toán mà là một chuỗi có ý nghĩa. Nếu đọc thành số nguyên, nó sẽ trở thành 125 và mất hai số 0 ở đầu. Vì vậy, các cột mã được đọc hoặc chuyển thành kiểu string.
Ngày tháng cũng dễ gây sai lệch. Chuỗi 03/04/2026 có thể được hiểu là ngày 3 tháng 4 hoặc ngày 4 tháng 3 tùy quy ước. Trong dữ liệu doanh nghiệp tại Việt Nam, nếu nguồn sử dụng định dạng ngày, tháng, năm, chương trình cần chỉ định quy tắc rõ ràng hoặc yêu cầu nguồn gửi theo một định dạng thống nhất như YYYY-MM-DD.
Giá trị thiếu không phải lúc nào cũng được biểu diễn bằng ô trống. File có thể chứa N/A, null, NULL, dấu gạch hoặc chuỗi chỉ gồm khoảng trắng. Chương trình cần chuẩn hóa chúng trước khi kiểm tra. Tương tự, đơn giá đôi khi có dấu phân cách hàng nghìn hoặc ký hiệu tiền tệ. Bài này giả định đơn giá là dữ liệu số có thể chuyển đổi trực tiếp; phần bài tập sẽ yêu cầu mở rộng cho những định dạng phức tạp hơn.
6. Xây dựng ứng dụng từng bước
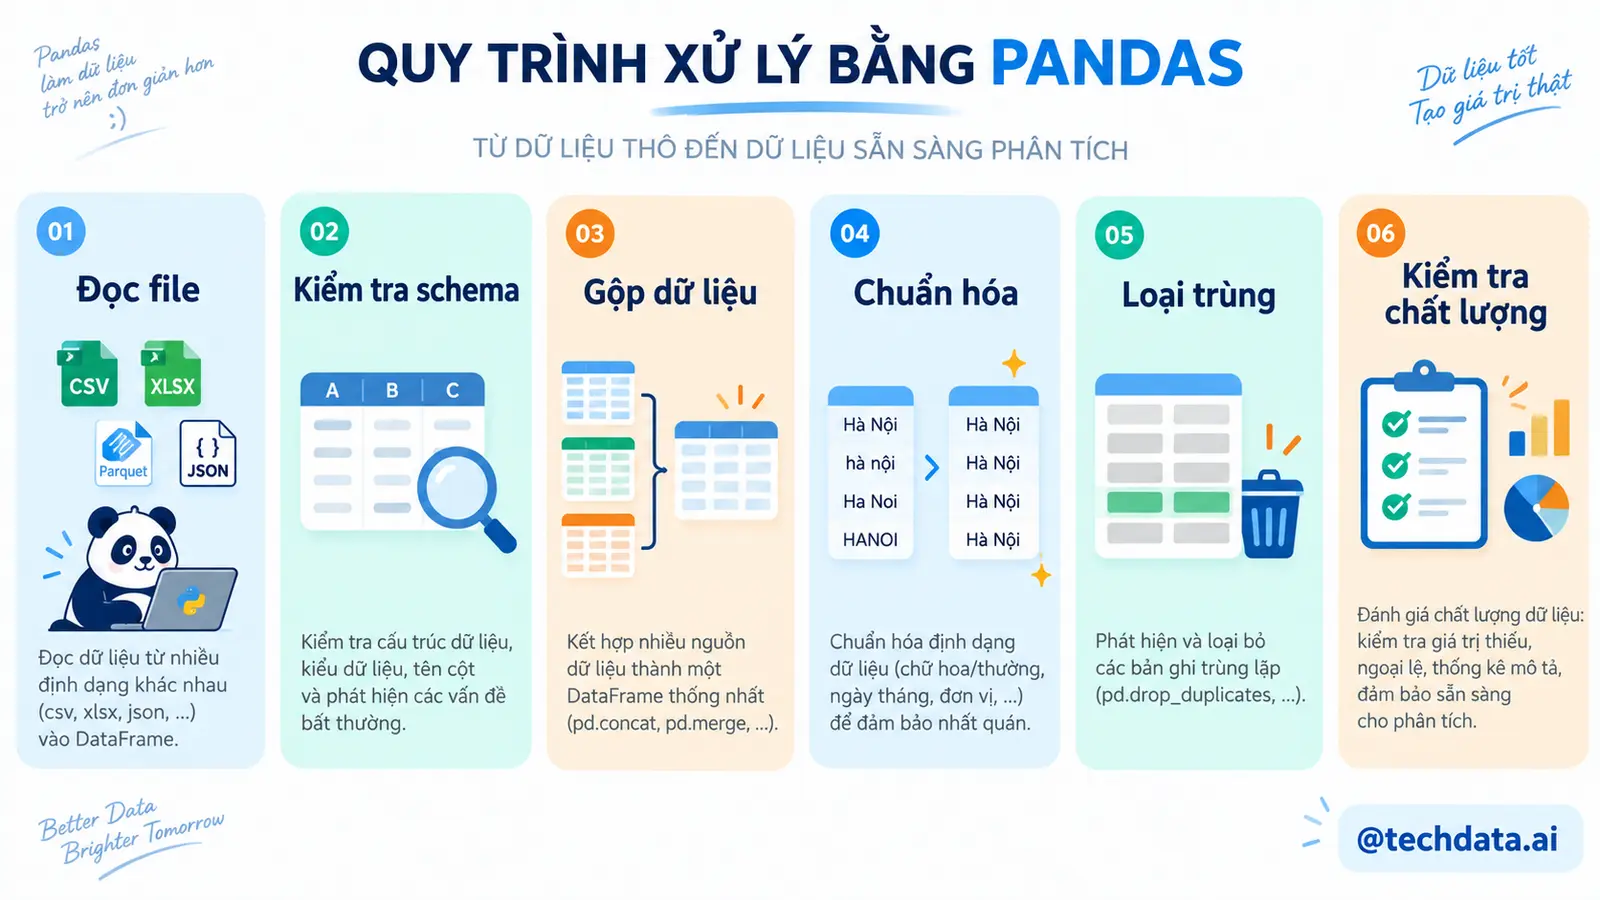
Bước 1: Khai báo cấu hình và schema bắt buộc
Vấn đề. Nếu tên thư mục, danh sách cột và khóa kiểm tra được viết lặp lại ở nhiều nơi, việc thay đổi yêu cầu sẽ dễ tạo ra sai lệch. Chúng ta đặt các giá trị này ở đầu chương trình.
from pathlib import Path

import pandas as pd


INPUT_DIR = Path("data/raw")
OUTPUT_DIR = Path("output")
OUTPUT_FILE = OUTPUT_DIR / "sales_report.xlsx"

REQUIRED_COLUMNS = [
    "order_id",
    "order_date",
    "store_id",
    "product_id",
    "quantity",
    "unit_price",
]

DUPLICATE_KEY = ["order_id", "product_id"]
Giải thích code. INPUT_DIR là nơi nhận file gốc. OUTPUT_DIR chỉ chứa kết quả, nhờ đó chương trình không đọc nhầm file báo cáo của chính nó trong lần chạy sau. REQUIRED_COLUMNS đóng vai trò schema tối thiểu. DUPLICATE_KEY thể hiện giả định nghiệp vụ về một dòng bán hàng duy nhất.
Kết quả. Chương trình có một nơi quản lý cấu hình cơ bản. Khi thay đổi thư mục hoặc khóa nhận diện, người bảo trì không phải tìm và sửa nhiều đoạn code.
Bước 2: Tìm danh sách file đầu vào
Vấn đề. Thư mục có thể chứa nhiều loại file hoặc file tạm do Excel tạo ra. Chương trình chỉ nên nhận .csv và .xlsx, đồng thời phải báo lỗi rõ ràng nếu không có dữ liệu.
def discover_files(input_dir: Path) -> list[Path]:
    files = [
        path
        for path in input_dir.iterdir()
        if path.is_file()
        and path.suffix.lower() in {".csv", ".xlsx"}
        and not path.name.startswith("~$")
    ]

    if not files:
        raise FileNotFoundError(
            f"Không tìm thấy file CSV hoặc XLSX trong {input_dir.resolve()}"
        )

    return sorted(files)
Giải thích code. iterdir() duyệt các phần tử trực tiếp trong thư mục. Điều kiện is_file() loại thư mục con. Tên bắt đầu bằng ~$ thường là file tạm được Excel tạo ra khi workbook đang mở, vì vậy được bỏ qua. Hàm trả về danh sách đã sắp xếp để thứ tự đọc có tính ổn định.
Kết quả. Nếu thư mục có ba file dữ liệu hợp lệ, hàm trả về ba đối tượng Path. Nếu không có file, chương trình dừng với thông báo chứa đường dẫn đầy đủ thay vì tạo một báo cáo rỗng khó phát hiện.
Bước 3: Đọc từng file và kiểm tra schema
Vấn đề. Excel và CSV cần hàm đọc khác nhau. Ngoài ra, một file thiếu cột quan trọng không nên được âm thầm đưa vào báo cáo.
def normalize_column_name(column: object) -> str:
    return str(column).strip().lower().replace(" ", "_")


def read_sales_file(file_path: Path) -> pd.DataFrame:
    if file_path.suffix.lower() == ".csv":
        frame = pd.read_csv(
            file_path,
            encoding="utf-8",
            dtype={
                "order_id": "string",
                "store_id": "string",
                "product_id": "string",
            },
        )
    else:
        frame = pd.read_excel(
            file_path,
            dtype={
                "order_id": "string",
                "store_id": "string",
                "product_id": "string",
            },
        )

    frame.columns = [
        normalize_column_name(column)
        for column in frame.columns
    ]

    missing_columns = sorted(
        set(REQUIRED_COLUMNS) - set(frame.columns)
    )

    if missing_columns:
        raise ValueError(
            f"File {file_path.name} thiếu cột bắt buộc: "
            f"{missing_columns}"
        )

    frame = frame[REQUIRED_COLUMNS].copy()
    frame["source_file"] = file_path.name
    return frame
Giải thích code. Tên cột được bỏ khoảng trắng, chuyển về chữ thường và thay khoảng trắng bằng dấu gạch dưới. Nhờ đó, Order ID, order id và order_id cùng trở thành order_id. Sau khi chuẩn hóa, chương trình so sánh cột thực tế với schema bắt buộc.
Tham số dtype cố gắng bảo toàn các mã định danh dưới dạng chuỗi. Tuy nhiên, nếu file Excel đã lưu mã 00125 thành giá trị số 125, Pandas không thể khôi phục hai số 0 đã mất nếu không có quy tắc về độ dài mã. Đây là vấn đề phải xử lý tại nguồn hoặc bằng master data.
Cột source_file được thêm vào để truy vết. Khi một dòng sai, người vận hành có thể biết nó đến từ file nào. Đây là một chi tiết nhỏ nhưng rất hữu ích trong quá trình đối soát.
Kết quả. Mỗi file hợp lệ được chuyển thành một DataFrame có cùng schema. File thiếu cột bắt buộc bị từ chối với thông báo cụ thể.
Bước 4: Gộp dữ liệu
Vấn đề. Sau khi đọc riêng lẻ, các DataFrame cần được ghép theo chiều dọc thành một tập dữ liệu duy nhất.
def extract(files: list[Path]) -> pd.DataFrame:
    frames = [
        read_sales_file(file_path)
        for file_path in files
    ]
    return pd.concat(frames, ignore_index=True)
Giải thích code. List comprehension gọi hàm đọc cho từng file. pd.concat() ghép các DataFrame. ignore_index=True tạo lại chỉ số hàng liên tục, tránh việc nhiều file đều mang chỉ số bắt đầu từ 0.
Không nên nối DataFrame liên tục bên trong vòng lặp vì mỗi lần nối có thể tạo ra một đối tượng mới và làm giảm hiệu năng. Thu thập DataFrame vào list rồi gọi concat() một lần thường rõ ràng và hiệu quả hơn.
Kết quả. Nếu ba file có lần lượt 40.000, 35.000 và 50.430 dòng, DataFrame đầu vào có 125.430 dòng trước khi làm sạch.
Bước 5: Chuẩn hóa giá trị và kiểu dữ liệu
Vấn đề. Các cột mã có thể chứa khoảng trắng, ngày có thể sai định dạng và cột số có thể chứa chuỗi. Nếu tính toán ngay, chương trình có thể báo lỗi hoặc tạo kết quả không đáng tin cậy.
def transform(frame: pd.DataFrame) -> pd.DataFrame:
    cleaned = frame.copy()

    text_columns = [
        "order_id",
        "store_id",
        "product_id",
    ]

    for column in text_columns:
        cleaned[column] = (
            cleaned[column]
            .astype("string")
            .str.strip()
        )
        cleaned[column] = cleaned[column].replace(
            "",
            pd.NA,
        )

    cleaned["order_date"] = pd.to_datetime(
        cleaned["order_date"],
        errors="coerce",
        dayfirst=True,
    )

    cleaned["quantity"] = pd.to_numeric(
        cleaned["quantity"],
        errors="coerce",
    )

    cleaned["unit_price"] = pd.to_numeric(
        cleaned["unit_price"],
        errors="coerce",
    )

    cleaned["revenue"] = (
        cleaned["quantity"] * cleaned["unit_price"]
    )

    return cleaned
Giải thích code. astype("string") dùng kiểu string có hỗ trợ giá trị thiếu của Pandas. str.strip() xóa khoảng trắng ở hai đầu nhưng không tự ý thay đổi khoảng trắng hợp lệ bên trong mã. Chuỗi rỗng sau đó được đổi thành pd.NA để bước kiểm tra missing value hoạt động nhất quán.
pd.to_datetime() chuyển cột ngày thành kiểu datetime. errors="coerce" biến giá trị không chuyển được thành NaT, giá trị thiếu dành cho dữ liệu thời gian. Tương tự, pd.to_numeric() biến dữ liệu số không hợp lệ thành NaN. Cách này cho phép chương trình thu thập bản ghi lỗi thay vì dừng ngay ở lỗi đầu tiên.
dayfirst=True phù hợp với dữ liệu mẫu dùng quy ước ngày trước tháng. Trong hệ thống thật, tốt hơn hết là thống nhất một định dạng và truyền format cụ thể. Việc để thư viện tự suy luận nhiều định dạng khác nhau có thể tạo kết quả không nhất quán.
Kết quả. DataFrame có các cột mã được làm sạch, cột ngày và số ở đúng kiểu dữ liệu, cùng cột revenue được tính cho từng dòng.
Bước 6: Xác định và loại bản ghi trùng
Vấn đề. Cửa hàng có thể gửi lại một file hoặc cùng giao dịch xuất hiện trong hai lần trích xuất. Cần loại trùng nhưng vẫn ghi nhận số lượng đã loại.
def remove_duplicates(
    frame: pd.DataFrame,
) -> tuple[pd.DataFrame, int]:
    duplicate_mask = frame.duplicated(
        subset=DUPLICATE_KEY,
        keep="last",
    )

    duplicate_count = int(duplicate_mask.sum())

    deduplicated = frame.loc[
        ~duplicate_mask
    ].copy()

    return deduplicated, duplicate_count
Giải thích code. duplicated() đánh dấu những dòng trùng theo khóa đã xác định. keep="last" giữ bản xuất hiện sau cùng. Quy tắc này phù hợp khi file gửi sau được xem là phiên bản mới hơn, nhưng chỉ đáng tin nếu thứ tự file phản ánh đúng thứ tự cập nhật.
Với dữ liệu thật, nên có cột updated_at và sắp xếp theo thời điểm cập nhật trước khi loại trùng. Việc trả về cả DataFrame đã xử lý và số lượng duplicate giúp bước kiểm tra cuối cùng giải thích được chênh lệch giữa input và output.
Kết quả. Nếu có 318 dòng trùng, DataFrame giảm 318 dòng và biến duplicate_count nhận giá trị 318.
Bước 7: Kiểm tra quy tắc chất lượng dữ liệu
Vấn đề. Không phải mọi dòng còn lại đều hợp lệ. Chúng ta cần phân loại rõ nguyên nhân thay vì xóa dữ liệu lỗi mà không để lại dấu vết.
def validate(
    frame: pd.DataFrame,
) -> tuple[pd.DataFrame, pd.DataFrame]:
    checked = frame.copy()

    conditions = {
        "missing_order_id": (
            checked["order_id"].isna()
        ),
        "missing_store_id": (
            checked["store_id"].isna()
        ),
        "missing_product_id": (
            checked["product_id"].isna()
        ),
        "invalid_order_date": (
            checked["order_date"].isna()
        ),
        "invalid_quantity": (
            checked["quantity"].isna()
            | (checked["quantity"] <= 0)
            | (checked["quantity"] % 1 != 0)
        ),
        "invalid_unit_price": (
            checked["unit_price"].isna()
            | (checked["unit_price"] < 0)
        ),
    }

    checked["validation_errors"] = ""

    for error_name, mask in conditions.items():
        checked.loc[
            mask,
            "validation_errors",
        ] += error_name + ";"

    valid_mask = checked[
        "validation_errors"
    ].eq("")

    valid_rows = checked.loc[
        valid_mask
    ].copy()

    invalid_rows = checked.loc[
        ~valid_mask
    ].copy()

    valid_rows["quantity"] = valid_rows[
        "quantity"
    ].astype("int64")

    valid_rows = valid_rows.drop(
        columns="validation_errors"
    )

    return valid_rows, invalid_rows
Giải thích code. Mỗi quy tắc tạo một Boolean mask. Một dòng có thể vi phạm nhiều điều kiện, vì vậy chương trình nối các mã lỗi vào validation_errors. Ví dụ, một dòng không có mã đơn và có số lượng âm sẽ giữ cả hai nguyên nhân. Điều này tốt hơn việc chỉ ghi “invalid” vì người vận hành biết cần sửa gì.
Điều kiện số lượng kiểm tra ba trường hợp: thiếu, không lớn hơn 0 và không phải số nguyên. Đơn giá được phép bằng 0 vì doanh nghiệp có thể có hàng tặng; đây là một giả định nghiệp vụ cần được xác nhận trong dự án thật. Sau khi tách dữ liệu hợp lệ, số lượng được chuyển sang integer.
Kết quả. Hàm trả về hai DataFrame. valid_rows sẵn sàng dùng cho báo cáo. invalid_rows giữ nguyên dữ liệu lỗi, file nguồn và danh sách nguyên nhân để xử lý sau.
Bước 8: Tính báo cáo doanh thu theo cửa hàng
Vấn đề. Dữ liệu chi tiết cần được tổng hợp thành kết quả mà bộ phận vận hành có thể sử dụng.
def build_store_report(
    valid_rows: pd.DataFrame,
) -> pd.DataFrame:
    report = (
        valid_rows
        .groupby("store_id", as_index=False)
        .agg(
            order_count=("order_id", "nunique"),
            product_lines=("product_id", "size"),
            total_quantity=("quantity", "sum"),
            total_revenue=("revenue", "sum"),
        )
        .sort_values(
            "total_revenue",
            ascending=False,
        )
    )

    return report
Giải thích code. groupby() nhóm dữ liệu theo cửa hàng. Named aggregation giúp tên cột đầu ra phản ánh đúng ý nghĩa nghiệp vụ. order_count đếm số đơn duy nhất, trong khi product_lines đếm số dòng sản phẩm. Hai chỉ số này không giống nhau vì một đơn có thể chứa nhiều sản phẩm.
Kết quả. Báo cáo có một dòng cho mỗi cửa hàng và được sắp xếp theo doanh thu giảm dần.
Bước 9: Tạo bảng kiểm soát và xuất Excel
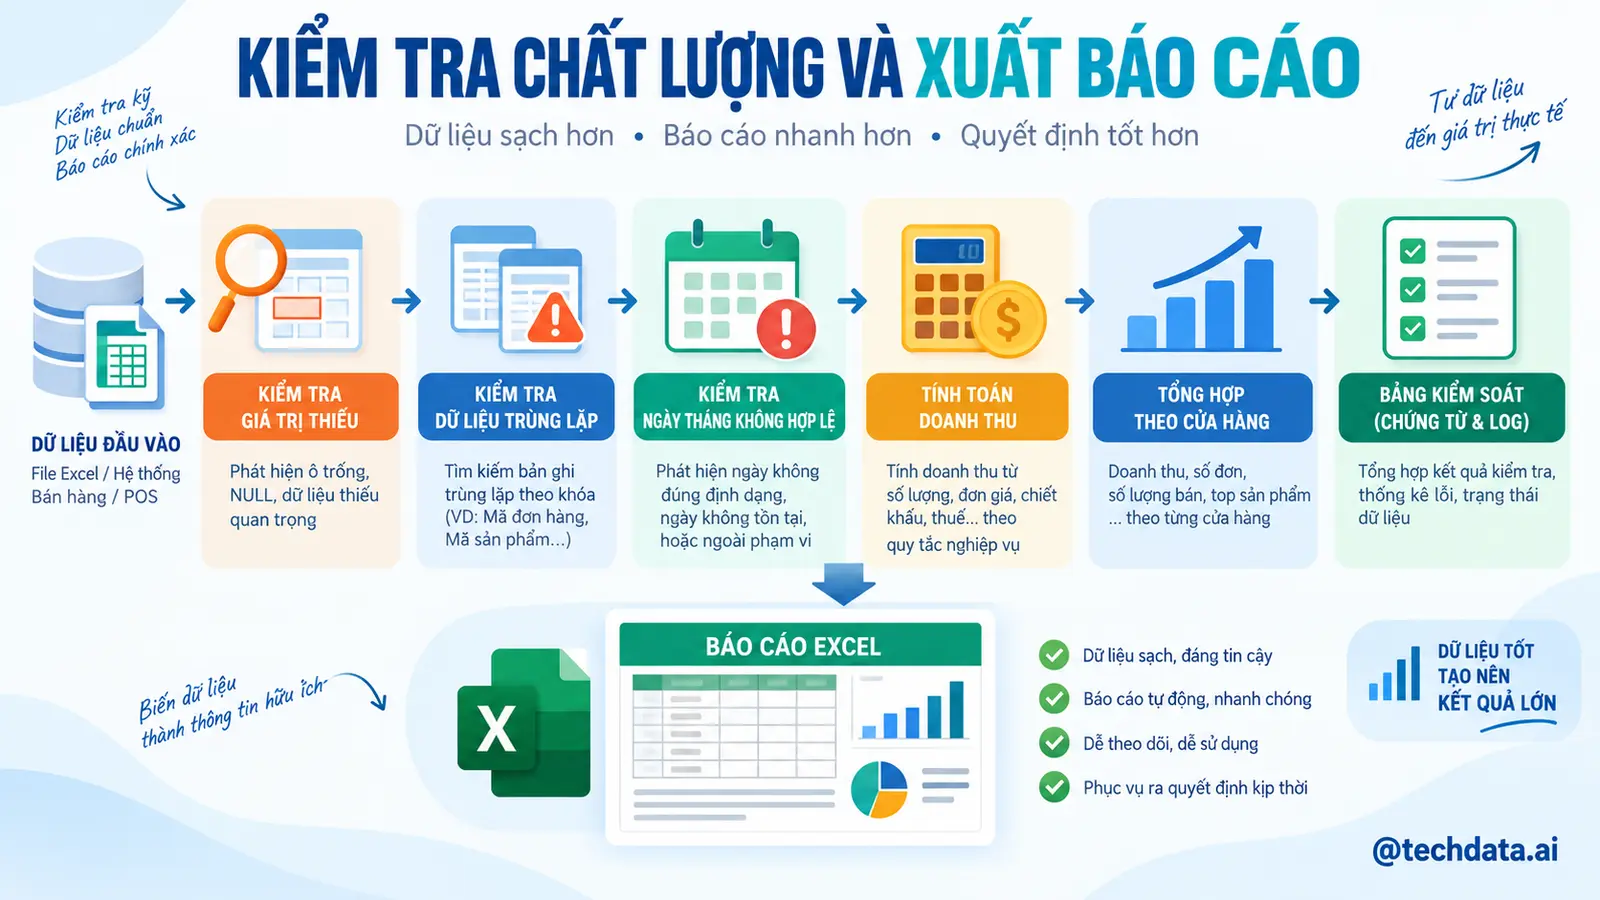
Vấn đề. Một báo cáo doanh thu không đủ để chứng minh dữ liệu đã được xử lý đúng. Cần thêm số liệu kiểm soát và dữ liệu lỗi.
def build_quality_report(
    file_count: int,
    input_count: int,
    duplicate_count: int,
    valid_count: int,
    invalid_count: int,
    total_revenue: float,
) -> pd.DataFrame:
    metrics = [
        ("files_processed", file_count),
        ("input_records", input_count),
        ("duplicates_removed", duplicate_count),
        ("invalid_records", invalid_count),
        ("valid_records", valid_count),
        ("total_revenue", total_revenue),
    ]

    return pd.DataFrame(
        metrics,
        columns=["metric", "value"],
    )


def export_report(
    valid_rows: pd.DataFrame,
    invalid_rows: pd.DataFrame,
    store_report: pd.DataFrame,
    quality_report: pd.DataFrame,
    output_file: Path,
) -> None:
    output_file.parent.mkdir(
        parents=True,
        exist_ok=True,
    )

    with pd.ExcelWriter(
        output_file,
        engine="openpyxl",
    ) as writer:
        valid_rows.to_excel(
            writer,
            sheet_name="clean_sales",
            index=False,
        )

        invalid_rows.to_excel(
            writer,
            sheet_name="invalid_rows",
            index=False,
        )

        store_report.to_excel(
            writer,
            sheet_name="store_report",
            index=False,
        )

        quality_report.to_excel(
            writer,
            sheet_name="data_quality",
            index=False,
        )
Giải thích code. Bảng chất lượng được tổ chức theo hai cột metric và value, thuận tiện cho cả người đọc lẫn việc nạp vào hệ thống khác. mkdir() tạo thư mục đầu ra nếu chưa tồn tại. Context manager bảo đảm workbook được đóng đúng cách ngay cả khi code được mở rộng sau này.
Kết quả. File Excel đầu ra có bốn sheet, phục vụ cả nhu cầu phân tích, kiểm tra lỗi và đối soát.
7. Ghép thành chương trình hoàn chỉnh
Đặt toàn bộ code sau vào main.py. Phiên bản này bổ sung kiểm tra thư mục đầu vào và thông báo kết quả sau khi chạy.
from pathlib import Path

import pandas as pd


INPUT_DIR = Path("data/raw")
OUTPUT_DIR = Path("output")
OUTPUT_FILE = OUTPUT_DIR / "sales_report.xlsx"

REQUIRED_COLUMNS = [
    "order_id",
    "order_date",
    "store_id",
    "product_id",
    "quantity",
    "unit_price",
]

DUPLICATE_KEY = [
    "order_id",
    "product_id",
]


def normalize_column_name(
    column: object,
) -> str:
    return (
        str(column)
        .strip()
        .lower()
        .replace(" ", "_")
    )


def discover_files(
    input_dir: Path,
) -> list[Path]:
    if not input_dir.exists():
        raise FileNotFoundError(
            "Thư mục đầu vào không tồn tại: "
            f"{input_dir.resolve()}"
        )

    files = [
        path
        for path in input_dir.iterdir()
        if path.is_file()
        and path.suffix.lower()
        in {".csv", ".xlsx"}
        and not path.name.startswith("~$")
    ]

    if not files:
        raise FileNotFoundError(
            "Không tìm thấy file CSV hoặc XLSX "
            f"trong {input_dir.resolve()}"
        )

    return sorted(files)


def read_sales_file(
    file_path: Path,
) -> pd.DataFrame:
    identifier_types = {
        "order_id": "string",
        "store_id": "string",
        "product_id": "string",
    }

    if file_path.suffix.lower() == ".csv":
        frame = pd.read_csv(
            file_path,
            encoding="utf-8",
            dtype=identifier_types,
        )
    else:
        frame = pd.read_excel(
            file_path,
            dtype=identifier_types,
        )

    frame.columns = [
        normalize_column_name(column)
        for column in frame.columns
    ]

    missing_columns = sorted(
        set(REQUIRED_COLUMNS)
        - set(frame.columns)
    )

    if missing_columns:
        raise ValueError(
            f"File {file_path.name} thiếu "
            f"cột bắt buộc: {missing_columns}"
        )

    frame = frame[
        REQUIRED_COLUMNS
    ].copy()

    frame["source_file"] = file_path.name

    return frame


def extract(
    files: list[Path],
) -> pd.DataFrame:
    frames = [
        read_sales_file(file_path)
        for file_path in files
    ]

    return pd.concat(
        frames,
        ignore_index=True,
    )


def transform(
    frame: pd.DataFrame,
) -> pd.DataFrame:
    cleaned = frame.copy()

    for column in [
        "order_id",
        "store_id",
        "product_id",
    ]:
        cleaned[column] = (
            cleaned[column]
            .astype("string")
            .str.strip()
        )

        cleaned[column] = (
            cleaned[column]
            .replace("", pd.NA)
        )

    cleaned["order_date"] = (
        pd.to_datetime(
            cleaned["order_date"],
            errors="coerce",
            dayfirst=True,
        )
    )

    cleaned["quantity"] = (
        pd.to_numeric(
            cleaned["quantity"],
            errors="coerce",
        )
    )

    cleaned["unit_price"] = (
        pd.to_numeric(
            cleaned["unit_price"],
            errors="coerce",
        )
    )

    cleaned["revenue"] = (
        cleaned["quantity"]
        * cleaned["unit_price"]
    )

    return cleaned


def remove_duplicates(
    frame: pd.DataFrame,
) -> tuple[pd.DataFrame, int]:
    duplicate_mask = frame.duplicated(
        subset=DUPLICATE_KEY,
        keep="last",
    )

    duplicate_count = int(
        duplicate_mask.sum()
    )

    deduplicated = frame.loc[
        ~duplicate_mask
    ].copy()

    return (
        deduplicated,
        duplicate_count,
    )


def validate(
    frame: pd.DataFrame,
) -> tuple[pd.DataFrame, pd.DataFrame]:
    checked = frame.copy()

    conditions = {
        "missing_order_id": (
            checked["order_id"].isna()
        ),
        "missing_store_id": (
            checked["store_id"].isna()
        ),
        "missing_product_id": (
            checked["product_id"].isna()
        ),
        "invalid_order_date": (
            checked["order_date"].isna()
        ),
        "invalid_quantity": (
            checked["quantity"].isna()
            | (checked["quantity"] <= 0)
            | (checked["quantity"] % 1 != 0)
        ),
        "invalid_unit_price": (
            checked["unit_price"].isna()
            | (checked["unit_price"] < 0)
        ),
    }

    checked["validation_errors"] = ""

    for error_name, mask in conditions.items():
        checked.loc[
            mask,
            "validation_errors",
        ] += error_name + ";"

    valid_mask = checked[
        "validation_errors"
    ].eq("")

    valid_rows = checked.loc[
        valid_mask
    ].copy()

    invalid_rows = checked.loc[
        ~valid_mask
    ].copy()

    valid_rows["quantity"] = (
        valid_rows["quantity"]
        .astype("int64")
    )

    valid_rows = valid_rows.drop(
        columns="validation_errors"
    )

    return valid_rows, invalid_rows


def build_store_report(
    valid_rows: pd.DataFrame,
) -> pd.DataFrame:
    return (
        valid_rows
        .groupby(
            "store_id",
            as_index=False,
        )
        .agg(
            order_count=(
                "order_id",
                "nunique",
            ),
            product_lines=(
                "product_id",
                "size",
            ),
            total_quantity=(
                "quantity",
                "sum",
            ),
            total_revenue=(
                "revenue",
                "sum",
            ),
        )
        .sort_values(
            "total_revenue",
            ascending=False,
        )
    )


def build_quality_report(
    file_count: int,
    input_count: int,
    duplicate_count: int,
    valid_count: int,
    invalid_count: int,
    total_revenue: float,
) -> pd.DataFrame:
    metrics = [
        (
            "files_processed",
            file_count,
        ),
        (
            "input_records",
            input_count,
        ),
        (
            "duplicates_removed",
            duplicate_count,
        ),
        (
            "invalid_records",
            invalid_count,
        ),
        (
            "valid_records",
            valid_count,
        ),
        (
            "total_revenue",
            total_revenue,
        ),
    ]

    return pd.DataFrame(
        metrics,
        columns=["metric", "value"],
    )


def export_report(
    valid_rows: pd.DataFrame,
    invalid_rows: pd.DataFrame,
    store_report: pd.DataFrame,
    quality_report: pd.DataFrame,
    output_file: Path,
) -> None:
    output_file.parent.mkdir(
        parents=True,
        exist_ok=True,
    )

    with pd.ExcelWriter(
        output_file,
        engine="openpyxl",
    ) as writer:
        valid_rows.to_excel(
            writer,
            sheet_name="clean_sales",
            index=False,
        )

        invalid_rows.to_excel(
            writer,
            sheet_name="invalid_rows",
            index=False,
        )

        store_report.to_excel(
            writer,
            sheet_name="store_report",
            index=False,
        )

        quality_report.to_excel(
            writer,
            sheet_name="data_quality",
            index=False,
        )


def main() -> None:
    files = discover_files(INPUT_DIR)

    raw_data = extract(files)
    input_count = len(raw_data)

    transformed_data = transform(
        raw_data
    )

    (
        deduplicated_data,
        duplicate_count,
    ) = remove_duplicates(
        transformed_data
    )

    (
        valid_rows,
        invalid_rows,
    ) = validate(
        deduplicated_data
    )

    store_report = build_store_report(
        valid_rows
    )

    total_revenue = float(
        valid_rows["revenue"].sum()
    )

    quality_report = (
        build_quality_report(
            file_count=len(files),
            input_count=input_count,
            duplicate_count=duplicate_count,
            valid_count=len(valid_rows),
            invalid_count=len(invalid_rows),
            total_revenue=total_revenue,
        )
    )

    export_report(
        valid_rows=valid_rows,
        invalid_rows=invalid_rows,
        store_report=store_report,
        quality_report=quality_report,
        output_file=OUTPUT_FILE,
    )

    print(
        quality_report.to_string(
            index=False
        )
    )

    print(
        "Báo cáo đã được lưu tại: "
        f"{OUTPUT_FILE.resolve()}"
    )


if __name__ == "__main__":
    main()
Chạy chương trình từ thư mục gốc của project:
python main.py
Điều kiện if __name__ == "__main__" giúp main() chỉ chạy khi file được thực thi trực tiếp. Khi cần viết unit test hoặc import function từ module khác, chương trình không tự động xử lý dữ liệu ngoài ý muốn.
8. Kiểm tra kết quả
Giả sử ba file đầu vào có tổng cộng 125.430 dòng. Chương trình phát hiện 318 bản ghi trùng và 300 bản ghi vi phạm ít nhất một quy tắc. Khi đó, output trên terminal có thể giống như sau:
              metric          value
     files_processed              3
       input_records         125430
  duplicates_removed            318
     invalid_records            300
       valid_records         124812
       total_revenue    4867250000

Báo cáo đã được lưu tại:
/project/python-sales-report/output/sales_report.xlsx
Phép đối soát số lượng phải thỏa mãn công thức: input bằng số duplicate đã loại cộng với số bản ghi invalid và số bản ghi valid. Với số liệu mẫu, 125.430 bằng 318 cộng 300 cộng 124.812. Nếu công thức không đúng, pipeline có thể đã làm mất hoặc nhân đôi dữ liệu ở một bước nào đó.
Mở sheet data_quality trước để kiểm tra tổng quan. Sau đó kiểm tra invalid_rows, lọc theo validation_errors và source_file để xác định cửa hàng nào cần sửa dữ liệu. Sheet store_report cho biết doanh thu tổng hợp, còn clean_sales là dữ liệu chi tiết đã đủ điều kiện sử dụng.
Không nên chỉ tin vào tổng doanh thu. Hãy chọn ngẫu nhiên một vài đơn hàng, đối chiếu số lượng, đơn giá và doanh thu với file gốc. Ngoài ra, có thể tính tổng doanh thu trực tiếp từ clean_sales và so sánh với tổng trong store_report. Hai giá trị phải bằng nhau, ngoại trừ khác biệt rất nhỏ nếu dữ liệu sử dụng số thực và phát sinh vấn đề làm tròn.
Trong dữ liệu tài chính, không nên dùng float cho các phép tính cần độ chính xác tuyệt đối. Project minh họa dùng float vì dữ liệu mẫu là tiền đồng không có phần thập phân. Một hệ thống production có thể lưu tiền dưới dạng số nguyên theo đơn vị nhỏ nhất hoặc sử dụng kiểu decimal trong cơ sở dữ liệu.
9. Những lỗi thường gặp
FileNotFoundError
Lỗi xảy ra khi chương trình được chạy từ sai working directory hoặc thư mục data/raw chưa tồn tại. Hãy chạy python main.py từ thư mục gốc của project và kiểm tra đường dẫn được in trong thông báo lỗi. Trong production, nên dùng đường dẫn tuyệt đối lấy từ cấu hình thay vì phụ thuộc vào nơi người dùng mở terminal.
UnicodeDecodeError khi đọc CSV
Không phải file CSV nào cũng dùng UTF-8. File xuất từ một số phần mềm cũ có thể dùng cp1258, latin1 hoặc encoding khác. Không nên mặc định thêm errors="ignore" vì cách đó có thể âm thầm làm mất ký tự. Hãy xác nhận encoding từ hệ thống nguồn, sau đó truyền đúng giá trị vào read_csv().
frame = pd.read_csv(
    file_path,
    encoding="utf-8-sig",
)
utf-8-sig thường hữu ích với CSV được xuất từ Excel và có BOM.
ParserError hoặc dữ liệu dồn vào một cột
CSV không phải lúc nào cũng dùng dấu phẩy. Một số file dùng dấu chấm phẩy hoặc tab. Nếu toàn bộ dòng xuất hiện trong một cột, hãy kiểm tra delimiter và truyền sep phù hợp.
frame = pd.read_csv(
    file_path,
    sep=";",
    encoding="utf-8-sig",
)
ImportError liên quan đến openpyxl
Pandas cần engine phù hợp để đọc và ghi .xlsx. Hãy bảo đảm virtual environment đã được kích hoạt và cài openpyxl bằng đúng Python đang chạy project.
python -m pip install openpyxl
Ngày bị hiểu sai
03/04/2026 là một giá trị mơ hồ. dayfirst=True chỉ là quy tắc suy luận, không phải bảo đảm tuyệt đối cho dữ liệu hỗn hợp. Nếu nguồn có format cố định, hãy khai báo cụ thể:
cleaned["order_date"] = pd.to_datetime(
    cleaned["order_date"],
    format="%d/%m/%Y",
    errors="coerce",
)
Mất số 0 ở đầu mã
Nếu mã được lưu dưới dạng số trong Excel, phần định dạng hiển thị có thể làm người dùng thấy 00125 nhưng giá trị thật vẫn là 125. Hãy yêu cầu cột mã được lưu dưới dạng text tại nguồn. Nếu mọi mã đều có độ dài cố định, có thể áp dụng str.zfill(), nhưng chỉ nên làm khi quy tắc nghiệp vụ đã được xác nhận.
MemoryError với file lớn
read_csv() có thể đọc theo từng phần bằng chunksize. Tuy nhiên, chia chunk không tự động giải quyết mọi vấn đề vì việc gộp toàn bộ chunk trở lại vẫn tiêu thụ bộ nhớ. Với dữ liệu lớn, nên chọn cột cần thiết bằng usecols, khai báo dtype, xử lý từng chunk và ghi kết quả trung gian vào database hoặc định dạng cột như Parquet.
for chunk in pd.read_csv(
    "large_sales.csv",
    chunksize=100_000,
):
    process_chunk(chunk)
PermissionError khi ghi báo cáo
Trên Windows, lỗi thường xuất hiện khi sales_report.xlsx đang mở trong Excel. Hãy đóng file rồi chạy lại. Trong quy trình tự động, nên xuất file với tên chứa thời gian chạy hoặc ghi vào file tạm, sau đó đổi tên khi quá trình hoàn tất.
10. Nâng cấp từ demo thành ứng dụng thực tế
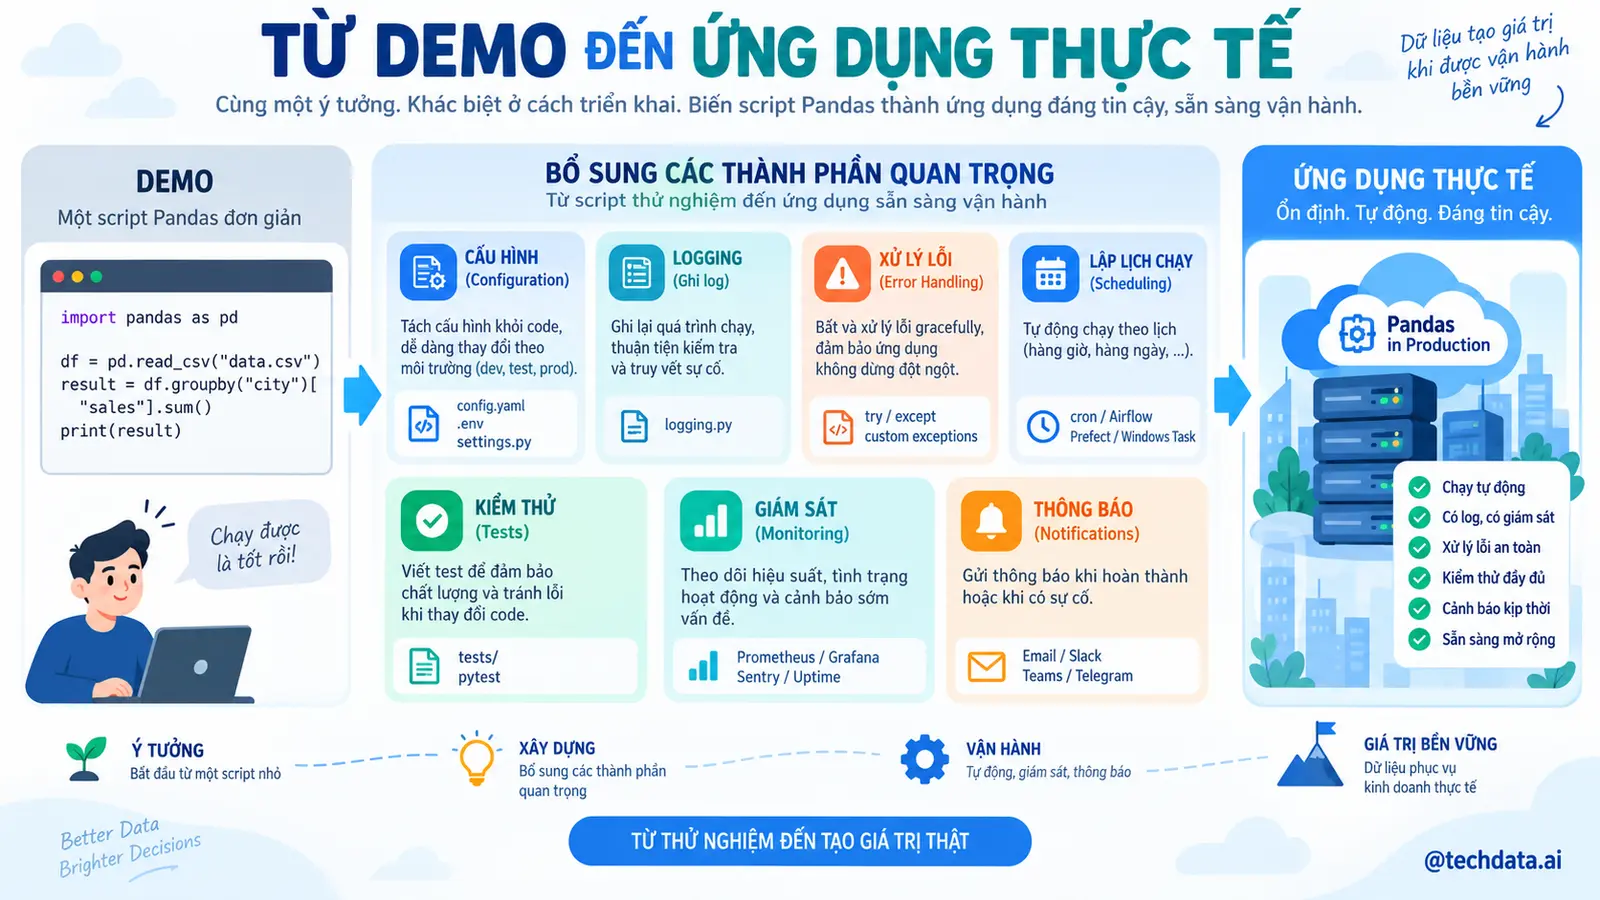
Project hiện phù hợp cho một nhóm nhỏ xử lý file trong thư mục dùng chung. Khi đưa vào doanh nghiệp, điều đầu tiên cần thay đổi không nhất thiết là công nghệ mà là quy ước dữ liệu. Các cửa hàng cần dùng cùng schema, cùng định dạng ngày, cùng quy tắc mã định danh và cùng thời điểm chốt dữ liệu. Nếu hợp đồng dữ liệu không rõ, Python chỉ chuyển công việc sửa lỗi thủ công thành một tập hợp ngoại lệ khó quản lý.
Cấu hình nên được tách khỏi source code. Đường dẫn, tên sheet, schema, định dạng ngày và quy tắc duplicate có thể nằm trong file YAML, biến môi trường hoặc bảng cấu hình. Mật khẩu database và khóa truy cập tuyệt đối không được ghi trực tiếp vào code hoặc commit lên Git.
Logging cần thay cho print(). Mỗi lần chạy nên có run ID, thời điểm bắt đầu, thời điểm kết thúc, danh sách file đã nhận, checksum của file, số lượng bản ghi và trạng thái. Checksum giúp phát hiện một file đã được xử lý trước đó ngay cả khi người dùng đổi tên file. Pipeline cũng cần chính sách rõ ràng cho file lỗi: dừng toàn bộ lô, bỏ qua file hoặc chuyển file vào vùng quarantine để xử lý riêng.
Khi dữ liệu tăng, Excel không nên tiếp tục là nơi lưu trữ trung tâm. Python có thể đọc file từ vùng tiếp nhận, kiểm tra và nạp dữ liệu hợp lệ vào PostgreSQL, MySQL hoặc Data Warehouse. Power BI sau đó đọc dữ liệu từ hệ thống quản trị thay vì phụ thuộc vào một workbook được ghi đè mỗi ngày. Excel vẫn có thể được xuất ra như một sản phẩm phục vụ người dùng, nhưng lịch sử và trạng thái xử lý cần được quản lý trong hệ thống có khả năng truy vấn và kiểm soát truy cập.
Quy trình production cũng cần tính idempotent, nghĩa là chạy lại cùng một đầu vào không tạo thêm dữ liệu trùng hoặc làm thay đổi kết quả ngoài dự kiến. Điều này thường được thực hiện bằng business key, file checksum, bảng audit và cơ chế upsert. Nếu chỉ dùng keep="last" theo thứ tự tên file như demo, kết quả có thể thay đổi khi tên hoặc thứ tự file thay đổi.
Chất lượng dữ liệu nên được quản lý bằng ngưỡng. Ví dụ, pipeline có thể tiếp tục khi tỷ lệ lỗi dưới 0,5% nhưng gửi cảnh báo. Nếu tỷ lệ lỗi vượt 5%, lô dữ liệu bị chặn để tránh báo cáo sai. Ngưỡng cần được thống nhất với chủ sở hữu dữ liệu chứ không nên do lập trình viên tự quyết định.
Cuối cùng, project cần kiểm thử. Unit test có thể xác nhận hàm chuẩn hóa cột, xử lý ngày, phát hiện số lượng âm và loại duplicate. Integration test chạy toàn bộ pipeline trên một bộ file nhỏ đã biết trước kết quả. Với báo cáo quan trọng, nên có reconciliation giữa tổng doanh thu từ nguồn và tổng doanh thu sau xử lý, đồng thời lưu lại bằng chứng đối soát cho từng lần chạy.
11. Bài tập thực hành
Level 1: Thay đổi dữ liệu và chạy lại project
Tạo thêm một file CSV cho cửa hàng mới với ít nhất 100 dòng. Cố ý thêm năm dòng trùng, ba dòng thiếu mã sản phẩm và hai dòng có ngày sai định dạng. Chạy chương trình và xác nhận bảng data_quality phản ánh đúng số dòng đã thêm. Kiểm tra invalid_rows phải chứa đúng nguồn file và nguyên nhân lỗi.
Level 2: Bổ sung giảm giá và doanh thu thuần
Thêm cột discount_amount vào schema. Giá trị giảm giá phải không âm và không lớn hơn thành tiền trước giảm giá. Tính gross_revenue từ số lượng và đơn giá, sau đó tính net_revenue sau giảm giá. Những dòng vi phạm quy tắc phải được đưa vào sheet dữ liệu lỗi với mã lỗi dễ hiểu. Báo cáo cửa hàng cần hiển thị cả doanh thu trước giảm giá, tổng giảm giá và doanh thu thuần.
Level 3: Tự động gửi báo cáo và cảnh báo chất lượng
Bổ sung file cấu hình chứa ngưỡng tỷ lệ dữ liệu lỗi. Nếu tỷ lệ lỗi vượt ngưỡng, chương trình không gửi báo cáo doanh thu mà gửi thông báo yêu cầu kiểm tra dữ liệu. Nếu tỷ lệ nằm trong giới hạn, chương trình gửi file báo cáo qua email hoặc một kênh thông báo nội bộ. Không ghi mật khẩu trực tiếp trong code; sử dụng biến môi trường và bảo đảm log không làm lộ thông tin xác thực.
12. Project mở rộng
Một project portfolio phù hợp là hệ thống tổng hợp doanh số đa chi nhánh. Bối cảnh là doanh nghiệp có 50 cửa hàng gửi file mỗi ngày. File có thể là CSV hoặc Excel, tên cột có một số biến thể được định nghĩa trước và dữ liệu cần được lưu theo lịch sử.
Project cần có vùng tiếp nhận file, module đọc và chuẩn hóa schema, module kiểm tra chất lượng, module loại trùng theo business key và thời gian cập nhật, database lưu dữ liệu hợp lệ, bảng lưu dữ liệu lỗi, bảng audit cho từng lần chạy và dashboard hiển thị doanh thu theo ngày, cửa hàng và sản phẩm. Người dùng phải tra được một dòng báo cáo đến file nguồn và lần chạy đã tạo ra nó.
Tiêu chí hoàn thành gồm khả năng chạy lại an toàn, không nhân đôi dữ liệu; có ít nhất mười unit test; có file cấu hình; có logging; có tài liệu hướng dẫn chạy; có dữ liệu mẫu; có ảnh chụp dashboard; và có một phần giải thích các quyết định thiết kế. Nếu muốn nâng cấp thêm, có thể đóng gói bằng Docker và lập lịch chạy hằng ngày bằng Airflow hoặc một dịch vụ orchestration phù hợp.
Đây là project tốt cho portfolio vì nó thể hiện nhiều năng lực thực tế: hiểu dữ liệu nghiệp vụ, Python, Pandas, data quality, database, logging, kiểm thử và tư duy vận hành. Nhà tuyển dụng có thể đánh giá sản phẩm chạy được thay vì chỉ xem một notebook phân tích ngắn.
13. Tổng kết
Bạn vừa dùng Python và Pandas để giải quyết một bài toán phổ biến trong doanh nghiệp: nhận nhiều file Excel và CSV, chuẩn hóa cấu trúc, làm sạch dữ liệu, loại bản ghi trùng, tách dữ liệu lỗi, tính doanh thu và xuất báo cáo có thể đối soát.
Đầu vào của project là các file bán hàng từ nhiều cửa hàng. Đầu ra là workbook sales_report.xlsx gồm dữ liệu sạch, dữ liệu lỗi, báo cáo doanh thu và chỉ số chất lượng. Quan trọng hơn, bạn đã thực hành cách tổ chức một quy trình dữ liệu có function rõ ràng, schema bắt buộc, business rule, traceability và kiểm tra chênh lệch số lượng bản ghi.
Trong bài tiếp theo, những kỹ thuật này có thể được mở rộng thành một quy trình làm sạch dữ liệu tổng quát hơn, xử lý sâu các vấn đề về missing value, datatype, outlier, dữ liệu text và quy tắc nghiệp vụ.
14. Tài liệu tham khảo
- Python Software Foundation,
venvvà cách tạo virtual environment: https://docs.python.org/3/library/venv.html - Pandas documentation,
pandas.read_csv: https://pandas.pydata.org/docs/reference/api/pandas.read_csv.html - Pandas documentation,
pandas.read_excel: https://pandas.pydata.org/docs/reference/api/pandas.read_excel.html - Pandas documentation,
pandas.concat: https://pandas.pydata.org/docs/reference/api/pandas.concat.html - Pandas documentation,
DataFrame.duplicated: https://pandas.pydata.org/docs/reference/api/pandas.DataFrame.duplicated.html - Pandas documentation, Working with missing data: https://pandas.pydata.org/docs/user_guide/missing_data.html
- Pandas documentation,
DataFrame.to_excel: https://pandas.pydata.org/docs/reference/api/pandas.DataFrame.to_excel.html - OpenPyXL documentation: https://openpyxl.readthedocs.io/en/stable/