



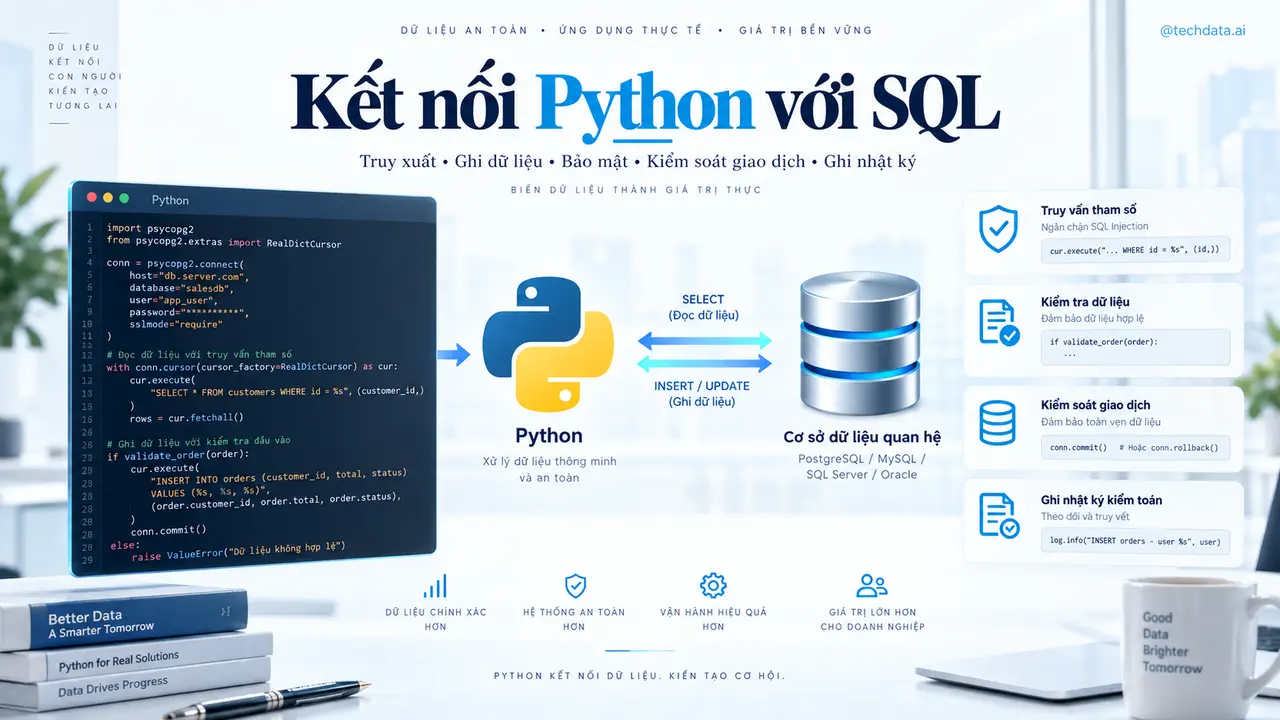

Dữ liệu quan trọng của doanh nghiệp thường không nằm trong một file riêng lẻ mà được lưu trong hệ quản trị cơ sở dữ liệu. Python giúp người làm Data truy vấn, kiểm tra, biến đổi và ghi kết quả trở lại SQL theo một quy trình có thể tự động hóa. Bài viết xây dựng một project hoàn chỉnh lấy dữ liệu đơn hàng từ PostgreSQL, kiểm tra chất lượng, tính doanh thu theo ngày và ghi kết quả vào bảng báo cáo.
Mục lục
- Bài toán thực tế
- Sau bài này bạn sẽ làm được gì?
- Kiến thức Python cần dùng
- Chuẩn bị môi trường
- Hiểu dữ liệu đầu vào
- Xây dựng ứng dụng từng bước
- Ghép thành chương trình hoàn chỉnh
- Kiểm tra kết quả
- Những lỗi thường gặp
- Nâng cấp thành ứng dụng thực tế
- Bài tập thực hành
- Project mở rộng
- Tổng kết
- Tài liệu tham khảo
1. Bài toán thực tế
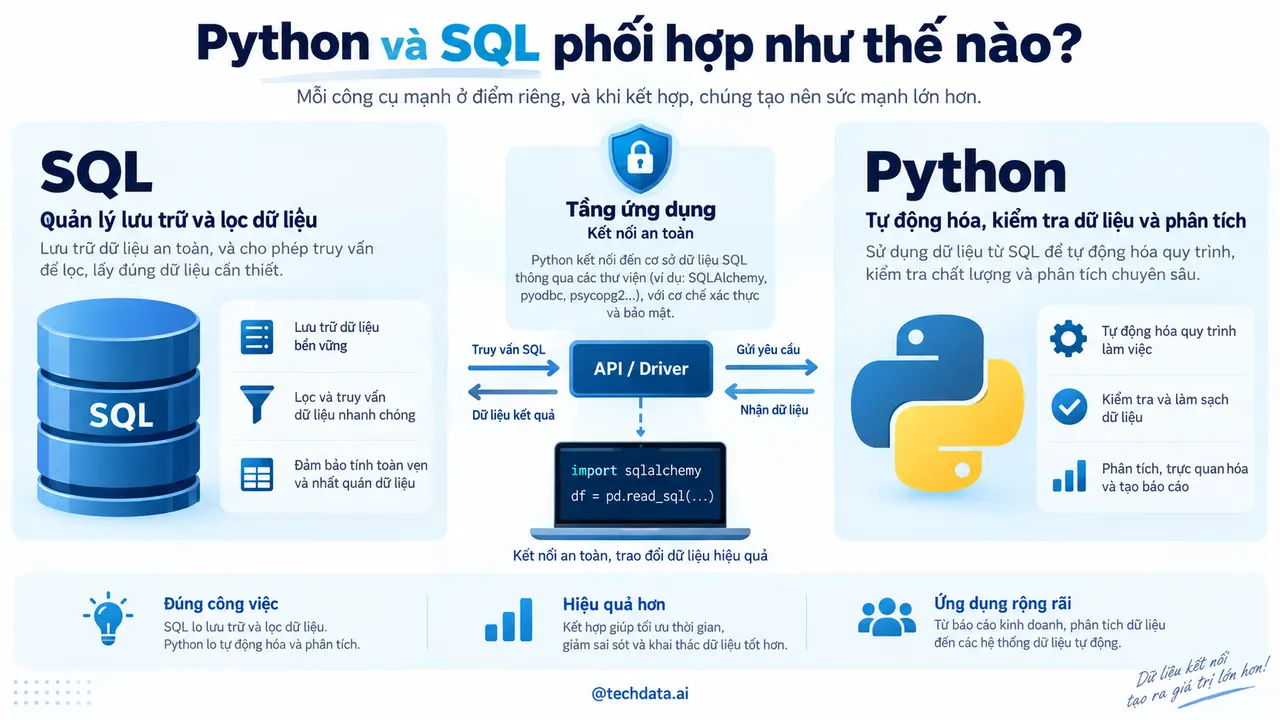
Một công ty thương mại điện tử lưu đơn hàng trong PostgreSQL. Mỗi sáng, bộ phận vận hành cần báo cáo doanh thu ngày hôm trước theo cửa hàng và trạng thái đơn. Cách làm thủ công là xuất CSV, mở Excel, lọc đơn bị hủy và tạo PivotTable. Quy trình này mất thời gian, phụ thuộc vào người thực hiện và khó phát hiện khi dữ liệu nguồn thay đổi.
Project trong bài sử dụng Python và SQLAlchemy để mở kết nối, chạy câu SQL có tham số, đọc kết quả vào Pandas, xác thực dữ liệu, tổng hợp KPI và ghi bảng báo cáo trở lại database trong một transaction. Thông tin kết nối được lấy từ biến môi trường, không đặt mật khẩu trong source code.
2. Sau bài này bạn sẽ làm được gì?
Sản phẩm cuối bài là chương trình main.py nhận ngày báo cáo, đọc bảng orders, loại dữ liệu không hợp lệ, tính số đơn, số lượng sản phẩm, doanh thu gộp và doanh thu thuần theo cửa hàng. Kết quả được ghi vào bảng daily_store_revenue. Chương trình đồng thời in báo cáo kiểm soát gồm số dòng đầu vào, số dòng lỗi và tổng doanh thu.
3. Kiến thức Python cần dùng
Project dùng SQLAlchemy để quản lý engine và connection pool, driver psycopg để giao tiếp với PostgreSQL, Pandas để đọc và tổng hợp dữ liệu, os.getenv() để lấy cấu hình và transaction để bảo đảm thao tác ghi hoàn tất trọn vẹn. Câu SQL sử dụng bind parameter thay vì ghép chuỗi nhằm giảm rủi ro SQL injection và lỗi định dạng.
4. Chuẩn bị môi trường
python -m venv .venv
source .venv/bin/activate
python -m pip install pandas sqlalchemy "psycopg[binary]" python-dotenv
python-sql-report/
.env
main.py
requirements.txt
sql/
create_report_table.sqlFile .env chỉ dùng trong môi trường phát triển và phải được thêm vào .gitignore. Production nên dùng secret manager của nền tảng triển khai.
DATABASE_URL=postgresql+psycopg://report_user:password@localhost:5432/sales5. Hiểu dữ liệu đầu vào
| Cột | Ý nghĩa | Quy tắc |
|---|---|---|
| order_id | Mã đơn hàng | Không trống và duy nhất |
| order_date | Thời điểm tạo đơn | Phải là timestamp hợp lệ |
| store_id | Mã cửa hàng | Không trống |
| status | Trạng thái đơn | Thuộc miền giá trị đã thống nhất |
| quantity | Số lượng | Số nguyên dương |
| unit_price | Đơn giá | Không âm |
| discount_amount | Giảm giá | Không âm và không vượt thành tiền |
Khóa và grain phải được xác định trước khi viết query. Ví dụ này giả định mỗi dòng đại diện cho một sản phẩm trong đơn hàng và khóa dòng là tổ hợp order_id, product_id. Nếu bảng nguồn có grain khác, phép đếm đơn và phép cộng doanh thu cũng phải thay đổi tương ứng.
6. Xây dựng ứng dụng từng bước
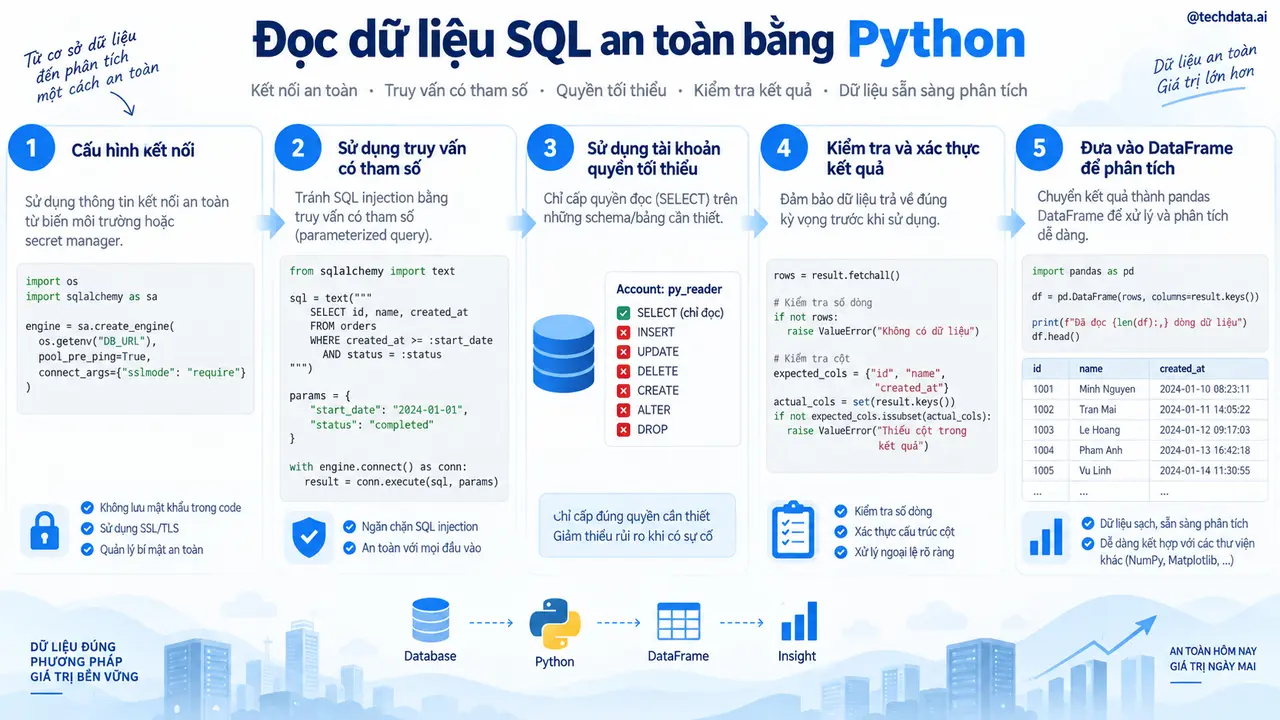
Bước 1: Tạo kết nối từ biến môi trường
import os
from sqlalchemy import create_engine


def create_database_engine():
    database_url = os.getenv("DATABASE_URL")

    if not database_url:
        raise RuntimeError(
            "Chưa cấu hình DATABASE_URL"
        )

    return create_engine(
        database_url,
        pool_pre_ping=True,
        pool_size=5,
        max_overflow=10,
    )
pool_pre_ping=True kiểm tra connection trước khi sử dụng lại. Pool không nên được đặt quá lớn theo cảm tính vì mỗi connection tiêu thụ tài nguyên của database. Kích thước phù hợp phụ thuộc giới hạn server và số worker chạy đồng thời.
Bước 2: Đọc dữ liệu bằng query có tham số
import pandas as pd
from sqlalchemy import text


ORDER_QUERY = text("""
    SELECT
        order_id,
        product_id,
        order_date,
        store_id,
        status,
        quantity,
        unit_price,
        COALESCE(discount_amount, 0)
            AS discount_amount
    FROM orders
    WHERE order_date >= :start_time
      AND order_date < :end_time
""")


def extract_orders(
    engine,
    start_time,
    end_time,
) -> pd.DataFrame:
    with engine.connect() as connection:
        return pd.read_sql_query(
            ORDER_QUERY,
            connection,
            params={
                "start_time": start_time,
                "end_time": end_time,
            },
        )
Khoảng thời gian dùng điều kiện đóng ở đầu và mở ở cuối để tránh đếm trùng các bản ghi đúng thời điểm giao ngày. Bind parameter tách dữ liệu khỏi cấu trúc SQL. Không dùng f-string để chèn trực tiếp ngày hoặc dữ liệu do người dùng cung cấp vào query.
Bước 3: Kiểm tra và biến đổi dữ liệu
def transform_orders(
    frame: pd.DataFrame,
) -> tuple[pd.DataFrame, pd.DataFrame]:
    checked = frame.copy()

    checked["quantity"] = pd.to_numeric(
        checked["quantity"],
        errors="coerce",
    )
    checked["unit_price"] = pd.to_numeric(
        checked["unit_price"],
        errors="coerce",
    )
    checked["discount_amount"] = pd.to_numeric(
        checked["discount_amount"],
        errors="coerce",
    )

    checked["gross_revenue"] = (
        checked["quantity"]
        * checked["unit_price"]
    )
    checked["net_revenue"] = (
        checked["gross_revenue"]
        - checked["discount_amount"]
    )

    invalid = (
        checked["order_id"].isna()
        | checked["store_id"].isna()
        | checked["quantity"].isna()
        | (checked["quantity"] <= 0)
        | checked["unit_price"].isna()
        | (checked["unit_price"] < 0)
        | checked["discount_amount"].isna()
        | (checked["discount_amount"] < 0)
        | (checked["net_revenue"] < 0)
    )

    return (
        checked.loc[~invalid].copy(),
        checked.loc[invalid].copy(),
    )
Dữ liệu lỗi được tách riêng thay vì âm thầm loại bỏ. Trong production, cần bổ sung cột nguyên nhân lỗi và lưu vùng quarantine để nhóm nguồn sửa dữ liệu. Trạng thái đơn cũng phải được ánh xạ rõ ràng để xác định đơn nào được tính doanh thu.
Bước 4: Tính KPI đúng grain
def build_daily_report(
    valid_orders: pd.DataFrame,
    report_date,
) -> pd.DataFrame:
    completed = valid_orders.loc[
        valid_orders["status"].eq("completed")
    ].copy()

    report = (
        completed
        .groupby("store_id", as_index=False)
        .agg(
            order_count=("order_id", "nunique"),
            product_lines=("product_id", "size"),
            total_quantity=("quantity", "sum"),
            gross_revenue=("gross_revenue", "sum"),
            discount_amount=(
                "discount_amount",
                "sum",
            ),
            net_revenue=("net_revenue", "sum"),
        )
    )

    report["report_date"] = report_date
    return report
order_count dùng nunique vì một đơn có nhiều dòng sản phẩm. Nếu dùng size, báo cáo sẽ đếm số dòng chứ không phải số đơn. Đây là lỗi phổ biến khi grain của bảng không được làm rõ.
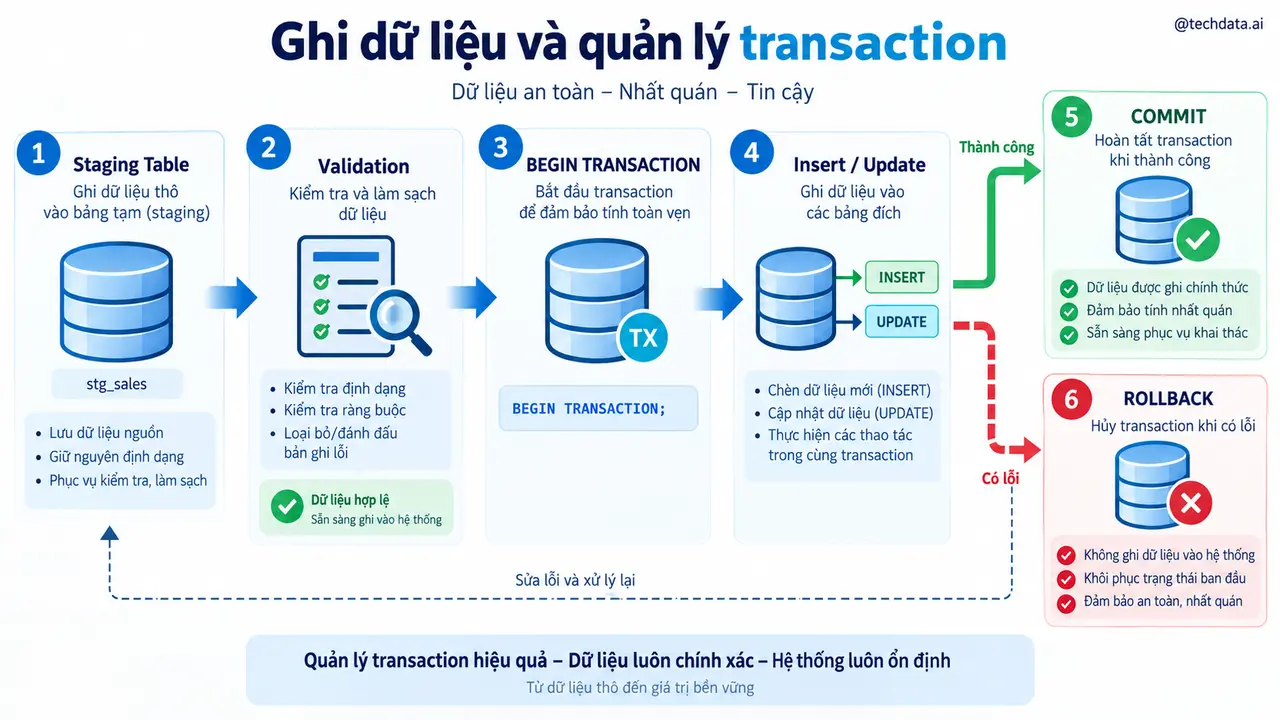
Bước 5: Ghi kết quả trong transaction
DELETE_REPORT = text("""
    DELETE FROM daily_store_revenue
    WHERE report_date = :report_date
""")


def load_report(
    engine,
    report: pd.DataFrame,
    report_date,
) -> None:
    with engine.begin() as connection:
        connection.execute(
            DELETE_REPORT,
            {"report_date": report_date},
        )

        report.to_sql(
            "daily_store_revenue",
            connection,
            if_exists="append",
            index=False,
            method="multi",
        )
Transaction bảo đảm bước xóa dữ liệu cũ và ghi dữ liệu mới cùng thành công hoặc cùng được rollback. Cách delete rồi insert giúp ví dụ dễ hiểu và có tính chạy lại, nhưng production có thể dùng upsert cùng unique constraint để giảm phạm vi khóa.
7. Ghép thành chương trình hoàn chỉnh
from datetime import date, datetime, time, timedelta
import os

import pandas as pd
from sqlalchemy import create_engine, text


ORDER_QUERY = text("""
    SELECT
        order_id,
        product_id,
        order_date,
        store_id,
        status,
        quantity,
        unit_price,
        COALESCE(discount_amount, 0)
            AS discount_amount
    FROM orders
    WHERE order_date >= :start_time
      AND order_date < :end_time
""")


def create_database_engine():
    database_url = os.getenv("DATABASE_URL")
    if not database_url:
        raise RuntimeError(
            "Chưa cấu hình DATABASE_URL"
        )
    return create_engine(
        database_url,
        pool_pre_ping=True,
    )


def main() -> None:
    report_date = date.today() - timedelta(days=1)
    start_time = datetime.combine(
        report_date,
        time.min,
    )
    end_time = start_time + timedelta(days=1)

    engine = create_database_engine()
    raw_orders = extract_orders(
        engine,
        start_time,
        end_time,
    )

    valid_orders, invalid_orders = (
        transform_orders(raw_orders)
    )

    report = build_daily_report(
        valid_orders,
        report_date,
    )

    load_report(
        engine,
        report,
        report_date,
    )

    print(f"Input records: {len(raw_orders)}")
    print(f"Valid records: {len(valid_orders)}")
    print(f"Invalid records: {len(invalid_orders)}")
    print(
        "Net revenue: "
        f"{report['net_revenue'].sum():,.0f}"
    )


if __name__ == "__main__":
    main()
Các function extract_orders, transform_orders, build_daily_report và load_report sử dụng đúng phiên bản đã trình bày ở các bước trước. Tách function giúp viết unit test mà không phải chạy toàn bộ pipeline.
8. Kiểm tra kết quả
Input records: 128450
Valid records: 128312
Invalid records: 138
Store rows written: 42
Net revenue: 8,426,315,000
Kiểm tra đầu tiên là số dòng input bằng valid cộng invalid. Tiếp theo, đối chiếu tổng doanh thu của báo cáo với một câu SQL độc lập trên nguồn. Kiểm tra unique constraint của tổ hợp report_date và store_id, sau đó chạy lại cùng ngày để xác nhận kết quả không bị nhân đôi.
9. Những lỗi thường gặp
OperationalError. Kiểm tra host, port, database, firewall và quyền của tài khoản. Không in toàn bộ connection string vào log vì có thể làm lộ mật khẩu.
Connection pool exhausted. Luôn đóng connection bằng context manager. Không tạo engine mới cho từng dòng hoặc từng request.
SQL injection. Không ghép dữ liệu người dùng vào câu SQL bằng f-string. Dùng bind parameter và whitelist riêng cho tên bảng hoặc tên cột động.
Kiểu Decimal và float. Dữ liệu tiền từ database có thể là Decimal. Hạn chế chuyển sang float nếu yêu cầu độ chính xác tài chính; nên lưu theo decimal hoặc số nguyên ở đơn vị nhỏ nhất.
Ghi đè bảng bằng replace. if_exists="replace" có thể làm mất index, constraint và quyền. Production nên quản lý schema bằng migration, sau đó append hoặc upsert dữ liệu.
10. Nâng cấp thành ứng dụng thực tế
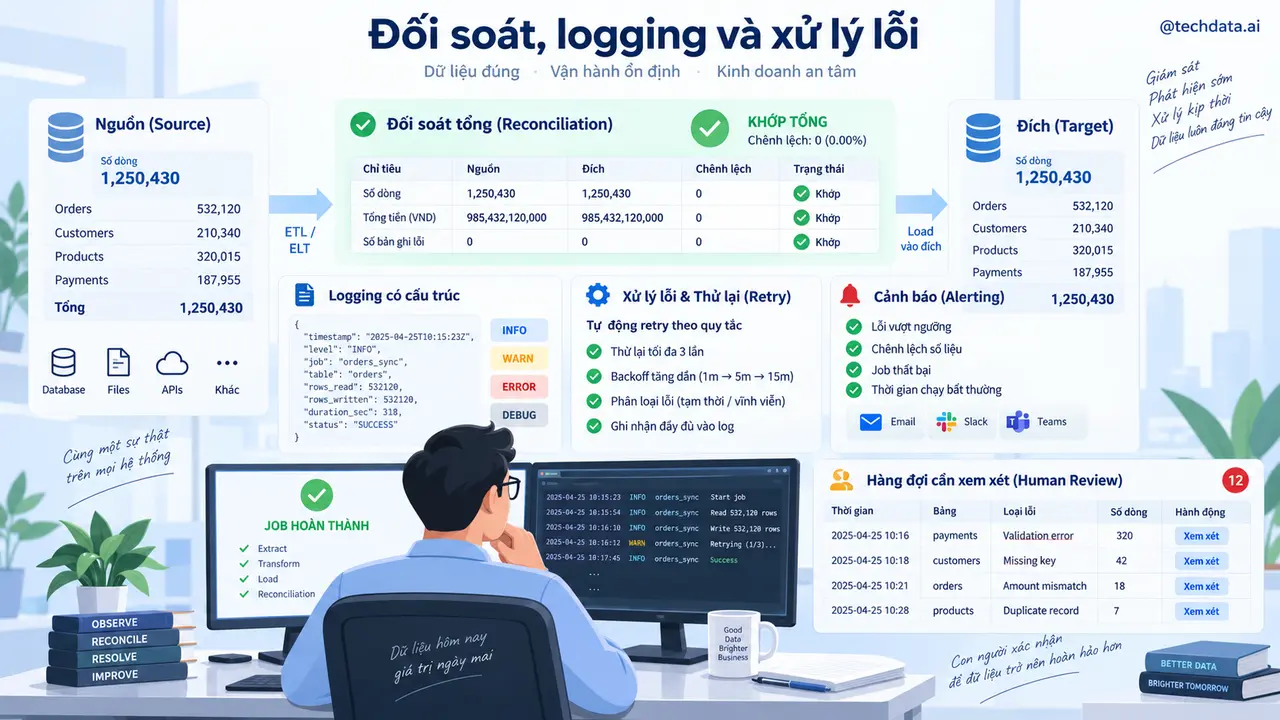
Tài khoản pipeline chỉ nên có quyền đọc bảng nguồn cần thiết và quyền ghi đúng bảng đích. Secret được quản lý bên ngoài code. Database cần unique constraint, index theo ngày và cửa hàng, timeout cho query, giới hạn retry và statement timeout để một tác vụ lỗi không giữ tài nguyên vô hạn.
Pipeline cần logging theo run ID, audit số dòng, thời gian chạy và trạng thái commit. Với dữ liệu lớn, không nên tải toàn bộ bảng vào RAM. Có thể dùng query tổng hợp tại database, đọc theo chunk hoặc dùng công cụ xử lý phân tán. Cần quan sát cả chất lượng dữ liệu lẫn hiệu năng query bằng execution plan và chỉ số database.
11. Bài tập thực hành
- Thêm tham số cửa hàng và vẫn sử dụng bind parameter.
- Bổ sung bảng quarantine lưu bản ghi lỗi cùng run ID và error reason.
- Thay delete và insert bằng PostgreSQL upsert có unique constraint.
12. Project mở rộng
Xây Sales Reporting Service đọc dữ liệu từ PostgreSQL, tạo các mart doanh thu, khách hàng và sản phẩm, ghi lịch sử chạy, hỗ trợ backfill theo khoảng ngày và cung cấp bảng cho Power BI. Portfolio cần có migration, Docker Compose, unit test, integration test, dữ liệu mẫu và tài liệu mô tả grain của từng bảng.
13. Tổng kết
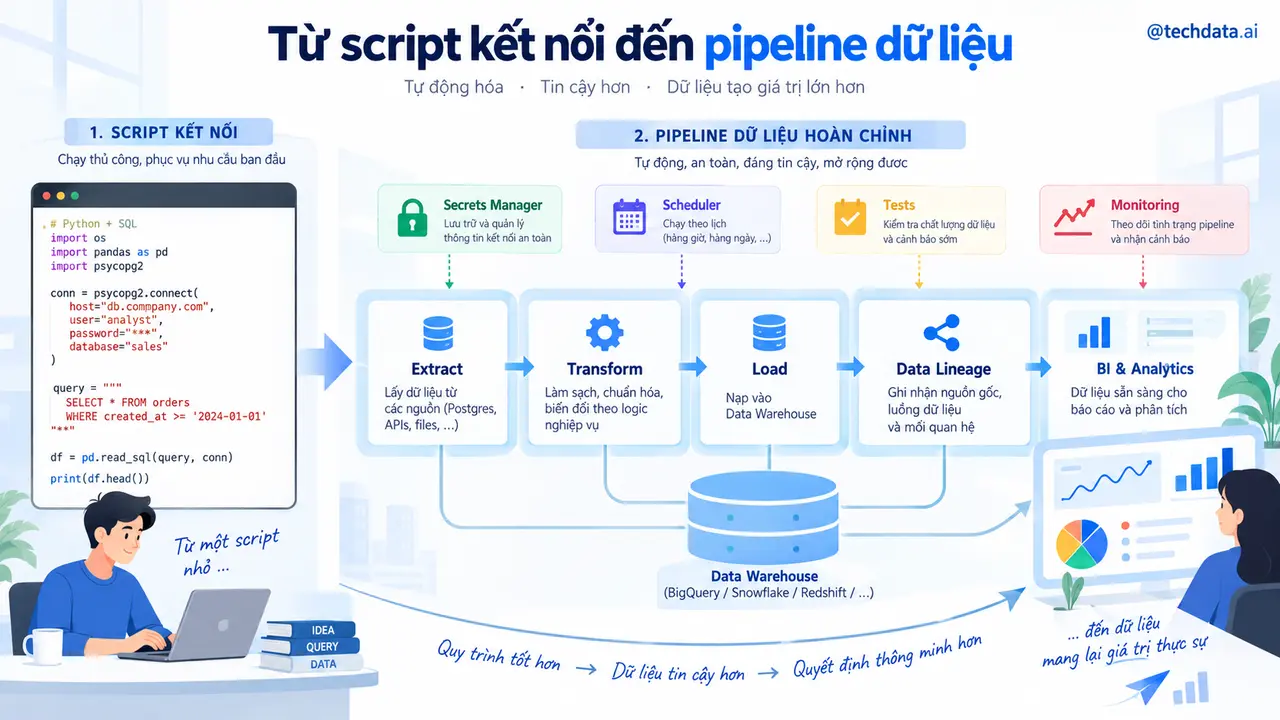
Bạn vừa xây một pipeline Python đọc dữ liệu SQL an toàn, kiểm tra business rule, tổng hợp KPI và ghi kết quả trong transaction. Giá trị quan trọng nhất là khả năng chạy lại, đối soát số dòng, bảo vệ thông tin kết nối và hiểu đúng grain trước khi tính chỉ số.
14. Tài liệu tham khảo
- SQLAlchemy Engine Configuration: https://docs.sqlalchemy.org/en/20/core/engines.html
- SQLAlchemy Transactions: https://docs.sqlalchemy.org/en/20/core/connections.html
- Pandas read_sql_query: https://pandas.pydata.org/docs/reference/api/pandas.read_sql_query.html
- Pandas DataFrame.to_sql: https://pandas.pydata.org/docs/reference/api/pandas.DataFrame.to_sql.html
- PostgreSQL Transaction Isolation: https://www.postgresql.org/docs/current/transaction-iso.html
- Psycopg documentation: https://www.psycopg.org/psycopg3/docs/