




Một doanh nghiệp có thể sở hữu BigQuery, Airflow và hàng trăm pipeline nhưng báo cáo vẫn trễ, khó chạy lại và không ai biết bản ghi lỗi đã đi đâu. Vấn đề thường không nằm ở tên công cụ mà ở cách dữ liệu được trích xuất, biến đổi, kiểm thử và công bố.
ETL và ELT là hai cách tổ chức chuỗi công việc đó. Bài viết đi từ nguồn, ingestion, raw, staging, gold đến orchestration, bảo mật, kiểm thử, chi phí và một case bán hàng đa kênh.
Mục lục
- PHẦN I — Hiểu đúng ETL và ELT
- PHẦN II — Toàn bộ kiến trúc pipeline
- PHẦN III — Độ tin cậy, bảo mật và vận hành
- PHẦN IV — Tối ưu Cloud Data Warehouse
- PHẦN V — Case, KPI và checklist
PHẦN I — ETL, ELT VÀ CÁCH CHỌN
1. ETL và ELT thực chất khác nhau ở đâu
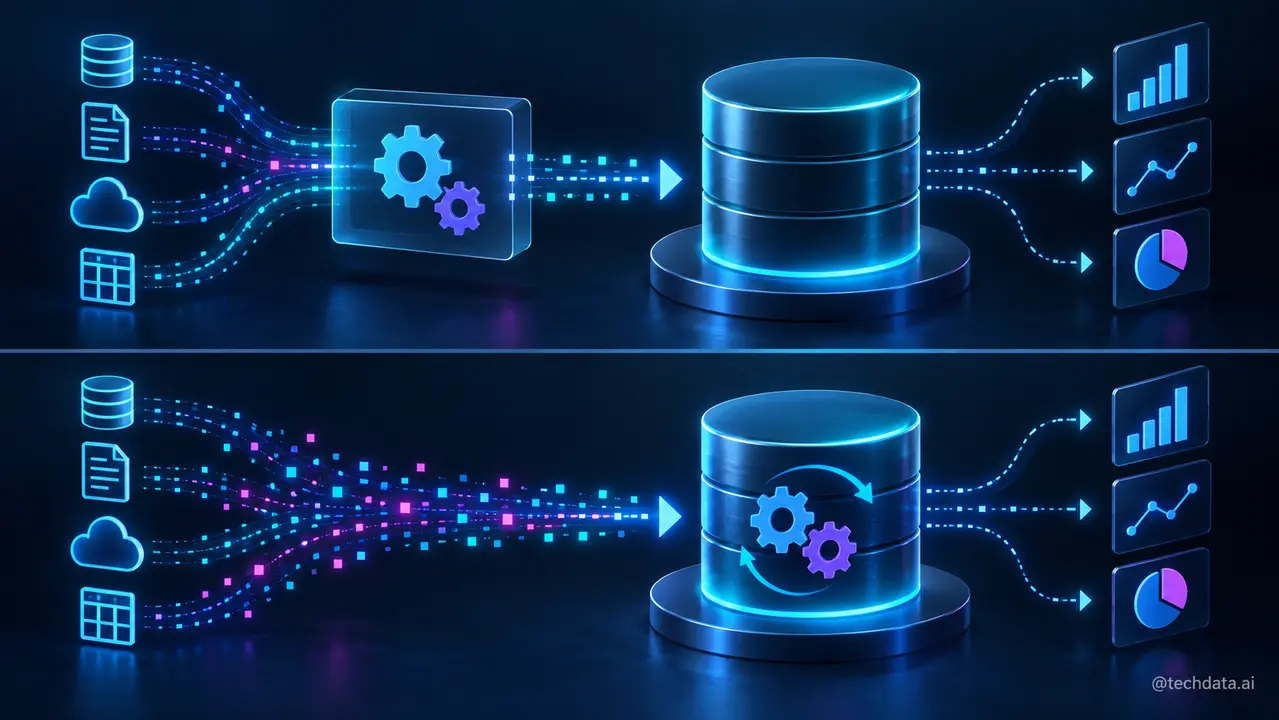
ETL biến đổi trước khi nạp, ELT nạp dữ liệu vào nền tảng đích rồi mới biến đổi. Đây là điểm thường quyết định ETL và ELT có tạo được một mô hình dễ dùng hay chỉ tạo thêm lớp kỹ thuật. Trước khi viết SQL, đội dự án phải chốt câu hỏi cần trả lời, mức chi tiết, owner và điều kiện nghiệm thu.
Ví dụ thực tế: Dữ liệu thẻ phải loại trước khi rời nguồn là ETL; log đơn hàng có thể vào raw rồi chuẩn hóa bằng SQL là ELT. Ví dụ phải được đối soát bằng dữ liệu thật và một báo cáo đang được nghiệp vụ sử dụng; nếu chỉ kiểm tra vài dòng mẫu, sai lệch tổng hợp có thể không xuất hiện.
Rủi ro cần tránh: Chọn theo khẩu hiệu cloud-first mà bỏ qua bảo mật và khả năng nguồn. Cách kiểm soát là ghi quyết định vào tài liệu mô hình, tạo test tự động và chỉ phát hành khi owner nghiệp vụ xác nhận kết quả.
2. Không phải pipeline nào cũng cần cùng một cách
Kiến trúc lai thường phù hợp hơn việc buộc toàn bộ dữ liệu theo một mô hình. Trong dự án thực tế, bước này cần được xử lý đồng thời ở ba lớp: định nghĩa nghiệp vụ, thiết kế dữ liệu và cơ chế vận hành. Thiếu một lớp, giải pháp có thể đúng hôm nay nhưng sai khi nguồn hoặc quy trình thay đổi.
PII được tokenize trước, file vận hành giữ gần bản gốc, logic KPI chạy trong BigQuery. Nhóm dữ liệu nên lưu truy vấn đối soát, dữ liệu đầu vào và kết quả mong đợi để biến ví dụ thành regression test. Khi logic được sửa, test cho biết thay đổi nào là chủ ý và thay đổi nào là lỗi.
Một tiêu chuẩn duy nhất làm pipeline đơn giản trên sơ đồ nhưng khó đáp ứng từng loại dữ liệu. Vì vậy, không nên đánh giá riêng bằng tốc độ truy vấn. Khả năng giải thích, truy vết, phân quyền và chạy lại cũng phải nằm trong tiêu chí nghiệm thu.
3. Lập hồ sơ nguồn dữ liệu
Một cách tiếp cận an toàn với lập hồ sơ nguồn dữ liệu là bắt đầu từ tình huống cụ thể. Mỗi nguồn cần owner, khóa, tần suất, timezone, schema, mức nhạy cảm và giới hạn truy cập. Sau đó mới chọn cấu trúc bảng, chiến lược xử lý và công nghệ phù hợp.
Tình huống: MySQL đơn hàng khác API quảng cáo về cách phân trang, thời điểm hoàn tất và khả năng sửa lịch sử. Từ tình huống này, đội dự án xác định dữ liệu nào là nguồn chuẩn, dữ liệu nào chỉ bổ sung ngữ cảnh và thời điểm nào được xem là hoàn tất.
Điểm kiểm soát: Không hiểu nguồn khiến incremental load bỏ sót hoặc tạo trùng. Mỗi lần chạy cần ghi phiên bản mã, khoảng dữ liệu, kết quả test và tài sản phía sau bị ảnh hưởng. Đây là cơ sở để xử lý sự cố mà không phải dò tìm thủ công.
4. Full load, incremental load và CDC
Phương thức lấy dữ liệu phải dựa trên khối lượng, độ trễ và hành vi cập nhật. Câu hỏi quan trọng không phải “công cụ có hỗ trợ hay không”, mà là doanh nghiệp muốn bảo toàn ý nghĩa nào của dữ liệu khi thời gian, khối lượng và số lượng người dùng tăng lên.
Danh mục nhỏ có thể full load; giao dịch dùng updated_at; bảng lớn cần CDC từ transaction log. Khi đưa vào production, nhóm nên đo cả độ đúng, độ tươi, chi phí và thời gian phục hồi. Một thiết kế tốt phải giữ kết quả ổn định khi chạy lại cùng dữ liệu và phải nêu rõ hành vi với dữ liệu đến muộn.
Full load liên tục gây tải nguồn và chi phí đích tăng nhanh. Nếu chưa thể loại bỏ rủi ro, hệ thống cần ít nhất phát hiện, cách ly và cảnh báo có owner. Không nên âm thầm thay giá trị lỗi bằng 0 hoặc bỏ bản ghi vì dashboard vẫn có thể hiển thị “đẹp” nhưng dẫn tới quyết định sai.
PHẦN II — KIẾN TRÚC TỪ RAW TỚI GOLD
1. Vùng landing và raw
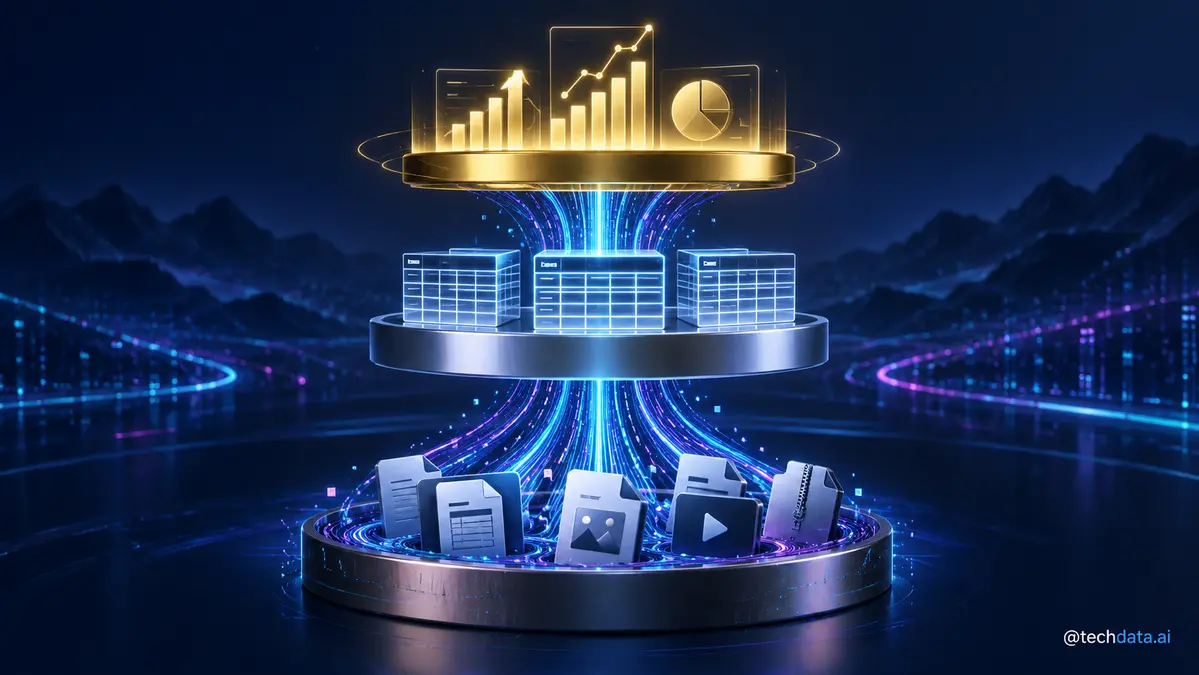
Raw giữ bằng chứng gần nguồn cùng metadata về lần nạp. Đây là điểm thường quyết định pipeline dữ liệu có tạo được một mô hình dễ dùng hay chỉ tạo thêm lớp kỹ thuật. Trước khi viết SQL, đội dự án phải chốt câu hỏi cần trả lời, mức chi tiết, owner và điều kiện nghiệm thu.
Ví dụ thực tế: Mỗi file hoặc batch có source, ingestion_time, schema_version và run_id để truy vết. Ví dụ phải được đối soát bằng dữ liệu thật và một báo cáo đang được nghiệp vụ sử dụng; nếu chỉ kiểm tra vài dòng mẫu, sai lệch tổng hợp có thể không xuất hiện.
Rủi ro cần tránh: Raw không có retention, quyền và quy ước trở thành data swamp. Cách kiểm soát là ghi quyết định vào tài liệu mô hình, tạo test tự động và chỉ phát hành khi owner nghiệp vụ xác nhận kết quả.
2. Lớp staging
Staging xử lý kiểu dữ liệu, tên cột, timezone và bản ghi lỗi nhưng chưa áp toàn bộ logic KPI. Trong dự án thực tế, bước này cần được xử lý đồng thời ở ba lớp: định nghĩa nghiệp vụ, thiết kế dữ liệu và cơ chế vận hành. Thiếu một lớp, giải pháp có thể đúng hôm nay nhưng sai khi nguồn hoặc quy trình thay đổi.
Chuỗi ngày được parse, tiền tệ gắn mã, trạng thái nguồn được giữ cạnh trạng thái chuẩn. Nhóm dữ liệu nên lưu truy vấn đối soát, dữ liệu đầu vào và kết quả mong đợi để biến ví dụ thành regression test. Khi logic được sửa, test cho biết thay đổi nào là chủ ý và thay đổi nào là lỗi.
Gộp làm sạch kỹ thuật với logic kinh doanh khiến khó debug. Vì vậy, không nên đánh giá riêng bằng tốc độ truy vấn. Khả năng giải thích, truy vết, phân quyền và chạy lại cũng phải nằm trong tiêu chí nghiệm thu.
3. Lớp curated và gold
Một cách tiếp cận an toàn với lớp curated và gold là bắt đầu từ tình huống cụ thể. Curated tích hợp thực thể; gold phục vụ quyết định bằng fact, dimension và metric. Sau đó mới chọn cấu trúc bảng, chiến lược xử lý và công nghệ phù hợp.
Tình huống: Đơn POS, website và sàn được chuẩn hóa rồi hợp nhất thành fact_sales. Từ tình huống này, đội dự án xác định dữ liệu nào là nguồn chuẩn, dữ liệu nào chỉ bổ sung ngữ cảnh và thời điểm nào được xem là hoàn tất.
Điểm kiểm soát: Đưa bảng raw thẳng vào dashboard tạo công thức phân tán. Mỗi lần chạy cần ghi phiên bản mã, khoảng dữ liệu, kết quả test và tài sản phía sau bị ảnh hưởng. Đây là cơ sở để xử lý sự cố mà không phải dò tìm thủ công.
4. Orchestration và dependency
Điều phối phải biết thứ tự, cửa sổ dữ liệu, retry và SLA. Câu hỏi quan trọng không phải “công cụ có hỗ trợ hay không”, mà là doanh nghiệp muốn bảo toàn ý nghĩa nào của dữ liệu khi thời gian, khối lượng và số lượng người dùng tăng lên.
Nạp khách hàng và sản phẩm trước khi build fact; chỉ publish mart sau khi test đạt. Khi đưa vào production, nhóm nên đo cả độ đúng, độ tươi, chi phí và thời gian phục hồi. Một thiết kế tốt phải giữ kết quả ổn định khi chạy lại cùng dữ liệu và phải nêu rõ hành vi với dữ liệu đến muộn.
Chạy cron độc lập làm downstream dùng dữ liệu nửa cũ nửa mới. Nếu chưa thể loại bỏ rủi ro, hệ thống cần ít nhất phát hiện, cách ly và cảnh báo có owner. Không nên âm thầm thay giá trị lỗi bằng 0 hoặc bỏ bản ghi vì dashboard vẫn có thể hiển thị “đẹp” nhưng dẫn tới quyết định sai.
5. Idempotency
Chạy lại cùng một khoảng dữ liệu phải cho cùng kết quả. Đây là điểm thường quyết định pipeline dữ liệu có tạo được một mô hình dễ dùng hay chỉ tạo thêm lớp kỹ thuật. Trước khi viết SQL, đội dự án phải chốt câu hỏi cần trả lời, mức chi tiết, owner và điều kiện nghiệm thu.
Ví dụ thực tế: MERGE theo business key và event time thay vì INSERT mù. Ví dụ phải được đối soát bằng dữ liệu thật và một báo cáo đang được nghiệp vụ sử dụng; nếu chỉ kiểm tra vài dòng mẫu, sai lệch tổng hợp có thể không xuất hiện.
Rủi ro cần tránh: Retry sau timeout tạo doanh thu trùng. Cách kiểm soát là ghi quyết định vào tài liệu mô hình, tạo test tự động và chỉ phát hành khi owner nghiệp vụ xác nhận kết quả.
6. Watermark và checkpoint
Pipeline cần biết chính xác mốc đã xử lý. Trong dự án thực tế, bước này cần được xử lý đồng thời ở ba lớp: định nghĩa nghiệp vụ, thiết kế dữ liệu và cơ chế vận hành. Thiếu một lớp, giải pháp có thể đúng hôm nay nhưng sai khi nguồn hoặc quy trình thay đổi.
Lưu timestamp cùng khóa tie-breaker hoặc log position để không bỏ bản ghi cùng thời điểm. Nhóm dữ liệu nên lưu truy vấn đối soát, dữ liệu đầu vào và kết quả mong đợi để biến ví dụ thành regression test. Khi logic được sửa, test cho biết thay đổi nào là chủ ý và thay đổi nào là lỗi.
Chỉ dùng MAX(updated_at) dễ mất dữ liệu. Vì vậy, không nên đánh giá riêng bằng tốc độ truy vấn. Khả năng giải thích, truy vết, phân quyền và chạy lại cũng phải nằm trong tiêu chí nghiệm thu.
7. Dữ liệu đến muộn
Một cách tiếp cận an toàn với dữ liệu đến muộn là bắt đầu từ tình huống cụ thể. Late data phải có cửa sổ và chính sách backfill. Sau đó mới chọn cấu trúc bảng, chiến lược xử lý và công nghệ phù hợp.
Tình huống: Đơn sàn hôm trước hoàn tiền sau ba ngày cần cập nhật lại partition lịch sử. Từ tình huống này, đội dự án xác định dữ liệu nào là nguồn chuẩn, dữ liệu nào chỉ bổ sung ngữ cảnh và thời điểm nào được xem là hoàn tất.
Điểm kiểm soát: Chỉ xử lý ngày hiện tại làm báo cáo quá khứ sai dần. Mỗi lần chạy cần ghi phiên bản mã, khoảng dữ liệu, kết quả test và tài sản phía sau bị ảnh hưởng. Đây là cơ sở để xử lý sự cố mà không phải dò tìm thủ công.
8. Schema evolution
Thêm cột, đổi kiểu và xóa cột cần phân loại tương thích. Câu hỏi quan trọng không phải “công cụ có hỗ trợ hay không”, mà là doanh nghiệp muốn bảo toàn ý nghĩa nào của dữ liệu khi thời gian, khối lượng và số lượng người dùng tăng lên.
Cột mới nullable có thể nhận tự động; đổi amount từ số sang chuỗi phải cách ly. Khi đưa vào production, nhóm nên đo cả độ đúng, độ tươi, chi phí và thời gian phục hồi. Một thiết kế tốt phải giữ kết quả ổn định khi chạy lại cùng dữ liệu và phải nêu rõ hành vi với dữ liệu đến muộn.
Auto-accept mọi schema change làm lớp gold hỏng âm thầm. Nếu chưa thể loại bỏ rủi ro, hệ thống cần ít nhất phát hiện, cách ly và cảnh báo có owner. Không nên âm thầm thay giá trị lỗi bằng 0 hoặc bỏ bản ghi vì dashboard vẫn có thể hiển thị “đẹp” nhưng dẫn tới quyết định sai.
9. Data contract
Contract mô tả schema, ý nghĩa, SLA và trách nhiệm giữa nguồn với nền tảng. Đây là điểm thường quyết định pipeline dữ liệu có tạo được một mô hình dễ dùng hay chỉ tạo thêm lớp kỹ thuật. Trước khi viết SQL, đội dự án phải chốt câu hỏi cần trả lời, mức chi tiết, owner và điều kiện nghiệm thu.
Ví dụ thực tế: Đội bán hàng cam kết order_id duy nhất và thông báo trước khi đổi trạng thái. Ví dụ phải được đối soát bằng dữ liệu thật và một báo cáo đang được nghiệp vụ sử dụng; nếu chỉ kiểm tra vài dòng mẫu, sai lệch tổng hợp có thể không xuất hiện.
Rủi ro cần tránh: Contract chỉ là tài liệu không có test sẽ nhanh chóng lỗi thời. Cách kiểm soát là ghi quyết định vào tài liệu mô hình, tạo test tự động và chỉ phát hành khi owner nghiệp vụ xác nhận kết quả.
PHẦN III — CHẤT LƯỢNG VÀ BẢO MẬT
1. Kiểm thử cấu trúc
Schema, kiểu, null, uniqueness và accepted values cần chạy tự động. Đây là điểm thường quyết định Data Warehouse có tạo được một mô hình dễ dùng hay chỉ tạo thêm lớp kỹ thuật. Trước khi viết SQL, đội dự án phải chốt câu hỏi cần trả lời, mức chi tiết, owner và điều kiện nghiệm thu.
Ví dụ thực tế: order_id không null, amount là numeric và status thuộc danh sách phê duyệt. Ví dụ phải được đối soát bằng dữ liệu thật và một báo cáo đang được nghiệp vụ sử dụng; nếu chỉ kiểm tra vài dòng mẫu, sai lệch tổng hợp có thể không xuất hiện.
Rủi ro cần tránh: Ép kiểu lỗi thành null che mất sự cố nguồn. Cách kiểm soát là ghi quyết định vào tài liệu mô hình, tạo test tự động và chỉ phát hành khi owner nghiệp vụ xác nhận kết quả.
2. Đối soát nghiệp vụ
Row count không đủ; phải đối soát tổng tiền và số giao dịch. Trong dự án thực tế, bước này cần được xử lý đồng thời ở ba lớp: định nghĩa nghiệp vụ, thiết kế dữ liệu và cơ chế vận hành. Thiếu một lớp, giải pháp có thể đúng hôm nay nhưng sai khi nguồn hoặc quy trình thay đổi.
Tổng gross, discount, tax, refund theo ngày được so với nguồn. Nhóm dữ liệu nên lưu truy vấn đối soát, dữ liệu đầu vào và kết quả mong đợi để biến ví dụ thành regression test. Khi logic được sửa, test cho biết thay đổi nào là chủ ý và thay đổi nào là lỗi.
Số dòng bằng nhau nhưng JOIN hoặc công thức vẫn có thể sai. Vì vậy, không nên đánh giá riêng bằng tốc độ truy vấn. Khả năng giải thích, truy vết, phân quyền và chạy lại cũng phải nằm trong tiêu chí nghiệm thu.
3. Quarantine dữ liệu lỗi
Một cách tiếp cận an toàn với quarantine dữ liệu lỗi là bắt đầu từ tình huống cụ thể. Bản ghi lỗi nên được cách ly cùng lý do và khả năng xử lý lại. Sau đó mới chọn cấu trúc bảng, chiến lược xử lý và công nghệ phù hợp.
Tình huống: Ngày không hợp lệ vào error table thay vì bị bỏ hoặc đổi thành 1970-01-01. Từ tình huống này, đội dự án xác định dữ liệu nào là nguồn chuẩn, dữ liệu nào chỉ bổ sung ngữ cảnh và thời điểm nào được xem là hoàn tất.
Điểm kiểm soát: Quarantine không owner sẽ tích tụ vĩnh viễn. Mỗi lần chạy cần ghi phiên bản mã, khoảng dữ liệu, kết quả test và tài sản phía sau bị ảnh hưởng. Đây là cơ sở để xử lý sự cố mà không phải dò tìm thủ công.
4. Bảo mật trong ETL và ELT
Quyền tối thiểu áp dụng cho connector, service account và bảng. Câu hỏi quan trọng không phải “công cụ có hỗ trợ hay không”, mà là doanh nghiệp muốn bảo toàn ý nghĩa nào của dữ liệu khi thời gian, khối lượng và số lượng người dùng tăng lên.
Pipeline chỉ đọc bảng cần thiết; analyst không được đọc raw chứa số điện thoại. Khi đưa vào production, nhóm nên đo cả độ đúng, độ tươi, chi phí và thời gian phục hồi. Một thiết kế tốt phải giữ kết quả ổn định khi chạy lại cùng dữ liệu và phải nêu rõ hành vi với dữ liệu đến muộn.
Dùng tài khoản admin chung làm tăng phạm vi sự cố. Nếu chưa thể loại bỏ rủi ro, hệ thống cần ít nhất phát hiện, cách ly và cảnh báo có owner. Không nên âm thầm thay giá trị lỗi bằng 0 hoặc bỏ bản ghi vì dashboard vẫn có thể hiển thị “đẹp” nhưng dẫn tới quyết định sai.
5. Mã hóa và quản lý secrets
Secrets phải nằm trong secret manager và được xoay vòng. Đây là điểm thường quyết định Data Warehouse có tạo được một mô hình dễ dùng hay chỉ tạo thêm lớp kỹ thuật. Trước khi viết SQL, đội dự án phải chốt câu hỏi cần trả lời, mức chi tiết, owner và điều kiện nghiệm thu.
Ví dụ thực tế: Airflow lấy credential theo runtime thay vì ghi trong DAG. Ví dụ phải được đối soát bằng dữ liệu thật và một báo cáo đang được nghiệp vụ sử dụng; nếu chỉ kiểm tra vài dòng mẫu, sai lệch tổng hợp có thể không xuất hiện.
Rủi ro cần tránh: Credential trong mã nguồn hoặc log có thể bị phát tán. Cách kiểm soát là ghi quyết định vào tài liệu mô hình, tạo test tự động và chỉ phát hành khi owner nghiệp vụ xác nhận kết quả.
PHẦN IV — VẬN HÀNH VÀ TỐI ƯU CLOUD
1. Tối ưu BigQuery
Partition, clustering và incremental model giảm dữ liệu quét. Đây là điểm thường quyết định ELT trên cloud có tạo được một mô hình dễ dùng hay chỉ tạo thêm lớp kỹ thuật. Trước khi viết SQL, đội dự án phải chốt câu hỏi cần trả lời, mức chi tiết, owner và điều kiện nghiệm thu.
Ví dụ thực tế: Fact partition theo event_date; job chỉ MERGE partition bị thay đổi. Ví dụ phải được đối soát bằng dữ liệu thật và một báo cáo đang được nghiệp vụ sử dụng; nếu chỉ kiểm tra vài dòng mẫu, sai lệch tổng hợp có thể không xuất hiện.
Rủi ro cần tránh: SELECT sao và full refresh hằng ngày làm hóa đơn tăng. Cách kiểm soát là ghi quyết định vào tài liệu mô hình, tạo test tự động và chỉ phát hành khi owner nghiệp vụ xác nhận kết quả.
2. Quan sát pipeline
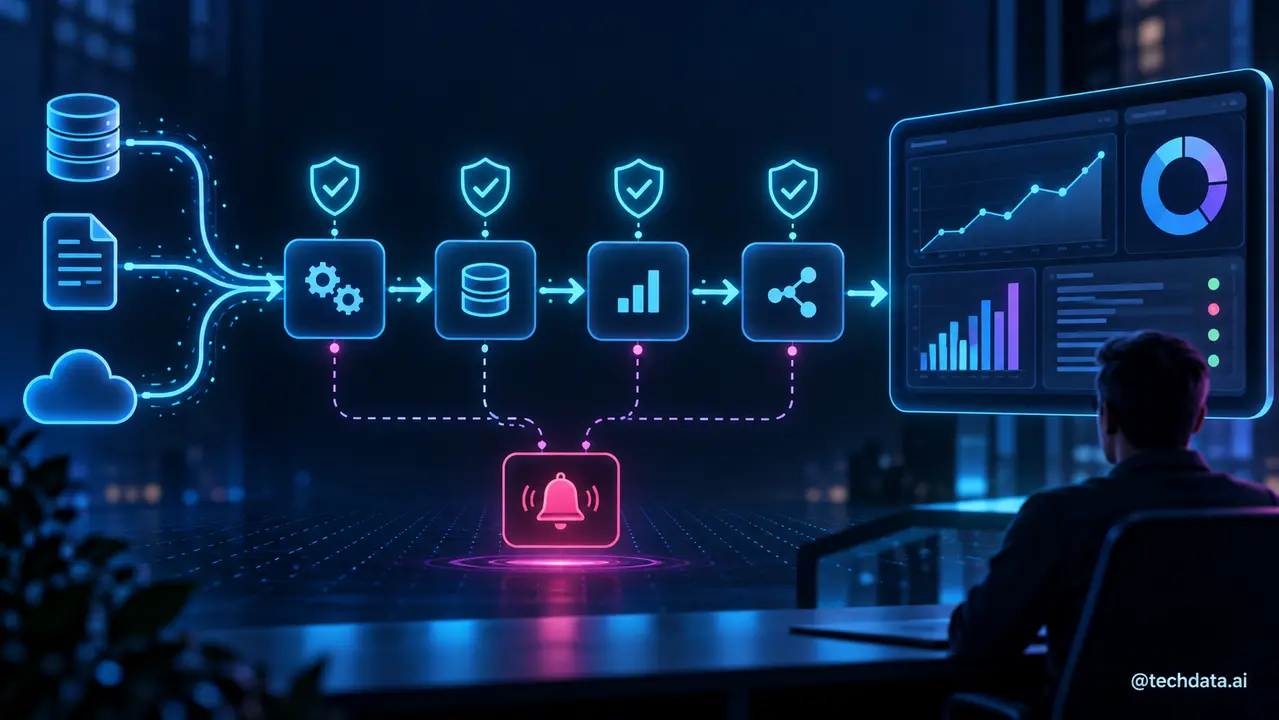
Theo dõi freshness, duration, volume, error và cost theo run. Trong dự án thực tế, bước này cần được xử lý đồng thời ở ba lớp: định nghĩa nghiệp vụ, thiết kế dữ liệu và cơ chế vận hành. Thiếu một lớp, giải pháp có thể đúng hôm nay nhưng sai khi nguồn hoặc quy trình thay đổi.
Cảnh báo chỉ rõ nguồn, bảng, partition, owner và dashboard bị ảnh hưởng. Nhóm dữ liệu nên lưu truy vấn đối soát, dữ liệu đầu vào và kết quả mong đợi để biến ví dụ thành regression test. Khi logic được sửa, test cho biết thay đổi nào là chủ ý và thay đổi nào là lỗi.
Thông báo “job failed” không đủ để xử lý nhanh. Vì vậy, không nên đánh giá riêng bằng tốc độ truy vấn. Khả năng giải thích, truy vết, phân quyền và chạy lại cũng phải nằm trong tiêu chí nghiệm thu.
3. Backfill có kiểm soát
Một cách tiếp cận an toàn với backfill có kiểm soát là bắt đầu từ tình huống cụ thể. Backfill cần phạm vi, phiên bản logic và ngân sách. Sau đó mới chọn cấu trúc bảng, chiến lược xử lý và công nghệ phù hợp.
Tình huống: Tính lại 12 tháng theo từng partition, kiểm tra chênh lệch rồi mới thay bảng serving. Từ tình huống này, đội dự án xác định dữ liệu nào là nguồn chuẩn, dữ liệu nào chỉ bổ sung ngữ cảnh và thời điểm nào được xem là hoàn tất.
Điểm kiểm soát: Chạy toàn lịch sử cùng lúc gây nghẽn và tạo số liệu không nhất quán. Mỗi lần chạy cần ghi phiên bản mã, khoảng dữ liệu, kết quả test và tài sản phía sau bị ảnh hưởng. Đây là cơ sở để xử lý sự cố mà không phải dò tìm thủ công.
4. CI/CD cho transformation
SQL và cấu hình pipeline cần version control, review và môi trường kiểm thử. Câu hỏi quan trọng không phải “công cụ có hỗ trợ hay không”, mà là doanh nghiệp muốn bảo toàn ý nghĩa nào của dữ liệu khi thời gian, khối lượng và số lượng người dùng tăng lên.
Pull request chạy unit test cùng sample data trước khi deploy. Khi đưa vào production, nhóm nên đo cả độ đúng, độ tươi, chi phí và thời gian phục hồi. Một thiết kế tốt phải giữ kết quả ổn định khi chạy lại cùng dữ liệu và phải nêu rõ hành vi với dữ liệu đến muộn.
Sửa trực tiếp production làm mất dấu quyết định. Nếu chưa thể loại bỏ rủi ro, hệ thống cần ít nhất phát hiện, cách ly và cảnh báo có owner. Không nên âm thầm thay giá trị lỗi bằng 0 hoặc bỏ bản ghi vì dashboard vẫn có thể hiển thị “đẹp” nhưng dẫn tới quyết định sai.
PHẦN V — CASE VÀ CHECKLIST
1. Case bán hàng đa kênh
Một case hoàn chỉnh kết hợp ETL cho dữ liệu nhạy cảm và ELT cho logic phân tích. Đây là điểm thường quyết định kiến trúc tích hợp dữ liệu có tạo được một mô hình dễ dùng hay chỉ tạo thêm lớp kỹ thuật. Trước khi viết SQL, đội dự án phải chốt câu hỏi cần trả lời, mức chi tiết, owner và điều kiện nghiệm thu.
Ví dụ thực tế: POS, website và sàn vào raw; PII được token; BigQuery build fact_sales và marts. Ví dụ phải được đối soát bằng dữ liệu thật và một báo cáo đang được nghiệp vụ sử dụng; nếu chỉ kiểm tra vài dòng mẫu, sai lệch tổng hợp có thể không xuất hiện.
Rủi ro cần tránh: Không tách doanh thu đặt hàng với doanh thu kế toán gây lệch. Cách kiểm soát là ghi quyết định vào tài liệu mô hình, tạo test tự động và chỉ phát hành khi owner nghiệp vụ xác nhận kết quả.
2. KPI đánh giá kiến trúc
Đo freshness, success rate, reconciliation, recovery time và cost. Trong dự án thực tế, bước này cần được xử lý đồng thời ở ba lớp: định nghĩa nghiệp vụ, thiết kế dữ liệu và cơ chế vận hành. Thiếu một lớp, giải pháp có thể đúng hôm nay nhưng sai khi nguồn hoặc quy trình thay đổi.
MVP đặt SLA T+1, đối soát 99,9% và phục hồi dưới hai giờ. Nhóm dữ liệu nên lưu truy vấn đối soát, dữ liệu đầu vào và kết quả mong đợi để biến ví dụ thành regression test. Khi logic được sửa, test cho biết thay đổi nào là chủ ý và thay đổi nào là lỗi.
Chỉ đếm số pipeline không chứng minh giá trị. Vì vậy, không nên đánh giá riêng bằng tốc độ truy vấn. Khả năng giải thích, truy vết, phân quyền và chạy lại cũng phải nằm trong tiêu chí nghiệm thu.
3. Checklist lựa chọn ETL hay ELT
Một cách tiếp cận an toàn với checklist lựa chọn etl hay elt là bắt đầu từ tình huống cụ thể. Quyết định cần xét dữ liệu, nền tảng, đội ngũ, tuân thủ và chi phí. Sau đó mới chọn cấu trúc bảng, chiến lược xử lý và công nghệ phù hợp.
Tình huống: Nếu cloud mạnh, SQL tốt và cần tái xử lý, ELT thường thuận lợi; dữ liệu phải làm sạch trước khi rời nguồn cần ETL. Từ tình huống này, đội dự án xác định dữ liệu nào là nguồn chuẩn, dữ liệu nào chỉ bổ sung ngữ cảnh và thời điểm nào được xem là hoàn tất.
Điểm kiểm soát: Chọn công cụ trước khi chốt yêu cầu khóa doanh nghiệp vào kiến trúc không phù hợp. Mỗi lần chạy cần ghi phiên bản mã, khoảng dữ liệu, kết quả test và tài sản phía sau bị ảnh hưởng. Đây là cơ sở để xử lý sự cố mà không phải dò tìm thủ công.
Kết luận
ETL và ELT không phải hai phe loại trừ nhau. Kiến trúc tốt đặt kiểm soát đúng vị trí: dữ liệu nhạy cảm được bảo vệ trước khi rời vùng tin cậy, dữ liệu gốc đủ để truy vết, logic KPI được quản lý bằng mã và mọi lớp đều có test. Khi đó pipeline mới là nền tảng vận hành, không chỉ là đường vận chuyển dữ liệu.
Câu hỏi thường gặp
Cloud Data Warehouse có bắt buộc dùng ELT?
Không. Cloud làm ELT thuận lợi, nhưng dữ liệu nhạy cảm vẫn có thể cần biến đổi hoặc loại bỏ trước khi nạp.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với ETL và ELT, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
Airflow là công cụ ETL hay ELT?
Airflow chủ yếu điều phối tác vụ. Phần biến đổi có thể chạy ở Python, Spark, BigQuery, dbt hoặc dịch vụ khác.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với ETL và ELT, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
Có cần giữ raw mãi mãi?
Không. Retention phụ thuộc nhu cầu replay, kiểm toán, chi phí và nghĩa vụ bảo vệ dữ liệu.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với ETL và ELT, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
Incremental load có luôn tốt hơn full load?
Không. Với bảng nhỏ và ổn định, full load có thể đơn giản, rẻ và dễ đối soát hơn.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với ETL và ELT, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
Làm sao tránh dữ liệu trùng khi retry?
Thiết kế idempotent bằng business key, checkpoint, MERGE và run metadata.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với ETL và ELT, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
ELT có làm dữ liệu kém an toàn?
Không mặc định, nhưng raw phải được mã hóa, phân quyền và loại PII không cần thiết.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với ETL và ELT, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
dbt có thay Airflow không?
dbt quản lý transformation và dependency mô hình; Airflow điều phối workflow rộng hơn. Hai công cụ thường bổ sung nhau.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với ETL và ELT, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
Khi nào phải backfill?
Khi logic đổi, dữ liệu đến muộn hoặc pipeline bỏ sót khoảng lịch sử; backfill cần phạm vi và đối soát.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với ETL và ELT, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
Đo pipeline bằng KPI nào?
Freshness, success rate, completeness, reconciliation, recovery time và cost theo run là nhóm tối thiểu.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với ETL và ELT, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
SME nên chọn ETL hay ELT?
Nếu dùng Cloud Data Warehouse và đội mạnh SQL, ELT thường dễ bắt đầu; vẫn kết hợp ETL cho dữ liệu cần bảo vệ sớm.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với ETL và ELT, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
Nguồn tham khảo và cách áp dụng
IBM định nghĩa ETL là quá trình kết hợp, làm sạch và tổ chức dữ liệu từ nhiều nguồn trước khi đưa vào kho, đồng thời phân biệt ELT bằng vị trí của bước transform. Tài liệu IBM cũng nhấn mạnh ETL vẫn hữu ích cho hệ thống legacy, batch định kỳ và trường hợp cần che PII trước khi dữ liệu tới đích. AWS cung cấp pattern nạp tăng dần từ S3 vào Redshift bằng Glue, cho thấy lựa chọn ETL hay ELT cuối cùng vẫn phải được chuyển thành checkpoint, incremental processing và cơ chế vận hành cụ thể.
Tài liệu tham khảo
- IBM, “What is ETL (Extract, Transform, Load)?”. Định nghĩa, so sánh ETL–ELT, streaming ETL và CDC.
- AWS Prescriptive Guidance, “Build an ETL service pipeline to load data incrementally”. Pattern incremental load với S3, Glue và Redshift.
- Google Cloud, “Optimize storage for query performance”. Khuyến nghị partition và tổ chức lưu trữ BigQuery.
- Google Cloud, “Optimize query computation”. Khuyến nghị giảm dữ liệu xử lý và tránh oversharding.
- Google Cloud, “Query partitioned tables”. Partition pruning để giảm chi phí và thời gian truy vấn.
TechData.AI - Leading the Future.