




Một pipeline có thể hiển thị màu xanh trong khi doanh thu bị nhân đôi. Dashboard có thể tải nhanh trong khi một chi nhánh đã ngừng gửi dữ liệu hai ngày. “Job chạy thành công” và “dữ liệu đủ tin để ra quyết định” là hai trạng thái khác nhau.
Bài viết trình bày Data Quality từ góc nhìn kinh doanh, 10 nhóm kiểm thử cốt lõi, cách đặt test tại raw-staging-gold, severity, quarantine, incident, data contract, observability và dữ liệu đáng tin cậy cho AI Agents.
Mục lục
- PHẦN I — Chất lượng dữ liệu thực chất là gì?
- PHẦN II — Các kiểm thử cốt lõi
- PHẦN III — Đặt test trong kiến trúc
- PHẦN IV — Vận hành sự cố và Data Contract
- PHẦN V — Observability, Trust Score và AI
PHẦN I — TỪ RỦI RO KINH DOANH TỚI DATA QUALITY
1. Data Quality là gì
Chất lượng là mức dữ liệu phù hợp với mục đích, không chỉ đúng kiểu. Đây là điểm thường quyết định Data Quality có tạo được một mô hình dễ dùng hay chỉ tạo thêm lớp kỹ thuật. Trước khi viết SQL, đội dự án phải chốt câu hỏi cần trả lời, mức chi tiết, owner và điều kiện nghiệm thu.
Ví dụ thực tế: Số điện thoại thiếu có thể chấp nhận cho doanh thu nhưng không cho chiến dịch SMS. Ví dụ phải được đối soát bằng dữ liệu thật và một báo cáo đang được nghiệp vụ sử dụng; nếu chỉ kiểm tra vài dòng mẫu, sai lệch tổng hợp có thể không xuất hiện.
Rủi ro cần tránh: Đặt một tiêu chuẩn cho mọi bảng. Cách kiểm soát là ghi quyết định vào tài liệu mô hình, tạo test tự động và chỉ phát hành khi owner nghiệp vụ xác nhận kết quả.
2. Chất lượng là vấn đề kinh doanh
Lỗi dữ liệu tác động doanh thu, chi phí, rủi ro và niềm tin. Trong dự án thực tế, bước này cần được xử lý đồng thời ở ba lớp: định nghĩa nghiệp vụ, thiết kế dữ liệu và cơ chế vận hành. Thiếu một lớp, giải pháp có thể đúng hôm nay nhưng sai khi nguồn hoặc quy trình thay đổi.
Đơn trùng làm doanh thu tăng và đặt hàng quá mức. Nhóm dữ liệu nên lưu truy vấn đối soát, dữ liệu đầu vào và kết quả mong đợi để biến ví dụ thành regression test. Khi logic được sửa, test cho biết thay đổi nào là chủ ý và thay đổi nào là lỗi.
Xem Data Quality là việc riêng của Data Engineer. Vì vậy, không nên đánh giá riêng bằng tốc độ truy vấn. Khả năng giải thích, truy vết, phân quyền và chạy lại cũng phải nằm trong tiêu chí nghiệm thu.
3. Xác định data product quan trọng
Một cách tiếp cận an toàn với xác định data product quan trọng là bắt đầu từ tình huống cụ thể. Ưu tiên theo quyết định và mức rủi ro. Sau đó mới chọn cấu trúc bảng, chiến lược xử lý và công nghệ phù hợp.
Tình huống: fact_revenue quan trọng hơn bảng log thử nghiệm. Từ tình huống này, đội dự án xác định dữ liệu nào là nguồn chuẩn, dữ liệu nào chỉ bổ sung ngữ cảnh và thời điểm nào được xem là hoàn tất.
Điểm kiểm soát: Viết hàng nghìn test nhưng bỏ KPI cốt lõi. Mỗi lần chạy cần ghi phiên bản mã, khoảng dữ liệu, kết quả test và tài sản phía sau bị ảnh hưởng. Đây là cơ sở để xử lý sự cố mà không phải dò tìm thủ công.
PHẦN II — 10 NHÓM KIỂM THỬ CỐT LÕI
1. Completeness
Đo trường và kỳ dữ liệu có đầy đủ. Đây là điểm thường quyết định kiểm thử dữ liệu có tạo được một mô hình dễ dùng hay chỉ tạo thêm lớp kỹ thuật. Trước khi viết SQL, đội dự án phải chốt câu hỏi cần trả lời, mức chi tiết, owner và điều kiện nghiệm thu.
Ví dụ thực tế: 100 cửa hàng phải gửi dữ liệu; thiếu một cửa hàng không được hiển thị thành 0. Ví dụ phải được đối soát bằng dữ liệu thật và một báo cáo đang được nghiệp vụ sử dụng; nếu chỉ kiểm tra vài dòng mẫu, sai lệch tổng hợp có thể không xuất hiện.
Rủi ro cần tránh: Chỉ đo null toàn bảng che lỗi theo chi nhánh. Cách kiểm soát là ghi quyết định vào tài liệu mô hình, tạo test tự động và chỉ phát hành khi owner nghiệp vụ xác nhận kết quả.
2. Uniqueness
Khóa phải duy nhất ở đúng grain. Trong dự án thực tế, bước này cần được xử lý đồng thời ở ba lớp: định nghĩa nghiệp vụ, thiết kế dữ liệu và cơ chế vận hành. Thiếu một lớp, giải pháp có thể đúng hôm nay nhưng sai khi nguồn hoặc quy trình thay đổi.
order_line_id duy nhất trong fact_sales. Nhóm dữ liệu nên lưu truy vấn đối soát, dữ liệu đầu vào và kết quả mong đợi để biến ví dụ thành regression test. Khi logic được sửa, test cho biết thay đổi nào là chủ ý và thay đổi nào là lỗi.
Kiểm tra order_id trên bảng mức dòng sản phẩm rồi báo lỗi giả. Vì vậy, không nên đánh giá riêng bằng tốc độ truy vấn. Khả năng giải thích, truy vết, phân quyền và chạy lại cũng phải nằm trong tiêu chí nghiệm thu.
3. Validity
Một cách tiếp cận an toàn với validity là bắt đầu từ tình huống cụ thể. Giá trị phải nằm trong miền và quy tắc. Sau đó mới chọn cấu trúc bảng, chiến lược xử lý và công nghệ phù hợp.
Tình huống: amount không âm, currency thuộc danh mục, status hợp lệ. Từ tình huống này, đội dự án xác định dữ liệu nào là nguồn chuẩn, dữ liệu nào chỉ bổ sung ngữ cảnh và thời điểm nào được xem là hoàn tất.
Điểm kiểm soát: Ép giá trị lạ thành mặc định. Mỗi lần chạy cần ghi phiên bản mã, khoảng dữ liệu, kết quả test và tài sản phía sau bị ảnh hưởng. Đây là cơ sở để xử lý sự cố mà không phải dò tìm thủ công.
4. Referential integrity
Fact phải nối được dimension hoặc có Unknown được quản lý. Câu hỏi quan trọng không phải “công cụ có hỗ trợ hay không”, mà là doanh nghiệp muốn bảo toàn ý nghĩa nào của dữ liệu khi thời gian, khối lượng và số lượng người dùng tăng lên.
product_key luôn tồn tại trong dim_product. Khi đưa vào production, nhóm nên đo cả độ đúng, độ tươi, chi phí và thời gian phục hồi. Một thiết kế tốt phải giữ kết quả ổn định khi chạy lại cùng dữ liệu và phải nêu rõ hành vi với dữ liệu đến muộn.
INNER JOIN làm mất giao dịch không khớp. Nếu chưa thể loại bỏ rủi ro, hệ thống cần ít nhất phát hiện, cách ly và cảnh báo có owner. Không nên âm thầm thay giá trị lỗi bằng 0 hoặc bỏ bản ghi vì dashboard vẫn có thể hiển thị “đẹp” nhưng dẫn tới quyết định sai.
5. Consistency
Cùng khái niệm cần biểu diễn thống nhất. Đây là điểm thường quyết định kiểm thử dữ liệu có tạo được một mô hình dễ dùng hay chỉ tạo thêm lớp kỹ thuật. Trước khi viết SQL, đội dự án phải chốt câu hỏi cần trả lời, mức chi tiết, owner và điều kiện nghiệm thu.
Ví dụ thực tế: Timezone, mã tỉnh và tiền tệ được chuẩn hóa. Ví dụ phải được đối soát bằng dữ liệu thật và một báo cáo đang được nghiệp vụ sử dụng; nếu chỉ kiểm tra vài dòng mẫu, sai lệch tổng hợp có thể không xuất hiện.
Rủi ro cần tránh: Mỗi mart có mapping riêng. Cách kiểm soát là ghi quyết định vào tài liệu mô hình, tạo test tự động và chỉ phát hành khi owner nghiệp vụ xác nhận kết quả.
6. Freshness
Độ tươi phải theo SLA của quyết định. Trong dự án thực tế, bước này cần được xử lý đồng thời ở ba lớp: định nghĩa nghiệp vụ, thiết kế dữ liệu và cơ chế vận hành. Thiếu một lớp, giải pháp có thể đúng hôm nay nhưng sai khi nguồn hoặc quy trình thay đổi.
Tồn kho dưới 15 phút, tài chính T+1. Nhóm dữ liệu nên lưu truy vấn đối soát, dữ liệu đầu vào và kết quả mong đợi để biến ví dụ thành regression test. Khi logic được sửa, test cho biết thay đổi nào là chủ ý và thay đổi nào là lỗi.
Pipeline chạy xong nhưng dữ liệu nguồn dừng từ hôm trước. Vì vậy, không nên đánh giá riêng bằng tốc độ truy vấn. Khả năng giải thích, truy vết, phân quyền và chạy lại cũng phải nằm trong tiêu chí nghiệm thu.
7. Volume anomaly
Một cách tiếp cận an toàn với volume anomaly là bắt đầu từ tình huống cụ thể. So khối lượng với lịch sử và lịch kinh doanh. Sau đó mới chọn cấu trúc bảng, chiến lược xử lý và công nghệ phù hợp.
Tình huống: Số đơn giảm 40% vào ngày thường cần cảnh báo. Từ tình huống này, đội dự án xác định dữ liệu nào là nguồn chuẩn, dữ liệu nào chỉ bổ sung ngữ cảnh và thời điểm nào được xem là hoàn tất.
Điểm kiểm soát: Ngưỡng cố định báo động sai vào Tết. Mỗi lần chạy cần ghi phiên bản mã, khoảng dữ liệu, kết quả test và tài sản phía sau bị ảnh hưởng. Đây là cơ sở để xử lý sự cố mà không phải dò tìm thủ công.
8. Distribution anomaly
Theo dõi phân phối giúp phát hiện lỗi không làm đổi row count. Câu hỏi quan trọng không phải “công cụ có hỗ trợ hay không”, mà là doanh nghiệp muốn bảo toàn ý nghĩa nào của dữ liệu khi thời gian, khối lượng và số lượng người dùng tăng lên.
Doanh thu vẫn đủ dòng nhưng 95% amount bằng 0. Khi đưa vào production, nhóm nên đo cả độ đúng, độ tươi, chi phí và thời gian phục hồi. Một thiết kế tốt phải giữ kết quả ổn định khi chạy lại cùng dữ liệu và phải nêu rõ hành vi với dữ liệu đến muộn.
Chỉ kiểm tra số lượng. Nếu chưa thể loại bỏ rủi ro, hệ thống cần ít nhất phát hiện, cách ly và cảnh báo có owner. Không nên âm thầm thay giá trị lỗi bằng 0 hoặc bỏ bản ghi vì dashboard vẫn có thể hiển thị “đẹp” nhưng dẫn tới quyết định sai.
9. Reconciliation
Đối soát tổng và checksum giữa nguồn với đích. Đây là điểm thường quyết định kiểm thử dữ liệu có tạo được một mô hình dễ dùng hay chỉ tạo thêm lớp kỹ thuật. Trước khi viết SQL, đội dự án phải chốt câu hỏi cần trả lời, mức chi tiết, owner và điều kiện nghiệm thu.
Ví dụ thực tế: Gross, discount, tax, refund theo ngày. Ví dụ phải được đối soát bằng dữ liệu thật và một báo cáo đang được nghiệp vụ sử dụng; nếu chỉ kiểm tra vài dòng mẫu, sai lệch tổng hợp có thể không xuất hiện.
Rủi ro cần tránh: Chỉ so count. Cách kiểm soát là ghi quyết định vào tài liệu mô hình, tạo test tự động và chỉ phát hành khi owner nghiệp vụ xác nhận kết quả.
10. Business rule test
KPI cần test theo định nghĩa đã phê duyệt. Trong dự án thực tế, bước này cần được xử lý đồng thời ở ba lớp: định nghĩa nghiệp vụ, thiết kế dữ liệu và cơ chế vận hành. Thiếu một lớp, giải pháp có thể đúng hôm nay nhưng sai khi nguồn hoặc quy trình thay đổi.
Net revenue loại hủy và trừ hoàn trả. Nhóm dữ liệu nên lưu truy vấn đối soát, dữ liệu đầu vào và kết quả mong đợi để biến ví dụ thành regression test. Khi logic được sửa, test cho biết thay đổi nào là chủ ý và thay đổi nào là lỗi.
Data Engineer tự đoán quy tắc. Vì vậy, không nên đánh giá riêng bằng tốc độ truy vấn. Khả năng giải thích, truy vết, phân quyền và chạy lại cũng phải nằm trong tiêu chí nghiệm thu.
11. Schema test
Một cách tiếp cận an toàn với schema test là bắt đầu từ tình huống cụ thể. Phát hiện thêm, xóa, đổi kiểu và đổi nullability. Sau đó mới chọn cấu trúc bảng, chiến lược xử lý và công nghệ phù hợp.
Tình huống: order_id từ integer sang string phải review. Từ tình huống này, đội dự án xác định dữ liệu nào là nguồn chuẩn, dữ liệu nào chỉ bổ sung ngữ cảnh và thời điểm nào được xem là hoàn tất.
Điểm kiểm soát: Tự động chấp nhận mọi thay đổi. Mỗi lần chạy cần ghi phiên bản mã, khoảng dữ liệu, kết quả test và tài sản phía sau bị ảnh hưởng. Đây là cơ sở để xử lý sự cố mà không phải dò tìm thủ công.
12. Cross-table test
Một số quy tắc cần so nhiều bảng. Câu hỏi quan trọng không phải “công cụ có hỗ trợ hay không”, mà là doanh nghiệp muốn bảo toàn ý nghĩa nào của dữ liệu khi thời gian, khối lượng và số lượng người dùng tăng lên.
Tổng payment không vượt order trừ trường hợp hoàn ứng. Khi đưa vào production, nhóm nên đo cả độ đúng, độ tươi, chi phí và thời gian phục hồi. Một thiết kế tốt phải giữ kết quả ổn định khi chạy lại cùng dữ liệu và phải nêu rõ hành vi với dữ liệu đến muộn.
Kiểm thử từng bảng độc lập bỏ mâu thuẫn. Nếu chưa thể loại bỏ rủi ro, hệ thống cần ít nhất phát hiện, cách ly và cảnh báo có owner. Không nên âm thầm thay giá trị lỗi bằng 0 hoặc bỏ bản ghi vì dashboard vẫn có thể hiển thị “đẹp” nhưng dẫn tới quyết định sai.
PHẦN III — KIỂM THỬ THEO TỪNG LỚP
1. Test ở raw
Raw kiểm tra delivery, schema, checksum và metadata. Đây là điểm thường quyết định Data Warehouse có tạo được một mô hình dễ dùng hay chỉ tạo thêm lớp kỹ thuật. Trước khi viết SQL, đội dự án phải chốt câu hỏi cần trả lời, mức chi tiết, owner và điều kiện nghiệm thu.
Ví dụ thực tế: File có source, received_at và row_count. Ví dụ phải được đối soát bằng dữ liệu thật và một báo cáo đang được nghiệp vụ sử dụng; nếu chỉ kiểm tra vài dòng mẫu, sai lệch tổng hợp có thể không xuất hiện.
Rủi ro cần tránh: Raw được xem như bãi chứa không kiểm soát. Cách kiểm soát là ghi quyết định vào tài liệu mô hình, tạo test tự động và chỉ phát hành khi owner nghiệp vụ xác nhận kết quả.
2. Test ở staging
Staging kiểm tra parse, mapping và duplicate kỹ thuật. Trong dự án thực tế, bước này cần được xử lý đồng thời ở ba lớp: định nghĩa nghiệp vụ, thiết kế dữ liệu và cơ chế vận hành. Thiếu một lớp, giải pháp có thể đúng hôm nay nhưng sai khi nguồn hoặc quy trình thay đổi.
Ngày lỗi vào quarantine. Nhóm dữ liệu nên lưu truy vấn đối soát, dữ liệu đầu vào và kết quả mong đợi để biến ví dụ thành regression test. Khi logic được sửa, test cho biết thay đổi nào là chủ ý và thay đổi nào là lỗi.
Thay lỗi bằng null im lặng. Vì vậy, không nên đánh giá riêng bằng tốc độ truy vấn. Khả năng giải thích, truy vết, phân quyền và chạy lại cũng phải nằm trong tiêu chí nghiệm thu.
3. Test ở gold
Một cách tiếp cận an toàn với test ở gold là bắt đầu từ tình huống cụ thể. Gold kiểm tra khóa, quan hệ, KPI và đối soát. Sau đó mới chọn cấu trúc bảng, chiến lược xử lý và công nghệ phù hợp.
Tình huống: fact_sales cân với nguồn theo ngày và kênh. Từ tình huống này, đội dự án xác định dữ liệu nào là nguồn chuẩn, dữ liệu nào chỉ bổ sung ngữ cảnh và thời điểm nào được xem là hoàn tất.
Điểm kiểm soát: Chỉ test SQL chạy thành công. Mỗi lần chạy cần ghi phiên bản mã, khoảng dữ liệu, kết quả test và tài sản phía sau bị ảnh hưởng. Đây là cơ sở để xử lý sự cố mà không phải dò tìm thủ công.
4. Severity và hành động
Critical chặn publish; warning cho phép nhưng phải có owner. Câu hỏi quan trọng không phải “công cụ có hỗ trợ hay không”, mà là doanh nghiệp muốn bảo toàn ý nghĩa nào của dữ liệu khi thời gian, khối lượng và số lượng người dùng tăng lên.
Thiếu 20% hóa đơn chặn, thiếu mô tả sản phẩm cảnh báo. Khi đưa vào production, nhóm nên đo cả độ đúng, độ tươi, chi phí và thời gian phục hồi. Một thiết kế tốt phải giữ kết quả ổn định khi chạy lại cùng dữ liệu và phải nêu rõ hành vi với dữ liệu đến muộn.
Mọi lỗi đều chặn hoặc mọi lỗi đều bỏ qua. Nếu chưa thể loại bỏ rủi ro, hệ thống cần ít nhất phát hiện, cách ly và cảnh báo có owner. Không nên âm thầm thay giá trị lỗi bằng 0 hoặc bỏ bản ghi vì dashboard vẫn có thể hiển thị “đẹp” nhưng dẫn tới quyết định sai.
5. Quarantine và reprocessing
Bản ghi lỗi cần lý do, owner và đường quay lại. Đây là điểm thường quyết định Data Warehouse có tạo được một mô hình dễ dùng hay chỉ tạo thêm lớp kỹ thuật. Trước khi viết SQL, đội dự án phải chốt câu hỏi cần trả lời, mức chi tiết, owner và điều kiện nghiệm thu.
Ví dụ thực tế: Sau khi sửa mapping, batch lỗi được chạy lại idempotent. Ví dụ phải được đối soát bằng dữ liệu thật và một báo cáo đang được nghiệp vụ sử dụng; nếu chỉ kiểm tra vài dòng mẫu, sai lệch tổng hợp có thể không xuất hiện.
Rủi ro cần tránh: Quarantine trở thành nghĩa địa dữ liệu. Cách kiểm soát là ghi quyết định vào tài liệu mô hình, tạo test tự động và chỉ phát hành khi owner nghiệp vụ xác nhận kết quả.
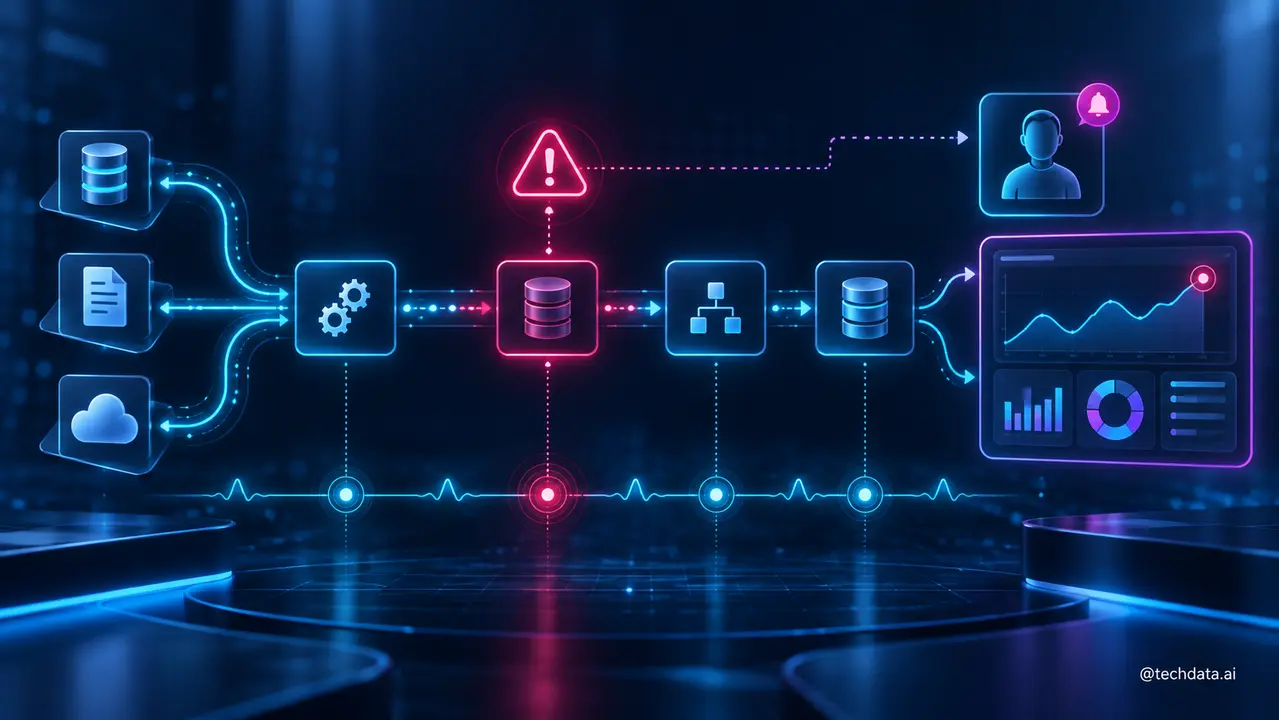
PHẦN IV — INCIDENT VÀ DATA CONTRACT
1. Incident management
Runbook phải nêu phát hiện, cô lập, thông báo, sửa và hậu kiểm. Đây là điểm thường quyết định vận hành chất lượng dữ liệu có tạo được một mô hình dễ dùng hay chỉ tạo thêm lớp kỹ thuật. Trước khi viết SQL, đội dự án phải chốt câu hỏi cần trả lời, mức chi tiết, owner và điều kiện nghiệm thu.
Ví dụ thực tế: Dashboard đánh dấu kỳ bị ảnh hưởng. Ví dụ phải được đối soát bằng dữ liệu thật và một báo cáo đang được nghiệp vụ sử dụng; nếu chỉ kiểm tra vài dòng mẫu, sai lệch tổng hợp có thể không xuất hiện.
Rủi ro cần tránh: Sửa số âm thầm khiến người dùng mất niềm tin. Cách kiểm soát là ghi quyết định vào tài liệu mô hình, tạo test tự động và chỉ phát hành khi owner nghiệp vụ xác nhận kết quả.
2. Root cause analysis
Tìm nguyên nhân hệ thống thay vì chỉ vá bản ghi. Trong dự án thực tế, bước này cần được xử lý đồng thời ở ba lớp: định nghĩa nghiệp vụ, thiết kế dữ liệu và cơ chế vận hành. Thiếu một lớp, giải pháp có thể đúng hôm nay nhưng sai khi nguồn hoặc quy trình thay đổi.
Duplicate do retry không idempotent được sửa ở pipeline. Nhóm dữ liệu nên lưu truy vấn đối soát, dữ liệu đầu vào và kết quả mong đợi để biến ví dụ thành regression test. Khi logic được sửa, test cho biết thay đổi nào là chủ ý và thay đổi nào là lỗi.
Xóa dòng trùng mỗi ngày. Vì vậy, không nên đánh giá riêng bằng tốc độ truy vấn. Khả năng giải thích, truy vết, phân quyền và chạy lại cũng phải nằm trong tiêu chí nghiệm thu.
3. Data contract
Một cách tiếp cận an toàn với data contract là bắt đầu từ tình huống cụ thể. Nguồn cam kết schema, semantics, SLA và thông báo thay đổi. Sau đó mới chọn cấu trúc bảng, chiến lược xử lý và công nghệ phù hợp.
Tình huống: CRM báo trước khi đổi lifecycle_stage. Từ tình huống này, đội dự án xác định dữ liệu nào là nguồn chuẩn, dữ liệu nào chỉ bổ sung ngữ cảnh và thời điểm nào được xem là hoàn tất.
Điểm kiểm soát: Contract không gắn test. Mỗi lần chạy cần ghi phiên bản mã, khoảng dữ liệu, kết quả test và tài sản phía sau bị ảnh hưởng. Đây là cơ sở để xử lý sự cố mà không phải dò tìm thủ công.
PHẦN V — OBSERVABILITY, TRUST VÀ AI
1. Data observability
Quan sát kết hợp metadata, lineage, test và hành vi. Đây là điểm thường quyết định Data Quality có tạo được một mô hình dễ dùng hay chỉ tạo thêm lớp kỹ thuật. Trước khi viết SQL, đội dự án phải chốt câu hỏi cần trả lời, mức chi tiết, owner và điều kiện nghiệm thu.
Ví dụ thực tế: Alert biết bảng lỗi ảnh hưởng dashboard CEO nào. Ví dụ phải được đối soát bằng dữ liệu thật và một báo cáo đang được nghiệp vụ sử dụng; nếu chỉ kiểm tra vài dòng mẫu, sai lệch tổng hợp có thể không xuất hiện.
Rủi ro cần tránh: Mua công cụ nhưng không có owner. Cách kiểm soát là ghi quyết định vào tài liệu mô hình, tạo test tự động và chỉ phát hành khi owner nghiệp vụ xác nhận kết quả.
2. Trust score và case AI
Trust score nên tổng hợp freshness, test, incident và mức chứng nhận theo data product. Trong dự án thực tế, bước này cần được xử lý đồng thời ở ba lớp: định nghĩa nghiệp vụ, thiết kế dữ liệu và cơ chế vận hành. Thiếu một lớp, giải pháp có thể đúng hôm nay nhưng sai khi nguồn hoặc quy trình thay đổi.
AI chỉ dùng metric certified và trả lời kèm nguồn, kỳ dữ liệu, bộ lọc. Nhóm dữ liệu nên lưu truy vấn đối soát, dữ liệu đầu vào và kết quả mong đợi để biến ví dụ thành regression test. Khi logic được sửa, test cho biết thay đổi nào là chủ ý và thay đổi nào là lỗi.
Một điểm tổng che lỗi critical hoặc AI truy cập raw. Vì vậy, không nên đánh giá riêng bằng tốc độ truy vấn. Khả năng giải thích, truy vết, phân quyền và chạy lại cũng phải nằm trong tiêu chí nghiệm thu.
Kết luận
Chất lượng dữ liệu không đến từ một buổi kiểm tra cuối dự án. Nó được tạo bởi định nghĩa rõ, test đúng lớp, đối soát nghiệp vụ, cảnh báo có owner và quy trình xử lý minh bạch. Khi nền tảng cho biết dữ liệu nào đáng tin, mới đến đâu và được dùng trong phạm vi nào, dashboard và AI mới có cơ sở để hỗ trợ quyết định.
Câu hỏi thường gặp
Bao nhiêu test là đủ?
Không có con số cố định. Ưu tiên test bảo vệ KPI, khóa, quan hệ, độ tươi và rủi ro lớn nhất.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với Data Quality, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
Data Quality tool có tự sửa dữ liệu không?
Công cụ phát hiện và điều phối; sửa đúng vẫn cần quy tắc nghiệp vụ và owner.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với Data Quality, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
Mọi lỗi có nên chặn pipeline?
Không. Severity phải phân biệt critical, warning và informational theo tác động.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với Data Quality, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
Kiểm thử ở nguồn hay trong kho?
Cả hai. Kiểm tra sớm giảm lan truyền; kiểm tra gold bảo vệ KPI sau tích hợp.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với Data Quality, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
Anomaly detection có thay rule test không?
Không. Anomaly tìm bất thường chưa biết; rule test bảo vệ điều kiện đã xác định.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với Data Quality, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
Làm sao đo độ tin cậy?
Kết hợp freshness, test pass rate, incident, reconciliation và mức chứng nhận của data product.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với Data Quality, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
Ai là data owner?
Người nghiệp vụ có quyền xác nhận ý nghĩa, chất lượng và cách sử dụng dữ liệu.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với Data Quality, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
Dashboard sai có cần thông báo không?
Có. Người dùng cần biết phạm vi, thời gian ảnh hưởng và trạng thái khắc phục.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với Data Quality, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
AI có tự phát hiện dữ liệu sai không?
AI có thể hỗ trợ phát hiện mẫu nhưng không thay test xác định, lineage và phê duyệt nghiệp vụ.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với Data Quality, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
Bắt đầu Data Quality từ đâu?
Chọn một KPI quan trọng, vẽ lineage, xác định rủi ro và đặt test tại từng điểm kiểm soát.
Trong thực tế, câu trả lời còn phụ thuộc vào quy mô dữ liệu, SLA, yêu cầu lịch sử, quyền truy cập và năng lực vận hành. Với Data Quality, nên kiểm chứng bằng dữ liệu thật, truy vấn thật và tiêu chí nghiệm thu đã thống nhất; không nên quyết định chỉ từ một sơ đồ hoặc benchmark của nhà cung cấp.
Nguồn tham khảo và cách áp dụng
Google Cloud phân biệt rõ việc job hoàn thành với việc truy vấn được tối ưu và dữ liệu có thể sử dụng. Microsoft mô tả Slowly Changing Dimension như cơ chế giữ thay đổi thuộc tính theo thời gian để bảo toàn báo cáo lịch sử. AWS Well-Architected Machine Learning Lens yêu cầu hệ thống monitoring thu thập dữ liệu, so sánh với baseline, phát hiện vấn đề và gửi cảnh báo. Ba góc nhìn này gặp nhau ở một điểm: chất lượng không phải lần kiểm tra cuối cùng mà là một vòng vận hành liên tục.
Tài liệu tham khảo
- Google Cloud, “Introduction to optimizing query performance”. Quan sát workload và giảm công việc không cần thiết.
- Microsoft Fabric, “Slowly changing dimensions”. Bảo toàn thay đổi để báo cáo lịch sử chính xác.
- Microsoft Learn, “Slowly Changing Dimension Transformation”. Xử lý changing, historical và inferred members.
- AWS, “Machine Learning Lens — Well-Architected Framework”. Monitoring dữ liệu, drift và cảnh báo sau triển khai.
- Google Cloud, “Manage partition and cluster recommendations”. Dùng insight để cải thiện tổ chức dữ liệu.
TechData.AI - Leading the Future.