



Series Apache Kafka · Bài 3/10. Ở bài 2, ta đã gửi dữ liệu bằng terminal. Bài này chuyển sang hai chương trình Python: producer tạo đơn hàng dưới dạng JSON và consumer nhận, kiểm tra, xử lý rồi ghi nhận tiến độ. Mục tiêu là hiểu đường đi của một event và nhìn thấy kết quả gửi, thay vì chỉ gọi hàm rồi mặc định dữ liệu đã an toàn.
Lab dùng Python 3.10 trở lên, Kafka local của bài 2 và thư viện confluent-kafka. Đây là client Python của Confluent cho Apache Kafka; không cần cài Confluent Platform hoặc dùng dịch vụ trả phí để chạy với broker local. Các chương trình Python chạy trên máy host hoặc trong cùng WSL nơi bạn truy cập được cổng Kafka.
Mục lục
- Chuẩn bị môi trường
- Thiết kế event và serialize JSON
- Viết producer
- Viết consumer
- Chạy và đối chiếu kết quả
- Dừng, chạy lại và commit offset
- Xử lý lỗi thường gặp
- Bài tập và gợi ý
- Tài liệu tham khảo
1. Chuẩn bị môi trường Python và topic riêng
Hãy giữ Kafka của bài 2 đang chạy. Tạo topic orders_python riêng để các dòng text thử nghiệm của bài trước không làm hỏng bước đọc JSON. Ba partition chuẩn bị cho bài 4; replication factor bằng 1 vì chỉ có một broker. Lệnh dưới đây chạy từ terminal có quyền dùng Docker.
docker exec kafka-lab /opt/kafka/bin/kafka-topics.sh --bootstrap-server localhost:9092 --create --topic orders_python --partitions 3 --replication-factor 1Nếu topic đã tồn tại, dùng --describe để kiểm tra rồi tiếp tục, không cần xóa dữ liệu. Tạo thư mục dự án Python riêng và môi trường ảo:
mkdir -p ~/kafka-python-lab
cd ~/kafka-python-lab
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install "confluent-kafka==2.16.1"
Môi trường ảo giúp dự án có bộ thư viện riêng. python -m pip buộc pip đi cùng interpreter đang dùng, giảm lỗi cài bằng một Python nhưng chạy bằng Python khác. Trên Windows PowerShell, dùng py -m venv .venv rồi .venv\Scripts\Activate.ps1. Nếu đang dùng WSL, giữ toàn bộ lệnh và file trong WSL.
Nếu pip cần biên dịch từ source trên kiến trúc không có wheel, hãy xem yêu cầu librdkafka trong hướng dẫn chính thức. Không đổi tùy tiện sang thư viện kafka-python: hai package có API và tên cấu hình khác nhau. Kiểm tra bằng lệnh sau rồi lưu dependencies để tái lập môi trường:
python -c "import confluent_kafka; print(confluent_kafka.version())"
python -m pip freeze > requirements.txt
2. Thiết kế event: dict, JSON và bytes
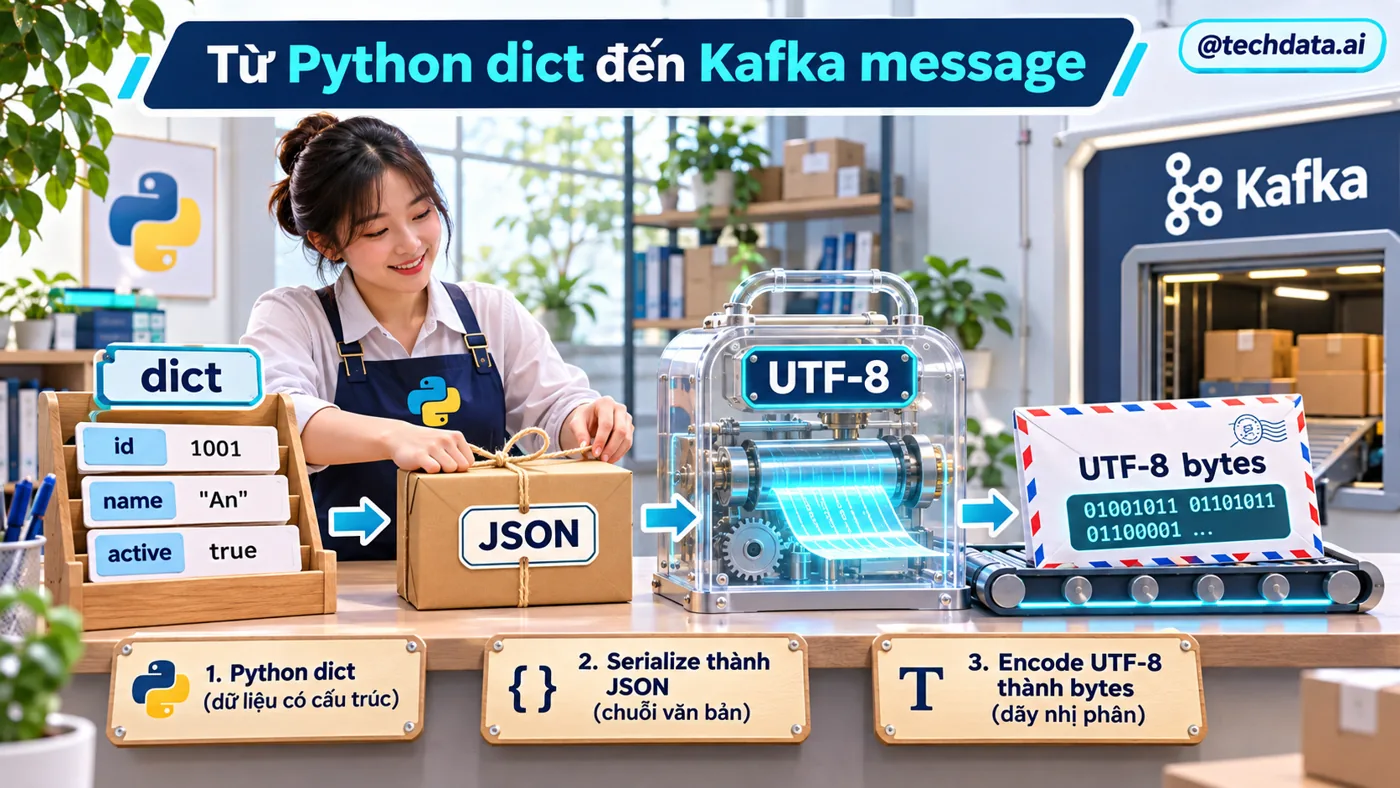
Python dict là đối tượng trong bộ nhớ chương trình. JSON là cách biểu diễn dữ liệu bằng văn bản để ứng dụng khác hiểu. Kafka nhận key và value dưới dạng bytes; broker không tự kiểm tra nội dung JSON hay các trường nghiệp vụ. Vì vậy producer cần serialize và encode, còn consumer làm ngược lại: decode bytes thành text rồi parse JSON thành dict.
import json

order = {"order_id": "ORD-1001", "customer_name": "Nguyễn An", "amount_vnd": 850000}
text = json.dumps(order, ensure_ascii=False)
payload = text.encode("utf-8")
restored = json.loads(payload.decode("utf-8"))
print(restored["customer_name"])
ensure_ascii=False giữ tiếng Việt dễ đọc trong JSON text; UTF-8 quyết định cách ký tự thành bytes. Tên amount_vnd ghi rõ đơn vị tiền. Dùng số nguyên đồng trong ví dụ để tránh cộng tiền bằng số thực gần đúng. Cặp dumps/loads xử lý cấu trúc, còn encode/decode xử lý mã hóa ký tự: chúng là hai bước khác nhau.
Event trong lab có event_id để nhận diện một lần phát, event_type để biết việc đã xảy ra, schema_version để biết cấu trúc và occurred_at để biết thời điểm. order_id là định danh đối tượng nghiệp vụ; một đơn có thể phát nhiều event với nhiều event_id. Key được đặt bằng order_id để các event cùng đơn có cơ sở đi vào cùng partition khi số partition và partitioner ổn định. Key không tự loại bỏ trùng.
3. Viết producer có kiểm tra kết quả gửi
Tạo file producer.py, dán toàn bộ mã sau. Chương trình tạo mười sự kiện, theo dõi callback thành công/thất bại và chờ hàng đợi gửi hết trước khi thoát. UUID tạo event_id mới mỗi lần chạy, nên chạy chương trình hai lần là phát hai đợt event mới.
import json
import os
import uuid
from datetime import datetime, timezone
from confluent_kafka import Producer

TOPIC = "orders_python"
failures = []
delivered = 0

def on_delivery(err, msg):
    global delivered
    if err is not None:
        failures.append(str(err))
        print("DELIVERY FAILED:", err)
    else:
        delivered += 1
        print(f"ACK topic={msg.topic()} partition={msg.partition()} offset={msg.offset()}")

producer = Producer({
    "bootstrap.servers": os.getenv("KAFKA_BOOTSTRAP", "localhost:9092"),
    "client.id": "techdata-python-producer",
    "enable.idempotence": True,
    "acks": "all",
    "delivery.timeout.ms": 30000,
})

for number in range(1, 11):
    event = {
        "event_id": str(uuid.uuid4()),
        "event_type": "order.created",
        "schema_version": 1,
        "occurred_at": datetime.now(timezone.utc).isoformat(),
        "order_id": f"PY-{number:04d}",
        "customer_name": "Nguyễn An",
        "amount_vnd": number * 100000,
    }
    payload = json.dumps(event, ensure_ascii=False).encode("utf-8")
    while True:
        try:
            producer.produce(
                TOPIC,
                key=event["order_id"].encode("utf-8"),
                value=payload,
                on_delivery=on_delivery,
            )
            break
        except BufferError:
            producer.poll(0.5)
    producer.poll(0)

remaining = producer.flush(35)
if remaining or failures:
    raise SystemExit(f"Send failed: pending={remaining}, errors={failures}")
print(f"Delivered {delivered}/10 events")
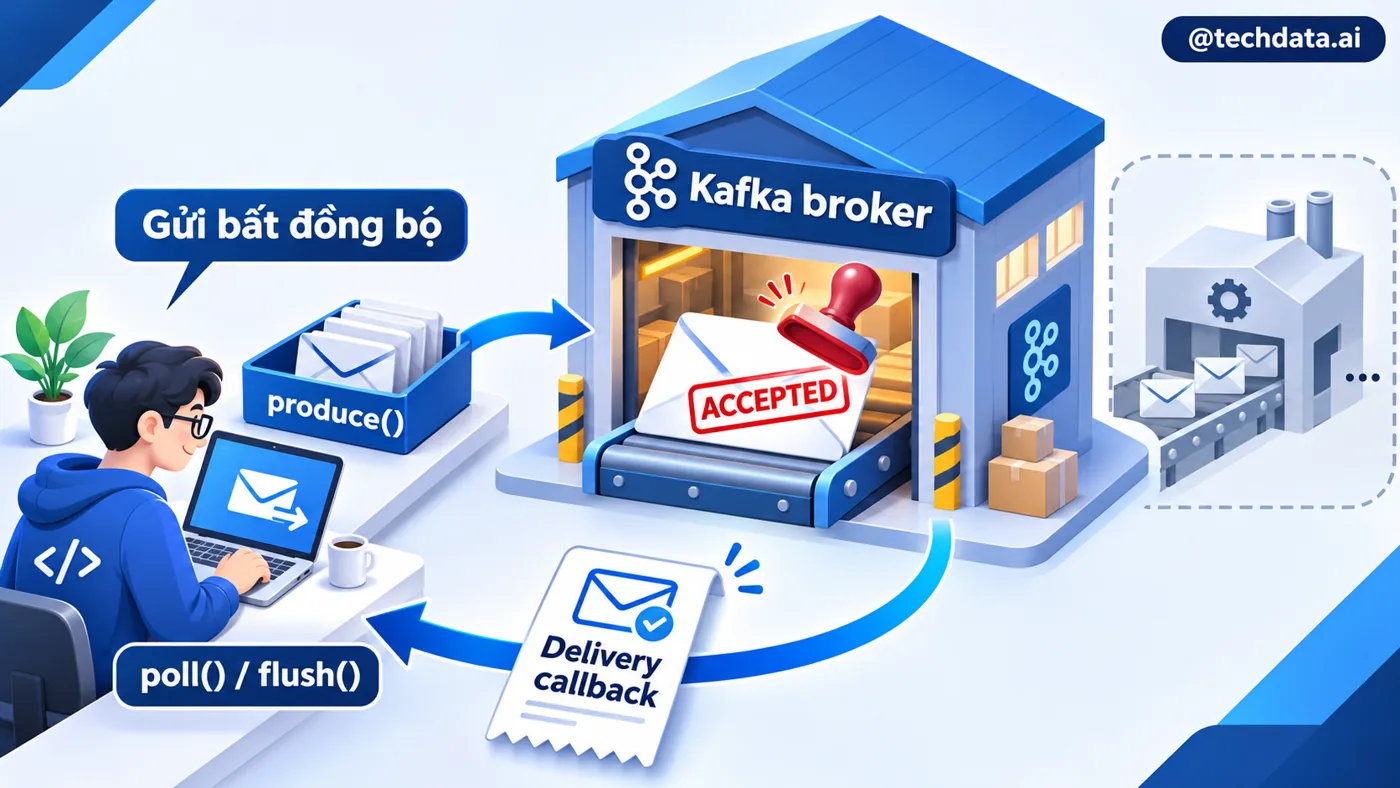
produce() thường đưa message vào hàng đợi của client để gửi bất đồng bộ. Hàm trả về không đồng nghĩa broker đã xác nhận. on_delivery nhận kết quả sau đó; poll() và flush() phục vụ callback. poll(0) không chờ nhưng cho client cơ hội chạy callback đã sẵn sàng. flush(35) chờ tối đa 35 giây và trả số message còn chưa hoàn tất. Ta kiểm tra cả số còn lại lẫn lỗi callback vì hàng đợi rỗng vẫn có thể chứa những lần gửi đã thất bại.
BufferError báo hàng đợi cục bộ đầy. Vòng lặp gọi poll(0.5) rồi thử lại cùng event; nó không tạo UUID mới khi chỉ thử enqueue lại. Trong hệ thống thật cần thêm giới hạn thời gian, chỉ số theo dõi và cơ chế dừng ứng dụng. Producer idempotence hạn chế bản ghi trùng do retry của producer trong phạm vi guarantee của Kafka; không làm hai lần chạy độc lập tự trở thành một event duy nhất.
acks=all yêu cầu xác nhận theo tập replica đồng bộ và cấu hình broker. Với lab chỉ một broker, điều này không tạo thêm bản sao và không bảo vệ khi mất toàn bộ ổ đĩa. Delivery callback thành công xác nhận Kafka tiếp nhận theo cấu hình; nó chưa chứng minh consumer đã cập nhật database hoặc gửi email.
4. Viết consumer: xử lý trước, commit sau
Tạo consumer.py trong cùng thư mục. Consumer dùng group.id cố định để nhớ tiến độ qua lần khởi động. Chúng ta tắt auto commit và commit đồng bộ sau khi hàm process xử lý thành công. Nếu record không hợp lệ hoặc xử lý thất bại, chương trình dừng và không commit record đó, giúp bạn nhìn thấy lỗi thay vì âm thầm bỏ qua.
import json
import os
from confluent_kafka import Consumer, KafkaException

consumer = Consumer({
    "bootstrap.servers": os.getenv("KAFKA_BOOTSTRAP", "localhost:9092"),
    "group.id": os.getenv("GROUP_ID", "techdata-python-v1"),
    "client.id": "techdata-python-consumer",
    "auto.offset.reset": "earliest",
    "enable.auto.commit": False,
})

def process(event):
    if event.get("event_type") != "order.created":
        raise ValueError("Unsupported event_type")
    if not isinstance(event.get("event_id"), str) or not event["event_id"]:
        raise ValueError("Missing event_id")
    if not isinstance(event.get("order_id"), str) or not event["order_id"]:
        raise ValueError("Missing order_id")
    amount = event.get("amount_vnd")
    if type(amount) is not int or amount < 0:
        raise ValueError("amount_vnd must be a non-negative integer")
    print(f"PROCESS {event['order_id']} amount={amount:,} VND", flush=True)

consumer.subscribe(["orders_python"])
try:
    while True:
        msg = consumer.poll(1.0)
        if msg is None:
            continue
        if msg.error():
            raise KafkaException(msg.error())
        if msg.value() is None:
            raise ValueError("Tombstone not supported in this lab")
        event = json.loads(msg.value().decode("utf-8"))
        if not isinstance(event, dict):
            raise ValueError("Expected a JSON object")
        process(event)
        consumer.commit(message=msg, asynchronous=False)
        print(f"COMMIT partition={msg.partition()} next_offset={msg.offset()+1}", flush=True)
except KeyboardInterrupt:
    print("Stopping consumer")
finally:
    consumer.close()
subscribe đăng ký topic, không tải toàn bộ dữ liệu ngay. poll(1.0) chờ tối đa khoảng một giây cho một record hoặc sự kiện client; None nghĩa là lần poll này chưa có message, không phải lỗi. msg.error() kiểm tra lỗi Kafka trước khi đọc value. Với JSON hợp lệ, json.loads vẫn có thể trả list, số hoặc chuỗi; kiểm tra dict giúp hợp đồng dữ liệu rõ ràng.
process hiện chỉ kiểm tra và in một dòng để tập trung vào giao tiếp Kafka. Ở bài 5, xử lý sẽ là transaction ghi PostgreSQL. Chỉ khi process thành công mới commit message. API commit(message=msg) ghi offset kế tiếp: xử lý offset 2 thì commit 3. Consumer cần biết lần sau bắt đầu ở đâu; vì vậy commit không ghi lại nội dung đơn hàng và không xóa record.
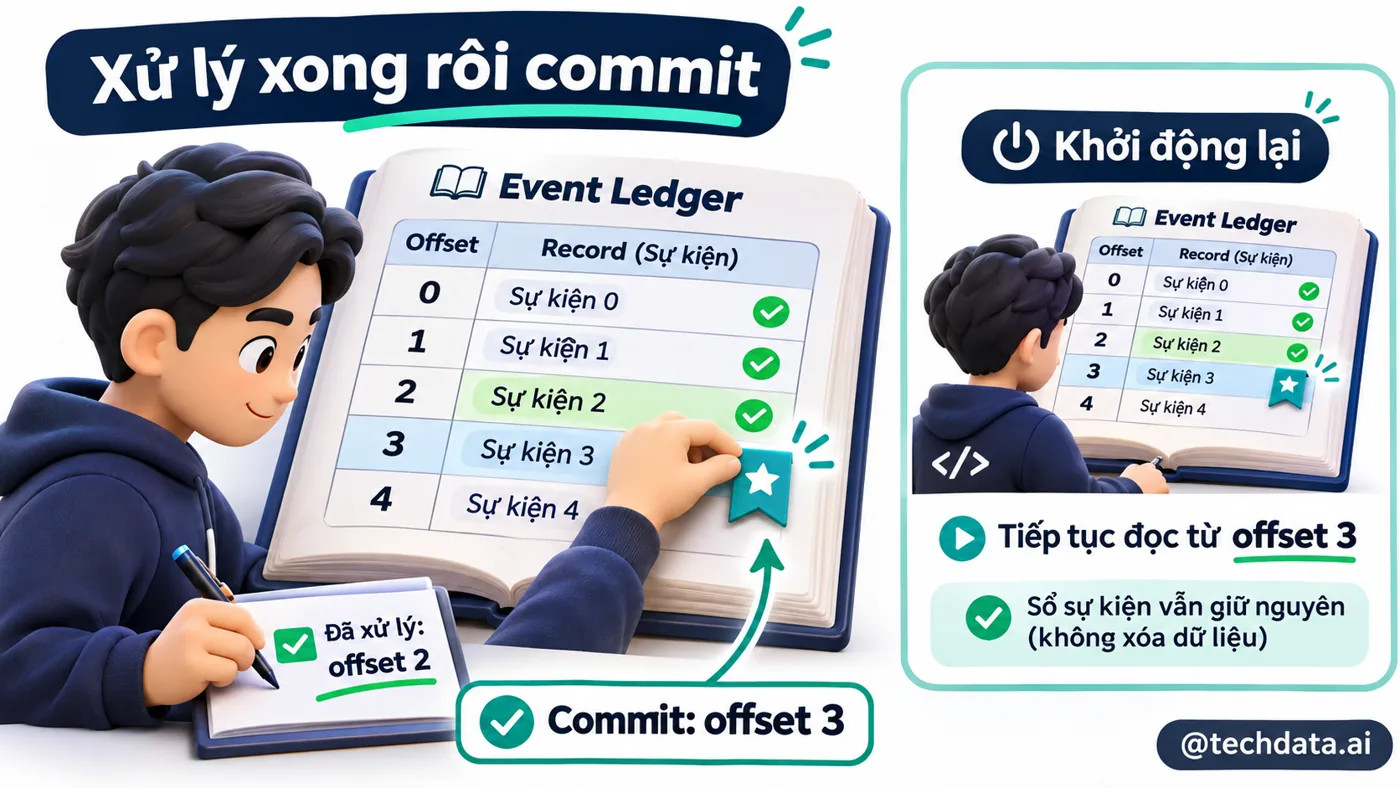
Ta xử lý tuần tự rồi commit từng record nên không vượt qua một record thất bại trong cùng partition. Nếu đổi sang nhiều thread hoặc commit theo batch, phải quản lý các offset đã hoàn tất liên tục của từng partition. Không được lấy offset lớn nhất của một worker rồi commit khi các record trước vẫn đang xử lý.
5. Chạy lab và đối chiếu kết quả
Mở hai terminal, cùng kích hoạt môi trường ảo. Terminal A chạy consumer trước; terminal B chạy producer sau. Consumer có thể mất vài giây tham gia group trước khi nhận assignment.
source .venv/bin/activate
python consumer.py
source .venv/bin/activate
python producer.pyProducer phải báo Delivered 10/10 events nếu mọi callback thành công. Mỗi ACK cho biết topic, partition và offset; giá trị cụ thể phụ thuộc dữ liệu đã có. Consumer in mười PROCESS tương ứng các order_id PY-0001 đến PY-0010 ở lần chạy đầu với topic mới, rồi các COMMIT. Không yêu cầu mười dòng xuất hiện theo thứ tự số đơn toàn cục, vì topic có ba partition.
Bạn có thể cộng amount_vnd của mười event: 100.000 nhân tổng từ 1 đến 10 bằng 5.500.000 đồng. Đây là tổng dữ liệu gửi của một lần chạy, không phải phép tổng hợp lưu bền trong consumer. Nếu chạy producer thêm lần nữa, bạn tạo mười event_id mới và có thể thấy thêm mười PROCESS.
6. Quan sát khi dừng và chạy lại
Dừng consumer bằng Ctrl+C rồi chạy lại cùng group.id. Khi commit trước đó thành công, consumer tiếp tục sau các offset đã lưu và chờ dữ liệu mới; earliest không bắt nó đọc lại từ đầu trong mỗi lần khởi động. auto.offset.reset chỉ được dùng khi group chưa có offset hợp lệ, hoặc offset cũ không còn khả dụng theo chính sách reset.
Để đọc lại dữ liệu còn lưu mà không thay đổi group cũ, dùng một group lab mới. Chạy trên Bash:
GROUP_ID=techdata-python-replay-v1 python consumer.pyGroup mới có tiến độ riêng nên có thể đọc lại mười event. Nếu tên group replay đã được dùng và commit, hãy chọn một tên mới. Hai group khác nhau đều có thể đọc cùng luồng; hai consumer cùng group sẽ chia partition. Bài 4 sẽ mô phỏng cụ thể việc này trên 100.000 đơn hàng.
Nếu chương trình đã hoàn thành tác dụng phụ nhưng chết trước commit, record có thể được giao lại. Đây là cửa sổ gây xử lý lặp trong mô hình at-least-once. Commit sau process giúp tránh bỏ qua dữ liệu chưa xử lý, nhưng không tự ngăn trùng nghiệp vụ. Khi ghi database cần event_id duy nhất và transaction phù hợp. Không tuyên bố exactly-once chỉ vì đã tắt auto commit.
7. Tìm lỗi theo đúng lớp
ModuleNotFoundError thường do môi trường ảo chưa kích hoạt hoặc pip và python khác nhau. Broker transport failure thường liên quan Kafka chưa chạy, cổng hoặc advertised listeners. JSONDecodeError nghĩa là bytes đã tới consumer nhưng nội dung không phải JSON hợp lệ. Ba nhóm lỗi này cần ba cách sửa khác nhau: không cài lại thư viện để chữa JSON sai hoặc đổi group.id để chữa địa chỉ broker.
Nếu consumer không in dữ liệu, kiểm tra producer có ACK không, topic có đúng orders_python không, group đã đọc hết chưa và có consumer khác cùng group đang giữ partition không. Dùng lệnh describe group để nhìn tiến độ:
docker exec kafka-lab /opt/kafka/bin/kafka-consumer-groups.sh --bootstrap-server localhost:9092 --describe --group techdata-python-v1CURRENT-OFFSET là tiến độ đã commit; LOG-END-OFFSET là vị trí cuối log theo partition; LAG thể hiện chênh lệch theo offset. Lag thấp không chứng minh kết quả nghiệp vụ đúng; nó chỉ giúp đánh giá tiến độ đọc. Bài này dừng khi gặp record lỗi để không mất dấu. Bài 8 sẽ xây retry và dead letter topic để xử lý có kiểm soát.
8. Bài tập có gợi ý
Bài 1: thêm trường channel với giá trị web vào producer và kiểm tra consumer in được trường đó. Gợi ý: sửa event trước json.dumps, sau đó đọc event.get("channel") trong process. Không sửa chuỗi bytes bằng thao tác thay thế text thủ công.
Bài 2: cố tình gửi amount_vnd bằng chuỗi "850000". Consumer phải dừng trước commit record lỗi. Sửa producer không làm record sai đã lưu biến mất; hãy dùng topic lab mới để làm lại, hoặc đợi bài 8 để xử lý dữ liệu lỗi có kiểm soát. Không commit vượt record chỉ để terminal hết báo lỗi.
Bài 3: chạy consumer với group mới để replay. Giải thích vì sao dữ liệu vẫn còn sau khi group cũ đọc xong. Đáp án: Kafka giữ dữ liệu theo retention; offset là tiến độ riêng của group. Đọc và lưu trữ là hai vòng đời khác nhau.
Điều kiện hoàn thành: producer xác nhận đủ mười event, consumer hiểu đúng JSON và tiếng Việt, bạn giải thích được key/value, poll/flush và commit vị trí kế tiếp; đồng thời nêu được một tình huống xử lý lặp vẫn có thể xảy ra.
Tài liệu tham khảo
- Confluent Python Client Overview — producer, callback, poll và flush.
- confluent-kafka Python API — cấu hình consumer và commit offset.
- Apache Kafka Design — partition, consumer group và delivery semantics.
- Python JSON Documentation — dumps và loads.
Apache Kafka: Từ cơ bản đến ứng dụng thực tế trong Data Engineering · @techdata.ai
Comments are closed!