


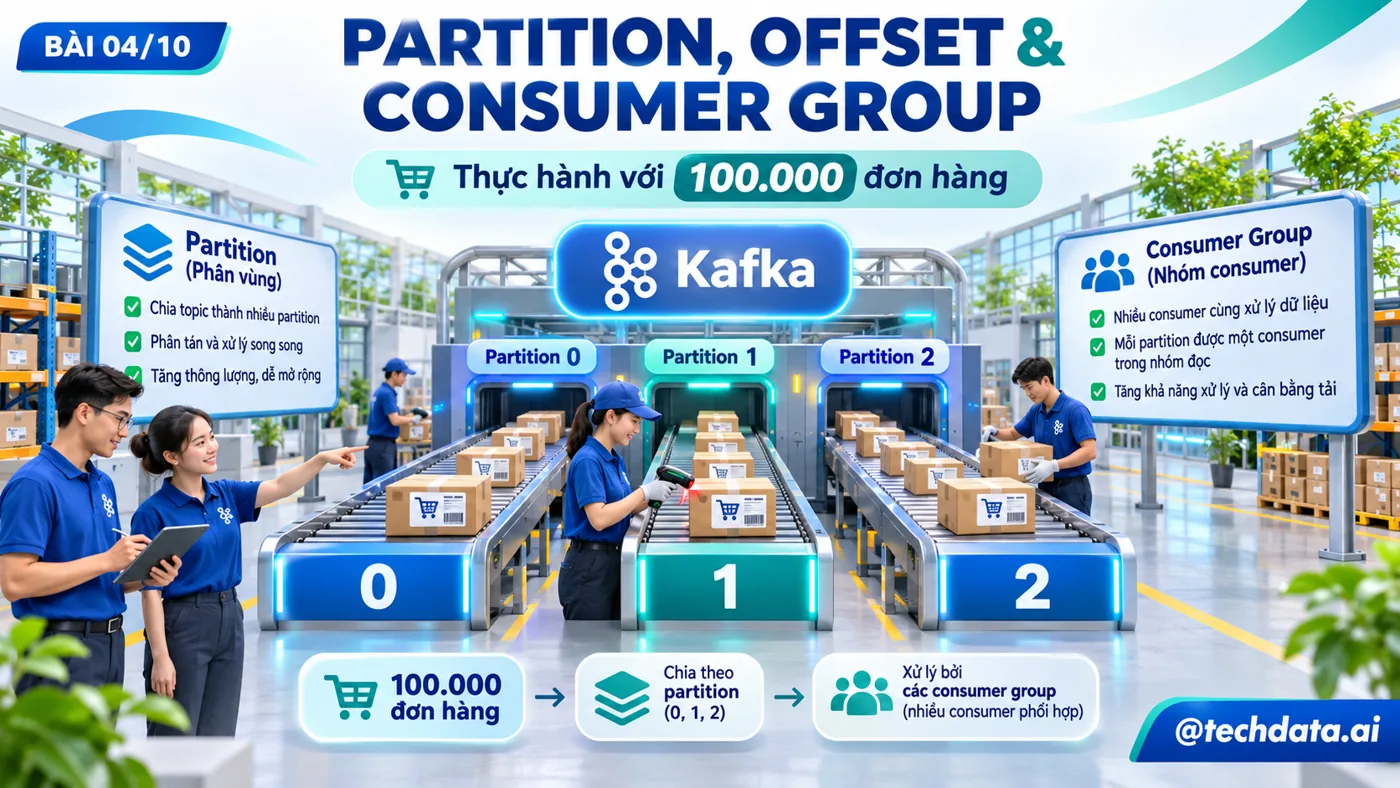

Series Apache Kafka · Bài 4/10. Một consumer đọc được JSON chưa có nghĩa hệ thống đã biết chia tải. Với 100.000 đơn hàng, ba partition và bốn worker, ai đọc phần nào? Khi một worker dừng, công việc được chuyển ra sao? Bài này dùng dữ liệu có thể kiểm đếm để trả lời bằng thí nghiệm.
Bạn cần Kafka local của bài 2 và môi trường confluent-kafka của bài 3. Các chương trình Python chạy trên host và kết nối localhost:9092. Lab dùng topic riêng, không sửa dữ liệu các bài trước. Kết quả thời gian trên laptop không được xem là benchmark production.
Mục lục
- Topic, partition và offset
- Consumer group và key
- Tạo topic riêng
- Sinh 100.000 đơn hàng
- Consumer quan sát assignment
- Thí nghiệm từ một đến bốn worker
- Rebalance và lag
- Đối soát dữ liệu
- Bài tập và lựa chọn partition
- Tài liệu tham khảo
1. Topic, partition và offset là ba khái niệm khác nhau
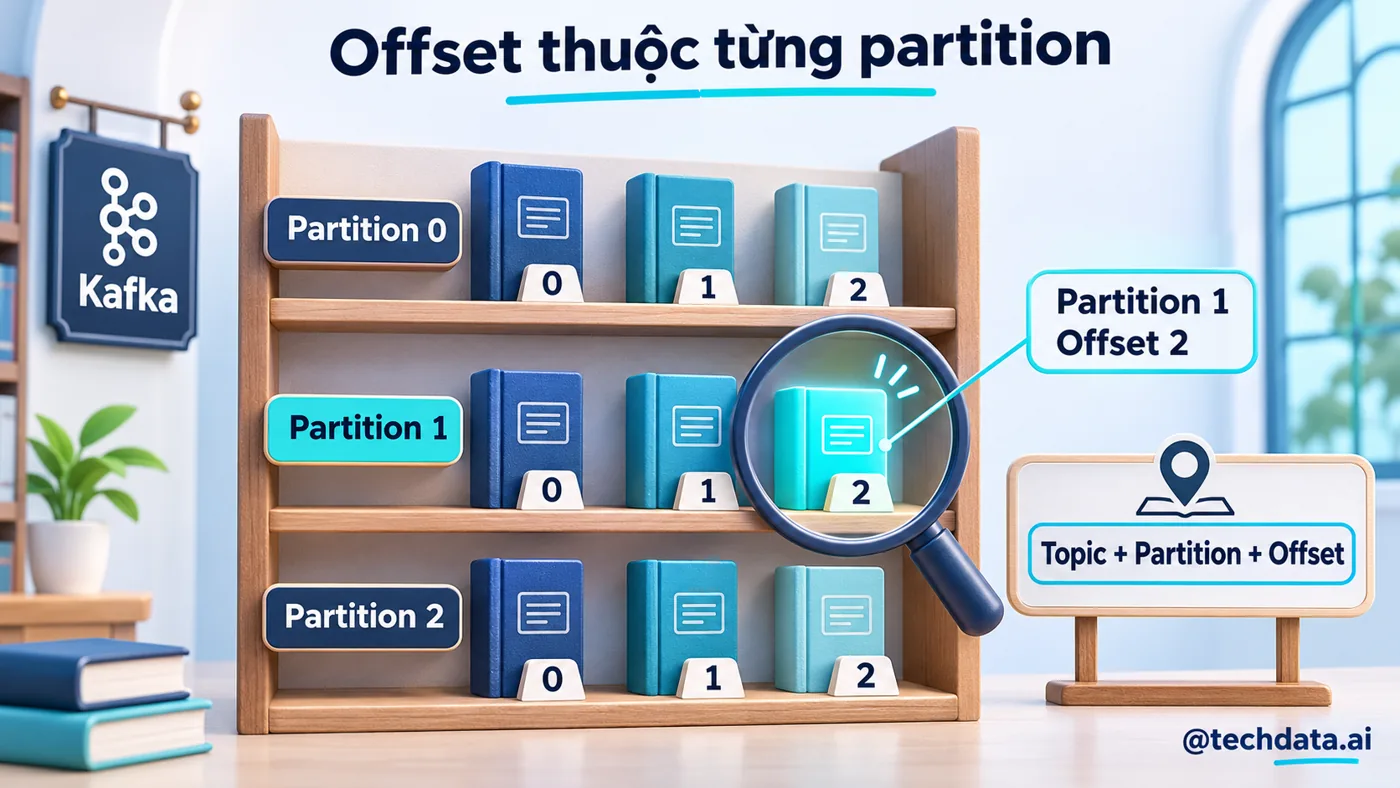
Topic là tên luồng dùng để gom các event cùng chủ đề, ví dụ đơn hàng. Partition là một phần log của topic. Mỗi record được ghi vào một partition và có offset trong partition đó. Offset 15 của partition 0 khác offset 15 của partition 1; cần bộ ba topic, partition và offset để chỉ đúng một vị trí Kafka.
Hình dung topic là thư viện, partition là các kệ và offset là vị trí trên mỗi kệ. Thêm kệ cho phép nhiều người làm việc song song. Tuy nhiên số vị trí trên kệ A không thể dùng để xác định thứ tự đến của sách trên kệ B. Kafka bảo đảm thứ tự trong partition, không tạo một thứ tự toàn cục cho topic nhiều partition.
Partition khác replica. Partition chia dữ liệu, còn replica là bản sao của cùng partition trên broker khác. Ba partition với replication factor 1 trên một broker vẫn chỉ có một nơi phục vụ. Tăng partition không tạo thêm broker và không thay thế replication để chịu lỗi.
2. Consumer group phối hợp và key quyết định phạm vi thứ tự
Trong consumer group truyền thống dùng subscribe của bài này, mỗi partition được giao cho tối đa một consumer trong cùng group ở trạng thái ổn định. Một consumer có thể giữ nhiều partition. Group khác có assignment và offset riêng, nên analytics và kiểm tra gian lận có thể cùng đọc topic mà không lấy mất record của nhau.
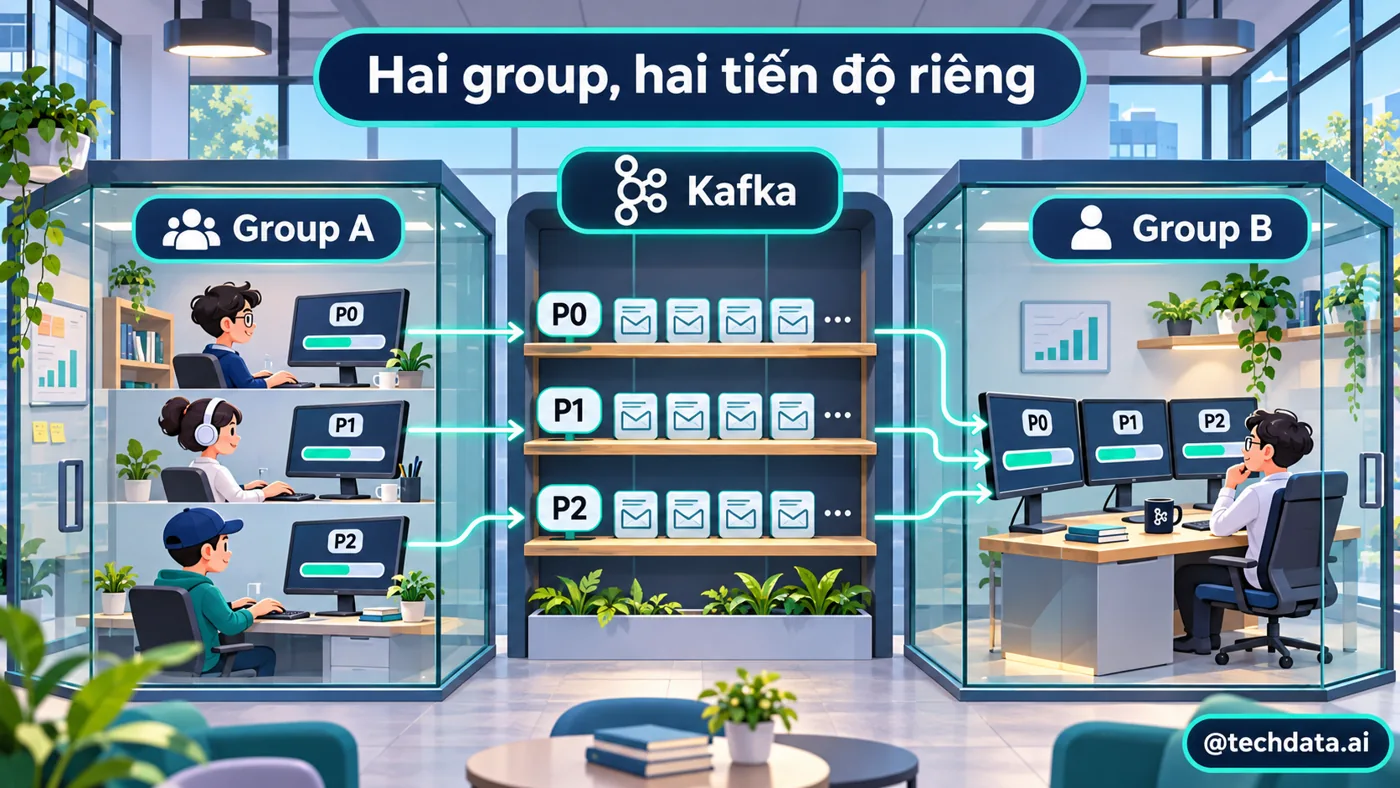
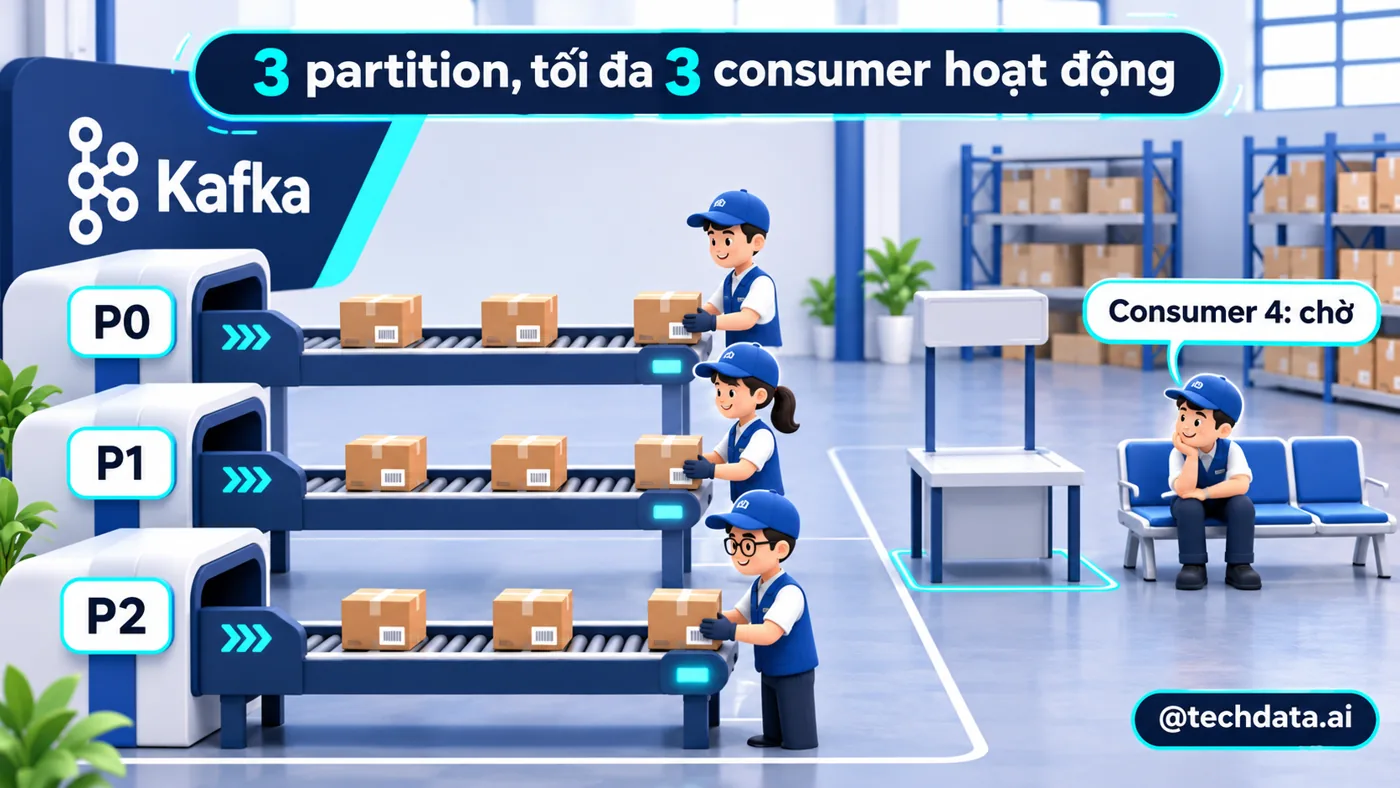
Với ba partition: một consumer giữ cả ba; hai consumer thường chia 2 và 1; ba consumer có thể mỗi người giữ một; bốn consumer thì ít nhất một người không có partition. Kết luận này nói về mô hình consumer group truyền thống, không mô tả Kafka share group.
Key ảnh hưởng cách producer chọn partition. Lab dùng customer_id làm key. Khi partitioner và số partition ổn định, cùng khách có cơ sở đi cùng partition. Nếu cần thứ tự theo đơn thay vì khách, order_id thường là key phù hợp hơn. Key không loại bỏ bản ghi trùng và không bảo đảm hai producer độc lập đã phát event đúng thứ tự nghiệp vụ.
Tăng số partition có thể thay đổi ánh xạ key. Vì vậy, không tăng partition rồi mặc định thứ tự theo key vẫn giữ xuyên suốt lịch sử. Nếu ứng dụng xử lý record bằng nhiều thread, thứ tự hoàn tất còn có thể khác thứ tự đọc; bảo đảm ở broker không tự truyền thành bảo đảm nghiệp vụ.
3. Tạo topic lab riêng và chốt số liệu kỳ vọng
docker exec kafka-lab /opt/kafka/bin/kafka-topics.sh --bootstrap-server localhost:9092 --create --topic orders_100k_v1 --partitions 3 --replication-factor 1
docker exec kafka-lab /opt/kafka/bin/kafka-topics.sh --bootstrap-server localhost:9092 --describe --topic orders_100k_v1
Dùng topic mới chưa có record. Nếu đã dùng tên v1, chọn v2 rồi sửa TOPIC trong cả producer và worker. Không xóa topic đang dùng của dự án khác để làm lại lab. Bài giả định retention chưa loại bỏ dữ liệu trong thời gian thí nghiệm.
Bộ sinh tạo order_id từ ORD-000000 đến ORD-099999, 1.000 customer_id lặp lại và mỗi đơn 100.000 đồng. Kỳ vọng là 100.000 order_id duy nhất, tổng 10.000.000.000 đồng. Đây là số suy ra từ dữ liệu mẫu, không phải con số hiệu năng được đo.
4. Producer gửi 100.000 đơn và đếm ACK theo partition
Tạo produce_100k.py. event_id xác định một event created cho mỗi đơn trong bộ lab. Mỗi key khách xuất hiện 100 lần, nhưng phân bố hash giữa ba partition không nhất thiết đúng một phần ba. Callback cho bạn phân bố thực tế.
import json
from collections import Counter
from confluent_kafka import Producer

TOPIC = "orders_100k_v1"
TOTAL = 100_000
acknowledged = Counter()
errors = []

def delivered(err, msg):
    if err:
        errors.append(str(err))
    else:
        acknowledged[msg.partition()] += 1

p = Producer({
    "bootstrap.servers": "localhost:9092",
    "enable.idempotence": True,
    "acks": "all",
    "delivery.timeout.ms": 60000,
    "linger.ms": 10,
})
for i in range(TOTAL):
    customer = f"C{i % 1000:04d}"
    event = {
        "event_id": f"created-ORD-{i:06d}",
        "event_type": "order.created",
        "order_id": f"ORD-{i:06d}",
        "customer_id": customer,
        "amount_vnd": 100000,
    }
    payload = json.dumps(event).encode("utf-8")
    while True:
        try:
            p.produce(TOPIC, key=customer.encode(), value=payload, on_delivery=delivered)
            break
        except BufferError:
            p.poll(0.1)
    p.poll(0)
    if (i + 1) % 10000 == 0:
        print("Enqueued", i + 1)
remaining = p.flush(65)
print("ACK per partition:", dict(acknowledged))
print("ACK total:", sum(acknowledged.values()))
if remaining or errors or sum(acknowledged.values()) != TOTAL:
    raise SystemExit(f"Failed pending={remaining} errors={errors[:3]}")
Chạy python produce_100k.py đúng một lần trên topic mới. Enqueued cho biết đã đưa vào client queue; ACK total 100000 mới là số delivery callback thành công. Nếu gửi thất bại, không chạy lại mù rồi coi số record log là số đơn duy nhất. Hãy kiểm tra event_id hoặc làm lại bằng topic lab mới.
BufferError báo hàng đợi client đầy nên producer poll rồi thử enqueue lại cùng payload. linger.ms cho phép gom record trong thời gian ngắn, không bảo đảm mọi message có cùng độ trễ. acks=all và idempotence không tạo thêm bản sao khi cluster chỉ có một broker.
5. Worker in assignment và ghi dấu xử lý
Tạo worker.py bằng mã dưới đây. Mỗi tiến trình có WORKER_ID riêng và ghi một file JSON Lines riêng. Độ trễ một mili giây cố ý tạo thời gian quan sát; đây không phải cấu hình tối ưu throughput. Commit theo batch 100 record tránh một lệnh đồng bộ cho từng đơn.
import json
import os
import time
from pathlib import Path
from confluent_kafka import Consumer, KafkaException

TOPIC = "orders_100k_v1"
GROUP = os.getenv("GROUP_ID", "orders-lab-a")
WORKER = os.getenv("WORKER_ID", "w1")
Path("results").mkdir(exist_ok=True)

c = Consumer({
    "bootstrap.servers": "localhost:9092",
    "group.id": GROUP,
    "client.id": WORKER,
    "auto.offset.reset": "earliest",
    "enable.auto.commit": False,
})
def assigned(consumer, partitions):
    print(WORKER, "ASSIGNED", [p.partition for p in partitions], flush=True)
def revoked(consumer, partitions):
    print(WORKER, "REVOKED", [p.partition for p in partitions], flush=True)

c.subscribe([TOPIC], on_assign=assigned, on_revoke=revoked)
count = 0
try:
    with open(f"results/{GROUP}-{WORKER}.jsonl", "a", encoding="utf-8") as out:
        while True:
            msg = c.poll(1.0)
            if msg is None:
                continue
            if msg.error():
                raise KafkaException(msg.error())
            event = json.loads(msg.value().decode("utf-8"))
            time.sleep(0.001)
            row = {"order_id": event["order_id"], "amount_vnd": event["amount_vnd"],
                   "partition": msg.partition(), "offset": msg.offset(), "worker": WORKER}
            out.write(json.dumps(row) + "\n")
            out.flush()
            count += 1
            if count % 100 == 0:
                c.commit(asynchronous=False)
                print(WORKER, "processed", count, flush=True)
except KeyboardInterrupt:
    c.commit(asynchronous=False)
finally:
    c.close()
    print(WORKER, "stopped; processed", count, flush=True)
Đây là sink lab để quan sát, không phải sink production. out.flush đẩy buffer Python xuống hệ điều hành nhưng không bảo đảm dữ liệu chịu mất điện. File và offset Kafka không cùng transaction. Nếu worker ghi file xong rồi chết trước commit, một số record có thể được đọc và ghi lại. Ta sẽ kiểm tra số dòng và số order_id duy nhất riêng.
Auto offset store vẫn mặc định bật. Vòng lặp poll một record, xử lý xong rồi mới poll tiếp, nên commit trong luồng tuần tự này không vượt record chưa xử lý. Khi dùng worker pool, không được áp dụng cách commit này mà thiếu theo dõi các offset hoàn tất liên tục theo partition. Lỗi parse hoặc ghi file làm chương trình dừng trước batch commit tiếp theo.
Callback on_assign và on_revoke giúp nhìn thấy partition được giao và thu hồi. Chúng không tự chuyển dữ liệu vào file. Việc đọc vẫn xảy ra trong poll. Tên worker giúp quan sát; group.id mới quyết định các tiến trình đang phối hợp hay đọc độc lập.
6. Tăng từ một đến bốn consumer
Sau khi producer xác nhận đủ dữ liệu, chạy worker đầu trong terminal A. Kích hoạt .venv ở mỗi terminal trước khi chạy. Các lệnh GROUP_ID và WORKER_ID bên dưới dùng cú pháp Bash.
GROUP_ID=orders-lab-a WORKER_ID=w1 python worker.pyWorker đầu nhận cả ba partition. Khi nó đang đọc, mở terminal B chạy w2, rồi terminal C chạy w3. Chạy mỗi dòng ở một terminal riêng, không chạy tuần tự trong cùng terminal đang bị worker chiếm.
GROUP_ID=orders-lab-a WORKER_ID=w2 python worker.py
# Terminal khác
GROUP_ID=orders-lab-a WORKER_ID=w3 python worker.py
Khi thành viên mới tham gia, coordinator điều phối lại assignment. Bạn có thể thấy REVOKED rồi ASSIGNED. Partition cụ thể của từng worker không cố định giữa các lần chạy. Hãy kiểm tra quy tắc một partition chỉ thuộc một consumer trong group ở trạng thái ổn định, thay vì yêu cầu w1 luôn giữ P0.
GROUP_ID=orders-lab-a WORKER_ID=w4 python worker.pyVới consumer thứ tư cùng group, một worker sẽ không được giao partition. Không nhất thiết w4 là người chờ, vì assignment có thể đổi. Cả bốn tiến trình vẫn đang chạy, nhưng tối đa ba consumer có partition hoạt động. Nếu dữ liệu đã đọc hết, dùng describe --members --verbose để nhìn assignment; không dùng việc terminal im lặng làm bằng chứng duy nhất.
Bây giờ chạy một worker trong group B mới. Nó có thể đọc lại toàn bộ dữ liệu còn lưu, không làm group A lùi tiến độ.
GROUP_ID=orders-lab-b WORKER_ID=w1 python worker.py7. Rebalance, commit và lag
docker exec kafka-lab /opt/kafka/bin/kafka-consumer-groups.sh --bootstrap-server localhost:9092 --describe --group orders-lab-a
docker exec kafka-lab /opt/kafka/bin/kafka-consumer-groups.sh --bootstrap-server localhost:9092 --describe --group orders-lab-a --members --verbose
CURRENT-OFFSET là vị trí kế tiếp đã commit, LOG-END-OFFSET là cuối log của partition, LAG là chênh lệch theo offset. Khi worker còn xử lý batch chưa commit, lag có thể chưa giảm dù file đang tăng. Lag 0 không chứng minh nghiệp vụ đúng nếu ứng dụng commit quá sớm.
Dừng một worker bằng Ctrl+C để quan sát group phân công lại. close giúp consumer rời group rõ ràng; tiến trình chết đột ngột có thể cần thêm thời gian để bị phát hiện theo timeout. Rebalance đổi quyền đọc partition, không sao chép tất cả record sang bộ nhớ consumer mới.
So sánh một và ba worker bằng hai group mới để cùng đọc từ đầu với cùng dữ liệu. Không so lượt đầu 100.000 record với lượt sau group cũ chỉ còn vài record. Ghi số unique đã xử lý cùng thời gian; throughput còn phụ thuộc file I/O, logging, broker, Python và tần suất commit. Không kỳ vọng tăng consumer sẽ luôn nhanh đúng tỷ lệ.
8. Đối soát đủ dữ liệu
Chờ group A đọc hết và dừng mềm các worker, rồi tạo verify.py. File có thể có record lặp do rebalance hoặc restart. Mã đếm cả tổng dòng và order_id duy nhất, sau đó so với tập đơn kỳ vọng.
import json
from pathlib import Path

GROUP = "orders-lab-a"
rows = []
for file in Path("results").glob(f"{GROUP}-*.jsonl"):
    with file.open(encoding="utf-8") as f:
        rows.extend(json.loads(line) for line in f if line.strip())
unique = {row["order_id"]: row for row in rows}
expected = {f"ORD-{i:06d}" for i in range(100000)}
print("Rows:", len(rows))
print("Unique orders:", len(unique))
print("Missing:", len(expected - unique.keys()))
print("Unexpected:", len(unique.keys() - expected))
print("Total VND:", sum(r["amount_vnd"] for r in unique.values()))
assert unique.keys() == expected
assert sum(r["amount_vnd"] for r in unique.values()) == 10_000_000_000
Kỳ vọng là unique orders 100000, missing 0, unexpected 0 và tổng 10 tỷ đồng. Rows có thể lớn hơn unique orders nếu đã xử lý lặp. Nếu thiếu, kiểm tra lag, topic, group và file đúng tên. Nếu cùng một order_id có hai payload khác nhau, cách lấy dict cuối cùng này chưa đủ phát hiện xung đột; bộ lab xác định payload nên dùng được, còn hệ thống thật cần quy tắc kiểm tra event trùng và schema.
9. Bài tập và cách chọn partition
Bài 1: trên topic mới, đổi key thành một giá trị cố định cho toàn bộ producer. Dự đoán trước khi chạy: dữ liệu sẽ tập trung vào một partition khi partitioner ổn định, nên thêm consumer cùng group không giúp chia nhỏ partition nóng đó. Đây là lý do key lệch tải có thể làm hệ thống chậm dù có nhiều worker.
Bài 2: chạy group B khi A đã đọc xong. B vẫn đọc được khi retention còn dữ liệu vì hai group có offset riêng; message không bị xóa sau lần đọc đầu.
Bài 3: đo một và ba worker bằng group mới, đối chiếu số unique và tổng tiền. Nếu chưa đủ record, chưa được kết luận phép đo nhanh hơn là tốt hơn. Nếu không tăng tốc tuyến tính, xem bottleneck và overhead thay vì chỉ tăng partition.
Chọn partition production cần throughput đỉnh, thời gian xử lý, độ lệch key, phạm vi thứ tự, số consumer mong muốn và chi phí quản lý. Quá ít giới hạn song song; quá nhiều tạo overhead. Thay đổi partition cần kế hoạch cho key và thứ tự lịch sử.
Bài tiếp theo: website phát sinh đơn, Kafka tiếp nhận, Python xử lý và PostgreSQL lưu bằng transaction cùng unique event_id để giảm tác dụng phụ trùng.
Tài liệu tham khảo
- Apache Kafka Design — partition, group và delivery semantics.
- Confluent Python API — assignment callback, poll và commit.
- Apache Kafka Basic Operations — topic và consumer group CLI.
@techdata.ai · Series Apache Kafka