



Bạn đã biết Python, đã dùng Pandas để đọc dữ liệu và muốn tự huấn luyện một mô hình AI. Nhưng khi mở ví dụ PyTorch, hàng loạt từ mới xuất hiện cùng lúc: Tensor, shape, gradient, backward, optimizer, batch và checkpoint. Nếu chỉ chạy nguyên notebook, bạn có thể thấy accuracy rất cao mà vẫn chưa hiểu mô hình đã học ở đâu, dữ liệu được chia thế nào và vì sao cần gọi zero_grad trước mỗi bước.
Bài hướng dẫn PyTorch từ A tới Z này xây một nền tảng hoàn chỉnh bằng một bài lab nhỏ: tạo dữ liệu, chia train/validation/test, chuẩn hóa, xây mạng nơ-ron, huấn luyện, chọn mô hình tốt nhất, đánh giá rồi lưu và nạp lại để dự đoán. Mục tiêu là hiểu từng bước đủ để tự sửa code, đọc lỗi và chuyển sang một dataset khác.
Bạn cần kiến thức Python cơ bản: hàm, vòng lặp, class, import và thao tác thư mục. Không cần GPU, không cần API trả phí và không phải tải bộ dữ liệu bên ngoài. “A tới Z” ở đây là vòng đời một mô hình đầu tiên; các chủ đề như huấn luyện phân tán hay fine-tune mô hình ngôn ngữ lớn được định vị ở phần học tiếp, thay vì hứa bao phủ toàn bộ hệ sinh thái trong một bài.
PyTorch là gì và khi nào bạn cần dùng?
Có thể hình dung PyTorch là bộ công cụ để biểu diễn dữ liệu bằng Tensor, thực hiện phép tính và xây mô hình học từ dữ liệu. Trong một mô hình dự đoán, bạn không viết tay mọi quy tắc đầu ra. Bạn chọn một cấu trúc có các tham số, đưa ví dụ đã biết đáp án vào, đo sai số và điều chỉnh tham số qua nhiều lượt.
Ví dụ, thay vì viết hàng nghìn điều kiện để phân loại ảnh, một mạng học mối liên hệ giữa giá trị pixel và nhãn. Nhưng dữ liệu đầu vào vẫn phải được chuẩn bị, nhãn phải có ý nghĩa và chất lượng phải được đánh giá. Framework không tự quyết định mục tiêu kinh doanh hay xác nhận dataset đại diện cho môi trường triển khai.
Bạn nên cân nhắc PyTorch khi cần tự xây hoặc điều chỉnh mạng nơ-ron và muốn kiểm soát quá trình học. Với bài toán chỉ cần tổng hợp doanh thu, SQL hoặc Pandas thường gần nhu cầu hơn. Với dữ liệu bảng quy mô vừa, một mô hình đơn giản hoặc cây tăng cường có thể là mốc so sánh phù hợp. Đừng chọn mạng sâu chỉ vì nó có chữ AI; hãy chọn công cụ sau khi xác định kiểu dữ liệu, mục tiêu và cách đo.
| Thành phần | Vai trò | Bạn cần quyết định |
|---|---|---|
| Dữ liệu | Cung cấp ví dụ và nhãn | Đầu vào có sẵn lúc dự đoán không? Có rò rỉ thông tin tương lai không? |
| Mô hình | Biến đầu vào thành điểm dự đoán | Kiến trúc và kích thước phù hợp tới đâu? |
| Loss | Biến sai khác thành số để tối ưu | Sai theo cách nào và có phản ánh mục tiêu không? |
| Optimizer | Cập nhật tham số từ gradient | Learning rate và lịch huấn luyện thế nào? |
| Đánh giá | Đo khả năng trên dữ liệu chưa dùng để học | Dùng metric nào, chia tập ra sao? |
Cài đặt môi trường: chạy CPU trước cho chắc
Bài lab được chạy kiểm tra với Python 3.12 và PyTorch 2.9.1+cpu trên Linux. Đây là cấu hình tham chiếu cố định của bài, không phải khẳng định phiên bản mới nhất. Tạo một môi trường riêng để tránh xung đột các dự án. Trên Linux hoặc macOS, chạy các lệnh sau trong terminal:
mkdir pytorch-lab
cd pytorch-lab
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
Trên Windows PowerShell, bước tạo và kích hoạt môi trường tương ứng như bên dưới. Nếu máy có nhiều Python, kiểm tra phiên bản trước; các lệnh dùng cùng một interpreter sẽ giảm tình huống cài thư viện vào nơi khác với nơi chạy code.
mkdir pytorch-lab
cd pytorch-lab
py -3.12 -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install --upgrade pip
Cho Linux/Windows chạy CPU, dùng wheel CPU đã cố định phiên bản:
python -m pip install torch==2.9.1 --index-url https://download.pytorch.org/whl/cpuTrên macOS, cài bản cùng phiên bản từ PyPI bằng lệnh dưới. Bài không cần torchvision hoặc torchaudio vì chỉ dùng dữ liệu Tensor tự tạo.
python -m pip install torch==2.9.1Nếu muốn dùng GPU, chọn lệnh đúng hệ điều hành và nền tảng tính toán tại trang cài đặt chính thức. Không dùng tùy tiện một lệnh CUDA trên mọi máy. Bản CPU vẫn huấn luyện được lab này; việc có card đồ họa không bảo đảm môi trường Python hiện tại đã truy cập được nó.
python -c "import torch; print(torch.__version__); print(torch.cuda.is_available())"Dòng đầu phải in được phiên bản; dòng thứ hai False vẫn là bình thường khi dùng CPU. Lỗi ModuleNotFoundError thường cần kiểm tra môi trường đang kích hoạt và lệnh python -m pip, trước khi thử cài lại nhiều bản. Khi chạy trong notebook, kernel cũng phải trỏ về môi trường chứa torch.
Tensor: luôn hỏi shape, dtype và device
Tensor là cấu trúc dữ liệu nhiều chiều. Một số đơn có thể là Tensor vô hướng, một dãy số là vector và một bảng số là ma trận. Trong bài lab, mỗi mẫu có hai đặc trưng nên một batch 64 mẫu có shape [64, 2]. Hàng đại diện cho mẫu; cột đại diện cho đặc trưng. Ý nghĩa của từng chiều do thiết kế dữ liệu quyết định, không tự xuất hiện từ số chiều.
import torch

x = torch.tensor([[1.0, 2.0], [3.0, 4.0]], dtype=torch.float32)
y = torch.tensor([0, 2], dtype=torch.long)
print(x.shape, x.dtype, x.device)
print(y.shape, y.dtype)
print(x[:, 0])  # tensor([1., 3.])
print(x.mean(dim=0))  # mean of each column: tensor([2., 3.])
Theo hướng dẫn Tensor chính thức, shape, kiểu dữ liệu và thiết bị là ba thuộc tính cần nắm. Khi gỡ lỗi, in cả ba giúp phân biệt sai kích thước, sai kiểu số và Tensor nằm khác thiết bị. Phép nhân từng phần tử dùng dấu *, còn nhân ma trận có thể dùng @; hai thao tác trả lời hai câu hỏi khác nhau.
a = torch.ones(2, 3)
b = torch.ones(3, 4)
print((a @ b).shape)  # torch.Size([2, 4])
# a * b is not this matrix multiplication.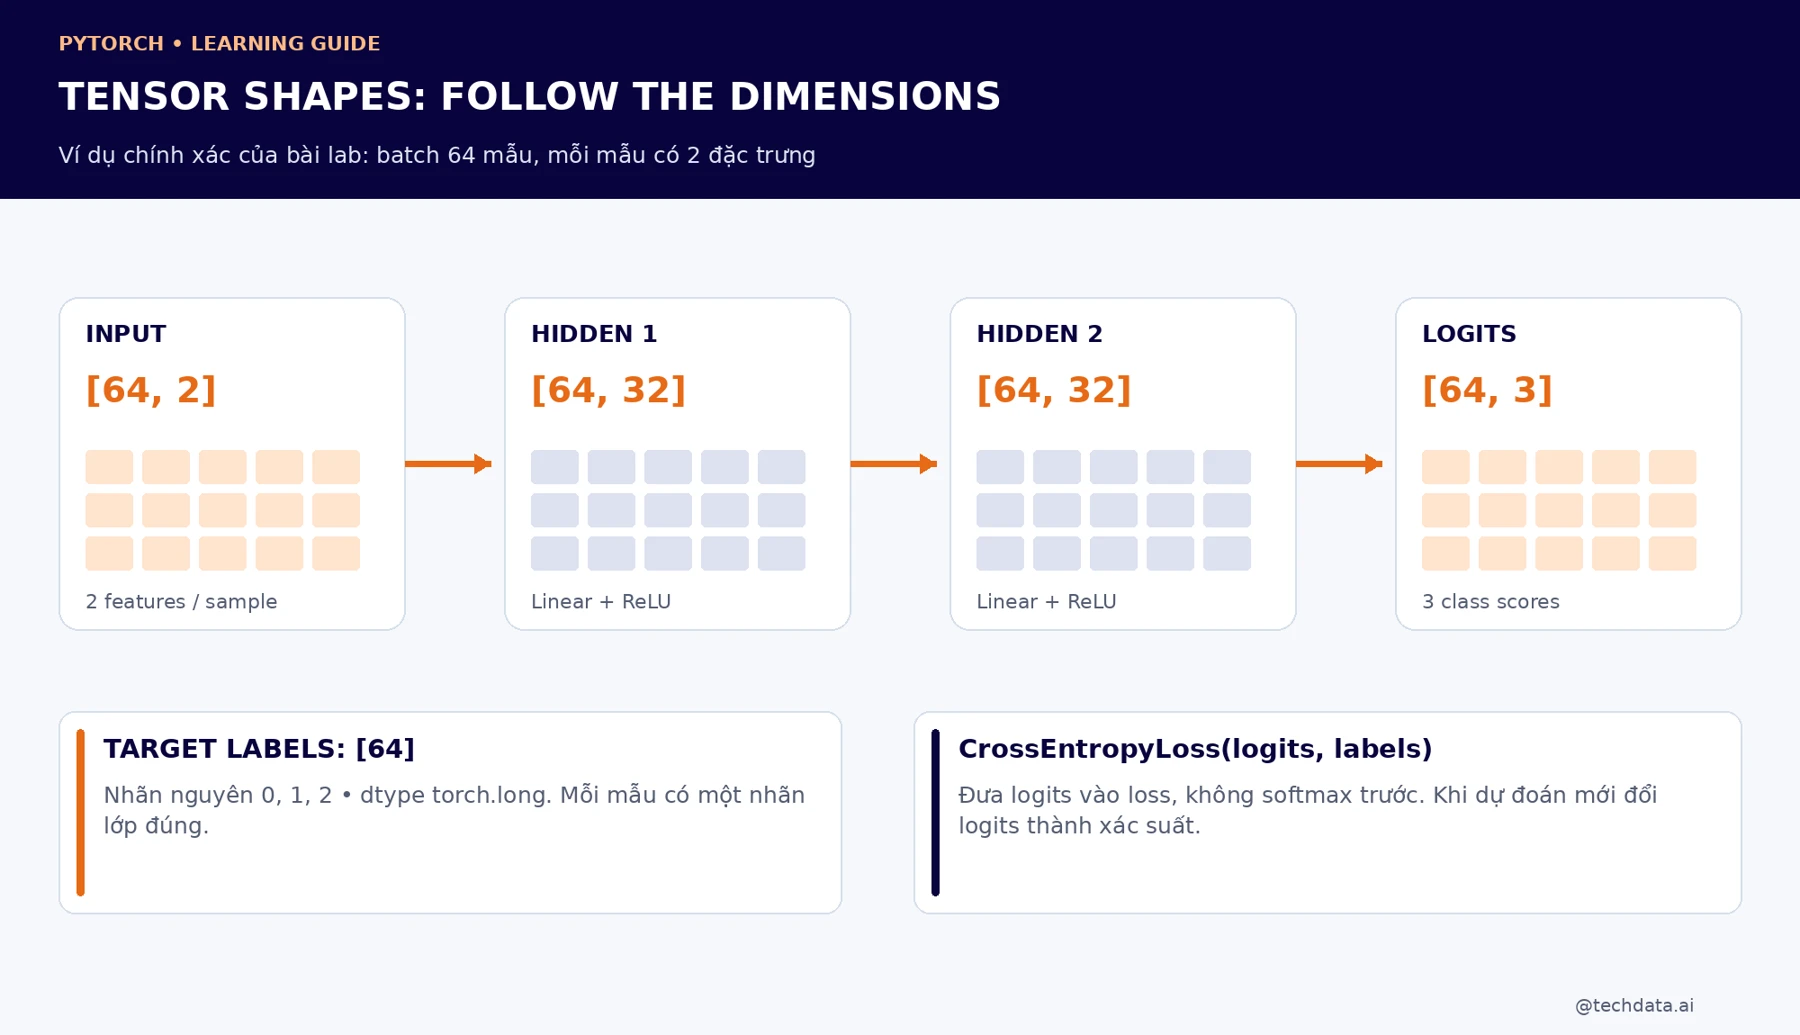
Một lỗi khó nhận ra hơn là broadcasting: một số phép tính được mở rộng chiều tự động. Code có thể chạy nhưng tạo ra một bảng sai ý định. Chẳng hạn dự đoán hồi quy shape [64, 1] trừ nhãn [64] có thể lan thành [64, 64]. Trước khi tin một loss đang giảm, cần xác nhận hai phía của phép tính có shape đúng. Với lab phân loại ở đây, đầu vào là [B, 2], logits là [B, 3] và nhãn là [B].
Autograd: máy tính đạo hàm giúp mô hình học thế nào?
Giả sử dự đoán bằng w nhân x. Khi x bằng 3, mục tiêu bằng 10 và w khởi tạo bằng 2, dự đoán là 6. Nếu loss là bình phương sai số, ta có loss bằng 16. Đạo hàm của loss theo w bằng âm 24. Dấu âm cho biết ở vị trí này, tăng w một lượng nhỏ sẽ làm loss giảm. Không cần đoán w bằng cách thử thủ công từng số.
import torch

w = torch.tensor(2.0, requires_grad=True)
x = torch.tensor(3.0)
target = torch.tensor(10.0)
prediction = w * x
loss = (prediction - target).square()
loss.backward()
print(loss.item())  # 16.0
print(w.grad.item())  # -24.0
print(w.item())  # still 2.0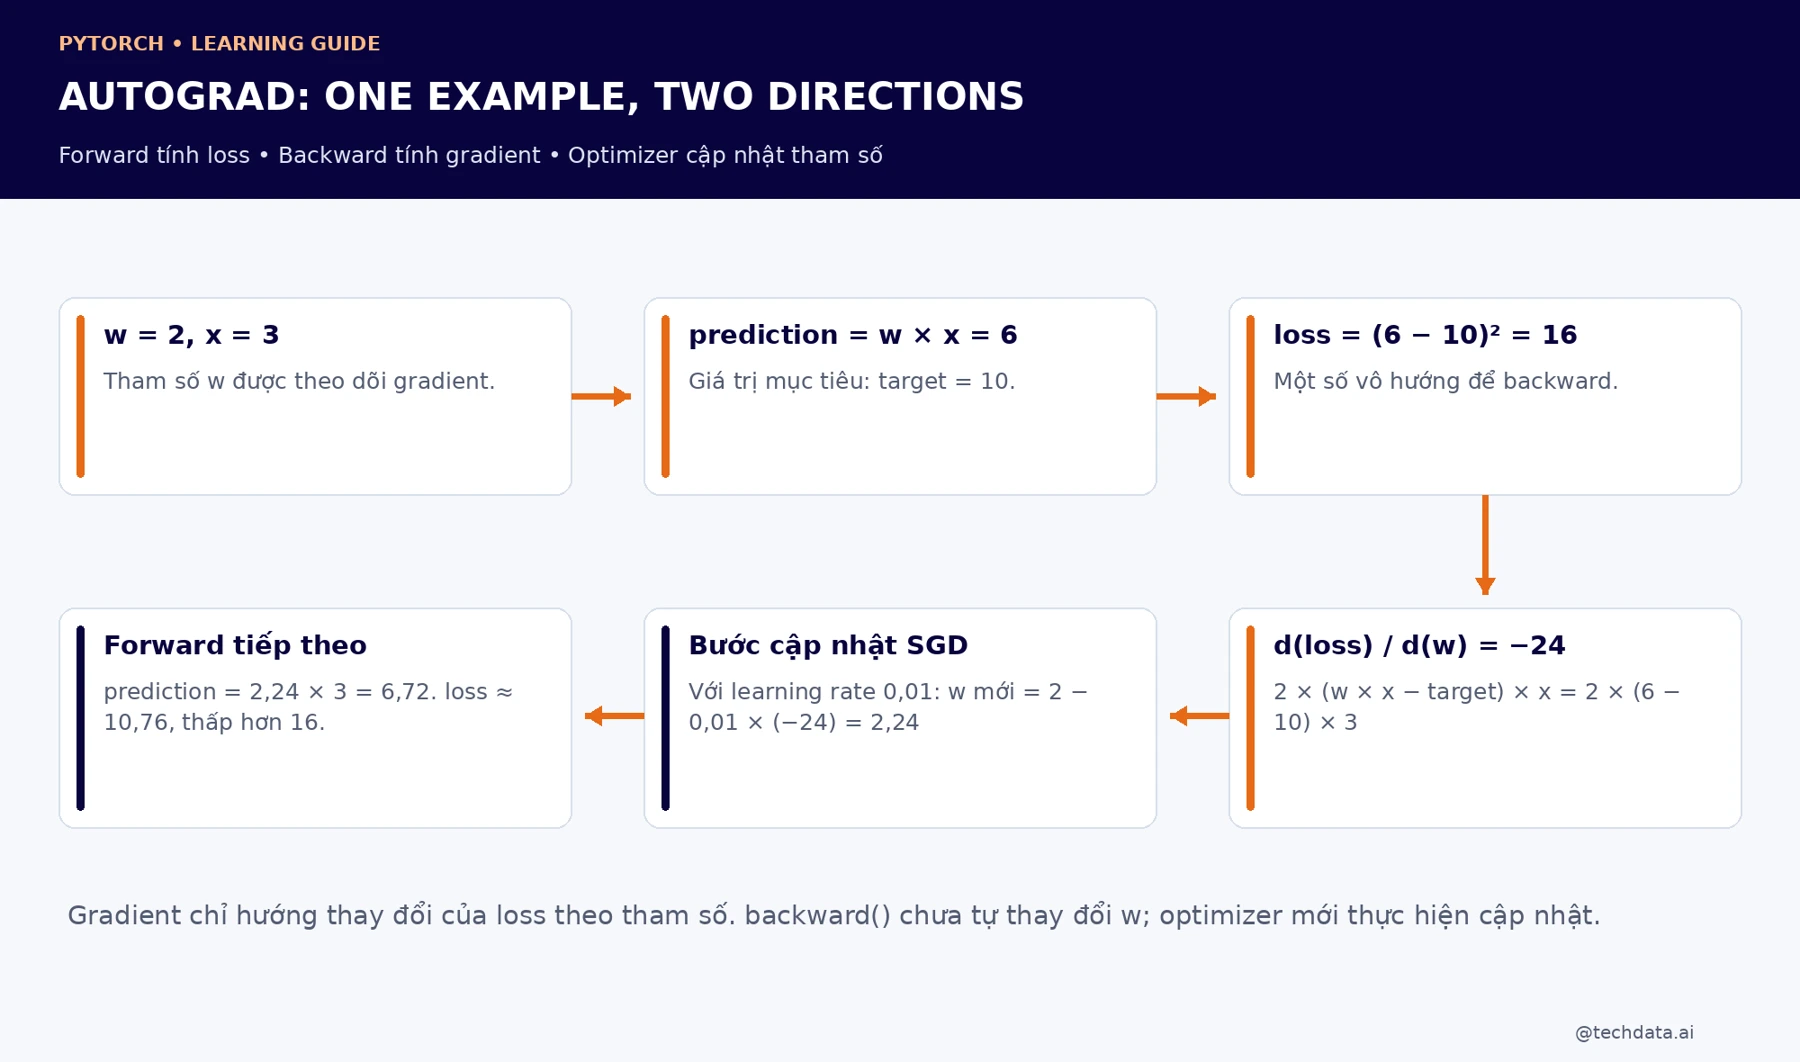
Trong ví dụ riêng này, SGD với learning rate 0,01 đưa w thành 2,24. Dự đoán mới là 6,72 và loss khoảng 10,76. Điều này giải thích một bước học, không bảo đảm mọi bước trên mọi mô hình đều giảm loss. Bước quá lớn có thể đi quá điểm tốt; dữ liệu theo batch cũng làm quá trình dao động.
Cơ chế Autograd theo dõi các phép tính phù hợp để suy ra gradient. requires_grad cho biết cần theo dõi đạo hàm cho Tensor; backward thực hiện lan truyền ngược từ loss. Gradient được cộng dồn nếu không xóa. Vì vậy vòng học thông thường cần zero_grad trước bước backward kế tiếp. Các thao tác như chuyển sang số Python bằng item chỉ nên dùng để ghi log, không thay Tensor loss trước backward.
Bài lab: phân loại ba vùng trên mặt phẳng
Ta tạo 2.400 điểm với hai tọa độ x1, x2 và gán một trong ba nhãn dựa vào góc của điểm quanh gốc tọa độ. Đây là dữ liệu giả lập có quy luật rõ, giúp tập trung vào vòng đời PyTorch. Mô hình nhận hai con số và học dự đoán một trong ba vùng. Tên lớp sector_0, sector_1, sector_2 chỉ là mã vùng, không đại diện cho khách hàng hay quyết định doanh nghiệp.
Quy tắc tạo nhãn đã biết nhưng không được đưa trực tiếp vào đầu vào mô hình. Trong bài tập thực tế, nhãn thường đến từ dữ liệu đã xác nhận thay vì một công thức dễ tạo. Điểm số cao trên ví dụ này chỉ cho thấy mô hình học được quy luật đơn giản trong cùng cách sinh dữ liệu. Nó không chứng minh khả năng giải bài toán ảnh, ngôn ngữ hay một dataset kinh doanh.
| Tập dữ liệu | Số mẫu | Vai trò |
|---|---|---|
| Train | 1.680 (70%) | Dùng để cập nhật tham số và fit bước chuẩn hóa. |
| Validation | 360 (15%) | Theo dõi khả năng tổng quát và chọn checkpoint. |
| Test | 360 (15%) | Chỉ đánh giá sau khi đã chọn mô hình. |
Điểm được xáo trộn bằng seed cố định trước khi chia. Cách chia ngẫu nhiên phù hợp với giả định các điểm độc lập trong lab. Với dữ liệu theo thời gian, thường cần chia theo thời gian; với nhiều bản ghi của một khách hàng hoặc một người, cần cân nhắc chia theo nhóm. Nếu các bản gần như trùng nhau xuất hiện ở cả train và test, điểm đo có thể quá lạc quan.
Dataset và DataLoader: lấy mẫu và ghép batch
Dataset mô tả cách lấy một mẫu cùng nhãn. DataLoader gom các mẫu thành batch và quyết định thứ tự lấy. Tài liệu chính thức tách hai trách nhiệm này để phần đọc dữ liệu không bị trộn với vòng học. Khi dữ liệu đã nằm trong Tensor như bài này, TensorDataset đủ dùng; chưa cần viết một lớp Dataset riêng.
batch_size bằng 64 không có nghĩa mỗi epoch chỉ học 64 mẫu. Với 1.680 mẫu và không bỏ batch cuối, một epoch có 27 batch: 26 batch đủ 64 và một batch 16 mẫu. Một epoch là một lượt đi qua tập train; một optimizer step là một lần cập nhật sau một batch trong code này. Qua 40 epoch sẽ có 1.080 bước cập nhật.
Train bật shuffle để thay thứ tự mẫu mỗi epoch. Validation và test giữ thứ tự cố định để tiện kiểm tra. num_workers bằng 0 giúp lab đơn giản, dễ chạy trên nhiều môi trường; chưa phải cấu hình nhanh nhất cho mọi bộ ảnh lớn. Tăng số worker là một bài toán hiệu năng cần đo, không phải điều kiện để mô hình học đúng.
Chuẩn hóa được fit chỉ trên train: lấy trung bình và độ lệch chuẩn từng cột của train, rồi dùng đúng hai giá trị đó cho validation, test và dữ liệu mới. Nếu tính lại trên từng batch suy luận, cùng một mẫu có thể nhận đầu vào chuẩn hóa khác nhau tùy các mẫu đi cùng. Nếu dùng toàn bộ dataset trước khi chia, thông tin ngoài train đã đi vào bước chuẩn bị.
Xây mạng nơ-ron và đọc số tham số
Mạng trong lab gồm ba lớp Linear, hai lớp ReLU và ba điểm đầu ra. Lớp Linear đầu biến hai đặc trưng thành 32 giá trị; lớp tiếp theo giữ chiều 32; lớp cuối đưa về ba lớp. ReLU tạo tính phi tuyến. Nếu xếp nhiều lớp tuyến tính mà không có biến đổi phi tuyến giữa chúng, ta vẫn có thể gộp chúng thành một biến đổi tuyến tính duy nhất.
Mô hình kế thừa nn.Module và định nghĩa forward. Gọi model(x) sẽ đi qua cơ chế của Module; bạn không cần tự gọi forward trong vòng học. Các lớp được gán thành phần của Module sẽ được đăng ký để model.parameters và state_dict có thể quản lý. Tham khảo thêm hướng dẫn xây mạng để mở rộng cấu trúc.
model = Classifier()
parameter_count = sum(p.numel() for p in model.parameters())
print(parameter_count)  # 1251
example = torch.randn(64, 2)
print(model(example).shape)  # torch.Size([64, 3])
Đoạn trên chạy sau khi đã khai báo Classifier trong script đầy đủ phía dưới. Số tham số được tính theo trọng số và bias: lớp đầu có 2×32+32=96; lớp giữa 32×32+32=1.056; lớp cuối 32×3+3=99; tổng 1.251. Đây là mạng nhỏ có thể huấn luyện nhanh bằng CPU, không cần hàng triệu tham số để hiểu quy trình.
Loss, logits và optimizer: ba khái niệm không nên trộn
Đầu ra ba số của mạng là logits, chưa bắt buộc nằm trong khoảng 0 đến 1 hoặc cộng thành 1. Với nhãn lớp nguyên trong bài, CrossEntropyLoss nhận logits shape [B, 3] cùng nhãn shape [B], dtype long, giá trị 0, 1 hoặc 2. Không softmax trước loss này. Khi cần trình bày xác suất dự đoán, mới áp dụng softmax theo chiều lớp.
Quy ước trên được mô tả trong CrossEntropyLoss. Loss dùng trong tối ưu khác với accuracy dùng để đếm dự đoán đúng. Hai mô hình có cùng số mẫu đoán đúng vẫn có thể khác loss vì mức phân bổ điểm cho các lớp khác nhau. Vì vậy nên theo dõi cả hai, không thay một số bằng số còn lại.
Optimizer Adam nhận các tham số cần học cùng learning rate. Trong script, giá trị 0,01 được chọn cho ví dụ nhỏ sau khi kiểm tra; nó không phải mặc định tốt cho mọi mạng. Model tạo logits, loss đánh giá sai khác, backward tạo gradient và optimizer.step dùng gradient để cập nhật. Thay kiến trúc hay dữ liệu có thể cần điều chỉnh learning rate và các thiết lập khác.
Nhìn toàn bộ flow trước khi chạy code
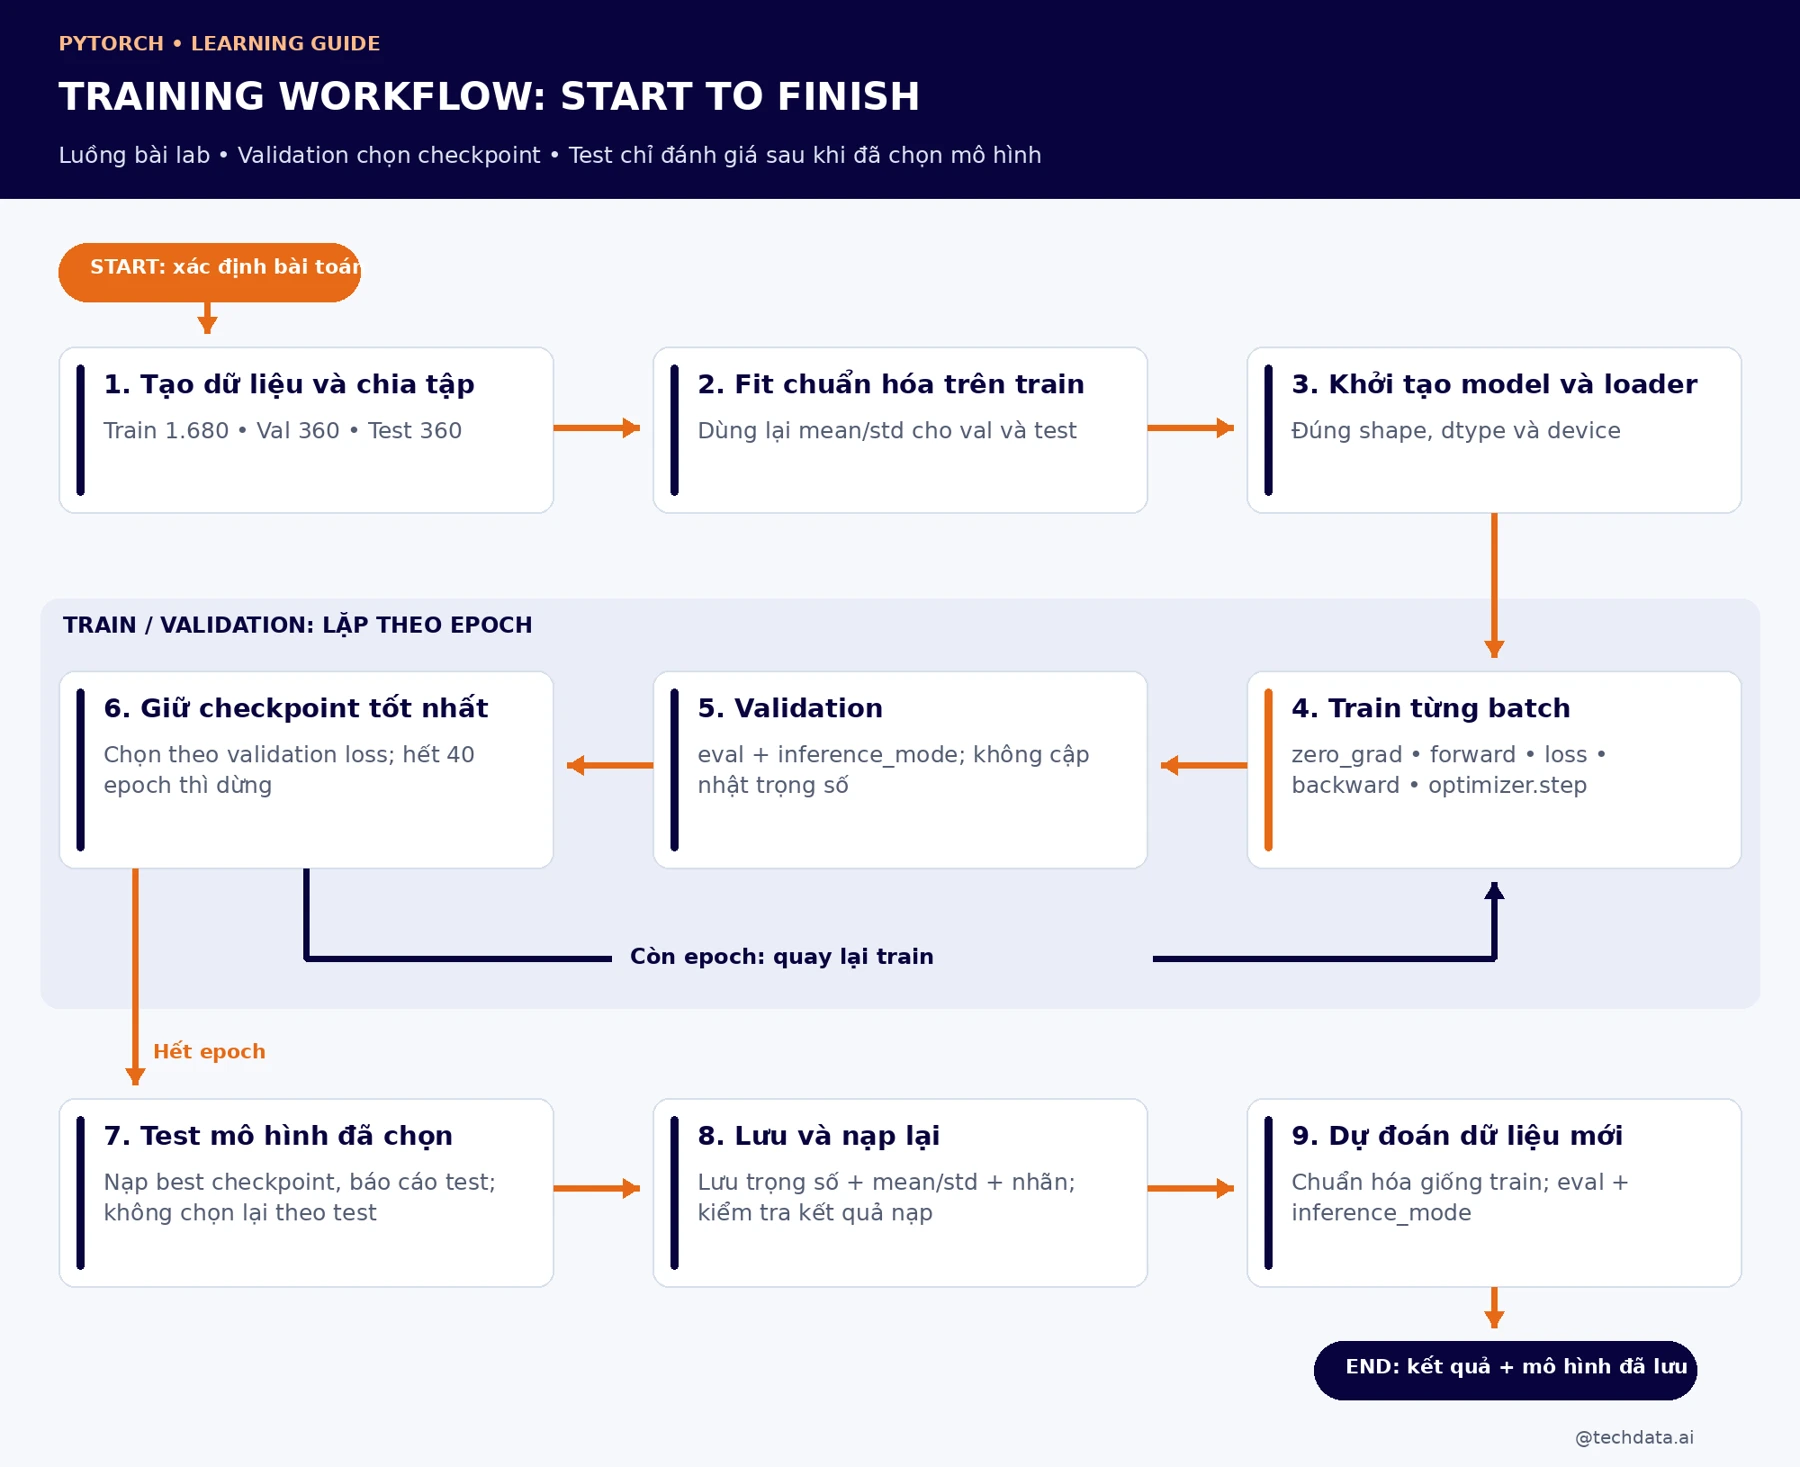
Trong một batch, thứ tự cần hiểu là xóa gradient cũ, tính dự đoán, tính loss, lan truyền ngược và cập nhật tham số. Sau một epoch, chương trình chuyển sang validation để tính số đo mà không học từ tập đó. Nếu validation loss tốt hơn, giữ bản sao trọng số. Lặp hết 40 epoch rồi nạp lại bản tốt nhất, không mặc định dùng epoch cuối.
Sự khác biệt giữa train và eval không phải bật hay tắt tính gradient. model.train và model.eval điều chỉnh hành vi các lớp có chế độ riêng, như Dropout hoặc BatchNorm. inference_mode là ngữ cảnh tắt theo dõi gradient để suy luận. Trong validation và dự đoán, ta dùng cả eval lẫn inference_mode. Mạng nhỏ này chưa có Dropout/BatchNorm, nhưng giữ cấu trúc chuẩn giúp bạn không quên khi mở rộng.
Code đầy đủ: tạo file train.py và chạy từ đầu đến cuối
Tạo file train.py trong thư mục pytorch-lab, sao chép toàn bộ đoạn dưới và chạy python train.py. Không ghép các mẩu giải thích phía trên vào một script một cách tùy ý; đoạn này đã chứa đủ import, hàm, lớp và điểm bắt đầu. Khi chạy lại, các file kết quả cùng tên trong thư mục hiện tại sẽ được cập nhật.
from pathlib import Path
import copy
import json
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

SEED = 42
BATCH_SIZE = 64
EPOCHS = 40
LEARNING_RATE = 0.01


def make_data(n=2400):
    generator = torch.Generator().manual_seed(SEED)
    x = torch.randn(n, 2, generator=generator)
    # Three classes defined by angular sectors; educational data only.
    angle = torch.atan2(x[:, 1], x[:, 0])
    y = torch.floor((angle + torch.pi) / (2 * torch.pi / 3)).long()
    y = y.clamp(0, 2)
    order = torch.randperm(n, generator=generator)
    return x[order], y[order]


class Classifier(nn.Module):
    def __init__(self):
        super().__init__()
        self.layers = nn.Sequential(
            nn.Linear(2, 32),
            nn.ReLU(),
            nn.Linear(32, 32),
            nn.ReLU(),
            nn.Linear(32, 3),
        )

    def forward(self, x):
        return self.layers(x)


@torch.inference_mode()
def evaluate(model, loader, loss_fn, device):
    model.eval()
    total_loss = 0.0
    correct = 0
    count = 0
    for x, y in loader:
        x, y = x.to(device), y.to(device)
        logits = model(x)
        total_loss += loss_fn(logits, y).item() * len(y)
        correct += (logits.argmax(dim=1) == y).sum().item()
        count += len(y)
    return total_loss / count, correct / count


def main():
    torch.manual_seed(SEED)
    torch.set_num_threads(1)
    # Set this to torch.device('cpu') for the article's reference run.
    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
    x, y = make_data()
    x_train, y_train = x[:1680], y[:1680]
    x_val, y_val = x[1680:2040], y[1680:2040]
    x_test, y_test = x[2040:], y[2040:]

    # Fit preprocessing only on training data.
    mean = x_train.mean(dim=0)
    std = x_train.std(dim=0).clamp_min(1e-6)
    normalize = lambda values: (values - mean) / std
    train_loader = DataLoader(
        TensorDataset(normalize(x_train), y_train),
        batch_size=BATCH_SIZE,
        shuffle=True,
        generator=torch.Generator().manual_seed(SEED),
        num_workers=0,
    )
    val_loader = DataLoader(
        TensorDataset(normalize(x_val), y_val),
        batch_size=BATCH_SIZE,
        shuffle=False,
        num_workers=0,
    )
    test_loader = DataLoader(
        TensorDataset(normalize(x_test), y_test),
        batch_size=BATCH_SIZE,
        shuffle=False,
        num_workers=0,
    )
    model = Classifier().to(device)
    loss_fn = nn.CrossEntropyLoss()
    optimizer = torch.optim.Adam(model.parameters(), lr=LEARNING_RATE)
    best_val_loss = float('inf')
    best_epoch = 0
    best_state = None
    history = []
    print(f'torch={torch.__version__}, device={device}')
    print('splits:', len(y_train), len(y_val), len(y_test))
    for epoch in range(1, EPOCHS + 1):
        model.train()
        total_loss = 0.0
        count = 0
        for xb, yb in train_loader:
            xb, yb = xb.to(device), yb.to(device)
            optimizer.zero_grad(set_to_none=True)
            logits = model(xb)
            loss = loss_fn(logits, yb)
            loss.backward()
            optimizer.step()
            total_loss += loss.item() * len(yb)
            count += len(yb)
        train_loss = total_loss / count
        val_loss, val_acc = evaluate(model, val_loader, loss_fn, device)
        history.append({'epoch': epoch, 'train_loss': train_loss,
                        'val_loss': val_loss, 'val_acc': val_acc})
        if val_loss < best_val_loss:
            best_val_loss = val_loss
            best_epoch = epoch
            best_state = copy.deepcopy(model.state_dict())
        if epoch == 1 or epoch % 10 == 0:
            print(f'epoch={epoch:02d} train_loss={train_loss:.4f} '
                  f'val_loss={val_loss:.4f} val_acc={val_acc:.4f}')

    model.load_state_dict(best_state)
    test_loss, test_acc = evaluate(model, test_loader, loss_fn, device)
    print(f'best_epoch={best_epoch}, test_loss={test_loss:.4f}, '
          f'test_acc={test_acc:.4f}')

    checkpoint = {
        'model_state': {k: v.detach().cpu() for k, v in best_state.items()},
        'mean': mean,
        'std': std,
        'class_names': ['sector_0', 'sector_1', 'sector_2'],
        'best_epoch': best_epoch,
    }
    torch.save(checkpoint, 'classifier.pt')
    saved = torch.load('classifier.pt', map_location='cpu', weights_only=True)
    restored = Classifier()
    restored.load_state_dict(saved['model_state'])
    restored.eval()
    samples = x_test[:5]
    with torch.inference_mode():
        normalized = (samples - saved['mean']) / saved['std']
        probabilities = restored(normalized).softmax(dim=1)
        predicted = probabilities.argmax(dim=1)
        reference = model(normalized.to(device)).cpu()
        torch.testing.assert_close(restored(normalized), reference,
                                   rtol=1e-4, atol=1e-5)
    print('predicted:', predicted.tolist())
    print('actual:   ', y_test[:5].tolist())
    print('reload check: PASS')
    Path('history.json').write_text(json.dumps(history))
    Path('metrics.json').write_text(json.dumps({
        'torch': str(torch.__version__), 'device': str(device),
        'best_epoch': best_epoch, 'test_loss': test_loss,
        'test_acc': test_acc, 'test_labels': y_test.tolist(),
        'test_predictions': predict_all(restored, normalize(x_test)),
    }))


@torch.inference_mode()
def predict_all(model, values):
    return model(values).argmax(dim=1).tolist()


if __name__ == '__main__':
    main()
python train.pyChương trình tạo classifier.pt chứa mô hình được chọn cùng thông số chuẩn hóa và tên lớp; history.json ghi lịch sử mỗi epoch; metrics.json ghi kết quả test và nhãn dự đoán. Nếu bạn chỉ thấy tên file mà không rõ ở đâu, kiểm tra thư mục hiện tại trong terminal. Đường dẫn tương đối được tính từ nơi chạy lệnh, không nhất thiết là nơi đặt file nếu gọi từ một thư mục khác.
Đọc kết quả thực chạy: accuracy 98,89% có ý nghĩa gì?
Lần kiểm tra trên CPU với cấu hình tham chiếu cho kết quả sau. Các số là đầu ra thực của script, không phải giá trị cần nhập tay để mô hình chạy. Khác phiên bản, thiết bị hoặc thư viện nền có thể tạo khác biệt; đặt seed giúp kiểm soát một phần ngẫu nhiên, không bảo đảm trùng tuyệt đối giữa mọi môi trường.
| Mốc | Train loss | Validation loss | Validation accuracy |
|---|---|---|---|
| Epoch 1 | 0,4783 | 0,1244 | 97,22% |
| Epoch 10 | 0,0243 | 0,0304 | 98,61% |
| Epoch 20 | 0,0313 | 0,0301 | 99,17% |
| Epoch 30 | 0,0668 | 0,0522 | 98,33% |
| Epoch 40 | 0,0260 | 0,0216 | 99,17% |
Checkpoint được chọn ở epoch 36 theo validation loss thấp nhất. Sau khi nạp checkpoint đó, test loss khoảng 0,0235 và accuracy là 356/360, tương đương 98,89%. Năm dự đoán đầu là [0, 0, 1, 1, 0], khớp nhãn của năm mẫu tương ứng. Kiểm tra nạp lại mô hình báo PASS. Năm mẫu đầu chỉ minh họa cách đọc đầu ra; số đo toàn test mới sử dụng đủ 360 mẫu.
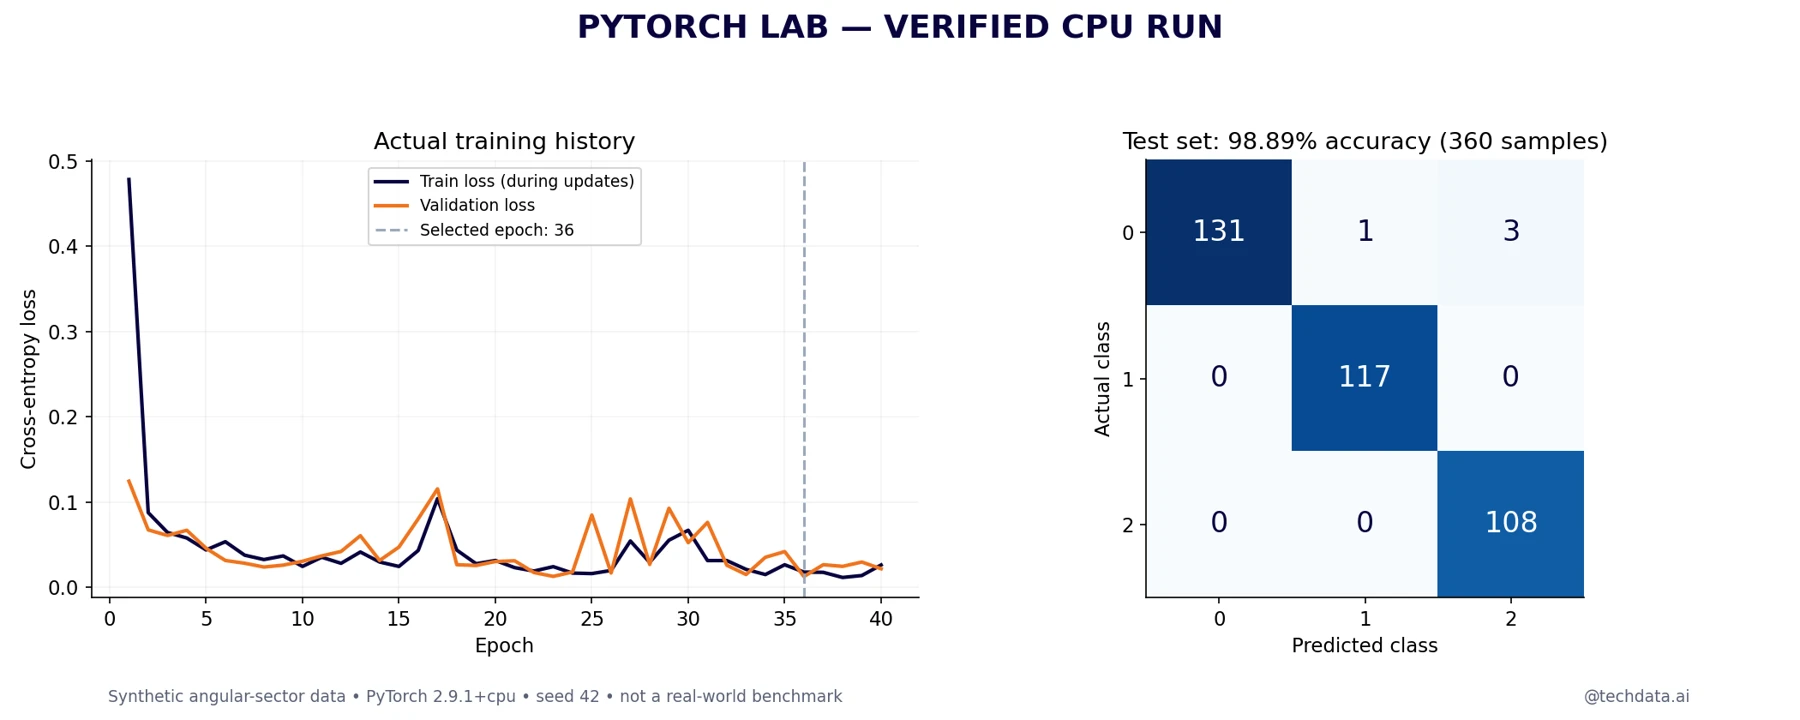
Biểu đồ bên trái cho thấy loss không giảm đều qua mọi epoch. Điều này bình thường với huấn luyện theo batch và bước học tương đối lớn. Train loss trong script được tích lũy trong lúc trọng số đang cập nhật; validation loss được tính sau epoch trên một tập khác. Vì vậy train loss cao hơn validation loss ở một epoch không tự chứng minh có lỗi hay rò rỉ dữ liệu.
Ma trận bên phải có hàng là nhãn thật, cột là nhãn dự đoán. Hàng lớp 0 có 135 mẫu: 131 đúng, một nhầm sang lớp 1 và ba nhầm sang lớp 2. Lớp 1 có 117 mẫu đúng; lớp 2 có 108 mẫu đúng. Tổng bốn lỗi phù hợp với accuracy đã báo. Cách đọc này giúp xác nhận chất lượng theo từng lớp thay vì chỉ nhìn một con số tổng.
Giải thích những dòng dễ chạy đúng nhưng hiểu sai
Vì sao loss được nhân với số mẫu trong batch?
CrossEntropyLoss mặc định trả trung bình của batch trong cấu hình không dùng trọng số lớp ở đây. Để có trung bình toàn epoch theo mẫu, code nhân loss.item với kích thước batch rồi chia tổng số mẫu. Batch cuối chỉ có 16 mẫu; nếu lấy trung bình đơn giản của 27 batch, batch nhỏ này sẽ được tính trọng lượng ngang một batch 64 mẫu. Trên dữ liệu lớn sai khác có thể nhỏ, nhưng cách tính đúng giúp log phản ánh điều mình định đo.
Vì sao phải deepcopy state_dict?
Khi đánh dấu epoch tốt nhất, cần giữ một bản chụp trọng số ở thời điểm đó. Chỉ gán một biến rồi tiếp tục huấn luyện có thể vẫn tham chiếu các Tensor sẽ bị thay đổi. copy.deepcopy tạo bản sao tách biệt trong bộ nhớ. Với mô hình lớn, giữ thêm một bản trên GPU có thể tốn bộ nhớ; khi đó có thể lưu checkpoint ra đĩa hoặc sao chép về CPU theo chiến lược phù hợp.
Vì sao không gọi optimizer trong evaluate?
Validation có quyền đo mô hình, không có quyền dạy mô hình trong luồng này. Hàm evaluate không có zero_grad, backward hay optimizer.step. Nếu cập nhật trọng số từ tập validation rồi tiếp tục dùng nó để chọn mô hình, ý nghĩa tách tập sẽ thay đổi. Test càng không được dùng để chọn learning rate hoặc thử hàng chục kiến trúc rồi chọn kết quả cao nhất.
Vì sao chọn theo validation loss thay vì epoch cuối?
Ở lab, cấu hình lưu checkpoint khi loss tốt hơn, rồi vẫn chạy đủ 40 epoch. Đây là chọn mô hình tốt nhất, chưa phải early stopping: chương trình không dừng sớm theo số epoch không cải thiện. Khi bạn bổ sung early stopping, cần định nghĩa patience và điều kiện cải thiện. Dù dùng cách nào, tiêu chí nên được chốt trước khi xem kết quả test.
Lưu, nạp và suy luận: phải giữ cả bước chuẩn hóa
Trọng số chỉ có ý nghĩa khi đi cùng kiến trúc và cách biến đổi đầu vào. Code lưu model_state, mean, std và class_names để mô hình nạp lại xử lý mẫu giống lúc train. Nếu khi triển khai bạn đảo thứ tự x1, x2 hoặc dùng một đơn vị đo khác, kích thước vẫn đúng nhưng dự đoán có thể sai. Đây là lỗi ngữ nghĩa dữ liệu, không phải lỗi Tensor.
Hướng dẫn lưu và nạp mô hình dùng state_dict để quản lý tham số. Trong bài, weights_only=True giới hạn cơ chế nạp cho checkpoint phù hợp; vẫn chỉ nạp file từ nguồn tin cậy. map_location="cpu" cho phép nạp trọng số về CPU ngay cả khi trước đó huấn luyện ở thiết bị khác.
Sau khi đã chạy train.py, tạo file predict.py cùng thư mục với nội dung dưới để thử suy luận trong một tiến trình Python mới. File này nhập Classifier từ train.py; khối if __name__ bảo đảm việc import không tự chạy lại huấn luyện.
import torch
from train import Classifier

saved = torch.load("classifier.pt", map_location="cpu", weights_only=True)
model = Classifier()
model.load_state_dict(saved["model_state"])
model.eval()

# Columns must stay in the order [x1, x2].
new_samples = torch.tensor([[1.0, 0.2], [-0.8, 0.5]], dtype=torch.float32)
with torch.inference_mode():
    x = (new_samples - saved["mean"]) / saved["std"]
    probabilities = model(x).softmax(dim=1)
    indices = probabilities.argmax(dim=1)

for row, index in zip(probabilities, indices):
    label = saved["class_names"][index.item()]
    print(label, [round(value, 4) for value in row.tolist()])
python predict.pyXác suất softmax là cách chuyển điểm của mạng thành một phân phối trên ba nhãn trong mô hình. Không nên mặc định coi giá trị 0,99 là bảo đảm đúng 99% ngoài thực tế. Mạng có thể tự tin với mẫu nằm ngoài miền dữ liệu đã học. Muốn dùng độ tin cậy để quyết định chuyển người kiểm tra, cần đánh giá và hiệu chỉnh trên dữ liệu phù hợp.
Checkpoint trong bài phục vụ suy luận, chưa đủ để tiếp tục huấn luyện một cách tương đương hoàn toàn. Muốn resume, còn cần trạng thái optimizer, epoch và tùy cấu hình là scheduler, trạng thái bộ sinh ngẫu nhiên hoặc các thành phần khác. Chỉ nạp trọng số rồi tạo optimizer mới là bắt đầu một diễn tiến tối ưu khác, dù điểm xuất phát của mô hình giống nhau.
Các lỗi thường gặp và thứ tự kiểm tra
| Triệu chứng | Điểm cần kiểm tra trước | Cách xử lý trong phạm vi lab |
|---|---|---|
| mat1 and mat2 shapes cannot be multiplied | Số đặc trưng đầu vào có đúng 2 không? | In xb.shape và xem Linear đầu tiên. Đừng reshape tùy ý để che lỗi. |
| Expected scalar type Long | Nhãn lớp đang là float hay one-hot? | Giữ nhãn [B], dtype torch.long, giá trị 0–2. |
| Expected all tensors to be on the same device | Model và dữ liệu nằm khác thiết bị | Đưa cả xb và yb sang device của model. |
| Loss không giảm | Gradient, learning rate, nhãn và scale | Xác nhận đủ backward, step, zero_grad; thử học một mẫu nhỏ trước. |
| Loss NaN | Dữ liệu không hữu hạn hoặc tính toán mất ổn định | Kiểm tra NaN/Inf, std bằng 0, learning rate; không bỏ qua NaN trong báo cáo. |
| Train tốt, validation kém | Overfitting, chia tập hoặc phân phối khác nhau | Xem lại dữ liệu và tiêu chí; giảm độ phức tạp hoặc regularization sau khi đã loại lỗi. |
| GPU hết bộ nhớ | Batch, kích thước mô hình, graph bị giữ lại | Giảm batch; ghi log bằng item; dùng inference_mode khi đánh giá. |
| Nạp mô hình báo thiếu/sai key | Kiến trúc và checkpoint không tương thích | Nạp đúng Classifier đã tạo trọng số; không bỏ qua lỗi bằng strict=False một cách tùy tiện. |
Một chiến lược gỡ lỗi hữu ích là làm cho pipeline nhỏ tới mức quan sát được: một batch, một forward, một loss và một bước backward. In shape và nhãn, kiểm tra tham số có gradient, rồi so loss trước và sau vài bước. Nếu mô hình không thể học nổi một tập rất nhỏ có nhãn nhất quán, tăng dữ liệu hoặc thêm GPU thường chưa phải giải pháp đầu tiên.
Đưa bài lab sang dữ liệu thật: thay gì và giữ gì?
Điều giữ lại là cấu trúc tách dữ liệu, tiền xử lý, mô hình, vòng train, vòng đánh giá và checkpoint. Điều phải thay là cách đọc mẫu, ý nghĩa nhãn, kiến trúc phù hợp và cách đo chất lượng. Với ảnh, Dataset có thể đọc đường dẫn ảnh và biến đổi pixel. Với văn bản, cần tokenizer và quy ước padding; không thể đưa nguyên chuỗi ký tự vào Linear hai đặc trưng của bài rồi mong có kết quả.
Với dữ liệu bảng, hãy bắt đầu từ định nghĩa mỗi hàng và thời điểm dự đoán. Nếu muốn dự đoán giao trễ trước khi giao hàng, một cột được tạo sau ngày giao sẽ làm rò rỉ đáp án. Mô hình có thể đạt điểm rất cao khi kiểm tra offline rồi thất bại trong vận hành vì đầu vào ấy chưa tồn tại lúc phải ra quyết định. Học framework không thay thế được hiểu dữ liệu.
Nếu lớp hiếm quan trọng, accuracy có thể che mất lỗi. Một hệ thống đoán mọi mẫu là lớp phổ biến vẫn có accuracy cao khi dữ liệu lệch mạnh. Cần xem confusion matrix, precision, recall hoặc metric phù hợp, cùng chi phí của từng kiểu sai. Nếu thay ngưỡng quyết định, dùng validation để chọn; giữ test để đánh giá sau cùng.
Một mô hình được dùng thật còn cần hợp đồng đầu vào: cột nào, đơn vị gì, thứ tự ra sao, giá trị thiếu xử lý thế nào và dữ liệu nào phải từ chối. Lưu thông tin phiên bản dữ liệu, code, môi trường và cách đánh giá sẽ giúp tái lập kết quả. Khi phân phối đầu vào thay đổi, cần theo dõi chất lượng và có cách quay về phiên bản trước, thay vì chỉ lưu một file .pt rồi kết thúc.
Học gì sau bài này và tự kiểm tra bằng cách nào?
Trước khi học mô hình lớn hơn, bạn nên tự làm được bốn thay đổi có chủ đích: đổi batch_size và tính lại số bước; giảm learning rate rồi so lịch sử loss; thay kích thước hidden layer và đếm tham số; dùng mô hình tuyến tính làm baseline. Giữ test ngoài quá trình chọn các cấu hình. Nếu sau khi đã xem test bạn tiếp tục điều chỉnh nhiều lần, cần một tập đánh giá cuối khác để tránh học gián tiếp từ test.
- Bài tập 1: đổi batch từ 64 thành 128. Với 1.680 mẫu và giữ batch cuối, mỗi epoch có 14 batch. Kiểm tra xem thời gian và chất lượng có thay đổi, không mặc định nhanh hơn là tốt hơn.
- Bài tập 2: thay hidden width từ 32 thành 16 ở cả hai lớp. Tự tính số tham số trước khi chạy phép đếm, rồi kiểm tra khớp.
- Bài tập 3: tạo một lớp Linear(2, 3) làm baseline. So với mạng phi tuyến bằng cùng cách chia và cùng metric trên validation.
- Bài tập 4: bỏ bước chuẩn hóa ở predict.py nhưng giữ mô hình cũ để quan sát sự không nhất quán. Sau đó khôi phục và giải thích vì sao một pipeline phải đóng gói cả tiền xử lý.
- Bài tập 5: thêm một mẫu chứa NaN và thiết kế kiểm tra đầu vào từ chối mẫu đó trước khi suy luận. Không dùng một nhãn dự đoán tùy ý để thay lỗi dữ liệu.
Sau đó mới mở rộng theo hướng bài toán: CNN và transfer learning cho ảnh; embedding và attention cho văn bản; kỹ thuật regularization để giảm overfitting; mixed precision và profiling khi hiệu năng thực sự trở thành nút thắt. Các lựa chọn như torch.compile, huấn luyện nhiều GPU hoặc xuất mô hình phục vụ môi trường khác cần thử nghiệm riêng, không phải điều kiện để hoàn thành vòng đời mô hình đầu tiên.
PyTorch trở nên dễ học hơn khi bạn nhìn nó như một chuỗi quyết định có thể kiểm tra: dữ liệu đúng nghĩa, Tensor đúng kích thước, loss đúng mục tiêu, gradient đúng chỗ, đánh giá đúng tập và suy luận đúng tiền xử lý. Hãy giữ lab nhỏ này làm điểm xuất phát, rồi thay từng thành phần để hiểu điều gì thay đổi và vì sao.
Tài liệu tham khảo
- PyTorch: Start Locally và Previous Versions — chọn bản cài phù hợp thiết bị.
- Tensors — biểu diễn và thao tác dữ liệu.
- Automatic Differentiation with torch.autograd — cơ chế tính gradient.
- Datasets & DataLoaders — tổ chức việc lấy và ghép mẫu.
- Build the Neural Network — cấu trúc nn.Module.
- CrossEntropyLoss API — logits, nhãn và kiểu dữ liệu.
- Optimizing Model Parameters — loss và vòng tối ưu.
- Save and Load the Model — state_dict và chế độ suy luận.
- Reproducibility — giới hạn tái lập giữa thiết bị và phiên bản.
Code và kết quả lab đã kiểm tra trên Python 3.12, PyTorch 2.9.1+cpu. Dữ liệu được tạo để học, không đại diện cho một ứng dụng đã triển khai. Sơ đồ bám theo code; biểu đồ kết quả được dựng từ log thực chạy.
Comments are closed!