


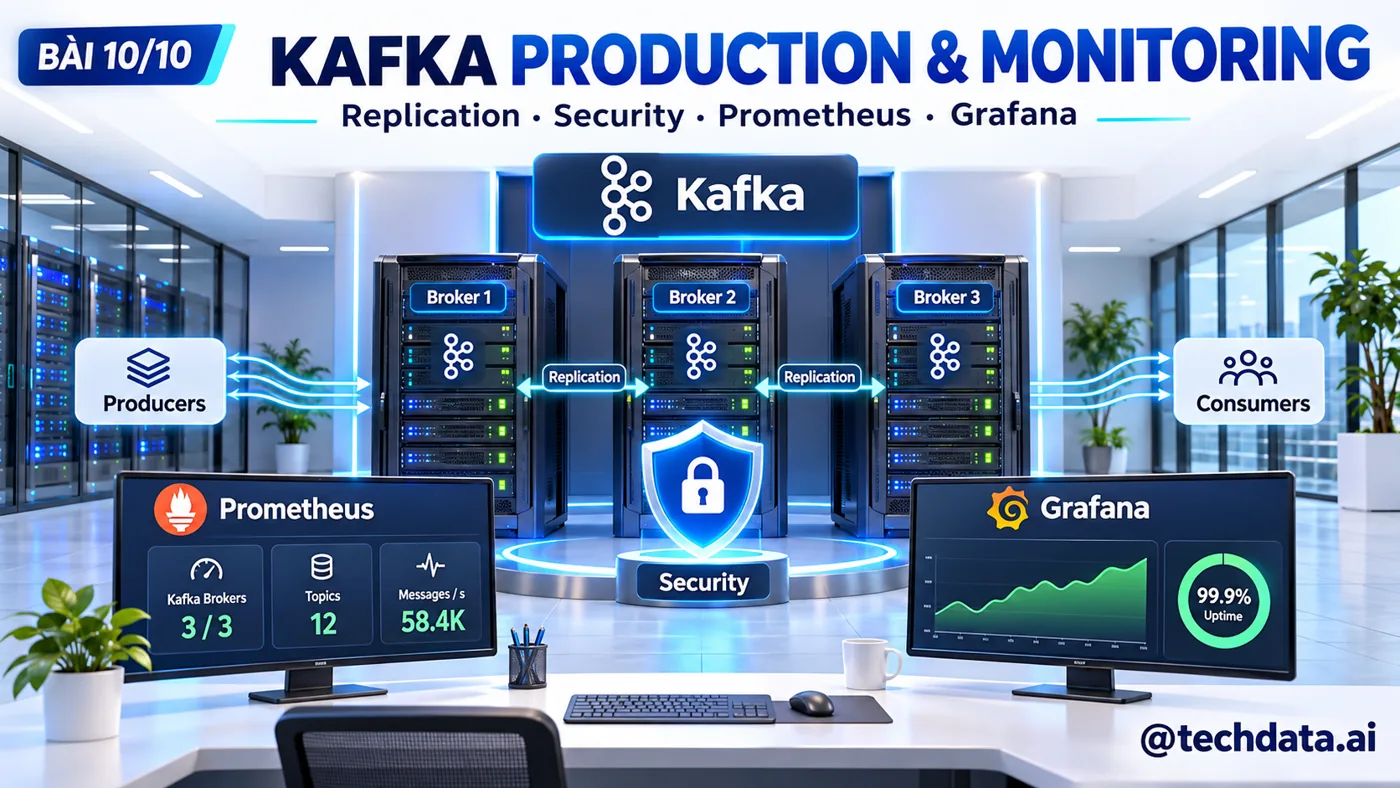

Series Apache Kafka · Bài 10/10. Pipeline chạy được trên laptop là một cột mốc. Nhưng khi nhận đơn hàng thật, câu hỏi tiếp theo là: một broker dừng thì sao, dữ liệu còn bao nhiêu bản sao, ai được đọc topic và làm sao biết consumer đang chậm trước khi khách hàng phản ánh?
Bài cuối ghép những kiến thức trong series thành một cách tiếp cận vận hành có kiểm chứng. Bạn sẽ dựng cụm Kafka KRaft ba node, tạo topic có replication factor 3, gửi dữ liệu với acks=all, dừng một broker, quan sát trên Prometheus và tạo dashboard Grafana. Sau đó, ta bổ sung tư duy bảo mật, dung lượng, nâng cấp và khôi phục để chuyển từ phòng lab sang môi trường doanh nghiệp.
Phạm vi: Compose trong bài là lab local dùng PLAINTEXT và ba node kiêm broker/controller trên cùng một máy. Nó giúp học replication và monitoring, không phải cấu hình production có thể đưa nguyên xi lên Internet. Các phiên bản được pin để đọc cấu hình nhất quán; trước triển khai thật cần chọn bản còn được hỗ trợ, kiểm tra bản vá và kiểm thử nâng cấp.
1. Kết quả cần đạt và kiến trúc
Hãy hình dung Kafka là nơi giữ nhật ký đơn hàng của công ty. Broker lưu các partition; controller quản lý metadata và việc điều phối của cụm. Trong KRaft, các controller cùng duy trì metadata bằng quorum. Ba controller cần đa số là hai để tiếp tục đưa ra quyết định. Việc có đủ controller và việc partition có đủ replica đồng bộ là hai điều kiện khác nhau.
Trong lab, kafka1, kafka2 và kafka3 đều có cả hai vai trò để giảm số container. Production quan trọng thường tách controller khỏi broker để tránh tải đọc/ghi dữ liệu làm ảnh hưởng control plane. Các node phải phân bố trên những miền lỗi phù hợp: ba container trên cùng một VPS vẫn có thể cùng dừng khi VPS hỏng.
| Thành phần | Vai trò trong lab | Địa chỉ truy cập |
|---|---|---|
| 3 Kafka node | Lưu message, sao chép partition và quản lý metadata | kafka1:9092, kafka2:9092, kafka3:9092 trong mạng Docker |
| JMX Exporter | Chuyển MBean của mỗi JVM Kafka thành metric HTTP | Mỗi broker có endpoint nội bộ :7071/metrics |
| Prometheus | Scrape metric định kỳ, lưu time series và đánh giá alert rule | http://127.0.0.1:9090 |
| Grafana | Truy vấn Prometheus, hiển thị dashboard | http://127.0.0.1:3000 |
Broker không publish cổng ra host trong lab này. Ta chạy Kafka CLI bên trong container để tránh nhầm địa chỉ advertised.listeners. Grafana truy cập Prometheus bằng tên dịch vụ prometheus:9090; localhost bên trong Grafana lại trỏ về chính container Grafana. Đây là cùng nguyên tắc mạng đã học ở bài 2.
2. Hiểu đúng replication, ISR và acks
Replication factor 3 nghĩa là mỗi partition có ba replica trên các broker khác nhau. Một replica làm leader; follower lấy dữ liệu từ leader để theo kịp. ISR là tập replica đang đáp ứng điều kiện đồng bộ của Kafka, không đơn giản là danh sách mọi máy còn bật. Một broker sống nhưng ổ đĩa hoặc mạng quá chậm vẫn có thể bị loại khỏi ISR.
min.insync.replicas=2 đặt ngưỡng ISR tối thiểu cho việc ghi với acks=all. Nếu ISR còn hai, một leader và một follower đồng bộ có thể đáp ứng điều kiện. Nếu ISR chỉ còn một, broker từ chối ghi theo cơ chế này để tránh tiếp tục chỉ với một bản sao đồng bộ.
acks=all không có nghĩa là luôn chờ đúng hai broker. Producer yêu cầu xác nhận từ toàn bộ ISR hiện tại theo cơ chế replication của Kafka; min ISR chỉ là ngưỡng tối thiểu. Khi cả ba replica thuộc ISR, cách hiểu “đủ hai là trả thành công” là sai. acks=all cũng không thay thế backup, idempotency nghiệp vụ hay bảo đảm hệ thống đích ghi database đúng một lần.
| Trạng thái partition | Với RF=3, min ISR=2, acks=all | Điều cần nhớ |
|---|---|---|
| ISR có 3 replica | Có thể ghi nếu các điều kiện khác bình thường | Dữ liệu được sao chép trong ISR trước khi xác nhận theo cơ chế Kafka |
| ISR còn 2 replica | Có thể ghi sau quá trình chuyển trạng thái/election nếu cần | Đã mất phần dự phòng còn lại cho một lỗi tiếp theo |
| ISR chỉ còn 1 replica | Ghi bị từ chối hoặc thất bại sau retry/timeout | Không hạ min ISR tùy tiện để che sự cố |
| Mất đa số controller | Metadata quorum không hoạt động bình thường | Khác với thiếu ISR của một partition |
Ta giữ unclean.leader.election.enable=false để không tự động chọn replica ngoài ISR làm leader theo cơ chế unclean election. Điều này ưu tiên tránh mất phần dữ liệu đã được xác nhận, nhưng có thể làm partition không sẵn sàng khi không còn replica phù hợp. Không có cấu hình nào loại bỏ mọi đánh đổi giữa tính sẵn sàng và độ bền dữ liệu.
3. Chuẩn bị thư mục và JMX Exporter
Dùng Linux, macOS hoặc WSL với Docker Engine/Docker Desktop và Docker Compose v2, Python 3, curl. Nên dành khoảng 8 GB RAM cho Docker để lab thoải mái hơn; mỗi Kafka JVM trong ví dụ có heap 512 MB nhưng còn native memory, page cache và các dịch vụ giám sát. Đây là gợi ý cho lab, không phải sizing production. Nếu bài trước vẫn chạy nhiều stack, hãy dừng stack lab không cần thiết trước.
mkdir -p kafka-production-lab/monitoring kafka-production-lab/grafana
cd kafka-production-lab
docker compose version
python3 --version
curl --fail --location --retry 3 \
  https://repo.maven.apache.org/maven2/io/prometheus/jmx/jmx_prometheus_javaagent/1.4.0/jmx_prometheus_javaagent-1.4.0.jar \
  --output monitoring/jmx_prometheus_javaagent.jar
ls -lh monitoring/jmx_prometheus_javaagent.jar
JMX Exporter được gắn trực tiếp vào JVM bằng javaagent. Nhờ vậy không cần mở thêm cổng JMX RMI để Prometheus truy cập. Nếu URL tải về lỗi, curl phải kết thúc với lỗi; đừng thay file JAR bằng một trang HTML rồi tiếp tục. Trong quy trình doanh nghiệp, pin và kiểm tra checksum theo artifact được phê duyệt.
Tạo tất cả file dưới đây trong thư mục kafka-production-lab. Không cần thêm package Python: chương trình sinh Compose chỉ dùng thư viện chuẩn. JSON là một tập con của YAML nên Docker Compose đọc được nội dung JSON trong file compose.yaml. Cách này tránh phải lặp ba đoạn cấu hình broker gần giống nhau.
4. Tạo đầy đủ cấu hình lab
4.1. Chọn metric rõ ràng: monitoring/kafka.yml
lowercaseOutputName: true
lowercaseOutputLabelNames: true
rules:
  - pattern: 'kafka.server<type=ReplicaManager, name=UnderReplicatedPartitions><>Value'
    name: kafka_under_replicated_partitions
    type: GAUGE
  - pattern: 'kafka.server<type=ReplicaManager, name=UnderMinIsrPartitionCount><>Value'
    name: kafka_under_min_isr_partitions
    type: GAUGE
  - pattern: 'kafka.controller<type=KafkaController, name=OfflinePartitionsCount><>Value'
    name: kafka_offline_partitions
    type: GAUGE
  - pattern: 'kafka.server<type=ReplicaManager, name=PartitionCount><>Value'
    name: kafka_partition_replicas
    type: GAUGE
Đây là bộ metric tối thiểu có tên do chúng ta tự đặt để dùng xuyên suốt bài. UnderReplicatedPartitions cho biết số partition trên broker có ISR nhỏ hơn số replica được gán. UnderMinIsrPartitionCount cho biết số partition có ISR dưới ngưỡng min ISR. Hai số này không tương đương: mất một trong ba replica có thể làm under-replicated tăng, trong khi under-min-ISR vẫn bằng 0.
OfflinePartitionsCount là metric controller; không nên ép mọi broker đều phải xuất nó. Khi panel không có dữ liệu, trước tiên kiểm tra endpoint thực tế và MBean ở vai trò tương ứng. Không dùng “or vector(0)” để biến một metric bị thiếu thành trạng thái khỏe. Bộ metric tối thiểu này chưa bao gồm disk, network, độ trễ ứng dụng hay consumer lag.
4.2. Lịch scrape: monitoring/prometheus.yml
global:
  scrape_interval: 15s
  evaluation_interval: 15s

rule_files:
  - /etc/prometheus/alerts.yml

scrape_configs:
  - job_name: kafka
    metrics_path: /metrics
    static_configs:
      - targets:
          - kafka1:7071
          - kafka2:7071
          - kafka3:7071
4.3. Cảnh báo cơ bản: monitoring/alerts.yml
groups:
  - name: kafka-lab
    rules:
      - alert: KafkaMetricsEndpointDown
        expr: up{job="kafka"} == 0
        for: 1m
        labels:
          severity: warning
        annotations:
          summary: "Cannot scrape {{ $labels.instance }}"
      - alert: KafkaUnderReplicated
        expr: kafka_under_replicated_partitions > 0
        for: 2m
        labels:
          severity: warning
        annotations:
          summary: "Replica lag on {{ $labels.instance }}"
      - alert: KafkaUnderMinISR
        expr: kafka_under_min_isr_partitions > 0
        for: 30s
        labels:
          severity: critical
        annotations:
          summary: "ISR below minimum on {{ $labels.instance }}"
for: 2m giúp tránh báo động ngay khi có chuyển trạng thái ngắn trong bảo trì. Ngưỡng này chỉ minh họa; production phải dựa trên SLO, mức độ quan trọng của topic và thời gian phản ứng của đội trực. up=0 nghĩa là Prometheus không scrape được endpoint, chưa đủ kết luận nguyên nhân chính xác là Kafka chết. Exporter, DNS, mạng hoặc chính tiến trình JVM đều cần kiểm tra.
4.4. Provision datasource: grafana/datasource.yml
apiVersion: 1
datasources:
  - name: Prometheus
    uid: prometheus
    type: prometheus
    access: proxy
    url: http://prometheus:9090
    isDefault: true
    editable: false
4.5. Sinh Compose bằng gen_stack.py
import json
from pathlib import Path

services = {}
volumes = {"prometheus_data": {}, "grafana_data": {}}
voters = ",".join(f"{n}@kafka{n}:9093" for n in range(1, 4))

for n in range(1, 4):
    name = f"kafka{n}"
    volumes[f"{name}_data"] = {}
    services[name] = {
        "image": "apache/kafka:4.1.2",
        "hostname": name,
        "environment": {
            "CLUSTER_ID": "MkU3OEVBNTcwNTJENDM2Qk",
            "KAFKA_NODE_ID": str(n),
            "KAFKA_PROCESS_ROLES": "broker,controller",
            "KAFKA_CONTROLLER_QUORUM_VOTERS": voters,
            "KAFKA_LISTENERS": "INTERNAL://:9092,CONTROLLER://:9093",
            "KAFKA_ADVERTISED_LISTENERS": f"INTERNAL://{name}:9092",
            "KAFKA_LISTENER_SECURITY_PROTOCOL_MAP":
                "INTERNAL:PLAINTEXT,CONTROLLER:PLAINTEXT",
            "KAFKA_CONTROLLER_LISTENER_NAMES": "CONTROLLER",
            "KAFKA_INTER_BROKER_LISTENER_NAME": "INTERNAL",
            "KAFKA_LOG_DIRS": "/tmp/kraft-combined-logs",
            "KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR": "3",
            "KAFKA_TRANSACTION_STATE_LOG_REPLICATION_FACTOR": "3",
            "KAFKA_TRANSACTION_STATE_LOG_MIN_ISR": "2",
            "KAFKA_DEFAULT_REPLICATION_FACTOR": "3",
            "KAFKA_MIN_INSYNC_REPLICAS": "2",
            "KAFKA_UNCLEAN_LEADER_ELECTION_ENABLE": "false",
            "KAFKA_AUTO_CREATE_TOPICS_ENABLE": "false",
            "KAFKA_HEAP_OPTS": "-Xms512m -Xmx512m",
            "KAFKA_OPTS":
                "-javaagent:/opt/jmx/jmx_prometheus_javaagent.jar=7071:/opt/jmx/kafka.yml",
        },
        "volumes": [
            f"{name}_data:/tmp/kraft-combined-logs",
            "./monitoring/jmx_prometheus_javaagent.jar:/opt/jmx/jmx_prometheus_javaagent.jar:ro",
            "./monitoring/kafka.yml:/opt/jmx/kafka.yml:ro",
        ],
    }

services["prometheus"] = {
    "image": "prom/prometheus:v3.5.0",
    "ports": ["127.0.0.1:9090:9090"],
    "volumes": [
        "./monitoring/prometheus.yml:/etc/prometheus/prometheus.yml:ro",
        "./monitoring/alerts.yml:/etc/prometheus/alerts.yml:ro",
        "prometheus_data:/prometheus",
    ],
}
services["grafana"] = {
    "image": "grafana/grafana:12.1.1",
    "ports": ["127.0.0.1:3000:3000"],
    "environment": {
        "GF_SECURITY_ADMIN_USER": "admin",
        "GF_SECURITY_ADMIN_PASSWORD": "${GRAFANA_ADMIN_PASSWORD:?Set GRAFANA_ADMIN_PASSWORD}",
        "GF_USERS_ALLOW_SIGN_UP": "false",
    },
    "volumes": [
        "grafana_data:/var/lib/grafana",
        "./grafana/datasource.yml:/etc/grafana/provisioning/datasources/prometheus.yml:ro",
    ],
}

Path("compose.yaml").write_text(
    json.dumps({"name": "kafka-production-lab",
                "services": services, "volumes": volumes}, indent=2),
    encoding="utf-8",
)
print("Created compose.yaml")
Cả ba node dùng chung CLUSTER_ID, nhưng NODE_ID và volume riêng. Không đổi cluster ID trên volume đã format rồi mong Kafka tự coi đó là cụm mới. KAFKA_LOG_DIRS trùng chính xác nơi mount volume để dữ liệu không nằm nhầm trong lớp ghi tạm của container. Khi gỡ container rồi tạo lại, named volume vẫn giữ dữ liệu; nó chưa bảo vệ bạn khỏi mất ổ đĩa của host.
Ba INTERNAL listener quảng bá đúng tên kafka1, kafka2, kafka3 trong mạng Docker. Controller dùng 9093 nội bộ, không nằm trong advertised listener của client. Prometheus và Grafana chỉ bind loopback của host. Nếu học trên máy từ xa, dùng đường truy cập quản trị riêng phù hợp thay vì đổi thành cổng public không xác thực.
5. Khởi động, tạo topic và gửi đơn hàng
5.1. Chạy stack và kiểm tra readiness
Tạo file .env bằng trình soạn thảo, đặt GRAFANA_ADMIN_PASSWORD thành mật khẩu riêng đủ mạnh cho lab. Đừng commit file này vào Git. Giá trị được Compose truyền cho Grafana khi khởi tạo database lần đầu; đổi biến sau đó không tự đổi mật khẩu của tài khoản đã tồn tại trong volume. Không dùng giá trị mẫu trên môi trường có người khác truy cập.
GRAFANA_ADMIN_PASSWORD=replace_with_your_own_lab_passwordpython3 gen_stack.py
docker compose config --quiet
docker compose pull
docker compose up -d
docker compose ps
docker compose logs --tail=80 kafka1 kafka2 kafka3config --quiet kiểm tra Compose có hợp lệ và đủ biến môi trường; nó chưa chứng minh Kafka đã sẵn sàng. Container ở trạng thái Up cũng chưa đủ. Nếu log báo JAR không đọc được, hãy kiểm tra đường dẫn mount và quyền đọc; nếu báo cluster ID hoặc node ID không khớp, kiểm tra volume cũ. Đừng xóa volume để xử lý lỗi một cách mù quáng.
Định nghĩa hàm tiện ích trong terminal đang đứng ở thư mục lab. Mỗi terminal mới cần khai báo lại hàm này. -T giữ stdin hoạt động tốt cho pipe và here-document. -e KAFKA_OPTS= chỉ bỏ javaagent khỏi JVM của lệnh CLI; tiến trình broker đang chạy vẫn giữ exporter. Nếu để CLI kế thừa javaagent, nó có thể cố mở lại cổng 7071 đã bị broker chiếm.
kcli() {
  local script="$1"
  shift
  docker compose exec -T -e KAFKA_OPTS= kafka1 "/opt/kafka/bin/$script" "$@"
}

kcli kafka-metadata-quorum.sh \
  --bootstrap-server kafka1:9092 describe --status

kcli kafka-topics.sh --bootstrap-server kafka1:9092 --list
Chạy trong Bash hoặc Zsh. Khi cụm vừa khởi động, đợi log ổn định rồi kiểm tra lại nếu lệnh chưa kết nối được. Kết quả quorum phải có leader hợp lệ; ID cụ thể tùy election, không bắt buộc node 1. Nếu JVM liên tục restart, điều tra log trước khi tạo topic.
5.2. Tạo topic rõ cấu hình
kcli kafka-topics.sh --bootstrap-server kafka1:9092 \
  --create --topic orders.prod.lab \
  --partitions 3 --replication-factor 3 \
  --config min.insync.replicas=2 \
  --config retention.ms=86400000 \
  --config unclean.leader.election.enable=false

kcli kafka-topics.sh --bootstrap-server kafka1:9092 \
  --describe --topic orders.prod.lab
Mỗi dòng partition phải có Leader hợp lệ, Replicas gồm ba ID và ISR gồm ba ID sau khi cụm đồng bộ. Thứ tự replica không cố định. Nếu chạy lại lệnh create, lỗi TopicExistsException chỉ có nghĩa topic đã có; hãy describe và kiểm tra cấu hình thay vì xóa topic. retention.ms đặt một ngày cho lab; Kafka dọn theo segment và chu kỳ kiểm tra nên không xóa chính xác từng message đúng thời điểm tròn 24 giờ.
5.3. Producer xác nhận bền hơn và consumer kiểm chứng
kcli kafka-console-producer.sh \
  --bootstrap-server kafka1:9092,kafka2:9092,kafka3:9092 \
  --topic orders.prod.lab \
  --producer-property acks=all \
  --producer-property enable.idempotence=true <<'EOF'
{"event_id":"prod-001","order_id":1,"amount":250000}
{"event_id":"prod-002","order_id":2,"amount":180000}
EOF

kcli kafka-console-consumer.sh \
  --bootstrap-server kafka1:9092,kafka2:9092,kafka3:9092 \
  --topic orders.prod.lab --from-beginning \
  --group prod-check --max-messages 2 --timeout-ms 15000
Nếu lab mới, consumer in hai JSON vừa gửi. Đây là kết quả mong đợi để bạn đối chiếu, không phải số liệu benchmark. Với group đã có committed offset, --from-beginning không tự ghi đè offset đã commit. Muốn kiểm tra độc lập, chọn group mới; khi topic có nhiều message cũ, --max-messages 2 cũng có thể chỉ đọc hai bản cũ.
enable.idempotence giúp producer tránh ghi lặp do retry trong phạm vi cơ chế idempotent producer. Nó không ngăn người dùng chạy lại chương trình gửi cùng một đơn và không chống ghi trùng ở PostgreSQL. event_id và ràng buộc unique ở hệ thống đích vẫn cần thiết như bài 5 và bài 8. Với Python client trong production, phải kiểm tra delivery callback, lỗi flush và trạng thái gửi, không chỉ log “đã gọi produce”.
6. Dừng một broker và quan sát phục hồi
Mở Prometheus trước tại http://127.0.0.1:9090/targets, kiểm tra cả ba target job kafka đều UP. Tại trang query, chạy up{job="kafka"}. Sau đó dừng kafka3, giữ kafka1 làm nơi thực thi CLI:
docker compose stop kafka3

kcli kafka-topics.sh --bootstrap-server kafka1:9092 \
  --describe --topic orders.prod.lab
Ngay khi dừng có thể xuất hiện khoảng chuyển trạng thái, retry hoặc election; đừng coi “không gián đoạn một mili giây” là tiêu chí. Sau khi ổn định, ISR của mỗi partition còn hai replica. Partition từng có leader trên kafka3 phải có leader mới đủ điều kiện. Hai controller còn lại vẫn là đa số của quorum ba node.
kcli kafka-console-producer.sh \
  --bootstrap-server kafka1:9092,kafka2:9092 \
  --topic orders.prod.lab \
  --producer-property acks=all \
  --producer-property enable.idempotence=true \
  --producer-property delivery.timeout.ms=30000 <<'EOF'
{"event_id":"prod-after-stop","order_id":3,"amount":320000}
EOF

kcli kafka-console-consumer.sh \
  --bootstrap-server kafka1:9092,kafka2:9092 \
  --topic orders.prod.lab --from-beginning \
  --group prod-failover-check --max-messages 3 --timeout-ms 30000
Trên topic mới chỉ có ba event của bài, group mới phải đọc được cả ba. Trong Prometheus, endpoint kafka3 chuyển DOWN sau lần scrape kế tiếp. Under-replicated trên các broker còn sống có thể tăng, trong khi under-min-ISR vẫn bằng 0 vì vẫn đủ hai replica đồng bộ. Dữ liệu lịch sử của target đã dừng có thể còn hiển thị trong một số truy vấn theo thời gian; hãy nhìn nhãn instance và up cùng thời điểm.
Không dừng tiếp kafka2 để rồi kết luận mọi lỗi chỉ do min ISR. Vì lab dùng combined roles, mất hai node đồng thời làm mất cả đa số controller lẫn hai broker dữ liệu. Muốn cô lập thử nghiệm min ISR, hãy thiết kế lab có controller riêng và kiểm soát replica của partition. Đây là lý do phải phân biệt control plane với data plane khi giải thích sự cố.
docker compose start kafka3

kcli kafka-topics.sh --bootstrap-server kafka1:9092 \
  --describe --topic orders.prod.lab

kcli kafka-metadata-quorum.sh \
  --bootstrap-server kafka1:9092 describe --replication
Đợi kafka3 bắt kịp, kiểm tra ISR trở lại ba và metric under-replicated về 0. Container chạy lại chưa có nghĩa replica đã đồng bộ xong. Trong production, chỉ bảo trì node tiếp theo sau khi xác nhận cụm đủ khỏe, không dựa vào một khoảng sleep cố định. Quorum replication ở lệnh sau là trạng thái metadata, còn topic describe cho biết replica của topic; cần đọc đúng đối tượng.
7. Prometheus, Grafana và cảnh báo có thể hành động
7.1. Kiểm tra nguồn dữ liệu trước khi vẽ panel
Trong Prometheus, mở Targets và chọn endpoint của từng broker. Xác nhận endpoint trả metric kafka_under_replicated_partitions và kafka_under_min_isr_partitions. Nếu target UP nhưng query rỗng, HTTP scrape thành công chưa chứng minh regex exporter đã khớp MBean. Kiểm tra tên metric thực tế và file kafka.yml, sau khi sửa cần restart broker vì javaagent được nạp lúc JVM khởi động.
up{job="kafka"}

kafka_under_replicated_partitions

kafka_under_min_isr_partitions

sum(kafka_under_replicated_partitions)

sum(kafka_under_min_isr_partitions)
Chạy từng biểu thức riêng. Hai phép sum dùng như tín hiệu tổng hợp trên các broker; chúng không nhất thiết là số partition duy nhất vì các metric có ngữ nghĩa theo broker và replica. Để điều tra, giữ bảng theo instance thay vì chỉ nhìn một con số tổng. Tên metric trong ví dụ do exporter rule của bài định nghĩa; không lấy tên từ một dashboard khác rồi mặc định luôn có.
7.2. Tạo dashboard Grafana
Mở http://127.0.0.1:3000, đăng nhập admin với mật khẩu đã đặt. Datasource Prometheus đã được provision bằng file. Vào Dashboards, tạo dashboard mới, Add visualization và chọn Prometheus. Dùng các panel dưới đây; đặt refresh 15s hoặc 30s và cửa sổ thời gian khoảng 15 phút khi làm bài thử dừng broker.
| Panel | PromQL | Cách đọc |
|---|---|---|
| Broker metrics endpoint | up{job="kafka"} | Stat theo instance: 1 scrape được, 0 scrape lỗi |
| Under-replicated theo broker | kafka_under_replicated_partitions | Time series; bình thường kỳ vọng 0, xem tăng trong bảo trì |
| Dưới min ISR | kafka_under_min_isr_partitions | Stat hoặc time series; giá trị dương cần ưu tiên xử lý |
| Replica được giữ trên broker | kafka_partition_replicas | Dùng đối chiếu phân bố replica, không cộng thành số logical partition duy nhất |
Panel đỏ phải dẫn tới runbook: broker nào, topic nào, thời điểm nào, vừa có deploy hoặc bảo trì không. Với production, thêm request latency, lỗi produce/fetch, controller health, disk usage, disk latency, network, JVM GC và end-to-end freshness. Metric ổ đĩa thường cần node exporter hoặc hệ thống giám sát hạ tầng riêng; heap thấp không chứng minh host còn đủ RAM hay disk còn an toàn.
7.3. Alert rule chưa đồng nghĩa đã gửi thông báo
Trang Alerts của Prometheus cho thấy Inactive, Pending rồi Firing theo biểu thức và khoảng for. Trong lab này, rule được đánh giá và hiển thị tại đó; chưa cấu hình Alertmanager và chưa tự gửi email, Slack hoặc Telegram. Muốn gửi thông báo trong production, cần thêm Alertmanager, route/receiver, thông tin xác thực được quản lý đúng và một lần diễn tập xác nhận người trực thực sự nhận được cảnh báo.
Nếu Prometheus hoặc toàn bộ pipeline giám sát dừng, rule ở chính Prometheus không tự cứu được nó. Cần giám sát từ bên ngoài cho hệ thống monitoring, kiểm tra khả năng gửi thông báo và phân công người chịu trách nhiệm. Cảnh báo tốt có mức độ, thời gian bắt đầu, phạm vi ảnh hưởng và bước kiểm tra đầu tiên.
7.4. Consumer lag không nằm trong bộ broker JMX tối thiểu
kcli kafka-consumer-groups.sh --bootstrap-server kafka1:9092 \
  --describe --group prod-check
CURRENT-OFFSET là offset group đã commit; LOG-END-OFFSET là vị trí cuối log; LAG phản ánh khoảng cách theo offset. Nếu consumer xử lý xong nhưng commit chậm, lag có thể lớn hơn lượng công việc thực sự chưa xử lý. Sau consumer ngắn của lab, group có thể chưa có offset như kỳ vọng; hãy kiểm tra output thay vì suy ra mọi group đều có dữ liệu. Muốn dashboard lag liên tục, bổ sung exporter đọc consumer-group offsets hoặc telemetry phù hợp từ client, với quyền tối thiểu cần thiết.
Một triệu message backlog không tự nói lên trễ bao lâu: với 100.000 message/giây khác hẳn 100 message/giây. Theo dõi thêm tuổi event cũ nhất chưa xử lý hoặc độ trễ từ event_time đến khi kết quả sẵn sàng. Nếu database đích chậm, tăng broker không giải quyết đúng nút thắt. Trước khi tăng consumer, kiểm tra số partition, khóa database, batch size và thời gian xử lý mỗi event.
8. TLS, SASL và ACL trong production
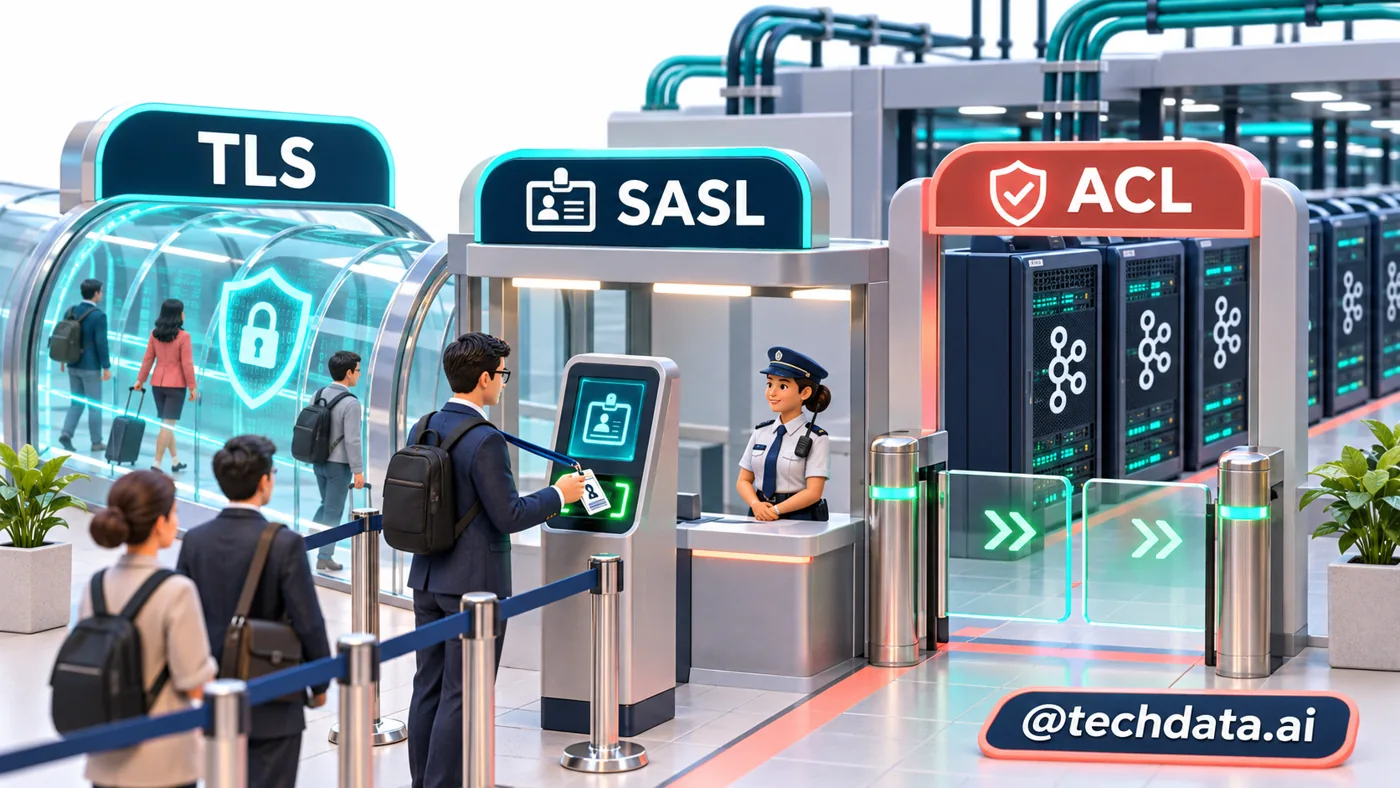
Ba lớp giải quyết ba câu hỏi riêng. TLS: dữ liệu đi trên mạng có được mã hóa và endpoint có được kiểm chứng không? SASL: client đang dùng danh tính nào? ACL: danh tính đó được ghi topic, đọc topic và dùng consumer group nào? Có TLS nhưng mọi ứng dụng dùng chung tài khoản admin vẫn chưa đạt nguyên tắc phân quyền tối thiểu.
Khi thiết kế listener production, tách endpoint client, inter-broker và controller theo kiến trúc mạng. Dùng tên DNS khớp SAN của certificate, truststore chứa CA phù hợp và giữ hostname verification. Không sửa ssl.endpoint.identification.algorithm thành rỗng để che lỗi certificate. Controller và inter-broker cũng cần được bảo vệ, không chỉ listener cho ứng dụng bên ngoài.
SCRAM qua SASL_SSL là một phương án xác thực phổ biến; cũng có thể dùng mTLS hoặc cơ chế khác theo hạ tầng. Với KRaft, thông tin SCRAM được lưu trong metadata log; tài khoản inter-broker phải sẵn sàng đúng giai đoạn bootstrap. Không bật một loạt cấu hình bảo mật trên cụm đang phục vụ rồi kỳ vọng tự chuyển đổi không gián đoạn. Cần kế hoạch tạo credential, certificate, quyền cho controller/broker và chuyển client theo từng bước.
8.1. Phân quyền theo vai trò ứng dụng
| Danh tính | Quyền cần thiết theo ví dụ | Không nên cấp |
|---|---|---|
| order-api | Ghi orders.created và quyền bổ sung thực sự cần cho chế độ producer | Đọc mọi topic, xóa topic, quản trị toàn cluster |
| order-worker | Đọc orders.created, dùng group order-workers, ghi topic retry/DLT nếu có | Dùng group tùy ý hoặc đọc dữ liệu phòng ban khác |
| metrics-reader | Đọc metadata/offset cần cho exporter lag theo thiết kế | Tài khoản super user chung với ứng dụng |
| platform-admin | Quyền quản trị có kiểm soát và audit | Credential chia sẻ trong repository hoặc image |
StandardAuthorizer trong KRaft dùng lớp org.apache.kafka.metadata.authorizer.StandardAuthorizer. Việc bật authorizer cần cấu hình đúng trên các node liên quan và bảo đảm principal hạ tầng có quyền cần thiết. ACL không thay thế network policy. Giới hạn firewall để chỉ client, broker và hệ thống quản trị được phép kết nối đúng cổng. Endpoint metrics, Prometheus và Grafana cũng chứa thông tin vận hành cần bảo vệ.
8.2. Ví dụ lệnh ACL cho cụm ĐÃ cấu hình xác thực
Các lệnh sau minh họa việc cấp quyền trên một cụm SASL_SSL đã bootstrap xong. Chúng không chạy trực tiếp với lab PLAINTEXT phía trên. File admin.properties phải chứa cấu hình client, CA và credential quản trị của môi trường thực tế; không đưa file đó vào bài viết, Git hoặc log CI. Thay bootstrap DNS và tên principal theo hệ thống của bạn.
bin/kafka-acls.sh --bootstrap-server broker1.example.internal:9094 \
  --command-config admin.properties \
  --add --allow-principal User:order-api \
  --producer --topic orders.created

bin/kafka-acls.sh --bootstrap-server broker1.example.internal:9094 \
  --command-config admin.properties \
  --add --allow-principal User:order-worker \
  --consumer --topic orders.created --group order-workers

bin/kafka-acls.sh --bootstrap-server broker1.example.internal:9094 \
  --command-config admin.properties --list
Preset --producer có thể cấp cả quyền Create cùng Write/Describe theo công cụ và phiên bản. Nếu tổ chức chỉ cho platform team tạo topic, dùng ACL operation cụ thể thay vì giữ preset rộng hơn nhu cầu. Producer idempotent/transactional còn có yêu cầu quyền riêng tùy cơ chế và phiên bản, ví dụ transactional ID. Phải kiểm tra chính xác bằng client thật: ứng dụng được phép làm việc cần làm, đồng thời bị từ chối khi thử đọc topic ngoài phạm vi.
Vòng đời secret quan trọng không kém lần cài đầu: ai tạo, lưu ở đâu, xoay vòng thế nào, ứng dụng reload ra sao và thu hồi khi nhân sự/ứng dụng ngừng sử dụng. Certificate cần cảnh báo trước ngày hết hạn. Đợt diễn tập nên bao gồm cả tình huống credential sai hoặc hết hạn để phân biệt lỗi authentication với authorization.
9. Tính dung lượng và tối ưu hiệu năng
9.1. Từ tốc độ event đến dung lượng đĩa
Giả sử mỗi ngày có 20 triệu event, payload trung bình 1 KB theo hệ thập phân. Payload thô khoảng 20 GB/ngày. Giữ bảy ngày và replication factor 3 cho ra khoảng 420 GB dữ liệu nhân bản trên toàn cụm, trước khi xét compression, index, metadata và khoảng trống phục vụ vận hành. Nếu nén còn 50%, phần payload lưu có thể giảm; đây là giả định để tính, phải đo trên dữ liệu thực.
Không chia tổng dung lượng cho ba rồi chọn ổ đĩa vừa khít. Topic có thể lệch kích thước, key có thể gây hot partition, quá trình reassign cần chỗ trống và một broker hỏng buộc các broker còn lại gánh thêm tải. Đặt ngưỡng cảnh báo và khoảng dự phòng từ tốc độ tăng thực tế, thời gian mua thêm tài nguyên và yêu cầu phục hồi. Theo dõi thời gian còn lại trước khi đầy đĩa thay vì chỉ phần trăm sử dụng.
Retention phải đủ để consumer phục hồi sau sự cố. Nếu dữ liệu chỉ giữ một ngày nhưng hệ thống đích dừng hai ngày, phần log cũ có thể đã bị dọn trước khi consumer đọc. Kafka giữ log theo retention, không giữ vô hạn chỉ vì có consumer chưa xử lý. Với compaction, việc giữ giá trị cuối theo key cũng không tương đương một lịch sử đầy đủ để audit.
9.2. Tối ưu theo nút thắt đã đo
| Triệu chứng | Kiểm tra trước | Hướng thử nghiệm |
|---|---|---|
| Producer throughput thấp | Kích thước batch, RTT, CPU, compression, lỗi retry | Đo batching/linger và compression với payload thực, giữ mục tiêu latency |
| Consumer lag tăng | Thời gian xử lý event, database sink, partition skew | Batch ghi đích, tối ưu truy vấn, tăng consumer trong giới hạn partition |
| Một broker nóng | Phân bố leader, replica, hot key, disk latency | Rebalance có kiểm soát, xem lại key và tải partition |
| GC hoặc RAM cao | Heap, native memory, page cache, số partition, buffer | Điều chỉnh sau đo đạc; không dành toàn bộ RAM host cho JVM |
| Mạng tăng khi bảo trì | Replica catch-up, reassignment, client fetch | Throttling và lịch thay đổi phù hợp, chừa headroom |
Tăng partition không tự làm mọi pipeline nhanh hơn. Nó tăng khả năng song song nhưng cũng tăng chi phí metadata, file và quản lý. Thứ tự chỉ được bảo đảm trong từng partition; thay số partition có thể đổi cách key được ánh xạ trong producer sử dụng hash partitioning. Với bài toán cần thứ tự theo order_id, phải đánh giá tác động này trước khi thay đổi.
9.3. Benchmark nhỏ, có giới hạn
Lệnh dưới dùng topic riêng, tạo 10.000 record 512 byte và giới hạn 1.000 record/giây. Chỉ chạy trên lab; đây là phép kiểm tra đường đi và đọc metric, không đại diện năng lực production. Đo cả latency và lỗi dưới tải bình thường lẫn khi một broker dừng. Không chạy benchmark không giới hạn trên cụm đang phục vụ khách hàng.
kcli kafka-topics.sh --bootstrap-server kafka1:9092 \
  --create --topic perf.lab --partitions 3 --replication-factor 3 \
  --config min.insync.replicas=2 --config retention.ms=3600000

kcli kafka-producer-perf-test.sh --topic perf.lab \
  --num-records 10000 --record-size 512 --throughput 1000 \
  --producer-props bootstrap.servers=kafka1:9092,kafka2:9092,kafka3:9092 \
  acks=all enable.idempotence=true compression.type=lz4
Ghi lại cấu hình máy, phiên bản, số partition, kích thước record, compression, acks, throughput và percentile latency nếu công cụ xuất ra. So sánh phải giữ điều kiện nhất quán. Kết quả đẹp trên payload lặp dễ nén không thể dùng để cam kết tải cho JSON doanh nghiệp có kích thước và entropy khác.
10. Runbook vận hành, nâng cấp và khôi phục
10.1. Khi nhận cảnh báo
Bắt đầu bằng phạm vi ảnh hưởng: produce có lỗi không, consumer nào chậm và báo cáo nào trễ? Tiếp theo, kiểm tra broker process, disk, network, controller quorum và ISR. Đối chiếu mốc deploy, thay certificate, tăng tải hoặc bảo trì. Lưu thông tin trước khi restart để tránh xóa mất dấu vết. Restart toàn bộ cụm thường làm việc điều tra và phục hồi khó hơn.
docker compose ps
docker compose logs --since=10m --tail=200 kafka1 kafka2 kafka3

kcli kafka-topics.sh --bootstrap-server kafka1:9092 \
  --describe --under-replicated-partitions

kcli kafka-metadata-quorum.sh \
  --bootstrap-server kafka1:9092 describe --status

kcli kafka-consumer-groups.sh --bootstrap-server kafka1:9092 \
  --describe --group prod-check
Nếu kafka1 là node hỏng, đổi dịch vụ thực thi CLI và bootstrap sang broker còn sống. Phần lệnh này giả định lab và tên group của bài; production cần endpoint quản trị, client security config và quy trình thu thập log phù hợp. Không gửi nguyên log chứa credential hoặc payload nhạy cảm vào kênh công khai.
10.2. Bảo trì từng node
Trước bảo trì, kiểm tra không có partition dưới min ISR, replica đã đồng bộ, quorum đủ khỏe và các broker còn lại còn tài nguyên. Dừng một node, xác nhận client hồi phục, đưa node lên rồi đợi ISR đủ trước node kế tiếp. Với cụm tách vai trò, có quy trình riêng cho controller và broker. Trong lúc bảo trì có kế hoạch, silence đúng phạm vi và thời hạn; không tắt toàn bộ cảnh báo.
Nâng cấp Kafka còn liên quan phiên bản metadata, khả năng tương thích client và giới hạn downgrade. Đọc upgrade guide đúng cặp phiên bản, thử trên staging và xác định bước nào còn rollback được trước khi thực hiện. Không thay image của cả ba node đồng thời. Lưu cấu hình đã phê duyệt và ghi lại thay đổi để đối chiếu khi sự cố xuất hiện.
10.3. Replication không thay thế kế hoạch khôi phục
Nếu người dùng có quyền xóa topic và thực hiện xóa, các replica cũng phản ánh thay đổi đó. Nếu toàn bộ ổ đĩa trong cùng miền lỗi mất, RF=3 trên ba container của host không giúp lấy lại dữ liệu. Cần xác định RPO, lượng dữ liệu có thể chấp nhận mất, và RTO, thời gian cần khôi phục dịch vụ, cho từng pipeline.
Tùy nhu cầu, doanh nghiệp có thể lưu event gốc ở object storage, sao chép sang cluster ở miền lỗi khác hoặc dùng cơ chế bảo vệ dữ liệu được hỗ trợ bởi nền tảng. Sao chép liên cluster cũng không tự đồng nghĩa backup bất biến. Kế hoạch phải bao gồm topic configuration, ACL, schema, Connect configuration, consumer offsets và cách dựng lại hệ thống đích; không chỉ có file log Kafka.
Diễn tập phục hồi trên môi trường tách biệt: tái tạo topic và quyền, replay một khoảng event, đo thời gian sink bắt kịp, đối soát số đơn và tổng tiền, kiểm tra chống ghi trùng. Đừng reset offset production chỉ vì muốn “chạy lại thử”. Reset cần dừng group theo yêu cầu công cụ và đánh giá tác động nghiệp vụ ở sink như đã học trong bài 8.
10.4. Dừng lab đúng cách
docker compose downLệnh trên dừng và gỡ container/network của stack, giữ named volume. Không thêm -v nếu muốn giữ dữ liệu Kafka, Prometheus và Grafana. Khi chủ động tạo lại lab sạch, hãy hiểu rõ việc xóa volume sẽ xóa dữ liệu tương ứng. Bài không yêu cầu áp dụng bất kỳ lệnh nào lên server production của bạn.
11. Bài tập nghiệm thu cuối series
Một bài lab hoàn thành khi bạn chứng minh được hành vi bằng kết quả, thay vì chỉ chụp màn hình container Up. Lưu lại những quan sát sau vào ghi chú thực hành của mình:
- Cụm khỏe: topic có ba partition, mỗi partition ba replica, ISR đủ ba; metadata quorum có leader hợp lệ.
- Gửi và đọc: event trước và sau khi dừng kafka3 đều đọc được bằng group mới trên topic lab sạch.
- Giám sát: Prometheus có ba target UP lúc bình thường; dừng một broker làm target tương ứng DOWN và thấy alert chuyển trạng thái sau khoảng for.
- Phục hồi: khởi động lại broker, đợi ISR đủ; giải thích vì sao Up chưa đủ chứng minh đã phục hồi.
- Phân biệt lỗi: giải thích được under-replicated khác under-min-ISR, consumer lag khác độ trễ end-to-end và quorum khác ISR.
- Thiết kế production: viết kế hoạch failure domain, listener bảo mật, tài khoản ứng dụng, retention, dung lượng, người trực và diễn tập restore.
Bài tập mở rộng: ghép consumer PostgreSQL của bài 5 vào cluster này bằng mạng Docker và bootstrap nội bộ phù hợp. Tạo backlog có kiểm soát bằng cách làm chậm sink, quan sát lag, tăng worker trong giới hạn partition rồi đối chiếu unique event_id ở database. Kết quả cần chứng minh cả tốc độ phục hồi lẫn số liệu đúng; thêm worker mà doanh thu bị cộng hai lần vẫn là một pipeline sai.
Tự kiểm tra: với RF=3, min ISR=2 và ISR hiện có ba replica, acks=all có chỉ chờ đúng hai replica không? Không. Khi một broker dừng, vì sao under-replicated có thể tăng mà ghi vẫn tiếp tục? Vì ISR còn đủ hai và các điều kiện leader/quorum vẫn đáp ứng. Vì sao không được dùng thử nghiệm dừng hai combined node để chứng minh riêng min ISR? Vì đồng thời mất đa số controller.
Qua mười bài, bạn đã đi từ Kafka là gì, cài KRaft, viết Python producer/consumer, chia partition và consumer group đến xử lý đơn hàng, CDC, analytics, retry/DLT, Spark Streaming và vận hành. Khi đưa một pipeline vào doanh nghiệp, hãy giữ ba tiêu chí đi cùng nhau: dữ liệu đúng, dịch vụ hồi phục được và đội vận hành biết điều gì đang xảy ra.
Ôn phần xử lý stream: Bài 9: Kafka kết hợp Apache Spark Structured Streaming. Ôn xử lý lỗi và replay: Bài 8: Retry, Dead Letter Topic và chống xử lý trùng.
12. Tài liệu tham khảo
- Apache Kafka 4.1: Monitoring và ý nghĩa các MBean
- Kafka broker configuration: min ISR, retention, replication
- Kafka authorization và ACL với StandardAuthorizer
- Kafka authentication bằng SASL
- Prometheus JMX Exporter 1.4.0: deployment modes
- Prometheus: alerting rules và trạng thái cảnh báo
- Grafana: provisioning datasource và dashboard