



Bạn nhìn một ảnh nhỏ và nhận ra đó là áo, túi hay giày gần như ngay lập tức. Máy tính ban đầu chỉ nhận được một bảng số. Vậy làm sao một mạng nơ-ron biến những con số ấy thành dự đoán? Nó học điều gì khi xem hàng nghìn ảnh, và vì sao vẫn có thể nhầm một chiếc áo thành áo khoác?
Deep Learning là cách học các phép biến đổi qua nhiều lớp để tạo ra dự đoán từ dữ liệu. Để hiểu nó, không cần bắt đầu bằng một mạng khổng lồ. Bài này đi từ một neuron với vài con số dễ tính, rồi xây một thí nghiệm nhận diện quần áo bằng PyTorch. Bạn sẽ thấy ảnh đầu vào thật, cách ảnh trở thành pixel, vòng học, kết quả đo và cả những ảnh mô hình dự đoán sai.
Nếu bài PyTorch từ A tới Z giúp bạn làm quen công cụ, bài này tập trung vào tư duy: học khác học thuộc thế nào, vì sao activation quan trọng, nên so sánh với mô hình đơn giản ra sao và cần kiểm tra gì trước khi tin một accuracy. Code chạy trên CPU; các kết quả thực nghiệm được ghi rõ phạm vi để bạn tự đối chiếu.
Deep Learning thực sự đang học cái gì?
Một chương trình quy tắc có thể kiểm tra màu, độ rộng hoặc một số vùng sáng rồi quyết định nhãn. Cách này đòi hỏi con người mô tả trước những dấu hiệu cần tìm. Với mạng nơ-ron, ta chọn một cấu trúc gồm các phép tính có tham số. Dữ liệu có nhãn cho biết đáp án; quá trình tối ưu điều chỉnh tham số để đầu ra của mạng phù hợp hơn với các đáp án đó.
Bạn có thể hình dung trọng số như các núm điều chỉnh bên trong một máy biến đổi tín hiệu. Ban đầu, chúng chưa được chỉnh cho bài toán. Mạng đoán, ta đo sai số rồi điều chỉnh. Nhưng đây chỉ là phép ví von để hình dung. Một neuron nhân tạo không phải bản sao đầy đủ của tế bào thần kinh, và việc mạng dự đoán đúng một nhãn không có nghĩa nó hiểu món đồ như con người.
Điều được lưu sau huấn luyện chủ yếu là các tham số đã học cùng cấu hình cần để sử dụng chúng. Mô hình không nhất thiết tra lại một bảng gồm tất cả ảnh đã xem mỗi khi dự đoán. Tuy nhiên, khả năng ghi nhớ mẫu vẫn có thể xuất hiện; vì thế cần đo trên dữ liệu không dùng để cập nhật trọng số. Một mô hình giỏi trên bài tập đã xem chưa đủ để chứng minh nó làm tốt với ảnh mới.
Trong thực tế, cần tách ba quyết định: dữ liệu nói về điều gì, đầu ra có ý nghĩa gì và sai theo kiểu nào là quan trọng. Phân loại áo và giày khác với nhận diện một mặt hàng cụ thể trong kho. Bài lab bên dưới chỉ chọn một trong mười nhóm quần áo, không nhận diện thương hiệu, chất liệu hay mã sản phẩm.
Từ một chiếc áo tới 784 con số
Bộ dữ liệu Fashion-MNIST của Zalando Research gồm ảnh xám 28×28 pixel thuộc mười lớp, với 60.000 ảnh train và 10.000 ảnh test trong bản gốc. Mỗi pixel có giá trị biểu diễn độ sáng. Các hình quần áo trong phần thực hành bên dưới được lấy từ dataset này, không phải ảnh do AI tạo để giả làm kết quả.
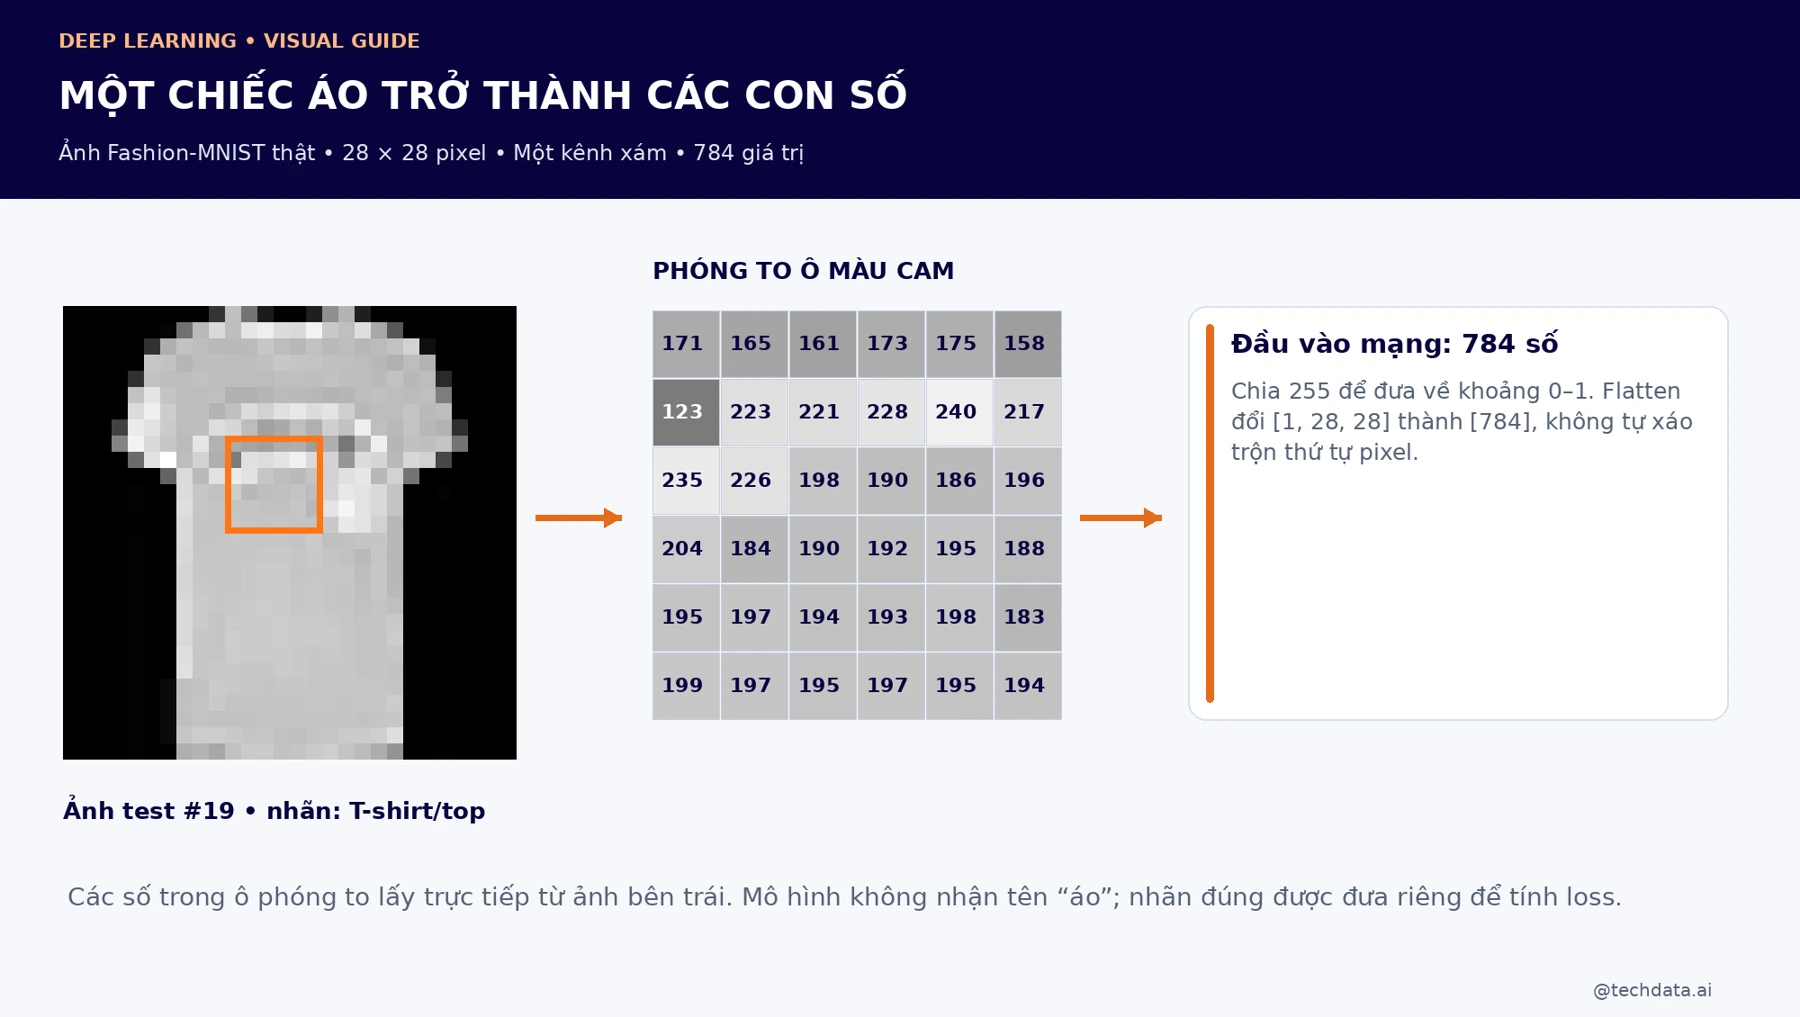
Trong hình, vùng màu cam được phóng to để thấy một phần bảng số. Giá trị nhỏ thường tương ứng vùng tối, giá trị lớn tương ứng vùng sáng. Khi chia tất cả giá trị cho 255, ta chuyển chúng về khoảng 0 đến 1 mà vẫn giữ thứ tự tương đối. Đây là quy tắc cố định; không cần lấy thống kê từ tập test để thực hiện.
Mạng trong bài là mạng fully connected, nên trước lớp Linear đầu tiên ta dùng Flatten. Ảnh có shape [1, 28, 28] trở thành một vector 784 phần tử. Flatten không tự học, không tự xáo trộn pixel và không thêm thông tin. Nó chỉ thay đổi cách sắp kích thước để lớp kế tiếp nhận được đầu vào phù hợp. Thứ tự pixel vẫn phải nhất quán ở lúc train và lúc suy luận.
Nhãn được đưa riêng với đầu vào: số 0 tương ứng T-shirt/top, số 1 là Trouser, tiếp tục tới số 9 là Ankle boot. Máy không cần tên tiếng Anh để tính loss; nó cần mã lớp nhất quán. Khi trình bày kết quả cho người dùng, ta đổi mã lớp về tên. Nếu đổi bảng tên mà không đổi mô hình tương ứng, dự đoán số có thể đúng nhưng chữ hiển thị lại sai.
| Điều con người thấy | Điều mạng nhận | Điều phải giữ nhất quán |
|---|---|---|
| Một ảnh quần áo | Một Tensor số, sau chuyển đổi nằm trong 0–1 | Kích thước, chiều kênh, độ sáng và thứ tự pixel. |
| Tên loại đồ | Mã nhãn nguyên từ 0 đến 9 | Bảng ánh xạ mã và tên lớp. |
| Một lượt nhiều ảnh | Batch có shape [B, 1, 28, 28] | Không nhầm chiều mẫu với chiều kênh hoặc chiều ảnh. |
Một neuron làm gì với các con số đầu vào?
Một neuron trong lớp Linear lấy các đầu vào, nhân với trọng số tương ứng rồi cộng lại và thêm bias. Với hai đầu vào giả định x1=0,8 và x2=0,3, hai trọng số w1=0,5 và w2=−0,4, bias b=0,1, tổng thu được là 0,8×0,5 + 0,3×(−0,4) + 0,1 = 0,38. Đây là ví dụ số học nhỏ để nhìn rõ thao tác, không phải kết quả trích từ mạng nhận diện ảnh.
Nếu có 784 pixel, một neuron Linear đầu tiên có thể nhận một trọng số cho mỗi pixel và một bias. Một lớp có 128 neuron tạo ra 128 tổng khác nhau từ cùng một ảnh. Các tổng này là biểu diễn trung gian để lớp sau xử lý, chưa phải 128 nhãn quần áo. Không nên tự gán mỗi neuron thành một khái niệm như “cổ áo” hoặc “đế giày” nếu chưa có kiểm tra thực sự.
Trọng số dương hay âm thể hiện tác động trong phép tính ở vị trí và ngữ cảnh đó. Không có quy tắc đơn giản rằng trọng số lớn luôn quan trọng hơn mọi trọng số nhỏ ở các lớp khác. Các lớp kết hợp với nhau; một cách giải thích đáng tin cần xét toàn mô hình và dữ liệu, thay vì chỉ tô một màu đẹp lên các nút rồi tuyên bố đã hiểu mạng.
Vì sao nhiều lớp vẫn cần activation?
Giả sử bạn chỉ ghép nhiều phép tuyến tính. Chúng vẫn có thể gộp thành một phép tuyến tính tương đương. Thêm nhiều lớp như vậy không tự tạo khả năng biểu diễn quan hệ phi tuyến. Activation được đặt giữa các lớp để biến đổi đầu ra theo cách phi tuyến; đó là lý do những lớp ẩn có thể làm được nhiều hơn một phép chiếu đơn.
Trong bài, activation là ReLU: đầu vào âm được đưa về 0, đầu vào dương giữ nguyên. Với tổng 0,38 ở ví dụ trước, đầu ra sau ReLU vẫn là 0,38; với tổng −0,2, đầu ra là 0. Cách biến đổi từng giá trị này đơn giản, nhưng khi kết hợp với nhiều phép trộn đầu vào, cả mạng có thể biểu diễn những quan hệ phức tạp hơn.
Bạn có thể đối chiếu trực giác này trong bài học activation của Google. Dù vậy, không nên suy ra cứ thêm lớp là tốt hơn. Mạng lớn hơn đòi hỏi tối ưu phù hợp, có thể tốn tài nguyên hơn và vẫn có thể học những tương quan không mong muốn trong dữ liệu.
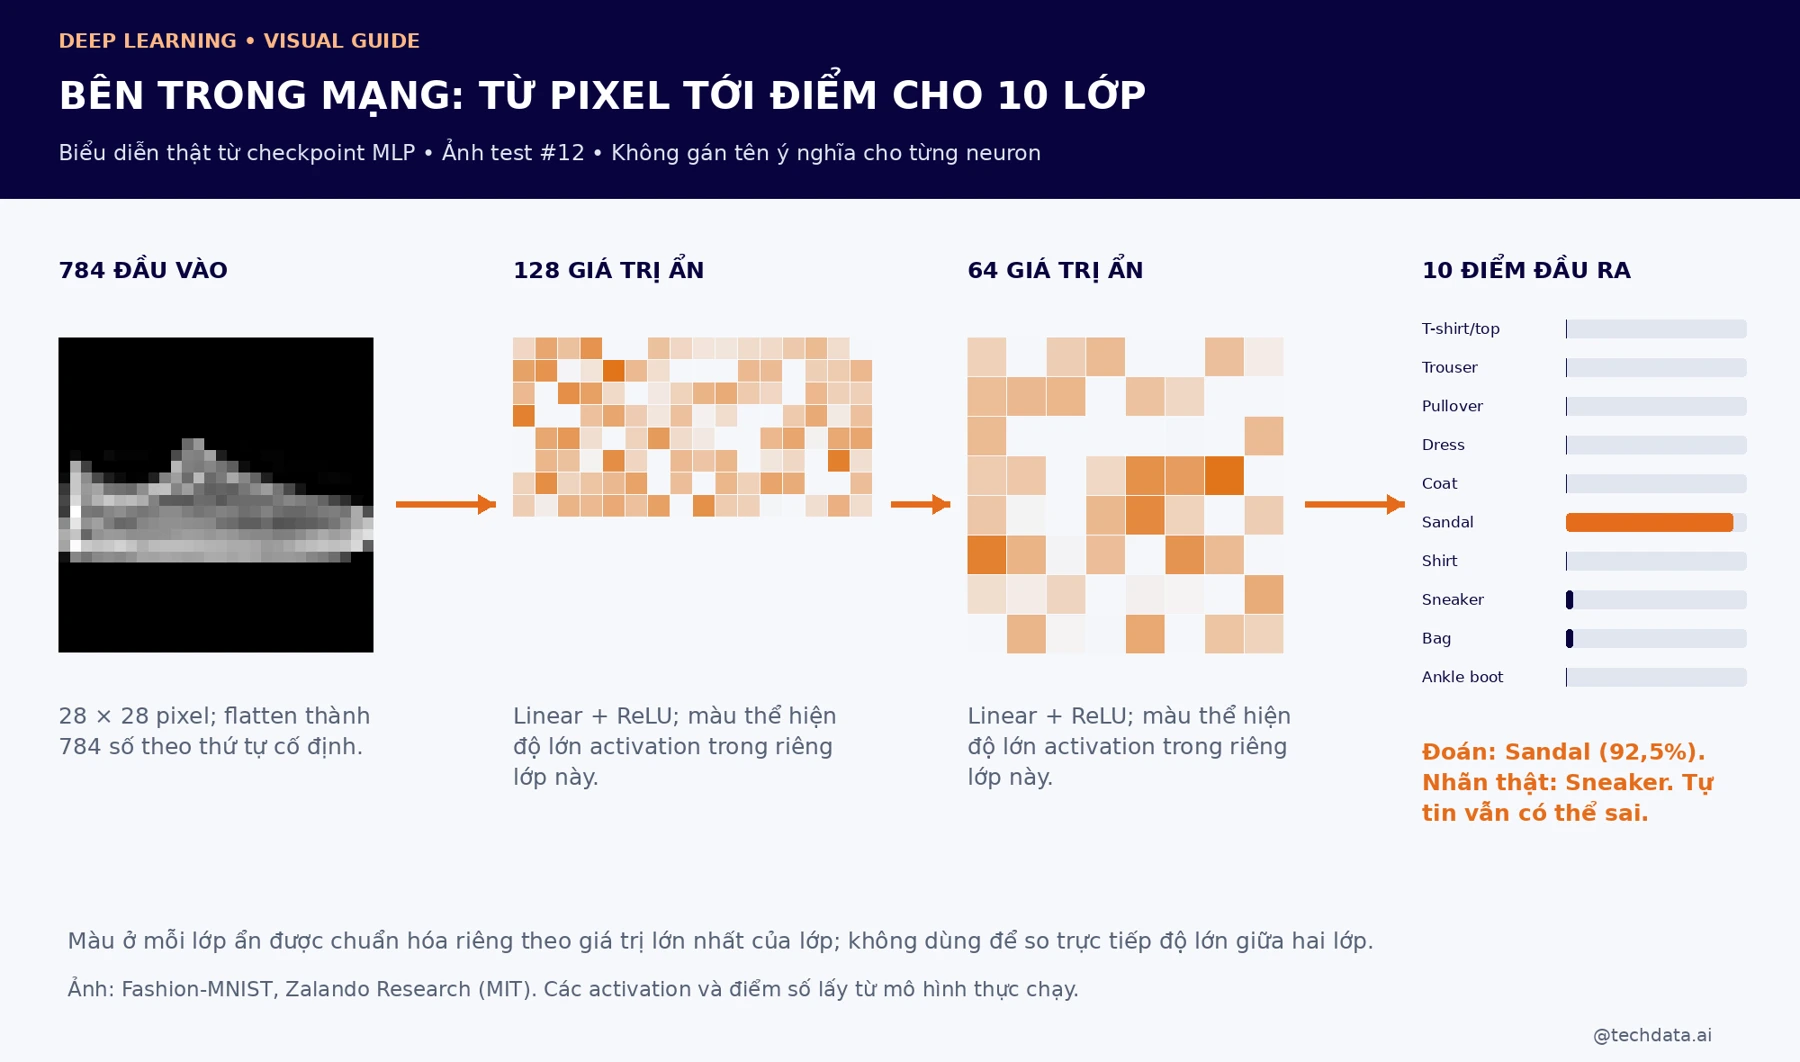
Mạng nhận diện ảnh ở đây đi qua các kích thước 784, 128, 64 rồi 10. Hai lớp ẩn có ReLU; lớp cuối tạo mười logits. Đây là một MLP nhỏ với nhiều lớp học được, không phải CNN hay mô hình ngôn ngữ lớn. Nó phù hợp để thấy cơ chế cơ bản mà không trộn thêm quá nhiều kỹ thuật cùng lúc.
Forward và loss: đoán một lần, đo sai theo cách nào?
Forward là lúc một batch ảnh đi qua các phép tính của mạng để tạo ra logits. Mười logits là mười điểm chưa chuẩn hóa cho mười lớp. Khi cần hiển thị, softmax chuyển các điểm thành một phân phối có tổng bằng 1. Khi huấn luyện trong lab, CrossEntropyLoss nhận trực tiếp logits và nhãn lớp; không thêm softmax vào trước loss này.
Loss trả lời một câu hỏi khác accuracy. Accuracy đếm xem lớp có điểm cao nhất có đúng nhãn hay không. Loss còn phản ánh mức phân bổ điểm cho đáp án đúng. Hai ảnh đều bị đoán sai có thể có loss khác nhau: một ảnh mạng gần phân vân giữa hai lớp, ảnh kia mạng gần như loại bỏ nhãn đúng. Vì vậy tối ưu loss tạo tín hiệu chi tiết hơn việc chỉ cộng số lần đoán đúng.
Bạn không cần tự viết mọi đạo hàm cho từng trọng số. Nhưng cần chắc rằng phép loss phù hợp kiểu đầu ra và nhãn. Với bài toán một nhãn trong mười lớp, mã nhãn là số nguyên 0–9, shape [B], kiểu long. Nếu bài toán cho phép một ảnh có nhiều nhãn độc lập, thiết kế đầu ra và loss sẽ khác; không thể áp dụng nguyên xi chỉ vì vẫn gọi là phân loại.
Backward và cập nhật: mô hình sửa mình ở đâu?
Để nhìn thật rõ, tạm bỏ ảnh và xét một mô hình vô hướng: dự đoán bằng w×x. Cho x=2, target=2 và w=0,5. Dự đoán bằng 1, loss bình phương bằng 1. Đạo hàm loss theo w là 2×(1−2)×2=−4. Gradient này cho biết hướng thay đổi cục bộ của loss theo tham số w.
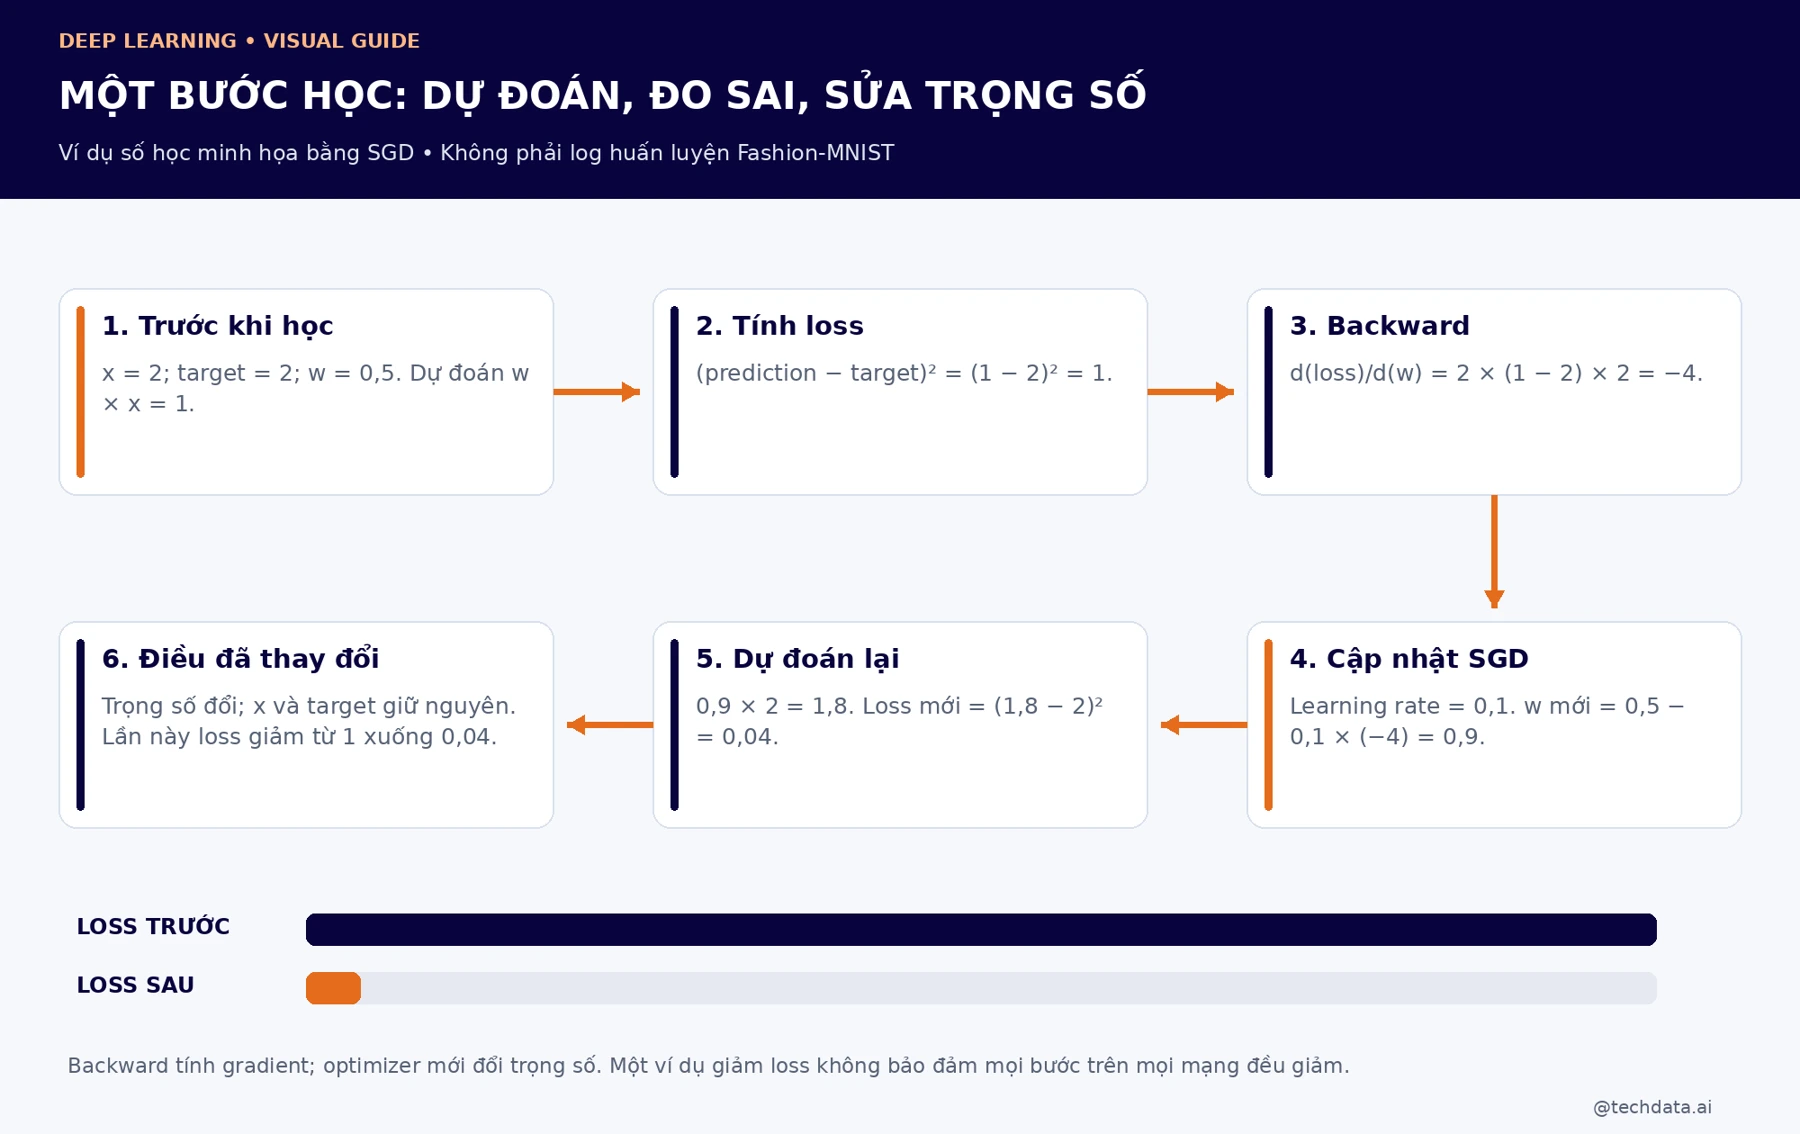
Với SGD và learning rate 0,1, ta cập nhật w thành 0,5−0,1×(−4)=0,9. Dự đoán mới bằng 1,8 và loss bằng 0,04. Những con số cho thấy gradient đi vào bước sửa tham số như thế nào. Nếu bước học quá lớn, có thể vượt qua vùng tốt và khiến loss tăng. Một bước giảm ở ví dụ này không bảo đảm mọi bước của mọi mạng đều giảm.
import torch

w = torch.tensor(0.5, requires_grad=True)
x, target = torch.tensor(2.0), torch.tensor(2.0)
optimizer = torch.optim.SGD([w], lr=0.1)
optimizer.zero_grad(set_to_none=True)
loss = (w * x - target).square()
loss.backward()
print(w.item(), loss.item(), w.grad.item())  # 0.5, 1.0, -4.0
optimizer.step()
print(round(w.item(), 2))  # 0.9
Theo cơ chế Autograd của PyTorch, backward tính gradient; nó chưa tự cập nhật tham số. Optimizer mới thực hiện bước thay đổi. Gradient được cộng dồn, nên luồng học thông thường xóa gradient cũ trước backward kế tiếp. Bài lab dùng Adam cho thí nghiệm ảnh, còn ví dụ một trọng số dùng SGD để phép tính nhìn thấy trực tiếp.
Học quy luật khác học thuộc: vai trò ba tập dữ liệu
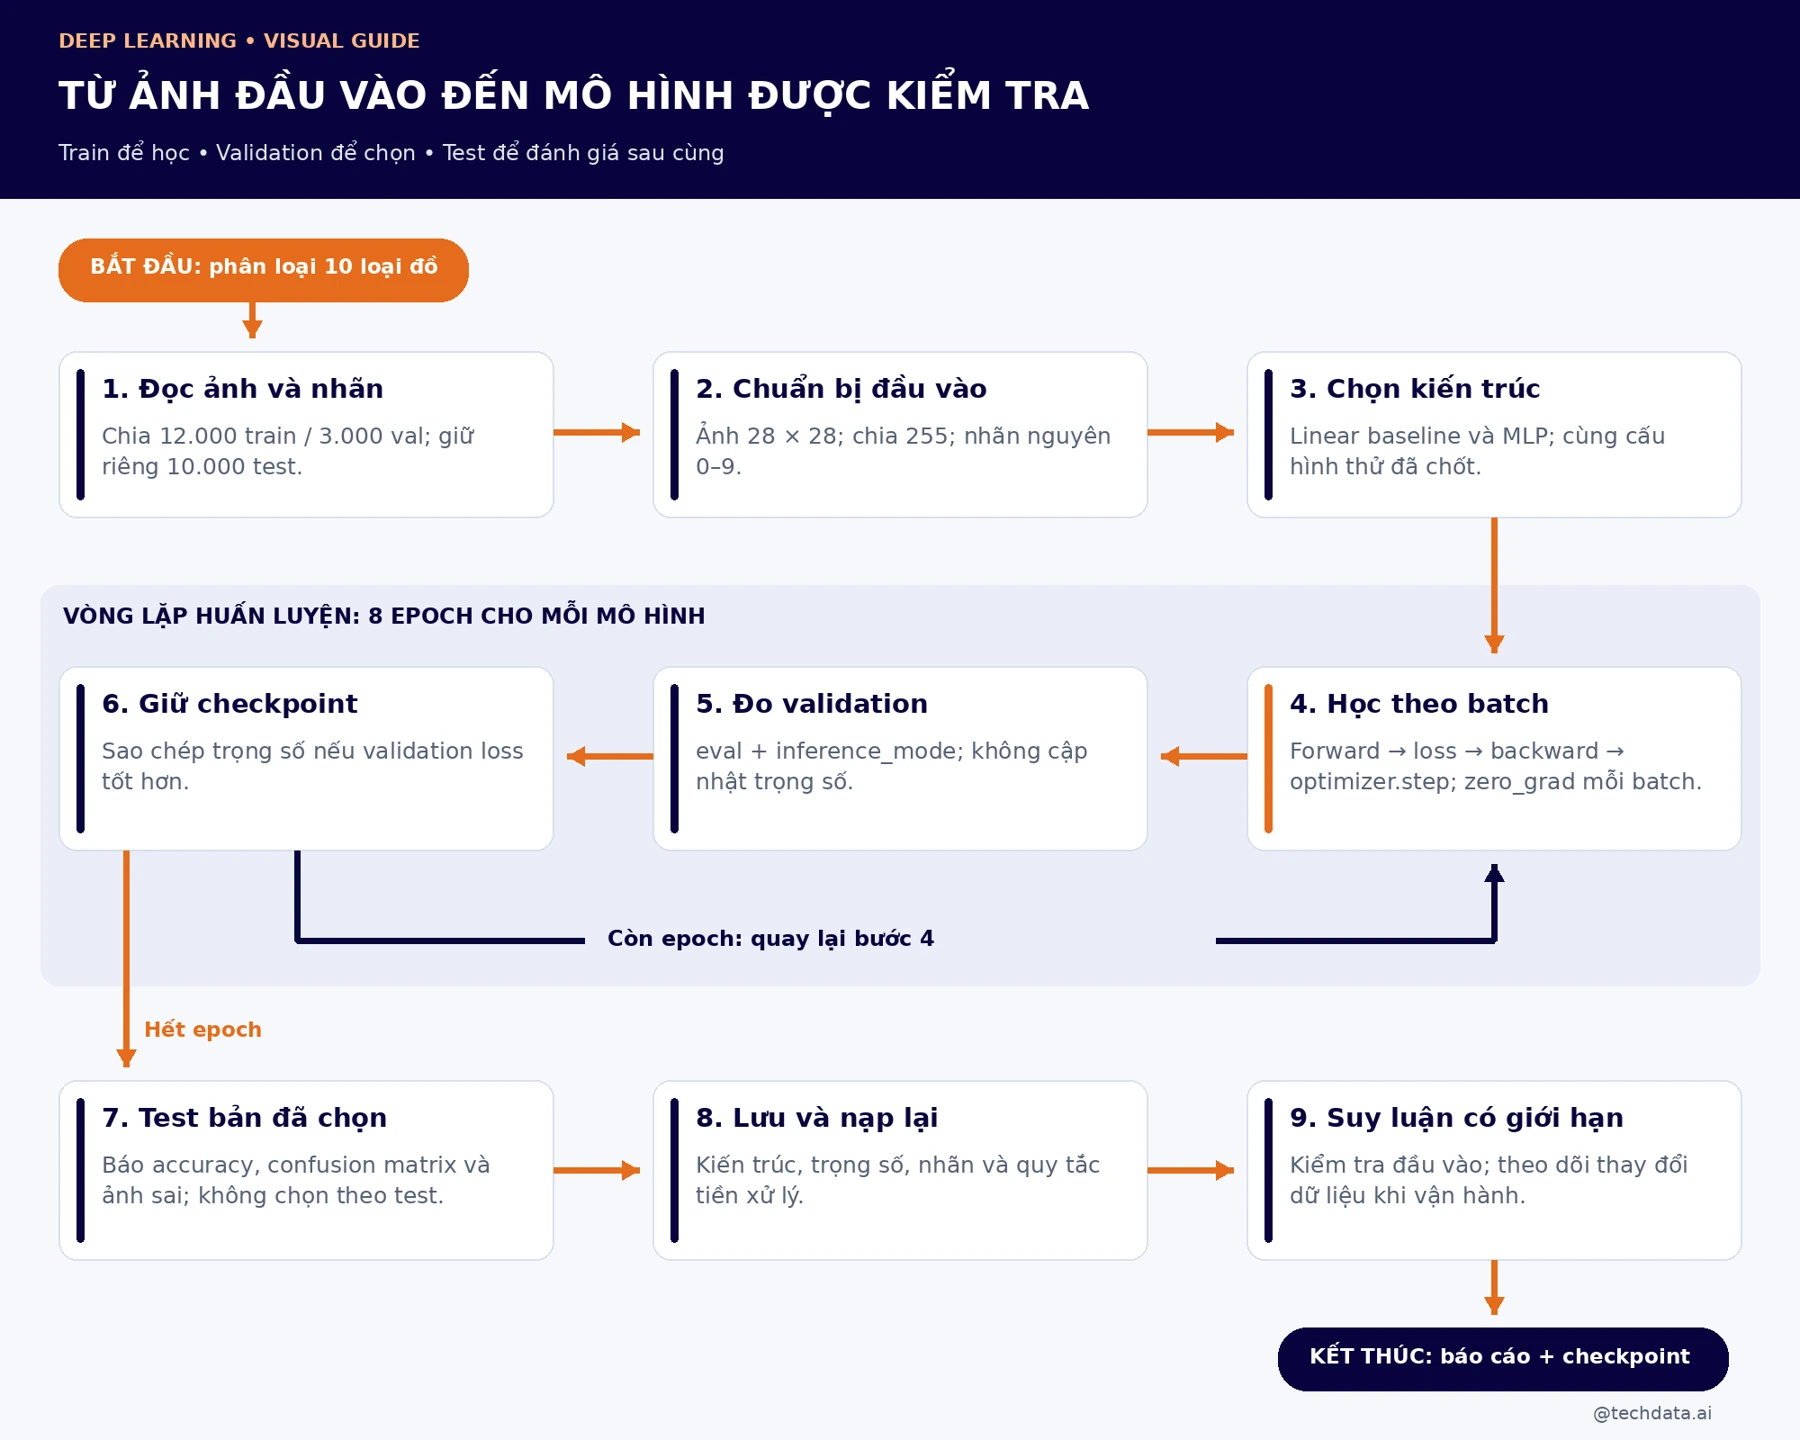
Nếu kiểm tra một người bằng đúng những câu đã cho họ học thuộc, điểm cao không nói hết năng lực giải câu mới. Mô hình cũng cần đánh giá ngoài dữ liệu dùng để cập nhật tham số. Train dùng để học; validation giúp chọn cấu hình hoặc checkpoint; test dùng để báo cáo sau khi đã chọn. Ba vai trò cần được giữ rõ từ lúc thiết kế thí nghiệm.
Overfitting là tình huống mô hình làm tốt trên dữ liệu đã học nhưng tổng quát kém sang dữ liệu mới. Google ML Crash Course dùng sự khác biệt giữa đường loss train và validation để xây trực giác về vấn đề này. Tuy nhiên, một epoch validation tăng đơn lẻ chưa đủ để kết luận; cần xem xu hướng, quy mô dữ liệu và các yếu tố ngẫu nhiên.
Một lỗi khác là data leakage: thông tin mà mô hình không được phép biết lại lọt vào quá trình xây dựng hoặc đánh giá. Ví dụ, ảnh cùng sản phẩm gần như giống nhau nằm ở cả train và test, hoặc bạn liên tục nhìn test rồi chỉnh cấu hình tới khi điểm cao. Khi đó bài kiểm tra không còn phản ánh mức độc lập mà bạn tưởng.
Với dữ liệu thật, nên xác định đơn vị cần tách: một sản phẩm, một khách hàng, một thời điểm hay một nguồn chụp ảnh. Nếu mục tiêu là dùng cho sản phẩm mới, giữ ảnh của cùng sản phẩm ở nhiều tập có thể làm điểm quá đẹp. Mục tiêu triển khai quyết định cách chia; random split không phải quy tắc đúng cho mọi tình huống.
Thiết kế thí nghiệm Fashion-MNIST có thể chạy lại
Để giảm thời gian chạy trên CPU, bài chọn một phần tập train gốc theo seed 42: 12.000 ảnh train, 3.000 ảnh validation; 45.000 ảnh còn lại của tập train gốc không dùng. Tập test chính thức 10.000 ảnh được giữ riêng. Đây là thí nghiệm học tập với ngân sách nhỏ, không phải kết quả dùng toàn bộ dữ liệu hay benchmark tối ưu của Fashion-MNIST.
| Thiết lập | Giá trị trong bài |
|---|---|
| Đầu vào | Ảnh xám 28×28, chia pixel cho 255. |
| Hai mô hình đã chốt | Linear(784,10) và MLP 784–128–64–10 có ReLU. |
| Dữ liệu | 12.000 train / 3.000 validation / 10.000 test. |
| Ngân sách huấn luyện | 8 epoch mỗi mô hình, batch 128, Adam, learning rate 0,001. |
| Chọn checkpoint | Validation loss thấp nhất trong 8 epoch, riêng cho từng mô hình. |
| Môi trường thực chạy | Python 3.12, torch 2.9.1+cpu, torchvision 0.24.1+cpu. |
Hai mô hình dùng cùng phần dữ liệu, thứ tự batch có seed tương ứng và cùng số epoch. Mỗi epoch train có 94 batch: 93 batch đủ 128 và một batch 96 ảnh. Tuy nhiên cùng số epoch không có nghĩa cùng lượng tính toán, vì MLP nhiều tham số hơn. So sánh trong bài chỉ trả lời hai cấu hình này hoạt động thế nào dưới một thiết lập cụ thể.
Thực hành: chạy hai mô hình bằng PyTorch
Nếu đã có môi trường ảo của bài PyTorch trước, cài thêm torchvision đúng cặp phiên bản. Nếu chưa có, dùng Python 3.12 tạo một môi trường riêng trước. Lệnh CPU dưới dành cho Linux/Windows; trên macOS dùng cùng hai phiên bản từ PyPI mà không thêm index CPU. Tham khảo bảng phiên bản chính thức khi chọn nền tảng khác.
python -m pip install torch==2.9.1 torchvision==0.24.1 --index-url https://download.pytorch.org/whl/cpuTạo file fashion_lab.py rồi sao chép toàn bộ code. Lần đầu cần kết nối Internet để tải dataset từ kho chính thức; các lần sau dùng dữ liệu đã lưu trong thư mục data. Cách tải dùng FashionMNIST của torchvision và kiểm tra mã MD5 của các file. Code chọn CPU để giữ thí nghiệm đơn giản, không tự chuyển sang GPU.
import copy
import json
from pathlib import Path
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset
from torchvision.datasets import FashionMNIST

SEED = 42
EPOCHS = 8
BATCH_SIZE = 128
LEARNING_RATE = 0.001


def make_model(name):
    if name == 'linear':
        return nn.Sequential(nn.Flatten(), nn.Linear(784, 10))
    if name == 'mlp':
        return nn.Sequential(
            nn.Flatten(), nn.Linear(784, 128), nn.ReLU(),
            nn.Linear(128, 64), nn.ReLU(), nn.Linear(64, 10),
        )
    raise ValueError(name)


@torch.inference_mode()
def evaluate(model, loader, loss_fn):
    model.eval()
    total, correct, count = 0.0, 0, 0
    all_logits, all_labels = [], []
    for images, labels in loader:
        logits = model(images)
        total += loss_fn(logits, labels).item() * len(labels)
        correct += (logits.argmax(1) == labels).sum().item()
        count += len(labels)
        all_logits.append(logits)
        all_labels.append(labels)
    return total / count, correct / count, torch.cat(all_logits), torch.cat(all_labels)


def main():
    torch.set_num_threads(2)
    torch.manual_seed(SEED)
    # Official dataset repository; torchvision verifies file MD5 hashes.
    FashionMNIST.mirrors = [
        'https://raw.githubusercontent.com/zalandoresearch/fashion-mnist/master/data/fashion/'
    ]
    raw_train = FashionMNIST('data', train=True, download=True)
    raw_test = FashionMNIST('data', train=False, download=True)
    order = torch.randperm(len(raw_train), generator=torch.Generator().manual_seed(SEED))
    train_ids, val_ids = order[:12000], order[12000:15000]
    # Fixed 0..255 -> 0..1 conversion; no statistics are fit on validation/test.
    train_set = TensorDataset(raw_train.data[train_ids].unsqueeze(1).float() / 255,
                              raw_train.targets[train_ids])
    val_set = TensorDataset(raw_train.data[val_ids].unsqueeze(1).float() / 255,
                            raw_train.targets[val_ids])
    test_set = TensorDataset(raw_test.data.unsqueeze(1).float() / 255, raw_test.targets)
    val_loader = DataLoader(val_set, batch_size=512, shuffle=False, num_workers=0)
    test_loader = DataLoader(test_set, batch_size=512, shuffle=False, num_workers=0)
    loss_fn = nn.CrossEntropyLoss()
    results = {}
    print(f'torch={torch.__version__}; device=cpu; split=12000/3000/10000')
    for name in ['linear', 'mlp']:
        torch.manual_seed(SEED)
        model = make_model(name)
        optimizer = torch.optim.Adam(model.parameters(), lr=LEARNING_RATE)
        train_loader = DataLoader(
            train_set, batch_size=BATCH_SIZE, shuffle=True,
            generator=torch.Generator().manual_seed(SEED), num_workers=0,
        )
        best_loss, best_epoch, best_state = float('inf'), 0, None
        history = []
        for epoch in range(1, EPOCHS + 1):
            model.train()
            running, count = 0.0, 0
            for images, labels in train_loader:
                optimizer.zero_grad(set_to_none=True)
                loss = loss_fn(model(images), labels)
                loss.backward()
                optimizer.step()
                running += loss.item() * len(labels)
                count += len(labels)
            val_loss, val_acc, _, _ = evaluate(model, val_loader, loss_fn)
            row = dict(epoch=epoch, train_loss=running/count,
                       val_loss=val_loss, val_acc=val_acc)
            history.append(row)
            if val_loss < best_loss:
                best_loss, best_epoch = val_loss, epoch
                best_state = copy.deepcopy(model.state_dict())
            print(name, row, flush=True)
        model.load_state_dict(best_state)
        test_loss, test_acc, logits, labels = evaluate(model, test_loader, loss_fn)
        checkpoint = dict(model_name=name, model_state=best_state,
                          class_names=raw_train.classes, scale=255.0,
                          best_epoch=best_epoch)
        torch.save(checkpoint, f'fashion_{name}.pt')
        loaded = torch.load(f'fashion_{name}.pt', map_location='cpu', weights_only=True)
        restored = make_model(loaded['model_name'])
        restored.load_state_dict(loaded['model_state'])
        restored.eval()
        with torch.inference_mode():
            torch.testing.assert_close(restored(test_set.tensors[0][:10]), logits[:10])
        results[name] = dict(history=history, best_epoch=best_epoch,
                             parameters=sum(p.numel() for p in model.parameters()),
                             test_loss=test_loss, test_acc=test_acc)
        if name == 'mlp':
            torch.save(dict(logits=logits, labels=labels), 'test_predictions.pt')
        print('FINAL', name, results[name], 'reload=PASS', flush=True)
    Path('results.json').write_text(json.dumps(results, indent=2))


if __name__ == '__main__':
    main()
python fashion_lab.pyKết quả gồm hai checkpoint fashion_linear.pt, fashion_mlp.pt; results.json ghi lịch sử và số đo; test_predictions.pt lưu logits cùng nhãn test để có thể vẽ lại kết quả. Các file cùng tên được cập nhật khi chạy lại trong cùng thư mục. Cần giữ bảng class_names và quy tắc chia 255 cùng mô hình, thay vì chỉ gửi một bộ trọng số rồi đoán cách xử lý ảnh.
Kết quả thực chạy: mạng nhiều lớp cải thiện bao nhiêu?
Kết quả dưới đây lấy từ lần chạy CPU đã kiểm tra. Checkpoint mỗi mô hình được chọn theo validation loss, rồi mới đánh giá trên test. Hai kiến trúc được xác định trước để minh họa; bài không thử nhiều cấu hình trên test rồi chỉ trình bày một bản thắng.
| Mô hình | Tham số | Epoch được chọn | Test loss | Test accuracy |
|---|---|---|---|---|
| Linear | 7.850 | 8 | 0,5287 | 82,11% |
| MLP hai lớp ẩn | 109.386 | 5 | 0,4645 | 83,78% |
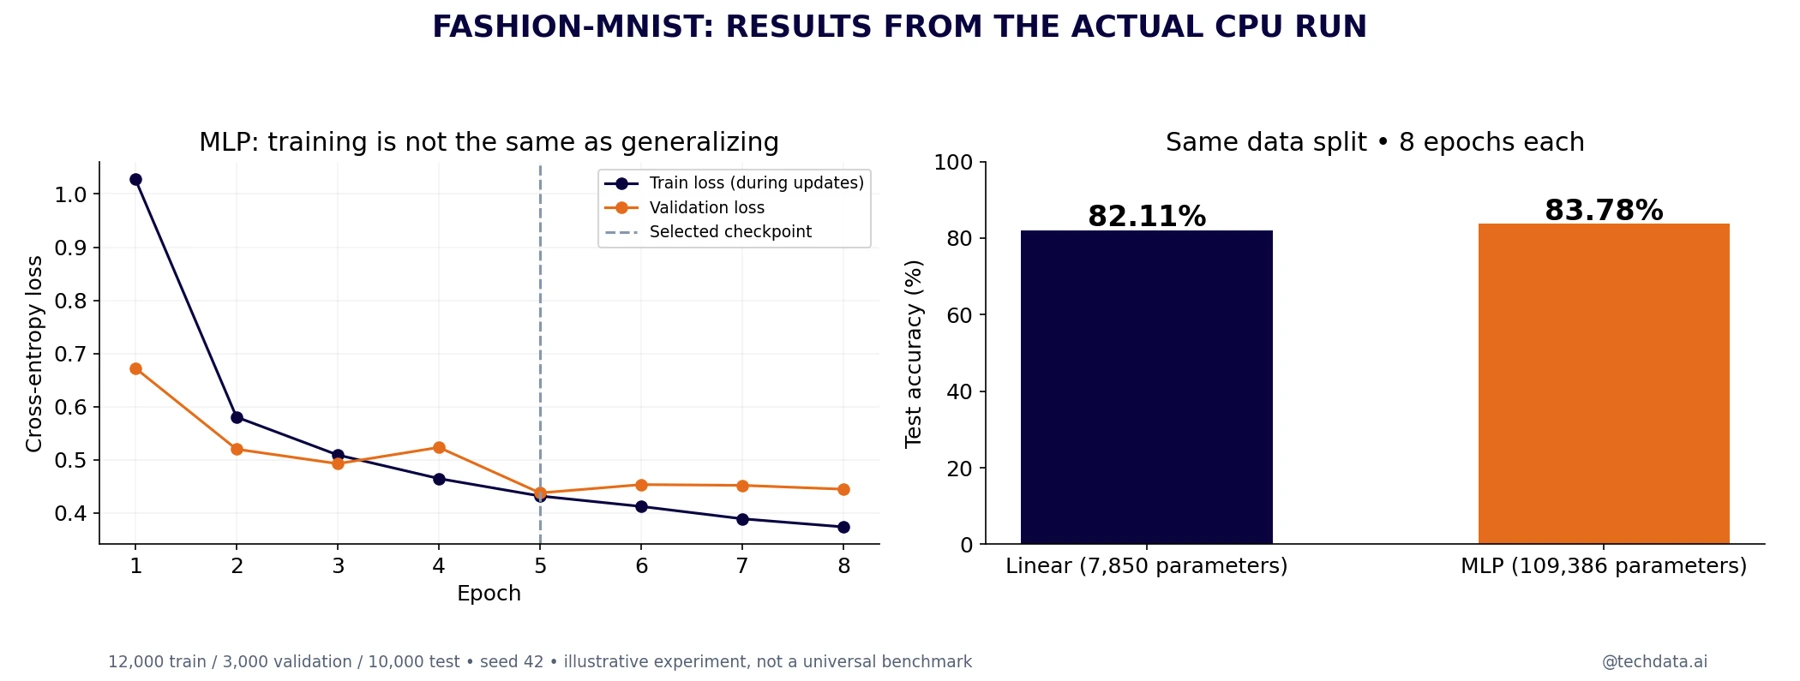
MLP dự đoán đúng 8.378 trong 10.000 ảnh, còn Linear đúng 8.211 ảnh. Chênh lệch là 167 ảnh, tương đương 1,67 điểm phần trăm accuracy. Số tham số của MLP lớn hơn khoảng 13,9 lần. Đây là cách nhìn đầy đủ hơn câu “mạng sâu chính xác hơn”: phần cải thiện phải được đặt cạnh tài nguyên, chi phí và yêu cầu của ứng dụng.
Không nên biến một lần chạy thành kết luận rằng MLP luôn hơn mô hình tuyến tính đúng 1,67 điểm phần trăm. Thay seed, ngân sách học, regularization hoặc cách xử lý đầu vào có thể cho kết quả khác. Hai mô hình cũng chưa được tối ưu riêng tới mức tốt nhất. Mục đích của baseline là tạo mốc có thể đo, giúp bạn biết độ phức tạp thêm vào có mang lại lợi ích trong thí nghiệm đang xét hay không.
Ở MLP, validation loss thấp nhất xuất hiện tại epoch 5, khoảng 0,4374. Sau đó train loss vẫn giảm, trong khi validation loss dao động và tới epoch 8 ở khoảng 0,4444. Vì vậy checkpoint được lấy ở epoch 5, không phải epoch cuối. Khoảng cách nhỏ này là lý do cần theo dõi validation và chọn mô hình có quy tắc; chưa đủ để tuyên bố một hiện tượng overfitting mạnh chỉ từ vài điểm.
Train loss trong code được ghi trong lúc tham số đang thay đổi qua các batch, còn validation loss được tính sau epoch trên một tập khác. Hai con số không được đo trong điều kiện hoàn toàn giống nhau. Nếu thấy train loss cao hơn validation ở giai đoạn đầu, cần hiểu cách log trước khi kết luận pipeline có lỗi.
Nhìn những ảnh mạng dự đoán đúng
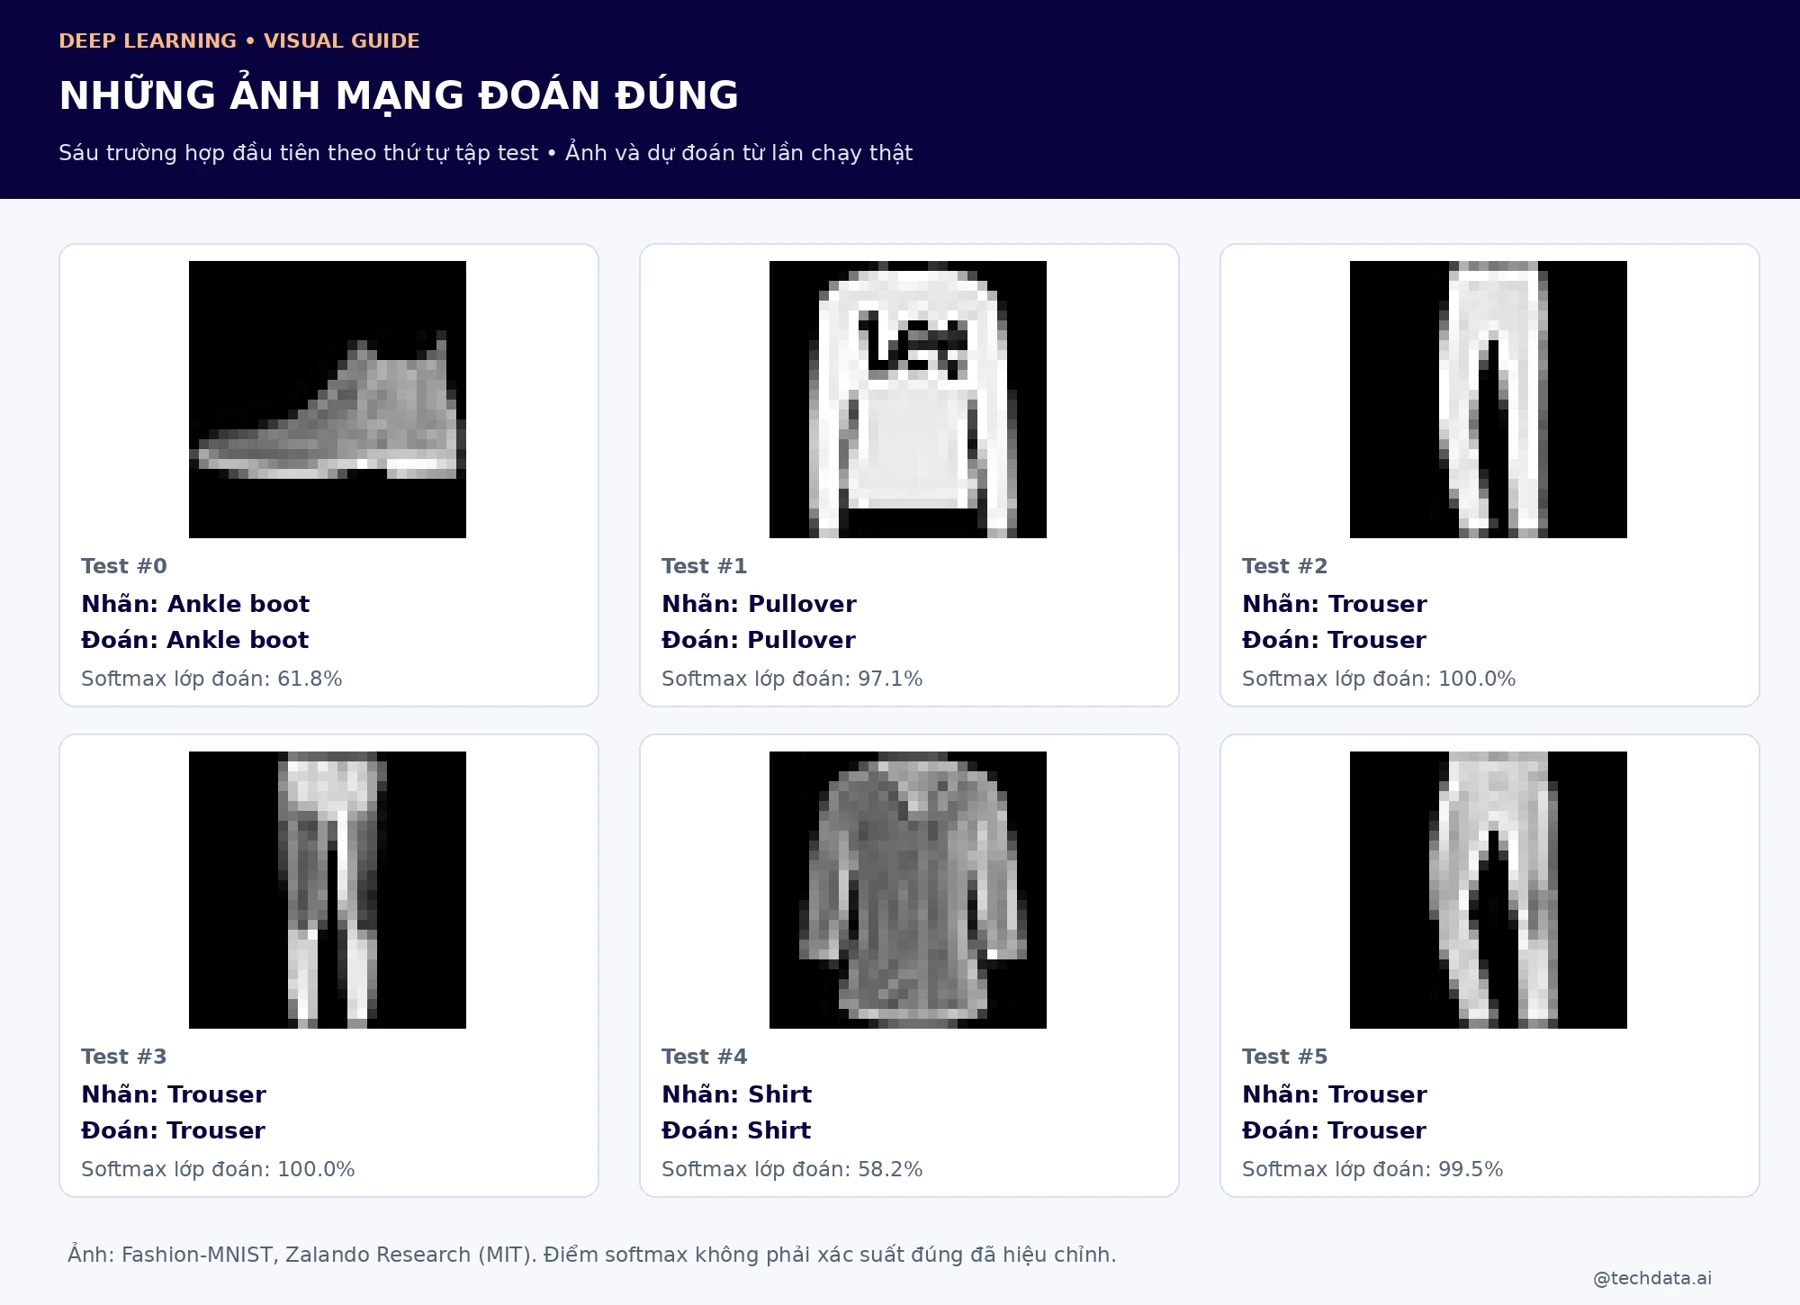
Các ảnh dự đoán đúng giúp kiểm tra những thứ cơ bản: đầu vào có hiển thị đúng không, bảng nhãn có khớp không và mô hình có phân biệt được một số dạng hình khác nhau không. Đừng bỏ qua bước này chỉ vì đã có accuracy. Một pipeline đảo nhãn hoặc đọc sai ảnh có thể cho ra các kết quả khó hiểu mà bảng tổng không chỉ ra ngay.
Những hình xám 28×28 rất nhỏ, nên ngay cả con người cũng có thể thấy một số món đồ mơ hồ. Khi phóng to, mỗi ô vuông vẫn là pixel cũ; không có chi tiết mới được tạo ra. Đây là lý do minh họa dùng kiểu phóng to giữ nguyên ô pixel thay vì làm nét bằng AI rồi khiến người đọc tưởng mô hình đã nhận một ảnh rõ hơn.
Điểm softmax hiển thị 100,0% trong hình là số đã làm tròn, không phải bảo đảm tuyệt đối về một dự đoán.
Những ảnh đoán sai đáng đọc hơn một accuracy đẹp
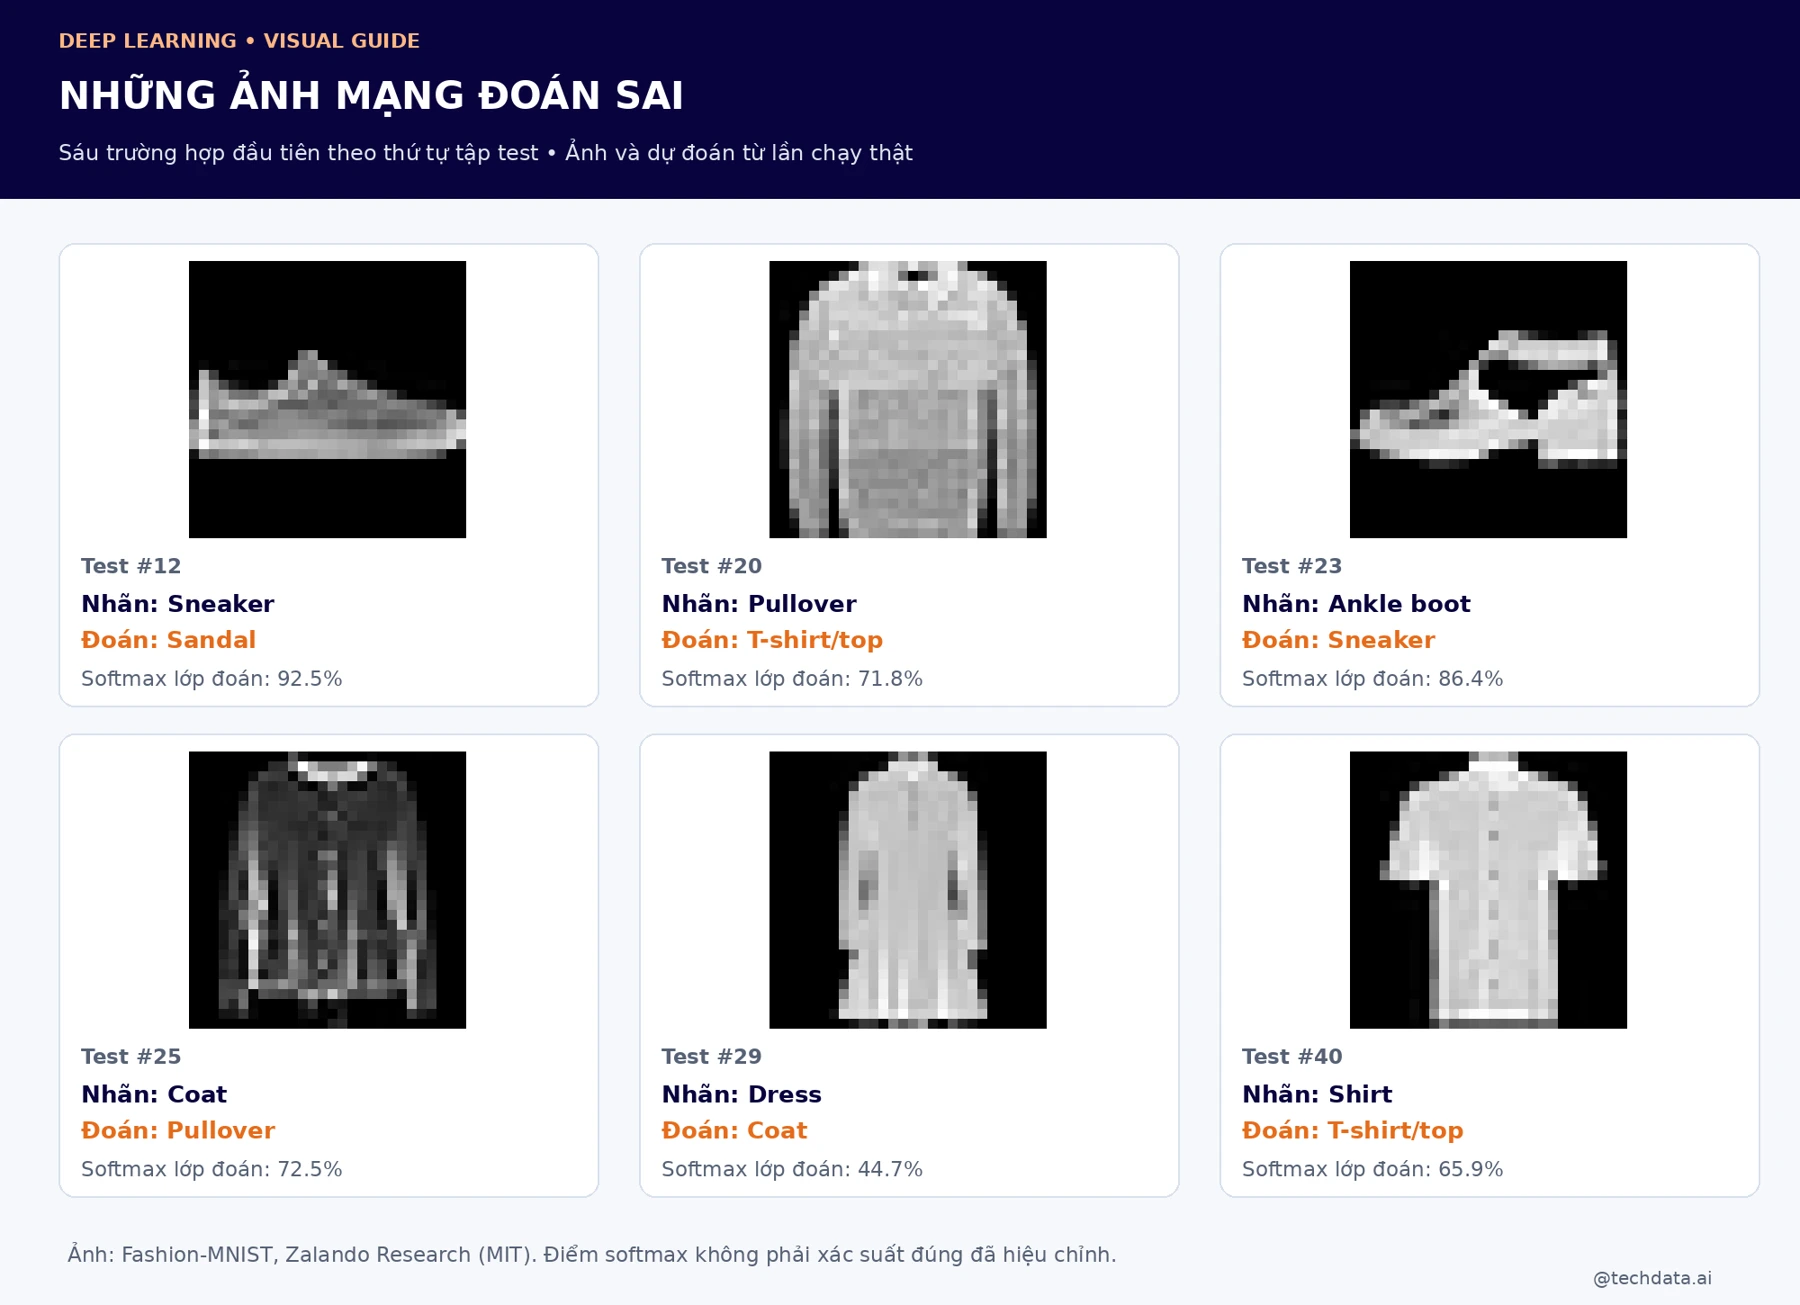
Ở ảnh test số 12, nhãn là Sneaker nhưng mạng chọn Sandal, với điểm softmax của lớp được chọn khoảng 92,5%. Ảnh số 23 mang nhãn Ankle boot nhưng được đoán thành Sneaker, với điểm khoảng 86,4%. Một số nhầm lẫn khác xảy ra giữa Coat và Pullover, hoặc Shirt với T-shirt/top. Đây là các ví dụ thực sự phát sinh trong lần chạy, không phải lỗi được dựng để kể chuyện.
Điều đáng chú ý là mạng có thể rất tự tin mà vẫn sai. Softmax cho biết cách mô hình phân bổ điểm giữa mười lớp đã định nghĩa, không tự trở thành xác suất đúng đã được hiệu chỉnh cho mọi ảnh. Nếu đưa vào một vật không thuộc mười loại đó, mạng vẫn có thể chọn một lớp và cho điểm cao. Bài toán “không biết thì từ chối” cần được thiết kế và đánh giá riêng.
Khi xem lỗi, nên hỏi những câu có thể kiểm tra: ảnh mờ hay khó phân biệt? Nhãn có đúng với định nghĩa lớp không? Có nhóm nào bị nhầm thường xuyên? Sai ở dữ liệu gần giống train hay ở nguồn ảnh khác? Sáu ảnh đầu không đủ để trả lời toàn bộ. Chúng là điểm bắt đầu cho phân tích lỗi có hệ thống, không phải bằng chứng rằng một loại đồ nào luôn gây khó nhất.
Với ứng dụng kiểm kê, nhầm giữa hai nhóm áo có thể có hậu quả khác nhầm giữa giày và túi. Accuracy xem mỗi mẫu đúng/sai như một lần đếm; nghiệp vụ có thể cần trọng số khác hoặc một bước người duyệt. Cần xác định chi phí sai rồi mới chọn metric và ngưỡng chuyển kiểm tra, thay vì mặc định dùng lớp có softmax cao nhất trong mọi trường hợp.
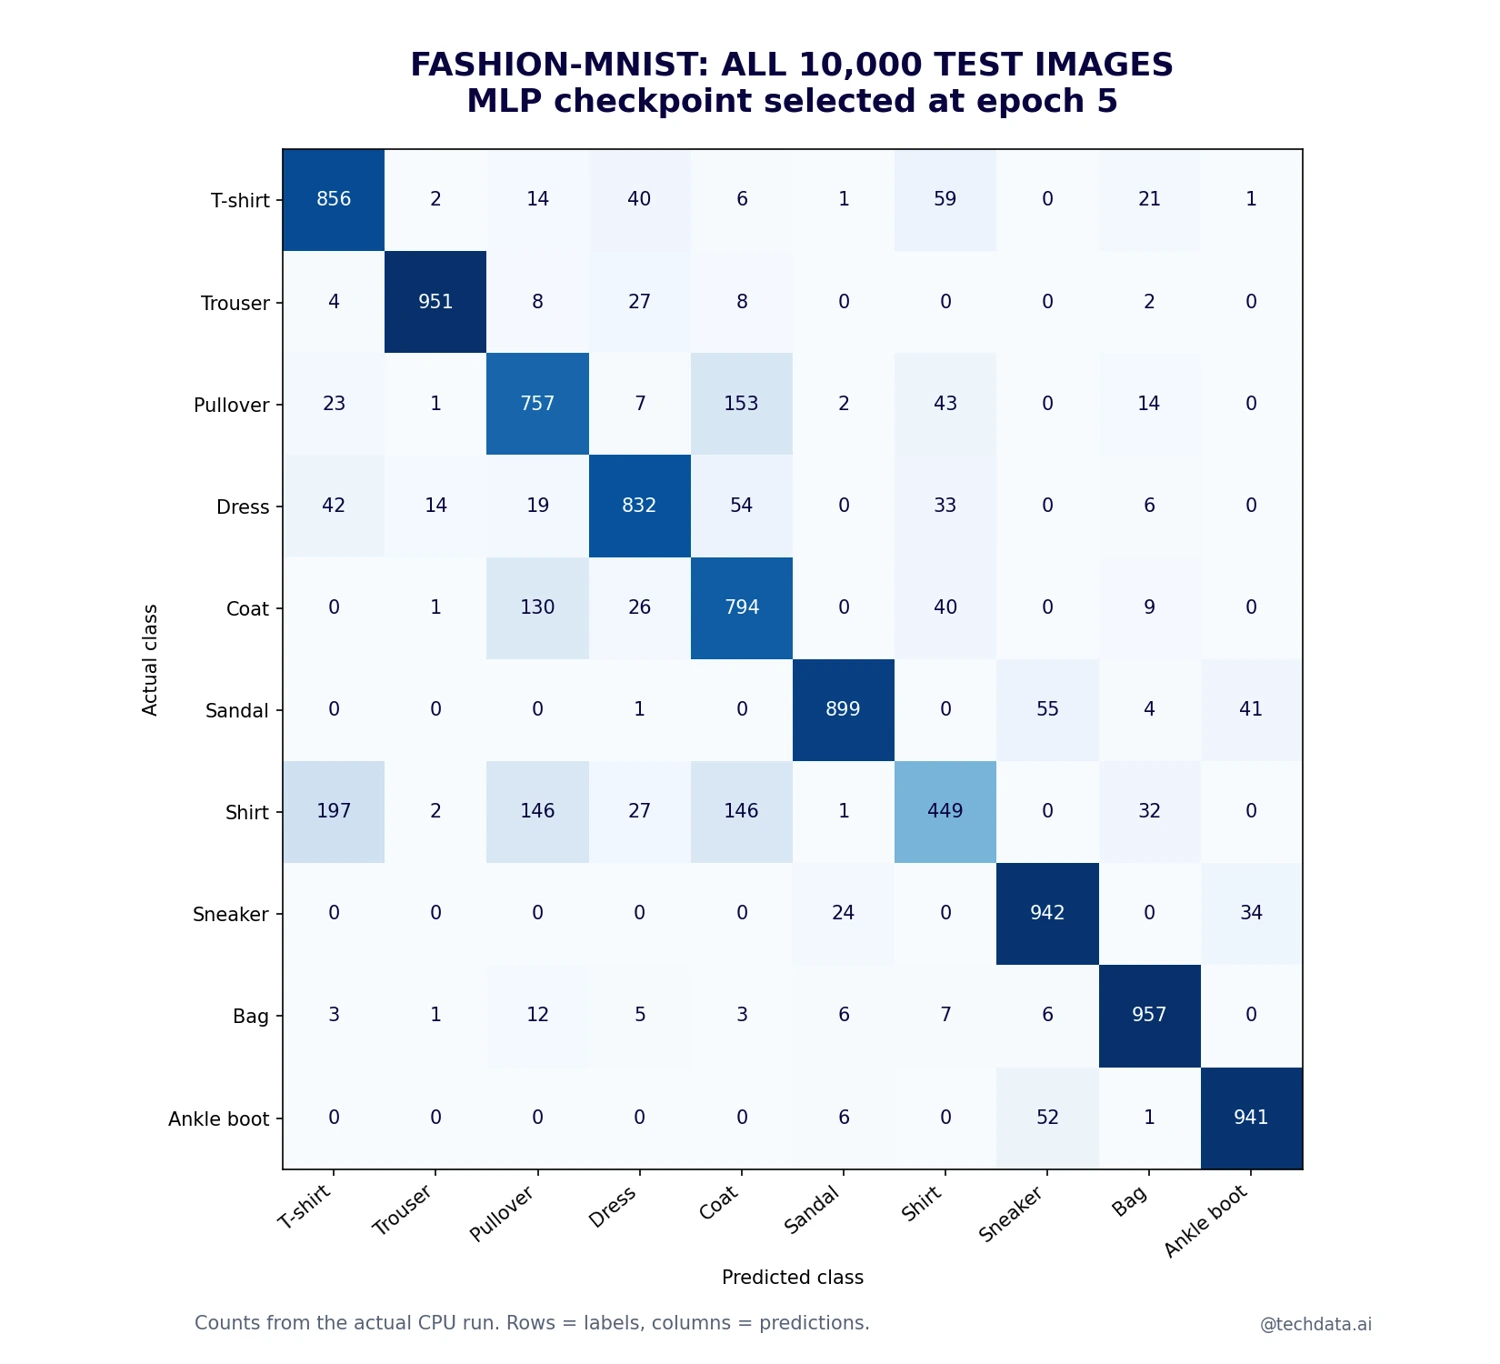
Ma trận toàn bộ test giúp kiểm tra các nhầm lẫn có phổ biến hay chỉ là trường hợp riêng. Mỗi hàng ở dataset test này có 1.000 ảnh. Cộng đường chéo được 8.378 ảnh đúng; các ô ngoài đường chéo cộng thành 1.622 lỗi. Khi đọc theo hàng, bạn đang xem một loại đồ thật bị mạng phân sang những lớp nào; khi đọc theo cột, bạn đang xem một nhãn mà mạng gán gồm những loại thật nào.
Đọc vòng học bằng đúng trách nhiệm của từng bước
Trong train, model.train đặt mô hình vào chế độ học. zero_grad xóa gradient cũ; model(images) chạy forward; loss so với labels; backward tính gradient; optimizer.step cập nhật tham số. Các bước này có trách nhiệm khác nhau. Nếu chỉ tính forward và loss rồi in log, mạng chưa học. Nếu quên xóa gradient, bạn đang thay đổi cách tích lũy gradient so với thí nghiệm đã mô tả.
Ở validation và test, evaluate chuyển model.eval và dùng inference_mode. Hàm chỉ đo, không gọi optimizer. Với những lớp như Dropout hoặc BatchNorm, eval thay đổi hành vi theo chế độ; inference_mode tắt theo dõi gradient cho suy luận. Hai việc liên quan nhưng không thay thế nhau. Mạng MLP này chưa dùng các lớp đó, song giữ cấu trúc rõ giúp mở rộng ít sai hơn.
Mỗi lần validation loss tốt hơn, code dùng deepcopy để giữ bản sao trọng số. Khi kết thúc, model.load_state_dict nạp lại bản đó trước test. Nếu bạn chỉ giữ một biến tham chiếu tới trạng thái rồi tiếp tục cập nhật, “bản tốt nhất” có thể không còn là bản ở thời điểm bạn muốn. Có thể đối chiếu cách quản lý tham số trong hướng dẫn lưu/nạp chính thức.
Phần cuối nạp checkpoint vào một mô hình mới và đối chiếu logits của mười mẫu test đầu. Lần chạy trong bài báo kiểm tra khớp cho cả hai mô hình. Đây là kiểm tra việc lưu/nạp, không phải phép chứng minh toàn mô hình chính xác. Checkpoint giữ cả tên kiến trúc, bảng lớp, scale và epoch để đầu ra có thể được hiểu lại đúng nghĩa.
Khi nào nên dùng Deep Learning, khi nào nên bắt đầu đơn giản?
Câu trả lời nên bắt đầu từ dữ liệu và yêu cầu. Khi dữ liệu là ảnh, âm thanh hoặc văn bản và mục tiêu cần học biểu diễn phức tạp, các mô hình Deep Learning là hướng đáng khảo sát. Nhưng việc khảo sát vẫn cần baseline, chi phí dữ liệu, cách đánh giá và khả năng vận hành. Có một mô hình pretrained phù hợp có thể quan trọng hơn việc tự xây mạng lớn từ đầu.
Với dữ liệu bảng không quá lớn, một mô hình tuyến tính hoặc cây có thể là mốc thực dụng để bắt đầu. Nếu dữ liệu đầu vào thiếu, nhãn không nhất quán hoặc mục tiêu chưa rõ, tăng số lớp chưa chắc giải quyết điều gì. Một dashboard tổng hợp doanh thu không tự cần mạng nơ-ron; một hệ thống phân loại ảnh có thể cần, nhưng còn phải so với giải pháp sẵn có và yêu cầu thực tế.
| Tình huống | Nên bắt đầu bằng | Điều phải chứng minh trước khi tăng độ phức tạp |
|---|---|---|
| Báo cáo hoặc quy tắc nghiệp vụ rõ | SQL, phép tính hoặc rule có thể kiểm tra | Có nhu cầu dự đoán thực sự hay chỉ cần tính đúng? |
| Bảng dữ liệu quy mô vừa | Baseline đơn giản, chia dữ liệu phù hợp | Mô hình mới cải thiện metric và chi phí sai ra sao? |
| Phân loại ảnh chuyên biệt | Baseline và mô hình pretrained phù hợp | Dữ liệu đại diện, nhãn rõ, cải thiện trên tập độc lập. |
| Thử nghiệm học cơ chế mạng | MLP nhỏ như bài này | Hiểu forward, loss, gradient và cách đánh giá trước. |
Nếu mở rộng bài này, một hướng tự nhiên là CNN: kiến trúc khai thác cấu trúc không gian của ảnh theo cách khác MLP đã flatten. Nhưng không nên viết trước rằng CNN chắc chắn tăng một con số cụ thể trong thiết lập này. Hãy chốt cách chia, ngân sách và metric, chạy rồi báo kết quả cùng giới hạn. Cơ chế thử nghiệm quan trọng hơn một lời hứa kiến trúc nào cũng thắng.
Từ notebook tới ứng dụng: những câu hỏi cần trả lời
Một ảnh trong Fashion-MNIST đã có kích thước, nền và cách đặt vật thể tương đối chuẩn. Ảnh điện thoại của người dùng có thể chứa nhiều vật, nền phức tạp, màu sắc, góc nghiêng hoặc ánh sáng khác. Việc ép ảnh đó về 28×28 không bảo đảm đầu vào trở nên tương đương dataset. Đây là thay đổi phân phối và có thể là thay đổi hẳn bài toán.
Trước khi dùng thật, cần xác định hợp đồng đầu vào: chỉ một vật hay nhiều vật, ảnh xám hay màu, nền như thế nào, đổi kích thước ra sao và trường hợp nào phải từ chối. Nếu cần cắt vật thể hoặc phát hiện nhiều món trong ảnh, đó là công đoạn khác với phân loại một ảnh đã chuẩn. Không nên quảng bá mô hình lab như một hệ thống nhận diện sản phẩm hoàn chỉnh.
Đầu ra cũng cần hợp đồng: hiển thị nhãn cho người dùng tham khảo, tự gán mã trong kho hay quyết định một thao tác tiếp theo? Tác động càng lớn, càng cần kiểm chứng và đường chuyển người xử lý. Với tác vụ quan trọng, một thông báo “không đủ tin cậy để tự xử lý” có thể hữu ích hơn việc luôn trả một nhãn nghe chắc chắn.
Cần theo dõi dữ liệu và lỗi sau triển khai: nguồn ảnh mới, nhóm mặt hàng mới, mức nhầm lẫn thay đổi và thời gian xử lý. Lưu phiên bản code, trọng số, cách tiền xử lý và bảng lớp giúp truy lại kết quả. Một file .pt không thay thế được quy trình vận hành, người chịu trách nhiệm và cách quay lại một phiên bản đã kiểm tra khi có vấn đề.
Bài tập để hiểu thật, thay vì chỉ chạy được
- Tắt cả hai ReLU trong MLP, giữ các điều kiện khác và chạy lại. Giải thích vì sao các lớp tuyến tính liên tiếp vẫn gộp được, rồi so kết quả trên validation; không mặc định việc tối ưu sẽ diễn ra giống mô hình Linear một lớp.
- Giảm hidden width từ 128–64 thành 64–32. Tự tính tham số, đo thời gian và validation loss trước khi quyết định mô hình nhỏ có đủ dùng không.
- Dùng các dự đoán đã lưu để đếm lỗi theo cặp nhãn thật và nhãn đoán. Xem sáu lỗi đầu khác với kết luận từ toàn bộ lỗi như thế nào.
- Tạo một luồng xử lý có ngưỡng chuyển người kiểm tra. Chọn ngưỡng trên validation và đo cả số ảnh tự xử lý lẫn số lỗi; không chọn ngưỡng bằng test.
- Thử ảnh của một vật ngoài mười lớp để quan sát đầu ra. Xem đây là minh họa giới hạn, không coi một ví dụ đơn lẻ là phép đánh giá đầy đủ khả năng phát hiện ngoài phân phối.
Khi thay đổi kiến trúc hoặc learning rate, hãy ghi lại giả thuyết trước: bạn kỳ vọng giảm công tính, giảm overfitting hay tăng khả năng biểu diễn? Nếu kết quả không như dự tính, kiểm tra dữ liệu và cách đo trước khi thêm một kỹ thuật khác. Nhiều thay đổi cùng lúc khiến bạn khó biết yếu tố nào tạo ra kết quả.
Điều cốt lõi của Deep Learning không nằm ở hình mạng có nhiều nút. Nó nằm ở một chu trình có thể kiểm tra: biểu diễn dữ liệu, tạo dự đoán, đo sai, tính gradient, cập nhật tham số rồi đánh giá trên dữ liệu phù hợp. Khi nhìn được chu trình đó qua pixel thật, con số thật và lỗi thật, bạn đã có nền tảng để học các kiến trúc lớn hơn một cách có căn cứ.
Tài liệu tham khảo và nguồn hình
- Fashion-MNIST — Zalando Research: dataset, nhãn và mô tả nguồn. Ảnh dataset: Copyright © 2017 Zalando SE, sử dụng theo MIT License.
- PyTorch: Build the Neural Network.
- PyTorch: Automatic Differentiation with torch.autograd.
- PyTorch: Optimizing Model Parameters.
- PyTorch: Datasets & DataLoaders.
- PyTorch: Save and Load the Model.
- Google ML Crash Course: Activation functions.
- Google ML Crash Course: Overfitting.
Bài lab kiểm tra trên Python 3.12, torch 2.9.1+cpu và torchvision 0.24.1+cpu. Ảnh quần áo, dự đoán và đường loss trong nội dung lấy từ dữ liệu/lần chạy thật; sơ đồ số học là minh họa có tính toán. Cover là hình minh họa được tạo mới. Kết quả chỉ mô tả thí nghiệm đã nêu, không phải cam kết chất lượng ứng dụng thực tế.